第 1 章
研究變化:為何個體內歷程需要專屬的方法
變化是本書存在的理由。在估計任何一個參數(parameter)之前,必須先弄清楚三件事:什麼是變化、談的是誰的變化,以及為什麼橫斷研究(cross-sectional research)所使用的常規工具,即使各盡其職,回答的其實是另一個問題,而不是縱貫研究 (longitudinal research) 者通常真正想問的那一個。
學習目標
讀完本章之後,你應該能夠:(1) 判斷一個研究問題涉及的是水準 (level)、系統性變化 (systematic change)、變異性 (variability)、動態 (dynamics),還是事件發生的時機 (timing of events);(2) 說明為何一個跨個體成立的關聯不必然在個體之內成立,並自行建構一個具體的反例;(3) 以非技術性的語言定義遍歷性 (ergodicity),並指出群體層次結構等於個體層次結構所需的兩個條件;(4) 區分心理歷程本身的時間尺度 (timescale) 與研究設計的時間尺度,並說明兩者不匹配為何重要;(5) 依據資料的樣態與問題的類型,找到本書中對應的篇章;(6) 說明增加測量時點為何會改變「什麼是可估計的」:兩個時點只支持關於變化量的陳述,三個以上的時點才支持關於變化形狀的陳述,而許多時點才支持關於變化動態的陳述。
1.1 一個問題,四種研究
先考慮一個幾乎所有讀者都不陌生的問題:壓力會影響睡眠嗎?這個問題聽起來很單純,就某個意義而言也的確如此。然而一旦真的要蒐集資料來回答它,就會發現「壓力會影響睡眠嗎」並不是一個問題,而是一整族彼此相關的問題;而所選擇的研究設計,會在無聲無息之間決定了你被允許回答的是哪一個。圖 1.1把同一個實質問題放進四種常見的設計裡,值得在繼續往下讀之前先仔細看過,因為本書的整個邏輯,就藏在這四個子圖的對比之中。
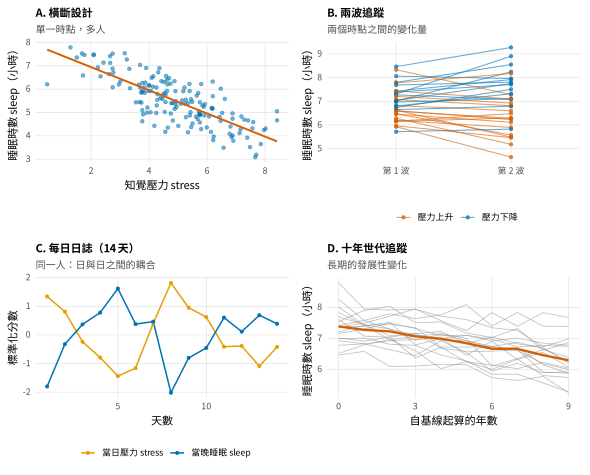
註:四個子圖都是模擬資料。子圖 A 是每人在單一時點上的一筆觀察。子圖 B 是同一群人在兩個時點上的測量,連線代表同一人的兩個數值。子圖 C 是同一人連續 14 天的測量。子圖 D 是一群人被追蹤十年。這四個子圖並不是同一筆資料的四種競爭性分析,而是四種不同的資料結構,各自估計著不同的量。
在子圖 A 這個橫斷研究中,每個人只貢獻一組數值:他有多大壓力、睡多久,都只測一次。負向的斜率告訴我們,回報壓力較大的人平均而言睡得比較少。這是一個關於「人與人之間差異」的陳述。它完全沒有說出,如果某一個特定的人壓力升高,他的睡眠會發生什麼事,因為研究裡沒有任何一個人曾經被觀察到發生變化。在子圖 B 這個兩波追蹤研究中,同一群人被測量兩次,於是每個人開始貢獻一小片個體內的資訊:當他的壓力移動時,他的睡眠往哪個方向移動。在子圖 C 這個 14 天的每日日誌中,一個人被反覆測量,問題也就明確地變成個體內的:在這個人壓力比平常大的那些日子裡,他是否睡得比平常少?在子圖 D 這個十年世代研究中,問題則是發展性的:當人們跨過十年而變老,他們的睡眠如何改變,而人與人之間在這個改變上是否有所不同?
四個子圖共用同樣的橫軸與縱軸,但它們並不共用同一個估計標的 (estimand),也就是研究實際上在估計的那個量。子圖 A 估計的是個體間關聯 (between-person association)。子圖 C 估計的是個體內關聯 (within-person association)。子圖 B 與子圖 D 估計的都是變化,但是不同種類、跨越不同時間尺度的變化。這些量完全可能彼此不一致,而在心理學中確實經常如此。本書要求你培養的核心紀律,是對任何一個分析都能說出某個效果究竟落在誰的變異之中:人與人之間的變異、同一個人跨時間的變異,還是兩者的某種混合。光是「這是誰的變異」這一個思考習慣,就會重新組織你閱讀實徵文獻的方式。
1.2 變化問題的分類
關於變化的問題會以幾種可辨識的家族出現,而學會這些家族比背下一份方法目錄更有用,因為是問題家族決定方法,而不是反過來。以下五個家族在心理學與社會科學中反覆出現,本書的每一章都可以被安置在其中。
第一個家族關心的是隨時間的水準與組間差異。研究者在此詢問的是,某個結果變項的平均值是否在不同組別之間或不同時點之間有差異:實驗組在臨床試驗的每一週是否都報告比控制組更低的憂鬱程度?平均生活滿意度在退休這樣的重大生命轉折之後是否隨之改變?第二個家族關心的是系統性變化的形式與速率,通常稱為成長 (growth)。研究者問的不只是結果變項有沒有改變,而是變化的軌跡 (trajectory) 長什麼樣子:詞彙量在小學階段是線性上升,還是呈現報酬遞減?起點較低的孩子,成長得比同儕更快還是更慢?第三個家族把個體內變異性當成本身就值得研究的量。研究者在此不問一個人的平均水準,而問這個人波動得有多厲害:在經歷壓力事件之後,心情是否變得一天一天更加起伏不定?而這樣的情緒不穩定性本身是否就是一個風險指標?第四個家族關心的是個體內動態:把一個人跨時間的狀態串連起來的延續效果 (carryover)、耦合 (coupling) 與回饋 (feedback)。今天的反芻思考能預測明天的悲傷嗎?壓力與負向情緒是否在片刻之間彼此放大?第五個家族關心事件發生的時機:病人多久之後會復發?什麼因素預測學生何時中途離校?表 1.1列出這五個家族、心理學上的例子,以及本書處理各家族的篇章。
表 1.1 變化問題的五個家族、例子,以及在本書中的位置。
| 問題家族 | 研究問題範例 | 本書位置 |
|---|---|---|
| 隨時間的水準與組間差異 | 實驗組與控制組在每一週的憂鬱程度是否不同?平均幸福感在退休後是否上升? | 第三部(第 10–12 章);第四部(第 13、15 章) |
| 系統性變化的形式與速率(成長) | 三到八年級之間學業成就的成長形狀是什麼?起點較低的孩子成長得較快嗎? | 第四部(第 14 章);第五部(第 19–20 章) |
| 個體內變異性 | 一個人在壓力事件後心情是否變得更起伏?情緒不穩定性是不是風險指標? | 第 7、16 章 |
| 個體內動態(延續效果、耦合、回饋) | 今天的反芻思考能預測明天的悲傷嗎?壓力與負向情緒是否在片刻之間互相強化? | 第六部(第 23–28 章) |
| 事件時機(初發、復發、流失) | 病人多久之後復發?什麼預測學生何時中途離校? | 第 29 章 |
註:章節編號指的是各問題家族的主要處理章節;許多家族會在應用章(第 33–35 章)再次出現。
這裡的順序是有意義的:問題先於模型。在已發表的研究與學位論文中都看得見一個常見而代價高昂的錯誤,就是先從一個偏愛的技術出發,再把問題彎折成能被那個技術處理的形狀。補救的辦法是先為問題命名家族,讓家族把你導向方法,而這正是表 1.1以及本章末更完整的決策輔助圖所要提供的服務。
1.3 個體間變異與個體內變異
本書的概念核心是一個簡單到容易被低估的分解。任何一筆重複測量的觀察值,都可以被切成描述「這個人」的部分與描述「這個時點」的部分。以 \(y_{it}\) 表示個體 \(i\) 在時點 \(t\) 上的結果變項,並以 \(\bar{y}_{i\cdot}\) 表示這個人在其所有時點上的平均。那麼每一筆觀察值都可以寫成他自己的個人平均數加上一個個體內離差:
第一項跨個體變動,但在同一個人之內是常數;它攜帶的是個體間差異的資訊,也就是誰的水準整體上比較高或比較低。第二項在同一個人的不同時點之間變動,但對每一個人而言平均為零;它攜帶的是個體內變化與波動的資訊,也就是一個人在什麼時候高於或低於他自己的常態。對應地,\(y\) 的總變異也就切分成一個個體間成分與一個個體內成分。式 (1.1) 是本章唯一需要你帶走的公式,而多層次模型 (multilevel model)(第 13 與 23 章)、潛在成長模型 (latent growth model)(第 19 章),以及交叉延宕 (cross-lagged) 文獻中關於「個體內對比個體間」的長期爭論(第 21 章),全都由這顆種子長出來。
這個分解值得如此強調,理由在於兩個成分在邏輯上是彼此獨立的:兩個變項在個體間層次的關聯,可以在強度上、甚至在方向上,都與個體內層次的關聯不同。這不是統計上的珍奇異事,而是實質上的家常便飯。以圖 1.2所示的咖啡因與疲倦感為例。跨個體來看,習慣攝取較多咖啡因的人傾向報告較為疲倦,因為人們正是在長期疲勞的時候才伸手去拿咖啡;個體間關聯為正。然而在同一個人之內,剛攝取咖啡因之後的那些時刻,恰恰是最不疲倦的時刻;個體內關聯為負。圖 1.2中每一團彩色點雲代表一個人,它們全都往下傾斜,而穿過各人平均數的虛線卻往上傾斜。一位研究者若只在每人身上測量咖啡因與疲倦感一次,就像一份橫斷問卷調查那樣,只會取回那條向上的個體間型態,並且可能荒謬地得出「咖啡因讓人疲倦」的結論。
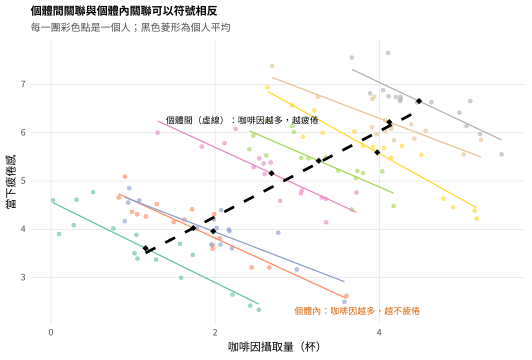
註:模擬示例。每一團彩色點雲代表一個人的重複觀察,每一條細的彩色線是該人「以咖啡因預測疲倦感」的個體內迴歸線。黑色菱形是各人的平均數,黑色虛線則是穿過這些平均數的個體間迴歸線。個體內斜率為負;個體間斜率為正。底層資料以 reversal_demo.csv 提供於配套的 Examples 資料夾中。
這個現象是統計學家所稱辛普森悖論 (Simpson’s paradox) 的一個版本,而它在社會科學中更長的血脈,則可以追溯到 Robinson (1950) 的示範:以群體聚合資料計算出來的相關,可能誤導、甚至反轉個體層次上成立的相關;他把這個錯誤命名為生態謬誤 (ecological fallacy)。Kievit et al. (2013) 為心理學者提供了一份易讀的現代處理,而 Curran and Bauer (2011) 則把個體間與個體內效果的拆解在縱貫模型中形式化,這是第 13 與 23 章會深入回到的處理方式。實務上的教訓簡單得近乎理所當然,卻不斷被遺忘:一個跨個體估計出來的效果,並不自動就是一個在個體之內運作的效果;而如果你的理論談的是一個在個體內部展開的歷程,那麼個體間的證據充其量是間接的,最糟的情況則是誤導的 (Hamaker, 2012; Molenaar, 2004)。
值得謹慎說明的是,這件事蘊含什麼、又不蘊含什麼。兩個分析層次沒有哪一個比另一個更真實或更有效;它們只是回答不同的問題。一位人事心理學者在多位求職者之間做篩選,他真正想知道的就是人與人之間如何不同,這是個體間的問題。一位臨床心理師判斷某位個案的症狀是否正在惡化,他真正想知道的就是這位個案相對於他自己的基線發生了什麼變化,這是個體內的問題。錯誤並不在於研究了其中一個層次而不是另一個;錯誤在於研究了一個層次,卻悄悄把結論寫成好像適用於另一個層次。本書全程都會把這個拆解明白攤開,最具體的做法是第 7、13 與 23 章介紹的個人平均數中心化 (person-mean centering),它把式 (1.1) 的兩個成分分開,使得每一個成分都能依其自身的條件被建模。
常見陷阱 • 橫斷的年齡差異不等於個體內的老化
假設一項橫斷研究發現年長者在處理速度作業上的分數低於年輕人,而報告的結論寫成「認知速度隨年齡而衰退」。這個說法悄悄地用一個個體內主張(某一個人隨著年齡增長而變慢)替換掉了資料實際上支持的個體間比較(目前年紀較大的人,分數低於目前年紀較輕的人)。兩者可能分歧,因為年長組與年輕組是相隔數十年出生的不同世代,在教育年數、營養與對測驗的熟悉度上都有差異。只有像圖 1.1子圖 D 那樣觀察同一群人變老的設計,才能為發展性的主張背書。每當你讀到「X 隨年齡改變」或「X 隨發展而增加」,請先問:研究中真的有任何人被觀察到發生變化嗎?還是只是在同一個時間點上比較了不同的人?
1.4 遍歷性與個殊/律則之軸
現在可以更精確地陳述兩個分析層次何時會重合,並理解心理學為何如此經常不滿足這個條件。借用統計物理學的術語,當一個歷程「在單一時刻跨個體計算出來的結構」等於「在單一個體身上跨時間計算出來的結構」時,這個歷程就被稱為遍歷的 (ergodic)。當一個歷程是遍歷的,個體間分析與個體內分析會收斂到同一個答案,而「測許多人一次」而非「測一個人許多次」這種省事的做法,就不需要付出任何推論上的代價。當一個歷程是非遍歷的,兩種分析可以任意分歧,而再多的個體間資料都不會揭露個體內的結構。Molenaar (2004) 把這個論證放在一篇廣受閱讀的宣言的核心位置,而隨之而來的個體特定研究綱領 (Molenaar & Campbell, 2009) 也重塑了許多心理學者思考「從樣本推論到個體」這件事的方式。
基礎概念 • 什麼時候「群體」等於「個體」?
一個重複測量的歷程要成為遍歷的(在此處相關的意義上),必須滿足兩個條件。第一個是跨個體的同質性 (homogeneity across individuals):每一個人都受同一個模型、同一組參數值所支配,因此在歷程本身上不存在有意義的個別差異。第二個是時間上的定態性 (stationarity over time):每個人的歷程都有穩定的平均數、變異數與關聯型態,不隨時間推移而漂移。若兩個條件同時成立,那麼「單一時點上跨個體的變異結構」就等於「單一個體內跨時點的變異結構」,群體層次的結果也就可以移轉到個體身上。心理歷程慣常違反這兩個條件。人們的動態彼此不同,破壞了同質性;而他們的動態會隨發展、學習、用藥與生命事件而改變,破壞了定態性。這不是一個可以假設掉的技術性麻煩;它往往正是我們感興趣的現象本身。形式化的陳述及其後果由 Molenaar (2004) 提出,而群體層次估計值可能嚴重曲解個體實況的實徵示範,則見 Fisher et al. (2018)。
非遍歷性是常態而非例外,這方面的證據到今天已相當充分。Fisher et al. (2018) 在六筆資料中比較了「在個體間估計」與「在個體內估計」的情緒與行為結構,發現個體內變異數一致地比從個體間變異數所能預期的大上數倍,因此群體推導出來的結果系統性地誤述了個體層次的關係。這裡的教訓不是「應該放棄群體研究」這種虛無主義式的結論,而是有紀律的那一個:模型的合併假設必須與問題相匹配。這件事很適合被想像成一條連續體,如圖 1.3所示。一端是針對單一個體的完全個殊分析,它對其他任何人都不做假設,代價是結果可能無法推論到他人。另一端是完全合併 (complete pooling),也就是把一個模型、一組參數強加在所有人身上;當同質性假設成立時,它既省事又具有檢定力;一旦假設不成立,偏誤就相當嚴重。兩極之間則是本書的主力工具:隨機效果模型 (random-effects model),它讓每個人擁有自己的參數,同時透過一個共享的分配在個體之間互相借力(第四部至第六部);以及個體特定模型,它估計個別的結構,同時利用「這些結構如何被塑形」上的共通性(第 28 章)。
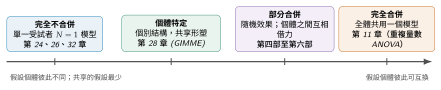
註:章節編號標示各立場在本書中的發展位置。由左至右,模型對個體間同質性的假設逐步增加;假設成立時獲得統計檢定力 (statistical power),不成立時招致偏誤。本書大多數方法落在中間的部分合併地帶,既容許個體彼此不同,又仍然從整個樣本中學習。
這個張力較早的名稱,是律則取向 (nomothetic) 與個殊取向 (idiographic) 的對比:前者尋求跨個體成立的普遍法則,後者尋求理解特定的個體。這個對比常被呈現為哲學上的二擇一,但現代的解決方式更具建設性:個殊分析與律則分析回答不同的問題,並且可以結合,例如先為每個人分別估計一個模型,再詢問這些個體特定的結果是否在人與人之間複製 (Molenaar & Campbell, 2009)。於是,跨個體的複製,而非跨個體的合併,成為通往普遍性的道路。這個想法在第六部的密集縱貫 (intensive longitudinal) 方法中被具體操作化:推論的標的常常就是個體,而普遍性則來自逐一展示同一個動態在許多個體身上都成立。
1.5 時間尺度
歷程有它的時間尺度,研究也有它的時間尺度,而把兩者混為一談是縱貫研究中後果最嚴重的錯誤之一。歷程的時間尺度是它實際展開的速率:皮質醇對壓力源的反應以分鐘計,心情以小時到日計,婚姻滿意度以月到年計,而認知能力以數十年計。設計的時間尺度則由研究者取樣的頻率與持續長度所決定:一週之內每小時一次、十年之間每年一次、間隔六個月測兩次。當取樣的時間尺度與歷程的時間尺度良好匹配時,資料會揭露歷程。當它們不匹配時,資料可能以一種當下容易忽略、事後又難以察覺的方式錯誤刻畫歷程。
圖 1.4示範了其中最重要的一種不匹配,稱為疊頻 (aliasing)。一個真正以大約每週為節律循環的歷程,被以兩種方式取樣:密集地,以每日為間隔;以及稀疏地,以大約每 8 天為間隔。密集取樣取回了週循環。稀疏取樣則每次都在不同的相位上捕捉到這個歷程,連起來成為一條平滑的下降線,暗示一個並不存在的緩慢衰退。只看得到紅點的稀疏取樣者會報告一個趨勢;而這個歷程根本沒有任何趨勢。這個教訓遠遠不只適用於週期性歷程。回溯性報告,也就是請參與者總結他們「過去一個月」的感受,其實是偽裝過的時間尺度決定:它把快速的個體內變異壓縮成一個被記住的平均,因而丟掉的恰恰是密集設計所要捕捉的動態 (Csikszentmihalyi & Larson, 1987; Stone & Shiffman, 1994)。而且,估計出來的效果依賴於取樣間隔這件事,並不只發生在描述性的圖示上:像「某一刻的壓力能在多大程度上預測下一刻的負向情緒」這樣的延宕效果,其大小、偶爾甚至方向,都取決於兩個時刻之間相隔多久;這個問題正是第 27 章連續時間模型的動機。
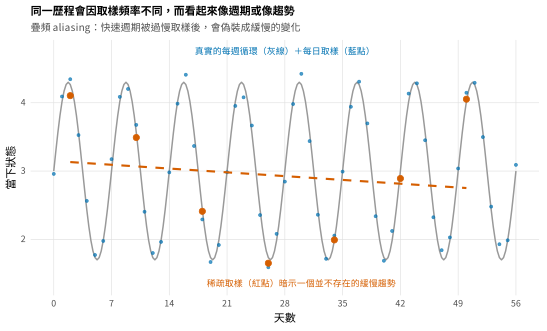
註:模擬示例。灰色曲線是真實歷程,具有大約以週為單位的循環。藍點是密集(每日)取樣,取回了循環。紅點是大約每 8 天取一次的稀疏取樣;紅色虛線是這些紅點的線性趨勢,它暗示一個緩慢的衰退,而這個衰退是取樣間隔造成的人工產物,不是歷程本身的特徵。
1.6 五個研究綱領的簡史
本書中的方法並非源自單一源頭。它們是五個研究傳統的匯流;這些傳統大致平行發展,常常分屬不同學科,並且對同樣的想法使用不同的詞彙,這也正是現代文獻中同義詞如此豐富的原因。一段簡短的歷史定位是有幫助的,不是為了歷史本身,而是因為它解釋了為什麼同一個模型會以好幾個名字出現,以及為什麼看起來毫不相干的技術往往是近親。
第一個傳統是變異數分析。它在二十世紀初為農業與實驗研究而發展,後來被改用於重複測量,成為重複量數變異數分析與混合設計變異數分析。它給了心理學第一套系統性的方法來檢定平均數是否在不同時點之間有差異,也仍然是許多研究者最先接觸到的框架;只是它的假設與縱貫資料的結構相處得並不自在,而這個張力正是多層次替代方案的動機(第 11 章)。第二個傳統是成長曲線與結構方程模型的傳統,它把變化重新概念化為一條具有個別變動的起點與斜率的潛在軌跡,由此產生了潛在成長模型及其眾多後裔(第 19 與 20 章)。第三個傳統是多層次或階層模型的傳統,它興起於教育學與社會學,用來處理巢套於單位之中的資料,例如巢套於學校之中的學生,後來被認識到同樣適用於巢套於個體之中的時點,於是產生了作為第四部核心的混合效果模型。Baltes and Nesselroade (1979) 闡述了「把縱貫研究當成一項獨立事業」的理由,他們的綱領性陳述至今仍值得一讀。
第四個傳統是時間序列與個殊取向的傳統。它在心理學中的源頭可以追溯到 Cattell et al. (1947),他們的 P 技術因素分析尋找的是單一個體在許多時點上的波動結構,這是一種明確的個體內因素分析,預示了第 26 章的動態因素模型與狀態空間模型。Molenaar 後來的工作則重新啟動並形式化了這個綱領。Nesselroade (1991) 貢獻了一個影響深遠的意象:把發展視為一塊織物,既有緩慢變化的「經線」,也有快速波動的「緯線」;這個意象促成了測量叢發設計 (measurement-burst design),也就是把短期的密集取樣以較長的間隔反覆施行,以便讓快速變化與緩慢變化能夠被一起研究。第五個傳統是經驗取樣 (experience sampling) 與生態瞬時評估 (ecological momentary assessment, EMA) 的傳統,它成長於「在日常生活中即時捕捉經驗,而非事後回溯」的努力 (Csikszentmihalyi & Larson, 1987; Stone & Shiffman, 1994);隨著智慧型手機與穿戴式感測器的到來,它已使密集縱貫資料從奇珍變成日常 (Bolger et al., 2003; Hamaker & Wichers, 2017)。表 1.2收集了最常見的跨傳統同義詞,讓你在一個陌生的方言中也能認出同一個想法。
表 1.2 跨傳統同義詞小辭典。
| 同一個想法 | 它旅行時使用的名字 |
|---|---|
| 多層次模型 | 階層線性模型 (hierarchical linear model, HLM)、混合效果模型 (mixed-effects model)、混合模型 (mixed model)、隨機係數模型 (random-coefficient model)、變異數成分模型 (variance-components model) |
| 成長曲線 | 潛在成長模型 (latent growth model, LGM)、潛在軌跡模型 (latent trajectory model)、潛在曲線模型 (latent curve model)、隨機效果成長模型 (random-effects growth model) |
| 個體內層次 | 第一層 (level 1)、時點層次 (occasion level)、時間層次 (time level)、狀態層次 (state level)、個體內 (intraindividual) |
| 個體間層次 | 第二層 (level 2)、個人層次 (person level)、特質層次 (trait level)、個體間 (interindividual) |
| 自我迴歸 (autoregression) | 延續效果 (carryover)、慣性 (inertia)、持續性 (persistence)、延宕一期效果 (lag-1 effect) |
| 經驗取樣 | 生態瞬時評估 (ecological momentary assessment, EMA)、隨身評估 (ambulatory assessment)、日誌法 (diary method)、經驗取樣法 (experience-sampling method, ESM) |
| 個體特定分析 | 個殊取向 (idiographic)、單一受試者 (single-subject)、\(N=1\)、i 層次 (i-level) |
註:名稱之所以繁多,反映的是正文所描述的那些傳統平行發展的歷史,而不是底層模型之間有什麼深刻差異。
1.7 如何使用本書
因為這個領域是按傳統組織起來的,而你的工作卻是按資料與問題組織起來的,本書提供兩條入口。第一條是表 1.3,一個把資料結構與問題家族交叉起來、並指向章節的入口矩陣。找到與你的資料形狀相符的那一列,橫讀到與你想知道的事情相符的那一欄,就從那裡開始。第二條是圖 1.5,一份更完整的方法選擇輔助圖,把上述導引整合進單一張圖;它是本書的主地圖,而第 36 章會回到這張圖,在你旅程的終點稽核本章所做出的種種承諾。
表 1.3 入口矩陣:資料結構乘以問題家族,附章節導引。
| 你的資料 | 平均水準 | 成長形狀 | 變異性 | 動態 | 事件 |
|---|---|---|---|---|---|
| 兩個時點 | 10 | 10 | – | 21\(^{a}\) | 29 |
| 3–8 波追蹤 | 11、12 | 14、19、20 | 7 | 21 | 29 |
| 每日日誌 | 23 | 14、23 | 7、16 | 23、25 | 29 |
| EMA/ESM | 23 | 23、30 | 16 | 25–28 | 29 |
| \(N=1\) 長序列 | 24 | 24、30 | 7、24 | 24–26、32 | – |
| 事件時間 | – | – | – | – | 29 |
註:格內數字為章次,列出主要處理該組合的章節;短橫線表示該組合一般無法由該資料結構估計。\(^{a}\) 兩波資料只支持一種有限而爭議甚多的動態推論形式,見第 21 章。橫跨各格的共通議題(遺漏資料 missing data、測量、估計)適用於每一格,於第 3、6、17 與 18 章處理。
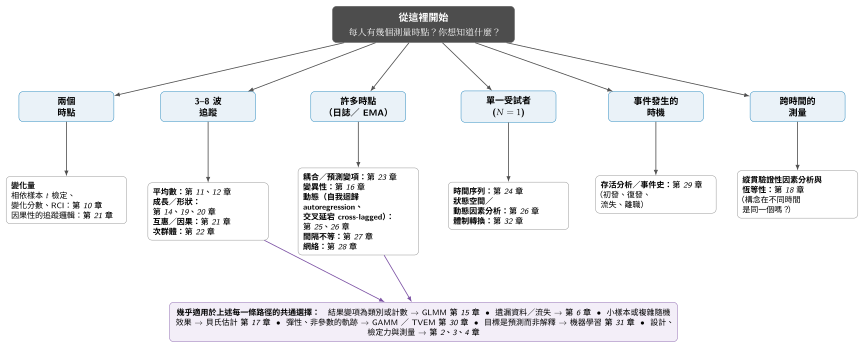
註:從最上方描述你的資料與問題進入,順著箭頭走到相符的類別,再讀該類別的葉節點,即可找到在該資料結構下處理各問題家族的章節。紫色橫帶列出橫跨各路徑的共通議題,各有專章處理。本圖是圖 36.1 的對照圖,第 36 章會在所有方法都發展完畢之後重訪同一張地圖。
關於本書的體例,幾句說明會讓後續各章更容易導航。符號在全書保持一致:個體以 \(i\) 索引、時點以 \(t\) 索引,個體 \(i\) 在時點 \(t\) 上的結果變項為 \(y_{it}\),而式 (1.1) 所引入的個體間與個體內成分,在任何地方都以相同的意義再次出現。每一章都用四種方塊標記關鍵想法:基礎概念方塊處理底層數學,實務要點方塊處理預設值與疑難排解,常見陷阱方塊處理我們最希望你避開的錯誤,而軟體提示方塊提供工具專屬的指引。每一個實作範例都取自一小組共用的資料集,讓你能夠帶著同一筆資料走過許多方法;這些資料集連同產生每一張圖的程式碼,都收錄在下方軟體提示所描述的配套材料中。最後,本書是模組化的。一個學期的古典縱貫分析課程可以走第 1 章、第 5 至 8 章、第 10 至 14 章、第 19、21 與 29 章;一門密集縱貫方法的課程可以走第 1 至 3 章、第 5 至 7 章、第 9、13、16 章,以及第 23 至 28 章;而手上已經有資料的讀者,可以直接從表 1.3進入。
軟體提示 • 配套 Examples 資料夾與可重製性
本書每一筆資料集都由一個文件化、設定了隨機種子的資料生成歷程 (data-generating process) 模擬而來,因此每筆資料背後的「真值」都是已知的,你可以據以研究某個方法把它還原得多好。本章用到其中兩筆。affect_ema 模擬一項經驗取樣研究:120 人、每天提示 6 次、持續 14 天,當下的壓力與情緒由一個個體特定的動態歷程產生,並帶有寫實的遺漏樣態。school_growth 模擬一項加速世代研究:1,200 名兒童的學業成就跨四個學年被測量,並由三個重疊世代拼接起來,涵蓋三到八年級(譯註:約當台灣的小學三年級至國中二年級)。兩筆資料都以 .rds 與 .csv 格式提供於配套的 Examples 資料夾中,同時附上產生它們的 R 程式碼,以及記錄每一個變項的資料編碼簿 (codebook)。本書所有分析都使用 R;在某些套裝軟體(例如 Mplus)是該領域標準做法的地方,會另以軟體專屬的附欄補充。
1.8 在 R 裡處理變化:初探
在進入後續各章的形式機器之前,值得先看看本章的想法在真實資料與真實程式碼中長什麼樣子。這裡的目標不是配適模型,那要到第 13 章才真正開始,而是「看」;因為在建模之前先把重複測量資料畫出來,是縱貫研究中最可靠的防錯機制之一。以下每一個指令都可以在配套資料集上執行,並以簡化的形式重製本章的圖形。
先載入資料並檢視它的形狀。本書的重複測量資料都以長格式 (long format) 保存,也就是每人每個時點一列;幾乎所有現代縱貫分析工具都預期這種格式(第 5 章完整處理資料管理)。
# 從配套的 Examples 資料夾載入兩筆資料集
affect_ema    <- readRDS("Examples/data/affect_ema.rds")
school_growth <- readRDS("Examples/data/school_growth.rds")

# 每人每個時點一列(長格式)
head(affect_ema[, c("person", "day", "beep", "stress", "na", "pa")])
nrow(affect_ema)                  # 10,080 個潛在的「個體 × 時點」
length(unique(affect_ema$person)) # 120 人
要看見「系統性變化」是什麼意思,可以畫出一部分兒童跨年級的學業成就軌跡,並疊上平均軌跡。由此得到的義大利麵圖 (spaghetti plot)(圖 1.6左側子圖)呈現的個別成長是一束向上的線條,帶著清楚的平均趨勢,這正是成長問題的視覺標記。
library(ggplot2); library(dplyr)

sg_mean <- school_growth
  group_by(grade)

ggplot(school_growth, aes(grade, achievement, group = child_id)) +
  geom_line(alpha = 0.08, color = "#0072B2") +               # 個別軌跡
  geom_line(data = sg_mean, aes(group = 1),                  # 平均軌跡
            color = "#C15A00", linewidth = 1.3) +
  labs(x = "年級", y = "學業成就分數")
要看見「波動」是什麼意思,可以畫出某一個人在 14 天內當下的負向情緒,如圖 1.6右側子圖所示。這裡沒有系統性趨勢,有的是繞著這個人自己的平均而發生的、有結構的移動,這正是動態問題的視覺標記。
one_person <- affect_ema

ggplot(one_person, aes(seq_along(na), na)) +
  geom_line(color = "#1B7F5C", na.rm = TRUE) +
  geom_point(color = "#1B7F5C", na.rm = TRUE) +
  geom_hline(yintercept = mean(one_person$na, na.rm = TRUE),
             linetype = "dashed") +                          # 這個人自己的平均
  labs(x = "測量時點", y = "負向情緒")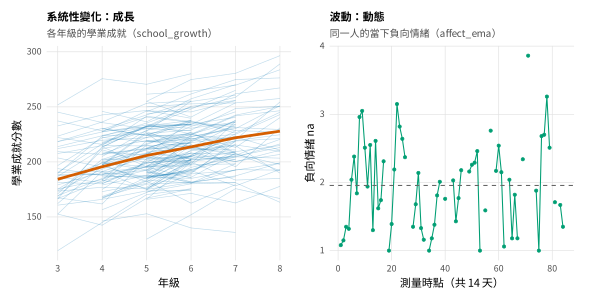
註:左圖:取自 school_growth 的一部分兒童的學業成就軌跡,橘色線為平均軌跡;故事是系統性成長。右圖:取自 affect_ema 的某一個人在 14 天內當下的負向情緒,虛線為這個人自己的平均;故事是繞著一個穩定水準的波動。右圖中的空隙是未回應的提示(遺漏資料)。
最後,可以把第 1.3 節「個體間對比個體內」的區分從視覺化推進到數值化。運用式 (1.1),把每個人當下的壓力與負向情緒切分成個人平均數與個體內離差,再分別計算兩個層次上的關聯。這是一個描述性的分解,不是一個估計出來的模型;具備適當標準誤的正式多層次版本要到第 13 章才出現。
d <- affect_ema
  filter(!is.na(stress), !is.na(na))
  group_by(person)
  mutate(stress_pm = mean(stress),  na_pm = mean(na),         # 個體間成分
         stress_wd = stress - stress_pm,                      # 個體內成分
         na_wd     = na - na_pm)
  ungroup()

# 天真的合併相關:忽略了個體的巢套結構
cor(d$stress, d$na)                                           # 約 0.42

# 個體間相關(跨個人平均)
pm <- d
  summarize(stress_pm = first(stress_pm), na_pm = first(na_pm))
cor(pm$stress_pm, pm$na_pm)                                   # 約 0.55

# 個體內相關(跨離差)
cor(d$stress_wd, d$na_wd)                                     # 約 0.33
這三個數字彼此不同,而它們的不同正是重點所在。約 \(.42\) 的天真相關,是把每一筆觀察都當成獨立的來計算的,它其實是兩個不同量的混合:一個約 \(.55\) 的個體間相關,告訴我們平均壓力較高的人平均而言也較為負向;以及一個約 \(.33\) 的個體內相關,告訴我們在一個人壓力高於他自己常態的那些時刻,他也比自己的常態更為負向。只報告合併值的研究者,等於兩個層次都沒有乾淨地描述到。對負向情緒的變異數做平行的分解會發現,它的總變異中只有大約 37% 落在個體之間,也就是說大約 63% 是個體內的波動;而這正是橫斷設計所丟棄的、也是本書的個體內方法所要建模的那一部分變異。
1.9 從報表到文章:書寫變化
統計報表要等到為讀者寫成文字,才算得上是一項結果,而縱貫分析尤其容易被描述得不夠精確,因為日常語言會模糊掉分析如此費力才分開的「個體間與個體內」之別。本節很短,本書每一個方法章都會以模型專屬的指引呼應它;此處先提出幾項原則,說明如何把上述圖示與數值轉化為站得住腳的文字。
第一項原則是明確指出層次。不要寫「壓力與負向情緒相關,\(r = .42\)」,那會讓讀者自行猜測指的是誰的變異;而要寫兩句話把層次分開。就上面的分析而言,一段謹慎的描述是:「跨個體來看,回報較高平均壓力的個體也回報較高的平均負向情緒,顯示存在個體間關聯(\(r = .55\))。在個體之內,壓力高於個人常態的那些當下,負向情緒也高於個人常態,顯示存在個體內關聯(\(r = .33\))。」讀者現在確切知道每一個數字指的是哪一種比較;而那個兩邊都不對應的合併值,則被擺在一旁,而不是被當成關係的摘要來報告。
第二項原則是描述變異結構,而不只是點估計值,因為在縱貫資料中,變異的配置本身就是一項發現。像「當下負向情緒的變異約有 63% 屬於個體內,顯示在穩定的個別差異之上存在相當程度的片刻波動」這樣的句子,告訴讀者個體內分析是有正當性的,並且大致有多少訊號可供運用。第三項原則是讓動詞配合設計,把變化與歷程的語言保留給真正觀察到變化的資料。橫斷差異應該用比較性的語言描述(「年紀較大的參與者分數較低」),而不是用發展性的語言(「分數隨年齡下降」),除非確實追蹤了同一群人。第四項原則是先陳述估計標的,再給出估計值:在結果段落的開頭先寫出被估計的量(「本研究估計壓力與負向情緒之間的個體內關聯」),使緊接著出現的數字從一開始就被正確地理解。這些習慣不花任何成本,卻能預防縱貫研究結果所招致的一大部分誤讀;第 36 章會依模型家族逐一彙整完整的報告標準。
實務要點 • 哪一種問題需要幾個測量時點?
測量時點的數目不是統計品味的問題;它決定了什麼東西根本上是可估計的。兩個時點支持關於兩者之間變化量的陳述,也就是每人一個差異值,但無法把變化的形狀與測量誤差區分開來,而且由兩波資料計算出來的差異分數以信度低落著稱(第 10 章)。三到四個時點開始支持關於系統性變化形狀的陳述,也就是一條線性軌跡,而有四個以上時就能容納某些曲率(第 14 與 19 章)。許多時點,大致上是每人數十個以上,才是動態所要求的,因為要估計一個人的延續效果、耦合或變異性,需要足夠多的個體內資料點來刻畫歷程本身(第 16 章與第 23 至 28 章)。一句好用的口號是:兩波給你變化,數波給你曲線,許多波才給你歷程。如果你的問題關乎動態,而設計只有三波,誠實的回應是改變問題或改變設計,而不是過度解讀模型。
1.10 常見的迷思
有幾種看法普遍到、也嚴重到值得直接點名。第一,認為縱貫資料自動就能支持因果主張。長期追蹤一群人排除了某些替代解釋,但沒有排除其他的;變項在時間上的先後排序對因果推論是必要條件,不是充分條件;第 21 章會誠實地處理那些假設。第二,認為個體內效果只是測得更精確的個體間效果。如圖 1.2所示,兩者可以方向相反,因此它們是不同的量,而不是同一個量的較好與較差的測量。第三,是一對孿生的看法:來自單一個體的發現無法推論,以及群體發現自動適用於每一個人。兩者都失之天真:一個被良好複製的單一受試者結果之所以能推論,恰恰是因為它已被證明在許多個體身上成立;而當歷程是非遍歷的時候,一個群體層次的結果卻可能不描述任何一個特定的個體 (Fisher et al., 2018; Molenaar, 2004)。最後是一個學生常問的實務問題:我的資料只有兩波,這本書適合我嗎?適合。兩波設計有它自己的細緻處理(第 10 章),也出現在第 21 章的因果推論爭論中,並且並且同樣涉及第一部所處理的設計、測量與遺漏資料等議題。
本章摘要
本章主張縱貫問題並不是「橫斷問題多加一個維度」,而是一個獨立的問題家族,關乎水準、成長、變異性、動態與事件時機,各自需要與之匹配的方法。它的核心工具是把任何一筆重複測量分解為一個個體間成分與一個個體內成分(式 1.1),它的核心警告則是:兩個層次上的關聯在邏輯上彼此獨立,甚至可能符號相反。遍歷性為兩個層次得以重合的那個罕見條件命名,即跨個體同質性與時間上的定態性;由於心理歷程慣常違反它,模型的合併假設必須與問題相匹配,而不是被逕行假定。時間尺度同樣必須與歷程相匹配,否則稀疏取樣會製造出並不存在的趨勢。本章最後給出本書的實用裝置:一份入口矩陣(表 1.3)與一張主決策地圖(圖 1.5),把你從資料與問題導引到方法。
接下來讀哪裡
想了解縱貫資料是由哪些設計產生的讀者,請繼續往第 2 章;關心一個構念 (construct) 在每個時點上是否還意謂同一件事的讀者,可以先跳到第 3 與 18 章;而準備好看見個體間與個體內分解變成一個被估計的模型的讀者,請轉往第 13 章,也就是本書大部分內容所倚賴的多層次基礎。要帶著往前走的那條線索,是第 1.1 節提出的問題:對任何一個你讀到或估計到的效果,都要問它活在誰的變異裡。第 36 章會回到圖 1.5的決策地圖,逐一稽核此處所做的承諾。
習題
- 1.1 為問題分類。以下每一個研究標題,請指出它屬於表 1.1五個問題家族中的哪一個,並以一句話說明理由:(a)「正念訓練是否相對於等候名單控制組降低了平均焦慮?」;(b)「自尊起伏較大的青少年是否回報較多憂鬱症狀?」;(c)「病人出院後多久首次復發?」;(d)「每日睡眠品質能否預測隔日的正向情緒?」;(e)「閱讀流暢度從一年級到五年級的軌跡是什麼?」
- 1.2 建構一個反轉。使用
Examples資料夾中的reversal_demo.csv資料集,重製圖 1.2。接著,從你自己的領域中描述一對變項,其個體間與個體內關聯在方向上很可能不同,並說明每一個層次上的機制。 - 1.3 什麼是可估計的?對圖 1.1的四個子圖,請精確說明該設計能夠回答與不能回答「壓力會影響睡眠」這個問題家族中的哪一個成員,以及為什麼。
- 1.4 說明遍歷性。以不超過 300 字,向一位大一學生解釋為何一個「跨人平均而言成立」的結果,不必然對任何一個特定的人成立。請使用具體的例子,並避免技術性詞彙。
- 1.5 為你自己的資料找入口。取一筆來自你自己研究的縱貫資料,或一篇你欣賞的已發表研究。使用表 1.3與圖 1.5,指出你會從哪一章開始,並寫一段文字為這個導引辯護,包括你追求的是哪一個問題家族,以及為什麼該資料結構支持它。
- 1.6 在 R 裡做變異數分解。使用
affect_ema,把第 1.8 節的個體間與個體內分解改用正向情緒(pa)而非負向情緒重做一次。報告pa與stress的合併相關、個體間相關與個體內相關,以及pa的變異中屬於個體內的比例。並依第 1.9 節的原則寫兩句話描述結果。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 個體內 | within-person | 同一個人在不同時點之間的變異;第 1.3 節 |
| 個體間 | between-person | 不同個體之間的差異;第 1.3 節 |
| 橫斷 | cross-sectional | 每人只在單一時點被測量的設計;第 1.1 節 |
| 縱貫 | longitudinal | 同一批對象跨時間被重複測量的設計;全書 |
| 密集縱貫 | intensive longitudinal | 每人有大量時點的設計(日誌、EMA);第六部 |
| 估計標的 | estimand | 研究實際上想估計的那個量;第 1.1 節 |
| 軌跡 | trajectory | 個體結果變項隨時間變化的形狀;第 1.2 節 |
| 成長 | growth | 系統性、通常具方向性的變化;第 1.2 節 |
| 變異性 | variability | 個體內波動的幅度,本身即為研究對象;第 1.2 節 |
| 動態 | dynamics | 跨時間的延續、耦合與回饋;第 1.2 節 |
| 延續效果 | carryover | 前一時點狀態對後一時點的殘留影響;第 1.2 節 |
| 耦合 | coupling | 兩個歷程跨時間彼此連動;第 1.2 節 |
| 個人平均數中心化 | person-mean centering | 以個人自身平均數為原點分離兩層變異;第 1.3 節 |
| 辛普森悖論 | Simpson’s paradox | 聚合後的關聯與分組內關聯方向相反;第 1.3 節 |
| 生態謬誤 | ecological fallacy | 以群體聚合資料推論個體關係的錯誤;第 1.3 節 |
| 遍歷性 | ergodicity | 群體結構等於個體結構的條件;第 1.4 節 |
| 同質性 | homogeneity | 所有個體受同一模型與同一組參數支配;第 1.4 節 |
| 定態性 | stationarity | 歷程的平均數、變異數與關聯不隨時間漂移;第 1.4 節 |
| 律則取向 | nomothetic | 追求跨個體成立的普遍法則;第 1.4 節 |
| 個殊取向 | idiographic | 追求理解特定個體本身;第 1.4 節 |
| 合併 | pooling | 模型假設個體之間共享參數的程度;第 1.4 節 |
| 隨機效果 | random effects | 允許參數在個體之間變動的模型成分;第 1.4 節 |
| 時間尺度 | timescale | 歷程展開或研究取樣的時間單位;第 1.5 節 |
| 疊頻 | aliasing | 取樣過慢使快速週期偽裝成緩慢趨勢;第 1.5 節 |
| 測量叢發設計 | measurement-burst design | 以長間隔反覆施行短期密集取樣;第 1.6 節 |
| 經驗取樣 | experience sampling | 在日常情境中即時重複測量經驗;第 1.6 節 |
| 生態瞬時評估 | ecological momentary assessment (EMA) | 同上,行為醫學傳統的名稱;第 1.6 節 |
| 多層次模型 | multilevel model | 時點巢套於個體的隨機效果模型;第 1.3 節 |
| 潛在成長模型 | latent growth model | 以潛在截距與斜率表徵變化的 SEM;第 1.3 節 |
| 交叉延宕 | cross-lagged | 兩變項互相以延宕項預測的追蹤模型;第 1.3 節 |
| 長格式 | long format | 每人每時點一列的資料排列方式;第 1.8 節 |
| 資料生成歷程 | data-generating process | 模擬資料時所設定的已知真實機制;第 1.7 節 |
參考文獻
Baltes, P. B., & Nesselroade, J. R. (1979). History and rationale of longitudinal research. In J. R. Nesselroade & P. B. Baltes (Eds.), Longitudinal research in the study of behavior and development (pp. 1–39). Academic Press.
Bolger, N., Davis, A., & Rafaeli, E. (2003). Diary methods: Capturing life as it is lived. Annual Review of Psychology, 54, 579–616. https://doi.org/10.1146/annurev.psych.54.101601.145030
Bolger, N., & Laurenceau, J.-P. (2013). Intensive longitudinal methods: An introduction to diary and experience sampling research. Guilford Press.
Cattell, R. B., Cattell, A. K. S., & Rhymer, R. M. (1947). P-technique demonstrated in determining psycho-physiological source traits in a normal individual. Psychometrika, 12(4), 267–288. https://doi.org/10.1007/BF02288941
Csikszentmihalyi, M., & Larson, R. (1987). Validity and reliability of the Experience-Sampling Method. The Journal of Nervous and Mental Disease, 175(9), 526–536. https://doi.org/10.1097/00005053-198709000-00004
Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62, 583–619. https://doi.org/10.1146/annurev.psych.093008.100356
Fisher, A. J., Medaglia, J. D., & Jeronimus, B. F. (2018). Lack of group-to-individual generalizability is a threat to human subjects research. Proceedings of the National Academy of Sciences, 115(27), E6106–E6115. https://doi.org/10.1073/pnas.1711978115
Hamaker, E. L. (2012). Why researchers should think “within-person”: A paradigmatic rationale. In M. R. Mehl & T. S. Conner (Eds.), Handbook of research methods for studying daily life (pp. 43–61). Guilford Press.
Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889
Hamaker, E. L., & Wichers, M. (2017). No time like the present: Discovering the hidden dynamics in intensive longitudinal data. Current Directions in Psychological Science, 26(1), 10–15. https://doi.org/10.1177/0963721416666518
Hoffman, L. (2015). Longitudinal analysis: Modeling within-person fluctuation and change. Routledge.
Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson’s paradox in psychological science: A practical guide. Frontiers in Psychology, 4, 513. https://doi.org/10.3389/fpsyg.2013.00513
Molenaar, P. C. M. (2004). A manifesto on psychology as idiographic science: Bringing the person back into scientific psychology, this time forever. Measurement: Interdisciplinary Research and Perspectives, 2(4), 201–218. https://doi.org/10.1207/s15366359mea0204_1
Molenaar, P. C. M., & Campbell, C. G. (2009). The new person-specific paradigm in psychology. Current Directions in Psychological Science, 18(2), 112–117. https://doi.org/10.1111/j.1467-8721.2009.01619.x
Nesselroade, J. R. (1991). The warp and woof of the developmental fabric. In R. M. Downs, L. S. Liben, & D. S. Palermo (Eds.), Visions of aesthetics, the environment, and development: The legacy of Joachim F. Wohlwill (pp. 213–240). Lawrence Erlbaum Associates.
Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
Singer, J. D., & Willett, J. B. (2003). Applied longitudinal data analysis: Modeling change and event occurrence. Oxford University Press.
Stone, A. A., & Shiffman, S. (1994). Ecological momentary assessment (EMA) in behavioral medicine. Annals of Behavioral Medicine, 16(3), 199–202. https://doi.org/10.1093/abm/16.3.199
Wang, L. P., & Maxwell, S. E. (2015). On disaggregating between-person and within-person effects with longitudinal data using multilevel models. Psychological Methods, 20(1), 63–83. https://doi.org/10.1037/met0000030