第 4 章
規劃縱貫研究:檢定力、精確度與設計上的取捨
第 2 章挑選了設計,第 3 章確保了設計的測量品質。本章要問的是計畫審查委員接下來一定會問的那個問題:這項研究需要多大?對縱貫模型而言,誠實的答案永遠不是單一個數字,因為一項在估計平均軌跡上檢定力充裕的研究,可能完全無力偵測那條軌跡的個體差異。規劃的意思是決定哪一個估計標的才重要,並圍繞它把研究建立起來;而對於現實的模型,讓這件事成為可能的工具是模擬。
學習目標
讀完本章之後,你應該能夠:(1) 指出在重複量數變異數分析、多層次成長模型、潛在成長模型與密集縱貫設計中,各自主導檢定力 (power) 的設計因素;(2) 對簡單的重複測量設計運用封閉解 (closed-form) 的檢定力公式,並說明公式在哪裡失效;(3) 依循一套可重複使用的六步驟流程,從零建立一個縱貫模型的模擬式檢定力分析;(4) 在標準情形下運用 simr 等既有工具與蒙地卡羅 (Monte Carlo) 功能;(5) 在預算固定的條件下,量化地推理「人數」與「時點數」之間的取捨;(6) 為現實的流失與配合度預作規劃;(7) 以「估計標的先行、關注精確度」的語言,向計畫審查委員說明樣本數的理由。
4.1 當模型有許多參數時,檢定力是什麼意思
在兩組比較裡,檢定力是一個數字,附著在一個效果上。一個縱貫模型同時估計許多個量,而每一個量都有自己的檢定力。圖 4.1用一項單一的每日日誌設計把這件事講清楚:三十個人,連續測量十四天。在這同一項研究裡,隨機截距 (random intercept) 的變異數被偵測到的檢定力幾乎等於一;某個每日預測變項的個體內效果,檢定力約為 \(.82\);但個體間效果、跨層次交互作用 (cross-level interaction) 以及隨機斜率 (random slope) 的變異數,三者被偵測到的檢定力都在 \(.50\) 附近,遠低於慣用的 \(.80\)。同一批資料的蒐集,會依你問的是哪個問題而同時處於檢定力過剩與檢定力不足的狀態。世上並不存在「這項研究的檢定力」這種東西;只存在「某一個指名的估計標的的檢定力」。
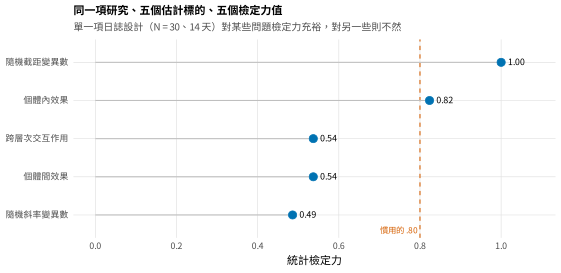
註:在單一項每日日誌設計(30 人、14 天)中,由同一個多層次模型估計的五個量,各自的模擬檢定力。檢定力從隨機截距變異數的接近 \(1.0\),一路到隨機斜率變異數的約 \(.49\)。虛線標示慣用的 \(.80\)。
這種多重性帶來一個建設性的推論:規劃要從指名「這項研究是為了估計哪一個估計標的而存在」開始,然後為那一個量準備檢定力。它也讓整件事值得重新框定。虛無假設檢定的檢定力問的是「一個效果能不能被區辨於零」,但一項研究可以跨過那道門檻,卻仍然把效果估計得太不精確而毫無用處。與之互補的框架是參數估計準確度 (accuracy in parameter estimation, AIPE),它改為針對一個目標精確度 (precision) 來規劃,問的是「要多少樣本,才能讓信賴區間 (confidence interval) 的寬度不超過某個由實質判斷選定的值」(Maxwell et al., 2008)。精確度規劃在第 4.6 節與圖 4.8中發展;當審稿人對一個「任何可行樣本都偵測不到」的量堅持要求 \(.80\) 檢定力時,精確度往往是更站得住腳的框架,因為它把對話從一個二元判決,轉成「這個效果會被釘得多緊」。
4.2 封閉解的結果及其適用範圍
對最簡單的重複測量設計,檢定力可以由公式算出來。成對樣本 \(t\) 檢定 (paired \(t\) test) 與重複量數變異數分析有基於非中心分配 (noncentral distribution) 的古典檢定力,而它們所編碼的那個關鍵的縱貫事實是:檢定力取決於重複測量之間的相關。時點之間相關得越強,受試者內的對比 (contrast) 就被估計得越精確,這正是重複測量設計有效率的原因;也正是為什麼球形 (sphericity) 假設一旦被違反,就會扭曲整個計算。從 G*Power 這類軟體轉過來的讀者會發現,這些情形在那些軟體裡都有現成的處理。基礎概念方塊陳述非中心性的邏輯,以及多層次成長斜率的解析結果。
基礎概念 • 非中心性,以及多層次的解析結果從何而來
一個雙尾的 \(H_0\!:\gamma = 0\) 檢定,在 \(|z| = |\hat\gamma / \mathrm{SE}(\hat\gamma)|\) 超過 \(z_{1-\alpha/2}\) 時拒絕。在對立假設 \(\gamma = \gamma^\ast\) 之下,統計量 \(z\) 的中心不在零,而在非中心性參數 (noncentrality parameter)
因此檢定力完全由「效果對其標準誤的比值」所主導。對於一個兩層次成長模型中的平均線性斜率,若有 \(N\) 個人,每個人都在編碼為 \(t_1,\dots,t_T\) 的各時點接受測量,則其標準誤有一個頗具啟發性的封閉解:
其中 \(\tau_{11}\) 是斜率的個體間變異數,\(\sigma^2\) 是個體內的殘差變異數 (Raudenbush & Liu, 2001; Snijders & Bosker, 2012)。式 (4.2) 是縱貫設計的解析核心。第二項會在增加時點或把時點拉得更開時縮小,因為 \(\sum_j (t_j - \bar t)^2\) 變大了;期程與間距買得到精確度。第一項 \(\tau_{11}/N\) 則是一道無法再壓低的下限 (floor),由斜率上真實存在的個體差異所設定,而個體內測量做得再多都無法把它壓低:只有增加人數才能。這正是為什麼一項研究可以在平均斜率上檢定力極為充裕,卻在斜率的變異數上很弱。
式 (4.2) 值得看成一張圖。圖 4.2把斜率估計值的抽樣變異數對人數作圖,並比較三種時點設計:四個時點集中在較窄的跨距、四個時點散布在較寬的跨距,以及八個時點。把時點拉寬或增加時點都能明顯把曲線壓低,這證實了「何時測量、測量幾次」可以和「招募多少人」一樣重要。但三條曲線都朝同一道下限下降,也就是 \(\tau_{11}/N\) 那一項,而只有招募更多人才能把它往下推。因此,一項需要估計「變化上的個體差異」而不只是「平均變化」的設計,無論測量密度多高,本質上都是一件大 \(N\) 的事。
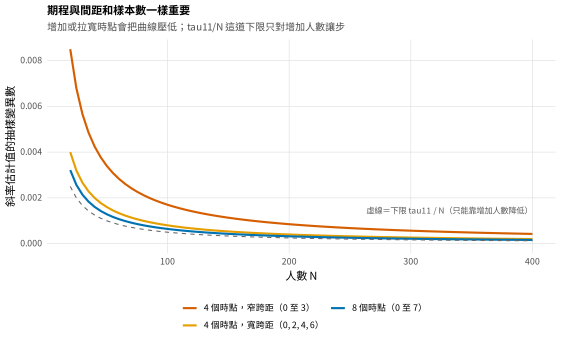
註:平均斜率的解析抽樣變異數(式 4.2)對人數作圖,比較三種時點設計。增加時點或把時點拉寬都會把曲線壓低;虛線是 \(\tau_{11}/N\) 這道下限,只能靠增加人數來降低。圖中參數為示意值(\(\tau_{11}=0.05\)、\(\sigma^2=0.6\))。
超出這些情形之後,公式就變得脆弱。廣義線性混合模型 (generalized linear mixed model)、參數眾多的潛在成長模型,以及帶有自我迴歸結構的密集縱貫模型,都很少能得到值得信賴的封閉解檢定力,因為目標參數的標準誤取決於整個模型,其方式沒有任何簡單公式能夠捕捉。對這些情形,誠實而通用的工具是模擬;而一旦把模擬學好,封閉解就從必需品變成可有可無的便利。
4.3 以模擬為基礎的檢定力分析流程
模擬式的檢定力分析是一項可以重複使用的單一技能:指定產生資料的歷程,從它產生大量的資料集,把分析模型配適到每一個資料集上,然後數一數目標效果被偵測到的次數比例。那個比例就是檢定力。這個流程有六個步驟,見圖 4.3;只要替換掉資料生成函式與分析方法,同一具骨架就能為任何模型服務。
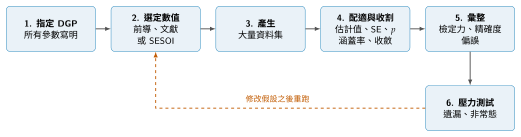
註:同一具骨架適用於任何模型:只有資料生成歷程 (data-generating process, DGP)(步驟 1)與分析方法(步驟 4)會改變。步驟 6 會回饋到步驟 2,因為一次檢定力分析是針對不確定假設所做的敏感度分析,不是一次計算。
下面這段程式碼就是完整的引擎,套用在一個每日日誌模型上:其中有一個個體內的預測變項,以及一個個人層次的調節變項 (moderator),兩者共同影響結果變項。這段程式刻意寫得精簡;配套的 power_sim_template_zh_V01.R 是同樣的邏輯加上註解,後續各章會反覆使用它。
library(lme4)

# 步驟 1:資料生成歷程,每一個參數都明白寫出
sim_diary <- function(N, D, g10 = 0.15, g01 = 0.20, g11 = 0.10,
                      tau00 = 0.25, tau11 = 0.03, sigma = sqrt(0.5)) {
  person <- rep(seq_len(N), each = D)
  w <- rep(rnorm(N), each = D); x <- rnorm(N * D)          # 調節變項、預測變項
  u0 <- rep(rnorm(N, 0, sqrt(tau00)), each = D)            # 隨機截距
  u1 <- rep(rnorm(N, 0, sqrt(tau11)), each = D)            # 隨機斜率
  y  <- u0 + (g10 + u1)*x + g01*w + g11*x*w + rnorm(N*D, 0, sigma)
  data.frame(person, x, w, y)
}

# 步驟 3 與 4:產生資料、配適模型、收割一次重複的結果
one_rep <- function(N, D) {
  d <- sim_diary(N, D)
  f <- lmer(y ~ x + w + x:w + (1 + x | person), data = d)
  b <- fixef(f); s <- sqrt(diag(vcov(f)))
  data.frame(p_within = 2*pnorm(-abs(b["x"]/s["x"])),      # 個體內效果
             converged = length(f@optinfo$conv$lme4$messages) == 0)
}

# 步驟 5:彙整多次重複的檢定力(步驟 2 就是上面選定的數值)
set.seed(2026)
reps <- do.call(rbind, replicate(500, one_rep(N = 40, D = 14),
                                 simplify = FALSE))
reps <- reps[reps$converged, ]                             # 收斂紀錄
mean(reps$p_within < 0.05) # 估計檢定力約 0.95這套流程有三個特徵,把值得信賴的檢定力分析與誤導性的檢定力分析區分開來。第一是收斂紀錄 (convergence bookkeeping)。混合模型在某些模擬資料集上會無法收斂,在小樣本時尤其如此;而默默把那些資料集丟掉會把回報的檢定力往上抬,因為這些失敗相對於效果並不是隨機發生的。誠實的做法是記錄每一次配適的收斂狀態、報告收斂率,並事先決定未收斂的配適要如何計入;把它們當成「未偵測到」是保守而站得住腳的做法。第二是種子管理 (seed management):在最上面設一個種子就能讓整份分析可重現,而若要平行執行,則必須使用平行安全的隨機數產生器(例如 L’Ecuyer 串流),這樣各個工作程序才不會共用或重複同一批隨機數。第三是:步驟 2 的那些參數值,正是檢定力分析生死存亡之處。
常見陷阱 • 檢定力分析出錯的三種方式
第一,觀察到的檢定力 (observed power),也就是事後檢定力 (post hoc power):拿一項已完成研究中實際觀察到的效果量 (effect size) 去算檢定力,是沒有訊息量的,因為觀察到的檢定力是 \(p\) 值的單調函數,並未在 \(p\) 值之外多說任何事;一個不顯著的結果,就其構造而言,觀察到的檢定力必然偏低。檢定力分析是一項設計活動,在蒐集資料之前完成。第二,只為固定的主效果準備檢定力:宣稱一項研究對平均斜率有 \(.90\) 的檢定力,而真正的科學主張其實關乎斜率的個體差異或某個跨層次交互作用,這是在替容易的估計標的宣傳檢定力,同時把困難的那一個藏起來(圖 4.1)。請為承載主張的那個估計標的準備檢定力。第三,忽略收斂失敗:只在收斂的那些資料集上彙整檢定力,卻不報告有多少沒收斂,會使估計值往上偏,並掩蓋一項「以其樣本而言野心過大」的設計。
那些參數值要從哪裡來?這是檢定力分析的「垃圾進、垃圾出」問題,它沒有完全令人滿意的解答,只有一些有紀律的選項,摘要於表 4.1。前導資料 (pilot data) 給得出現實的變異數成分,但樣本一小,效果的估計就既有雜訊又常被高估。已發表的文獻能提供效果量,卻被發表偏誤 (publication bias) 扭曲,於是照著已發表的效果去規劃,就是照著一個被膨脹的目標去規劃,結果得到一項檢定力不足的研究。最站得住腳的錨點往往是最小關切效果量 (smallest effect size of interest, SESOI),也就是「低於此值這項發現在實質上就不重要」的那個效果,因為為它準備檢定力,就保證這項研究能偵測到任何值得偵測的東西 (Lakens, 2022)。無論來源是什麼,面對輸入值不確定的補救辦法都是:在一段合理的參數範圍上報告檢定力,給出一條敏感度曲線 (sensitivity curve) 而不是單一個數字,讓讀者看見結論如何取決於假設。
表 4.1 檢定力分析的參數從何而來。
| 來源 | 它提供什麼 | 要注意什麼 |
|---|---|---|
| 前導資料 | 現實的變異數成分與相關 | 小型前導研究給出的效果量既有雜訊又偏高 |
| 已發表文獻 | 貌似合理的效果量 | 發表偏誤會膨脹效果(贏家的詛咒 winner’s curse) |
| 最小關切效果量(SESOI) | 一個有原則的下界,用來作為準備檢定力的對象 | 需要一個明確的實質判斷 |
| 敏感度分析 | 一段合理數值範圍上的檢定力 | 要報告整條曲線,不是某個方便的單一數字 |
註:把來源合併使用相當常見:變異數成分取自前導研究、效果取在 SESOI,再對最不確定的輸入做一次敏感度掃描。
4.4 標準情形的工具捷徑
從零寫出模擬是通用的技能,但對標準模型而言,既有的工具可以省掉那些樣板程式。表 4.2把常見的模型家族對應到工具。對 lme4 模型,simr 把整套流程包起來:它從一個已配適或已指定的模型模擬資料,並回報檢定力以及隨樣本數變化的檢定力曲線 (Green & MacLeod, 2016)。對兩層次與三層次的試驗設計,powerlmm 曾提供便利的封閉解與模擬檢定力,不過撰稿時應確認該套件的維護狀態,若已無法取得則以等效的自寫程式替代。對潛在成長模型與結構方程模型,lavaan 的資料模擬功能搭配一個配適迴圈,實作的就是同一套蒙地卡羅邏輯;而 Mplus 的 MONTECARLO 程序則是這個領域在潛在變項檢定力上長年的主力 (Muthén & Curran, 1997; Muthén & Muthén, 2002)。對帶有自我迴歸結構的密集縱貫設計,Lafit et al. (2021) 的 Shiny 應用程式能為「尊重時間依賴性」的多層次模型做檢定力分析,而現成工具通常忽略這種依賴性。無論用哪一種工具,同樣的三項紀律都成立:指名估計標的、誠實交代參數來源、報告敏感度。
表 4.2 縱貫檢定力分析的工具。
| 工具 | 模型家族 | 長處 | 限制 |
|---|---|---|---|
| simr | lme4 的 LMM/GLMM | 包好了「模擬、配適、計數」;可畫檢定力曲線 | 格點大時很慢;只支援 lme4 |
| powerlmm | 兩至三層次的試驗 | 對標準試驗設計很快 | 需確認 CRAN 狀態;模型類別有限 |
| lavaan 蒙地卡羅 | 潛在成長模型/SEM | 彈性高;迴圈由你掌控 | 需要自寫程式 |
Mplus MONTECARLO | 潛在成長/成長混合/DSEM | 潛在變項檢定力的領域標準 | 授權軟體 |
| Lafit 等人的 Shiny 程式 | 多層次自我迴歸(密集縱貫) | 尊重時間依賴性 | 模型選單固定 |
| 自寫模擬 | 任何模型 | 完全掌控;這是通用技能 | 必須自己寫、自己驗證 |
註:套件的可取得性會變動,撰稿時請再確認。自寫模擬永遠是備案,也正是其他工具所自動化的那項技能。
4.5 三個實作的檢定力分析
第 2 章那三個設計小案例在此以檢定力分析的形式回來,每一個都產出一張圖與一段可直接寫進計畫書的文字。
4.5.1 每日日誌研究:主效果便宜,交互作用昂貴
那項壓力與睡眠的日誌研究問兩個問題:每日壓力是否在個體內預測當晚的睡眠,以及這個個體內的耦合是否被某個個人層次的特質所調節。前者是個體內的主效果,後者是跨層次交互作用。圖 4.4顯示個體內效果在「人數 \(\times\) 天數」格點上的檢定力:它很便宜:即使每人只測一週,八十人也已超過 \(.80\);測滿兩週則三十人上下就達到,而且此後很快就飽和,因為個體內效果取用的是每個人所貢獻的許多時點。圖 4.5把那個主效果與跨層次交互作用放在同一條軸上對照。交互作用很昂貴:在十四天的條件下,它要到七十人附近才達到 \(.80\) 檢定力,大約是主效果所需樣本的兩倍,因為跨層次交互作用本質上是在個體間層次被估計的,而在那個層次上,訊息的單位是人,不是時點。這是日誌與經驗取樣研究最重要的一項規劃教訓,而它經常被忽略:增加天數對跨層次交互作用幫助很小,增加人數才是決定性的。
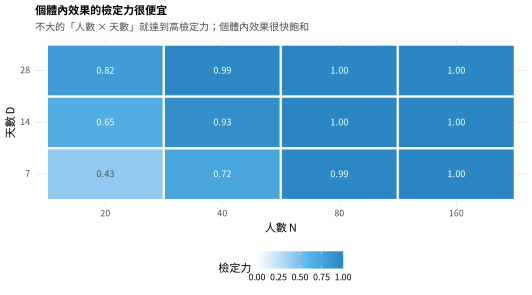
註:每日預測變項的個體內效果之模擬檢定力(每格 \(300\) 次重複),作為人數與天數的函數。個體內效果在不大的樣本下就達到高檢定力,並且很快飽和。
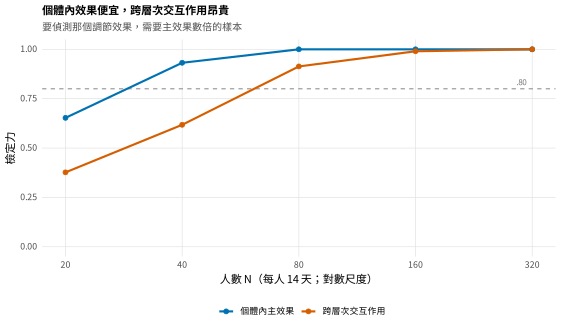
註:每人十四天下的模擬檢定力。個體內主效果(藍色)在三十人附近達到 \(.80\);跨層次交互作用(橘紅色)需要大約兩倍的人數,而且增加天數並不會把這個差距補起來。
這項研究可直接寫進計畫書的一段文字是:「本研究的主要假設關乎每日壓力與特質反芻思考在預測睡眠上的跨層次交互作用。假定個體內壓力對睡眠的斜率為 \(0.15\)、調節效果為 \(0.10\)、隨機斜率變異數為 \(0.03\)、殘差變異數為 \(0.50\)(取自前導資料與最小關切效果量),每個條件 \(300\) 次重複的蒙地卡羅檢定力分析顯示:\(120\) 位參與者完成十四天的日誌,在 \(\alpha = .05\) 之下偵測該交互作用的檢定力至少為 \(.90\)。對調節效果由 \(0.07\) 到 \(0.13\) 所做的敏感度分析,檢定力介於 \(.72\) 與 \(.98\);上述各條件的收斂率均超過 \(99\%\)。」
4.5.2 加速成長研究:偵測變化上的個體差異
那項加速世代的學業成就研究(school_growth 設計)問的不只是兒童是否成長,而是他們成長的速度是否有差異,也就是隨機斜率的變異數是否不為零。正如式 (4.2) 早已預告的,這是一個大 \(N\) 的問題。圖 4.6顯示斜率變異數的檢定力:從五十位兒童時的約 \(.45\),上升到四百位時的幾乎等於一,並在一百五十位附近跨過 \(.80\)。一項只按「估計平均成長軌跡」來定樣本數的研究,需要的兒童遠少於此,卻會在「個體差異」這個經常真正驅動發展研究的問題上嚴重檢定力不足 (Hertzog et al., 2006)。指名這兩個問題中哪一個是主要問題,是規劃這類研究的第一個動作。
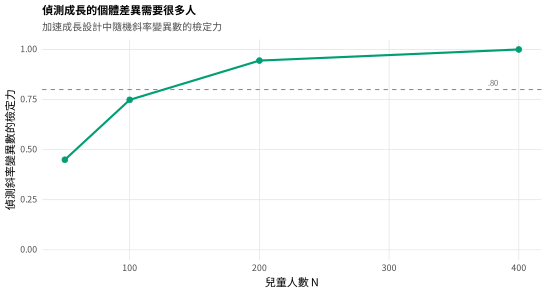
註:四波成長模型中隨機斜率變異數之概似比檢定 (likelihood-ratio test) 的模擬檢定力(每點 \(200\) 次重複),作為兒童人數的函數。偵測變化上的變異數需要很多人,與式 (4.2) 一致。
4.5.3 臨床試驗:在現實的退出率下規劃檢定力
那項兩組的憂鬱症試驗(therapy_rct 設計)檢定的是處理與時間的交互作用:實驗組的症狀軌跡是否比控制組下降得更快。試驗會流失參與者,而規劃者必須問:退出對檢定力做了什麼?圖 4.7顯示該交互作用的檢定力如何隨樣本數變化,並比較零、百分之十五與百分之三十的隨機遺漏退出。值得注意的結果是:損失是溫和的。在八十位病人時,檢定力從無退出下的約 \(.68\) 降到百分之三十退出下的約 \(.55\),是真實但不大的減損。理由很重要,而且預告了第 6 章。由於混合模型是以概似來估計軌跡,會使用每一位病人確實提供過的每一筆觀察,隨機遺漏的退出會耗掉訊息,因而耗掉檢定力,但不會使估計值產生偏誤。天真的替代做法是只分析完成者 (completer),那既會損失更多檢定力,也會因為完成者與退出者有系統性的不同而引入偏誤。因此為退出預作規劃的意思是:適度增加樣本以抵銷精確度的損失,而不是把退出當成災難;前提是遺漏可合理假定為隨機遺漏 (MAR),而分析是以概似為基礎的。
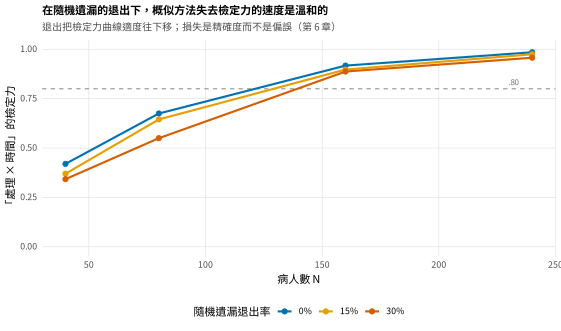
註:十二週試驗中處理 \(\times\) 時間交互作用的模擬檢定力(每點 \(400\) 次重複),比較三種單調的隨機遺漏退出水準。退出把曲線適度往下移;代價是精確度而不是偏誤,因為概似會用上所有可得的資料(第 6 章)。
4.6 在限制條件下設計
檢定力分析與現實相遇的形式是一份預算。人數、時點數與每個時點的密度各自都要花錢,也要花掉參與者的善意,而它們替不同的估計標的買檢定力,如表 4.3所摘要。核心的取捨在於人數與時點數之間。在觀察總數固定的條件下,怎麼分配並不是中性的:個體間的估計標的與跨層次交互作用是用人數買來的,而個體內效果、成長形狀與動態是用時點數買來的。一百個人各測十次的研究,與十個人各測一百次的研究,含有同樣的一千筆觀察,卻回答幾乎不相交的問題;這就是為什麼「重要的是 \(N \times T\) 的總數」這種坊間說法是錯的。設計必須與估計標的相匹配,而預算要花在估計標的的訊息所在之處。
表 4.3 哪一個設計因素替哪一個估計標的買檢定力。
| 增加…… | 主要買到的是 | 幫助很小的是 |
|---|---|---|
| 人數(\(N\)) | 個體間效果、跨層次交互作用、所有變異數成分 | (對所有量都提高精確度) |
| 時點數(\(T\)) | 個體內效果、成長形狀、動態 | 個體間的平均數差異 |
| 期程/間距 | 成長斜率的精確度、斜率變異數 | 快速的動態(有疊頻風險) |
| 每個時點的題目數 | 透過提高信度(減少衰減)而利於所有效果 | 直接的設計層次檢定力 |
註:本表把式 (4.2) 及其類比落實為操作原則:把預算對準估計標的的訊息所在之處。
精確度規劃為同一份預算提供第二種觀看方式。圖 4.8顯示個體內效果的信賴區間預期寬度如何隨人數變化:要把這個效果釘到 \(0.10\) 的寬度,大約需要一百人;不論那個樣本數能不能跨過某個檢定力門檻,答案都是這個數。當審稿人對一個「任何可行樣本都達不到」的變異數成分堅持要求 \(.80\) 檢定力時,精確度這個框架提供了一個誠實的回應:報告這項研究將達到的區間寬度,並主張一個估計良好的界限比一個檢定力不足的檢定更有訊息量。另外還有兩項工具能把固定的預算拉長。計畫性遺漏 (planned missingness) 設計刻意讓每位參與者只被分派到題目或時點的一個子集,能在降低負擔的同時保住主要估計標的的檢定力(第 6 章)。而循序設計 (sequential design,指依期中結果調整規模,與第 2 章的世代序列設計無關) 或內部前導設計 (internal-pilot design) 允許在研究進行到一半時重新估計變異數成分,以累積中的資料精修樣本數的決定。表 4.4把報告要點提煉成一份範本。
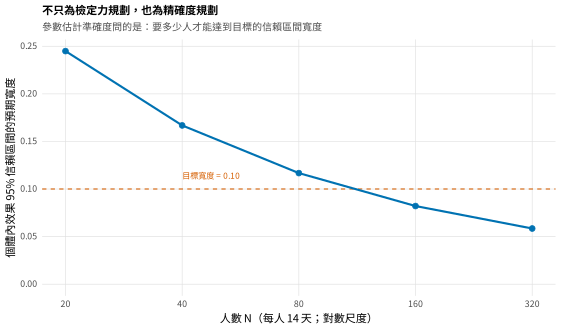
註:每人十四天下,個體內效果 \(95\%\) 信賴區間的模擬預期寬度。參數估計準確度所問的問題是「要多少樣本才能達到目標寬度」(此處為 \(0.10\),約在一百人附近),與圖 4.4的檢定力問題互補。
表 4.4 一份站得住腳的樣本數說明所包含的要素。
| 要素 | 要陳述什麼 |
|---|---|
| 估計標的 | 目標的量,用文字寫出來,以及它為何承載這項主張 |
| 分析模型 | 將要配適的模型,讓讀者能判斷該估計標的的標準誤 |
| 參數與其來源 | 所假定的數值,以及每一個是從哪裡來的(前導資料、文獻、SESOI) |
| 檢定力或精確度 | 在計畫的 \(N\) 之下的檢定力,或信賴區間寬度,並附方法與重複次數 |
| 敏感度 | 在最不確定的輸入的合理範圍上,檢定力或精確度各為多少 |
| 應變規劃 | 所假定的退出率與配合度,以及樣本如何被放大以抵銷它們 |
註:這些要素讓一次檢定力分析可被稽核,而預先註冊 (preregistration) 與計畫申請書也越來越期待它們(第 36 章)。
實務要點 • 大型檢定力格點的執行時間與檢查點存檔
在一整片條件格點上做檢定力分析,可能需要數萬次模型配適,而執行時間很容易被低估。啟動之前,先量一次配適要多久,乘上重複次數與格點數,再除以核心數;跑一整晚的格點是正常的,跑一整週的則需要重新想。以平行安全的隨機數產生器在重複次數上做平行化,結果才仍然可重現。對長時間的執行,請逐個條件把結果存到磁碟(檢查點存檔 checkpointing),這樣被中斷的執行是續跑而不是重跑,也讓部分結果可以先被檢視。開發階段先用很少的重複次數把流程除錯,等到流程正確之後再把次數拉高;二十五次重複的檢定力估計值作為最終答案毫無用處,但用來確認程式跑得動則再好不過。
軟體提示 • 潛在成長模型的 Mplus 蒙地卡羅
對潛在成長模型與混合模型,Mplus 的 MONTECARLO 功能仍是領域標準。它的邏輯與第 4.3 節的 R 流程相互對應:一個 MODEL POPULATION 區塊指定資料生成的參數,一個 MODEL 區塊指定分析模型,Mplus 則反覆產生資料並配適,回傳每一個參數顯著的重複次數比例(檢定力),連同參數偏誤、標準誤的準確度,以及涵蓋率 (coverage)。這個做法由 Muthén and Muthén (2002) 定型,當分析模型本身就是一個結構方程模型,而在 R 裡手寫生成與配適較為費工時,它是自然的選擇。報告的紀律則完全相同:指名估計標的、為母體值提出理由、呈現敏感度。
4.7 常見的迷思
有四種看法會誤導規劃者。第一,認為重要的是觀察總數 \(N \times T\):訊息是層次專屬的,所以十個人各測一百次無法回答一百個人各測十次所能回答的個體間問題,儘管兩者的總數相同。第二,認為流失只會降低檢定力:在隨機遺漏的退出加上以概似為基礎的分析之下,代價確實主要是檢定力(圖 4.7),但在非隨機遺漏的退出之下它也會使估計值產生偏誤,而那是任何樣本數都無法修補的(第 6 章)。第三,認為一次檢定力分析就是一個數字:它是一條曲線或一個曲面,橫跨各個設計因素,再加上產生它的那些假設;只報告一個孤零零的數字會把兩者都藏起來。第四,是那個實務上的兩難:「審稿人對每一件事都要求 \(.80\) 檢定力,但我的斜率變異數檢定力只有 \(.40\)」:答案不是把假設膨脹到數字看起來可接受為止,而是誠實陳述哪些估計標的檢定力充裕、哪些是為精確度而估計,並以這樣的語言為設計提出理由 (Lakens, 2022)。
本章摘要
縱貫模型的檢定力是估計標的專屬的:同一項研究對某些量檢定力充裕,對另一些量則無能為力(圖 4.1),因此規劃要從指名「承載科學主張的那個估計標的」開始。封閉解只在簡單設計中存活,但它們留下一個耐久的洞見:斜率估計量的變異數(式 4.2)分成兩項,一項可以靠時點數與間距降低,另一項是 \(\tau_{11}/N\) 這道下限,只能靠人數降低。對現實的模型,通用工具是六步驟的模擬流程,而它的正當性建立在收斂紀錄、可重現的種子,以及以最小關切效果量為錨的誠實參數來源之上。三個實作分析帶出幾個反覆出現的教訓:個體內效果便宜,跨層次交互作用昂貴;偵測變化上的個體差異是一件大 \(N\) 的事;隨機遺漏的退出耗掉的是精確度而不是造成偏誤。規劃最終是一個預算問題,解法是把人數、時點數與密度對準估計標的的訊息所在之處,並以「估計標的先行、關注精確度」的語言報告出來。
接下來讀哪裡
本章各項模擬所用的壓力測試,用到第 6 章所形式化的遺漏機制;本章當成黑盒子處理的那些模型,則在第 13、14 章(多層次成長)、第 19 章(潛在成長)與第 23 章(密集縱貫)中發展。貝氏規劃把單一個檢定力數字換成「在先驗不確定性上平均後的保證度 (assurance)」,見第 17 章。檢定力分析本身就是一個可以預先註冊的對象,第 36 章處理它的預先註冊。這裡引入的可重複使用的 power_sim_template_zh_V01.R 會在後續各章的習題中反覆出現,屆時只需替換各個新模型的資料生成歷程。
習題
- 4.1 加入未作答。把第 4.3 節的日誌檢定力模擬加以延伸,在配適之前完全隨機刪除 \(20\%\) 的「人 \(\times\) 時點」。報告個體內效果的檢定力變化,並以「訊息的損失」來解釋它。
- 4.2 使用 simr。取一份小型的前導資料(例如
sleepstudy),配適一個隨機斜率模型,並用 simr 計算固定斜率隨樣本數變化的檢定力曲線。把結果與從零寫出的模擬相比較。 - 4.3 精確度(AIPE)。使用日誌的資料生成歷程,以模擬找出「要多少人,才能讓標準化個體內效果的 \(95\%\) 信賴區間寬度不超過 \(0.10\)」。把這個 \(N\) 與產生 \(.80\) 檢定力的 \(N\) 相對照。
- 4.4 評論一段檢定力陳述。給定一段已發表的樣本數說明,指出它為哪一個估計標的準備了檢定力、陳述了哪些假設,以及一位持懷疑態度的審稿人還會想知道什麼。
- 4.5 寫出說明。依表 4.4,為第 4.5 節的加速成長研究撰寫樣本數段落,為斜率變異數這個估計標的準備檢定力,並納入一項敏感度分析。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 檢定力 | power | 效果為真時能偵測到它的機率;全書 |
| 估計標的 | estimand | 研究真正要估計的那個量;全書 |
| 精確度 | precision | 估計值的區間寬度;第 4.1 節 |
| 參數估計準確度 | accuracy in parameter estimation (AIPE) | 以達到目標區間寬度為目標的規劃;第 4.1 節 |
| 信賴區間 | confidence interval | 反覆抽樣下涵蓋參數的區間;第 4.1 節 |
| 封閉解 | closed form | 可用公式直接算出的解;第 4.2 節 |
| 非中心性參數 | noncentrality parameter | 對立假設下檢定統計量的中心位置;第 4.2 節 |
| 非中心分配 | noncentral distribution | 非中心性不為零的抽樣分配;第 4.2 節 |
| 球形 | sphericity | 重複量數變異數分析對共變異數結構的假設;第 4.2 節 |
| 成對樣本 \(t\) 檢定 | paired \(t\) test | 兩個相依測量之差的檢定;第 4.2 節 |
| 對比 | contrast | 各時點平均數的線性組合;第 4.2 節 |
| 隨機截距 | random intercept | 個體特定的起始水準;第 4.1 節 |
| 隨機斜率 | random slope | 個體特定的變化率;第 4.1 節 |
| 跨層次交互作用 | cross-level interaction | 個體間變項調節個體內效果;第 4.1 節 |
| 廣義線性混合模型 | generalized linear mixed model | 非常態結果變項的混合模型;第 4.2 節 |
| 資料生成歷程 | data-generating process (DGP) | 模擬中產生資料的機制;第 4.3 節 |
| 蒙地卡羅 | Monte Carlo | 以反覆隨機抽樣求近似的方法;第 4.3 節 |
| 收斂紀錄 | convergence bookkeeping | 記錄並報告每次配適是否收斂;第 4.3 節 |
| 種子管理 | seed management | 設定隨機種子以確保可重現;第 4.3 節 |
| 觀察到的檢定力 | observed (post hoc) power | 由已觀察效果量回推的檢定力;無訊息量;第 4.3 節 |
| 前導資料 | pilot data | 小規模先行蒐集的資料;第 4.3 節 |
| 發表偏誤 | publication bias | 顯著結果較易被發表所造成的膨脹;第 4.3 節 |
| 贏家的詛咒 | winner’s curse | 被選中發表的效果量系統性偏大;第 4.3 節 |
| 最小關切效果量 | smallest effect size of interest (SESOI) | 低於此值即不具實質意義的效果;第 4.3 節 |
| 敏感度分析 | sensitivity analysis | 在一段假設範圍上重算結論;第 4.3 節 |
| 敏感度曲線 | sensitivity curve | 檢定力隨假設值變化的曲線;第 4.3 節 |
| 檢定力曲線/曲面 | power curve / surface | 檢定力隨設計因素變化的圖形;第 4.4 節 |
| 概似比檢定 | likelihood-ratio test | 比較嵌入模型的檢定;第 4.5 節 |
| 涵蓋率 | coverage | 區間實際包含真值的比例;第 4.3 節 |
| 退出 | dropout | 參與者中途離開研究;第 4.5 節 |
| 完成者 | completer | 完成全部評量的參與者;第 4.5 節 |
| 計畫性遺漏 | planned missingness | 刻意只施測部分題目或時點;第 4.6 節 |
| 循序設計 | sequential design | 允許依期中結果調整規模的設計;第 4.6 節 |
| 內部前導設計 | internal-pilot design | 以研究前段資料重估變異數成分;第 4.6 節 |
| 檢查點存檔 | checkpointing | 逐條件存檔,使中斷後可續跑;第 4.6 節 |
| 保證度 | assurance | 在先驗不確定性上平均後的檢定力;「接下來讀哪裡」 |
| 預先註冊 | preregistration | 資料蒐集前公開登錄分析計畫;第 4.6 節 |
參考文獻
Arend, M. G., & Schäfer, T. (2019). Statistical power in two-level models: A tutorial based on Monte Carlo simulation. Psychological Methods, 24(1), 1–19. https://doi.org/10.1037/met0000195
Bolger, N., Stadler, G., & Laurenceau, J.-P. (2012). Power analysis for intensive longitudinal studies. In M. R. Mehl & T. S. Conner (Eds.), Handbook of research methods for studying daily life (pp. 285–301). Guilford Press.
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Green, P., & MacLeod, C. J. (2016). SIMR: An R package for power analysis of generalized linear mixed models by simulation. Methods in Ecology and Evolution, 7(4), 493–498. https://doi.org/10.1111/2041-210X.12504
Hertzog, C., Lindenberger, U., Ghisletta, P., & von Oertzen, T. (2006). On the power of multivariate latent growth curve models to detect correlated change. Psychological Methods, 11(3), 244–252. https://doi.org/10.1037/1082-989X.11.3.244
Lafit, G., Adolf, J. K., Dejonckheere, E., Myin-Germeys, I., Viechtbauer, W., & Ceulemans, E. (2021). Selection of the number of participants in intensive longitudinal studies: A user-friendly Shiny app and tutorial for performing power analysis in multilevel regression models that account for temporal dependencies. Advances in Methods and Practices in Psychological Science, 4(1). https://doi.org/10.1177/2515245920978738
Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), 33267. https://doi.org/10.1525/collabra.33267
Maxwell, S. E., Kelley, K., & Rausch, J. R. (2008). Sample size planning for statistical power and accuracy in parameter estimation. Annual Review of Psychology, 59, 537–563. https://doi.org/10.1146/annurev.psych.59.103006.093735
Muthén, B. O., & Curran, P. J. (1997). General longitudinal modeling of individual differences in experimental designs: A latent variable framework for analysis and power estimation. Psychological Methods, 2(4), 371–402. https://doi.org/10.1037/1082-989X.2.4.371
Muthén, L. K., & Muthén, B. O. (2002). How to use a Monte Carlo study to decide on sample size and determine power. Structural Equation Modeling, 9(4), 599–620. https://doi.org/10.1207/S15328007SEM0904_8
Raudenbush, S. W., & Liu, X. (2000). Statistical power and optimal design for multisite randomized trials. Psychological Methods, 5(2), 199–213. https://doi.org/10.1037/1082-989X.5.2.199
Raudenbush, S. W., & Liu, X.-F. (2001). Effects of study duration, frequency of observation, and sample size on power in studies of group differences in polynomial change. Psychological Methods, 6(4), 387–401. https://doi.org/10.1037/1082-989X.6.4.387
Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel analysis: An introduction to basic and advanced multilevel modeling (2nd ed.). Sage.