第 6 章
縱貫研究中的遺漏資料與流失
縱貫資料在結構上就是遺漏資料的問題。參與者會跳過某一波、錯過某次提示、中途離開研究,也會答了一些題卻不答另一些題,於是方法所假定的那個長方形資料矩陣,幾乎從來不是研究實際蒐集到的矩陣。本章刻意放在全書估計方法各部之前,因為遺漏的處理方式並不是真正的分析做完之後才補上的雜務,而是一個決定「真正的分析到底成不成立」的建模決定。本章的核心主張是:多數研究者被教會的那些老式修補,也就是刪掉不完整的個案、把最後一個值往後推補,並不是保守的預設值,而是偏誤的積極來源;而兩種現代做法,完全訊息最大概似法 (FIML) 與多重插補 (MI),既有原則,對本書所關心的多層次與密集資料而言也都在能力所及範圍之內。
學習目標
讀完本章之後,你應該能夠:(1) 把 Rubin 的三種機制,也就是完全隨機遺漏 (MCAR)、隨機遺漏 (MAR) 與非隨機遺漏 (MNAR),陳述為關於「資料與遺漏之聯合分配」的精確主張,並說明這套分類為什麼管的是「忽略遺漏是否成立」,而不是在描述遺漏的成因;(2) 診斷單調與間歇兩種型態,並執行一份有訊息量的流失分析,同時不把它過度吹捧成可忽略性的證明;(3) 以方向性的直覺說明整列刪除與末次觀察值向前推補為什麼會讓縱貫估計產生偏誤;(4) 以完全訊息最大概似法 (FIML) 配適模型,並明確說出被極大化的是哪一個概似;(5) 執行與資料結構相稱的多重插補 (MI),包括巢套與密集資料所需的多層次插補;(6) 在有原則的基礎上於完全訊息最大概似法與多重插補之間做選擇;(7) 執行並報告至少兩種非隨機遺漏的敏感度分析,其中包括臨界點分析 (tipping-point analysis);(8) 以計畫性遺漏設計 (planned missingness design),用設計本身來降低受訪者負擔。
6.1 縱貫遺漏的剖析
重複測量中的遺漏不是一個現象,而是好幾個;而替型態命名是第一步,因為不同的型態容許不同的補救。單位未回應 (unit nonresponse) 是整個人的流失:被抽樣到卻從未被測量,或在第一波之前就退出。波次未回應 (wave nonresponse) 是某些人整個時點的流失,例如錯過了一次追蹤評量,但後來又回來了。單調退出 (monotone dropout),也就是流失 (attrition),是「一旦缺席,其後每一個時點都缺席」的型態;它是追蹤研究與臨床試驗中的主流型態,而它的單調結構同時讓插補與建模都變得比較單純。間歇性遺漏 (intermittent missingness) 是非單調的型態,人們時進時出,在某些時點在、在另一些時點不在,這是經驗取樣與日誌設計的特徵。題目遺漏 (item missingness) 是在一次已完成的評量之內,特定題目的流失;而密集縱貫設計中的提示層次遺漏 (prompt-level missingness),則是對一次預定的提示完全沒有作答。圖 6.1 把其中六種原型畫成「個體乘時點」的矩陣;任何關於遺漏的數值摘要之前,都應該先看這種圖,因為它會顯露出單一個完成率所掩蓋掉的結構。
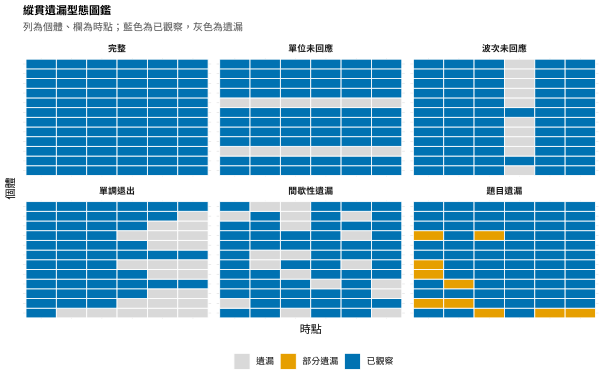
註:列是個體,欄是時點;藍色格是已觀察,灰色格是遺漏,部分著色代表一次已完成的評量之內的題目層次流失。單調退出,也就是缺席具有吸收性的那種,是追蹤研究與試驗流失的典型型態;間歇性遺漏則是密集設計的典型。型態決定了哪些插補與估計策略用得上。
不過真正有後果的區分不是型態,而是機制 (mechanism),也就是「某個值遺漏的機率」與「資料的值」之間的機率關係,而且是包含看得見與看不見的值在內。Rubin (1976) 的分類把這層關係形式化。令 \(Y\) 為完整資料,切分為已觀察部分 \(Y_{\mathrm{obs}}\) 與遺漏部分 \(Y_{\mathrm{mis}}\),並令 \(M\) 為記錄哪些格位存在的遺漏指標矩陣。機制就是由參數 \(\phi\) 所支配的條件分配 \(P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, \phi)\)。當遺漏與資料完全獨立,\(P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, \phi) = P(M \mid \phi)\),資料就是完全隨機遺漏 (missing completely at random, MCAR),此時已觀察到的個案是完整個案的一個簡單隨機子樣本。當遺漏可以依賴已觀察值,但在給定它們之後不再依賴遺漏值,\(P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, \phi) = P(M \mid Y_{\mathrm{obs}}, \phi)\),資料就是隨機遺漏 (missing at random, MAR)。當即使在所有已觀察量都被條件化之後,遺漏的機率仍然依賴那些看不見的值本身,資料就是非隨機遺漏 (missing not at random, MNAR)。圖 6.2 把三種機制畫成相依圖,表 6.1 則列出各自的定義,以及在該機制下什麼仍然成立。
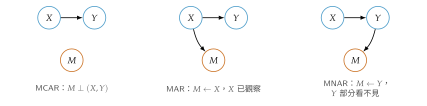
註:\(X\) 是完全被觀察到的共變項,\(Y\) 是部分被觀察到的結果變項,\(M\) 是 \(Y\) 的遺漏指標。在 MCAR 下,沒有任何箭頭從資料指向 \(M\)。在 MAR 下,指向 \(M\) 的箭頭只從已觀察的訊息(\(X\),以及 \(Y\) 已觀察到的值)出發。在 MNAR 下,指向 \(M\) 的箭頭來自 \(Y\) 本身,而 \(Y\) 中相關的那些值有一部分看不見,這正是這個假設無法用手上的資料檢驗的原因。
關於這套分類,有三件事經常被誤解,值得明白說清楚。第一,這些標籤描述的是「忽略遺漏歷程」是否成立,而不是日常意義下遺漏的成因;MAR 並不表示遺漏是雜亂無章或無害的,只表示它的依賴關係走的是那些「已經被記錄下來」的量。第二,用已觀察資料無法檢驗 MAR 與 MNAR 孰是孰非,因為兩種機制對 \(Y_{\mathrm{obs}}\) 做出完全相同的預測,兩者只在對 \(Y_{\mathrm{mis}}\) 的依賴上有別,而 \(Y_{\mathrm{mis}}\) 依定義就是拿不到的;任何「這筆資料是 MAR」的說法都是一個假設,可辯護與否是另一回事,但它永遠不是一項發現。第三,只有 MCAR 部分可檢驗,Little 檢定(Little (1988))提供了一個綜合性的檢查,做法是比較各遺漏型態之間已觀察變項的平均數;但它不顯著只是很弱的證據,會受到檢定力與特定對立假設的左右,而且絕不可以被讀成「因此可以採用分析真正倚賴的那個強得多的 MAR 假設」。對學生而言,實務上的重新框架是把「哪一個標籤符合我的資料」這個問題,換成「為了讓我選的方法成立,我必須願意相信什麼」,因為後者是回答得了的,而且當那份相信本身不確定時,它會直接把人帶向敏感度分析。
表 6.1 Rubin 的遺漏機制及其後果。
| 機制 | 定義 | 可檢驗嗎? | 在該機制下仍然成立的方法 |
|---|---|---|---|
| MCAR | \(P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}) = P(M)\);遺漏與所有資料獨立 | 部分可以(Little 檢定) | 整列刪除(不偏,但沒有效率);FIML;MI |
| MAR | \(P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}) = P(M \mid Y_{\mathrm{obs}})\);只依賴已觀察資料 | 否(相對於 MNAR 不可檢驗) | FIML;MI(兩者皆一致);整列刪除一般有偏誤 |
| MNAR | 即使給定 \(Y_{\mathrm{obs}}\),仍依賴 \(Y_{\mathrm{mis}}\) | 否 | 不把 \(M\) 建模就沒有方法成立;必須做敏感度分析 |
註:在 MAR 之下,只要驅動遺漏的那些變項被放進模型裡,「不對遺漏歷程建模」的概似估計仍然成立,這個性質 Rubin 稱為可忽略性 (ignorability)。此處的「成立」指的是對目標參數具一致性;各方法的效率仍然有別。
6.2 那些不好的方法做了什麼
被教給整整一代研究者的預設修補有兩種:整列刪除 (listwise deletion),把任何記錄不完整的人整個丟掉;以及末次觀察值向前推補 (last-observation-carried-forward, LOCF),用這個人最近一次觀察到的值去填補遺漏值。兩者都被廣泛認為是保守的。而兩者在縱貫的情境下都會積極地誤導人;正因為那個信念如此根深柢固,這個論證值得精確地做一遍。
整列刪除只有在 MCAR 下才不偏,而且即使在那時也很浪費,因為在一項有好幾個時點的研究中,一個人「每一個時點都完整」的機率可能很小,於是一個蒐集了好幾百個「人乘時點」的設計,被縮減成從未缺席的那一小群人。在 MAR 之下,刪除就不只是沒有效率,而是有偏誤,因為完成者是一個被選擇過的子樣本;而在縱貫的健康與臨床研究中,這個選擇很少是無害的:完成者系統性地是比較健康的、比較配合的、比較有改善的那些人,於是用完成者配適出來的成長曲線描述的是「留下來的人」的軌跡,而不是當初被收案的那個母體。有一個細節讓完全個案分析 (complete-case analysis) 在特定的迴歸情境中仍然活著:當遺漏只依賴那些本身被完全觀察到、而且已被放進模型當預測變項的共變項時,完全個案的迴歸係數可以維持不偏;但這個例外講的是條件模型中「由共變項驅動的遺漏」,不是主宰縱貫研究的「由結果變項驅動的流失」,不應該被推廣成替這個方法辯護的理由。
LOCF 更糟,因為它不只是選出一個子樣本,而是捏造資料,而且捏造是有方向的。在一項典型軌跡是改善的研究中,例如本章的心理治療試驗,把最後一個觀察值往後推補,等於把每一位退出者凍結在他退出前的嚴重度上,也就是在毫無證據的情況下主張:改善在離開的那一刻就停止了。如果退出集中在沒有反應的人身上,LOCF 會保住他們偏高的症狀分數,把實驗組的平均數往上拉,於是使估計到的效益衰減;如果退出集中在「因為好了所以離開」的反應者身上,LOCF 則會低報他們持續中的進步。無論哪一種,這個方法都是用一個「已知會系統性錯誤」的值去取代遺漏值,而它保守的名聲,只是「碰巧在某些特定試驗中偏向虛無」的巧合。平均數插補 (mean imputation),也就是用樣本平均數或該波平均數去填補空缺,同樣有捏造的問題,還多了第二個缺陷:它會讓變異數與每一個共變數都衰減,因為插補進去的值毫無離散度,全部剛好落在平均數上;用單一個迴歸預測值來插補雖然改善了這一點,卻仍然把插補值當成已觀察值看待,因而注入了虛假的確定性。
圖 6.3 是本章的招牌演示,也是值得投資在替代方法上的理由。它報告的是估計到的「處理 \(\times\) 時間」交互作用,也就是兩組之間症狀斜率的差;資料來自一項已知真值的模擬,其中真實效果是每週 \(-0.40\) 個症狀分,而單調退出分別在三種機制之下被加上去;完整的模擬就是隨書附的腳本 ch06_missing_sims_V01.R。這個教訓很鮮明,而且有三層。在 MCAR 之下,也就是刪除本來應該安全的情況,整列刪除確實還原了真值(\(-0.39\)),但精確度的代價很大;而 LOCF(\(-0.32\))與平均數插補(\(-0.25\))此時就已經偏向零,因為它們捏造出來的值扭曲了模型正在估計的那些斜率。在 MAR 之下,天真的方法進一步惡化,而有原則的方法則守得住。在 MNAR 這個最難的情況下,平均數插補整個崩潰(\(-0.07\)),整列刪除與 LOCF 都嚴重偏誤,而即使在這裡,完全訊息最大概似法仍然幾乎精確地還原了真值(\(-0.40\)),多重插補也緊追在後(\(-0.35\)),因為退出前的軌跡帶有關於斜率的大部分訊息,而這兩種方法都完整地用上了它。這個 MNAR 的結果並不是在保證概似方法一般而言能修好 MNAR,它們並不能;它示範的是「丟棄或捏造資料會白白放棄有原則的方法所保留下來的訊息」,而它引出的是第 6.6 節的敏感度分析,不是取代它。
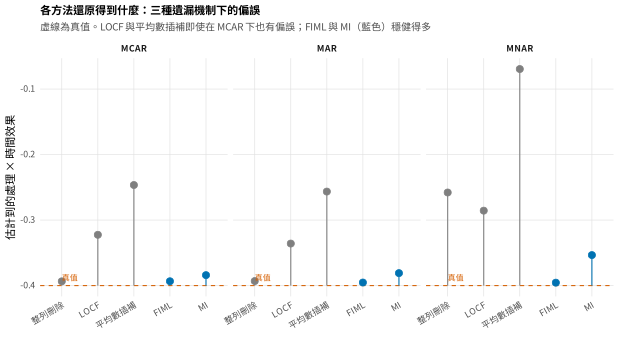
註:每一個點是 100 次重複之下估計到的「處理 \(\times\) 時間」交互作用的平均;虛線是真實效果(\(-0.40\))。灰色點是天真的方法(整列刪除、LOCF、平均數插補),藍色點是有原則的方法(FIML、MI)。LOCF 與平均數插補即使在「刪除名義上成立」的 MCAR 之下也偏向零。FIML 與 MI 在三種機制之下都貼近真值;MI 在 MNAR 下殘留的落差,以及第 6.6 節對它的處理,是「單靠資料能做到什麼」的誠實界限。
6.3 完全訊息最大概似法
第一種有原則的替代方案,把整個問題重新框架了一次。完全訊息最大概似法 (full-information maximum likelihood, FIML),也稱直接最大概似 (direct maximum likelihood),不去修補資料好讓完整資料的方法跑得動,而是改動估計式,使得不完整的記錄根本不需要修補。這個想法建立在概似的一個因式分解上。在可忽略的機制之下,「給定已觀察資料的參數概似」可以在完全不提遺漏模型的情況下寫出來,於是每一個人都是透過「他確實擁有的那些變項的密度」對概似做出貢獻,並在完整模型的參數上求值。一個在所有時點都被測量到的人貢獻完整的多變量密度;一個只在部分時點被測量到的人貢獻對應的邊際密度;沒有任何值被填補,也沒有任何個案被刪除,因為這個估計式就只是把每個人所提供的訊息加總起來。基礎概念方塊寫出這個因式分解,以及使它得以成立的可忽略性條件。
基礎概念 • 已觀察資料的概似與可忽略性
把資料與遺漏的聯合模型寫成 \(P(Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, M \mid \theta, \phi) = P(Y_{\mathrm{obs}}, Y_{\mathrm{mis}} \mid \theta)\, P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, \phi)\),其中 \(\theta\) 索引資料模型、\(\phi\) 索引遺漏模型。已觀察資料的概似對遺漏值積分,\(L(\theta, \phi \mid Y_{\mathrm{obs}}, M) \propto \int P(Y_{\mathrm{obs}}, Y_{\mathrm{mis}} \mid \theta)\, P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, \phi)\, dY_{\mathrm{mis}}\)。當機制是 MAR 時,\(P(M \mid Y_{\mathrm{obs}}, Y_{\mathrm{mis}}, \phi) = P(M \mid Y_{\mathrm{obs}}, \phi)\) 可以提到積分外面,剩下 \(L(\theta \mid Y_{\mathrm{obs}}) \propto \int P(Y_{\mathrm{obs}}, Y_{\mathrm{mis}} \mid \theta)\, dY_{\mathrm{mis}} = P(Y_{\mathrm{obs}} \mid \theta)\)。若再加上參數 \(\theta\) 與 \(\phi\) 彼此相異 (distinct),關於 \(\theta\) 的推論就可以單從已觀察資料的密度 \(P(Y_{\mathrm{obs}} \mid \theta)\) 出發,完全忽略遺漏模型。這就是 Rubin 的可忽略性 (ignorability),也是「正確設定的概似分析在 MAR 下成立」的形式理由。
這個因式分解也解釋了一件通常被當成黑盒子便利性來陳述的事實:多層次與混合效果模型「會自動處理不平衡的資料」。混合模型極大化的正是上面那個已觀察資料的概似,所以一個在五個時點中只有三個時點有資料的人,就只貢獻一個三維的密度;沒有刪除也沒有插補,因為這個估計式從來就不是用一個完整長方形來表達的。那個經常被漏掉的條件,在可忽略性的推導裡寫得很精確:只有當遺漏只依賴模型裡的量時,這個保證才成立。如果流失依賴某個基線共變項,那個共變項就必須在模型裡,分析才承接得到 MAR 的保證;這也正是「一個省略了退出預測變項的混合模型並不會自動受到保護」的原因。在結構方程的框架裡,同一個估計式在 lavaan 中以引數 missing = "ml" 叫用;而它的觸及範圍還可以由輔助變項 (auxiliary variables) 擴大,也就是那些與結果變項或與遺漏相關、但不屬於實質模型的變項,透過飽和相關項 (saturated correlates) 的設定加進來,使 MAR 的條件化集合更豐富,估計因此既偏誤更小、也更有效率 (Collins et al., 2001)。FIML 的限制同樣值得說清楚:它假定了所給定的那個結果變項分配,因此資料若非常態就需要穩健校正;它處理的是「被建模變項上」的遺漏,而不是被當成固定值的外生預測變項上的遺漏;而它要納入輔助訊息,只能靠把那些變項一起帶進被估計的模型裡。
6.4 多重插補
第二種有原則的替代方案,把遺漏的處理與分析本身分開。多重插補 (multiple imputation, MI) 把每一個遺漏值不只取代一次,而是取代 \(m\) 次,從「給定已觀察資料之下遺漏資料的後驗預測分配」中抽樣,產生 \(m\) 份只在插補值上有差異的完整資料集。實質分析在每一份完整資料集上各跑一次,\(m\) 組結果再依Rubin 規則 (Rubin’s rules) 合併,而這套規則就是讓整個程序誠實的那組算術。合併後的點估計是 \(m\) 個估計的平均,\(\bar{Q} = \frac{1}{m}\sum_{j=1}^{m} \hat{Q}_j\)。總變異數有兩個部分,\(T = \bar{U} + (1 + 1/m)\,B\),其中 \(\bar{U} = \frac{1}{m}\sum_j U_j\) 是平均的插補內變異數,也就是「資料若完整時仍然會有的那份普通不確定性」,而 \(B = \frac{1}{m-1}\sum_j (\hat{Q}_j - \bar{Q})^2\) 是插補間變異數,也就是遺漏本身額外貢獻的不確定性。乘數 \((1 + 1/m)\) 校正的是「只用了有限份插補」這件事。關鍵之處在於 \(B\):因為各份插補彼此有變異,插補間變異數不為零,合併後的標準誤會被放大到足以反映遺漏的真實代價,而這正是單一插補所偽造掉的那份確定性。總變異數中歸因於遺漏的那個比例,也就是遺漏訊息比例 (fraction of missing information, FMI),決定了需要多少份插補,以及損失了多少效率。
MI 的成立倚賴一個實務上很容易違反的條件,契合性 (congeniality),也就是「插補模型至少要和分析模型一樣豐富」的要求。分析將要估計的每一個特徵,插補都必須保留下來:如果分析裡有交互作用,插補模型就必須包含它,否則插補值會從一個「交互作用不存在」的分配中抽出來,合併後的估計就會被衰減而偏向零;非線性項、插補預測變項時的結果變項,以及下文要談的群集結構,都是同樣的道理。表 6.2 是插補模型的建構檢核表。在 R 裡標準的實作是 mice (van Buuren & Groothuis-Oudshoorn, 2011),它以全條件設定 (fully conditional specification, FCS) 插補,也就是在不完整的變項之間輪流走,每一個都用其餘變項的迴歸來插補;預設值使用穩健的預測平均數配對 (predictive mean matching, PMM),從已觀察個案中抽取插補值,因而能貼合經驗分配。這套工作流程有它的紀律:預測變項矩陣要刻意設定,而不是放著用預設值;插補份數要設得比歷史上常被引用的五份更多,依照現代的建議把 \(m\) 調整到與遺漏訊息比例相稱 (von Hippel, 2020);而且插補在使用之前要先檢視。圖 6.4 呈現最關鍵的診斷,也就是已觀察密度與插補密度的疊圖:插補值相對於已觀察值應該是合理的,既不該完全相同(那表示插補什麼也沒加進去),也不該離譜地偏移(那表示插補模型設定錯誤)。
表 6.2 插補模型建構檢核表(契合性)。
| 分析的特徵 | 對插補模型的要求 |
|---|---|
| 交互作用項 | 把乘積項納入,或在各子群體之內分別插補,使關聯得以保留。 |
| 非線性項(例如 \(x^2\)) | 插補轉換後的量(被動插補,passive imputation),或把它當成預測變項納入。 |
| 結果變項 \(Y\) | 插補預測變項時要納入 \(Y\);略去它會使關聯偏向零。 |
| 群集/巢套 | 使用多層次插補模型;扁平插補會扭曲變異數成分(圖 6.5)。 |
| 輔助變項 | 加入與遺漏或與 \(Y\) 相關的變項,以強化 MAR 的條件化集合。 |
| 衍生的量表分數 | 可行時在題目層次插補,再組成分數(被動插補)。 |
註:支配一切的原則是:插補模型必須至少和分析模型一樣一般。任何分析將要估計、而插補卻省略掉的結構,都會被系統性地從完整資料中抹掉。
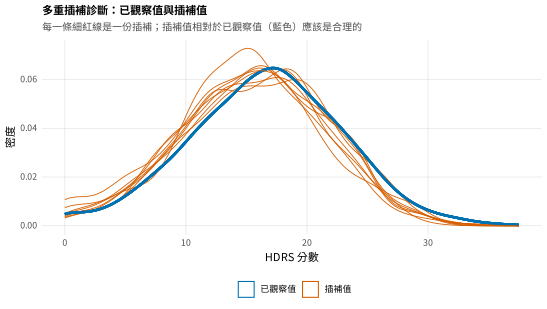
註:粗藍線是已觀察 HDRS 值的密度;每一條細紅線是八份完整資料集之一當中插補值的密度。插補值如本圖這樣跟著已觀察分配走,是「插補模型合理」的必要條件(不是充分條件)。紅線若系統性地偏移,就代表設定錯誤。
真正讓本書有別於標準教材的一節,是多層次多重插補 (multilevel multiple imputation),因為本書所關心的縱貫與密集資料是巢套的,時點巢套在個體之內,而忽略巢套的扁平插補 (flat imputation) 會造成可測量的損害。最清楚的受害者是組內相關 (intraclass correlation, ICC),也就是落在個體之間的變異數比例,而這個量正定義了一個設計能從它的重複測量中獲益多少。圖 6.5 在經驗取樣資料上把這一點做了出來:當下負向情緒的真實 ICC 是 \(0.36\),但若用一個把所有觀察視為可交換、忽略個體層次的扁平模型去插補遺漏的提示,它就幾乎減半到 \(0.20\),因為跨個體的匯集會把每個人的值都往總平均數拉,摧毀了個體之間的區隔。一個把個體當成群集來建模的多層次插補 (multilevel imputation),此處是 mice 搭配 2l.pan 方法,則還原了真值(\(0.38\))。個體內與個體間的迴歸係數只要被扁平插補,也會受到同樣的扭曲,這正是「巢套資料的契合性要求一個巢套的插補模型」的原因。實務上的選擇有兩種:波次數不多時,把時點當成分開的欄位做寬格式插補,就足以保住共變結構;而密集設計的長序列,則需要真正的多層次插補,透過聯合建模的工具(jomo、mitml)或 mice 之內的多層次方法為之,同時誠實地附上但書:隨機斜率結構要契合地插補仍然困難,而全條件設定與聯合建模這兩條路交換的是不同的假設。多層次結果的合併遵循同一套 Rubin 算術,在混合模型與 lavaan 上分別由 mitml 與 semTools 生態系實作;由於這個領域的工具持續演變,確切的函式名稱應該在使用當下再查證一次。表 6.3 摘要了什麼情況該伸手拿哪一種策略。
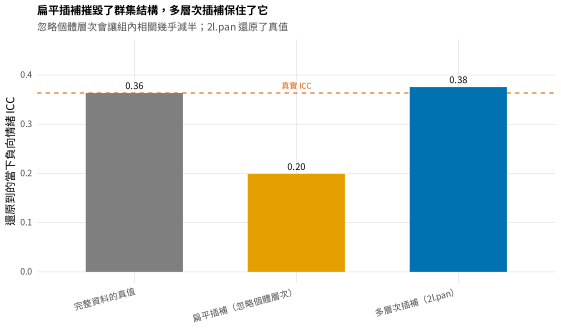
註:虛線是經驗取樣資料中當下負向情緒的真實 ICC(\(0.36\))。忽略個體層次的扁平插補讓還原到的 ICC 幾乎減半到 \(0.20\);以 2l.pan 做的多層次插補則還原了它(\(0.38\))。由於 ICC 支配著重複測量設計的訊息含量,它一旦被扭曲,就會傳遞到下游每一個變異數切分與跨層次的結果上。
表 6.3 依情境選擇方法的指南。
| 情境 | 偏好的做法 | 說明 |
|---|---|---|
| 混合模型,只有結果變項有遺漏 | FIML(直接 ML) | 在 lmer/lavaan 中自動採用;把退出的預測變項當共變項納入。 |
| 預測變項有遺漏 | MI | FIML 無法插補外生的 \(x\),MI 可以。 |
| 有強力的輔助變項 | MI,或搭配飽和相關項的 FIML | 輔助變項會豐富 MAR 的條件化集合。 |
| 波次少、有巢套 | 寬格式 MI 或 FIML | 寬格式 MI 保住時點之間的共變。 |
| 密集/時點多、有巢套 | 多層次 MI(2l.pan、jomo) | 扁平 MI 會扭曲 ICC(圖 6.5)。 |
| 類別或計數結果變項 | 搭配配對法的 MI,或以模型為基礎的 ML | 要對照分析所用的連結函數檢查契合性。 |
| 懷疑是 MNAR | 任一種有原則的基礎方法加上敏感度分析 | 不把 \(M\) 建模就沒有方法成立(第 6.6 節)。 |
註:當插補模型與分析模型契合,而且用的是同一批訊息時,FIML 與 MI 在漸近上等價;選擇是實務性的,取決於遺漏位在哪裡,以及手上有什麼輔助訊息。
對密集資料的分析者而言,還有一個定向性的最後問題:到底要不要插補。當分析是以最大概似估計的多層次或動態模型時,已觀察到的反應往往可以直接被建模,於是結果變項並不需要插補,插補則保留給共變項上的遺漏、輔助變項的納入,或是那些需要完整序列當輸入的方法,例如某些網絡與向量自我迴歸模型(第 25、28 章)。這個決定不是教條,而是把工具與遺漏對上:模型允許時就以 ML 直接建模結果變項,而當問題的結構或分析方法要求完整資料時就插補。
6.5 流失分析與報告
在任何建模之前,一項縱貫研究欠讀者一份「誰在什麼時候離開」的描述。這件事的弱版本,也就是單一個退出百分比,丟掉了真正要緊的時間結構;有訊息量的版本則把留存當成一個歷程來處理。圖 6.6 把心理治療試驗中每一組「仍然留在研究裡的比例」對週次作圖,這是一種存活圖(其形式機制見第 29 章),而它一眼就傳達了一個比率傳達不了的事:流失是早發還是晚發、是穩定還是集中,以及它是否因組別而異。在圖中這項試驗裡,兩組的留存都穩定下降,到最後一週約為 \(56\%\),而且兩組走得很接近;這件事本身就有訊息量,因為兩組之間的差異性退出 (differential dropout) 是一個特定的威脅,而這種圖正好會把它暴露出來。
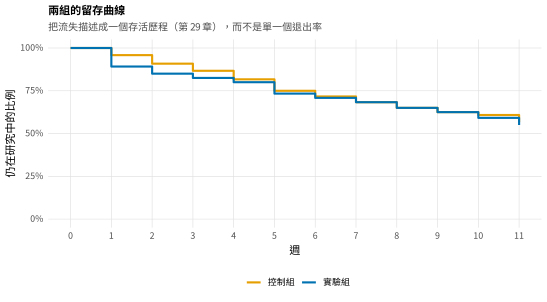
註:圖中畫的是每一組仍在貢獻資料的比例對週次的變化。把流失描述成一個留存歷程,而不是單一個研究結束時的退出率,會把它的時機與兩組之間的差異都暴露出來,而這兩件事都關係到可忽略性假設是否可信。
真正的流失分析 (attrition analysis) 比較的是離開的人與留下來的人,而且它必須比較兩件事,不是一件。在基線特徵上的比較,也就是人口學變項 (demographics) 與初始狀態,是標準做法,但並不充分,因為兩個在基線上完全相同的人,在其中一個退出之前,軌跡可能已經差很多。因此縱貫研究特有的比較是在到目前為止的軌跡上:退出者在他們確實提供的那些時點裡,相對於完成者是在改善還是在惡化。「退出者退出前的下降比較陡」或「退出前的嚴重度比較高」這樣的發現並不能證明 MNAR,但它指認出了「遺漏所依賴的那些已觀察量」,而這正是所需要的訊息:這些量一旦被放進模型,就能把一個具威脅性的 MNAR 故事,轉換成一個站得住腳的 MAR 故事。這重新界定了流失分析的目的:它不是一個要通過的檢定,也不是把不顯著的差異宣告成隨機性的證明,而是一場對「模型接下來必須納入的遺漏預測變項」的搜尋。當那些預測變項無法被帶進模型時,另一個框架是逆機率加權 (inverse-probability weighting),也就是用「被觀察到的估計機率」的倒數去對已觀察個案重新加權,把代表性不足的往上加權;它是第 12 章邊際模型的天然搭檔,而且在加權模型設定錯誤時有它自己的脆弱性。報告應該遵循 CONSORT 針對縱貫與群集設計的延伸版,附上一張把每一位收案者在每一波都交代清楚的參與者流程圖,而第 6.9 節的語句範本會把該寫的那一段講得很具體。
6.6 MNAR 敏感度分析
當遺漏可能依賴那些看不見的值本身時,任何對已觀察資料的分析都無法被確知為正確;此時誠實的回應不是去找出那一個能救回結果的 MNAR 模型,而是去問:結論要錯到什麼程度,才會被推翻。這就是敏感度分析 (sensitivity analysis) 的邏輯,而它現代、實用的形式是搭配delta 調整 (delta adjustment) 的型態混合模型 (pattern-mixture model)。想法很透明:先在 MAR 之下插補遺漏值,然後刻意把退出者的插補值平移一個敏感度參數 \(\delta\),代表「離開的人比他們的已觀察資料所預測的系統性地更差(或更好)」這個假設,再重新配適模型,並追蹤估計值隨 \(\delta\) 增大而如何變化。結果就是臨界點分析 (tipping-point analysis),它定位出「實質結論被推翻」的那個 \(\delta\) 值,此處指的是處理效果的顯著性,然後追問:這麼大的偏離,在臨床上或心理學上可不可信。
圖 6.7 對這項心理治療試驗做了這個分析。在 MAR(\(\delta = 0\))之下,估計到的「處理 \(\times\) 時間」效果明顯不為零而且有利;而隨著實驗組的退出者被假定惡化的幅度愈來愈大,估計到的優勢就縮小,信賴區間也變寬。臨界點大約在 \(\delta = 5.6\) 個 HDRS 分:只有當實驗組的退出者被假定平均比他們退出前的軌跡所預測的還要差將近六個憂鬱量表分,也就是一場相當大、可以說並不合理的崩解,處理效果才會失去顯著。這是一個很強的敏感度結果,因為它把一個不可檢驗的假設換算成一個量化、可解讀的餘裕,而且它被報告出來不是當成弱點,而是當成穩健性的證據。另一個家族,Diggle and Kenward (1994) 的選擇模型 (selection model),則是明確地把「退出機率」設定成「可能遺漏的當前值」的函數,並與結果模型聯合估計;它在概念上很優雅,但它的識別幾乎完全建立在分配假設上,而不是資料中的訊息上,因此估計脆弱,最好用來探查而不是用來定案。「有原則的分析應該在一系列可信的遺漏假設之下報告一系列結果,而不是在一個未經檢視的假設之下報告單一個數字」,這條主張如今已是臨床試驗方法學共識所建議的標準 (National Research Council, 2010),而第 29 章的共享參數模型 (shared-parameter model),以及縱貫與存活資料的聯合模型,則是它最具企圖心的表現。
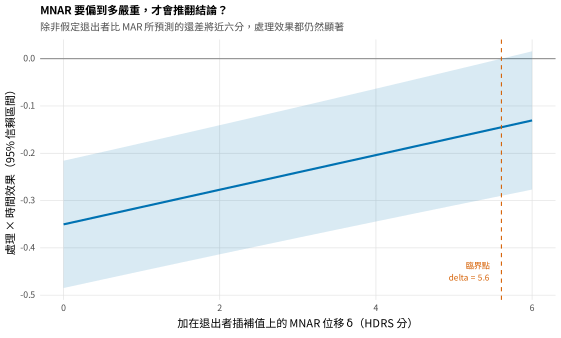
註:圖中畫的是估計到的「處理 \(\times\) 時間」效果及其 \(95\%\) 信賴區間對 MNAR 敏感度參數 \(\delta\) 的變化;\(\delta\) 是「實驗組退出者被假定超出其 MAR 預測值」的 HDRS 分數。結論一直維持顯著到 \(\delta \approx 5.6\),那是一個很大的假定偏離,這也就量化了這項發現對可信的 MNAR 違反有多穩健。
6.7 計畫性遺漏
遺漏通常是強加在研究上的問題,但它也可以是研究自己選用的工具,而計畫性遺漏設計 (planned missingness designs) 正是利用本章的機制,用設計本身來降低受訪者負擔 (Graham et al., 2006)。在三式設計 (three-form design) 中,題庫被切分成一個所有人都施測的共同核心,加上另外三個題組;每一位受訪者拿到核心加上三組中的兩組,於是每一位受訪者都作答了三分之二的題目,而且每一對題組都在某些受訪者身上被同時觀察到,這正是讓多重插補或 FIML 得以還原完整共變結構所需要的覆蓋。圖 6.8 呈現這個示意圖。如此誘發出來的遺漏依建構就是 MCAR,因為題組的指派是隨機化的,與任何反應都無關,所以困擾非計畫性遺漏的那些強假設根本不會出現;代價是一項適度、可量化的效率損失,換來的則是任何單一份問卷長度的大幅縮減。在密集縱貫設計中,同樣的邏輯支持跨提示的題目輪替 (item rotation),每一次提示只呈現題目的一個子集,讓當下的負擔保持低,同時在一整天之內累積出完整的覆蓋。該注意的地方確實存在:計畫性遺漏在小樣本中特別不適用,效率損失在那裡最為嚴重;而且它預設了分析將會使用有原則的遺漏資料方法,所以一個用整列刪除來分析的三式設計,等於丟掉了它自己的存在理由。
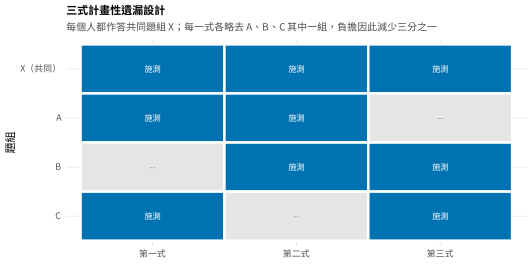
註:每一位受訪者都作答共同題組 \(X\);三式各略去 \(A\)、\(B\)、\(C\) 其中一組。因此每一位受訪者作答三分之二的題目,而每一對題組都在某些式子中被同時觀察到,於是完整的共變結構可以由 FIML 或 MI 還原。所誘發出來的遺漏依設計就是 MCAR。
6.8 在 R 中執行遺漏資料分析
這個實作範例把心理治療試驗走完整條路,從描述流失,到以一個有原則的方法配適成長模型,再到探查 MNAR。資料是 therapy_rct,\(240\) 位病人分屬兩組,每週測量共十二週,單調退出影響了 \(44\%\) 的病人,留下 \(75\%\) 的「人乘週」被觀察到。第一件工作是描述留存,而不是用單一個數字把它摘要掉。
library(dplyr); library(tidyr); library(ggplot2); library(lme4)

rct <- readRDS("Examples/data/therapy_rct.rds")

# 把流失描述成一個留存歷程,依組別分開
retention <- rct
  group_by(arm, week)
  summarise(retained = mean(!is.na(hdrs)), .groups = "drop")

# 流失分析:退出者與完成者有沒有不同?
completer <- rct
  summarise(complete = all(!is.na(hdrs)), .groups = "drop")
rct <- left_join(rct, completer, by = "patient_id")
rct
  group_by(complete)
  summarise(baseline_hdrs = mean(hdrs), n = n())
留存曲線(圖 6.6)與基線比較合起來構成流失分析;基線比較還應該補上退出前斜率的比較,那才是縱貫研究特有的檢查。接著以直接最大概似配適成長模型,而這對混合模型而言是自動的:lmer 極大化的就是已觀察資料的概似,所以把不完整的長格式資料直接傳進去,配適出來的就是 FIML 之下的模型,不需要任何特別的引數,前提是退出的預測變項在模型裡。
# 用混合模型做 FIML:不刪除,也不插補
fit_fiml <- lmer(hdrs ~ week * arm + (1 + week | patient_id),
                 data = rct)                  # 只用已觀察列;在已觀察值上做 ML
summary(fit_fiml)$coefficients["week:armTreatment", ]

# 同一個成長模型,在 lavaan 中寫成潛在曲線模型,同樣用 FIML
# library(lavaan)
# model <- ' i =~ 1*w0 + 1*w1 + ... ; s =~ 0*w0 + 1*w1 + ... '
# fit <- growth(model, data = wide, missing = "ml")   # FIML
多重插補提供第二個估計,而更重要的是,它是敏感度分析的載具。把試驗重整成寬格式,用 mice 插補 \(m\) 次,每一份完整資料集各自重新配適,再依 Rubin 規則合併;隨書附的腳本 ch06_missing_sims_V01.R 把合併的算術明確寫出來,讓它看得見,而不是藏在包裝函式裡。
library(mice)

wide <- rct
  pivot_wider(names_from = week, values_from = hdrs, names_prefix = "w")

imp <- mice(select(wide, starts_with("w")), m = 20,
            method = "pmm", printFlag = FALSE)   # m 與 FMI 相稱

# 在每一份完整資料集上重新配適,再依 Rubin 規則合併
wk <- paste0("w", 0:11)
was_missing <- is.na(wide[, wk])
pool_delta <- function(delta = 0) {
  est <- sapply(1:20, function(mm) {
    cw <- complete(imp, mm)
    cw[was_missing & wide$arm == "Treatment"] <-
      cw[was_missing & wide$arm == "Treatment"] + delta   # MNAR 位移
    long <- cw
      pivot_longer(all_of(wk), names_to = "week", values_to = "hdrs",
                   names_prefix = "w")
    f <- lmer(hdrs ~ week * arm + (1 + week | patient_id), data = long)
    c(fixef(f)["week:armTreatment"], sqrt(vcov(f)["week:armTreatment",
                                                  "week:armTreatment"]))
  })
  Qbar <- mean(est[1, ]); Ubar <- mean(est[2, ]^2); B <- var(est[1, ])
  Tvar <- Ubar + (1 + 1/20) * B                       # Rubin 的總變異數
  c(estimate = Qbar, se = sqrt(Tvar))
}
pool_delta(0)          # MAR 的結果
sapply(seq(0, 6, 0.5), function(d) pool_delta(d)["estimate"])   # 臨界曲線
由 pool_delta 在一組 \(\delta\) 格點上描出來的臨界曲線就是圖 6.7;合併後的信賴區間第一次涵蓋零的那個值,就是臨界點。對於巢套的經驗取樣資料,保住 ICC 的那個多層次插補(圖 6.5)是透過預測變項矩陣設定的:把個體識別碼以代碼 \(-2\) 標記為群集變項,並選用 2l.pan 方法,如隨書附的腳本所實作。
實務要點 • 要幾份插補,以及要跑多久
\(m = 5\) 這個老建議是針對點估計校準的;現代做法把 \(m\) 調整到與遺漏訊息比例相稱,因為標準誤,尤其是檢定的自由度,穩定得慢得多。一條可用的規則是把 \(m\) 設得至少和遺漏訊息的百分比一樣大,於是 \(30\%\) 的遺漏訊息就意味著 \(m \approx 30\) 或更多 (von Hippel, 2020);對少數幾波的寬格式插補而言,代價很便宜,但對長的密集序列做多層次插補時代價就相當可觀,因為多份插補中的每一份本身都是一次跑過數千個「人 \(\times\) 時點」的 Gibbs 抽樣 (Gibbs sampling)。請據此編列執行時間與儲存空間的預算,把插補物件存下來,讓插補不必重新產生,並在報告中連同結果一起寫出 \(m\) 與估計到的遺漏訊息比例。
6.9 在縱貫論文中報告遺漏資料
遺漏資料的報告已經不再是選擇性的,而審稿人也愈來愈期待那些會移動效果量的分析決定被完整陳述。一段站得住腳的遺漏資料文字要交代五件事:遺漏的量與型態、所假定的機制以及與它相關的證據、所使用的方法及其關鍵設定、流失分析及其發現,以及在 MNAR 是實質疑慮時的敏感度分析及其結論。針對本章這項試驗的示範文字可以這樣寫:「在收案的 \(240\) 位病人中,\(134\) 位(\(55.8\%\))完成了全部十二次每週評量;單調退出影響了其餘的 \(106\) 位(\(44.2\%\)),留下 \(75.2\%\) 的預定人週被觀察到,到第 12 週時控制組的留存降至 \(56\%\)、實驗組降至 \(55\%\)。完成者與退出者在基線嚴重度上沒有差異,但退出者在退出前的下降較陡,因此捕捉了該軌跡的『週』及其與組別的交互作用被保留在模型中,以支持隨機遺漏的假設。成長模型以完全訊息最大概似法估計,它用上了全部已觀察到的人週,不做刪除也不做插補。作為敏感度分析,套用了型態混合的 delta 調整,把實驗組退出後的插補值往上平移 \(\delta = 0\) 到 \(6\) 個 HDRS 分;『處理乘時間』效果一直維持顯著到 \(\delta \approx 5.6\),顯示除非假定實驗組的退出者比其已觀察軌跡再惡化將近六個量表分,否則這個結論是穩健的。」每一個子句都記錄了一個決定,而每一個數字都來自分析本身,不是來自範本。表 6.4 是報告檢核表。
表 6.4 縱貫研究遺漏資料的報告檢核表。
| 項目 | 該報告什麼 |
|---|---|
| 量與型態 | 整體與各波的完成率;單調或間歇;依組別或群體分開的留存。 |
| 所假定的機制 | 把假設(通常是 MAR)當成假設來陳述;來自流失分析的證據;Little 檢定只在說明其限制的情況下引用。 |
| 方法與設定 | FIML 或 MI;若是 MI,寫出軟體、方法、插補份數 \(m\)、輔助變項,以及估計到的 FMI。 |
| 流失分析 | 退出者與完成者在基線與退出前軌跡上的比較;遺漏的預測變項,以及它們如何進入模型。 |
| 敏感度分析 | 針對可信的 MNAR,寫出 delta 的格點與臨界點,或選擇模型的結果,並附上可信度的判斷。 |
| 流程圖 | CONSORT 式的參與者流程,交代每一波的每一個個案。 |
註:這份檢核表對應期刊與報告規範對縱貫及試驗資料的期待。它的目的是讓遺漏資料的決定可被稽核,而不是要證明沒有資料遺漏。
常見陷阱 • 四個能通過同儕審查的失誤
第一,把 Little 檢定當成通行證:不顯著的 MCAR 檢定被讀成 MAR 的證明,但這個檢定管的是 MCAR 而不是 MAR,而且它的不顯著可能只反映檢定力低;MAR 始終是一個要被辯護的假設,永遠不是一項結果。第二,先插補再刪除:分析者有時把資料插補完,卻在某個衍生變項上跑完全個案分析,於是丟掉了插補的好處,也把偏誤請了回來;一旦插補完成,就必須使用完整資料並加以合併。第三,忘了輔助變項:FIML 與 MI 只透過它們納入的變項來防護遺漏,因此漏掉一個強力的退出預測變項,就等於放棄了那個變項本來可以爭取到的 MAR 保證。第四,對長的密集資料做寬格式插補:把一份經驗取樣資料用幾百個提示欄位以寬格式插補,會產生一個不穩定、過度參數化的插補模型;長的密集資料需要的是多層次插補,不是一個非常寬的扁平插補。
軟體提示 • 遺漏資料的工具鏈
在 R 裡,mice 是全條件多重插補的標準工具,jomo 與 mitml 負責聯合模型與多層次插補,而 mitml 的 testEstimates 用來合併混合模型的結果;lavaan 透過 missing = "ml" 提供 FIML,semTools/lavaan.mi 的常式則合併插補後的 SEM 配適結果,不過這個領域的函式名稱在各版本之間改過,應該對照當前的文件確認。在 Mplus 中,連續結果變項在 TYPE = ... 之下預設即為 FIML,其 DATA IMPUTATION 功能與 H1MODEL 選項可實作 MI,選擇模型的邏輯也可以透過限制式表達。無論用哪一種工具,插補物件都應該存下來,讓結果可重現,也讓插補不必重新產生,而軟體、版本與設定都應該在報告中指名。
6.10 常見的迷思
關於遺漏資料,有幾個信念既常見又有害。第一個是認為 MAR 就是日常語意下的「隨機遺漏」,也就是遺漏是雜亂無章的;MAR 是一個精確的條件獨立陳述,說的是「在給定已觀察值之後,遺漏與遺漏值無關」,而它完全可以在「遺漏與已觀察變項有強烈而系統的關聯」時成立。第二個是認為 FIML 與 MI 是對手,兩者不一致時必有一方是錯的;當它們在同一個模型下使用同一批訊息時,兩者漸近等價,而不一致所反映的是輸入的差異,也許是某個輔助變項只進了其中一邊,也許是插補模型不契合,而不是一個矛盾。第三對是關於多層次模型的兩個相反的迷思:認為 混合模型要求第一層是完整個案,這是錯的,因為模型是在已觀察到的反應上估計的;以及認為 混合模型會自動修好所有遺漏,這也是錯的,因為它的防護只延伸到「依賴被建模的量」的那部分遺漏。第四個是認為 敏感度分析是在承認弱點;恰恰相反,它是在示範結論已經被壓力測試過,而且如今它愈來愈是被要求的,而不只是被允許的。還有一個經常被問到的實務問題,要插補當下的題目還是插補算好的量表分數,答案一般傾向題目層次的插補,再被動地建構分數,因為那用上了更多訊息,也保住了內部結構,前提是負擔與執行時間許可。
本章摘要
縱貫資料在結構上就是遺漏資料的問題,而遺漏的處理方式是一個建模決定,不是一個清理步驟。Rubin 的三種機制,MCAR、MAR 與 MNAR,是關於「遺漏與資料之間相依關係」的精確陳述,它們支配的是「忽略遺漏歷程」是否成立,而不是在描述遺漏的成因(圖 6.2);MAR 相對於 MNAR 不可檢驗,因此它永遠是一個要被辯護的假設。預設的修補並不保守:整列刪除只有在 MCAR 下才成立,而且它選出的是最健康的完成者,至於 LOCF 與平均數插補則是捏造資料,即使在 MCAR 下也會讓估計偏誤(圖 6.3)。兩種有原則的方法做得好太多。完全訊息最大概似法極大化已觀察資料的概似,讓每個人以他手上有的訊息做出貢獻,不刪除也不插補,這正是混合模型能處理不平衡資料的原因,前提是退出的預測變項在模型裡。多重插補把每一個遺漏值取代 \(m\) 次,再依 Rubin 規則合併,其中的插補間變異數還原了單一插補所隱藏掉的不確定性;契合性要求插補模型和分析模型一樣豐富,而對巢套資料而言,那意味著多層次插補,因為扁平插補會讓 ICC 幾乎減半(圖 6.5)。流失要被描述成一個留存歷程,並藉由比較退出者與完成者在基線與軌跡上的差異來分析,以便找出模型必須納入的遺漏預測變項(圖 6.6)。當 MNAR 可信時,型態混合的臨界點分析會量化「違反要大到什麼程度才會推翻結論」(圖 6.7),並且作為穩健性的證據被報告出來。計畫性遺漏則把問題倒過來,用隨機化、依設計即為 MCAR 的遺漏來削減受訪者負擔(圖 6.8)。
接下來讀哪裡
本章的方法是後續一切的先備條件,後面各章會直接假定它們,而不再重新推導。第 13 與 14 章的多層次與成長模型承接此處所建立的 FIML 性質;第 12 章的邊際模型提供逆機率加權這個替代方案,以及 GEE 在 MAR 之下的脆弱性;第 22 章的混合分配模型 (mixture model) 在面對未觀察異質性的同時也要面對遺漏;第 25 與 28 章的動態與網絡模型對提示層次的遺漏很敏感,而本章的多層次插補是處理它的起點;第 29 章的存活與聯合模型把退出當成一個要被建模的事件,而不是一個要被插補掉的麻煩,這是對 MNAR 最完整的回答;報告的紀律則在第 36 章被整合起來。唯一的要求是:遺漏要以一個公開陳述的假設,加上一個與之相稱的方法來面對;而當那個假設不確定時,它的後果要被量化,而不是被忽略。
習題
- 6.1 重製招牌圖。以更強的 MNAR 機制重跑圖 6.3 背後的模擬,並描述每一種方法的偏誤在大小與方向上如何改變。指出哪些方法變差了,並就「每一種方法用了什麼、捏造了什麼」加以解釋。
- 6.2 一套契合的 MI 流程。在所提供的一份四波資料上,其分析模型含有「處理 \(\times\) 時間」交互作用;請建立一個保住該交互作用的插補模型,執行 mice,並依 Rubin 規則合併。請以所附的檢查項目驗證:把交互作用從插補模型中拿掉,會使合併後的估計衰減。
- 6.3 多層次插補與扁平插補。在一份經驗取樣的子集上,先扁平地插補遺漏的當下情緒,再用多層次模型插補一次,並把還原到的 ICC 與個體內斜率拿去和已知真值比較。報告扁平插補扭曲了哪些量、扭曲了多少。
- 6.4 臨界點分析。在
therapy_rct上執行圖 6.7 的型態混合 delta 分析,找出臨界點,並依第 6.9 節寫出那段敏感度文字。接著就實質面論證:那樣大小的偏離可不可信。 - 6.5 用設計對付 MNAR。就你自己選定的一項日誌研究,建構一個寫實的 MNAR 故事,然後提出一項設計上的改動,也就是一個要測量的變項,使那個機制因為捕捉到遺漏的驅動因素而往 MAR 移動。請說明為什麼這個新增的變項值得在分析模型中佔一席之地。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 遺漏資料 | missing data | 應觀察到卻未取得的資料值;全章主題 |
| 單位未回應 | unit nonresponse | 整個人的流失;第 6.1 節 |
| 波次未回應 | wave nonresponse | 某些人整個時點的流失;第 6.1 節 |
| 單調退出 | monotone dropout | 一旦缺席其後皆缺席;第 6.1 節 |
| 流失 | attrition | 研究進行中參與者的持續損失;第 6.1 節 |
| 間歇性遺漏 | intermittent missingness | 時進時出的非單調型態;第 6.1 節 |
| 題目遺漏 | item missingness | 已完成評量之內特定題目的流失;第 6.1 節 |
| 提示層次遺漏 | prompt-level missingness | 對預定提示完全未作答;第 6.1 節 |
| 機制 | mechanism | 遺漏機率與資料值之間的機率關係;第 6.1 節 |
| 完全隨機遺漏 | missing completely at random (MCAR) | 遺漏與所有資料獨立;第 6.1 節 |
| 隨機遺漏 | missing at random (MAR) | 給定已觀察值後與遺漏值無關;第 6.1 節 |
| 非隨機遺漏 | missing not at random (MNAR) | 條件化之後仍依賴看不見的值;第 6.1 節 |
| 遺漏指標 | missingness indicator | 記錄哪些格位存在的矩陣 \(M\);第 6.1 節 |
| Little 檢定 | Little’s test | MCAR 的綜合檢定,不顯著不等於 MAR;第 6.1 節 |
| 整列刪除 | listwise deletion | 丟棄記錄不完整的人;第 6.2 節 |
| 完全個案分析 | complete-case analysis | 整列刪除後的分析;第 6.2 節 |
| 末次觀察值向前推補 | last-observation-carried-forward (LOCF) | 以最近一次觀察值填補;第 6.2 節 |
| 平均數插補 | mean imputation | 以平均數填補,衰減變異數與共變數;第 6.2 節 |
| 完全訊息最大概似法 | full-information maximum likelihood (FIML) | 直接極大化已觀察資料的概似;第 6.3 節 |
| 可忽略性 | ignorability | 可忽略遺漏模型的條件;第 6.3 節 |
| 輔助變項 | auxiliary variables | 豐富 MAR 條件化集合的相關變項;第 6.3 節 |
| 飽和相關項 | saturated correlates | 在 SEM 中納入輔助變項的設定方式;第 6.3 節 |
| 多重插補 | multiple imputation (MI) | 每個遺漏值取代 \(m\) 次再合併;第 6.4 節 |
| Rubin 規則 | Rubin’s rules | 合併 \(m\) 組結果的算術;第 6.4 節 |
| 插補內變異數 | within-imputation variance | 資料完整時仍有的抽樣變異數;第 6.4 節 |
| 插補間變異數 | between-imputation variance | 遺漏本身額外貢獻的不確定性;第 6.4 節 |
| 遺漏訊息比例 | fraction of missing information (FMI) | 總變異數中歸因於遺漏的比例;第 6.4 節 |
| 契合性 | congeniality | 插補模型至少要與分析模型一樣豐富;第 6.4 節 |
| 全條件設定 | fully conditional specification (FCS) | mice 逐變項輪流插補的做法;第 6.4 節 |
| 預測平均數配對 | predictive mean matching (PMM) | 由已觀察個案抽取插補值;第 6.4 節 |
| 被動插補 | passive imputation | 先插補成分再由其建構衍生量;第 6.4 節 |
| 多層次多重插補 | multilevel multiple imputation | 把個體當群集建模的插補;第 6.4 節 |
| 組內相關 | intraclass correlation (ICC) | 落在個體之間的變異數比例;第 6.4 節 |
| 扁平插補 | flat imputation | 忽略巢套的插補,會扭曲 ICC;第 6.4 節 |
| 流失分析 | attrition analysis | 比較退出者與完成者的基線與軌跡;第 6.5 節 |
| 逆機率加權 | inverse-probability weighting | 以被觀察機率的倒數重新加權;第 6.5 節 |
| 敏感度分析 | sensitivity analysis | 問結論要錯到多少才會被推翻;第 6.6 節 |
| 型態混合模型 | pattern-mixture model | 依遺漏型態分層的 MNAR 模型;第 6.6 節 |
| delta 調整 | delta adjustment | 刻意平移退出者插補值的敏感度做法;第 6.6 節 |
| 臨界點分析 | tipping-point analysis | 定位結論被推翻的 \(\delta\);第 6.6 節 |
| 選擇模型 | selection model | 聯合設定退出機率與結果模型;第 6.6 節 |
| 計畫性遺漏設計 | planned missingness design | 以隨機化遺漏降低負擔;第 6.7 節 |
| 三式設計 | three-form design | 共同題組加三選二的題組指派;第 6.7 節 |
| 題目輪替 | item rotation | 密集設計中跨提示輪替題目;第 6.7 節 |
參考文獻
Collins, L. M., Schafer, J. L., & Kam, C.-M. (2001). A comparison of inclusive and restrictive strategies in modern missing data procedures. Psychological Methods, 6(4), 330–351. https://doi.org/10.1037/1082-989X.6.4.330
Diggle, P., & Kenward, M. G. (1994). Informative drop-out in longitudinal data analysis. Journal of the Royal Statistical Society: Series C (Applied Statistics), 43(1), 49–93. https://doi.org/10.2307/2986113
Enders, C. K. (2022). Applied missing data analysis (2nd ed.). Guilford Press.
Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60, 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
Graham, J. W., Taylor, B. J., Olchowski, A. E., & Cumsille, P. E. (2006). Planned missing data designs in psychological research. Psychological Methods, 11(4), 323–343. https://doi.org/10.1037/1082-989X.11.4.323
Grund, S., Lüdtke, O., & Robitzsch, A. (2018). Multiple imputation of missing data for multilevel models: Simulations and recommendations. Organizational Research Methods, 21(1), 111–149. https://doi.org/10.1177/1094428117703686
Little, R. J. A. (1988). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). Wiley. https://doi.org/10.1002/9781119482260
Lüdtke, O., Robitzsch, A., & Grund, S. (2017). Multiple imputation of missing data in multilevel designs: A comparison of different strategies. Psychological Methods, 22(1), 141–165. https://doi.org/10.1037/met0000096
National Research Council (2010). The prevention and treatment of missing data in clinical trials. National Academies Press. https://doi.org/10.17226/12955
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
von Hippel, P. T. (2020). How many imputations do you need? A two-stage calculation using a quadratic rule. Sociological Methods & Research, 49(3), 699–718. https://doi.org/10.1177/0049124117747303