第 10 章
分析兩個時點:配對比較、變化分數與可靠改變
兩個時點的資料,前測一次、後測一次,是最常見的縱貫設計,也是最常被處理錯的。本章認真看待它,而不是把它當成一個退化的特例打發掉,因為它所逼出來的選擇,正是讀者第一次遭遇貫穿本書其餘部分的那個論點:模型把問題編碼進去,而同一批資料的兩種站得住腳的分析,可以得到相反的結論,因為它們回答的是不同的問題。本章由第一原理建立配對比較,走過「變化分數對共變數分析」這個核心爭議與那個把它戲劇化的悖論,然後轉向兩個組層次檢定回答不了的問題:某一個特定的人是否可靠地改變了,以及一個組別是否真的穩定、而不只是「沒有顯著差異」。本章同時也固定下後續每一個方法章節都會遵循的樣板:模型、假設、估計、效果量、實作範例與報告。
學習目標
讀完本章之後,你應該能夠:(1) 依結果變項的量尺與研究問題選擇並辯護配對 \(t\) 檢定、Wilcoxon 符號等級檢定 (Wilcoxon signed-rank test) 或 McNemar 檢定;(2) 把配對 \(t\) 推導成對差異分數的單樣本檢定,並說明前後測相關 (pre-post correlation) 如何驅動它的檢定力;(3) 講清楚變化分數 (change score) 分析與共變數分析 (analysis of covariance, ANCOVA) 的區別,重現 Lord 悖論 (Lord’s paradox),並依設計選擇分析;(4) 計算並解讀配對的效果量,區分差異計量的 \(d_z\) 與原始計量的 \(d_{av}\);(5) 用可靠改變指標 (reliable change index, RCI) 把個體的改變分類;(6) 當主張是「沒有發生有意義的改變」時,改用等值檢定 (equivalence testing);(7) 把一項兩時點分析報告到可供發表的水準。
10.1 一組,兩個時點
配對比較的起點,是認清「同一個人的前後兩次測量」得到的不是兩個獨立的數字,而是一個差異分數 (difference score),而把每一個人化約成他自己的改變量,就移除了原本會遮蔽這個改變的個體間變異。配對 \(t\) 檢定 (paired \(t\) test) 於是不過就是一個單樣本 \(t\) 檢定,問的是平均差異是否偏離零,而它相對於獨立組比較的檢定力優勢,完全來自那一次移除,如基礎概念方塊所推導。它所作的假設很溫和:不是結果變項服從常態分配,而是那些差異近似常態,而在中等樣本下連這一點都很寬容。圖 10.1 顯示治療試驗實驗組配對資料的兩種誠實圖示:一張把每位病人的基線與終點連起來的斜率圖 (slope chart),它顯示摘要所遮蔽的改變異質性;以及差異分數的分配,它的平均數正是配對檢定所評估的那個量。在這項試驗中,這些病人平均改善了 \(12.67\) 個 HDRS 分(\(95\%\) CI \([-14.14, -11.20]\)),這個下降在兩個子圖中都看得見。
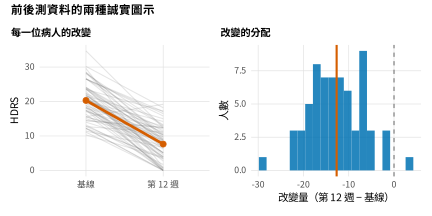
註:左:一張斜率圖,把每一位接受治療的病人的基線與第 12 週 HDRS 連起來,粗線是平均數;個別斜率的分散程度看得見。右:變化分數 (change score) 的分配,它的平均數(紅線)就是配對 \(t\) 檢定拿來與零(虛線)比較的量。配對檢定是對這些差異所作的單樣本檢定。
基礎概念 • 配對為什麼划算:差異的變異數
對一組配對測量 \((X_1, X_2)\),其變異數為 \(\sigma_1^2, \sigma_2^2\)、相關為 \(\rho\),則差異 \(D = X_2 - X_1\) 的變異數為 \(\mathrm{Var}(D) = \sigma_1^2 + \sigma_2^2 - 2\rho\,\sigma_1\sigma_2\)。當兩個時點正相關時,被減掉的那一項會縮小差異的變異數,而在變異數相等(皆為 \(\sigma^2\))時它變成 \(\mathrm{Var}(D) = 2\sigma^2(1 - \rho)\),隨著 \(\rho \to 1\) 而趨向零。配對 \(t\) 統計量是 \(\bar{D}/(s_D/\sqrt{n})\),因此較小的 \(\mathrm{Var}(D)\) 會給出較大的統計量,在相同的平均改變之下有更高的檢定力。這就是配對設計優勢的全部:藉由把同一批人測兩次,它移除了獨立組比較必須當成雜訊扛著的那份穩定的個體間變異數 (between-person variance) \(\sigma^2\)。同一個改變若以獨立組檢定,面對的差異變異數會是 \(2\sigma^2\),也就是 \(\rho = 0\) 的情形。
檢定力對前後測相關的依賴不是一項技術細節,而是偏好個體內設計的理由,圖 10.2 把它量化。在固定的原始改變量與樣本數之下,配對設計的檢定力隨著前後測相關增大而陡升,而對同一批資料所作的獨立組分析,因為用不上配對,就平平地停在相關為零的水準。在兩個時點上相關達 \(0.7\) 的研究,只要幾十筆配對觀察就能偵測到的效果,換成獨立觀察則要多出許多筆才辦得到。當結果變項是次序量尺、或差異嚴重偏離常態時,常見的替代是 Wilcoxon 符號等級檢定 (Wilcoxon signed-rank test),但必須正確理解它:它不只是一個無母數版的 \(t\) 檢定,而是檢定「差異的分配是否對稱於零」;而更粗略的符號檢定 (sign test) 只問上升的次數是否多於下降的次數。對配對的二元結果,也就是由一個類別換到另一個類別,McNemar 檢定 (McNemar’s test) 評估的是兩種不一致的改變是否一樣頻繁,而且絕不可與 kappa 這類一致性指標混為一談,因為兩個時點可以高度一致、卻仍呈現系統性的改變。表 10.1 把結果變項的量尺與研究問題對應到適當的檢定。
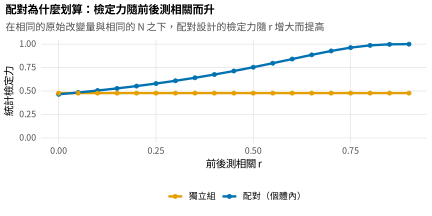
註:偵測一個固定原始改變量的統計檢定力 (statistical power),分別為配對(個體內)分析與對同一批資料所作的獨立組分析,作為前後測相關的函數。配對設計隨著相關增大而獲得檢定力,因為相關的那份個體間變異數被差分掉了;獨立分析用不上配對,因此停在相關為零的水準。
表 10.1 兩時點檢定的選擇指南。
| 結果變項的量尺 | 設計與問題 | 檢定 |
|---|---|---|
| 連續 | 一組,平均改變 | 配對 \(t\)(對差異作) |
| 連續,但差異非常態 | 一組,分配的位移 | Wilcoxon 符號等級(對稱性) |
| 次序,或只有方向 | 一組,上升是否多於下降? | 符號檢定 (sign test) |
| 二元 | 一組,類別的轉換 | McNemar(精確或 mid-\(p\)) |
| 連續 | 兩組,差異性的改變 | 見第 10.3 節(變化分數對 ANCOVA) |
註:配對 \(t\) 假設的是差異分數近似常態,不是結果變項近似常態。符號等級檢定評估的是差異的對稱性 (symmetry),不是平均數相等,而當差異的分配偏態 (skewed) 時,兩者可能得到不同結論。
10.2 配對資料的效果量
報告一項配對分析需要一個效果量 (effect size),而這裡有一個已經污染過許多後設分析 (meta-analysis) 的陷阱。配對設計有兩個標準化效果量在流通,而它們回答的是不同的問題。差異計量 (difference-metric) 的標準化效果 \(d_z = \bar{D}/s_D\),是把平均改變除以差異的標準差,而由於那個分母會被前後測相關縮小(見基礎概念方塊),\(d_z\) 正好在相關高時變大,所以它不能與組間的 \(d\) 相比,把它與組間 \(d\) 併在一起會膨脹。原始計量 (raw-metric) 的效果 \(d_{av} = \bar{D}/s_{av}\) 則是除以前測與後測標準差的平均,它與組間效果在同一個計量上,適合用於後設分析 (Dunlap et al., 1996; Morris & DeShon, 2002)。兩者可以差很多:在試驗的實驗組中,\(d_z = -2.12\) 而 \(d_{av} = -2.38\),而若前後測相關更高,兩者的差距會拉大。規則是:兩個都報告、寫明哪個是哪個,而且絕不要把 \(d_z\) 放進組間效果的後設分析裡。表 10.2 定義了各個配對效果量與它們的用途,而它們的信賴區間都可以由非中心 \(t\) 分配 (noncentral \(t\) distribution) 或拔靴法 (bootstrap) 得到。
表 10.2 配對設計的效果量。
| 效果量 | 分母 | 什麼時候報告它 |
|---|---|---|
| \(d_z\) | 差異的標準差 \(s_D\) | 研究內的檢定力與樣本數規劃;不可與組間 \(d\) 相比 |
| \(d_{av}\) | 前測與後測標準差的平均 | 通用的配對效果量;跨設計可比,用於後設分析是安全的 |
| \(d_{rm}\) | 已對相關作校正 | 相關已知時的後設分析併計 (Morris & DeShon, 2002) |
| 等級二系列相關 (rank-biserial correlation) | 以等級為基礎 | Wilcoxon 符號等級檢定的搭檔 |
註:分母不同,數字就不同;這個選擇不是裝飾性的。把 \(d_z\) 當成組間 \(d\) 來報告,是後設分析 (meta-analysis) 中常見而且後果嚴重的錯誤。
10.3 兩組,兩個時點:核心爭議
當兩個組各自被前後測一次時,有三種分析擺在眼前,而理解它們為什麼會彼此不合,正是本章智識上的核心。研究者可以分析變化分數 (change scores),檢定兩組在「改變了多少」上是否不同;可以作共變數分析 (analysis of covariance, ANCOVA),檢定在調整前測之後兩組在後測上是否不同;也可以單獨比較後測分數、完全不理前測。在隨機化設計、兩組基線期望值相等之下,前兩者在期望值上一致,而 ANCOVA 只是效率較高;但當兩組在基線就非等組 (nonequivalent) 時,變化分數分析與 ANCOVA 估計的是不同的量,而且可以得到相反的結論。這就是 Lord 悖論 (Lord’s paradox) (Lord, 1967),而圖 10.3 用構造出來的資料在數值上重現它。兩個非等組的組別各自完全穩定,後測平均數等於前測平均數,於是變化分數分析根本找不到任何組間的改變差異,效果只有 \(0.5\) 分且未達顯著。然而由於兩組在基線就不同,而且組內「後測對前測」的迴歸斜率小於一,ANCOVA 卻找到一個在調整前測之後、後測上高達 \(6.9\) 分且高度顯著的組間差異。資料一模一樣;判決完全相反。
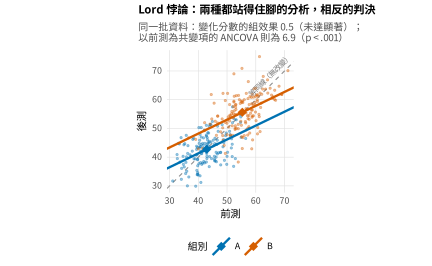
註:兩個非等組組別的構造資料。各組的平均數(菱形)都落在等同線 (identity line)(虛線)上,所以兩組都是穩定的,變化分數分析找不到組間差異。兩條共變數分析的迴歸線(實線,共同斜率)在垂直方向上錯開,因此調整前測之後在後測上得到一個很大的組間差異。悖論在於:兩種分析各自對不同的估計標的都是正確的。
解決之道不是宣告某一種分析才對,而是看清每一種回答的是不同的反事實 (counterfactual) 問題,而設計決定哪一個問題才合理。變化分數分析假設平行趨勢 (parallel trends),也就是在沒有任何組效果的情況下兩組會改變同樣多,這正是計量經濟學的差異中的差異 (difference-in-differences) 邏輯;當兩組走在只有水準不同的平行軌跡上時,它站得住腳。ANCOVA 假設的則是:在給定前測之下,若無效果則組別與後測無關,這在前測捕捉到了相關的混淆時站得住腳。在隨機化之下兩個假設都成立、兩種分析一致,而 ANCOVA 因檢定力較高而較受偏好 (Senn, 2006; van Breukelen, 2006)。在非等組之下兩個假設都不是免費的,分析者必須由實質知識為其中一個辯護,而不是讓軟體替他選。另有兩項難題讓情況更複雜。迴歸趨中 (regression to the mean),如圖 10.4 所示,是極端分數者在重測時會較不極端的傾向,純粹因為兩個時點的相關並不完美:在完全沒有介入的情況下,前測最低的十分之一會朝平均數上升、最高的十分之一會朝平均數下降 (Barnett et al., 2005),於是任何以基線的極端程度為條件的分析,都有把這個假象誤認為改變的風險。而當被當成共變項的前測本身帶有測量誤差時,ANCOVA 會調整不足 (under-adjust),因為被衰減的迴歸係數無法完全消除基線差異;圖 10.5 顯示在非等組中這會留下一個虛假的組效果,並隨著前測信度下降而增大,由完美信度時的接近零,一路到信度 \(0.5\) 時的將近五分,而此時真實效果是零。這種衰減,正是「改以一個已去除測量誤差的潛在前測來調整」的理由,也就是第 19 到 21 章的結構方程取向。表 10.3 是一個決策框架。
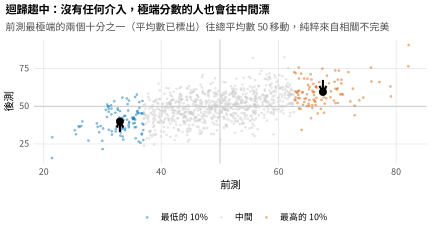
註:沒有任何介入的模擬資料,總平均數為五十,前後測相關並不完美。前測最低與最高的十分之一(其平均數以箭頭標出)在後測時都朝總平均數移動,純粹因為兩個時點的相關不完美。以基線的極端程度為條件,會把這個假象 (artifact) 誤認為真實的效果。
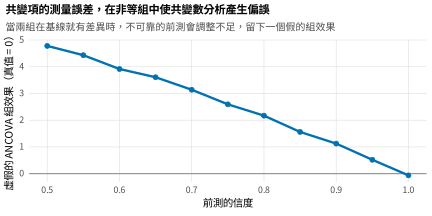
註:模擬的非等組資料,後測上沒有真實的組效果。隨著前測共變項的信度下降,共變數分析對基線差異調整不足,於是報告出一個虛假的組效果,在信度為二分之一時達到將近五分。這個偏誤只在前測完全可靠時才消失,這也構成採用潛在變項調整 (latent-variable adjustment) 的理由。
表 10.3 變化分數對共變數分析:一個決策框架。
| 情境 | 較宜採用的分析 | 理由 |
|---|---|---|
| 隨機化,基線相等 | ANCOVA | 兩者都不偏;ANCOVA 檢定力較高 |
| 非等組,平行趨勢說得通 | 變化分數 | 差異中的差異估計標的與設計相符 |
| 非等組,前測捕捉到混淆 | ANCOVA(前測不可靠時改用潛在的) | 條件可交換性 (conditional exchangeability) 的估計標的;須校正測量誤差 |
| 前測不可靠 | 以潛在共變項調整 | 觀察值的 ANCOVA 調整不足(圖 10.5) |
| 基線依極端程度挑選 | 兩者都不宜逕行採用 | 迴歸趨中同時污染兩者 |
註:這兩種分析在不同的假設之下估計不同的量。是設計、而不是預設值,選出估計標的 (estimand);在非等組中,這個選擇必須被論證,不能被自動化。
10.4 個體的改變:可靠改變指標
組層次的檢定回答的是「平均而言的那個人」是否改變了,但臨床與應用上的問題往往關心的是這一個人是否改變了,而且改變的幅度超出單靠測量誤差所能產生的範圍。Jacobson and Truax (1991) 的可靠改變指標 (reliable change index, RCI) 用「把一個人觀察到的改變除以差異的標準誤」來回答這件事,\(\mathrm{RCI} = (X_2 - X_1)/S_{\mathrm{diff}}\),也就是差異的標準誤 (standard error of the difference),其中 \(S_{\mathrm{diff}} = \sqrt{2}\,\mathrm{SE}_{\mathrm{meas}}\),而 \(\mathrm{SE}_{\mathrm{meas}} = s_1\sqrt{1 - r_{xx}}\) 取決於量表的信度。一個人的可靠改變指標絕對值超過 \(1.96\),就表示他的改變超出了測量誤差所能輕易解釋的範圍。把它與一個區隔功能範圍與失功能範圍的臨床切點 (clinical cutoff) 合起來,就得到 Jacobson–Truax 分類 (Jacobson–Truax classification):一個人若可靠地改變了、而且跨進了功能範圍,就是痊癒 (recovered);若可靠地改變了但仍在功能範圍之外,就是改善 (improved);若改變落在測量誤差之內,就是未改變 (unchanged);若可靠地變差了,就是惡化 (deteriorated)。圖 10.6 把試驗中每一位病人依基線與終點畫出來,並畫上可靠改變的帶與緩解切點,讓分類變得可見:可靠的改變要求那個點落在一條寬 \(5.4\) 個 HDRS 分的帶之外,而痊癒還要求它落在緩解線之下。這兩個判準是各自獨立的,而表 10.4 列出計算方式;最要緊的警告是,信度係數必須與量表和母體相符,因為一個不適當的信度會讓每一個分類都被膨脹或壓縮。
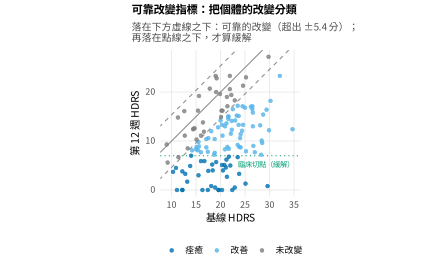
註:每一位病人依基線與第 12 週 HDRS 畫出。實線是無改變;落在下方虛線之下的點是可靠地改變了(超出由量表信度決定的 \(\pm 5.4\) 分的帶);點線是緩解 (remission) 切點。同時落在兩條線之下的病人是痊癒;落在可靠改變帶之下但仍在緩解線之上的是改善。可靠改變與臨床顯著性 (clinical significance) 是兩個各自獨立的判準。
表 10.4 可靠改變指標的各個成分。
| 量 | 定義與角色 |
|---|---|
| \(\mathrm{SE}_{\mathrm{meas}} = s_1\sqrt{1 - r_{xx}}\) | 測量標準誤 (standard error of measurement);量表越可靠它就越小 |
| \(S_{\mathrm{diff}} = \sqrt{2}\,\mathrm{SE}_{\mathrm{meas}}\) | 兩次測量之差的標準誤 |
| \(\mathrm{RCI} = (X_2 - X_1)/S_{\mathrm{diff}}\) | 標準化的改變;\(|\mathrm{RCI}| > 1.96\) 即為可靠 |
| 臨床切點 | 一個把功能與失功能分數區隔開來的判準 |
| 分類 | 由 RCI 與切點共同決定:痊癒、改善、未改變或惡化 |
註:可靠改變問的是這個改變是否超出測量誤差;臨床顯著性 (clinical significance) 問的是這個人是否跨過了一個有意義的門檻。一個人可以只符合其中一項而不符合另一項,所以兩項都要報告。
10.5 確立「沒有改變」
一個不顯著的配對檢定並不能確立什麼都沒改變,因為未能拒絕虛無假設並不是支持它的證據,而一項小到偵測不出有意義改變的研究,不論真相如何都會例行地回報不顯著。要主張穩定,就必須直接去檢定它,而工具是等值檢定 (equivalence testing),具體而言是兩個單尾檢定 (two one-sided tests, TOST) 的程序 (Lakens, 2017; Lakens et al., 2018)。研究者要先指定一個等值區間 (equivalence region),也就是一個小到可以視為微不足道的改變範圍,由第 4 章那個最小關切效果量 (smallest effect size of interest) 決定,然後檢定觀察到的改變是否顯著地比兩端的界限都更靠近零。圖 10.7 把這個邏輯用在控制組的短期穩定性上:改變的90% 信賴區間完全落在 \(\pm 2\) 分的等值區間之內,所以這個改變顯著地小於最小關切效果,於是可以作出「等值」的結論,而不只是「沒能找到差異」。等值界限是關鍵,必須在分析之前由實質理由加以辯護,因為區間寬就容易宣告等值、區間窄就幾乎不可能;這個界限編碼的是「什麼才算沒有有意義的改變」,而那是一項科學判斷,不是統計判斷。
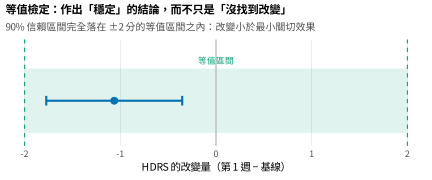
註:控制組短期改變的90% 信賴區間,完全落在 \(\pm 2\) 分的等值區間(底色區塊)之內。由於這個區間排除了兩端的等值界限,這個改變顯著地小於最小關切效果,因而可以作出等值的結論。這些等值界限 (equivalence bounds) 必須在分析之前就被辯護。
10.6 兩波之外:學不到的東西
無論分析得多麼小心,兩個時點都帶著一個硬性的限制:它們識別得出改變的量,卻識別不出改變的形狀,而且它們對後續各章所建模的個體內動態無話可說。圖 10.8 用三條基線相同、終點也相同、中間卻完全不同的軌跡把這個限制具體化:一條穩定下降,一條晚期驟降,一條早期驟降之後持平。一項兩波研究只測到兩個端點,因此無法區分這三種歷程,而它們在臨床與理論上都是不同的:一個穩定反應者、一個晚期反應者、與一個早期反應之後就持平的人,訴說的是關於機制與預後的不同故事。這不是分析的失敗,而是設計的失敗,也是本書要走出兩波的理由。它同時也讓第 3 章那個差異分數信度的問題復活:兩個不完美可靠的測量之差,可能比其中任何一個都更不可靠 (Cronbach & Furby, 1970; Rogosa, 1988);那個問題在該章已被平反,在此仍然相關,而它也為下一章的變異數分析方法與第四部的成長模型鋪路,而那些方法都需要三個以上的時點,才能識別出一條軌跡。
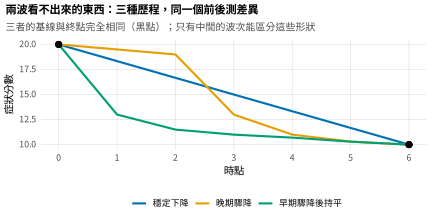
註:三條軌跡 (trajectory) 的基線值與終點值完全相同(黑點),形狀卻截然不同:穩定下降、晚期驟降,以及早期驟降之後進入高原。一個兩時點的設計只觀察到兩個端點,無法區分這些歷程;要區分它們需要三個以上的波次 (wave)。
10.7 在 R 中執行這些分析
實作的分析使用 base R,它的 t.test、wilcox.test 與 mcnemar.test 涵蓋了各種配對檢定,效果量則直接計算。配對檢定是對差異所作的單樣本檢定,而兩個效果量都報告只是兩行計算。
library(dplyr); library(tidyr)
rct <- readRDS("Examples/data/therapy_rct.rds")
pp <- rct |> filter(week
  pivot_wider(names_from = week, values_from = hdrs, names_prefix = "w",
              id_cols = c(patient_id, arm)) |>
  filter(!is.na(w0), !is.na(w11)) |> mutate(change = w11 - w0)

trt <- filter(pp, arm == "Treatment")
t.test(trt$w11, trt$w0, paired = TRUE)              # 對差異作的配對 t
dz  <- mean(trt$change) / sd(trt$change)            # 差異計量的 d
dav <- mean(trt$change) / mean(c(sd(trt$w0), sd(trt$w11)))   # 原始計量的 d
那三種兩組分析就是三個線性模型,而 Lord 悖論的重現方式,是把三個模型都配適到非等組資料上,再比較組別係數。
ld <- readRDS("Examples/data/lord_demo.rds")
lm(change ~ group, data = ld)                       # 變化分數分析
lm(post ~ pre + group, data = ld)                   # ANCOVA(調整前測)
lm(post ~ group, data = ld)                         # 只看後測
可靠改變指標是由量表信度直接算出來的,而分類則由指標與一個臨床切點決定。等值檢定就是兩個單尾檢定的程序,把一個90% 信賴區間與等值界限比較。
rel <- 0.86                                         # 已發表的量表信度
se_meas <- sd(pp$w0) * sqrt(1 - rel); s_diff <- sqrt(2) * se_meas
pp <- pp |> mutate(RCI = change / s_diff,
  class = case_when(RCI <= -1.96 & w11 <= 7 ~ "Recovered",
                    RCI <= -1.96            ~ "Improved",
                    RCI >=  1.96            ~ "Deteriorated",
                    TRUE                    ~ "Unchanged"))

# --- 等值檢定 (TOST):改變是否落在 +/- 2 分的區間內? ---
d <- na.omit(with(filter(rct, arm == "Control", week
                  tapply(hdrs, week, mean)))        # 示意用;詳見腳本
完整的分析,包括檢定力對相關的曲線、迴歸趨中與測量誤差的模擬,以及完整的可靠改變分類,都在隨附的 ch10_analysis_V01.R 之中。圖形由 ch10_figures_zh_V01.R 繪出,而悖論的資料存檔為 lord_demo。對使用圖形介面套件的讀者而言,effectsize 與 TOSTER 兩個套件分別可計算配對的效果量與等值檢定,並重現此處所示的數值。
軟體提示 • 效果量與等值檢定的工具
base R 涵蓋了本章的每一個檢定,但有兩個套件可以讓報告更順手。effectsize 套件可由一個已配適的配對檢定算出 \(d_z\)、\(d_{av}\) 與它們的信賴區間,免去把錯的分母配上錯的標籤的風險,它也為無母數檢定 (nonparametric test) 報告以等級為基礎的效果量。TOSTER 套件實作兩個單尾檢定的程序與它的檢定力分析,等值界限可以用原始單位或標準化單位給定。由點選式軟體 (point-and-click software) 轉過來的讀者,會在「成對樣本」選單下找到配對 \(t\)、在一般線性模型或迴歸選單下找到 ANCOVA;對應是精確的,但「依設計而不是依預設值來選擇變化分數或 ANCOVA」這個責任,仍然在分析者身上。
10.8 報告一項兩時點分析
一項兩時點的結果,報告時要有檢定、平均改變與它的區間、正確標示的效果量,而若是試驗,還要有 CONSORT 的參與者流程。這項試驗的示範段落可以這樣寫:「在 \(66\) 位有完整前後測資料的實驗組病人中,HDRS 分數由基線到第 12 週平均下降 \(12.67\) 分,\(t(65) = 17.1\),\(p < .001\),效果很大(\(d_{av} = 2.38\);\(d_z = 2.12\)),差異計量與原始計量的標準化效果分開報告。控制組下降 \(6.80\) 分(\(95\%\) CI \([5.40, 8.20]\))。由於本試驗經過隨機化,組間比較採用以基線為共變項的共變數分析,那是兩種不偏分析中檢定力較高的一種。個體的改變以可靠改變指標分類,採用已發表的信度 \(.86\)(\(S_{\mathrm{diff}} = 2.74\));\(66\) 位實驗組病人中有 \(30\) 位痊癒、另有 \(31\) 位可靠地改善,對照之下控制組分別為 \(8\) 位與 \(32\) 位。」每一個元素都在,效果量沒有混淆,而選擇 ANCOVA 的理由來自設計、不是斷言。下面的陷阱方塊收錄了這樣的報告所避開的錯誤。
常見陷阱 • 兩時點分析的三個錯誤
第一,拿 \(d_z\) 去做後設分析:由於 \(d_z\) 會被前後測相關膨脹,把它放進組間效果的後設分析會高估效果,有時嚴重高估;請報告並併計 \(d_{av}\) 或一個已對相關校正的效果量。第二,把「控制基線」當成理所當然的美德:在非等組設計中,對一個組間本來就不同的基線作調整,估計的是一個可能並不存在的反事實 (counterfactual),而在前測不可靠時它還會調整不足(圖 10.5);這項調整必須由設計來論證,而當審查者反射性地要求它時,站得住腳的回應是援引 Lord 悖論與爭議中的那個估計標的。第三,用錯信度的可靠改變指標:採用來自不同量表、不同樣本或不同間隔的信度,會讓每一個分類都失準,所以那個係數必須與手上的工具與母體相符。
10.9 常見的迷思
關於兩時點分析,有幾個信念會誤導。第一個是配對 \(t\) 檢定要求結果變項服從常態分配;它只要求差異分數近似常態,而且在中等樣本下對輕微的偏離相當穩健。第二個是ANCOVA 永遠優於變化分數;兩者估計的是不同的量,而在非等組之下這個「優越」的主張是空的,因為根本沒有一個不帶假設的答案,Lord 悖論已經說明了這一點。第三個是一個不顯著的前後測檢定就表示沒有發生改變;證據的缺席不是缺席的證據,而一項關於穩定的主張需要一個帶有已辯護界限的等值檢定。第四個是一個顯著的可靠改變指標就代表臨床上有意義的痊癒;可靠改變與臨床顯著性是兩個各自獨立的判準,一個人可以可靠地改變、卻沒有跨過任何有意義的門檻。一個反覆出現的實務問題,也就是「在觀察性的前後測設計中,審查者要求作基線調整時該怎麼回應」,答案不是拒絕,而是把估計標的講明白:說出那項調整所假設的是哪一個反事實、顯示設計是否支持它,並在平行趨勢之下提出變化分數分析作為互補的估計標的 (Allison, 1990; Holland & Rubin, 1983)。
本章摘要
兩時點的設計無所不在、也很有教育意義,而它們的核心啟示是:分析把問題編碼了進去。配對 \(t\) 檢定是對差異分數 (difference score) 所作的單樣本檢定,它的檢定力優勢來自把個體間變異數差分掉,而這個優勢隨著前後測相關增大(圖 10.1、10.2);Wilcoxon 檢定與 McNemar 檢定處理非常態與二元的結果,各自帶著自己的假設。配對的效果量有差異計量的 \(d_z\) 與原始計量的 \(d_{av}\) 兩種,絕不可混淆,因為 \(d_z\) 會隨相關而膨脹並污染後設分析。變化分數對共變數分析的爭議由 Lord 悖論戲劇化:同一批非等組資料在改變上沒有組間差異,用 ANCOVA 卻有很大的差異(圖 10.3),因為兩種分析假設的是不同的反事實;迴歸趨中與前測的測量誤差讓這項調整更加複雜(圖 10.4、10.5),而必須由設計來選出估計標的。個體的改變以可靠改變指標對照測量誤差與一個臨床切點 (clinical cutoff) 來分類(圖 10.6),穩定性由等值檢定而不是由一個不顯著的結果來確立(圖 10.7),而兩個波次無論怎麼分析,都只識別得出改變的量、識別不出它的形狀(圖 10.8)。
接下來讀哪裡
兩時點的情形是後續一切的種子。配對 \(t\) 檢定是最簡單的個體內模型,一個對差異分數只含截距的模型,而下一章把它推廣到三個以上的時點,用的是重複量數變異數分析;第四部則把兩者都重新表述為混合模型的特例,其中變化分數與共變項調整重新出現為建模的選擇,而不是彼此分立的程序。變化分數分析的差異中的差異邏輯,會在第 20 與 21 章的交叉延宕追蹤模型爭論中回來,同樣的估計標的爭議在那裡是在潛在層次上開打;而「以一個無誤差的潛在前測來調整」的理據,由第 19 到 21 章的結構方程方法接手。可靠改變與臨床顯著性的想法會在第 33 章的臨床應用中再度出現。往前帶著的唯一啟示是:兩種站得住腳的分析可以回答不同的問題,而分析者的第一項責任,是在選模型之前先把問題講清楚。
習題
- 10.1 它們何時一致。以代數證明:當兩組的基線平均數相等、且組內「後測對前測」的迴歸斜率為一時,變化分數估計式與共變數分析估計式所得的組間差異相等,並指出隨機化保證的是哪一個假設。
- 10.2 重現這個悖論。就所提供的
lord_demo資料,執行三種兩組分析,說出每一方會提出的主張,再藉由把反事實假設講明白來裁決它們。 - 10.3 一次完整的配對分析。就
therapy_rct的其中一組,執行配對檢定,報告兩個標準化效果量與它們的區間,並產出斜率圖與差異的分配圖。 - 10.4 可靠改變。在兩個不同的信度係數之下,把所有病人依可靠改變指標分類,並報告有多少個分類改變了、往哪個方向改變。
- 10.5 設計一項等值檢定。針對「停止治療之後沒有惡化」這個主張,由一個最小關切效果辯護出等值界限,並說明兩個單尾檢定的程序需要多大的樣本,才能以足夠的檢定力偵測到等值。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 差異分數 | difference score | 同一個人前後兩次測量之差;第 10.1 節 |
| 配對 \(t\) 檢定 | paired \(t\) test | 對差異分數所作的單樣本 \(t\) 檢定;第 10.1 節 |
| 符號等級檢定 | Wilcoxon signed-rank test | 檢定差異的分配是否對稱於零;第 10.1 節 |
| 符號檢定 | sign test | 只問上升是否多於下降;第 10.1 節 |
| McNemar 檢定 | McNemar’s test | 配對二元結果的兩種轉換是否等頻;第 10.1 節 |
| 差異計量效果量 | difference-metric effect size (\(d_z\)) | 平均改變除以差異的 SD;隨相關膨脹;第 10.2 節 |
| 原始計量效果量 | raw-metric effect size (\(d_{av}\)) | 平均改變除以前後測 SD 的平均;第 10.2 節 |
| 變化分數 | change score | 兩組設計中作為結果變項的改變量;第 10.3 節 |
| 共變數分析 | analysis of covariance (ANCOVA) | 調整前測之後比較後測;第 10.3 節 |
| 非等組 | nonequivalent groups | 兩組在基線就有系統性差異;第 10.3 節 |
| Lord 悖論 | Lord’s paradox | 同一批資料兩種分析得到相反判決;第 10.3 節 |
| 平行趨勢 | parallel trends | 無效果時兩組會改變同樣多的假設;第 10.3 節 |
| 差異中的差異 | difference-in-differences | 平行趨勢之下的組間改變對比;第 10.3 節 |
| 迴歸趨中 | regression to the mean | 極端分數重測時趨向平均數;第 10.3 節 |
| 調整不足 | under-adjustment | 共變項有誤差時 ANCOVA 消不掉基線差異;第 10.3 節 |
| 可靠改變指標 | reliable change index (RCI) | 個體改變除以差異的標準誤;第 10.4 節 |
| 測量標準誤 | standard error of measurement | \(s_1\sqrt{1 - r_{xx}}\);第 10.4 節 |
| 臨床切點 | clinical cutoff | 區隔功能與失功能範圍的判準;第 10.4 節 |
| 臨床顯著性 | clinical significance | 是否跨過有意義的門檻;第 10.4 節 |
| Jacobson–Truax 分類 | Jacobson–Truax classification | 痊癒/改善/未改變/惡化四類,由 RCI 與臨床切點共同決定;第 10.4 節 |
| 等值檢定 | equivalence testing (TOST) | 直接檢定改變小於最小關切效果;第 10.5 節 |
| 等值區間 | equivalence region | 小到可視為微不足道的改變範圍;第 10.5 節 |
參考文獻
Allison, P. D. (1990). Change scores as dependent variables in regression analysis. Sociological Methodology, 20, 93–114. https://doi.org/10.2307/271083
Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299
Cronbach, L. J., & Furby, L. (1970). How we should measure “change”: Or should we?. Psychological Bulletin, 74(1), 68–80. https://doi.org/10.1037/h0029382
Dunlap, W. P., Cortina, J. M., Vaslow, J. B., & Burke, M. J. (1996). Meta-analysis of experiments with matched groups or repeated measures designs. Psychological Methods, 1(2), 170–177. https://doi.org/10.1037/1082-989X.1.2.170
Holland, P. W., & Rubin, D. B. (1983). On Lord’s paradox. In H. Wainer & S. Messick (Eds.), Principals of modern psychological measurement: A festschrift for Frederic M. Lord (pp. 3–25). Lawrence Erlbaum Associates.
Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12–19. https://doi.org/10.1037/0022-006X.59.1.12
Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
Morris, S. B., & DeShon, R. P. (2002). Combining effect size estimates in meta-analysis with repeated measures and independent-groups designs. Psychological Methods, 7(1), 105–125. https://doi.org/10.1037/1082-989X.7.1.105
Rogosa, D. R. (1988). Myths about longitudinal research. In K. W. Schaie, R. T. Campbell, W. Meredith, & S. C. Rawlings (Eds.), Methodological issues in aging research (pp. 171–209). Springer.
Senn, S. (2006). Change from baseline and analysis of covariance revisited. Statistics in Medicine, 25(24), 4334–4344. https://doi.org/10.1002/sim.2682
van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007