第 19 章
潛在成長曲線模型
第 14 章把成長寫成多層次模型 (multilevel model),個人特有的截距與斜率是從一個分配裡抽出來的。本章把同一批成長寫成結構方程模型 (structural equation model),截距與斜率改設想為潛在因素 (latent factor),而重複測量的分數負荷 (load) 在這兩個因素上。在假設相配的前提下,兩者是同一個模型。本章刻意與第 14 章亦步亦趨,用同一份資料、同樣的編碼決定,好讓「兩者等價」這件事是讀者自己驗證出來的,而不是被要求相信的。重點不在於哪一個架構 (framework) 比較好,而在於它們是同一種語言的兩種方言 (dialect):兩種都通的研究者,可以挑那個「用起來比較合乎這個問題」的來用。結構方程這一種方言有它自己的餽贈:它天生就以平均數結構 (mean structure) 與整體配適 (global fit) 來思考,它讓成長因素 (growth factor) 在更大的變項系統裡同時擔任預測項與結果變項,它輕鬆地配適多個群組與多個平行歷程 (parallel process),而且它以放開的負荷量 (freed loading) 直接估計改變的形狀。多層次那一種方言則有另一批餽贈,其中最主要的是它毫不費力地處理個別不同的測量時點 (individually varying measurement times)。等價性 (equivalence) 與它的例外是本章的思想核心;其餘的一切,條件模型 (conditional model)、多群組比較、平行歷程,都是從「把成長看成加在重複測量的平均數與共變數上的一組限制」這個看法推出來的。
學習目標
讀完本章之後,你應該能夠:(1) 設定一個帶平均數結構 (mean structure) 的線性潛在成長曲線模型 (latent growth curve model),並解讀截距因素與斜率因素的平均數、變異數與共變數;(2) 依波次數目與成長形式陳述其識別 (identification) 要求;(3) 把一個多層次成長模型翻譯成潛在曲線模型 (latent curve model) 再翻譯回來,並列舉兩者等價的條件、以及兩者分道揚鑣的地方;(4) 評估一個成長模型的配適,並在平均數結構中定位配適不良 (misfit);(5) 在條件成長模型中加入共變項與遠端結果變項 (distal outcome);(6) 以一套限制檢定序列配適多群組 (multiple-group) 成長模型;(7) 配適平行歷程模型,並以應有的謹慎解讀其斜率與斜率的關聯;(8) 以放開的負荷量估計一個非線性的形狀。
19.1 從路徑圖說起這個模型
潛在成長曲線模型 (latent growth curve model),或稱潛在曲線模型 (latent curve model),以兩個潛在因素來表示每個人的軌跡 (trajectory)。一個是截距因素 (intercept factor),每一次重複測量都以固定為一的負荷量 (loading) 負荷在它上面,因此它代表各時點共有的那個水準;另一個是斜率因素 (slope factor),它的負荷量固定為時間編碼 (time code),第一個時點為零、第二個時點為一,依此類推,因此它代表每單位時間的線性變化。圖 19.1 為五個波次畫出這個模型。某個人在某個時點的分數,就是截距因素加上斜率因素乘以該時點的時間編碼,再加上一個殘差 (residual);在代數上,這正是第 14 章那條個人特有的直線,只是改寫成因素模型 (factor model) 的樣子。對熟悉結構方程的讀者來說,真正陌生的是平均數結構 (mean structure)。一般的因素分析只模型化各指標之間的共變數,把它們的平均數擱在一旁;成長模型卻非模型化平均數不可,因為平均軌跡,也就是平均的起始水準與平均的改變速率,正是研究的首要對象。因素平均數 (factor mean),也就是截距因素的平均數與斜率因素的平均數,承載的是平均軌跡;因素變異數 (factor variance) 承載的是繞著平均軌跡的個別差異;而因素之間的共變數 (covariance) 承載的則是兩者的關聯。對於只受過共變數取向因素分析訓練的人,這是一道概念上的門檻,而它值得耐心跨過:成長模型是一個把平均數與共變數合在一起處理的模型。
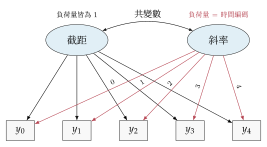
註:截距因素以固定為一的負荷量負荷在每一個時點上;斜率因素的負荷量則是時間編碼 (\(0,1,2,3,4\))。因素平均數(圖上未畫)承載平均軌跡,因素變異數承載個別差異,因素之間的共變數承載兩者的關聯。為求清楚,各指標的殘差略去未畫。這個模型就是第 14 章那條個人特有的直線,改寫成因素模型的樣子。
這樣看這個模型,會顯露出它最深的一項特徵:成長模型是一組加在動差上的限制 (constraints on the moments)。這個因素結構為觀察到的重複測量隱含 (imply) 出一個特定的平均數向量與共變數矩陣,其中平均數呈線性成長,而變異數則依截距變異數、斜率變異數以及兩者的共變數而向外展開或向內收攏。配適這個模型,檢定的就是「觀察到的平均數與共變數是否吻合那個隱含的結構」;圖 19.2 在本章的示範資料上展示了這個吻合:模型隱含的平均數以直線穿過觀察平均數,而隱含的變異數也追上了觀察到的扇形展開。這個「隱含動差」的視角,正是結構方程取向之所以能做整體配適檢定 (global fit test) 的動力來源,因為觀察動差與隱含動差之間的差距,恰恰就是各項配適指標所量化的東西。在 lavaan 中,這個模型可以透過便利函式 growth 來寫,它會自動設好截距與斜率的負荷量以及因素平均數;也可以手寫。本章先教手寫的設定,好讓那份便利是被理解的,而不是被信任的。
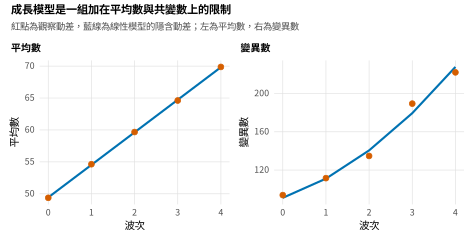
註:觀察動差(紅點)對線性潛在曲線模型的隱含動差(藍線)。這個模型同時重現了線性成長的平均數與向外展開的變異數。成長模型把平均數向量與共變數矩陣合在一起加以限制,而各項配適指標量化的就是觀察值與隱含值之間的差距。
19.2 識別與資料需求
因為成長模型是一組加在動差上的限制,它的識別 (identification) 就是一件「數已知量、數未知量」的事。已知量是觀察到的動差:有 \(T\) 個波次時,就有 \(T\) 個平均數與 \(T(T+1)/2\) 個變異數與共變數。未知量是模型參數:兩個因素平均數、兩個因素變異數、它們的共變數,以及各殘差變異數。表 19.1 把這筆算術算了出來。帶平均數結構的線性模型在三個波次時是可以識別的,但也只是剛好而已,不留下自由度 (degree of freedom) 來檢定成長形式,所以三個波次配得出一條直線,卻無法裁決這條直線是不是對的。四個波次是裁決形式的誠實下限,非線性的形狀則愈多愈好。另一個獨立的問題是經驗上的不可識別 (empirical underidentification):當斜率變異數真的接近零時,資料裡幾乎不帶關於它的訊息,估計就可能給出一個負的變異數估計值,也就是一個 Heywood 案例 (Heywood case)。這是第 13 章那個邊界問題 (boundary problem) 換上結構方程的外衣,回應的方式也一樣:診斷這個負的估計值究竟反映的是一個真正接近零的變異數、是抽樣雜訊,還是模型設定錯誤 (misspecification),然後以加限制、簡化模型,或如第 17 章所示改用能把變異數留在合法範圍內的貝氏估計 (Bayesian estimation) 來回應,而不是慌張,也不是盲目地把估計值固定為零。
表 19.1 依波次數目與成長形式所做的識別算術。
| 波次 | 已知的動差 | 線性模型的參數 | 後果 |
|---|---|---|---|
| 三 | \(3 + 6 = 9\) | \(6\) | 對一條直線恰好識別;無從檢定形式 |
| 四 | \(4 + 10 = 14\) | \(6\) | 有自由度可以檢定形式 |
| 五或更多 | 增加得很快 | \(6\)(線性) | 有餘裕容納二次式、潛在基底與殘差的自由度 |
註:已知的動差是 \(T\) 個平均數加上 \(T(T+1)/2\) 個變異數與共變數;線性模型有兩個因素平均數、兩個變異數、一個共變數,以及各殘差變異數。三個波次識別得出一條直線,卻不留下東西來檢定它的形狀;要裁決成長形式,需要四個或更多波次。
19.3 等價性的重頭戲
「多層次架構與潛在曲線架構配適的是同一個模型」這項主張,最好是示範出來,而不是宣稱出來。把第 14 章那個無條件線性成長模型 (unconditional linear growth model) 用兩種方式配適在同一份資料上,一次是 lme4 裡的混合模型 (mixed model),一次是 lavaan 裡的潛在曲線模型,得到的估計值完全相同。圖 19.3 把兩者對畫起來:每一個參數,截距與斜率的平均數、它們的變異數與共變數,以及殘差變異數,都精準地落在等值線 (line of equality) 上,吻合到小數第三位。表 19.2 是那本雙語辭典,把每個參數的名稱在兩個架構之間互譯。這個等價性成立於一些特定條件之下,值得把條件說清楚,因為條件被違反的地方,正是兩個架構分道揚鑣的地方:時間編碼必須對每個人都相同,而且殘差結構必須相配,通常是各波次共用單一個殘差變異數。當這些條件成立時,兩者就是同一個模型、由同一個概似 (likelihood) 估計出來,而在兩者之間做選擇只是方便與否的問題。
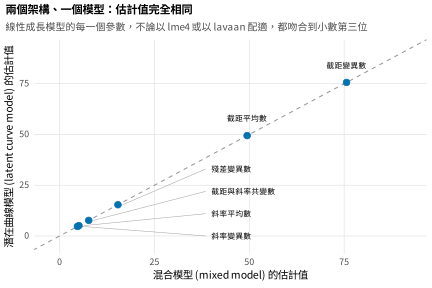
註:無條件線性成長模型的每一個參數,分別以混合模型(橫軸)與潛在曲線模型(縱軸)估計,對畫在等值線上。每一個參數都吻合到小數第三位。當時間編碼與殘差結構相配時,這兩個架構是同一個模型的兩種方言。
表 19.2 多層次與潛在曲線兩套語彙的對照表。
| 多層次模型 | 潛在曲線模型 |
|---|---|
| 固定截距 (fixed intercept) | 截距因素的平均數 |
| 固定斜率 (fixed slope) | 斜率因素的平均數 |
| 隨機截距的變異數 (random-intercept variance) | 截距因素的變異數 |
| 隨機斜率的變異數 (random-slope variance) | 斜率因素的變異數 |
| 截距與斜率的共變數 | 截距因素與斜率因素的共變數 |
| 殘差變異數 (residual variance) | 指標的殘差變異數 |
註:同樣的六個量,在兩個架構裡有不同的名字。能在兩邊都讀得流利,是本章要建立的實用技能;只要模型設定相配,數字就是一樣的。
這個等價性有它的邊界,而走一趟這些邊界,就看得出各架構分別提供了什麼。多層次架構天生就能處理個別不同的測量時點 (individually varying measurement times),因為時間是以一個數值預測項的身分進入模型的,而它可以因人而異;標準的潛在曲線模型卻把時間編碼固定在負荷量裡,因而假定了一份共同的測量時程。要在結構方程架構裡容納不同的測量時點,需要定義變項 (definition variable),讓每個人的負荷量等於他自己的測量時間;有些程式提供這項功能,另一些則沒有,而這是後者真正的限制 (Mehta & Neale, 2005; Mehta & West, 2000)。反過來,結構方程架構供應了多層次架構所欠缺的一整套整體配適的做法 (global fit machinery),而這並非閒置的裝飾,因為它偵測得到成長形式的設定錯誤,而多層次模型並不把隱含的共變數結構拿去對照觀察值,因此可能漏掉。結構方程架構還能把成長因素嵌進更大的結構系統 (larger structural systems) 裡,讓一個斜率因素去預測一個遠端結果變項,或去中介 (mediate) 一個效果,而這是多層次架構無法直接做到的。兩者都處理得了有結構的殘差,只是操作起來的手感不同;兩者在有遺漏資料時也都預設使用完全訊息最大概似 (full-information maximum likelihood)。表 19.3 是那份決策指南,而本書的立場是雙語:這兩個架構是方言,不是教派 (Bauer, 2003; Curran, 2003; McNeish & Matta, 2018)。
基礎概念 • 隱含動差與等價性
對一個時間編碼為 \(a_t\) 的線性模型,波次 \(t\) 的隱含平均數是 \(\mu_t = \gamma_I + \gamma_S a_t\),其中 \(\gamma_I\) 與 \(\gamma_S\) 是截距因素與斜率因素的平均數,所以隱含平均數是時間編碼的一條直線。波次 \(s\) 與 \(t\) 之間的隱含共變數是 \(\tau_{II} + (a_s + a_t)\tau_{IS} + a_s a_t\,\tau_{SS} + \sigma^2\mathbb{1}(s=t)\),其中 \(\tau_{II}\)、\(\tau_{SS}\) 與 \(\tau_{IS}\) 是因素的變異數與共變數,而 \(\sigma^2\) 是殘差變異數。這正是第 13 章為隨機斜率混合模型 (random-slope mixed model) 推導出來的邊際共變數 \(\mathbf{Z}\mathbf{T}\mathbf{Z}' + \sigma^2\mathbf{I}\),其中 \(\mathbf{Z}\) 是時間編碼構成的矩陣,\(\mathbf{T}\) 是因素的共變數矩陣。因此這兩個架構加在資料上的平均數向量與共變數矩陣是同一個,而以同一個最大概似 (maximum likelihood) 準則配適,回傳的估計值也就是同一組。等價性恰恰在這兩個隱含結構不再相同時破裂:當時間編碼因人而異、\(\mathbf{Z}\) 不再共通時,或當殘差結構偏離 \(\sigma^2\mathbf{I}\)、而其偏離方式只有一個架構參數化得出來時。
表 19.3 在多層次架構與結構方程架構之間做選擇。
| 以下情況偏向多層次架構 | 以下情況偏向結構方程架構 |
|---|---|
| 測量時間因人而異 | 成長形式必須拿去對照整體配適來檢定 |
| 時點多而且不平衡 | 成長因素要去預測或中介其他變項 |
| 巢套層次有三層或更多 | 要比較多個群組或多個平行歷程 |
| 問題問的是固定效果與隨機效果 | 要把改變的形狀估計出來(潛在基底) |
註:兩個架構在常見情況下等價,在邊緣處分道揚鑣。多層次架構擅長不平衡的設計與因人而異的測量時間;結構方程架構擅長整體配適、結構上的嵌入,以及多群組與平行歷程的延伸。流利的研究者兩邊都用。
19.4 成長模型的配適評估
因為成長模型把平均數與共變數合在一起加以限制,它的配適指標帶著多層次架構不會浮現的訊息,但這些指標必須小心地讀。比較配適指標 (comparative fit index, CFI) 偏低或近似均方根誤差 (root mean square error of approximation, RMSEA) 偏大,訊號是隱含動差與觀察動差不吻合,而第一個要做的診斷問題是「不吻合在哪裡」:成長模型的配適不良常常出在平均數結構,也就是平均軌跡的形狀不對,而不是出在共變數。鑑識的工具是檢視殘差動差 (residual moments),也就是觀察平均數與隱含平均數之差、以及觀察共變數與隱含共變數之差,用它們把差距定位出來。圖 19.4 在一個減速 (decelerating) 的結果變項上示範了這項診斷,該變項是以線性模型配適的:線性模型的隱含平均數系統性地彎離觀察平均數,在中段高估、在兩端低估,這正是成長形式選錯的指紋;而一個把形狀估計出來的模型則重現了那些平均數。各項配適指標的判準帶著第 18 章已經演練過的同一批告誡,也就是它們是從特定條件推出來的經驗法則;在這裡它們還對樣本數以及斜率變異數的大小敏感。成長形式的巢套模型 (nested models),線性對放開負荷量的形狀對二次式,以卡方差異 (chi-square difference) 與訊息準則 (information criteria) 來比較。表 19.4 是那套流程;而一個一再出現的教訓是,整體配適良好並不能認證成長形式是對的,只能說所選的形式沒有被明顯推翻 (Wu et al., 2009)。
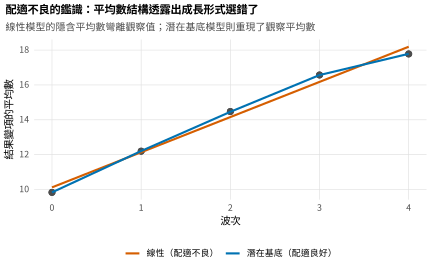
註:一個減速結果變項的觀察平均數(灰點),對線性模型(紅)與潛在基底(放開負荷量)模型(藍)的隱含平均數。線性模型的隱含平均數彎離觀察值,這是成長形式設定錯誤的特徵,而它坐落在平均數結構裡;放開負荷量的模型則重現了那些平均數。要定位成長模型的配適不良,就去檢視殘差動差。
表 19.4 成長模型的配適評估流程。
| 步驟 | 要做的事 |
|---|---|
| 整體指標 | 把卡方、CFI、RMSEA 與標準化均方根殘差 (standardized root mean square residual, SRMR) 對照判準來讀,當成診斷而不是判決 |
| 定位配適不良 | 檢視殘差平均數與殘差共變數,找出模型偏離的位置 |
| 平均數還是共變數 | 判定配適不良是出在軌跡的形狀,還是出在個別差異 |
| 比較各種形式 | 以卡方差異與訊息準則檢定線性對潛在基底對二次式 |
| 守住結論 | 記得配適良好並不認證成長形式 |
註:成長模型的配適不良常常出在平均數結構,因此檢視殘差動差是必要的一步。各項配適指標對樣本數與斜率變異數的大小都敏感,而配適良好對於「成長形式正確」是必要條件,不是充分條件。
19.5 條件模型與成長的後果
條件成長模型 (conditional growth model) 加入預測成長因素的共變項,它是第 14 章那些跨層次交互作用 (cross-level interaction) 在結構方程裡的對應物,同一個估計標的 (estimand),換了一身衣服。把一個時間不變共變項 (time-invariant covariate) 迴歸到截距因素與斜率因素上,得到的就是它對起始水準的效果與對改變速率的效果;圖 19.5 畫出共變項取數個值時的預測軌跡,它們之所以發散,是因為該共變項把斜率拉高了。在本章的示範資料上,共變項對斜率因素的效果還原了它的真值。時間變動共變項 (time-varying covariate) 則以時點特定預測項的身分進入重複測量,帶著第 14 章已經演練過的同一批警告,也就是一個隨時間有趨勢的共變項,可能把它本該與之並列的那份成長給吸收掉。結構方程架構特有的延伸,是把成長因素放成遠端結果變項的預測項 (predictors of a distal outcome),也就是那個「以斜率為預測項」的模型,讓改變的速率去預測一個較晚的結果。這件事既有力量也有危險:斜率因素是帶著誤差被估出來的,所以它的信度 (reliability) 限定了它能預測到什麼程度;而且時間窗 (time window) 很要緊,因為若用來測量改變的那段區間與結果變項本身重疊,預測就有循環論證 (circularity) 之虞。這些告誡,是結構方程架構那份伸展能力的代價。
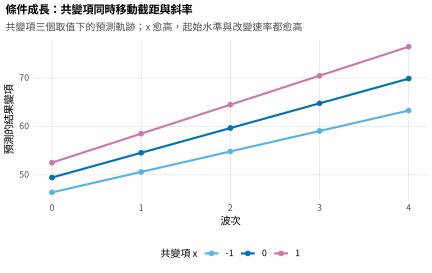
註:一個被迴歸到截距因素與斜率因素上的時間不變共變項,在三個取值下的預測軌跡。共變項的值愈高,起始水準與改變速率都愈高,因此軌跡發散。這是第 14 章那個跨層次交互作用在潛在曲線裡的對應物。
19.6 多群組成長
在多個群組 (multiple groups) 中配適成長模型,是在比較不同群組的軌跡,例如一項試驗的兩組,而它把治療效果變成斜率因素平均數的差異。圖 19.6 畫出第 14 章那個治療試驗中各組的配適軌跡,此處改以多群組潛在曲線模型分析,並以完全訊息最大概似處理中途退出 (dropout);實驗組下降得比較陡,斜率比控制組每週約快一分,這個差別就是治療效果。分析依一套限制檢定序列進行,從一個各組成長形式自由的形貌模型 (configural model),走到一個限制各組成長因素平均數相等的模型,而對這項限制所做的檢定,就是對治療效果所做的檢定,在此處它斬釘截鐵地拒絕了相等。表 19.5 把這套序列列了出來。這個多群組的參數化,與第 14 章條件模型裡那個「組別乘週次」的交互作用完全等價;治療效果在一個架構裡現身為交互作用,在另一個架構裡現身為斜率平均數的組間差異,而再一次示範這種等價性,正是雙語紀律的一部分。當構念是以多道題目測量時,這項比較還倚賴第 18 章的測量恆等性 (measurement invariance);而完整的鏈條,也就是以恆等的測量支撐可比較的成長因素,是第 20 章要發展的二階成長模型 (second-order growth model)。
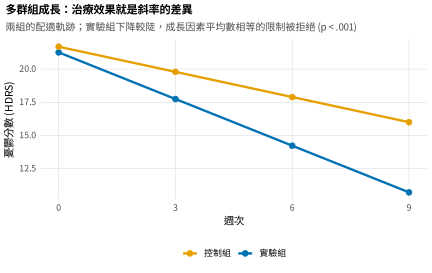
註:治療試驗兩組的配適軌跡,來自一個以完全訊息最大概似估計的多群組潛在曲線模型。實驗組下降得比較快,而限制兩組成長因素平均數相等的檢定被拒絕,因而確立了治療效果。這個參數化與第 14 章的「組別乘週次」交互作用等價。
表 19.5 多群組成長的限制序列。
| 模型 | 跨組限制什麼 | 檢定什麼 |
|---|---|---|
| 形貌 (configural) | 不限制(形式相同) | 那個形式在各組是否都成立 |
| 變異數相等 | 因素變異數 | 成長的個別差異是否相等 |
| 平均數相等 | 因素平均數 | 平均軌跡是否相等(組別效果) |
註:治療效果或組別效果,就是「成長因素平均數相等」這項限制的檢定。當結果變項是多題目構成時,必須先成立測量恆等性(第 18 章),而完整的鏈條是第 20 章的二階成長模型。
19.7 平行歷程成長
平行歷程模型 (parallel-process model) 同時配適兩個領域的成長,並估計它們的成長因素之間的關聯,其中包括斜率與斜率的共變數 (slope-slope covariance),它問的是「一個領域的變化是否伴隨著另一個領域的變化」。圖 19.7 把兩個結果變項的估計成長斜率對畫起來,呈現正的關聯:第一個結果變項長得比較快的人,第二個結果變項也傾向長得比較快。這裡在解讀上的告誡是必要的,而且很容易被忘記。斜率與斜率的相關是一項關於相伴的變化 (correlated change) 的陳述,說的是兩個歷程在人與人之間一起移動,它並不是「其中一個歷程帶動另一個」的證據。要確立哪一個歷程領先,需要一個關於時間動態 (temporal dynamics) 的模型,也就是一個靜態關聯揭示不出來的領先落後的結構;而那正是第 20 章與第 21 章的潛在變化分數模型 (latent change score model) 與交叉延宕追蹤模型 (cross-lagged panel model)、以及密集縱貫那一部的動態模型所要提供的東西。平行歷程模型描述那份耦合 (coupling),它並不解釋那份耦合;把它當成解釋來報告,是一種常見的越權。
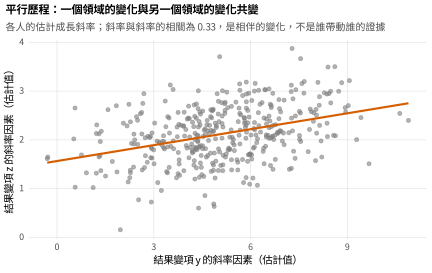
註:兩個結果變項在各人身上的估計成長斜率,以及它們之間的正向關聯。斜率與斜率的相關描述的是相伴的變化,也就是兩個歷程一起移動,它不是「其中一個帶動另一個」的證據。要確立方向,需要後續各章的動態模型。
19.8 潛在基底成長
當改變的形狀未知時,結構方程架構可以把它估計出來,而不是把它強加上去,做法是使用潛在基底 (latent basis) 模型,也稱放開負荷量 (freed-loading) 模型。第一個與最後一個斜率負荷量被固定為零與一,好讓斜率因素代表「從第一個時點到最後一個時點的總變化量」;中間各個負荷量則被放開來估計,於是每一個中間負荷量就是「到那個波次為止已經發生的總變化比例」。圖 19.8 在一個減速的結果變項上呈現了結果:放開的負荷量還原了真實的非線性形狀,而且它們與線性模型會強加的等距明顯不同。在本章的示範資料上,潛在基底模型配適得比線性模型好,與二次式模型相當,而且用的參數比較少。放開負荷量這個做法確實有力量,它給出一個可解讀的「變化比例」讀法,也能適應任何單調 (monotone) 的形狀,但它帶著陷阱。它會佔機遇的便宜 (capitalize on chance),配到的是這一份樣本特有的形狀,因此估計出來的基底應該做交叉驗證 (cross-validation) 或有理論依據;而且要跨組比較潛在基底,必須把負荷量加上限制,因為一組不受限制、而且各組不同的基底,會把「形狀的差異」與「變化之測量方式的差異」混在一起。在這些告誡之下使用,潛在基底往往比多項式 (polynomial) 更可取,因為多項式強加一個僵硬的函數形式,而且外推 (extrapolate) 得很差。
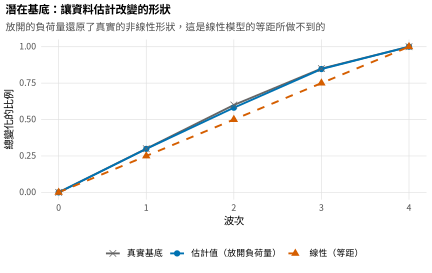
註:估計出來的放開負荷量(藍)、真實的形狀(灰),以及線性模型所強加的等距(紅),都以「到該波次為止的總變化比例」表示。放開的負荷量還原了真實的非線性形狀,而這是線性模型做不到的。每一個中間負荷量都讀作「到那個波次為止已達成的總變化比例」。
19.9 報告一項潛在成長分析
一項潛在成長分析要報告到讓它的限制與選擇都清晰可讀,而表 19.6 是那份檢核表。報告陳明時間編碼及其原點 (origin),因為每一個與截距有關的量都取決於它,這一點與第 14 章完全相同;指名成長形式,以及選擇該形式的依據;給出因素平均數、變異數與共變數,並解讀其中的平均軌跡與個別差異;報告整體配適,並在配適不完美時附上殘差動差的診斷;描述遺漏資料的處理方式;而對於條件模型、多群組模型或平行歷程模型這些延伸,則報告相應的係數、限制檢定或因素之間的關聯,連同它們的告誡。在兩個架構等價的地方,註明它與多層次參數化的對應關係,有助於雙語的讀者群。
表 19.6 潛在成長分析的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 時間編碼與原點 | 所用的計量、單位,以及時間在哪裡等於零 |
| 成長形式 | 形狀,以及選擇它的依據 |
| 因素平均數 | 平均截距與平均斜率,也就是平均軌跡 |
| 因素變異數與共變數 | 個別差異及其關聯,並註明是在哪一個原點下 |
| 配適與配適不良 | 整體指標,以及殘差動差的診斷 |
| 遺漏資料 | 所用的估計式,通常是完全訊息最大概似 |
| 延伸 | 條件係數、限制檢定或因素關聯,連同告誡 |
註:這份檢核表把第 14 章的成長模型報告要求,延伸到結構方程特有的那些量:整體配適及其定位,以及因素的參數化。註明與多層次的對應關係,是為了服務雙語的讀者群。
19.10 在 R 中執行潛在成長模型
lavaan 套件透過便利函式 growth 配適這個模型,它會設好截距與斜率的負荷量並估計因素平均數;也可以透過手寫語法,把每一項限制都寫得明明白白。
library(lavaan)
lgm <- '
  I =~ 1*y0 + 1*y1 + 1*y2 + 1*y3 + 1*y4      # 截距:負荷量全為 1
  S =~ 0*y0 + 1*y1 + 2*y2 + 3*y3 + 4*y4      # 斜率:負荷量 = 時間編碼
  y0 ~~ r*y0; y1 ~~ r*y1; y2 ~~ r*y2         # 殘差相等,以配合混合模型
  y3 ~~ r*y3; y4 ~~ r*y4
  I ~ 1; S ~ 1                                # 平均數結構:因素平均數 '
# 或 sem(lgm, ..., meanstructure = TRUE)
fit <- growth(lgm, data = wide)
summary(fit, fit.measures = TRUE, standardized = TRUE)
條件模型、多群組模型、平行歷程模型與潛在基底模型,都是這套語法的小幅延伸:共變項就是把它迴歸到兩個因素上 (I ~ x; S ~ x);群組比較用 group 與 group.equal 兩個引數;平行歷程就是再加一對因素;而潛在基底則是把中間的負荷量放開 (S =~ 0*y0 + NA*y1 + NA*y2 + NA*y3 + 1*y4)。
growth(lgm, data = wide, group = "arm", missing = "fiml")   # 多群組,FIML
anova(fit_configural, fit_equalmeans)                      # 檢定組別效果
# 等價性檢查:同一個模型寫成混合模型
library(lme4); lmer(y ~ wave + (wave | id), data = long)
完整的分析,包括與 lme4 逐一參數的等價比對、動差檢視、條件模型、多群組模型與平行歷程模型,以及潛在基底的形狀還原,都寫在隨書腳本 ch19_analysis_V01.R 之中。本章的各張圖形由中文版的 ch19_figures_zh_V01.R 繪製,而所用的那份資料,則由 gen_growth_wide_V01.R 產生。
軟體提示 • 潛在成長模型在各套軟體中的做法
這個模型在 lavaan 中以 growth 或 sem 配適,在 SAS 中以 PROC CALIS 配適,在 Mplus 中則以 MODEL 指令配適;Mplus 的 i s | y0@0 y1@1 ... 語法把截距因素與斜率因素命名得相當精簡,而它的 TSCORES 選項以定義變項供應個別不同的測量時間,這正是標準的 lavaan 模型所欠缺的功能。OpenMx 套件直接實作了定義變項,因此配適得出帶有個人特有測量時點的成長模型,這是通往「個別不同的測量時點」的結構方程路線,而多層次架構天生就走得通這條路。對於例行的線性模型與多項式模型,lavaan 與各個多層次套件可以互相替換,選擇取決於周邊分析用起來的手感;至於已把 Mplus 定為標準工具的研究室,MplusAutomation 套件支援一套來回往返的工作流程。
19.11 常見的誤解
關於潛在成長模型,有幾種信念會把人帶偏。第一種是認為結構方程的成長模型比多層次的成長模型更進階或更正確;在假設相配時兩者是同一個模型,差別只在用起來的手感(圖 19.3)。第二種是認為比較配適指標偏低就宣判成長模型死刑;配適不良應該先被定位,因為它常常坐落在平均數結構裡,訊號是成長形式選錯了,而不是一項致命的缺陷。第三種是認為斜率變異數不為零就證明了改變的個別差異存在;那個變異數是帶著誤差估出來的,而且可能撞到邊界,所以它的精確度、以及偵測到它的檢定力 (power),都必須一併衡量。第四種是認為平行歷程的斜率相關顯示了一個領域帶動另一個領域;它顯示的是相伴的變化,而方向需要一個動態模型。第五種是認為配適良好就認證了成長形式;配適良好是必要條件而非充分條件,一個配適良好的線性模型,在未被觀察到的時點上仍然可能是錯的形狀。
常見陷阱 • 潛在成長實作上的四個錯誤
第一,解讀截距與斜率的相關卻不陳明時間原點:與第 14 章相同,這個相關取決於時間在哪裡被編碼為零,所以原點必須指名。第二,一見 Heywood 案例就慌張:一個負的變異數估計值召喚的是診斷,判定它反映的是一個真正接近零的變異數、是抽樣雜訊,還是設定錯誤,而不是一個反射性的修補。第三,跨組比較潛在基底的負荷量卻不加以限制:不受限制的基底會把形狀的差異與變化之測量方式的差異混在一起。第四,把平行歷程的相關當成因果耦合:相伴的變化不是一種領先落後的關係。
本章摘要
潛在成長曲線模型以一個負荷量全為一的截距因素、以及一個負荷量固定為時間編碼的斜率因素來表示變化,而它獨有的要求是平均數結構,因為平均軌跡是由因素平均數承載的(圖 19.1)。這個模型把觀察到的平均數與共變數合在一起加以限制,而這正是它的整體配適檢定的動力來源(圖 19.2);它在三個波次時對一條直線可以識別,但要檢定形式需要四個或更多波次(表 19.1)。在時間編碼與殘差結構相配時,它與第 14 章的多層次成長模型是同一個模型,回傳同一組估計值(圖 19.3、表 19.2);而它們在「多層次架構那個因人而異的測量時間」或「結構方程架構那套整體配適、結構嵌入,以及多群組與平行歷程的延伸」登場的地方分道揚鑣(表 19.3)。它的配適以「把配適不良定位在平均數結構裡」來評估(圖 19.4、表 19.4)。共變項在條件模型中預測成長因素,那是跨層次交互作用的對應物(圖 19.5);群組以一套限制序列來比較,使治療效果成為斜率平均數的差異(圖 19.6、表 19.5);平行歷程揭示的是相伴的、而非因果耦合的變化(圖 19.7);而放開的負荷量把一個非線性的形狀估計成總變化的比例(圖 19.8)。這兩個架構是同一種語言的方言,而兩邊都流利,正是本章的目標。
接下來要去哪裡
本章與第 14 章合起來,把成長模型這個核心以兩種方言都走完了一遍。第 20 章把潛在曲線架構往兩個方向延伸:一是二階成長模型,把軌跡配適在第 18 章那些恆等的潛在因素上,兌現複合分數 (composite score) 默默假定的那張測量支票;二是潛在變化分數模型,它把成長重新參數化成一連串的變化分數,因而開始模型化變化的動態,而不只是它的形狀。第 21 章把成長因素放進交叉延宕追蹤系統裡,那些系統問的是哪一個歷程領先,也就解決了平行歷程模型只能提出而無法回答的方向問題。第 22 章則問,單一個成長模型是不是藏著一組彼此不同的軌跡類別 (trajectory class) 的混合分配 (mixture)。貫穿這一切的,是本章要養成的雙語習慣:把每一個成長模型同時看成一個混合模型、以及一組加在動差上的限制,而這正是縱貫結構方程模型的工作能力。
習題
- 19.1 手算隱含動差。對一個給定因素平均數、變異數、共變數與殘差變異數的四波次線性模型,算出隱含的平均數向量與共變數矩陣,並拿去對照一個
lavaan的配適結果加以驗證。 - 19.2 重現等價性,再把它弄壞。把無條件線性模型分別配適成混合模型與潛在曲線模型,確認估計值相符;然後加入一個自我迴歸的殘差結構,並解釋等價性為何不再成立。
- 19.3 配適不良的鑑識。對一份植入了二次形狀的資料配適線性模型,並以殘差動差定位並診斷那份配適不良。
- 19.4 多群組分析。以那套限制序列配適一個多群組成長模型,檢定組別效果,並把結果寫出來,同時註明它與交互作用參數化的等價關係。
- 19.5 潛在基底。配適一個放開負荷量的模型,把負荷量解讀成總變化的比例,並在配適與精簡兩方面拿它與二次式模型比較。
- 19.6 雙語互譯。把一張已發表的多層次成長模型表格翻譯成潛在曲線的語法,並確認兩者產生相同的估計值。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 潛在成長曲線模型 | latent growth curve model | 以截距因素與斜率因素表示個人軌跡的因素模型;第 19.1 節 |
| 截距因素 | intercept factor | 各時點負荷量皆為一,代表共有的水準;第 19.1 節 |
| 斜率因素 | slope factor | 負荷量固定為時間編碼,代表每單位時間的線性變化;第 19.1 節 |
| 平均數結構 | mean structure | 把指標的平均數一併模型化,以承載平均軌跡;第 19.1 節 |
| 加在動差上的限制 | constraints on the moments | 因素結構為觀察平均數與共變數隱含出特定的形式;第 19.1 節 |
| 經驗上的不可識別 | empirical underidentification | 斜率變異數近乎零時,資料幾乎不帶關於它的訊息;第 19.2 節 |
| Heywood 案例 | Heywood case | 估出負的變異數;召喚診斷而非反射性的修補;第 19.2 節 |
| 個別不同的測量時點 | individually varying measurement times | 每個人的測量時間不同(承第 14 章);第 19.3 節 |
| 定義變項 | definition variable | 讓每個人的負荷量等於自己的測量時間;第 19.3 節 |
| 整體配適的做法 | global fit machinery | 結構方程架構用來偵測設定錯誤的那套指標與檢定;第 19.3 節 |
| 更大的結構系統 | larger structural systems | 成長因素在其中擔任預測項或中介變項;第 19.3 節 |
| 條件成長模型 | conditional growth model | 以共變項預測成長因素(承第 14 章);第 19.5 節 |
| 遠端結果變項的預測項 | predictors of a distal outcome | 以斜率因素預測一個較晚的結果;第 19.5 節 |
| 多個群組 | multiple groups | 分組配適同一個成長模型並比較其參數;第 19.6 節 |
| 平行歷程模型 | parallel-process model | 同時配適兩個領域的成長並估計因素間的關聯;第 19.7 節 |
| 斜率與斜率的共變數 | slope-slope covariance | 兩個領域的變化是否相伴;第 19.7 節 |
| 相伴的變化 | correlated change | 兩個歷程一起移動,但不指明誰帶動誰;第 19.7 節 |
| 潛在基底 | latent basis | 放開中間負荷量,把改變的形狀估計出來;第 19.8 節 |
參考文獻
Bauer, D. J. (2003). Estimating multilevel linear models as structural equation models. Journal of Educational and Behavioral Statistics, 28(2), 135–167. https://doi.org/10.3102/10769986028002135
Bollen, K. A., & Curran, P. J. (2006). Latent curve models: A structural equation perspective. Wiley. https://doi.org/10.1002/0471746096
Chou, C.-P., Bentler, P. M., & Pentz, M. A. (1998). Comparisons of two statistical approaches to study growth curves: The multilevel model and the latent curve analysis. Structural Equation Modeling, 5(3), 247–266. https://doi.org/10.1080/10705519809540104
Curran, P. J. (2003). Have multilevel models been structural equation models all along?. Multivariate Behavioral Research, 38(4), 529–569. https://doi.org/10.1207/s15327906mbr3804_5
Duncan, T. E., Duncan, S. C., & Strycker, L. A. (2006). An introduction to latent variable growth curve modeling: Concepts, issues, and applications (2nd ed.). Erlbaum. https://doi.org/10.4324/9780203879962
Grimm, K. J., Ram, N., & Estabrook, R. (2017). Growth modeling: Structural equation and multilevel modeling approaches. Guilford Press.
McArdle, J. J. (2009). Latent variable modeling of differences and changes with longitudinal data. Annual Review of Psychology, 60(1), 577–605. https://doi.org/10.1146/annurev.psych.60.110707.163612
McArdle, J. J., & Epstein, D. (1987). Latent growth curves within developmental structural equation models. Child Development, 58(1), 110–133. https://doi.org/10.2307/1130295
McNeish, D., & Matta, T. (2018). Differentiating between mixed-effects and latent-curve approaches to growth modeling. Behavior Research Methods, 50(4), 1398–1414. https://doi.org/10.3758/s13428-017-0976-5
Mehta, P. D., & Neale, M. C. (2005). People are variables too: Multilevel structural equations modeling. Psychological Methods, 10(3), 259–284. https://doi.org/10.1037/1082-989X.10.3.259
Mehta, P. D., & West, S. G. (2000). Putting the individual back into individual growth curves. Psychological Methods, 5(1), 23–43. https://doi.org/10.1037/1082-989X.5.1.23
Meredith, W., & Tisak, J. (1990). Latent curve analysis. Psychometrika, 55(1), 107–122. https://doi.org/10.1007/BF02294746
Preacher, K. J., Wichman, A. L., MacCallum, R. C., & Briggs, N. E. (2008). Latent growth curve modeling. Sage. https://doi.org/10.4135/9781412984737
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Willett, J. B., & Sayer, A. G. (1994). Using covariance structure analysis to detect correlates and predictors of individual change over time. Psychological Bulletin, 116(2), 363–381. https://doi.org/10.1037/0033-2909.116.2.363
Wu, W., West, S. G., & Taylor, A. B. (2009). Evaluating model fit for growth curve models: Integration of fit indices from SEM and MLM frameworks. Psychological Methods, 14(3), 183–201. https://doi.org/10.1037/a0015858