第 21 章
交叉延宕追蹤設計:CLPM、RI-CLPM 與追蹤資料的因果推論
心理學裡問得最多的問題之一,是「這件事是不是會帶動那件事」:自尊會不會造成後來的憂鬱,還是反過來;投入程度會不會拉高後來的學業成就;媒體使用會不會助長後來的攻擊行為。半個世紀以來,回答這類問題的反射性工具是交叉延宕追蹤模型 (cross-lagged panel model),其中每個變項在控制住自己的穩定性之後去預測另一個變項的下一波,而一條顯著的交叉延宕 (cross-lag) 就被讀成一項前瞻效果 (prospective effect)。本章是本書對這項工具的清算。它以代數、以及一份把程式碼完全攤開的模擬,說明當人與人之間存在穩定差異時,經典模型會把那些穩定差異與「狀態被帶到下一刻」混在一起,於是它的交叉延宕可能被灌大、被壓小,或乾脆被憑空造出來。接著本章發展隨機截距交叉延宕追蹤模型 (random intercept cross-lagged panel model),把穩定的個體間 (between-person) 那一層與個體內 (within-person) 的動態分開;再把兩個模型放進一個更大的家族裡,家族成員各自對特質 (trait)、成長與動態做了不同的假設;並且堅持「在它們之間做選擇,是在選估計標的 (estimand),不是在趕流行」。本章的公平負擔不尋常:這項修補自己也有批評者,而他們的論點,也就是「個體內效果是短期而且時點特定的」以及「有時候個體間的問題才是對的問題」,在此被完整地說出來。本章最後談追蹤資料在因果主張上許可什麼、不許可什麼,用的是有向無環圖 (directed acyclic graph) 與一座通往固定效果 (fixed effects) 的橋;並談縱貫中介 (longitudinal mediation),在那裡橫斷 (cross-sectional) 的捷徑會把人帶偏。
學習目標
讀完本章之後,你應該能夠:(1) 設定經典的交叉延宕追蹤模型,並精確說出當穩定的特質變異數存在時,它的交叉延宕為什麼會把個體內與個體間的訊息混在一起;(2) 設定隨機截距交叉延宕追蹤模型,把它的參數解讀為個體內的量,並陳述它的識別 (identification) 與波次要求;(3) 把 CLPM、RI-CLPM、自我迴歸潛在軌跡 (autoregressive latent trajectory) 模型、帶結構化殘差 (structured residuals) 的潛在曲線模型、一般化交叉延宕追蹤模型,以及雙變量潛在變化分數模型放進一個統整的架構裡,並依估計標的在它們之間做選擇;(4) 把有向無環圖的推理用到追蹤設計上,並說出個人層次的固定效果移除了什麼、又沒有移除什麼;(5) 把一個計量經濟的固定效果估計值與 RI-CLPM 的個體內效果對得起來;(6) 以蒙地卡羅 (Monte Carlo) 信賴區間分析縱貫中介,並說明橫斷中介為什麼有偏誤;(7) 執行並報告一項方向性主張所需要的模型比較與敏感度流程。
21.1 相互因果的問題與那個經典模型
驅動本章的問題是「隨時間而來的相互影響」。一個人的自尊會不會形塑他後來的憂鬱症狀,還是症狀侵蝕了後來的自尊,或者兩者皆是?學生的投入程度會不會拉高他後來的學業成就,還是成功餵養了後來的投入?這些是關於時間先後 (temporal precedence) 的問題,問的是兩個交纏的歷程 (process) 裡哪一個先動;而追蹤資料 (panel data),也就是同一批人在數個時點上被測量了兩個變項,看起來正是為回答它們而生的。經典的工具是交叉延宕追蹤模型 (cross-lagged panel model, CLPM),一個結構方程模型 (structural equation model),其中每個變項在每一波 (wave) 都被迴歸到前一波的兩個變項上。一個變項對自己過去的迴歸是自我迴歸 (autoregression),讀作穩定性 (stability) 或延續效果 (carryover);一個變項對另一個變項過去的迴歸則是交叉延宕效果 (cross-lagged effect),而它就是研究要的東西。傳統的讀法簡單得誘人:由 \(x\) 到 \(y\) 的交叉延宕,是在控制住 \(y\) 的穩定性之後、\(x\) 對後來的 \(y\) 的前瞻效果;如果它顯著而反向的那條不顯著,那就是 \(x\) 領先 \(y\)。
圖 21.1 的上半為三個波次畫出這個模型。自我迴歸係數 \(a\) 與 \(d\) 沿著各變項自己的鏈條走,交叉延宕 \(b\) 與 \(c\) 斜跨在兩條鏈之間,而彎曲的路徑則是兩個變項在第一波的共變數 (covariance)、以及它們在後續各波的殘差共變數,後者捕捉的是延宕結構沒解釋掉的同時關聯 (contemporaneous association)。在本章通用的受限版本中,四個動態係數 (dynamic coefficient) 被限制為跨波相等,這是一項定態性 (stationarity) 假設,它買到了可解讀性與檢定力,而它本身也應該被檢定。這個模型在任何結構方程程式中都以最大概似 (maximum likelihood) 配適,而在超過兩波時它是過度識別 (overidentified) 的,因此有可被檢定的配適。
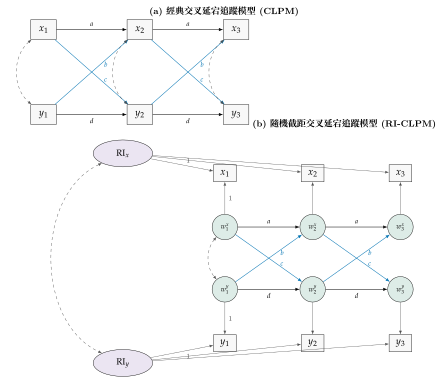
註:矩形是觀察分數,圓形是個體內成分,橢圓是穩定特質的隨機截距。在 CLPM(a)中,延宕結構直接作用在觀察分數上,因此一個人穩定的高低是由自我迴歸來承載的。在 RI-CLPM(b)中,每一個觀察分數都是一個特質隨機截距(負荷量為一)與一個個體內成分(負荷量為一)之和;自我迴歸 \(a,d\) 與交叉延宕 \(b,c\) 只作用在個體內成分上,而特質之間的共變數(左側)則吸收掉穩定的個體間關聯。藍色的斜線就是我們要的那兩條交叉延宕。
這項技術有一段長長的血緣。它的祖先是 1960 年代的交叉延宕追蹤相關 (cross-lagged panel correlation),做法是比較兩個交叉延宕相關 \(r(x_1,y_2)\) 與 \(r(y_1,x_2)\),再由兩者之差推論哪一邊的因果佔優勢 (causal predominance)。Rogosa (1980) 拆掉了這個比較,指出兩個交叉延宕相關取決於兩個變項各自不同的信度 (reliability) 與穩定性,因此即使兩者互不為因,它們也可能不相等,於是那個相關版本什麼都識別不出來。至於結構方程的版本,它迴歸而不是相關,因而把穩定性控制住了,人們普遍相信它已經把問題修好,而在往後三十年裡,CLPM 一直是發展與人格心理學者的預設選擇。真正重新掀開這個問題、也組織起本章的那項批評,比 Rogosa 的更細緻,也讓整個領域措手不及。
21.2 把那項批評講嚴謹
現代的批評由 Hamaker et al. (2015) 提出,影響最大,內容是:CLPM 漏掉了心理學資料裡幾乎必然存在的一層結構,也就是跨越所有波次而持續存在、類似特質 (trait-like) 的穩定個體間差異。人與人在自尊的慣常水準、在典型的投入程度、在症狀的基線負荷 (baseline symptom load) 上都不一樣,而這些差異與「一個狀態 (state) 一波一波被帶下去」不是同一件事。CLPM 只有一個機制,也就是自我迴歸,來表示所有的持續性 (persistence),於是它被迫把穩定的特質與動態的延續效果一起塞進同一個係數。當穩定特質存在時,自我迴歸會被灌大,因為它必須重現「特質所誘發的、一個人在相隔很遠的兩波之間的高相關」;而傷害更大的是,交叉延宕被汙染了。如果兩個特質在人與人之間彼此相關,而它們通常是相關的(特質 \(x\) 高的人,特質 \(y\) 往往也高),CLPM 除了交叉延宕之外就沒有別的參數可以承載那份個體間關聯,於是它把交叉延宕徵召過來,把一份純粹的穩定相關報告成一項前瞻效果 (prospective effect)。
21.2.1 穿上動態外衣的個體內與個體間混淆
這就是貫穿全書的那個混淆 (confound),也就是第 1 章以 Lord 悖論引入、第 13 章以預測項中心化 (centering) 處理過的「個體內與個體間訊息的混為一談」;而中心化與「固定效果對隨機效果」之間的關聯,由 Hamaker and Muthén (2020) 講明白了。在這裡它換上了動態的外衣。一項個體間關聯,也就是「比別人投入的人也比別人成就高」,講的是人的排序 (ranking),對歷程隻字未提。一項個體內效果,也就是「某個學生比他自己平常更投入時,他隨後也比他自己平常更有成就」,講的是一個人的偏離如何隨時間往下傳,而那才是一項關於投入程度的因果主張 (causal claim) 所需要的東西。CLPM 的交叉延宕把兩者混在一起,而只要穩定特質佔了變異數的一大塊,這份混合就會被個體間那一部分主宰;圖 21.2 顯示那正是常態而不是例外。
基礎概念 • 遺漏特質之下交叉延宕偏誤的代數
把觀察分數寫成一個穩定特質與一個個體內部分之和,\(x_{it}=\mu^x_i+w^x_{it}\)、\(y_{it}=\mu^y_i+w^y_{it}\),其中特質 \((\mu^x_i,\mu^y_i)\) 對一個人來說跨波固定不變,而在人與人之間以共變數 \(\sigma_{\mu}\) 相關。假設真正的個體內動態裡沒有 \(x\) 對 \(y\) 的效果,也就是 \(w^y_{it}\) 不依賴 \(w^x_{i,t-1}\)。CLPM 把 \(y_{it}\) 迴歸到 \(x_{i,t-1}\) 與 \(y_{i,t-1}\) 上,而這些是仍然帶著特質的觀察分數。因為 \(x_{i,t-1}\) 含有 \(\mu^x_i\),\(\mu^x_i\) 與 \(\mu^y_i\) 相關,而 \(\mu^y_i\) 又含在 \(y_{it}\) 裡,所以即使已經條件化在 \(y_{i,t-1}\) 上,\(y_{it}\) 對 \(x_{i,t-1}\) 的迴歸在母體中仍有一個不為零的係數:單獨一個延宕的控制項 \(y_{i,t-1}\) 只是特質 \(\mu^y_i\) 的一次會出錯的測量,無法把它完全吸收掉。殘留的特質共變數於是漏進交叉延宕,而後者的機率極限是 \(\sigma_{\mu}\) 的一個正倍數,儘管個體內效果為零。隨機截距是「一個人跨所有波次的分數的一個潛在共同因素」,它把 \(\mu^y_i\) 精確地移除掉,而不是透過一個有雜訊的替身,於是這個漏洞就關上了。
21.2.2 招牌模擬
要看清這個問題,最清楚的方式是造一份真相已知的資料,然後看 CLPM 錯過它。隨書資料集 panel_sim 有 \(1{,}000\) 個人,在五個波次上被測量了兩個變項,由一個「帶穩定人特質、外加一個個體內動態系統 (dynamic system)」的模型生成。個體內的真相刻意是不對稱的 (asymmetric):\(x\) 對後來的 \(y\) 的效果是 \(0.20\),因此 \(x\) 貨真價實地領先 \(y\);而 \(y\) 對後來的 \(x\) 的效果恰好是零。兩個個體內自我迴歸都是 \(0.40\)。在這個動態系統之上坐著兩個穩定特質,在人與人之間相關 \(0.60\),各佔兩個變項觀察變異數 (observed variance) 的四成多一點(圖 21.2)。每一個參數在生成腳本 gen_panel_sim_V01.R 裡都看得到,因此這場比較沒有任何一處是藏起來的。
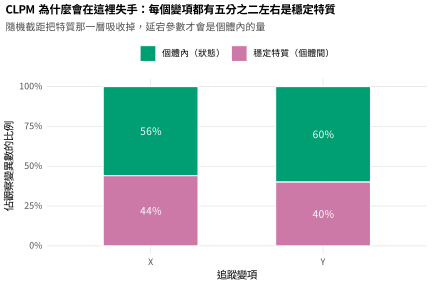
註:每一個追蹤變項都被分解成「觀察變異數中屬於穩定特質(個體間)的比例」與「屬於個體內狀態的比例」,由 RI-CLPM 還原出來。每個變項大約有五分之二是穩定特質。這正是那個 CLPM 的單一自我迴歸分不開「穩定的高低」與「動態的延續」的區間,而交叉延宕會把那份差額吸收掉。
把兩個模型都配適到這份資料上,那項批評就被原原本本地重現出來。圖 21.3 是本章的招牌展示。受限的 CLPM 把兩個自我迴歸估成 \(0.64\) 與 \(0.61\),遠高於它們 \(0.40\) 的真值,因為它們同時吸收了穩定特質與動態的延續。更糟的是,它把那條真值為零的 \(y \to x\) 交叉延宕報告成 \(0.056\),標準誤 \(0.012\),\(p < .001\):一項在資料生成歷程 (data-generating process) 中根本不存在、卻高度顯著的相互效果 (reciprocal effect)。而那條貨真價實的 \(x \to y\) 效果,它估成 \(0.187\),在這個特定設計中湊巧接近 \(0.20\) 的真值,於是一位讀 CLPM 輸出的研究者會做出錯誤的結論,以為這兩個變項彼此相互影響。RI-CLPM 拿到的是一模一樣的資料,卻還原了真相:自我迴歸 \(0.41\) 與 \(0.43\),一條不顯著的 \(y \to x\) 效果 \(-0.014\)(\(p = .49\)),以及一條 \(0.201\) 的 \(x \to y\) 效果。它正確地報告了一個單向的歷程。在一般描述的意義上,RI-CLPM 也配適得比較好,近似均方根誤差 (root mean square error of approximation, RMSEA) \(0.021\) 對上 CLPM 的 \(0.075\),比較配適指標 (comparative fit index, CFI) \(0.997\) 對上 \(0.964\);但配適的差異不是這裡的教訓。教訓是這兩個模型回答的是不同的問題,而只有那個個體內的問題,才是相互效果文獻本來想問的。
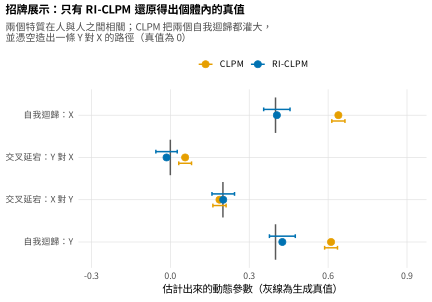
註:把經典 CLPM(橘)與 RI-CLPM(藍)配適到 panel_sim 上所估出來的動態參數,附 \(95\%\) 信賴區間;灰色的直立短線是生成值。CLPM 把兩個自我迴歸都灌大,並報告一條真值為零、卻在統計上顯著的 \(y \to x\) 交叉延宕。RI-CLPM 則把四個個體內參數全都還原出來。
有一項「不要從這個展示過度學習」的告誡必須立刻提出,而它預告了第 21.4 節的反潮流。CLPM 之所以失手,不是因為它是個壞模型,而是因為它的估計標的,也就是那個把個體間與個體內訊息混在一起的量,並不是這場模擬所要檢驗的那個個體內估計標的。在一個沒有穩定特質的世界裡,CLPM 與 RI-CLPM 會重合。因此那項批評是有條件的:穩定的個體間差異存在到什麼程度,它就咬到什麼程度;而它的力道是一個關於資料的實證問題,由圖 21.2 的變異數分解 (variance decomposition) 來回答,而不是一條「RI-CLPM 永遠比較好」的定理。
21.3 隨機截距交叉延宕追蹤模型
由 Hamaker et al. (2015) 與同僚提出、並由 Mulder and Hamaker (2021) 加以擴充的這項修補,只在模型上加了一層。每個變項各得到一個隨機截距 (random intercept),那是一個以固定為一的負荷量 (loading) 負荷在該變項每一波上的潛在因素 (latent factor),因此它代表一個人的分數中跨所有時點都不變的那個部分,也就是穩定特質。把隨機截距移除之後剩下的,是一組個體內成分 (within-person components),每個變項每一波各一個,每一個都是一個對它的觀察分數有固定單位負荷量的潛在變項,代表一個人在那個時點上相對於他自己期望水準的暫時偏離 (deviation)。圖 21.1 的下半畫出這個結構:觀察分數是特質與個體內成分之和,而整套自我迴歸與交叉延宕的做法 (machinery),都從觀察分數上被搬到個體內成分上。兩個隨機截距容許彼此共變,而那個共變數吸收掉 CLPM 無處可放的穩定個體間關聯。
這一步所強迫的重新解讀,正是它的全部要點。在 RI-CLPM 中,由 \(x\) 到 \(y\) 的交叉延宕,是「一個人在某個時點上高於他自己在 \(x\) 上的期望水準」對「他在下一個時點上高於他自己在 \(y\) 上的期望水準」的效果,是一個嚴格意義下的個體內量,已經把人的排序清除掉了。表 21.1 把兩種讀法逐一參數並排,因為用詞很要緊:同一個希臘字母在兩個模型裡指的是不同的東西,而審稿人與作者經常把 CLPM 那套個體間的說法搬到 RI-CLPM 的個體內係數上,那是一項範疇錯誤 (category error)。
表 21.1 CLPM 與 RI-CLPM 的逐一參數解讀。
| 量 | CLPM 的讀法 | RI-CLPM 的讀法 |
|---|---|---|
| 自我迴歸 | 等級順序穩定性與動態延續效果兩者的混合 | 個體內慣性:偏離自己常態之後還撐不撐得住 |
| 交叉延宕 \(x\to y\) | \(x\) 的水準對後來 \(y\) 的前瞻效果,控制 \(y\) 的穩定性(混合了個體內與個體間) | 高於自己 \(x\) 常態,對後來高於自己 \(y\) 常態的效果(純個體內) |
| 穩定的個別差異 | 未被模型化;被硬塞進自我迴歸與交叉延宕 | 由隨機截距的變異數承載 |
| 跨構念的特質連結 | 未被模型化;漏進交叉延宕 | 由隨機截距的共變數承載 |
| 殘差/創新項 (innovation) 的共變數 | 每一波的同時關聯 | 個體內衝擊的同步移動 |
註:兩個模型為在輸出中長得一模一樣的係數賦予了不同的意義。把 CLPM 那套個體間的語言搬到 RI-CLPM 的估計值上,是一個常見而且後果嚴重的錯誤。
識別 (identification) 與設計上的要求,隨著多出來的那一層而來。把穩定特質與個體內動態分開,至少需要三個波次;只有兩個波次時,隨機截距與波次特定的成分無法區辨,模型退化成一個重新參數化 (reparameterized) 的 CLPM,交不出它所承諾的那份分離。第一波的個體內成分被當成前定 (predetermined) 處理,變異數與共變數自由估計,因為沒有更早的時點可以預測它們;延宕結構從第二波才開始。在受限的形式中,四個動態係數與創新項 (innovation) 的(共)變異數被限制為跨後續各波相等,而這需要、也值得一次定態性檢查。這個模型以最大概似配適,而完全訊息最大概似 (full-information maximum likelihood) 處理得了中途退出 (dropout) 所產生的遺漏資料,與第 19、20 章完全相同。隨 ch21_analysis_V01.R 一起出貨的那個可重複使用的產生器,會為任意波次數寫出 RI-CLPM 的 lavaan 語法,好讓那些固定的單位負荷量、被歸零的觀察殘差變異數 (residual variance),以及「特質與第一波成分正交 (orthogonal)」這幾件事被寫下來而不會出手誤。
# RI-CLPM 骨架(三個波次;產生器可寫出任意波次數)
RIx =~ 1*x1 + 1*x2 + 1*x3        # x 的穩定特質
RIy =~ 1*y1 + 1*y2 + 1*y3        # y 的穩定特質
wx1 =~ 1*x1;  wx2 =~ 1*x2;  wx3 =~ 1*x3    # 個體內成分
wy1 =~ 1*y1;  wy2 =~ 1*y2;  wy3 =~ 1*y3
x1 ~~ 0*x1;  x2 ~~ 0*x2;  x3 ~~ 0*x3      # 不留觀察層的誤差
y1 ~~ 0*y1;  y2 ~~ 0*y2;  y3 ~~ 0*y3
wx2 ~ a*wx1 + b*wy1;  wx3 ~ a*wx2 + b*wy2  # 個體內動態(受限)
wy2 ~ c*wx1 + d*wy1;  wy3 ~ c*wx2 + d*wy2
RIx ~~ RIy;  RIx ~~ 0*wx1 + 0*wy1;  RIy ~~ 0*wx1 + 0*wy1
有兩種實務上的風險會一再出現。當組內相關 (intra-class correlation, ICC) 偏低、穩定特質只佔一點點變異數時,隨機截距的變異數會被估在接近零的地方,甚至可能略為負值,產生一個 Heywood 案例 (Heywood case);誠實的回應是把它報出來,把變異數界在零重新配適,並認清「特質變異數接近零」這件事本身就是發現,也就是 CLPM 與 RI-CLPM 將會近乎一致。當波次之間的間隔不相等時,那個受限的模型是設定錯誤的,因為一個意義為「每單位時間的變化」的係數,不可能在長度不同的區間上都相同;這是一個與第 20 章為潛在變化分數模型提出的區間依賴完全相同的問題,而第 27 章以連續時間 (continuous-time) 估計解決它。這些都收在下面的實作方塊裡。
實務要點 • RI-CLPM 的收斂與區間風險
當特質變異數很小時,要預期隨機截距的變異數接近零、甚至略為負值;把它界在零,報告組內相關,並註明兩個模型將會近乎重合。當波次間距不相等時,不要把動態限制為在長度不同的區間上相等;要嘛依區間把係數放開,要嘛改用連續時間模型(第 27 章)。波次少而個體內成分承載的變異數又不多時,要留意不收斂,並在有中途退出時優先採用完全訊息最大概似而不是整列刪除。永遠去確認配適物件裡的組別順序與參數標籤,而不是假設它們;並檢視標準化後的個體內估計值,因為未標準化的交叉延宕是掛在觀察分數的量尺上的。
21.4 那個家族與估計標的地圖
CLPM 與 RI-CLPM 是一個更大的追蹤模型家族中的兩個成員,這個家族由 Usami et al. (2019) 統整起來,成員之間的差別在於它們對三件事的假設 (assumption):有沒有穩定特質、有沒有系統性的成長,以及一波到下一波的動態是怎麼結構起來的。圖 21.4 勾出六個成員,表 21.2 則陳述每一個成員的那組假設三元組。經典的 CLPM 假設沒有穩定特質、沒有成長,只有觀察分數上的動態。RI-CLPM 加上一個穩定特質。Bollen and Curran (2004) 的自我迴歸潛在軌跡 (autoregressive latent trajectory) 模型加上一條成長軌跡,也就是一個截距與一個斜率,並讓繞著它的殘差 (residual) 服從一個自我迴歸,把成長曲線與自我迴歸兩個傳統熔在一起。Curran et al. (2014) 的帶結構化殘差的潛在曲線模型 (latent curve model with structured residuals) 保留一條成長軌跡,但把交叉延宕的動態搬到繞著它的殘差上,這通常是把發展趨勢 (developmental trend) 與個體內波動 (fluctuation) 分開的更乾淨做法。Zyphur 與同僚的一般化交叉延宕追蹤模型 (general cross-lagged panel model) 更進一步一般化,加入累積因素 (accumulating factors) 並讓衝擊同步移動,因此它同時表示得了短期動態與長期的脈衝反應 (impulse response) (Zyphur et al., 2020a; Zyphur et al., 2020b)。第 20 章那個雙變量潛在變化分數模型 (bivariate latent change score model, LCS),則是把動態寫成變化分數而不是迴歸的那個家族成員;當它納入一個特質時,它與 RI-CLPM 是近親 (close kin)。
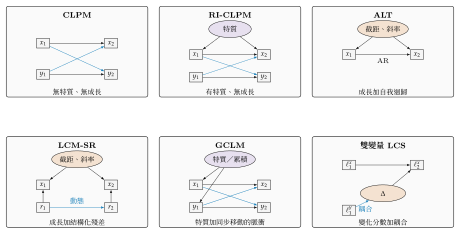
註:這是示意的圖徽,不是完整的路徑圖:紫色橢圓是穩定特質或累積因素,橘色橢圓是成長因素(截距與斜率),矩形是觀察分數、真分數或殘差,藍色箭頭是交叉延宕或耦合路徑。每個成員對特質、成長與動態各編碼了不同的假設;表 21.2 列出那些三元組。第 20 章的雙變量潛在變化分數模型,是 RI-CLPM 的變化分數表親。
表 21.2 追蹤模型家族與它們的假設。
| 模型 | 穩定特質 | 成長趨勢 | 動態放在 | 它回答的估計標的 |
|---|---|---|---|---|
| CLPM | 無 | 無 | 觀察分數 | 個體間加個體內混合的前瞻預測 |
| RI-CLPM | 有(截距) | 無 | 個體內成分 | 個體內的延續效果與交叉效果 |
| ALT | 經由軌跡 | 有 | 觀察殘差 | 成長加殘差的動態 |
| LCM-SR | 經由軌跡 | 有 | 結構化殘差 | 扣掉發展趨勢之後的個體內動態 |
| GCLM | 有(累積) | 可有可無 | 個體內,帶衝擊 | 短期與長期的脈衝效果 |
| 雙變量 LCS | 可有可無 | 經由變化規則 | 潛在變化分數 | 耦合的變化:一個歷程的水準是否驅動另一個的變化 |
註:在成員之間做選擇,是在選估計標的、以及在選關於持續性與成長的實質假設,不是在排名次。一個模型對某個問題是正確的,取決於它的特質、成長與動態三項假設與被檢驗的理論相符到什麼程度。
21.4.1 把反潮流講足
如果從這批文獻得出「RI-CLPM 就是修正版的 CLPM、事情已經定案」的結論,那會是一次嚴重的誤讀。有一股強勁的反潮流 (counter-current) 主張,從 CLPM 換到 RI-CLPM 是換了估計標的,不是一項純粹的更正;而且 CLPM 的估計標的有時候正是研究者想要的那一個。Lüdtke and Robitzsch (2022) 從因果推論的觀點出發,指出 RI-CLPM 的個體內交叉延宕識別的是一項短期的 (short-run)、時點特定的 (occasion-specific) 效果,它不必然等於一項政策或介入 (intervention) 所會產生的效果;而且在某些因果結構之下,對個體間的前瞻問題而言,CLPM 的係數才是站得住腳的目標,RI-CLPM 的反而有偏誤。Usami (2021) 把兩個模型的交叉延宕之間的關係形式化,並說明各自在什麼時候適用。Lucas (2023) 則從另一邊主張 CLPM 幾乎從來都不是對的選擇,因為它的估計標的很少對得上心理學者真正抱持的任何問題,而把它當預設已經產出了一整片充滿假象 (artifact) 的文獻。Orth et al. (2021) 在許多份真實資料上比較了七個模型,發現這些模型的參數值經常彼此不合,卻有時在實質結論上一致,而他們建議配適數個模型並報告敏感度 (sensitivity),而不是為其中一個加冕。Rohrer and Murayama (2023) 退一步堅持作者應該先指名估計標的,也就是他們指的是個體內還是個體間的效果,然後才選模型,因為模型是在問題的下游;而 Berry and Willoughby (2017) 更早就對這個發展領域的主力工具的使用者施加過同樣的解讀告誡。Hamaker (2026) 回顧了這場爭論,主張跨過「哪個模型打敗哪個模型」這種框架,走向「把模型對到估計標的」。表 21.3 公平地攤開兩個陣營 (camps)。
表 21.3 那項批評與它的反批評,公平地陳述。
| Hamaker 一路(支持 RI-CLPM) | Lüdtke–Robitzsch–Lucas–Orth 一路(提出告誡) |
|---|---|
| 穩定特質無所不在;CLPM 把它們硬塞進自我迴歸、又讓它們漏進交叉延宕,因此它報告的相互效果往往是假象。 | RI-CLPM 的個體內交叉延宕是一個短期的、時點特定的量,它不必然等於一項介入的效果,也不必然等於一項個體間的前瞻效果。 |
| 把特質與個體內動態分開,回答的正是相互效果主張本來要問的那個歷程問題。 | 要哪一個估計標的取決於理論;對某些個體間的前瞻問題來說,CLPM 那個目標是站得住腳的。 |
| 當混淆變項是一個時間不變的特質時,個體內交叉延宕才是在因果上有意義的量。 | 真實的混淆往往是時間變動的,而隨機截距移除不了它;那份「免疫」的主張是有限的。 |
| 報告 RI-CLPM,CLPM 只作為對照。 | 先指名估計標的;配適數個模型;報告它們之間的敏感度(Orth 等人;Rohrer 與 Murayama)。 |
註:本書的立場是估計標的優先:先陳述這項主張所需要的是個體內還是個體間的量,再選一個在明說的假設之下能識別它的模型;而且只要主張帶方向性,就把 CLPM 與 RI-CLPM 都報出來,當作一項必做的敏感度分析。
本書的立場,也是後續各章一貫採用的做法,是「選擇由指名估計標的來做成,由必做的敏感度報告來約束」。圖 21.5 把這件事變成一份決策輔助:研究問題的措辭,也就是它問的是人怎麼排序、還是一個人自己的偏離怎麼往下傳,指向估計標的相符的那個家族成員;而只要主張帶方向性,CLPM 與 RI-CLPM 就都要報出來,好讓讀者看得見這個結論在模型選擇之下是否還站得住。
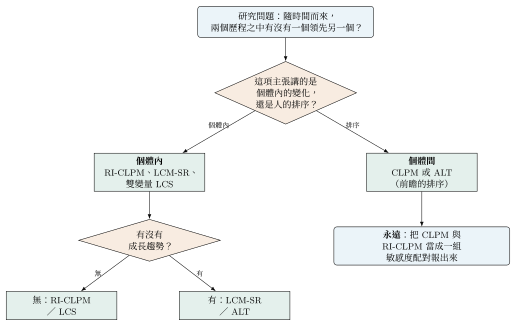
註:研究問題的措辭選出估計標的,而估計標的選出家族成員。一項個體內的主張指向 RI-CLPM、LCM-SR 或雙變量 LCS;一項個體間的前瞻主張則由 CLPM 或 ALT 來服務。只要牽涉到方向性的主張,CLPM 與 RI-CLPM 就都要報出來,好讓這個結論對模型選擇的依賴是看得見的。
21.4.2 測量誤差那一層
還有第二項橫跨整個家族的細緻處理:那些變項是帶著誤差被測量的,而沒有被模型化的誤差會不對稱地損害延宕結構 (lagged structure)。理由是測量誤差 (measurement error) 會衰減 (attenuate) 自我迴歸,因為一個會出錯的分數,對自己會出錯的未來的預測力,比不上真分數對自己真未來的預測力;而被衰減的自我迴歸留下了沒被解釋掉的穩定性,交叉延宕接著就把它吸收過去。圖 21.6 在一個真交叉延宕為 \(0.15\)、反向路徑為虛無的兩歷程系統上示範這件事,把觀察分數的 CLPM 在信度由一降到二分之一的一連串水準上配適一遍。在信度為完美時,模型還原了真相。當信度下降時,自我迴歸由 \(0.50\) 被衰減到 \(0.25\),真的交叉延宕由 \(0.15\) 縮到 \(0.12\),而最能說明問題的是,那條虛無的交叉延宕離開零、朝 \(0.03\) 膨脹:測量誤差製造得出一項根本不存在的相互效果的外觀。補救之道是把誤差模型化,或者用多重指標與追蹤模型的潛在變項版本,那會把第 18 章那整套縱貫恆等性 (longitudinal invariance) 的做法帶進來;或者在只有單一指標可用時,做一次信度校正 (reliability correction),把該指標的誤差變異數固定在一個站得住腳的值上。這份損害的不對稱,也就是對交叉延宕傷得最重,正是為什麼潛在變項的處理恰恰在本章所談的相互效果問題上最要緊。
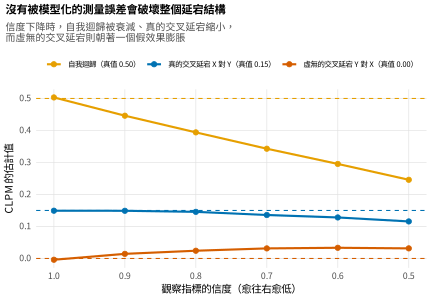
註:一個兩歷程系統的觀察分數 CLPM 估計值,指標信度由一(左)降到二分之一(右);虛線是生成值,每一個水準取 60 次重複的平均。自我迴歸被衰減,真的交叉延宕縮小,而虛無的交叉延宕則朝一個偽陽性膨脹。把誤差模型化,透過多重指標或單一指標的信度校正,就是補救之道。
21.5 追蹤資料的因果推論
指名估計標的引出了一個問題:一份追蹤設計許可得了什麼樣的因果主張?誠實的答案是謙虛的,而它最好透過有向無環圖 (directed acyclic graph, DAG) 來推理,那是第 3 章引入的因果推論工具,在此被用到追蹤結構上。圖 21.7 畫了兩個追蹤 DAG。左半顯示的是時間變動的混淆 (time-varying confounding):一個隨時間改變的未觀察 (unobserved) 原因 \(U_t\),在每一波都影響兩個變項。RI-CLPM 的隨機截距只有在混淆變項是時間不變的、也就是在每一波都相同的穩定特質時,才移除得了它;一個像 \(U_t\) 這樣時間變動的混淆變項會直接穿過去,因為它不是常數,所以不會被一個常數的潛在因素吸收。這是 RI-CLPM 那份被大肆宣傳的「對混淆免疫 (immunity)」的銳利界線,也是表 21.3 為什麼把時間變動的混淆列為一項常設告誡:個體內交叉延宕對因果效果不偏 (unbiased),只在「所有混淆都是時間不變的」這個很少能檢定的假設之下才成立。
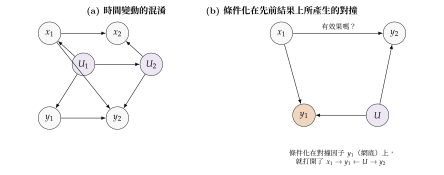
註:(a) 一個時間變動的混淆變項 \(U_t\)(紫)在每一波都影響兩個變項;因為它不是常數,RI-CLPM 的隨機截距移除不了它,交叉延宕 \(x_1 \to y_2\) 仍然被混淆。(b) 條件化在先前的結果 \(y_1\)(網底)上,也就是每一個交叉延宕模型都在做的事,會在 \(y_1\) 是對撞因子時打開一條非因果的路徑;所謂對撞因子,是 \(x_1\) 與另一個也影響 \(y_2\) 的未觀察原因 \(U\) 的共同結果,而由此誘發出來的 \(x_1\) 與 \(U\) 之間的關聯,會使 \(x_1\) 對 \(y_2\) 的估計效果產生偏誤。個人層次的固定效果只移除得了時間不變的混淆變項。
圖 21.7 的右半顯示一個更細緻的風險。每一個交叉延宕模型都條件化在先前的結果上,把 \(y_2\) 迴歸到 \(y_1\) 上以控制穩定性。如果 \(y_1\) 與 \(y_2\) 共享一個未觀察的共同原因,那麼條件化在「由 \(x_1\) 經那個共同原因通到 \(y_2\)」那條路徑上的對撞因子 (collider) \(y_1\) 上,就可能打開一條假的 (spurious) 關聯,即使 \(x_1\) 對 \(y_2\) 毫無效果。控制先前的結果,正是定義了交叉延宕取向的那一步,因此並不自動是良性的;它可能引入偏誤 (bias) 而不是移除偏誤。這就是為什麼任何一條交叉延宕的因果讀法,都倚靠著資料無法驗證的假設;也是為什麼表 21.4 那座合理主張的階梯要把關聯、個體內前瞻預測與因果效果放在不同的級上,每一級都要求得比前一級更多。至於「為縱貫觀察資料明說因果估計標的與假設」這個更廣的計畫,追蹤這個案例只是其中一例,其綱領見 VanderWeele et al. (2020) 的全結果 (outcome-wide) 模板。
表 21.4 一座由追蹤資料出發、站得住腳的主張階梯。
| 級 | 主張 | 它需要什麼 |
|---|---|---|
| 1 | 關聯 | 兩個變項跨波共變。最低限度;對方向、對「人還是時點」都沒說什麼。 |
| 2 | 前瞻預測(個體間) | 一個變項的水準在人的排序上預測得了另一個變項後來的水準。需要時間順序;屬 CLPM 或 ALT 的估計標的。 |
| 3 | 個體內的前瞻預測 | 一個人相對於自己常態的偏離,預測得了他後來在另一個變項上的偏離。需要 RI-CLPM 或 LCM-SR,以及定態性。 |
| 4 | 因果效果 | 個體內效果等於一項操弄所會產生的效果。需要沒有未測量的時間變動混淆、正確的函數形式,以及條件化在先前結果上不會產生對撞偏誤。觀察性的追蹤資料很少許可得了這一級。 |
註:每一級所要求的都嚴格多於它下面那一級。追蹤資料最站得住腳地支撐第一到第三級;第四級所需要的假設是觀察性設計無法驗證的,應該被明說、被探查,並照實報告。
21.5.1 那座計量經濟的橋
經濟學者用另一套工具攻擊同一個個體內估計標的,也就是固定效果 (fixed effects) 估計式:在估計動態之前,先從每一個分數減掉這個人自己的平均數,把他穩定的水準移除掉,這就是組內轉換 (within transformation)。把它用到一份動態追蹤資料上,也就是把一個變項迴歸到自己與另一個變項的個人平均數中心化 (person-mean-centered) 延宕項上,這就是 RI-CLPM 個體內交叉延宕在計量經濟裡的手足,而把兩者跑在同一份資料上很有啟發。圖 21.8 把一個手算的固定效果迴歸的四個動態參數,對著 panel_sim 上 RI-CLPM 的估計值畫出來。兩條交叉延宕吻合得很好,落在對角線上:固定效果估計式把 \(x \to y\) 效果還原到 \(0.199\),與 RI-CLPM 的 \(0.201\) 以及 \(0.20\) 的真值幾乎完全相同。自我迴歸卻分歧得厲害,固定效果的估計值接近 \(0.05\),對上 RI-CLPM 的 \(0.41\)。這不是程式錯誤,而是 Nickell 偏誤 (Nickell bias):對一份波次不多的動態追蹤資料做個人平均數中心化,會在中心化後的延宕預測項 (lagged predictor) 與中心化後的誤差之間誘發出相關,使自我迴歸向下偏誤,而波次數愈少偏得愈嚴重。計量經濟裡的補救之道,一是 Allison et al. (2017) 那個最大概似的結構化形式,它在沒有小樣本偏誤的情況下還原個體內效果,精神上與 RI-CLPM 接近;二是 Arellano and Bond (1991) 的工具變項 (instrumental variable) 廣義動差法 (generalized method of moments, GMM),它以更早的水準來當差分後延宕項的工具。心理計量與計量經濟這兩個傳統在同一個個體內估計標的上會合,是一項令人安心的檢查;而它們在自我迴歸上的分歧,則提醒我們波次少的動態追蹤資料對每一種方法來說都很難。
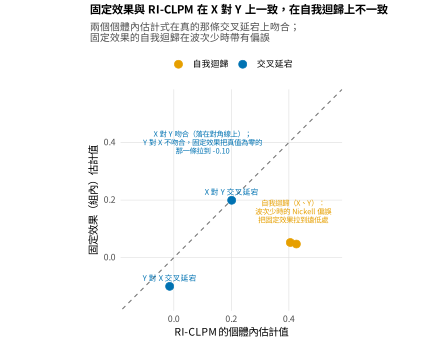
註:每一個點是一個動態參數,橫軸是它的 RI-CLPM 個體內估計值,縱軸是手算的固定效果估計值;虛線是等值線。\(x \to y\) 那條交叉延宕(藍)吻合,落在對角線上;\(y \to x\) 那條真值為零的交叉延宕則不吻合,固定效果把它拉到 \(-0.10\),而 RI-CLPM 是 \(-0.01\)。兩個自我迴歸(橘)遠落在等值線之下,因為波次數少時固定效果估計式帶有 Nickell 偏誤;Allison 與同僚那個最大概似的形式可以更正它。
當這個家族被配適到 school_panel 資料上時,招牌展示有了一次應用上的回聲;那是一份八百名學生、四個學期的投入程度與學業成就追蹤資料。受限的 CLPM 報告出一條標準化 (standardized) 的「投入到成就」交叉延宕 \(0.086\)、一條「成就到投入」交叉延宕 \(0.103\),兩者都顯著,正是那幅熟悉的相互迴圈圖像。RI-CLPM 加上隨機截距之後,找到兩個特質之間一份 \(0.53\) 的穩定個體間相關,並把兩條個體內交叉延宕都降到 \(0.05\),兩者都不顯著。CLPM 所報告的那個相互迴圈,一旦把穩定特質分出來,大體上就只是「比別人投入的學生也比別人有成就」這句話,而不是「一個學生比平常更投入會拉高他自己後來的成就」。那兩條小小的個體內交叉延宕究竟是真的為零、還是只是檢定力 (power) 不足,這件事本身就值得說明白,而那正是那組敏感度配對想要浮上檯面的那種細緻之處。
21.6 縱貫中介
中介,也就是「\(x\) 透過一個中介變項 (mediator) \(m\) 影響 \(y\)」這項主張,本質上是關於一個隨時間展開的歷程;用單一時點所測量的變項來分析它,會引進一個隱藏而且往往嚴重的偏誤。Maxwell and Cole (2007) 證明了那個一般性的結果:當真正的歷程是一條縱貫鏈,其中 \(x\) 影響後來的 \(m\)、\(m\) 又影響更後來的 \(y\) 時,一份把三個變項都放在同一波估計的橫斷中介分析,只有在限制嚴苛到不可信的條件之下,才還原得出真正的縱貫間接效果 (indirect effect);而在一般情況下,它可能高估、低估,或把間接效果的正負號 (sign) 反轉。圖 21.9 在一條乾淨的模擬鏈上顯示這份分歧,該鏈真正的縱貫間接效果是 \(0.160\):正確設定的縱貫模型,也就是每一個連結都尊重時間延宕、並控制中介變項與結果變項各自的過去,還原出 \(0.159\);而對同一個生成歷程所做的橫斷分析卻回傳 \(0.087\),只有真值的一半多一點。偏誤的方向取決於那些自我迴歸參數,而這恰恰就是 Maxwell 與 Cole 的重點:那條橫斷捷徑不是保守的,它就只是錯的,而錯多少、往哪個方向錯,不跑縱貫模型就無從知道。
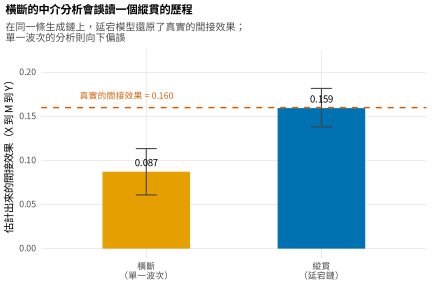
註:由單一波次的橫斷中介、以及正確加了延宕的縱貫中介所估計出來的間接效果,兩者都配適到同一條生成鏈上,該鏈真正的縱貫間接效果是虛線;長條是平均數,鬚是 80 份模擬樣本的第 2.5 到第 97.5 百分位數範圍。加了延宕的模型還原了真值;橫斷分析在此向下偏誤,而在一般情況下它的偏誤可以往任何一個方向跑。
正確的設計是 Cole and Maxwell (2003) 這一脈的半縱貫 (half-longitudinal) 與完全縱貫中介模型,它們把 \(x\) 放在 \(m\) 之前、\(m\) 放在 \(y\) 之前以尊重時間順序,並控制每個變項自己先前的水準;而 Selig and Preacher (2009) 為發展資料整理了它們的各種變體。實作範例隨分析腳本一起出貨:在 school_panel 資料上,第一學期的投入程度透過第二學期的讀書時間、對第三學期的學業成就所產生的間接效果,估計為 \(0.035\),蒙地卡羅 (Monte Carlo) \(95\%\) 信賴區間為 \([0.021, 0.052]\),算法是從兩個路徑係數的聯合抽樣分配中抽樣,再取它們乘積的百分位數 (percentile);這是間接效果的首選方法,因為兩個常態係數的乘積本身並不常態,而天真的對稱區間 (symmetric interval) 會失準。那個估計值老實說是結構上個體內間接效果的一個下界 (lower bound),後者由生成歷程設定為 \(0.105\),因為建在原始分數上的自我迴歸中介並沒有把穩定特質分離出去,於是把個體內的路徑衰減掉了,這是同一堂個體內與個體間的課,換成中介的形式。至於前沿,也就是一個以 RI-CLPM 為基礎、純粹在個體內估計間接效果的中介模型,是一個仍然活躍而未定案的方法學領域;誠實的報告會陳明估計標的、使用蒙地卡羅區間,並標明「經特質調整的個體內間接效果需要更完整的模型」。一個常見陷阱方塊收攏了本章所警告過的中介與解讀錯誤。
常見陷阱 • 相互效果與中介實作上的四個錯誤
第一,把每一波各自標準化之後再跨波比較交叉延宕,會把「係數的改變」與「變項變異數的改變」混在一起;要嘛只標準化一次、放在共同的量尺上,要嘛比較未標準化的係數。第二,把一條 RI-CLPM 的個體內交叉延宕讀成「一項介入所會產生的效果」是過度宣稱:它是在明說的假設之下的一項短期個體內關聯,不是一項政策效果。第三,兩個波次的設計分不開穩定特質與個體內動態,也識別不了 RI-CLPM,所以一份兩波的交叉延宕分析不管叫什麼名字,它就是一個 CLPM。第四,用三條橫斷迴歸、或用一個縱貫歷程的單一波次來估計中介,會引進 Maxwell 與 Cole 的偏誤,可能報出一個大小或正負都錯的間接效果。
21.7 工作流程與報告
本章實務上的產出,是一套把「相互效果問題」變成「站得住腳的分析」的工作流程 (workflow),畫在圖 21.10 裡。它不是從模型開始,而是從估計標的開始:先陳述這項主張講的是人怎麼排序,還是一個人自己的偏離怎麼往下傳。接著走到測量那一層,決定手上有沒有多重指標 (multiple indicators) 與一次縱貫恆等性檢查,還是必須以單一指標的信度校正頂替,因為測量誤差對交叉延宕的損害是不對稱的。它配適估計標的所指向的候選模型 (candidate models),而只要主張帶方向性,就一定包含 CLPM 與 RI-CLPM 這組敏感度配對;比較它們時不只看配適,還要看實質結論在它們之間穩不穩定。最後它以主張階梯 (claims ladder) 所許可的語言來報告,不高過設計所支撐的那一級。表 21.5 是報告檢核表,而軟體方塊指出工具在哪裡。
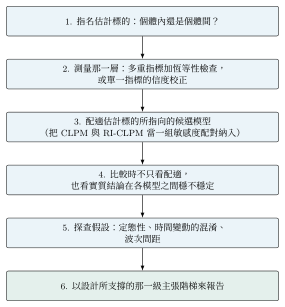
註:這套流程把估計標的放在模型之前,把測量那一層插在估計之前,對方向性的主張強制要求 CLPM 與 RI-CLPM 這組敏感度配對,並把結論的用語綁到設計所能支撐的那一級主張階梯(表 21.4)上。
表 21.5 相互效果研究的報告檢核表。
| 項目 | |
|---|---|
| 1 | 估計標的,以個體內或個體間的量陳述,且在任何模型之前 |
| 2 | 波次數、間距,以及間距是否相等;定態性假設及其檢定 |
| 3 | 測量模型:每個構念幾個指標、恆等性結果,或所用的信度校正 |
| 4 | 所配適的模型,而在主張帶方向性時 CLPM 與 RI-CLPM 都要報 |
| 5 | 標準化的個體內交叉延宕及其信賴區間,以及隨機截距的變異數與共變數 |
| 6 | 每個模型的配適指標,以及實質結論在它們之間是否穩定 |
| 7 | 假設探查:是否考慮過時間變動的混淆,是否承認條件化在先前結果上的對撞風險 |
| 8 | 結論的措辭落在設計所支撐的那一級主張階梯上,不再高 |
註:這份檢核表把「估計標的優先、敏感度必報」的立場化為操作。一項來自追蹤資料的方向性主張,若略去 RI-CLPM 的對照,或把結論說得高過所支撐的那一級,就是不完整的。
軟體提示 • 交叉延宕追蹤模型在各套軟體中的做法
在 lavaan 中,CLPM 是一個建在觀察分數上的普通路徑模型,而 RI-CLPM 的建法是加上單位負荷量的隨機截距因素、單位負荷量的個體內成分,並把觀察殘差變異數固定為零,與隨書的產生器完全相同;Mulder and Hamaker (2021) 所發布的模板也遵循同一套慣例。在 Mplus 中,RI-CLPM 的寫法是把隨機截距以 BY 掛到單位負荷量的觀察分數上,個體內成分同理定義,而動態放在個體內因素上。那座固定效果的橋在 R 中以個人平均數中心化再迴歸來算,就像分析腳本所做的;有 plm 與 fixest 套件時也可以用它們。至於那個避開 Nickell 偏誤的最大概似動態追蹤模型,Allison et al. (2017) 的做法是以一個受限的結構方程模型實作的。完整的工作流程,包括兩份模擬、家族配適、固定效果的對照、信度掃描與中介,都在隨書的 ch21_analysis_V01.R 之中。本章的各張圖形由中文版的 ch21_figures_zh_V01.R 繪製,而所用的兩份資料,則由 gen_panel_sim_V01.R 與 gen_school_panel_V01.R 建立。
本章摘要
交叉延宕追蹤模型由延宕迴歸來讀出相互影響,但當穩定的個體間差異存在時,而它們幾乎總是存在,它的單一自我迴歸分不開穩定特質與動態延續,於是交叉延宕把那份差額吸收過去,把相互效果灌大、壓小或憑空造出來;招牌模擬正是這樣報告了一條真值為零卻顯著的反向效果。隨機截距交叉延宕追蹤模型為每個變項加上一個穩定特質因素,並把動態搬到個體內成分上,還原了個體內的真相,並把每一條交叉延宕都重新解讀為個體內的量,代價是至少需要三個波次與一項定態性假設。從 CLPM 換到 RI-CLPM 是換了估計標的,不是一項純粹的更正;而那股反潮流,也就是「個體內效果是短期而且時點特定的」以及「個體間的前瞻問題有時候才是對的問題」,值得完整的份量;本書的紀律是先指名估計標的,並對任何方向性的主張把 CLPM 與 RI-CLPM 當一組敏感度配對報出來。更大的家族,ALT、LCM-SR、GCLM 與雙變量潛在變化分數模型,提供了與不同的特質、成長與動態假設相配的成員。由追蹤資料而來的因果主張是有界線的:個人層次的固定效果只移除得了時間不變的混淆,條件化在先前結果上可能打開對撞偏誤,而固定效果與 RI-CLPM 這兩個個體內估計式在交叉延宕上一致、在自我迴歸上因 Nickell 偏誤而分歧。縱貫中介必須尊重時間順序,因為對一個縱貫歷程做橫斷中介,其偏誤的大小與方向都不可知;而間接效果要附蒙地卡羅信賴區間報告。那座主張階梯把關聯、個體內預測與因果效果放在不同的級上,而結論的措辭不高過設計所支撐的那一級。
習題
- 21.1 重現招牌展示。把 CLPM 與 RI-CLPM 配適到
panel_sim上,確認那條假的交叉延宕與被還原的真相;然後在生成腳本中調高、調低特質相關,畫出 CLPM 在交叉延宕上的偏誤如何隨「變異數中屬於穩定特質的比例」而變。 - 21.2 把家族配一遍。在
school_panel的投入程度與學業成就資料上,配適 CLPM、RI-CLPM、ALT、LCM-SR 與雙變量潛在變化分數模型;以表 21.2 的樣式整理一份比較,並寫出「哪個模型回答哪個問題」的估計標的式裁決。 - 21.3 DAG 習題。把「CLPM 的交叉延宕等於一項因果效果」所需要的假設畫成一個有向無環圖,接著為一項投入程度與學業成就的研究指認一個可信的時間變動混淆變項,並指出 RI-CLPM 的免疫在哪裡失效。
- 21.4 固定效果的對照。在
panel_sim上以個人平均數中心化算出組內(固定效果)估計式,與 RI-CLPM 相比,並以 Nickell 偏誤與波次數解釋自我迴歸上的分歧。 - 21.5 縱貫中介。在
school_panel上配適縱貫中介並附蒙地卡羅信賴區間,接著在單一波次上配適橫斷中介,並以 Maxwell 與 Cole 的結果解釋兩者的分歧。 - 21.6 同儕審查演練。給定一段把 CLPM 交叉延宕報告成因果效果的稿件節錄,寫一份審查意見,指名那個估計標的問題,要求補做 RI-CLPM 的敏感度分析,並指明這份設計所能支撐的那一級主張階梯。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 交叉延宕追蹤模型 | cross-lagged panel model (CLPM) | 每個變項迴歸到前一波的兩個變項上;第 21.1 節 |
| 自我迴歸 | autoregression | 一個變項對自己過去的迴歸,讀作穩定性或延續效果;第 21.1 節 |
| 交叉延宕效果 | cross-lagged effect | 一個變項對另一個變項過去的迴歸;第 21.1 節 |
| 隨機截距 | random intercept | 在每一波以單位負荷量承載穩定特質的潛在因素;第 21.3 節 |
| 個體內成分 | within-person components | 一個人在某時點相對於自己期望水準的暫時偏離;第 21.3 節 |
| 自我迴歸潛在軌跡 | autoregressive latent trajectory (ALT) | 成長軌跡加上殘差的自我迴歸;第 21.4 節 |
| 帶結構化殘差的潛在曲線模型 | latent curve model with structured residuals (LCM-SR) | 成長軌跡加上建在殘差上的交叉延宕動態;第 21.4 節 |
| 一般化交叉延宕追蹤模型 | general cross-lagged panel model (GCLM) | 加入累積因素並讓衝擊同步移動;第 21.4 節 |
| 有向無環圖 | directed acyclic graph (DAG) | 用來推理因果結構的圖(承第 3 章);第 21.5 節 |
| 對撞因子 | collider | 兩個變項的共同結果;條件化在它上面會打開非因果路徑;第 21.5 節 |
| 固定效果 | fixed effects | 以個人平均數中心化移除穩定水準的估計式(承第 13 章);第 21.5 節 |
| Nickell 偏誤 | Nickell bias | 波次少時組內轉換使動態追蹤資料的自我迴歸向下偏誤;第 21.5 節 |
參考文獻
Allison, P. D. (2009). Fixed effects regression models. SAGE Publications. https://doi.org/10.4135/9781412993869
Allison, P. D., Williams, R., & Moral-Benito, E. (2017). Maximum likelihood for cross-lagged panel models with fixed effects. Socius: Sociological Research for a Dynamic World, 3, 2378023117710578. https://doi.org/10.1177/2378023117710578
Arellano, M., & Bond, S. (1991). Some tests of specification for panel data: Monte Carlo evidence and an application to employment equations. The Review of Economic Studies, 58(2), 277–297. https://doi.org/10.2307/2297968
Berry, D., & Willoughby, M. T. (2017). On the practical interpretability of cross-lagged panel models: Rethinking a developmental workhorse. Child Development, 88(4), 1186–1206. https://doi.org/10.1111/cdev.12660
Bollen, K. A., & Curran, P. J. (2004). Autoregressive latent trajectory (ALT) models: A synthesis of two traditions. Sociological Methods & Research, 32(3), 336–383. https://doi.org/10.1177/0049124103260222
Cole, D. A., & Maxwell, S. E. (2003). Testing mediational models with longitudinal data: Questions and tips in the use of structural equation modeling. Journal of Abnormal Psychology, 112(4), 558–577. https://doi.org/10.1037/0021-843X.112.4.558
Curran, P. J., Howard, A. L., Bainter, S. A., Lane, S. T., & McGinley, J. S. (2014). The separation of between-person and within-person components of individual change over time: A latent curve model with structured residuals. Journal of Consulting and Clinical Psychology, 82(5), 879–894. https://doi.org/10.1037/a0035297
Hamaker, E. L. (2026). The within-between dispute in cross-lagged panel research and how to move forward. Psychological Methods, 31(1), 56–76. https://doi.org/10.1037/met0000600
Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889
Hamaker, E. L., & Muthén, B. (2020). The fixed versus random effects debate and how it relates to centering in multilevel modeling. Psychological Methods, 25(3), 365–379. https://doi.org/10.1037/met0000239
Lucas, R. E. (2023). Why the cross-lagged panel model is almost never the right choice. Advances in Methods and Practices in Psychological Science, 6(1), 25152459231158378. https://doi.org/10.1177/25152459231158378
Lüdtke, O., & Robitzsch, A. (2022). A comparison of different approaches for estimating cross-lagged effects from a causal inference perspective. Structural Equation Modeling: A Multidisciplinary Journal, 29(6), 888–907. https://doi.org/10.1080/10705511.2022.2065278
Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989X.12.1.23
Mulder, J. D., & Hamaker, E. L. (2021). Three extensions of the random intercept cross-lagged panel model. Structural Equation Modeling: A Multidisciplinary Journal, 28(4), 638–648. https://doi.org/10.1080/10705511.2020.1784738
Orth, U., Clark, D. A., Donnellan, M. B., & Robins, R. W. (2021). Testing prospective effects in longitudinal research: Comparing seven competing cross-lagged models. Journal of Personality and Social Psychology, 120(4), 1013–1034. https://doi.org/10.1037/pspp0000358
Rogosa, D. (1980). A critique of cross-lagged correlation. Psychological Bulletin, 88(2), 245–258. https://doi.org/10.1037/0033-2909.88.2.245
Rohrer, J. M., & Murayama, K. (2023). These are not the effects you are looking for: Causality and the within-/between-persons distinction in longitudinal data analysis. Advances in Methods and Practices in Psychological Science, 6(1), 25152459221140842. https://doi.org/10.1177/25152459221140842
Selig, J. P., & Preacher, K. J. (2009). Mediation models for longitudinal data in developmental research. Research in Human Development, 6(2–3), 144–164. https://doi.org/10.1080/15427600902911247
Usami, S. (2021). On the differences between general cross-lagged panel model and random-intercept cross-lagged panel model: Interpretation of cross-lagged parameters and model choice. Structural Equation Modeling: A Multidisciplinary Journal, 28(3), 331–344. https://doi.org/10.1080/10705511.2020.1821690
Usami, S., Murayama, K., & Hamaker, E. L. (2019). A unified framework of longitudinal models to examine reciprocal relations. Psychological Methods, 24(5), 637–657. https://doi.org/10.1037/met0000210
VanderWeele, T. J., Mathur, M. B., & Chen, Y. (2020). Outcome-wide longitudinal designs for causal inference: A new template for empirical studies. Statistical Science, 35(3), 437–466. https://doi.org/10.1214/19-STS728
Zyphur, M. J., Allison, P. D., Tay, L., Voelkle, M. C., Preacher, K. J., Zhang, Z., Hamaker, E. L., Shamsollahi, A., Pierides, D. C., Koval, P., & Diener, E. (2020a). From data to causes I: Building a general cross-lagged panel model (GCLM). Organizational Research Methods, 23(4), 651–687. https://doi.org/10.1177/1094428119847278
Zyphur, M. J., Voelkle, M. C., Tay, L., Allison, P. D., Preacher, K. J., Zhang, Z., Hamaker, E. L., Shamsollahi, A., Pierides, D. C., Koval, P., & Diener, E. (2020b). From data to causes II: Comparing approaches to panel data analysis. Organizational Research Methods, 23(4), 688–716. https://doi.org/10.1177/1094428119847280