第 36 章
完整的工作流程:方法選擇、可重製性與報告
第 1 章許下一個承諾:關於變化的問題成家族出現,家族決定方法,而一位學會為問題命名的讀者,導得到對的分析。最後這一章就是那份承諾的稽核 (audit)。它把散在全書各處的導引裝置整併成一套決策系統,把「讓一次性的分析變成別人重建得了的結果」的可重製 (reproducible) 實作編成規範,把一章一章累積起來的報告檢核表調和成單一套標準,把貫串每一個方法章的敏感度 (sensitivity) 堅持形式化成一套教義,並且把縱貫與密集縱貫研究的預先註冊 (preregistration) 處理到它的時程所要求的實作深度。這一章不是一場合規的佈道。它所提出的每一項標準,都在一個從頭到尾走完的範例 (exemplar) 上示範它的回報,那是一份小而完整的研究,由一個問題出發,經過它的導引、它的預先註冊、它的管線 (pipeline)、它的主要分析、它的敏感度組合、它的報告稽核,一直到它的公開典藏庫 (repository),而每一步的推理都連回供應它的那一章。這個作為書擋 (bookend) 的結構是刻意的:第 1 章在任何方法存在之前先攤開那張地圖,而這一章在所有方法都存在之後重走同一張地圖,好讓那位一開始不知道該用哪個方法的讀者,最後不只知道怎麼選一個,還知道怎麼為那個選擇辯護、怎麼可重製地跑它,以及怎麼報告它,使得一位陌生人在許多年後看得到究竟做了什麼、也做得出同樣的事。這本書想留下的收尾意象很簡單:讀者做得到。
學習目標
讀完本章之後,你應該能夠:(1) 使用一套主決策系統 (master decision system),把問題家族與資料結構、以及你辯護得了的假設交叉起來,據以為一個主要分析、它必跑的敏感度組合,以及主張上限 (claim ceiling) 提出理由;(2) 建起一個可重製的縱貫專案,具備不可變動的原始資料 (immutable raw data)、鎖定的套件環境 (locked package environment)、受管理的管線 (managed pipeline)、一份亂數種子 (seed) 登錄簿,以及存檔的程式與資料;(3) 套用調和過的報告檢核表,並知道審查者現在對每一個模型家族所期待的項目;(4) 由分析岔路 (analytic fork) 登錄簿設計一份敏感度組合、把它當成一次多重宇宙 (multiverse) 分析來跑,並把「哪些岔路會移動結論」當成一項發現來報告;(5) 為一項縱貫或經驗取樣 (experience sampling) 研究作預先註冊,包含誠實的模型建構所要求的那些決策樹 (decision tree) 策略,並報告偏離;以及 (6) 以估計標的 (estimand) 優先、並帶著有紀律的不確定性語言來寫縱貫的結果,並在存放密集資料時處理它的再識別 (re-identification) 風險。
36.1 主決策系統
第 1 章以單一一張圖引入的那份導引 (routing),現在可以陳述成一套有三項輸入與三項輸出的系統。輸入是問題家族 (question family),也就是全書一路使用的那五個之一;資料結構 (data structure),由每人的時點數、人數、時機的規則性與結果的型態來描述;以及假設預算 (assumption budget),也就是設計與資料讓你辯護得了的那組假設,關於遺漏機制 (missingness mechanism)、測量的恆等性 (measurement invariance)、動態的定態性 (stationarity),以及量尺的等距 (interval) 意義。輸出是這些輸入所隱含的主要分析 (primary analysis)、主要分析的假設所要求的必跑敏感度分析,以及設計撐得起的主張上限。圖 36.1 是完整的地圖,也就是圖 1.5 的對應物,現在被本書發展過的每一個方法填滿,並在底部由本章要形式化的那條工作流程主幹收尾。表 36.1 是多數學生其實最先需要的那份搭檔,因為最難的一步不是在問題被命名之後選一個方法,而是把問題措辭到它的估計標的毫不含糊。
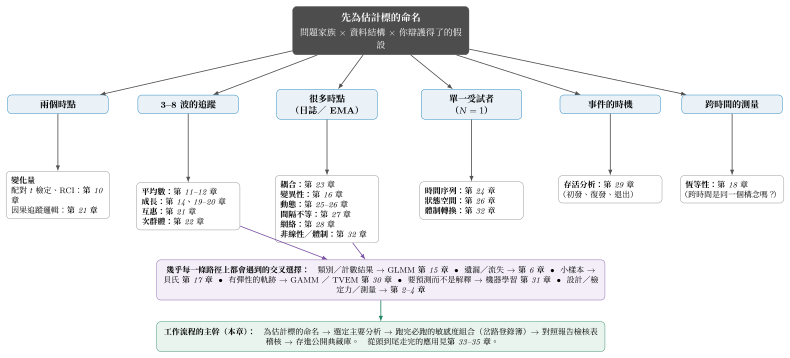
註:由最上方「為估計標的命名」進入,順著資料結構走到它的類別,再讀那片葉子上「回答每一個問題家族」的方法,現在包含第 1 章之後才發展出來的那些有彈性的、動態的與非線性的工具。紫色帶列出交叉的選擇;綠色帶加上本章要形式化的工作流程主幹。這就是圖 1.5 當初作為承諾畫下的那張地圖,如今在每一個方法都存在之後,被當成一次稽核重走一遍。
表 36.1 估計標的的措辭指引。
| 把問題措辭成 | 估計標的 | 方法家族 |
|---|---|---|
| 「在一個人 X 高於自己平常的那些天,他的 Y 是不是也比較高?」 | 個體內的關聯 (within-person association) | 多層次模型 (multilevel model)(第 23 章) |
| 「X 比較高的人,Y 是不是變化得比較快?」 | 由 X 預測的斜率 | 成長模型 (growth model)(第 14 章) |
| 「某個時點的 X 預報得了 Y 的變化嗎?」 | 個體內的交叉延宕 (within-person cross-lagged) | RI-CLPM/LCS(第 21 章) |
| 「多久之後會發生事件,又是什麼預測它?」 | 危險 (hazard) | 存活分析 (survival analysis)(第 29 章) |
| 「這個構念在每一波都是同一個嗎?」 | 恆等性 (invariance) | 縱貫驗證性因素分析 (longitudinal CFA)(第 18 章) |
註:措辭釘住估計標的,而估計標的釘住方法。含糊的措辭(「X 與 Y 隨時間有沒有關係?」)是多數方法選擇錯誤的來源,因為它分不出個體內與個體間的關聯,也分不出同時 (contemporaneous) 效果與延宕 (lagged) 效果。
一套決策系統是引導,不是赦免。當設計是新穎的、當好幾條路徑同樣站得住腳、或當那些假設排不出優劣時,這套系統與其說是失效,不如說是把問題連同它被攤開的結構一起交還給你,而誠實的回應不是癱瘓,而是一份敏感度組合 (sensitivity suite):把那幾條站得住腳的路徑都跑一遍,並報告它們一致或分歧。三個應用章展示過這套系統在真實問題上運作的樣子:一場臨床試驗被導向成長、退出與聯合模型 (joint model);一條發展連鎖被導向帶著估計標的紀律的追蹤模型家族;一份雙人日誌被導向多層次的行動者與伴侶模型 (actor-partner model)。那些導引在那裡已經走完;這裡的重點是,每一次都是由「為估計標的命名」開始,剩下的交給地圖。
36.2 可重製的縱貫專案
一個重建不了的結果是一項主張、不是一項發現,而縱貫專案格外脆弱,因為它把許多階段串在一起,清理、衍生、配適與繪圖,而且橫跨那些「抵達時很亂、之後又會演變」的資料。可重製的專案建立在幾條紀律上。原始資料是不可變動的 (immutable),只讀不寫,好讓每一份衍生資料都追溯得到一個未被碰過的源頭。套件環境是鎖定的 (locked),好讓產出某個結果的那些版本被記錄下來、也還原得回去,因為在某一版混合模型套件下配適出來的縱貫模型,可能與下一版不同。管線是受管理的 (managed),它的各階段連同依賴關係 (dependency) 被宣告出來,於是改動一項輸入就只重跑依賴它的那些、不多不少,那既是效率、也是一種文件,因為那張依賴圖就是分析的地圖。每一個隨機的步驟,每一條馬可夫鏈 (Markov chain)、每一次拔靴 (bootstrap)、每一次模擬與插補 (imputation),都由一顆登錄過的種子抽起,好讓隨機性是可重製的、而不只是看起來合理。而整個專案被連同一份資料編碼簿 (codebook) 存進典藏庫,好讓多年後的讀者重建得了它。圖 36.2 呈現這份解剖,圖 36.3 呈現範例的管線圖,而表 36.2 是每一個專案都該保有的種子登錄簿。
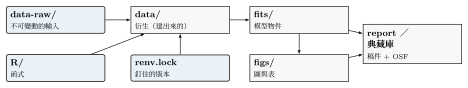
註:原始資料是不可變動的輸入;程式目錄裡的函式與一個鎖定的套件環境建出衍生資料,衍生資料餵給模型配適,配適餵給圖表與報告,最後存進一個公開的典藏庫。箭頭就是管線的依賴關係:改動一項輸入,就重建剛好依賴它的那些。目錄的慣例遵循「檔名帶版本、腳本有標頭、長計算設檢查點」的實驗室標準。
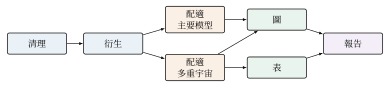
註:每一個節點是一個建置目標 (build target),每一支箭頭是一項依賴。主要配適與多重宇宙配適都依賴衍生資料、彼此獨立,因此改動多重宇宙的程式只會重跑它那一支。這張圖是由管線工具產生的、不是手畫的,因此它漂不離實際的分析,那正是它作為文件的價值。
表 36.2 種子與隨機步驟的登錄簿(範本)。
| 隨機的步驟 | 種子 | 在哪裡設定 | 平行 (parallel) 安全嗎? |
|---|---|---|---|
| 資料模擬 | \(20260820\) | 產生器腳本 | 不適用(單執行緒) |
| 拔靴法信賴區間 (bootstrap CI) | \(20260901\) | 分析腳本 | 是(每個工作者各一條流) |
| MCMC 鏈 | \(20260902\) | 配適腳本 | 是(每一條鏈) |
| 多重插補 (multiple imputation) | \(20260903\) | 插補腳本 | 是(每一次插補) |
註:每一個隨機步驟一列,記下種子、在哪裡設定,以及平行的工作者 (worker) 有沒有各自設種子。平行計算裡最常見的可重製性失敗,就是「只有一顆全域種子、工作者卻沒有設種子」,那讓整次執行看起來有設種子、實際上不可重製。
實務要點 • 當管線跟你作對
有兩種失敗反覆出現。一條「不會失效」的管線,也就是改了程式之後什麼都不重跑,通常表示那次改動改到了管線沒有當成依賴來追蹤的檔案,而修法是明確宣告那項依賴、不是強制重建,因為強制重建把問題藏起來了。一個「還原不了」的鎖定環境,也就是某個釘住的套件裝不回去,通常表示缺了一個系統層的函式庫、或那個版本已經被下架,而務實的分流是:把失敗記錄下來、裝上最接近的可得版本,並把這次替換寫成文件,而不是放棄那份鎖定。紀律不是要第一次就把可重製性做到完美,而是要讓每一次偏離都看得見,好讓讀者確切知道那次重建在哪裡離開了原始。
36.3 調和過的報告標準
全書一章一章累積起來的那些報告檢核表,涵蓋混合模型 (mixed model)、成長模型 (growth model)、恆等性、混合分配模型 (mixture model)、動態模型、網絡 (network)、存活分析 (survival analysis),以及有彈性的方法與機器學習,共享一根共同的主幹,而表 36.3 把它一次講清楚,並註明各家族的增補。這根主幹有七個要素:一份關於資料結構、遺漏與配合度 (compliance) 的描述;以方程式或毫不含糊的散文寫出的模型設定,語法放補充資料;一份關於估計方法、軟體、版本、設定與收斂診斷 (convergence diagnostics) 的陳述;連同自由度或診斷的推論程序;估計標的與它們的效果量 (effect size);敏感度的結果;以及視覺化的義務。各家族的增補是具體的,也正是一位方法審查者現在會查的東西:一個成長模型必須報告它的時間編碼 (time coding) 與隨機效果結構 (random effects structure),一個動態模型必須報告它如何處理定態性與去趨勢 (detrending),一個混合分配模型必須報告它決定類別數 (number of classes) 的準則與關於類別大小的但書,一個存活模型必須報告它的比例危險 (proportional hazards) 檢核,一個有彈性的模型必須報告它的平滑基底 (basis) 與共曲性 (concurvity)。期刊的現實在這裡介入,因為字數限制迫使材料搬到補充資料 (supplementary materials),而紀律是:把細節搬到補充資料而不把結果藏起來,好讓讀正文的人學到發現了什麼、讀補充資料的人重建得了它。
表 36.3 調和過的報告檢核表(主幹與各家族的增補)。
| 主幹的要素 | 該報告什麼(含各家族的增補) |
|---|---|
| 資料結構 | 人數、時點數、時機的規則性、結果型態;遺漏率與機制;配合度 |
| 模型設定 | 模型方程式或毫不含糊的散文;語法放補充資料。成長:時間編碼、隨機效果結構。動態:定態性、去趨勢。混合分配:決定類別數的準則 |
| 估計 | 方法、軟體、版本、執行選項;收斂(Rhat/有效樣本數 (effective sample size);Heywood 情形/奇異配適 (singular fit)) |
| 推論 | 檢定或區間的方法;自由度或診斷 |
| 估計標的 | 目標的量與它們的效果量,不只是 \(p\) |
| 敏感度 | 跑過的必跑岔路與它們的結果;分歧之處要點名 |
| 視覺化 | 呈現資料、不只是模型;把不確定性畫出來 |
註:主幹對每一個模型家族都共通;增補則是各家族特有、審查者現在會期待的項目。一份涵蓋了主幹與它那一家族增補的報告是可稽核的;一份省略估計版本或敏感度結果的報告則不是,不論它的頭條有多顯著。
36.4 形式化的敏感度教義
每一個方法章都堅持要作敏感度分析,而那份堅持現在可以形式化成一份登錄簿與一套方案 (protocol)。分析岔路登錄簿,也就是圖 36.4 與表 36.4,把依模型家族反覆出現的分析岔路編目起來,包括中心化 (centering) 的變體、時間編碼、隨機效果結構的替代方案、遺漏模型、去趨勢與延宕的選擇、決定類別數與調校 (tuning) 的決定,並把每一個標記成必跑或視脈絡而定。那套方案就是多重宇宙:先把岔路組合預先註冊下來,在管線的網格上系統性地跑完它,並把結果報告成一份設定摘要的呈現,讓每一個估計值連同它背後的分析選擇一起被看見,使分歧的型態變得可見。關鍵的那一步解讀是:會移動結論的那些岔路就是那項發現,因為一個「撐得過每一個站得住腳的選擇」的結論之所以強,恰恰是因為多重宇宙本來有機會推翻它而沒有推翻;而一個在某個中心化決定上翻掉的結論,是一個關於那個中心化的結論。把多重宇宙與 \(p\) 值操弄 (p-hacking) 分開的,是揭露 (disclosure) 與事前指定 (pre-specification):多重宇宙報告所有的設定,\(p\) 值操弄報告最好看的那一個。
那個範例把這件事變成具體的。問題是一個個體內的問題,也就是「一個人的負向情緒會不會在那個人壓力高於自己平常的那些時點上升」,估計在密集縱貫的 affect_ema 紀錄上,而主要分析,一個個人平均數中心化 (within-person-centered) 的隨機斜率 (random slope) 多層次模型,把反應性 (reactivity) 估計成 \(0.35\)、標準誤 (standard error) \(0.02\)。微型的多重宇宙在一個二十四種站得住腳的設定所構成的網格上重新估計它,交叉了中心化、隨機效果結構、延宕與共變項組合,而圖 36.5 呈現結果:二十四種設定每一種都回傳正的反應性,落在 \(0.31\) 到 \(0.36\) 的緊帶裡,因此「這個反應性是真的、而且是正的」這個結論撐得過每一條岔路,而最會移動大小的那一條岔路是共變項組合 (covariate set),控制同時的正向情緒會把估計值稍微往下拉。那段誠實的文字自己就從呈現裡寫出來了:反應性在所有站得住腳的設定下都是正的,它的大小穩定在「每一單位個體內壓力大約三分之一個量表點的負向情緒」附近,而沒有任何一項分析選擇推翻這個結論;那是一項單一研究說得出的最強的話,而且只有在多重宇宙被跑過並且被報告出來、而不是挑了單一一個設定的情況下,才說得出口。
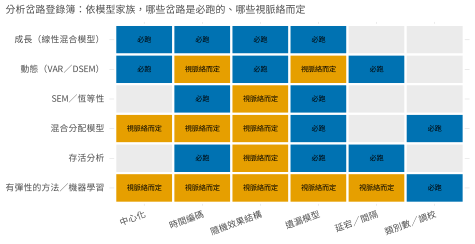
註:列是模型家族,行是反覆出現的分析岔路,而每一格把該家族的那條岔路標記成必跑(藍)、視脈絡而定(橘)或不適用(灰)。一個成長模型必須跑它的中心化、時間編碼、隨機效果結構與遺漏岔路;一個存活模型必須跑它的時間編碼、遺漏與間隔岔路。這份登錄簿把本書散落各處的敏感度建議,變成一份預先註冊事前就承諾得了的檢核表。
表 36.4 分析岔路登錄簿(選錄的家族)。
| 家族 | 反覆出現的岔路 | 必跑 |
|---|---|---|
| 成長(線性混合模型) | 中心化;時間編碼;隨機效果結構;遺漏 | 四項全部 |
| 動態(VAR/DSEM) | 去趨勢;延宕階數 (lag order);中心化;定態性 | 去趨勢;延宕 |
| 混合分配模型 | 決定類別數的準則;起始值 (starting values);共變項的處理 | 決定類別數 |
| 存活分析 | 時間編碼;比例危險檢核;競爭風險 (competing risks);遺漏 | 時間編碼;比例危險 |
| 有彈性的方法/機器學習 | 基底/調校;交叉驗證方案 (cross-validation scheme);正則化 (regularization) | 交叉驗證方案;調校 |
註:「必跑」那一欄點名的是「不去檢視它的變動並非選配」的那些岔路,因為它們的預設選擇在那個家族裡已知會移動結論。視脈絡而定的岔路,則在設計或資料讓它們變得有關時才跑。在一份預先註冊裡承諾這一組,正是讓一份敏感度組合成為驗證性、而不是探索性的關鍵。
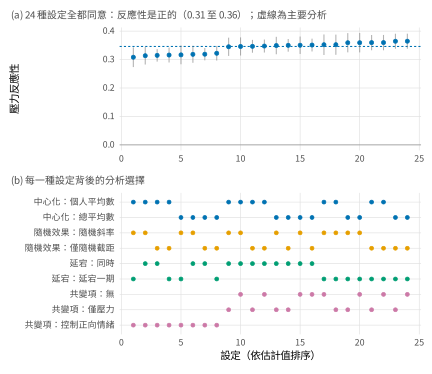
註:子圖 (a):在二十四種站得住腳的設定之下估出來的個體內壓力反應性,已排序,並附信賴區間;全部為正,而且落在主要估計(虛線)附近一條窄帶裡。子圖 (b):每一種設定背後的分析選擇,一條岔路層次一列。估計值最小的那些設定,正是控制了同時正向情緒的那些,指認出共變項組合是移動大小的那條岔路;沒有任何一條岔路改變正負號或改變質性的結論。那份穩健性 (robustness) 只有在整個網格都被跑過之後才看得見,而它就是那項發現。
36.5 縱貫研究的預先註冊
預先註冊買到的是一件具體的東西,也就是把驗證性 (confirmatory) 與探索性 (exploratory) 的分析分開,而它買不到免於思考的自由,也買不到真理的保證。對縱貫與經驗取樣研究而言,它有一些特有的形狀,而表 36.5 把「事前綁得住的」與「必須留給資料決定的」對照起來。即使模型建構真的是反覆迭代的,仍然有很多東西綁得住:估計標的、主要的設定、必跑的岔路組合、納入與配合度的規則,以及「模型將如何被建起來」的那棵決策樹,全都可以在看到資料之前指定,而誠實的中間路線是把決策樹、也就是「選擇將如何被作出」的規則預先註冊下來,而不是註冊一個真實資料一定會逼你放棄的固定終點。次級 (secondary) 與檔案 (archival) 資料,也就是許多縱貫工作所依賴的那種,仍然部分註冊得了:還沒被檢視過的變項、要在留出的切分 (held-out split) 上跑的分析,以及那組敏感度分析,都可以在資料已經存在的情況下承諾下來,因為預先註冊約束的是分析者、不是資料。偏離 (deviation) 是免不了的,也不是失敗;要緊的是它們被記錄下來、被報告出來,好讓讀者看得到分析在哪裡離開了它的計畫、並自行判斷那次離開。這個領域已經發展出來的經驗取樣預先註冊範本,在 Kirtley et al. (2021) 的譜系裡,逐節走過一個密集個體內設計所需要的部分;而一份為第 33 章臨床範例填好的範本,會在任何一次提示被分析之前,先指定它的取樣方案、它的配合度處理、它主要的個體內估計標的,以及它的敏感度組合。
表 36.5 縱貫研究的預先註冊涵蓋範圍對照表。
| 決定 | 事前綁得住嗎? | 說明 |
|---|---|---|
| 估計標的與主要模型 | 可以 | 核心的承諾 |
| 必跑的岔路組合 | 可以 | 來自岔路登錄簿 |
| 納入/配合度規則 | 可以 | 事前指定門檻 |
| 模型建構的策略 | 可以,以決策樹的形式 | 綁規則,不綁終點 |
| 確切的隨機效果結構 | 常常取決於資料 | 綁那條選擇規則 |
| 事後的動態分析 | 不行(探索性) | 報告成探索性 |
註:誠實的立場既不是「什麼都得事前固定」,那被反覆迭代的模型建構弄成不可能;也不是「什麼都不能固定」,那放棄了驗證性與探索性的區分。綁住決策樹,也就是「選擇將依哪一條規則作出」,既保住那道區分,又讓資料告知模型。
常見陷阱 • 預先註冊的表演與被埋起來的敏感度
有兩種失敗把這些實作掏空。預先註冊的表演,是把一份含糊的預先註冊當成一份強的來引用:一份只註冊了「我們會跑混合模型」的文件什麼也沒綁住,因為它沒有點名估計標的、設定或決策規則,而一位看到預先註冊徽章的讀者,該讀的是那份文件、不是那個徽章。被埋起來的敏感度,是把一份敏感度組合貶到補充資料、正文裡卻沒有任何綜合,於是二十四種設定坐在一張沒人看的表裡,而摘要只報一種:一份敏感度分析唯有在它的型態被寫進正文時,才賺得到它的可信度,就像範例那段誠實的文字所寫的那樣。這兩種失敗共有同一個形式,也就是有嚴謹的外觀而無它的實質,而兩者都被同一帖藥打敗:在正文裡說出做了什麼、以及它顯示了什麼。
36.6 寫作與存放
把縱貫的結果寫好,由估計標的開始:一句點名目標量的主題句,例如「負向情緒對壓力的個體內反應性為正,且跨設定穩定」,替讀者定位的方式是一句講顯著性的話做不到的。起草的工作流程是圖先行,先把「呈現結果」的那張圖建起來、再寫描述它的散文,因為一個呈現不出來的結果通常也信不過,而報告檢核表上那些視覺化的義務,是靠「畫資料、不只畫模型」來滿足的。不確定性的語言本身就是一門紀律,而表 36.6 把該避免的說法與它們誠實的替代品配成對,因為「壓力造成負向情緒」與「在壓力較高的時點上,同一個人的負向情緒較高」之間的差別,就是「一項設計撐不起的主張」與「一項它撐得起的主張」之間的差別。把一節多模型的結果安排好,意味著把它的車道標示出來,一條主要的車道、一條敏感度的車道與一條探索性的車道,用標題把那份知識論強制執行,好讓讀者絕不會把一項探索性的動態分析誤認成驗證性的。
表 36.6 不確定性的語言:該避免的說法與它們的替代品。
| 避免 | 改用 |
|---|---|
| 「X 造成 Y」(由觀察性的個體內資料) | 「在 X 較高的那些時點上,同一個人的 Y 較高」 |
| 「這個效果是顯著的」 | 「估計值是 \(0.35\),\(95\%\) 信賴區間 \([0.31,\ 0.38]\)」 |
| 「兩組沒有差異」 | 「差異是 \(0.02\),\(95\%\) 信賴區間 \([-0.10,\ 0.14]\),尚無定論」 |
| 「伴侶效果 (partner effect) 顯示有影響」 | 「那位伴侶的預測變項預報了結果;影響並未被建立」 |
| 「變異性先於下降」(當成定律) | 「在這份資料裡變異性先於平均數上升,個人層次的關聯幅度不大」 |
註:那些替代品比較長,是因為它們比較精確:它們陳述估計標的、附上不確定性,並拒絕設計撐不起的因果或普遍主張。習慣那些替代品,就是誠實的縱貫寫作的習慣。
存放把第 1 章打開的那個迴圈關上。一項縱貫研究的公開典藏庫有一份解剖,圖 36.6,包含原始與衍生資料、程式、一份資料編碼簿、那份預先註冊與稿件,並且分層 (tiered) 放置,使得可以開放的開放、必須保護的受管控 (controlled access)。這份保護對密集縱貫資料最要緊,因為它們密集的行為軌跡在「稀疏調查資料所不會」的意義上是可再識別的:一串時戳與位置,即使名字被移除,仍然單獨指認得出一個人;而表 36.7 列出那些技術,時戳 (timestamp) 粗化、地理資料移除,以及「任何一筆紀錄都不該在它的準識別項 (quasi-identifier) 上是唯一的」那個 \(k\) 匿名性 (k-anonymity) 直覺,連同每一項各自防住什麼、又各自付出什麼代價。當原始軌跡沒辦法安全地開放時,一份由配適好的模型產生的合成 (synthetic) 伴隨資料,也就是本書為每一個實作範例所用的那個裝置,讓讀者重建得了分析而不曝光任何一位參與者,那是一個很合適的收尾對稱:教會這些方法的那些模擬資料集,同時也是安全分享真實資料的範本。
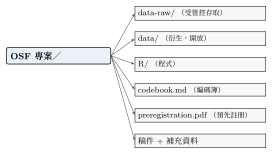
註:一個分層的典藏庫:衍生資料、程式、資料編碼簿、預先註冊與稿件都是開放的,而可能讓參與者被再識別的原始密集資料則受管控存取。當連分層釋出都不安全時,一份由配適好的模型產生的合成資料集,讓讀者重建得了分析而不曝光任何人,那正是本書用來教會每一個方法的同一個裝置。
表 36.7 密集縱貫資料的去識別化技術。
| 技術 | 防住什麼 | 代價 |
|---|---|---|
| 時戳粗化 | 以精確時間再識別 | 失去一天之內細部的動態 |
| 移除地理資料 | 以位置辨識 | 失去空間的共變項 |
| 準識別項上的 \(k\) 匿名性 | 在人口學變項上的唯一性 | 可能需要彙總 |
| 合成的伴隨資料 | 所有直接的再識別 | 保住的是模型化後、而非原始的結構 |
註:每一項技術都在保護與分析忠實度之間權衡。密集的行為軌跡在稀疏資料所不會的意義上是可再識別的,因此密集縱貫資料的預設是分層釋出、原始軌跡受管控存取,而在「開放地重建」比「原始的忠實度」更要緊時,配上一份合成的伴隨資料。
實務要點 • 倫理:開放資料與再識別的責任
推動開放資料是對的,而它撞上一項密集縱貫研究讓它變得尖銳的責任:行為紀錄越密,一位去識別化的參與者就越容易被再識別,於是一次完全開放的原始經驗取樣軌跡釋出,可能違反一份知情同意 (informed consent) 並未在知情之下放棄的信任。解方不是放棄開放,而是把它分層,開放那些讓別人重建得了分析的衍生資料與程式,同時管控那些可能曝光一個人的原始軌跡;並且取得一份誠實描述分享計畫的知情同意,而不是承諾一份會危及參與者的開放。照護的責任與開放的責任兩者都是真的,而「分層的典藏庫加上一份合成的伴隨資料」正是一項研究同時兌現兩者的方式。
軟體提示
可重製性的工具堆疊變動很快,具體的工具在採用之前應該對照它們當下的文件核對。在撰寫的當下,常見的縱貫堆疊是:一個記錄並還原釘住版本的套件鎖定工具、一個宣告建置目標與它們依賴關係並只重跑改動部分的管線工具、一套把散文與程式交織起來使敘述漂不離計算的文學式分析 (literate analysis) 系統,以及一個把專案存進公開典藏庫的用戶端。這些工具的應用程式介面 (API) 會跨版本改變;不會改變的是它們所編碼的紀律,也就是不可變動的輸入、釘住的版本、宣告出來的依賴、登錄過的種子與存檔的輸出,而那份紀律用任何工具、甚至不用工具都實行得了。對一位合作者還沒這樣工作的讀者而言,一份最小可行的採用順序是:先做種子與帶版本的檔名,再做鎖定的環境,再做那些檢核表,再做受管理的管線,最後才是完整的敏感度組合。
36.7 從頭到尾的範例
那個範例現在可以整個讀一遍,那是一份走完整套系統的小型研究。問題,以「釘住它的估計標的」的方式措辭,是「負向情緒會不會在一個人壓力較高的那些時點上升」,而估計標的的措辭指引把它導向一個個體內的多層次模型。那份在分析之前歸檔的預先註冊,點名了那個估計標的、把個人平均數中心化的隨機斜率設定當成主要分析、把二十四格的岔路網格當成必跑的敏感度組合,以及一條關於隨機效果結構的決策規則。管線由不可變動的原始提示紀錄建出衍生資料,把主要模型與多重宇宙當成互相獨立的兩支來配適,再畫出那些呈現,而每一個隨機的步驟都由登錄簿取種子。主要分析回傳 \(0.35\) 的反應性,而圖 36.7 以它該被呈現的方式呈現這個結果,不是一個單一的數字,而是一整組逐人的反應性圍繞著合併估計 (pooled estimate) 的分配,平均而言為正、也因人而異,好讓「一個個體內效果在個體間的異質性 (heterogeneity)」看得見、而不是被藏起來。那份敏感度組合,也就是圖 36.5 的設定曲線,確認估計值在全部二十四種設定下都是正的,並指認出共變項組合是唯一會明顯移動它的岔路。對照調和過的檢核表所作的報告稽核,確認資料結構、設定、估計的版本、推論、估計標的、敏感度與視覺化全都在。而存放則把衍生資料、程式、資料編碼簿、預先註冊,以及一份合成的伴隨資料,存進一個分層的典藏庫。每一個動作都追溯得到它的那一章,而整體是一份陌生人重建得了的研究。
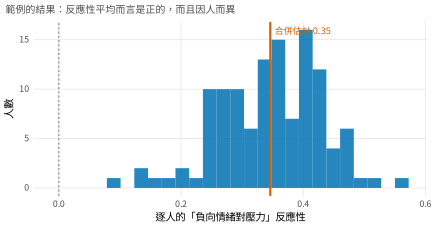
註:負向情緒對壓力的逐人反應性,並標出合併的估計值。這個效果對幾乎每一個人都是正的,而它的大小因人而異,那正是「一個個體內效果在個體間的異質性」,一個單一的合併數字會把它藏起來。呈現這個分配、而不是那個點,就是報告檢核表所加諸的視覺化義務,也是上一節所主張的估計標的優先寫作。英文版此圖的檔名是 ch36_fig09_exemplar.pdf,與印出來的圖號 \(36.7\) 不合,圖形腳本的區塊標題也跟著錯;見 EN-36-01。
這本書出發時要讓變化變得可分析,而它結束在它開始的地方,也就是那張地圖。第 1 章把那張地圖畫成一個對「還不知道該用哪個方法的讀者」的承諾;這一章把它當成一次稽核走了一遍,每一個方法都建好、每一張檢核表都調和過、每一條教義都形式化,而整體在一個誠實的例子上被示範過。兩個作為書擋的章節合起來提出的主張是:分析變化不是一份要背下來的技術目錄,而是一門要實行的紀律:為估計標的命名,選問題所隱含的方法,跑它的假設所要求的敏感度,把做了什麼報告出來好讓陌生人看得見,並把它存起來好讓陌生人重建得了。走到這裡的讀者做得到,而那正是重點。
本章摘要
這一章把整本書整併成一套工作流程。主決策系統把問題家族與資料結構、以及辯護得了的假設交叉起來,產出一個主要分析、一組必跑的敏感度,以及一道主張上限,而圖 36.1 完成了圖 1.5 開始的那張地圖。可重製專案那一節固定了不可變動的原始資料、鎖定的環境、受管理的管線與種子登錄簿這些紀律。調和過的檢核表把每一個模型家族共通的報告主幹與它們各自的增補一次講清楚。敏感度的教義被形式化成一份岔路登錄簿與一套多重宇宙方案,而範例的設定曲線顯示一個個體內的反應性在全部二十四種站得住腳的設定下都是正的,撐得過除了共變項組合以外的每一條岔路,那是一項單一研究提得出的最強主張,而且只有在整個網格被跑過並且被報告出來時才提得出。預先註冊被處理到實作的深度,綁的是決策樹而不是一個固定的終點,並且即使對檔案資料也仍然部分可行。寫作被要求估計標的優先、並使用有紀律的不確定性語言,而存放被要求分層,以一份合成的伴隨資料保護密集資料裡那些可再識別的軌跡。這本書結束在它開始的地方,也就是那張地圖,如今是走過的、而不只是承諾過的:為估計標的命名,選方法,跑敏感度,誠實地報告,開放地存放。讀者做得到。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 假設預算 | assumption budget | 設計與資料讓你辯護得了的那組假設;第 36.1 節 |
| 主張上限 | claim ceiling | 設計撐得起的最強結論(承第 32 章);第 36.1 節 |
| 不可變動的原始資料 | immutable raw data | 只讀不寫,使每一份衍生資料都追溯得到源頭;第 36.2 節 |
| 鎖定的套件環境 | locked package environment | 記錄並還原產出結果的那些版本;第 36.2 節 |
| 建置目標 | build target | 管線裡的一個節點,連同它宣告出來的依賴;第 36.2 節 |
| 種子登錄簿 | seed registry | 每一個隨機步驟一列,記下種子與設定的位置;第 36.2 節 |
| 分析岔路 | analytic fork | 一個站得住腳、但會影響估計值的分析選擇;第 36.4 節 |
| 多重宇宙分析 | multiverse analysis | 系統性地跑完整個岔路網格並全部報告;第 36.4 節 |
| 設定曲線 | specification curve | 把每一種設定的估計值連同它的分析選擇一起呈現;第 36.4 節 |
| 決策樹(預先註冊) | decision tree | 綁住「選擇將如何作出」的規則,而不是終點;第 36.5 節 |
| 準識別項 | quasi-identifier | 合起來足以指認一個人的那些變項;第 36.6 節 |
| \(k\) 匿名性 | \(k\)-anonymity | 任何一筆紀錄在準識別項上都不唯一;第 36.6 節 |
| 合成的伴隨資料 | synthetic companion data | 由配適好的模型產生,可重建分析而不曝光個人;第 36.6 節 |
參考文獻
Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609–610. https://doi.org/10.1016/j.cortex.2012.12.016
Gelman, A., & Loken, E. (2014). The statistical crisis in science. American Scientist, 102(6), 460–465. https://doi.org/10.1511/2014.111.460
Kirtley, O. J., Lafit, G., Achterhof, R., Hiekkaranta, A. P., & Myin-Germeys, I. (2021). Making the black box transparent: A template and tutorial for registration of studies using experience-sampling methods (ESM). Advances in Methods and Practices in Psychological Science, 4(1), 2515245920924686. https://doi.org/10.1177/2515245920924686
Klein, O., Hardwicke, T. E., Aust, F., Breuer, J., Danielsson, H., Hofelich Mohr, A., IJzerman, H., Nilsonne, G., Vanpaemel, W., & Frank, M. C. (2018). A practical guide for transparency in psychological science. Collabra: Psychology, 4(1), 20. https://doi.org/10.1525/collabra.158
Landau, W. M. (2021). The targets R package: A dynamic Make-like function-oriented pipeline toolkit for reproducibility and high-performance computing. Journal of Open Source Software, 6(57), 2959. https://doi.org/10.21105/joss.02959
Meyer, M. N. (2018). Practical tips for ethical data sharing. Advances in Methods and Practices in Psychological Science, 1(1), 131–144. https://doi.org/10.1177/2515245917747656
Munafò, M. R., Nosek, B. A., Bishop, D. V. M., Button, K. S., Chambers, C. D., Percie du Sert, N., Simonsohn, U., Wagenmakers, E.-J., Ware, J. J., & Ioannidis, J. P. A. (2017). A manifesto for reproducible science. Nature Human Behaviour, 1(1), 0021. https://doi.org/10.1038/s41562-016-0021
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114
Peikert, A., & Brandmaier, A. M. (2021). A reproducible data analysis workflow with R Markdown, Git, Make, and Docker. Quantitative and Computational Methods in Behavioral Sciences, 1, e3763. https://doi.org/10.5964/qcmb.3763
Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Simonsohn, U., Simmons, J. P., & Nelson, L. D. (2020). Specification curve analysis. Nature Human Behaviour, 4(11), 1208–1214. https://doi.org/10.1038/s41562-020-0912-z
Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
Trull, T. J., & Ebner-Priemer, U. W. (2020). Ambulatory assessment in psychopathology research: A review of recommended reporting guidelines and current practices. Journal of Abnormal Psychology, 129(1), 56–63. https://doi.org/10.1037/abn0000473
Van Lissa, C. J., Brandmaier, A. M., Brinkman, L., Lamprecht, A.-L., Peikert, A., Struiksma, M. E., & Vreede, B. M. I. (2021). WORCS: A workflow for open reproducible code in science. Data Science, 4(1), 29–49. https://doi.org/10.3233/DS-210031
Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, 1832. https://doi.org/10.3389/fpsyg.2016.01832
Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), e1005510. https://doi.org/10.1371/journal.pcbi.1005510