第 26 章
動態因素分析與狀態空間模型
前面幾章一路蓋起了一系列的動態模型,一個給單一條自我迴歸 (autoregression) 序列,一個給一整個向量的序列,一個再加上潛在的分解與隨機的動態,而每一個都帶著自己的記號與自己的估計式 (estimator) 登場。本章要說的是:它們其實是同一個模型。線性高斯狀態空間 (linear Gaussian state-space) 形式只有兩條方程式,一條狀態方程式 (state equation) 讓一個潛在歷程 (latent process) 隨時間演化,一條觀察方程式 (observation equation) 帶著誤差去測量它;只要選定狀態裡裝什麼、矩陣怎麼填,它就會變成一個自我迴歸、一個移動平均 (moving average)、一個向量自我迴歸、一條潛在成長曲線 (latent growth curve),或一個動態因素模型 (dynamic factor model)。卡爾曼濾波器 (Kalman filter) 是它的推論引擎,一個遞迴 (recursion) 就同時交出估計用的概似 (likelihood)、第 24 章就承諾過的遺漏時點的精確處理,以及診斷用的殘差,全都是同一趟前向掃描的副產品。統一並不是本章唯一的目的。狀態空間形式劃出了一條前面每一章都糊掉的界線,也就是測量誤差 (measurement error) 與歷程雜訊 (process noise) 之間、施測的雜訊與這個人狀態真正受到的衝擊 (shock) 之間的界線,並且指出把兩者混為一談會使動態產生偏誤 (bias),那正是本章在心理計量 (psychometrics) 上的核心回報。而動態因素模型,也就是帶著一個既演化又被測量的潛在因素 (latent factor) 的狀態空間形式,正是第 24 章標出缺陷的那個 P 技術 (P-technique) 的修補:一個終於帶著自己序列依賴 (serial dependence) 的逐人因素結構。這些矩陣會被溫和地引入,每一個都配上一句心理學的說法,因為這些模型是隨時間展開的潛在變項 (latent variable) 模型,是第五部分那些結構方程模型 (structural equation model) 的表親,不是控制工程 (control engineering) 的產物。
學習目標
讀完本章之後,你應該能夠:(1) 寫出狀態空間形式的狀態方程式與觀察方程式,並為「帶測量誤差的 AR(1)」、局部線性趨勢 (local linear trend)、VAR(1) 與動態因素模型各自填好矩陣,也就是「一個形式、多種模型」的本事;(2) 把卡爾曼濾波器與平滑器 (smoother) 說成一個「先預測、再更新」的遞迴,把卡爾曼增益 (Kalman gain) 讀成第 13 章收縮 (shrinkage) 意義下的信度 (reliability) 權重,並分辨濾波 (filtering) 與平滑 (smoothing) 的估計值;(3) 把測量誤差與歷程雜訊分開,並說明混為一談為什麼會使動態衰減 (attenuate),那是第 25 章測量誤差那條線的延伸;(4) 設定一個動態因素模型,分辨歷程因素 (process-factor) 形式與直接自我迴歸分數 (direct-autoregressive score) 形式,並說出它的識別 (identification) 要求;(5) 配適單人與多人的動態因素模型,並解讀逐人的測量與逐人的動態;(6) 以標準化的創新 (innovation) 診斷一個狀態空間配適,檢查它是否已漂白、是否常態,以及有無離群值 (outlier);(7) 判斷什麼時候狀態空間這套做法值得它相對於第 25 章工具的額外成本。
26.1 一個形式,容納所有模型
狀態空間形式就是兩條方程式。觀察方程式 \(\mathbf{y}_t = \mathbf{Z}\,\boldsymbol{\alpha}_t + \boldsymbol{\varepsilon}_t\),其中 \(\boldsymbol{\varepsilon}_t \sim N(\mathbf{0}, \mathbf{H})\),說的是在時點 (occasion) \(t\) 測到的東西,是一個負荷量矩陣 (loading matrix) \(\mathbf{Z}\) 乘上一個潛在狀態 \(\boldsymbol{\alpha}_t\),再加上測量誤差 \(\boldsymbol{\varepsilon}_t\)。狀態方程式 \(\boldsymbol{\alpha}_t = \mathbf{T}\,\boldsymbol{\alpha}_{t-1} + \boldsymbol{\eta}_t\),其中 \(\boldsymbol{\eta}_t \sim N(\mathbf{0}, \mathbf{Q})\),說的是潛在狀態依一個轉移矩陣 (transition matrix) \(\mathbf{T}\) 演化,並由歷程雜訊 \(\boldsymbol{\eta}_t\) 推動。這兩個雜訊項不是同一回事,而把它們分開正是整件事的重點。測量誤差 \(\boldsymbol{\varepsilon}_t\) 是施測的雜訊,是工具的不可靠,是一個情緒評分裡「反映的是題目本身含糊、而不是這個人真實狀態」的那一部分。歷程雜訊 \(\boldsymbol{\eta}_t\) 則是真正的衝擊,是這個人的狀態從一個時點到下一個時點的真實變化。前面每一章只要把一個觀察分數迴歸到它自己的延宕 (lag) 上,就默默地把這兩者熔在一起,而本章要把它們分開。圖 26.1 把這兩條方程式連同它們的心理學讀法一起畫了出來。
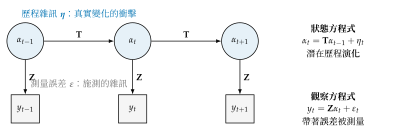
註:狀態方程式讓一個潛在狀態 \(\alpha_t\) 透過轉移矩陣 \(\mathbf{T}\) 演化,並受到歷程雜訊(真實的變化)擾動。觀察方程式透過負荷量矩陣 \(\mathbf{Z}\) 去測量這個狀態,而測量會被測量誤差(施測的雜訊)汙染。把這兩種雜訊分開,是這個形式在心理計量上最核心的貢獻。這張圖在第 27 與第 32 章會再次出現。
這項分離立刻帶來一個把第 24 章重新框起來的事實。一個被帶著測量誤差觀察到的一階自我迴歸 (first-order autoregressive, AR(1)),根本就不是一個自我迴歸;代數上它是一個 ARMA(1,1),而它天真的延宕一期自我相關 (autocorrelation) 會依這個測量不可靠的程度低估真實的延續效果 (carryover)。機制正是測量誤差加在任何一個相關上的那份衰減 (attenuation),只是這裡被用在「一條序列與它自己的過去」的相關上。圖 26.2 在 kalman_n1 上把這件事講得很具體,那是一條由潛在的 AR(1) 生成、真實延續效果為 \(0.60\)、在信度 \(0.65\) 下被帶誤差觀察到的單一受試者 (single-subject) 序列。左圖顯示天真的自我迴歸隨著信度變差而穩定下滑,掉到遠低於真值的位置;在這條序列上,天真的延宕一期自我相關是 \(0.46\),離生成用的 \(0.60\) 差得很遠。右圖則把修補與它的代價一起呈現:一個把測量誤差另外建模的卡爾曼最大概似 (maximum likelihood) 配適還原出 \(0.61\) 的延續效果,而跨一百條模擬序列來看它平均而言是不偏的,但它在每一條序列上的估計值都很有雜訊,因為要從一條短序列裡把兩個變異數分開,是一項苛刻的要求。這項分離在期望上是成功的,而且必須連同它的不確定性 (uncertainty) 一起報告。
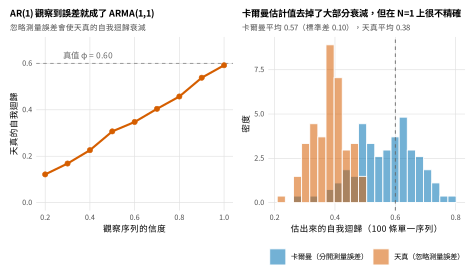
註:左:一條帶誤差的序列,它天真的自我迴歸隨著信度變差而掉到真實延續效果(\(0.60\))之下。右:跨 100 條單一序列的抽樣分配 (sampling distribution);把測量誤差另外建模的卡爾曼估計值落在真值附近,天真的估計值則被往零的方向衰減。這項分離平均而言是不偏的,但由一條序列來看很不精確。
同樣的兩條方程式,換上不同的矩陣,就成了那些熟悉的模型,而把那些矩陣填好正是本節要建立的本事。圖 26.3 列出五張卡片。一個帶測量誤差的 AR(1) 有一個純量 (scalar) 狀態,\(\mathbf{T} = \phi\)、\(\mathbf{Z} = 1\)、歷程變異數 \(\mathbf{Q} = \sigma^2_\eta\)、測量變異數 \(\mathbf{H} = \sigma^2_\varepsilon\)。一個局部線性趨勢,也就是「一個水準 (level) 隨著一個緩慢改變的斜率 (slope) 漂移」的結構時間序列 (structural time series) 模型,有一個由水準與斜率組成的二維狀態,而它的轉移矩陣把斜率帶進水準裡。一個 VAR(1) 有一個向量狀態與一個完整的轉移矩陣,也就是第 25 章的模型,在無誤差測量時 \(\mathbf{H} = \mathbf{0}\),否則 \(\mathbf{H} \neq \mathbf{0}\)。一個動態因素模型有一個會演化的潛在因素狀態,以及一個透過數個指標 (indicator) 去測量它的負荷量矩陣。而第 19 章的潛在成長曲線,就是一個狀態為截距 (intercept) 與斜率、轉移矩陣讓它們保持不變、負荷量矩陣隨時間變動而把斜率讀到接續的各個時點上的狀態空間模型,這一點把第五與第六部分統一在同一個形式之下。表 26.1 為每個矩陣命名,並給出它的維度、心理學意義,以及它在結構方程或多層次 (multilevel) 模型中的對應物;表 26.2 則說明五個模型各自在每個矩陣裡放了什麼。
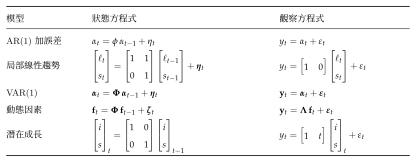
註:每一個熟悉的模型都是「填了特定矩陣的狀態空間形式」。自我迴歸、趨勢模型、向量自我迴歸、動態因素模型與潛在成長曲線之間的差別,只在於狀態裡裝什麼、轉移矩陣怎麼移動它,以及負荷量矩陣怎麼讀它。潛在成長的負荷量隨時間變動,而那正是一個靜態的成長模型成為狀態空間模型的關鍵。
表 26.1 狀態空間的各個物件與它們的對應物。
| 物件 | 名稱 | 心理學上的意義 | SEM/MLM 的對應物 |
|---|---|---|---|
| \(\boldsymbol{\alpha}_t\) | 狀態向量 | 這個人此刻的潛在狀態 | 潛在因素/隨機效果 |
| \(\mathbf{T}\) | 轉移矩陣 | 狀態如何往前延續與耦合 (couple) | 自我迴歸/交叉延宕 |
| \(\mathbf{Q}\) | 歷程共變數 | 真實變化衝擊的大小 | 創新/擾動 (disturbance) 變異數 |
| \(\mathbf{Z}\) | 負荷量矩陣 | 狀態如何顯現在測量上 | 因素負荷量 |
| \(\mathbf{H}\) | 測量共變數 | 施測的雜訊 | 殘差/獨特 (unique) 變異數 |
| \(\boldsymbol{\alpha}_1, \mathbf{P}_1\) | 起始狀態 | 歷程從哪裡開始 | 外生 (exogenous) 平均數與變異數 |
註:每一個狀態空間物件都有一個熟悉的表親。轉移矩陣就是自我迴歸,負荷量矩陣就是因素負荷量,歷程共變數就是創新變異數,而測量共變數就是一個測量模型 (measurement model) 裡的獨特變異數。
表 26.2 每個模型在每個矩陣裡放了什麼。
| 模型 | 狀態維度 | \(\mathbf{T}\) | \(\mathbf{Z}\) | \(\mathbf{H}\) |
|---|---|---|---|---|
| AR(1) 加誤差 | 1 | \(\phi\) | \(1\) | \(\sigma^2_\varepsilon > 0\) |
| 局部線性趨勢 | 2 | \(\left[\begin{smallmatrix}1&1\\0&1\end{smallmatrix}\right]\) | \([1\ 0]\) | \(\sigma^2_\varepsilon\) |
| VAR(1) | \(p\) | \(\boldsymbol{\Phi}\)(完整) | \(\mathbf{I}\) | \(\mathbf{0}\) 或對角 |
| 動態因素 | \(k\)(因素數) | \(\boldsymbol{\Phi}\)(因素 VAR) | \(\boldsymbol{\Lambda}\)(負荷量) | 對角且 \(> 0\) |
| 潛在成長 | 2 | \(\mathbf{I}\) | \([1\ \ t]\)(隨時間變動) | \(\sigma^2_\varepsilon\) |
註:各模型的差別在狀態維度,以及哪些矩陣是自由的、固定的或隨時間變動的。把 \(\mathbf{H}=\mathbf{0}\) 固定住,就把一個狀態空間模型變回一個觀察分數 (observed-score) 模型,而那正是本章在測量誤差確實存在時所要警告的簡化。
26.2 卡爾曼這具引擎
卡爾曼濾波器是一個沿著序列往前走的遞迴,而它在每一個時點做兩件事。它預測 (predict):拿前一個時點對狀態最好的估計,用轉移矩陣把它帶到對此刻狀態的一個預測上,而不確定性依歷程雜訊增長。它更新 (update):新的觀察值抵達,它與預測所隱含的值之間的差距就是創新,而狀態估計值會依一個叫作卡爾曼增益的量往觀察值修正。圖 26.4 把這個迴路畫了出來。增益是整件事的核心,而它就是第 13 章收縮意義下的信度權重。當測量相對於狀態的不確定性而言很精確時,增益很大,估計值幾乎整個移向觀察值;當測量有雜訊時,增益很小,估計值就留在模型的預測附近。濾波器是在以最佳的方式權衡一個事前的預報與一個帶雜訊的資料點,以精確度對精確度,而那正是「把一個人的估計值往群體平均數收縮」的同一套加權平均邏輯,只是現在在時間上運作。
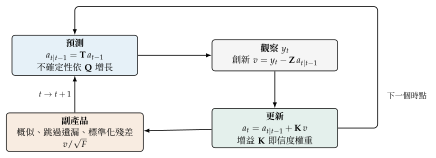
註:在每一個時點,濾波器先由轉移矩陣預測狀態(不確定性依歷程雜訊增長),再依卡爾曼增益往新的觀察值更新;增益是一個信度權重,測量精確時它大,測量有雜訊時它小。概似、遺漏資料的處理與標準化殘差都由同一趟掃描掉出來。
從那一趟前向掃描裡掉出三樣東西,而它們合起來就是這套做法值得付出的理由。概似透過預測誤差分解 (prediction-error decomposition) 免費取得:每一個創新以它自己的變異數標準化之後貢獻一個高斯項,而它們的和就是精確的對數概似 (log-likelihood),於是轉移、負荷量與各變異數參數的最大概似估計,就是一連串濾波器執行結果上的最佳化。遺漏資料被精確處理而且不需要插補 (imputation):當一個時點沒有被觀察到,更新這一步就直接跳過,預測往前帶,而狀態的不確定性持續增長直到下一個觀察值抵達,那正是第 24 章指出「天真的內插 (interpolation) 會灌大自我相關」的那個問題有原則的修補。而標準化的一步前 (one-step-ahead) 創新就是診斷用的殘差,模型對的時候它們是白的、常態的。基礎概念方塊以形式化的方式寫出概似分解與「AR 加誤差」的代數。
基礎概念 • 預測誤差分解與「AR 加誤差」的代數
執行濾波器,並在每一個被觀察到的時點收集創新 \(v_t = y_t - \mathbf{Z}\,a_{t|t-1}\) 與它的變異數 \(F_t = \mathbf{Z}\,P_{t|t-1}\mathbf{Z}^{\top} + \mathbf{H}\)。因為這些創新按其構造是彼此獨立且高斯的,整條序列的對數概似就分解成它們各自的貢獻,\(\log L = -\tfrac{1}{2}\sum_t \big(\log 2\pi + \log F_t + v_t^2/F_t\big)\),這就是預測誤差分解。正是它讓整個狀態空間家族的最大概似只靠一個遞迴就做得出來。至於「AR 加誤差」的情形,設潛在狀態為 \(\alpha_t = \phi\,\alpha_{t-1} + \eta_t\),且 \(\mathrm{Var}(\alpha) = \sigma^2_\eta/(1-\phi^2)\),被觀察成 \(y_t = \alpha_t + \varepsilon_t\),且 \(\mathrm{Var}(\varepsilon) = \sigma^2_\varepsilon\)。那麼被觀察到的延宕一期自我相關是 \(\rho_1 = \phi\,\mathrm{Var}(\alpha)/(\mathrm{Var}(\alpha) + \sigma^2_\varepsilon) = \phi\,R\),其中 \(R\) 就是信度,而更高階的延宕以 \(\phi^k R\) 衰減,那正是一個 ARMA(1,1) 的自我相關指紋。天真的估計值回傳的是 \(\phi R\),剛好被信度衰減掉,而只有把 \(\sigma^2_\varepsilon\) 當成一個獨立參數帶著走的模型,才還原得出 \(\phi\) 本身。
kalman_n1 上的卡爾曼弧線把這項分離示範了出來。以最大化濾波器概似的方式配適「AR 加誤差」模型,還原出的延續效果是 \(0.61\),對照生成用的 \(0.60\);平滑器接著在每一個時點產生對潛在狀態最好的回溯 (retrospective) 估計。圖 26.5 在有雜訊的觀察值底下畫出濾波與平滑的潛在路徑,連同它們的不確定帶。濾波估計值只用過去,因而可以即時 (real time) 取得;平滑估計值用了整條序列,因而更緊、也更貼近真實的潛在狀態,是回溯的最佳猜測。在兩者之間的選擇是一項估計標的 (estimand) 的選擇,表 26.3 把它列了出來:濾波是給「資料一邊進來一邊監看」用的,也就是第 33 章在及時介入 (just-in-time intervention) 上會發展的臨床用途;平滑則是給一份已完成的研究所要的歷史重建用的。
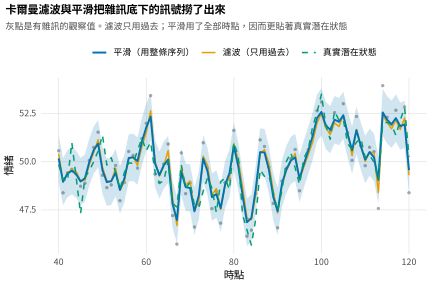
註:kalman_n1 上潛在狀態的濾波(只用過去)與平滑(整條序列)估計值,以及平滑的不確定帶,對照有雜訊的觀察值與真實的潛在路徑。兩者都把施測雜訊底下的訊號撈了出來;平滑更緊,也更貼著真值走。
表 26.3 濾波與平滑的對照。
| 濾波 | 平滑 | |
|---|---|---|
| 用到什麼 | 只用到 \(t\) 為止的觀察值 | 序列中全部的觀察值 |
| 估計標的 | 給定過去,此刻的狀態 | 給定全部訊息,\(t\) 時的狀態 |
| 不確定性 | 較寬 | 較緊 |
| 何時可得 | 即時,資料一邊進來一邊算 | 回溯,研究結束之後 |
| 使用場景 | 監看、預報、及時調適性介入(第 33 章) | 歷史重建、分析 |
註:這兩個估計值回答的是不同的問題。濾波在時間上是因果的,適合即時監看;平滑以整條序列為條件,是對一份已完成研究作事後分析的正確選擇。
遺漏資料的修補正是第 24 章承諾過的回報。把 kalman_n1 的一段遮起來再跑濾波器,缺口中的狀態估計值不是一條直線,而是一條往歷程平均數回復的曲線,它的不確定帶隨著資料的缺席而變寬,並在觀察值恢復時再度收攏。圖 26.6 把這件事拿來與線性內插對照,後者在缺口上畫出一條自信的直線,因而宣稱了一份它並不擁有的確定性。後果是量得出來的:卡爾曼平滑器在缺口中重建的潛在軌跡對照真實潛在狀態的均方根誤差 (root-mean-square error) 是 \(1.43\),內插則差得多,來到 \(2.04\);而在有缺口的序列上以卡爾曼法估出來的延續效果是 \(0.57\),仍貼近完整資料的值,反觀先內插再天真估計則會灌大被觀察到的自我相關。濾波器把一個遺漏的時點當成它本來的樣子,也就是訊息的缺席,而不是一個要去發明出來的數值。下面的程式面板把整條弧線收在一起。
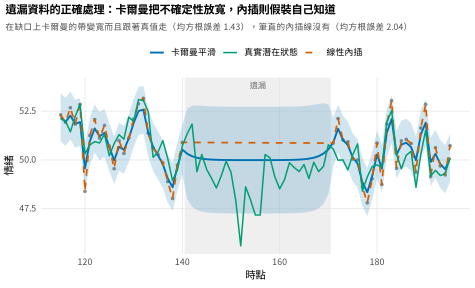
註:在 kalman_n1 一段被遮起來的區間上,卡爾曼平滑器的不確定帶變寬、估計值往平均數回復,並跟著真實潛在狀態走(均方根誤差 \(1.43\));線性內插畫出一條自信的直線,卻沒有跟上(均方根誤差 \(2.04\))。濾波器把遺漏表達成訊息的缺席,而不是一個被發明出來的數值。
# kalman_n1 上的卡爾曼弧線:把測量誤差與歷程雜訊分開
d <- readRDS("Examples/data/kalman_n1.rds")            # y(觀察值)、eta_true(潛在)
yc <- d$y - mean(d$y)
# 在 (phi, 歷程變異數 q, 測量變異數 r) 上最大化濾波器概似
negll <- function(par) {                               # kalman_filter() 手寫於 ch26_analysis
  phi <- tanh(par[1]); q <- exp(par[2]); r <- exp(par[3])
  -kalman_filter(matrix(yc), matrix(phi), matrix(1), matrix(q), matrix(r),
                 a1 = 0, P1 = matrix(q/(1-phi^2)))$loglik
}
fit <- optim(c(atanh(.3), 0, 0), negll, method = "BFGS")
tanh(fit$par[1])                                       # phi 約 0.61(天真的延宕一期自我相關 = 0.46)
# 平滑後的潛在狀態 + 跨越被遮起來的缺口時變寬的不確定性:
kf <- kalman_filter(matrix(d$y_gap - mean(d$y_gap, na.rm=TRUE)), ...)  # NA 的時點會被跳過
ks <- kalman_smoother(kf, matrix(tanh(fit$par[1])))
26.3 動態因素模型
動態因素模型就是「以一個潛在因素當狀態」的狀態空間形式,而它正是第 24 章留下缺陷的那個 P 技術的修補。P 技術把一個人的題目跨時點作因素分析 (factor analysis),卻把那些時點當成彼此獨立的,於是丟掉了序列依賴,而序列依賴正是一條時間序列的重點。動態因素模型保留了因素結構,也就是少數幾個負荷到觀察題目上的潛在因素,再加上動態,讓那些因素依一個向量自我迴歸演化,於是這個潛在歷程既透過負荷量矩陣被測量,也透過轉移矩陣把自己往前帶。結果就是一個帶著逐人動態的逐人測量模型,也就是個殊 (idiographic) 測量的落實。存在兩種標準形式,而這個區分值得說清楚,圖 26.7 把它畫了出來。在歷程因素形式裡,也就是 Molenaar 的傳統,潛在因素遵循那個自我迴歸,而測量是同時 (contemporaneous) 且乾淨的,於是動態完全住在因素裡。在直接自我迴歸形式裡,自我迴歸被寫在因素分數 (factor score) 上,配上延宕的負荷量,於是記憶被分散到測量之中。這兩種形式在某些條件下可以做到等價,而表 26.4 說明何時偏好哪一種、以及各自的識別要求。
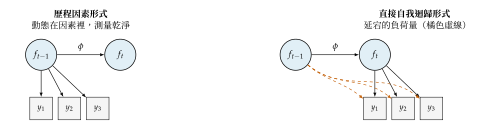
註:歷程因素形式(左):潛在因素遵循自我迴歸,而負荷量乾淨地測量當下的因素,於是全部的動態都住在因素裡。直接自我迴歸形式(右):記憶由「從較早的因素分數延宕負荷到當下指標」承載。兩種形式在某些條件下重合;歷程因素形式在心理學中比較常見。
表 26.4 動態因素模型的各種變體。
| 形式 | 結構 | 識別與用途 |
|---|---|---|
| 歷程因素(白雜訊) | 因素遵循 VAR;同時的乾淨負荷量 | 以一個錨定 (anchor) 負荷量或單位因素變異數設定尺度;當動態是因素的性質時優先 |
| 直接自我迴歸分數 | 自我迴歸寫在分數上;延宕的負荷量 | 延宕結構必須加以限制;當記憶由測量承載時有用 |
| 多因素 | 數個因素加上一個因素 VAR | 需要每個因素有足夠的指標、也需要足夠的時點;交叉延宕要小心才識別得出來 |
註:識別要求設定因素的尺度(把一個錨定負荷量固定為一,或把因素變異數固定住)以及一個站得住腳的延宕結構。時點數少的時候,一個豐富的多因素模型是識別不出來的;請簡化,或跨人彙整。
這個模型還原得出一個已知的結構,是在 dfm_sim 上示範的,那是一條帶著已知負荷量矩陣與已知因素轉移的雙因素序列,這裡以一個手寫的期望最大化 (expectation-maximization, EM) 演算法配適,它的期望步驟就是卡爾曼平滑器,而它的最大化步驟以封閉解更新負荷量、轉移與各變異數。圖 26.8 呈現這份還原:負荷量回到接近它們的生成值,因素轉移還原出自我迴歸的對角線與由第二個因素進入第一個因素的那條交叉延宕,而平滑後的因素分數與真實因素的相關是 \(0.94\) 與 \(0.91\)。這個估計式從有雜訊的多變量指標中重建出一個潛在的動態結構,而那正是「在真相未知的資料上使用它」所需要的驗證。
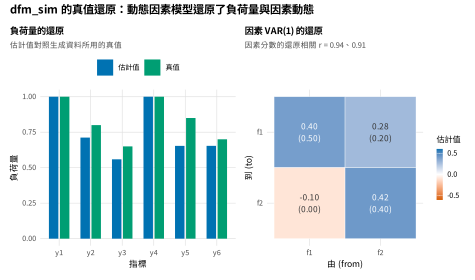
dfm_sim 上的真值還原。註:以卡爾曼 EM 配適到 dfm_sim 的雙因素動態因素模型,其估計出來的負荷量對照生成值(左),以及因素轉移矩陣(右,估計值與括號內的真值)。負荷量與因素 VAR 都被還原了出來,而平滑後的因素分數與真實因素的相關是 \(0.94\) 與 \(0.91\)。
個殊的承諾在真實題目上兌現。把一個單因素的動態因素模型配適到兩位 affect_ema 受試者的四個負向情緒題目上,讓因素自由地遵循它自己的自我迴歸,得到的是兩幅真正不同的圖像,如圖 26.9 所示。對第一個人而言,負向情緒這個因素既有一貫性也有持續性 (persistence):四個題目都與它有實質的關聯,其中「覺得緊張」最強,而這個因素帶著 \(0.41\) 的中等慣性 (inertia),於是他的負向情緒會賴著不走。對第二個人而言,這個因素幾乎沒有延續效果,慣性只有 \(0.06\),而且指標的剖面也不一樣:「覺得緊繃」是它最強的表徵,「覺得緊張」卻幾乎與它無關。同樣的四個題目在不同人身上組裝成不同的個人結構、帶著不同的動態,那正是第 24 章的非遍歷性 (nonergodicity) 在測量這一層被具體化,也正是「一個統一的個體間因素分析,硬把同一套負荷量型態與零動態加在每個人身上」所表達不出來的東西。多人的策略沿著兩條路走:複製式單一受試者取向為每個人各自配適,再摘述他們結構與動態的分配;而目前最先進的多層次動態因素模型則把他們彙整起來,那就是第 25 章 DSEM 的測量那一層,同一個想法從因素分析這一側抵達。
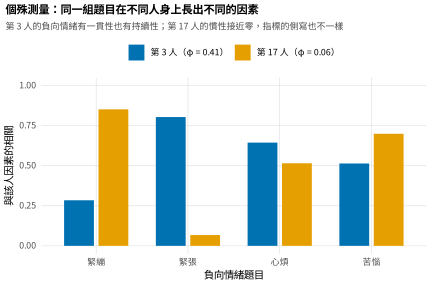
註:兩位 affect_ema 受試者四個負向情緒題目的單因素動態因素模型,呈現每個題目與這個人的因素之間的相關。第 3 人的因素有一貫性也有持續性(慣性 \(0.41\));第 17 人的慣性接近零(\(0.06\)),指標的剖面也不同。逐人的測量與逐人的動態,正是一個統一的個體間模型捕捉不到的東西。
26.4 診斷與選擇
一個配適好的狀態空間模型,跟任何時間序列模型一樣,是靠「它是不是把白雜訊 (white noise) 留在身後」來評判的,而受檢視的對象是標準化的一步前創新,也就是濾波器的殘差除以它自己預測出來的標準差。如果模型設定正確,這些標準化創新就是獨立的標準常態,於是有三項檢查適用。它們的自我相關應該可以忽略,這由眼睛與一個 Ljung-Box 檢定共同確認,因為殘留的序列結構意味著動態被設定錯了。它們的分配應該是常態的,這由一張分位數圖 (quantile plot) 與一個常態性檢定來查,因為厚尾 (heavy tail) 是離群值或非高斯歷程的訊號。而個別的大值標示出離群值,那在一條心理學序列中往往不是要被修剪掉的麻煩,而是要被理解而不是丟棄的實質事件,一個壓力源、一次危機、一次體制 (regime) 的轉換,是通往第 32 章的指路標。圖 26.10 呈現 kalman_n1 上「AR 加誤差」配適的診斷子圖組:標準化創新在它們的帶附近散布,它們的自我相關可以忽略,Ljung-Box 的 \(p\) 為 \(0.93\),而它們的分位數圖是直的,常態性的 \(p\) 為 \(0.23\),於是這個模型把序列漂白了,予以保留。
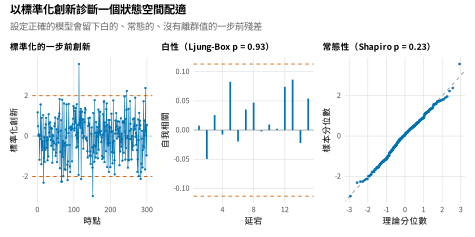
註:kalman_n1 上「AR 加誤差」配適的標準化一步前創新:它們的序列與 \(\pm 2\) 的帶(左)、它們的自我相關與 Ljung-Box 結果(中),以及它們的常態分位數圖(右)。白的、常態的、沒有離群值的殘差,表示模型是適當的。
在各種設定之間作選擇,遵循的是本書一路主張的精簡原則 (parsimony) 教條,並被心理學序列長度的現實磨得更銳利。巢套 (nested) 的模型,例如「AR 加誤差」對上一個單純的 AR,或一個單因素對上一個雙因素的動態模型,以預測誤差概似作概似比 (likelihood-ratio) 檢定來比較;非巢套的則用一個訊息準則 (information criterion)。至於「把狀態弄豐富」的誘惑,也就是加上第二個因素、更高的延宕階數、一個隨時間變動的參數,在心理學所蒐集到的序列長度上必須被抵抗,因為一個參數多過資料所能識別的狀態空間模型會收斂到一個邊界、報出一個被釘在零的變異數成分 (variance component),或者配適了這個樣本卻複製不出來,那正是第 13 章為變異數成分提出的 Heywood 案例與過度參數化 (over-parameterization) 的同一組危害。陷阱方塊把這些模型誤導人的具體方式收在一起。
常見陷阱 • 狀態空間分析誤導人的四種方式
第一,為了簡便把測量誤差固定為零,那等於違反了本章自己最核心的那個主張:一個觀察分數的動態模型會把施測雜訊算到歷程頭上,並使每一個自我迴歸衰減,所以只要測量是可能出錯的,測量誤差就該被建模,而不是被假設掉。第二,在心理學的序列長度上把狀態設定得過頭,加上一條一百個時點的序列識別不出來的因素、延宕階數或隨時間變動的參數,於是產生邊界估計值與複製不出來的配適。第三,把濾波或平滑出來的狀態當成觀察到的資料來解讀,忘了它們是帶著不確定性的後驗 (posterior) 估計值,於是一張沒有畫出不確定帶的平滑狀態圖會誇大「我們知道多少」,而一個把它們當資料的後續分析則會低估它自己的不確定性。第四,把一個平滑狀態估計值報告成這個人的真分數 (true score),然而它是一個依賴模型的後驗,換一種動態或測量的設定它就會移動。
26.5 軟體,以及這套做法何時划算
狀態空間形式由數個各有所長的 R 套件支援,圖 26.11 與表 26.5 把這片地景攤了出來。KFAS 套件對線性高斯模型與它們的指數族 (exponential family) 擴充既快又精確,是本章濾波與平滑的主力。MARSS 套件專攻多變量自我迴歸狀態空間模型,介面對生態學與心理學的時間序列都很好上手。dynr 套件,它「調配模型」的慣例會在第 32 章再度出現,加上了體制轉換 (regime switching) 與非線性 (nonlinear) 動態,為接下來的變化點 (change point) 與振盪子 (oscillator) 模型作了準備。而 OpenMx 在一個結構方程的環境裡以定義變項 (definition variable) 界定狀態空間模型,是熟悉 SEM 的讀者最自然的家。Mplus 則透過它的動態結構方程模型成為鄰近的生產工具,而它獨到的加法是跨人的多層次彙整;值得記住的區分是:DSEM 加的是多層次那一層,狀態空間套件加的是結構上的自由度,也就是「設定一個固定的 DSEM 模板不會開放給你的自訂轉移與測量結構」的能力。本章的分析一個套件也沒有用,全部由手寫的濾波器、平滑器與 EM 演算法建成,好讓每一個物件都能對照一個已知的真相被稽核;有生產需求的讀者應該去拿那些套件,而想弄懂那些套件在做什麼的讀者,會在隨附的腳本裡找到機制。
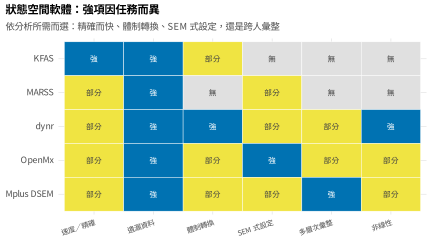
註:主要幾個狀態空間工具的能力矩陣。強項各不相同:KFAS 精確而快,dynr 擅長體制轉換與非線性,OpenMx 擅長 SEM 式的界定,而 Mplus DSEM 擅長多層次彙整。選擇跟著分析所需要的東西走。
表 26.5 狀態空間軟體的功能比較。
| 工具 | 強項 | 要留意 | 何時最適用 |
|---|---|---|---|
| KFAS | 線性高斯下又快又精確 | 只能線性/高斯 | 在一個固定模型上作濾波、平滑與 ML |
| MARSS | MARSS 介面好上手 | 模型較大時偏慢 | 多變量 AR 狀態空間、教學 |
| dynr | 體制轉換、非線性 | 設定門檻較高 | 變化點(第 32 章)、非線性動態 |
| OpenMx | SEM 原生、有定義變項 | 設定寫法冗長 | 熟悉 SEM 的讀者;自訂結構 |
| Mplus DSEM | 多層次彙整 | 模板固定 | 人數多、動態為隨機(第 25 章) |
註:狀態空間套件加的是結構上的自由度;Mplus DSEM 加的是多層次彙整。選擇時看的是這份分析最需要的是精確、體制轉換、SEM 式界定,還是跨人彙整。
狀態空間這套做法什麼時候賺得回它的額外成本,是那個實務問題,而答案很具體。當測量誤差必須與歷程雜訊分開時它划算,因為沒有任何觀察分數模型做得到這件事;當資料有遺漏、而遺漏必須被精確處理而不是被插補時它划算;當目標是一個潛在的多變量歷程、一個沒有任何單指標模型構得到的動態因素結構時它划算;當結構是自訂的、需要一個套裝模型沒有提供的轉移或測量矩陣時它也划算。它不划算的時候,是第 25 章的多層次 VAR 用更少的組裝就回答得了這個問題、而測量誤差可以忽略的時候,那時比較簡單的工具才是誠實的選擇。下一章的連續時間 (continuous-time) 模型就是同一套狀態空間架構,只是轉移改由一個微分方程 (differential equation) 而非一個離散的步伐支配,那是這個形式容納第 25 章標出的不等間隔的方式;而第 32 章的體制轉換模型讓轉移矩陣本身會改變,那是這個形式容納本章離群值所暗示的變化點的方式。
實務要點 • 狀態空間配適的數值衛生與執行時間
起始要小心:當起始狀態真的未知時,用一個瀰散 (diffuse) 先驗,也就是一個大的初始變異數,讓資料自己說話,而不是用一個緊的猜測去偏誤早期的估計值。配適之前先把變項縮放到可比的範圍,因為當變異數相差幾個數量級時,最佳化器與矩陣求逆都會表現得很糟。把變異數參數化在對數尺度上,把自我迴歸經由一個有界的轉換來參數化,好讓最佳化器不可能晃進負變異數或發散 (explosive) 的動態裡。要預期期望最大化演算法可靠但要跑到最後幾位數很慢,而直接最大概似比較快、卻對起始值比較敏感,所以請從數個起點各跑一次,並確認概似彼此一致。最後,要以檢視標準化創新來確認收斂 (convergence),不要只憑最佳化器回報的成功,因為一個在設定錯誤的模型上收斂的最佳化器,配的仍然是一個設定錯誤的模型。
寫出一份狀態空間或動態因素分析,是把前幾章的報告紀律延伸到這個形式特有的決定上。報告應該說明配適的是哪一個狀態空間模型、狀態裡裝了什麼、轉移與測量矩陣是怎麼設定的,尤其要說明測量誤差是被建模了還是被固定為零,因為單單這一項選擇就決定了動態會不會被衰減。它應該給出估出來的動態、它們的心理學讀法與它們的不確定性,報告遺漏資料是怎麼處理的,並呈現收斂與殘差的診斷,也就是那些認證這份配適的標準化創新檢查。對一個動態因素模型而言,它應該說明識別,也就是錨定或尺度的限制與延宕結構;而對一份個殊分析而言,它應該明說結構與動態是逐人的,並不假設可以推論到別人身上。一段示範的段落是這樣的:「本研究以卡爾曼 EM 對四個負向情緒題目配適了一個單因素的動態因素模型,因素為潛在的 AR(1),測量誤差變異數自由估計;因素的慣性在第 3 人為 \(0.41\)、在第 17 人為 \(0.06\),兩人的負荷量剖面也不同,顯示測量與動態都是逐人的;標準化創新是白的、近似常態的。」
本章摘要
線性高斯狀態空間形式是這一部分的母模型:一條狀態方程式讓一個潛在歷程透過轉移矩陣演化並受歷程雜訊擾動,一條觀察方程式透過負荷量矩陣去測量這個狀態並被測量誤差汙染。把矩陣填起來,就得到自我迴歸、趨勢模型、向量自我迴歸、潛在成長曲線與動態因素模型,全都是它的特例,一個形式容納了它們全部。卡爾曼濾波器是它的引擎,一個「先預測、再更新」的遞迴,它的增益是收縮意義下的信度權重;而從單單一趟前向掃描裡,掉出了由預測誤差分解得到的概似、由跳過更新得到的遺漏時點精確處理,以及診斷用的標準化創新。這個形式在心理計量上最核心的貢獻是把測量誤差與歷程雜訊分開:一個被帶誤差觀察到的自我迴歸是一個 ARMA(1,1),它天真的估計值剛好被信度衰減掉,而只有把測量變異數另外帶著走的模型才還原得出真實的延續效果,這件事在 kalman_n1 上確實做到了,儘管一條短序列把這項拆分估得相當不精確。第 24 章承諾的遺漏資料修補也兌現了,濾波器在缺口上把不確定性放寬,並比那條假裝有自信的內插線更準確地重建了潛在軌跡。動態因素模型透過「給一個逐人的因素結構配上它自己的動態」修補了 P 技術,在 dfm_sim 上還原了一個已知的負荷量矩陣與因素轉移,並在真實題目上揭露了兩個人由同一組測量長出不同的因素、帶著不同的慣性,也就是個殊測量的落實。一份配適以它創新是否已漂白、是否常態來評判,並以心理學序列長度所要求的精簡來選擇;而這套做法值得它額外成本的時機,恰恰是測量誤差、遺漏資料、潛在的多變量動態或自訂結構使第 25 章那些較簡單的工具不敷使用的時候。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 狀態空間形式 | state-space form | 一條狀態方程式加一條觀察方程式;容納本部分所有模型;第 26.1 節 |
| 狀態方程式 | state equation | 潛在狀態依轉移矩陣演化並受歷程雜訊擾動;第 26.1 節 |
| 觀察方程式 | observation equation | 潛在狀態經負荷量矩陣被帶誤差測量;第 26.1 節 |
| 歷程雜訊 | process noise | 這個人狀態真正的變化衝擊,\(\mathbf{Q}\);第 26.1 節 |
| 測量誤差 | measurement error | 施測本身的雜訊,\(\mathbf{H}\)(承第 20 章);第 26.1 節 |
| 局部線性趨勢 | local linear trend | 水準加斜率的二維狀態;結構時間序列模型;第 26.1 節 |
| 卡爾曼濾波器 | Kalman filter | 預測與更新的前向遞迴;狀態空間的推論引擎;第 26.2 節 |
| 卡爾曼增益 | Kalman gain | 決定往觀察值移動多少的信度權重(承第 13 章);第 26.2 節 |
| 創新 | innovation | 觀察值與一步前預測之差(承第 21 章);第 26.2 節 |
| 預測誤差分解 | prediction-error decomposition | 由創新拼出整條序列的對數概似;第 26.2 節 |
| 平滑器 | smoother | 以整條序列回溯估計潛在狀態;第 26.2 節 |
| 動態因素模型 | dynamic factor model | 帶著自身序列動態的逐人因素結構;第 26.3 節 |
| 歷程因素形式 | process-factor form | 動態全部住在因素裡,測量乾淨;第 26.3 節 |
參考文獻
Browne, M. W., & Nesselroade, J. R. (2005). Representing psychological processes with dynamic factor models: Some promising uses and extensions of ARMA time series models. In A. Maydeu-Olivares & J. J. McArdle (Eds.), Contemporary psychometrics: A festschrift for Roderick P. McDonald (pp. 415–452). Lawrence Erlbaum Associates.
Chow, S.-M., Ferrer, E., & Nesselroade, J. R. (2007). An unscented Kalman filter approach to the estimation of nonlinear dynamical systems models. Multivariate Behavioral Research, 42(2), 283–321. https://doi.org/10.1080/00273170701360423
Chow, S.-M., Ho, M.-H. R., Hamaker, E. L., & Dolan, C. V. (2010). Equivalence and differences between structural equation modeling and state-space modeling techniques. Structural Equation Modeling: A Multidisciplinary Journal, 17(2), 303–332. https://doi.org/10.1080/10705511003661553
Durbin, J., & Koopman, S. J. (2012). Time series analysis by state space methods (2nd ed.). Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199641178.001.0001
Harvey, A. C. (1989). Forecasting, structural time series models and the Kalman filter. Cambridge University Press. https://doi.org/10.1017/CBO9781107049994
Helske, J. (2017). KFAS: Exponential family state space models in R. Journal of Statistical Software, 78(10), 1–39. https://doi.org/10.18637/jss.v078.i10
Holmes, E. E., Ward, E. J., & Wills, K. (2012). MARSS: Multivariate autoregressive state-space models for analyzing time-series data. The R Journal, 4(1), 11–19. https://doi.org/10.32614/RJ-2012-002
Hunter, M. D. (2018). State space modeling in an open source, modular, structural equation modeling environment. Structural Equation Modeling: A Multidisciplinary Journal, 25(2), 307–324. https://doi.org/10.1080/10705511.2017.1369354
Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82(1), 35–45. https://doi.org/10.1115/1.3662552
Molenaar, P. C. M. (1985). A dynamic factor model for the analysis of multivariate time series. Psychometrika, 50(2), 181–202. https://doi.org/10.1007/BF02294246
Molenaar, P. C. M., De Gooijer, J. G., & Schmitz, B. (1992). Dynamic factor analysis of nonstationary multivariate time series. Psychometrika, 57(3), 333–349. https://doi.org/10.1007/BF02295422
Nesselroade, J. R., McArdle, J. J., Aggen, S. H., & Meyers, J. M. (2002). Dynamic factor analysis models for representing process in multivariate time-series. In D. S. Moskowitz & S. L. Hershberger (Eds.), Modeling intraindividual variability with repeated measures data: Methods and applications (pp. 235–265). Lawrence Erlbaum Associates.
Ou, L., Hunter, M. D., & Chow, S.-M. (2019). What’s for dynr: A package for linear and nonlinear dynamic modeling in R. The R Journal, 11(1), 91–111. https://doi.org/10.32614/RJ-2019-012
Ram, N., Brose, A., & Molenaar, P. C. M. (2013). Dynamic factor analysis: Modeling person-specific process. In T. D. Little (Ed.), The Oxford handbook of quantitative methods: Vol. 2. Statistical analysis (pp. 441–457). Oxford University Press. https://doi.org/10.1093/oxfordhb/9780199934898.013.0021
Schuurman, N. K., & Hamaker, E. L. (2019). Measurement error and person-specific reliability in multilevel autoregressive modeling. Psychological Methods, 24(1), 70–91. https://doi.org/10.1037/met0000188
Shumway, R. H., & Stoffer, D. S. (2017). Time series analysis and its applications: With R examples (4th ed.). Springer. https://doi.org/10.1007/978-3-319-52452-8
Song, H., & Ferrer, E. (2009). State-space modeling of dynamic psychological processes via the Kalman smoother algorithm: Rationale, finite sample properties, and applications. Structural Equation Modeling: A Multidisciplinary Journal, 16(2), 338–363. https://doi.org/10.1080/10705510902751432
Zhang, Z., Hamaker, E. L., & Nesselroade, J. R. (2008). Comparisons of four methods for estimating a dynamic factor model. Structural Equation Modeling: A Multidisciplinary Journal, 15(3), 377–402. https://doi.org/10.1080/10705510802154281