第 28 章
密集縱貫資料的網絡取向
前面幾章把心理變項之間的共變當成一件要被解釋的事,而解釋通常來自一個「這些變項所測量的」潛在共同原因 (latent common cause)。網絡 (network) 取向把這幅圖像整個翻過來。它把那些變項,症狀、情緒、行為,當成一個彼此直接影響的成分 (component) 系統,於是一個症候群 (syndrome) 就不是某個底層實體的倒影,而是互動所湧現 (emergent) 出來的型態,一個能夠安頓在穩定狀態 (stable state) 上、也能夠被推到另一個狀態去的回饋 (feedback) 結構。這個重新框架讓臨床與人格心理學動了起來,因為它許諾了介入的標的、把共病 (comorbidity) 說成兩個群集之間的橋接 (bridge),也讓逐人的病因學變得自然;還因為它的核心物件,那個估出來的網絡,是一張生動而且好分享的圖像。而那些圖也正是危險所在。一個估出來的網絡裡的一條連結 (edge) 是一項條件關聯 (conditional association),不是一條因果路徑;一個中心的節點 (node) 是一項拓樸 (topology) 摘要,不是一根被證實的槓桿;而一個由中等樣本估出來的網絡,可能以「一張說服力十足的佈局 (layout) 所遮蔽」的方式複製不出來。本章把這套做法的全部力量與全部紀律一起教。它建起高斯圖形模型 (Gaussian graphical model) 與它的正則化 (regularization) 估計,把密集縱貫的網絡三聯圖精確地對映到第 25 章的那三個矩陣上,好讓同一組物件穿上兩套詞彙;接著,在本書於此處最具特色的那項展示裡,把一個估出來的網絡對照一個已知的真相稽核 (audit) 一遍,指出還原是部分的而不是完美的。它把複製性 (replicability) 與中心性 (centrality) 這兩場爭論當成內容來教,給逐人 (person-specific) 結構配上它自己的方法,最後以一道主張階梯 (claims ladder) 收尾,把一項網絡結果所能使用的語言,固定在支撐它的證據上。
學習目標
讀完本章之後,你應該能夠:(1) 陳述精神病理學的網絡理論與「潛在變項與網絡的等價 (equivalence)」問題,並說出有哪些證據與它相關;(2) 估計一個正則化的偏相關 (partial correlation) 網絡,並精確說出一條連結是什麼,是一項條件關聯,以及不是什麼,不是一條因果路徑;(3) 估計密集縱貫的三聯圖,也就是時間網絡、同時性網絡與個體間網絡,並把每一個對映到第 25 章的矩陣上;(4) 以拔靴法 (bootstrap) 的連結權重區間與中心性穩定度 (centrality stability) 係數評估網絡的準確度與穩定度,並誠實報告不穩定的結果;(5) 帶著當前的批判文獻解讀中心性,知道強度 (strength) 是最站得住腳的指標,而一個中心的症狀是一項假設、不是一個治療標的;(6) 執行一次逐人的結構搜尋,並區分群體路徑與個人路徑;(7) 以排列檢定 (permutation test) 比較不同組的網絡,並把網絡結果寫在證據所支持的那一階上。
28.1 網絡這個想法
精神疾患 (mental disorder) 的網絡理論主張,一個症候群 (syndrome) 是一個彼此互相增強的成分系統,而不是某個潛在疾病實體 (latent disease entity) 的表面 (Borsboom, 2017; Borsboom & Cramer, 2013)。在潛在變項 (latent variable) 的說法裡,失眠、疲倦與低落心情之所以相關,是因為每一項都由底層的憂鬱造成;在網絡的說法裡,它們之所以相關,是因為失眠 (insomnia) 造成疲倦、疲倦惡化心情、低落心情又擾亂睡眠,一個能夠鎖進自我維持 (self-sustaining) 狀態的回饋迴路 (feedback loop)。這個重新框架對研究是有生產力的:它把共病重新說成連結兩個群集 (cluster) 的橋接症狀 (bridge symptom) (Cramer et al., 2010),它暗示連結最多的症狀可能是最有效的介入點 (intervention point),也讓逐人的病因學變得自然,因為不同的人,症狀可能以不同的方式接在一起。它同時往前接上第 32 章動力系統 (dynamical system) 的想法,在那裡一個疾患是另一個穩定狀態,而通往它的過程會顯示出早期預警訊號 (early-warning signal)。圖 28.1 畫出這兩個生成故事。
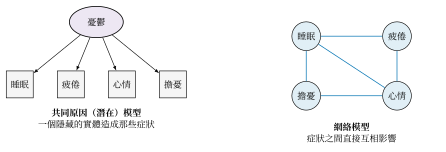
註:共同原因模型(左)以一個造成每個症狀的潛在實體解釋症狀之間的相關;網絡模型(右)以症狀之間的直接互動解釋它們。在橫斷資料上,兩者在統計上幾乎等價,所以這個選擇有一部分是詮釋性的;密集縱貫資料會約束動態,但並沒有把問題完全定案。
誠實要求在一開始就正面迎上等價問題。在橫斷資料上,一個網絡模型與一個潛在變項模型可以在統計上幾乎等價,把同一個共變數矩陣 (covariance matrix) 配適得一樣好,於是單靠資料無法在「一個隱藏的共同原因」與「一張直接互動的網」之間作出裁決 (Marsman et al., 2018; van der Maas et al., 2006)。這不是對網絡的致命反駁,但它是網絡主張的一道邊界:一個配適良好的網絡是共變結構的一種表徵 (representation),不是一個被示範出來的機制 (mechanism)。密集縱貫資料有幫助,因為一個動態網絡在時間上的先後順序,會以單一個快照 (snapshot) 做不到的方式限制哪些故事仍然可行;但它們並沒有把事情定案,因為第 25 與第 27 章的間隔與混淆 (confounding) 告誡對時間連結逐字適用。本書的立場是:網絡是一個強而有力的表徵與假設生成 (hypothesis-generating) 框架,而它的推論主張必須被掙來,而本章其餘的部分講的就是怎麼掙。
28.2 估計網絡
主力模型是高斯圖形模型,而它的定義性動作是「偏掉 (partialling)」。一個相關網絡在每一對會共變的變項之間都畫一條連結,而因為心理學裡幾乎每樣東西都彼此共變,這樣的網絡是一張密實 (dense) 而不帶訊息的網。高斯圖形模型改為只在「以其他全部變項為條件之後兩個變項仍然有關聯」時才畫一條連結,也就是一個偏相關,於是一個完全經由第三個變項傳導的關聯會消失,只留下直接的、條件的關聯。圖 28.2 在 symptom_net 資料上呈現這個對比:相關網絡幾乎把每樣東西都接在一起,而偏相關網絡留下的是一副由直接連結構成的稀疏骨架 (backbone)。那些偏相關是從共變數矩陣的反矩陣,也就是精確度矩陣 (precision matrix) 上讀出來的,它非對角線上的零恰恰就是不存在的那些連結,這一點由基礎概念方塊記下。這個網絡裡的一條連結是一項條件關聯,僅此而已,不是一條因果路徑,陷阱方塊會再回到這一點。
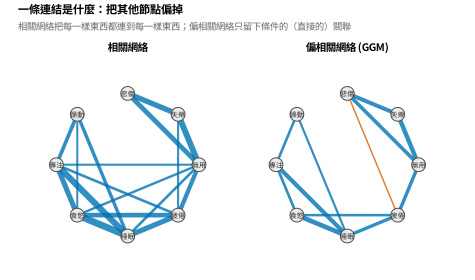
註:左:symptom_net 上的相關網絡,因為間接關聯也被畫成連結而顯得密實。右:偏相關網絡(高斯圖形模型),因為只有條件的、直接的關聯存活下來而顯得稀疏。藍色連結為正、紅色為負;粗細編碼偏相關的大小。
因為一個樣本 (sample) 偏相關永遠不會恰好等於零,估計就需要一個「決定哪些小連結是真的」的原則,而標準答案是正則化。圖形 lasso (graphical lasso),以及這裡用的逐節點迴歸 (nodewise regression) 取向,把小的偏相關收縮 (shrink) 到恰好為零,產生一個稀疏 (sparse) 的網絡;而收縮的程度由一個調校懲罰 (tuning penalty) 決定,該懲罰以最佳化一個擴充貝氏訊息準則 (extended Bayesian information criterion) 選出 (Epskamp & Fried, 2018)。圖 28.3 呈現正則化路徑,連結數隨懲罰上升而下降,而那個準則選出的懲罰在這裡還原到接近真實的連結數。正則化不是免費的:它在偽陽性 (false positive) 與偽陰性 (false negative) 之間權衡,而一個被正則化掉的零是「沒有支持這條連結的證據」,不是「有證據說它不存在」,所以這個方法晚近的文獻一直在辯論什麼時候採用「不正則化、改以明確模型選擇」的做法比較好 (Isvoranu & Epskamp, 2023; Williams et al., 2019)。表 28.2 攤開那些估計選擇,而軟體註記提醒這個領域在 2020 年之後有相當變動,應在實際分析時確認。
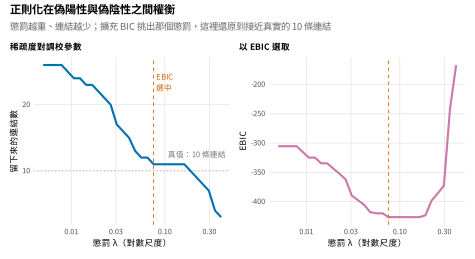
註:留下來的連結數(左)隨懲罰變大而下降;擴充貝氏訊息準則(右)選出一個懲罰,這裡還原到接近真實的十條連結。一個被正則化掉的零,意思是這條連結沒有被選上,不是我們已知它不存在。
密集縱貫的情形產生的不是一個網絡而是三個,而把它們連同各自的矩陣出處分清楚,正是本章的規則。在 affect_ema 上估計一個多層次向量自我迴歸 (multilevel VAR),也就是第 25 章一模一樣的模型,得到圖 28.4 的三聯圖:一個時間網絡,它的有向 (directed) 連結是延宕的交叉效果 (cross-effect),也就是轉移矩陣的非對角線;一個同時性網絡,它的無向 (undirected) 連結是個體內創新 (innovation) 的偏相關;以及一個個體間網絡,它的連結是個人平均數的偏相關。這些正是第 25 章以矩陣估出來的同一批物件,現在換上網絡的衣服,而表 28.1 就是把兩套詞彙對映 (mapping) 起來的羅塞塔石碑。「每一張網絡圖都必須說出它的矩陣出處」這條規則不是迂腐;一位讀者若看到一個無向網絡卻沒被告知它是同時性的還是個體間的,就無從知道它許可的是一項個體內的主張還是一項個體間的主張。
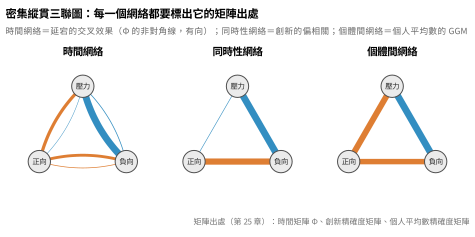
註:來自 affect_ema 上的一個多層次向量自我迴歸:時間網絡(有向的延宕交叉效果,也就是轉移矩陣的非對角線)、同時性網絡(創新的偏相關),以及個體間網絡(個人平均數的偏相關)。這些就是第 25 章那三個矩陣的網絡形貌;每一張網絡圖都必須說出它的矩陣出處。
表 28.1 網絡物件與它們在第 25 章的矩陣(羅塞塔對照)。
| 網絡(本章) | 矩陣(第 25 章) | 連結的意義 |
|---|---|---|
| 時間網絡 | 轉移矩陣 \(\boldsymbol{\Phi}\) 的非對角線 | 有向的延宕交叉效果(已偏掉其他) |
| 同時性網絡 | 創新的精確度矩陣 | 同一時點的條件關聯 |
| 個體間網絡 | 個人平均數的精確度矩陣 | 個體間的條件關聯 |
| 橫斷的 GGM | 資料本身的精確度矩陣 | 單一時點上的條件關聯 |
註:同一組物件,兩套詞彙。網絡是一個精確度矩陣或轉移矩陣的呈現方式;它的連結逐字繼承生成它的那個矩陣的意義與告誡,包括時間連結的間隔依賴(第 27 章)。
基礎概念 • 偏相關、精確度矩陣與 EBIC
對共變數為 \(\boldsymbol{\Sigma}\) 的多變量常態資料,精確度矩陣是 \(\mathbf{K} = \boldsymbol{\Sigma}^{-1}\),而變項 \(i\) 與 \(j\) 在控制其餘全部之後的偏相關是 \(\rho_{ij\cdot} = -k_{ij}/\sqrt{k_{ii}k_{jj}}\)。高斯圖形模型恰好就是 \(\mathbf{K}\) 非對角線上非零元素的型態:那裡是零,意思是給定其餘變項之後 \(i\) 與 \(j\) 條件獨立 (conditionally independent),也就是沒有連結。以圖形 lasso 估計,是最大化被 \(\lambda \sum_{i\neq j}|k_{ij}|\) 懲罰過的高斯對數概似 (log-likelihood),這會把小的元素收縮到恰好為零;逐節點迴歸則是以 lasso 把每個變項對其餘變項作迴歸、並在兩個方向都存活時保留一條連結,達成同樣的稀疏。懲罰 \(\lambda\) 以最小化擴充貝氏訊息準則選出,\(\mathrm{EBIC} = -2\ell + E\log n + 4\gamma E \log p\),其中 \(\ell\) 是對數概似、\(E\) 是連結數、\(p\) 是節點數,而 \(\gamma\) 是一個超參數 (hyperparameter)(常取 \(0.5\)),它對密度額外加罰,使這個準則在心理學所處的「節點多、\(n\) 中等」情境下偏保守。
這套估計由本章最具特色的那項展示來背書:真值稽核。因為 symptom_net 是由一個已知的稀疏網絡生成的,估計值就可以對照真相計分 (score),而圖 28.5 正是這麼做。估出來的網絡把全部十條真實連結都還原了,敏感度 (sensitivity) 為 \(1.00\),特異度 (specificity) 為 \(0.94\),另有幾條偽陽性 (false-positive) 的連結,而估出來的連結權重與真實權重的相關是 \(0.95\)。這個訊息是精確的,而且既不是凱旋也不是失敗:在一個現實的樣本數下,正則化估計式把真實結構還原得好但不完美,抓到了每一條真實連結、同時也納進了少數幾條假的,所以一個發表出來的網絡應該被讀成「一個結構的良好但不完美的估計值」,不是那個結構本身。這份誠實是那份生動的代價,而下面的程式面板把整套估計與稽核都寫了出來。
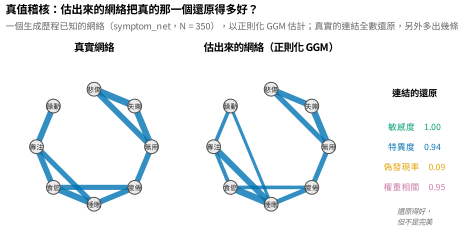
註:一個由已知稀疏結構生成的網絡(symptom_net,\(N=350\)),以正則化的高斯圖形模型估計。十條真實連結全數還原(敏感度 \(1.00\)),特異度為 \(0.94\),權重相關為 \(0.95\)。還原得好,但不完美,這是任何一個估出來的網絡該有的誠實讀法。
# 估計一個正則化的 GGM,並對照已知真相稽核它
sn <- readRDS("Examples/data/symptom_net.rds"); tr <- attr(sn, "truth")
X  <- as.matrix(sn[sn$group == 1, tr$nodes])
pcor <- function(X){ P <- -cov2cor(solve(cov(X))); diag(P) <- 0; P }   # 偏相關
reg  <- regularized_ggm(X)          # 逐節點 lasso(glmnet)+ EBIC 選取(ch28_analysis)
# 稽核:我們把哪些真實連結還原出來了?
ut <- upper.tri(tr$pcor)
sensitivity <- sum((reg$W != 0)[ut] &  (tr$pcor != 0)[ut]) / sum((tr$pcor != 0)[ut])  # 1.00
specificity <- sum((reg$W == 0)[ut] &  (tr$pcor == 0)[ut]) / sum((tr$pcor == 0)[ut])  # 0.94
cor(reg$W[ut], tr$pcor[ut])          # 0.95:估出來的連結權重對照真值
表 28.2 網絡估計的各項選擇。
| 選擇 | 選項 | 使用指引 |
|---|---|---|
| 連結的定義 | 相關對偏相關 | 用偏相關(GGM);相關會把間接的連接也接進來 |
| 稀疏性 | 正則化(glasso/EBIC)對不正則化加模型搜尋 | 正則化是預設;不正則化的替代方案仍在辯論(請確認當前建議) |
| 密集縱貫的結構 | 逐節點(mlVAR)對聯合(graphicalVAR、DSEM) | 逐節點快;聯合尊重完整的概似 |
| 隨機效果 | 正交對相關 | 相關比較貼近現實但代價較高;第 25 章的告誡適用 |
| 節點集合 | 全部題目對已修剪多餘者 | 先修剪掉幾乎重複的節點(第 28.4 節) |
註:估計方面的文獻在 2020 年之後變動相當大,特別是「正則化對不正則化」的辯論,請在實際分析時確認。無論作了哪一種選擇,都要報告出來;賭注高的時候,還要以模擬對照稽核。
28.3 穩定度、準確度與複製性
一個只估過一次的網絡是一個點估計值 (point estimate),而它的連結與中心性摘要都帶著單一張佈局 (layout) 藏起來的不確定性。準確度與穩定度工具組就是要讓那份不確定性看得見 (Epskamp et al., 2018a)。圖 28.6 呈現它的兩項輸出。一個無母數 (nonparametric) 拔靴法,重抽 (resample) 人再重估一次,為每一個連結權重產生一個信賴區間 (confidence interval),而區間跨過零的連結就不能可靠地與「不存在」區分開來。一個逐次丟個案 (case-dropping) 的拔靴法,在越來越小的子樣本上重估,追蹤中心性的排序被保留得多好,並以一個中心性穩定度係數摘要,也就是「在大多數子樣本中,強度排序與全樣本排序的相關仍高於 \(0.7\) 的前提下,最多可以丟掉多少比例的個案」;這裡那個係數是 \(0.45\),中等,意思是那個排序並不牢靠。門檻的慣例列在表 28.3。
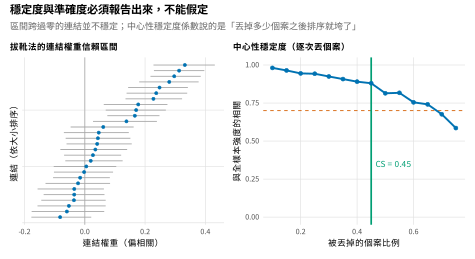
註:左:拔靴法的連結權重信賴區間;區間跨過零的連結並不穩定。右:逐次丟個案的中心性穩定度曲線,係數標示出「丟掉多少個案之後強度排序就開始瓦解」(這裡是 \(0.45\))。這些診斷是必要的,不是可選的。
心理學網絡的複製性成了一場公開的爭論,而本章把它當成內容來教。批評方的主張是,同一個母體 (population) 的不同樣本估出來的症狀網絡可能差別很大,因而使人懷疑它們的可靠性 (Forbes et al., 2017);回應方則主張那些比較用的指標本身有瑕疵,而網絡複製得比那份批評所暗示的更好 (Borsboom et al., 2017)。這個領域達成的解決是:不同的面向複製的程度不同,強連結 (strong edge) 的存在複製得好、確切的連結權重差一些,而中心性的排序,尤其是「最中心的那一個節點是誰」,最差。圖 28.7 在同一個樣本隨機切成的兩半上示範了這一點:連結權重的相關是 \(0.60\)、強度排序的相關是 \(0.78\),都還可以,然而最中心的那一個節點在兩半之間卻是不同的症狀。實務上的教訓是報告「複製得出來的東西」,也就是強連結與粗結構,並抵抗「拿最中心的節點來說故事」的誘惑,因為那個節點恰恰是整份估計中最不穩定的特徵。陷阱方塊把網絡分析過度推銷的各種方式收在一起。
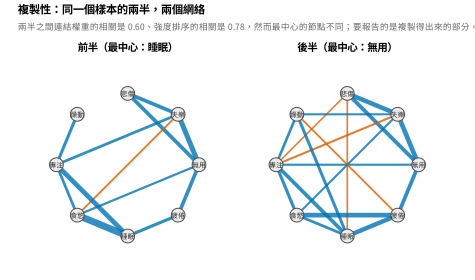
註:在 symptom_net 隨機切成的兩半上估出來的網絡。連結權重的相關是 \(0.60\)、強度排序的相關是 \(0.78\),然而最中心的那一個節點在兩半之間不同。強連結與粗結構複製得出來;最中心的那個節點往往複製不出來。
表 28.3 穩定度指標與它們的門檻。
| 指標 | 它評估什麼 | 經驗法則 |
|---|---|---|
| 拔靴法的連結信賴區間 | 連結權重的不確定性 | 區間跨過零:這條連結不可靠 |
| 連結權重差異檢定 | 兩條連結是否不同 | 大幅重疊:不要把連結排名次 |
| 中心性穩定度 (CS) | 中心性排序被保留的程度 | 偏好 \(>0.5\),最低 \(>0.25\) |
| 中心性差異檢定 | 兩個節點的中心性是否不同 | 通常檢定力不足;解讀要謹慎 |
註:CS 係數是「在 \(95\%\) 的子樣本中,排序與全樣本排序的相關仍高於 \(0.7\)」的前提下,最多可丟掉的個案比例。低於 \(0.25\) 意味著中心性根本不該被解讀。
常見陷阱 • 網絡分析過度推銷的四種方式
第一,把一條連結讀成一項因果效果:一條連結是一項條件關聯,而把它變成一支因果箭號需要一些假設,沒有未測量的混淆變項、因果方向正確,而那些假設估計式並不提供、設計通常也支撐不起。第二,靠肉眼比對兩張佈局來比較兩個網絡,然而佈局演算法是以力導向 (force-directed) 的捷思 (heuristic) 擺放節點的,資料上極小的改變就可能讓它大幅移動,於是兩個權重幾乎相同的網絡可以看起來不一樣、兩個權重不同的網絡可以看起來一樣;要比的是權重矩陣,不是圖。第三,由中心性推出臨床主張,斷言最中心的症狀就是治療標的,然而那項推論需要因果的連結、可介入性 (intervenability),以及沒有混淆,而那個中心節點往往正是整份估計中最不穩定的特徵。第四,把一個被正則化掉的零讀成「不存在的證據」,然而它只是「證據不足以克服懲罰」,所以一條缺席的連結並不是一項被示範出來的條件獨立。
28.4 中心性及其不滿
中心性指標依節點在網絡中的位置為它們排名,而它們在心理學裡的使用已經跑到它們的正當性之前。最站得住腳的指標是強度 (strength),也就是一個節點連結權重絕對值的總和,那是一項透明的摘要,說的是一個節點被連得多強。從社會網絡分析 (social-network analysis) 引進來、以流動 (flow) 為基礎的指標,中介中心性 (betweenness) 與接近中心性 (closeness),假設有某種東西沿著網絡中的最短路徑 (shortest path) 行進,而那個假設對一個偏相關網絡沒有清楚的意義,批判文獻也已指出它在心理學應用上並不可靠 (Bringmann et al., 2019)。即使是強度,若沒有進一步的假設,也不是任何因果意義下的重要性 (Dablander & Hinne, 2019);而且它容易受到一項特定的假象影響,圖 28.8 就示範了那項假象:當兩個節點幾乎重複,也就是兩個測到幾乎同一件事的多餘題目時,每一個都會把另一個的中心性膨脹起來,因為它們共有的變異被算成了連接。加進一個症狀的近似複本,把那個症狀的強度由 \(0.93\) 提高到 \(1.45\),並讓兩個雙胞胎都看起來很中心,那是多餘性 (redundancy) 造成的拓樸假象 (artifact),不是一項實質發現。補救的方法是在估計之前先修剪 (prune) 掉多餘的節點,而實作方塊給出檢查步驟。表 28.4 把這些指標各自框回它們站得住腳的用途。
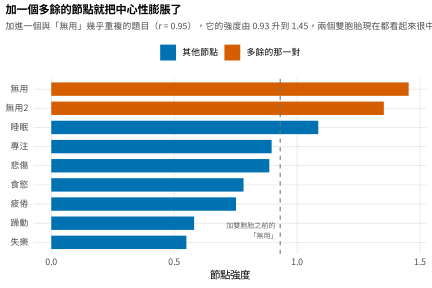
註:把「無用」這個症狀的一個近似複本(與它的相關為 \(0.95\))加進 symptom_net。它的強度由 \(0.93\) 跳到 \(1.45\),兩個雙胞胎現在都顯得很中心。多餘的節點會製造中心性;解讀之前先把它們修掉。
表 28.4 中心性指標:定義、假設與地位。
| 指標 | 定義 | 在心理學網絡中的地位 |
|---|---|---|
| 強度 | 連結權重絕對值的總和 | 最站得住腳的一個;仍然不是因果上的重要性;會被多餘性膨脹 |
| 期望影響力 | 帶正負號的連結權重總和 | 當連結正負號混雜時,優於強度 |
| 中介中心性 | 通過一個節點的最短路徑 | 「沿最短路徑流動」這個假設站不住;不穩定 |
| 接近中心性 | 到其他節點總距離的倒數 | 同樣的流動假設;很少站得住腳 |
| 橋接強度 | 跨越社群 (community) 的連接 | 對共病問題有用,但帶著同樣的告誡 |
註:請報告強度或期望影響力,先修剪掉多餘的節點,並以懷疑的態度對待中介中心性與接近中心性。沒有任何一個中心性指標能在缺少「網絡本身提供不了的因果論證」的情況下確立一個治療標的。
那項臨床上的期望,也就是「一個中心的症狀是最好的介入點」,值得把它的論證完整陳述一遍,因為它是一個好假設、卻是一個壞結論。要從中心性走到一個治療標的,需要那些連結是因果的而不只是關聯的、需要那個中心節點是人真的能夠介入的,也需要沒有任何混淆變項同時膨脹它的中心性與它表面上的影響力。這三件事都不從估出來的網絡推得出來,所以一個中心症狀誠實的地位,是一項「該用帶介入資訊的設計去檢驗」的可檢驗假設,不是一項該據以行動的結論。這樣框起來,中心性就是一具正當的假設引擎,那是一項真實的貢獻,前提是那些假設被標明為假設。
28.5 逐人的結構:GIMME
到目前為止的網絡描述的是一個樣本,但第 25 章記錄過的異質性 (heterogeneity) 意味著不同的人可能擁有性質上不同的結構,而不只是不同的參數值;而當結構本身就是問題時,就需要另一種方法。群體疊代多模型估計 (group iterative multiple model estimation, GIMME) 在偵測「跨樣本共有的路徑」的同時,找出逐人的有向網絡 (Beltz & Gates, 2017; Gates & Molenaar, 2012)。它的邏輯是一次搜尋 (search):它以「加進最能改善配適的延宕與同時有向連結」的方式蓋起每個人的網絡,並在一條連結出現在絕大多數個體身上時把它指定為群體層次的,於是輸出把一副共有的骨架與各人的裝飾分了開來,中間還可以有一層次群體 (subgroup)。圖 28.9 在一份植入了已知結構的模擬資料上呈現這個想法:一條所有人共有的群體路徑,這裡是壓力驅動負向情緒的類比 (analogue),在幾乎每個人身上重現,並被正確地標為群體層次;而只植入在一個次群體裡的路徑,就只出現在那些個體身上,並被正確地留在逐人的層次。它與第 25 章多層次模型與動態結構方程模型的分別正在這裡:那些模型估計的是一個共同結構加上變動的參數,而 GIMME 是逐人搜尋結構本身,所以當研究對象是性質上的結構異質性、而不是參數異質性時,它才是那個工具。表 28.5 畫出選擇指引,而實作方塊指出 GIMME 以搜尋為基礎的性格與它對複製的需求。
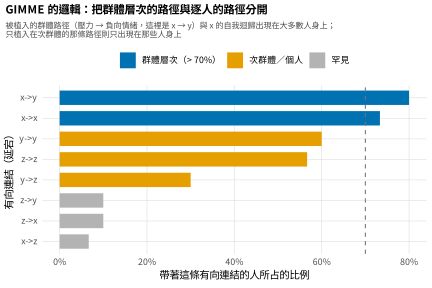
註:在模擬資料中,帶著每一條有向延宕連結的人所占的比例。被植入的群體路徑與 x 的自我迴歸在大多數人身上重現,並被標為群體層次(在虛線門檻之上);只植入在一個次群體裡的路徑,就只出現在那些個體身上。GIMME 搜尋的是結構,不只是它的參數。
表 28.5 在各種逐人動態方法之間作選擇。
| 方法 | 什麼東西因人而異 | 何時使用 |
|---|---|---|
| 多層次 VAR(第 25 章) | 參數,結構共有 | 結構是共同的;你要的是平均動態與它們的散布 |
| DSEM(第 25 章) | 參數,並帶潛在中心化 | 同上,再加上測量與潛在分解 |
| GIMME | 結構本身(哪些連結存在) | 性質上的異質性;不同的人有不同的地圖 |
註:當人們共有一個結構、只在程度上不同時,多層次模型與動態結構方程模型才是對的;當人們連「哪些連接存在」都不同時,GIMME 的結構搜尋才是那個工具。它給出的個人路徑是需要複製的搜尋結果,不是已確立的因果地圖。
實務要點 • 節點的挑選,以及 GIMME 以搜尋為基礎的性格
估計任何網絡之前,先為多餘性修剪節點集合:兩個幾乎互相改寫的題目會製造出一條假的強連結、並互相膨脹中心性,所以請先檢查題目之間的相關與內容重疊,把幾乎重複的併掉或刪掉。要注意遺漏資料,因為整列刪除 (listwise deletion) 可能扭曲一個由偏相關估出來的網絡,而第 6 章那種密集縱貫的遺漏需要有原則的處理。至於 GIMME 的輸出,請以它的方法所要求的謙遜來對待:因為它是以資料驅動的方式在可能的連結上搜尋來蓋出結構,它在個人層次上的路徑是「在資料中被發現的假設」,與任何逐步 (stepwise) 搜尋一樣容易過度配適 (overfit),所以在被讀成一個人的因果架構之前,需要在新資料上複製;而群體層次的路徑因為建立在「跨人的多數」之上,是輸出中比較可信的那一部分。
28.6 比較網絡與主張階梯
研究問題常常問兩個網絡是否不同,治療前後、不同診斷組之間,而誠實的檢定是一個排列檢定,不是用肉眼比對佈局。網絡比較檢定把組別標籤重新排列,為一個選定的差異統計量 (difference statistic) 建立虛無分配 (null distribution),那個統計量可以是整體連通度 (global connectivity) 的差、某一條特定連結的差,或整體結構的差,再把觀察到的差異拿去對照 (van Borkulo et al., 2023)。圖 28.10 把它用在 symptom_net 的兩組上,那兩組被生成為恰好只在一條連結上不同:這個檢定正確地找不到整體連通度的差異,排列 \(p\) 為 \(0.33\),同時偵測到被植入的那條連結差異,\(p=0.005\),這正是對的型態,一項整體統計量會錯過的局部差異。這個檢定在現實的樣本數下檢定力有限,所以一個虛無 (null) 結果是「等價的薄弱證據」而不是等價的證明;而網絡隨時間的比較則往前接上第 32 章的時變 (time-varying) 網絡。
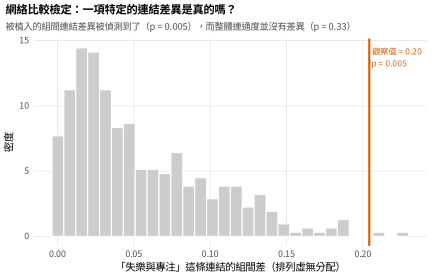
註:在 symptom_net 的兩組上作的排列檢定,那兩組被生成為只在一條連結上不同。被植入的連結差異被偵測到了(\(p=0.005\),紅線對照排列虛無分配),而整體連通度並沒有差異(\(p=0.33\))。排列檢定能定位出整體摘要會錯過的差異,而在心理學的樣本數下檢定力有限。
本章以「把網絡主張的語言固定在證據上」收尾,因為這片文獻反覆出現的失敗,正是把一個條件關聯結構描述得彷彿它是一個被發現的因果機制。圖 28.11 畫出一道有四階的主張階梯。最低的一階是描述:這個網絡呈現的是這個樣本中條件關聯的型態,那是估計值直接支持 (support) 的主張。第二階是條件關聯結構:這些變項在控制其餘之後仍然直接關聯,那項主張加進了偏掉的邏輯,並且需要那些穩定度檢查。第三階是預測性動態:在時間網絡中,一個變項較早的狀態預報另一個變項較晚的狀態,那項主張需要縱貫資料,並繼承第 27 章的間隔告誡。最高的一階是因果系統:這些變項以那些連結所描繪的方式互相因果影響,那項主張需要網絡本身提供不了的假設或介入,而多數網絡研究並沒有掙到它。表 28.6 把每一階配上一份報告檢核表與一段語言範本,好讓一節結果可以寫在它的證據所及的那一階上、而不再更高。這道階梯與第 21 與第 25 章的估計標的 (estimand) 階梯是對齊的,而它就是本章最後的紀律:這套做法很有力,而那些主張必須被掙來。
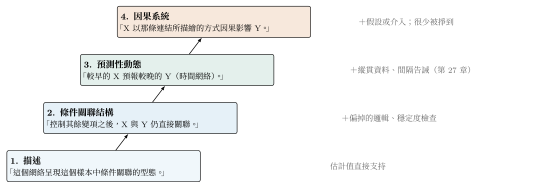
註:每一階都是一項比前一階更強、也需要更多東西的主張。估計值直接支持描述;條件關聯結構加上偏掉的邏輯與穩定度;預測性動態加上縱貫資料與第 27 章的間隔告誡;而一項因果系統的主張需要網絡本身提供不了的假設或介入。請寫在證據所及的那一階上。
寫出一份網絡分析,意味著報告估計、報告穩定度,並把主張寫在它們掙到的那一階上。報告應該說明節點集合與任何多餘性的修剪、估計方法與它的調校,以及這個網絡是橫斷的、還是密集縱貫三聯圖中的哪一格連同它的矩陣出處。它應該呈現準確度與穩定度的診斷,也就是連結權重區間與中心性穩定度係數,並據此節制中心性的主張,報告強度而不是那些流動指標,並把一個中心節點當成一項假設。若是組間比較,它應該給出排列檢定與它的檢定力告誡。而全篇都應該把語言留在階梯上:一條連結是一項條件關聯,一條時間連結是一項帶著間隔告誡的預測,而一項因果主張只有在有那個當得起它的設計時才作。一段示範的段落是這樣的:「在修剪掉兩個幾乎多餘的題目之後,本研究估計了一個正則化的偏相關網絡(擴充 BIC,\(\gamma=0.5\));最強的幾條連結(無用感與悲傷、以及與失樂之間)在拔靴區間下是穩定的,而強度的中心性穩定度係數為 \(0.45\),因此中心性只作描述性的報告,最中心的那個節點不被解讀為治療標的。」
軟體提示 • 網絡的軟體生態
標準的工具鏈是一套 R 生態:qgraph 負責估計與呈現,bootnet 負責準確度與穩定度的工作流程,mlVAR 與 graphicalVAR 負責密集縱貫的三聯圖,psychonetrics 提供一個統一的驗證性框架,gimme 負責逐人的結構搜尋,NetworkComparisonTest 負責組間比較,而 mgm 負責混合型與時變的網絡。這套生態仍在積極維護,而它的建議,尤其是關於「正則化對不正則化」的估計建議,在 2020 年之後有所變動,所以當前的指引應該在實際分析時確認,而不是從一本教科書上抄下來。本章的分析並沒有用到這些套件,因為它們在目前的環境中裝不起來;改以基礎 R 與 glmnet 作逐節點的正則化估計、一套手寫的偏相關與中心性工具,以及手寫的拔靴、排列與結構搜尋常式,好讓每一個量,真值稽核的還原、穩定度係數、多餘性造成的膨脹,都能對照一個已知的真相被檢查;在應用工作上,那些套件才是正確的選擇。
表 28.6 網絡的報告檢核表與主張階梯的語言範本。
| 項目 | 要報告什麼/語言範本 |
|---|---|
| 節點集合 | 題目、多餘性的修剪,以及理由 |
| 估計 | 方法、正則化與調校,以及矩陣出處(若為密集縱貫) |
| 準確度與穩定度 | 連結權重區間;中心性穩定度係數 |
| 中心性 | 強度或期望影響力;當成描述,不當成標的 |
| 比較 | 排列檢定,並附檢定力告誡 |
| 第一階(描述) | 「這個網絡呈現這個樣本中條件關聯的型態。」 |
| 第二階(結構) | 「控制其餘變項之後,X 與 Y 仍直接關聯。」 |
| 第三階(動態) | 「較早的 X 預測較晚的 Y」(時間網絡;附間隔告誡)。 |
| 第四階(因果) | 只有在具備當得起它的假設或介入時才作。 |
註:把結果一節寫在證據所及的那一階上。多數網絡研究有資格站在第一到第三階;因果的第四階需要一個網絡本身提供不了的設計。
本章摘要
網絡取向把心理變項表徵成一個直接互動的成分系統,而不是某個潛在共同原因的倒影,這個重新框架對臨床與人格科學有生產力,但它的核心物件,那個估出來的網絡,很容易引來過度的主張。在橫斷資料上,網絡與潛在變項兩種說法幾乎等價,所以一個網絡是共變結構的表徵,不是一個被示範出來的機制。高斯圖形模型只在「兩個變項在以其餘為條件之後仍有關聯」時才畫一條連結,也就是從精確度矩陣讀出來的偏相關,而正則化在一個訊息準則之下把小連結收縮到零,在偽陽性與偽陰性之間權衡。密集縱貫三聯圖,時間網絡、同時性網絡與個體間網絡,恰好就是第 25 章那三個矩陣穿上網絡的衣服,而每一張網絡圖都必須說出它的矩陣出處。真值稽核,也就是本章最具特色的展示,在生成歷程已知的資料上指出:一個正則化估計式把真實結構還原得好但不完美,抓到了每一條真實連結、也納進了少數幾條假的,所以一個發表出來的網絡是一個好的估計值,不是真相。準確度與穩定度必須報告:拔靴法的連結區間顯示哪些連結可靠,而中心性穩定度係數顯示那個中心性排序有多牢,而在現實資料上它只是中等。複製性因面向而異,強連結與粗結構複製得出來、最中心的那一個節點往往複製不出來,所以中心性只作描述性報告,用強度而不用那些可疑的流動指標,並先修剪多餘節點以免製造出中心性,而一個中心的症狀是一項假設而不是一個治療標的。當性質上的異質性才是問題時,GIMME 搜尋逐人的結構,把共有的路徑與各人的路徑分開;而網絡比較檢定能定位出一項整體摘要會錯過的組間差異。本章最後的紀律是那道主張階梯,它把一項網絡結果的語言,描述、條件關聯結構、預測性動態、因果系統,固定在支撐它的證據上,好讓這套做法以全力被使用,而那些主張是被掙來的。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 網絡 | network | 節點與連結構成的系統;本章的核心物件(承第 9 章);第 28.1 節 |
| 連結 | edge | 兩個節點之間的條件關聯;不是因果路徑(承第 9 章);第 28.2 節 |
| 高斯圖形模型 | Gaussian graphical model (GGM) | 只在偏相關不為零時畫連結的網絡模型;第 28.2 節 |
| 精確度矩陣 | precision matrix | 共變數矩陣的反矩陣;非對角線的零就是缺席的連結(承第 9 章);第 28.2 節 |
| 正則化 | regularization | 把小連結收縮到零以得到稀疏網絡(承第 13 章);第 28.2 節 |
| 擴充貝氏訊息準則 | extended Bayesian information criterion (EBIC) | 選取懲罰的準則;對密度額外加罰;第 28.2 節 |
| 三聯圖 | triptych | 時間、同時性與個體間三個網絡;即第 25 章的三個矩陣;第 28.2 節 |
| 真值稽核 | truth audit | 把估出來的網絡對照已知生成結構計分;第 28.2 節 |
| 中心性穩定度係數 | centrality-stability coefficient | 排序仍與全樣本相關高於 \(0.7\) 時可丟掉的個案比例;第 28.3 節 |
| 強度 | strength | 連結權重絕對值的總和;最站得住腳的中心性指標;第 28.4 節 |
| 橋接強度 | bridge strength | 跨越社群的連接;共病問題會用到;第 28.4 節 |
| GIMME | group iterative multiple model estimation | 逐人的有向結構搜尋,並標出群體層次的路徑;第 28.5 節 |
| 主張階梯 | claims ladder | 把網絡結果的語言固定在證據上的四階;第 28.6 節 |
參考文獻
Beltz, A. M., & Gates, K. M. (2017). Network mapping with GIMME. Multivariate Behavioral Research, 52(6), 789–804. https://doi.org/10.1080/00273171.2017.1373014
Borsboom, D. (2017). A network theory of mental disorders. World Psychiatry, 16(1), 5–13. https://doi.org/10.1002/wps.20375
Borsboom, D., & Cramer, A. O. J. (2013). Network analysis: An integrative approach to the structure of psychopathology. Annual Review of Clinical Psychology, 9, 91–121. https://doi.org/10.1146/annurev-clinpsy-050212-185608
Borsboom, D., Fried, E. I., Epskamp, S., Waldorp, L. J., van Borkulo, C. D., van der Maas, H. L. J., & Cramer, A. O. J. (2017). False alarm? A comprehensive reanalysis of “Evidence that psychopathology symptom networks have limited replicability” by Forbes, Wright, Markon, and Krueger (2017). Journal of Abnormal Psychology, 126(7), 989–999. https://doi.org/10.1037/abn0000306
Bringmann, L. F., Elmer, T., Epskamp, S., Krause, R. W., Schoch, D., Wichers, M., Wigman, J. T. W., & Snippe, E. (2019). What do centrality measures measure in psychological networks?. Journal of Abnormal Psychology, 128(8), 892–903. https://doi.org/10.1037/abn0000446
Bringmann, L. F., & Eronen, M. I. (2018). Don’t blame the model: Reconsidering the network approach to psychopathology. Psychological Review, 125(4), 606–615. https://doi.org/10.1037/rev0000108
Cramer, A. O. J., Waldorp, L. J., van der Maas, H. L. J., & Borsboom, D. (2010). Comorbidity: A network perspective. Behavioral and Brain Sciences, 33(2–3), 137–150. https://doi.org/10.1017/S0140525X09991567
Dablander, F., & Hinne, M. (2019). Node centrality measures are a poor substitute for causal inference. Scientific Reports, 9, Article 6846. https://doi.org/10.1038/s41598-019-43033-9
Epskamp, S. (2020). Psychometric network models from time-series and panel data. Psychometrika, 85(1), 206–231. https://doi.org/10.1007/s11336-020-09697-3
Epskamp, S., Borsboom, D., & Fried, E. I. (2018a). Estimating psychological networks and their accuracy: A tutorial paper. Behavior Research Methods, 50(1), 195–212. https://doi.org/10.3758/s13428-017-0862-1
Epskamp, S., & Fried, E. I. (2018). A tutorial on regularized partial correlation networks. Psychological Methods, 23(4), 617–634. https://doi.org/10.1037/met0000167
Epskamp, S., Waldorp, L. J., Mõttus, R., & Borsboom, D. (2018b). The Gaussian graphical model in cross-sectional and time-series data. Multivariate Behavioral Research, 53(4), 453–480. https://doi.org/10.1080/00273171.2018.1454823
Forbes, M. K., Wright, A. G. C., Markon, K. E., & Krueger, R. F. (2017). Evidence that psychopathology symptom networks have limited replicability. Journal of Abnormal Psychology, 126(7), 969–988. https://doi.org/10.1037/abn0000276
Fried, E. I., & Cramer, A. O. J. (2017). Moving forward: Challenges and directions for psychopathological network theory and methodology. Perspectives on Psychological Science, 12(6), 999–1020. https://doi.org/10.1177/1745691617705892
Gates, K. M., & Molenaar, P. C. M. (2012). Group search algorithm recovers effective connectivity maps for individuals in homogeneous and heterogeneous samples. NeuroImage, 63(1), 310–319. https://doi.org/10.1016/j.neuroimage.2012.06.026
Haslbeck, J. M. B., & Waldorp, L. J. (2020). mgm: Estimating time-varying mixed graphical models in high-dimensional data. Journal of Statistical Software, 93(8), 1–46. https://doi.org/10.18637/jss.v093.i08
Isvoranu, A.-M., & Epskamp, S. (2023). Which estimation method to choose in network psychometrics? Deriving guidelines for applied researchers. Psychological Methods, 28(4), 925–946. https://doi.org/10.1037/met0000439
Marsman, M., Borsboom, D., Kruis, J., Epskamp, S., van Bork, R., Waldorp, L. J., van der Maas, H. L. J., & Maris, G. (2018). An introduction to network psychometrics: Relating Ising network models to item response theory models. Multivariate Behavioral Research, 53(1), 15–35. https://doi.org/10.1080/00273171.2017.1379379
Robinaugh, D. J., Hoekstra, R. H. A., Toner, E. R., & Borsboom, D. (2020). The network approach to psychopathology: A review of the literature 2008–2018 and an agenda for future research. Psychological Medicine, 50(3), 353–366. https://doi.org/10.1017/S0033291719003404
van Borkulo, C. D., van Bork, R., Boschloo, L., Kossakowski, J. J., Tio, P., Schoevers, R. A., Borsboom, D., & Waldorp, L. J. (2023). Comparing network structures on three aspects: A permutation test. Psychological Methods, 28(6), 1273–1285. https://doi.org/10.1037/met0000476
van der Maas, H. L. J., Dolan, C. V., Grasman, R. P. P. P., Wicherts, J. M., Huizenga, H. M., & Raijmakers, M. E. J. (2006). A dynamical model of general intelligence: The positive manifold of intelligence by mutualism. Psychological Review, 113(4), 842–861. https://doi.org/10.1037/0033-295X.113.4.842
Williams, D. R., Rhemtulla, M., Wysocki, A. C., & Rast, P. (2019). On nonregularized estimation of psychological networks. Multivariate Behavioral Research, 54(5), 719–750. https://doi.org/10.1080/00273171.2019.1575716