第 29 章
存活分析與事件史分析
到目前為止的各章,建模的都是一個連續屬性如何隨時間起落。然而推動縱貫研究的許多問題根本不是關於一個水準 (level),而是關於一個時刻:一位病人何時復發、一名學生何時第一次被當、一對伴侶何時分手、一位員工何時離職、一個戒菸成功的人何時點起第一根菸。這些是時機 (timing) 問題,而它們之所以能擊潰前面各章的做法,是因為一個頑固的理由。在研究結束時,有些人已經發生事件、有些人還沒有;而對還沒有發生的那些人,真正的事件時間 (event time) 不是一般意義下的遺漏,而是「已知它落在觀察窗 (observation window) 之外」。這就是設限 (censoring);一個把設限個案丟掉的平均數,或一個假裝「最後一次觀察就是事件」的平均數,不只是不精確而已,它是有偏誤 (biased) 的,有時偏得很嚴重。存活分析 (survival analysis),也叫事件史分析 (event-history analysis),就是為了「把設限個案以它們完整的訊息價值留在分析裡,既不丟掉也不捏造」而建起來的一族方法。本章走的是心理學家進入這一族的那條路。它由離散時間 (discrete time) 存活開始,那裡資料變成個人期間檔 (person-period file),而模型就是第 15 章那個換上新解讀的羅吉斯迴歸 (logistic regression),因為多數心理學事件是以週、學期或波次記錄的,不是記到瞬間。接著它發展連續時間 (continuous time) 的那一套做法,Kaplan-Meier 估計式與 Cox 比例危險 (proportional-hazards) 模型,並帶著它們的優雅所要求的紀律;它也把審稿人最常抓到的那些錯誤,不朽時間 (immortal time)、從錯誤的曲線上讀競爭風險 (competing risks)、把危險比 (hazard ratio) 誤讀成風險比 (risk ratio),當成要精熟的內容而不是註腳。最後它把存活次模型與第 13、14 章的成長次模型接起來,好讓依賴結果的退出 (outcome-dependent dropout),也就是第 6 章承諾過的非隨機遺漏 (missing not at random) 機制,被建模而不是被假設掉。
學習目標
讀完本章之後,你應該能夠:(1) 在離散與連續時間中定義存活函數 (survivor function)、危險 (hazard) 與累積危險 (cumulative hazard),並在它們之間轉換;(2) 解釋右設限、左設限與區間設限,並把無訊息設限 (noninformative censoring) 說成這個領域裡「隨機遺漏 (missing at random)」的沉默親戚;(3) 建構個人期間資料集並以羅吉斯迴歸配適離散時間危險模型,選定一種基線危險 (baseline hazard) 設定,並把共變項 (covariate) 效果讀成危險勝算比 (hazard-odds ratio);(4) 估計並以對數等級檢定 (log-rank test) 比較 Kaplan-Meier 曲線,並配適一個帶著站得住腳之危險比解讀的 Cox 模型;(5) 以 Schoenfeld 殘差 (residual) 偵測比例危險的違反,並以一個時變 (time-varying) 係數解決它;(6) 透過計數歷程 (counting-process) 資料納入時變共變項,並辨認出不朽時間偏誤;(7) 延伸到共享脆弱性 (shared frailty)、重複事件 (recurrent events) 與競爭風險,並依所問的問題選擇病因特定 (cause-specific) 或次分配 (subdistribution) 危險;(8) 為依賴結果的退出配適一個共享參數 (shared-parameter) 的縱貫存活聯合模型 (joint model);(9) 把一份存活分析報告到可發表的標準。
29.1 時機問題與存活的詞彙
第 1 章點名的第五族問題,也就是關於事件的發生與時機的問題,一路等到現在才輪到它的方法,因為那些方法與本書其他方法都不一樣。推論的對象是一段期間 (duration),也就是由一個定義清楚的起點 (time origin) 到一個定義清楚的事件所經過的時間,而分析上的困難在於:資料蒐集結束時,這段期間對一部分參與者是確切已知的,對其餘的人卻只有一個界限。看看本章的貫穿範例 relapse 資料,那是一份模擬 (simulation) 研究,四百位因憂鬱發作 (depressive episode) 而接受治療的病人,每週追蹤 (follow-up) 最多二十四週,觀察症狀是否以及何時回到復發 (relapse) 的門檻 (threshold)。這份資料由一個已知的生成歷程 (data-generating process) 模擬而來,好讓每一個估計值都能對照真相稽核,這是本書一貫的做法。到第二十四週,一百八十一位病人復發、一百四十八位因復發以外的理由離開照護、七十一位仍在緩解 (remission) 中且仍被觀察。只有第一群人有一個被觀察到的復發時間。對第二與第三群人,我們知道的只是:復發,如果它終究會發生,在觀察停止的那一刻還沒有發生。
誘惑是伸手去拿一個熟悉的摘要,而每一個熟悉的摘要都以一種有教育意義的方式失敗。把那一百八十一位復發者的復發時間平均起來,得到大約九週,但這只描述了那些快速復發的人,並且默默丟掉了超過一半的樣本,而那些人「復發時間很長」正是治療的成功之處。把每位設限病人最後一次被觀察到的那一週當成復發週填進去,得到大約十二週,那是一個任意的數字,研究短它就縮、研究長它就長,追蹤的是設計而不是現象。用最小平方把觀察到的追蹤時間對治療組別作迴歸,會顯示被治療的病人多被追蹤了大約三週半,那是把治療的好處與「沒有復發的病人會被觀察到行政結束為止」這件記帳事實混在一起。Kaplan-Meier 估計式因為把每一位病人都用足了他被觀察到的那段時間,把復發時間的中位數 (median) 放在十八週,而那是上面每一個天真摘要都還原不出來的數字。表 29.1 固定住那套讓正確分析成為可能的詞彙,而圖 29.1 畫出那些天真摘要處理不了的設限結構。
表 29.1 離散與連續時間中的存活量。
| 量 | 連續時間 | 離散時間(期間 \(t=1,2,\dots\)) |
|---|---|---|
| 存活函數 \(S(t)\) | \(P(T>t)\),事件到 \(t\) 為止尚未發生的機率 | \(S(t)=\prod_{k\le t}\bigl(1-h(k)\bigr)\) |
| 危險 \(h(t)\) | \(P(t\le T<t+\Delta t\mid T\ge t)\,/\,\Delta t\) 在 \(\Delta t\to 0\) 時的極限,一個瞬時率 | \(h(t)=P(T=t\mid T\ge t)\),一個落在 \([0,1]\) 的條件機率 |
| 累積危險 | \(H(t)=\int_0^t h(u)\,du=-\log S(t)\) | \(H(t)=\sum_{k\le t} h(k)\)(近似) |
| 中位存活期 | 使 \(S(t)\le .5\) 的最小 \(t\) | 使 \(S(t)\le .5\) 的最小期間 |
| 與模型的連結 | \(h(t)=h_0(t)\exp(\mathbf{x}'\boldsymbol\beta)\)(Cox) | \(\mathrm{logit}\,h(t)=\alpha(t)+\mathbf{x}'\boldsymbol\beta\)(羅吉斯) |
註:危險是核心的量,因為它是條件地定義的,也就是在仍處於風險中的人裡定義,因而自然地吸收了設限。在連續時間裡它是一個可以超過一的率;在離散時間裡它是一個以一為上界的機率。存活函數則由危險逐期累積出來。
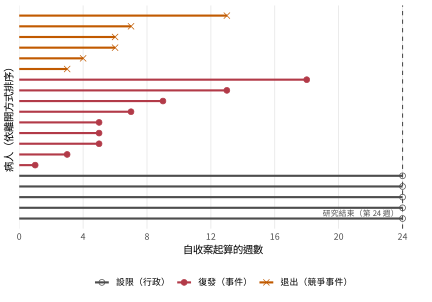
註:每一條水平的帶是一位病人自收案起算的追蹤。實心圓標出一次被觀察到的復發,也就是關心的事件;叉號標出退出,那是另一個結束觀察的事件;而虛線上的空心圓標出研究在第二十四週結束時仍在緩解中的病人。被設限的那些帶不是「該丟掉或該插補 (imputation) 的遺漏資料」:每一條都記錄了「這位病人至少無復發地存活了這麼久」,而那份訊息危險會完整用上。
危險那個條件性的定義是整個主題的概念樞紐,也是學生最常弄糊的定義。第 \(t\) 週的危險不是「一位隨機挑出的病人在第 \(t\) 週復發」的機率;它是「一位病人在第 \(t\) 週復發,在他到第 \(t\) 週之前還沒有復發的前提下」的機率。風險集 (risk set),也就是那群仍未發生事件且仍在觀察中的人,會隨時間縮小,因為病人會復發、會退出,或會走到行政的邊界;而危險永遠是相對於當下的風險集計算的。這正是設限之所以可處理的原因。一位被設限的病人對他被設限之前的每一個風險集都有貢獻,然後就單純地離開;關於那位病人,沒有任何東西被捏造,也沒有任何東西被丟棄。圖 29.2 呈現 relapse 資料的危險,以及它所隱含的存活函數,那是同一個分配的兩張面孔。
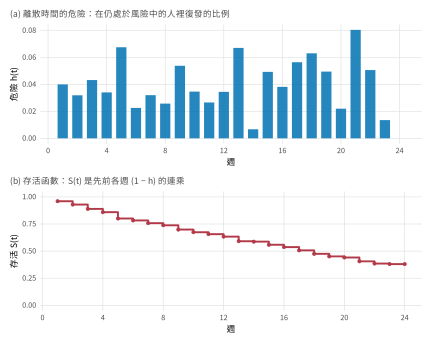
註:(a) 是實徵的離散時間危險,也就是每一週的復發人數除以那一週仍處於風險中的人數。(b) 是把無復發存活累積起來所得到的存活函數,\(S(t)=\prod_{k\le t}(1-h(k))\)。某一週的危險高,存活曲線 (survival curve) 就在那一週陡降;一個先升後降的危險,會使存活曲線在研究的中段下降得最快。
設限分好幾種,而種類是有差別的。右設限 (right censoring),也就是剛剛描述的那一種,發生在事件到觀察結束為止都還沒有發生時,也是最常見的一種。左設限 (left censoring) 發生在「已知事件在觀察開始之前就發生了,但確切時間不明」時,例如一份調查發現受訪者已經開始抽菸、卻沒辦法定出第一根菸的日期。區間設限 (interval censoring) 發生在「只知道事件落在兩次施測之間」時,而那正是多數追蹤資料真實的狀態,也是離散時間方法處理得很優雅的情形。跨越所有種類,讓標準分析成立的那個假設是無訊息設限 (noninformative censoring):那個把一位病人移出觀察的機制,除了共變項已經捕捉到的之外,不再帶著關於這位病人危險的任何訊息。這是第 6 章隨機遺漏假設在存活分析裡的表親,而它一樣無法由手上的資料檢驗、也一樣有後果。如果「快要復發的病人」正好就是那些退出的人,設限就是帶訊息的,風險集就不再能代表模型所想像的那群病人,而每一個估計值都會朝著「取決於那個機制」的方向偏誤。relapse 資料的競爭退出結構就是刻意做成這樣帶訊息的,而第 29.6 節會正面處理它,而不是假設掉它。
基礎概念 • 帶設限的概似
設限個案之所以能夠不靠捏造就留在分析裡,理由在概似 (likelihood) 上看得見。一位在時間 \(t\) 被觀察到發生事件的病人,貢獻的是事件時間在該處的密度,在危險的參數化下就是 \(h(t)\,S(t^-)\):這位病人存活到 \(t\),然後發生了事件。一位在時間 \(c\) 被右設限的病人,只貢獻 \(S(c)\):我們知道的只有「他存活超過了 \(c\)」。以 \(\delta_i=1\) 表示觀察到事件、\(\delta_i=0\) 表示設限,個別的貢獻就是 \(h(t_i)^{\delta_i}\,S(t_i)\);而在離散時間裡,這會逐期分解成一串 Bernoulli 項的乘積,每一期一項、涵蓋這位病人處於風險中的每一期,而「事件」的機率就是 \(h(t)\)。那個分解就是整個把戲:它把個人期間檔變成一組獨立的 Bernoulli 試驗,於是把存活估計變成羅吉斯迴歸。無訊息設限假設恰恰就是那個「允許我們把 \(S(c)\)、而不是某個取決於設限理由的東西,當成設限病人之貢獻」的東西。
29.2 離散時間存活:心理學家的入口
多數心理學事件不是記到瞬間的。復發記在每週的施測上,被當記在一個學期結束時,離婚記在一次年度的波次上。當時間的計量 (metric) 是粗的,離散時間存活就不是一個需要道歉的近似,而是自然的模型;而它在教學上最大的優點,是它化約成手上已經有的工具。這個方法由 Singer and Willett (1991) 與 Singer and Willett (1993) 為心理學與教育學發展出來,也見於 Allison (1982),它靠的是資料上一次重新塑形。個人期間檔 (person-period file) 把每一位參與者展開成「他處於風險中的每一期各一列」,由第一期一直到事件或設限的那一期,並帶一個二元 (binary) 指標,只有在事件發生的那一期等於一。一位在第五週復發的病人貢獻五列,指標在第一到第四週為零、第五週為一。一位在第十二週被設限的病人貢獻十二列,指標全為零。圖 29.3 畫出這個轉換,而軟體註記給出執行它的那幾行 R。
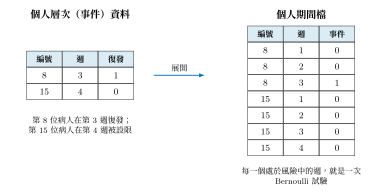
註:左邊的個人層次表格,每位病人一列,帶著事件時間與一個事件指標 (event indicator)。右邊的個人期間檔,每位病人每一個處於風險中的週各一列,事件指標只有在事件發生的那一週等於一、其餘為零。被設限的病人貢獻的是一路到設限那一週為止的全零列。展開後的檔案被當成一組獨立的二元結果來分析,這正是「在它上面跑一個羅吉斯迴歸就估出離散時間危險」的原因。
軟體提示 • 建立個人期間檔並配適危險模型
# 把個人層次的 (time, status) 展開成個人期間格式,再配適危險模型
build_pp <- function(df) do.call(rbind,
  lapply(seq_len(nrow(df)), function(i){
    k <- df$time[i]
    data.frame(person = df$person[i], week = 1:k,
               event = as.integer(df$status[i] == 1 & (1:k) == k)) }))
pp <- build_pp(relapse)                    # 重現出貨的 relapse_pp
# 離散時間危險模型:基線危險 + 共變項(logit 連結)
m <- glm(event ~ ns(week, df = 4) + arm + severity, data = pp, family = binomial)
# 多層次版本:跨場域的隨機截距(第 15 章的做法)
library(lme4)
m_ml <- glmer(event ~ ns(week, df = 4) + arm + severity + (1 | site),
              data = pp, family = binomial,
control = glmerControl("bobyqa"))檔案建好之後,離散時間危險模型就是「把事件指標對一個時間的表徵加上共變項作羅吉斯迴歸」。時間的那個表徵就是基線危險 (baseline hazard),也就是共變項固定在參照值時、風險跨各期的形狀,而它是這個設定裡唯一獨有的一項選擇。表 29.2 攤開那份菜單。最有彈性的選項是把時間放進去當成一組虛擬 (dummy) 指標、每一期一個,那完全不強加任何形狀,並精確重現 Kaplan-Meier 的基線;它的代價是每期一個參數,在期數多而每期事件少時很浪費。一個低階多項式 (polynomial),或更好的,一個在期數指標上的自然樣條 (natural spline),以少數幾個參數買到一條平滑的基線;而在 relapse 資料上,三次多項式與四個自由度 (degrees of freedom) 的樣條在赤池 (Akaike) 準則下都配適得比二十四個參數的虛擬設定好,而三種設定下的共變項估計值幾乎沒有變,治療的對數勝算 (log-odds) 都在 \(-0.90\) 附近、嚴重度的對數勝算都在 \(0.37\) 附近。實質係數在各種基線設定下的穩定性令人安心、也值得報告;不穩定則是一個警訊,表示基線與共變項正在交換變異數。
表 29.2 離散時間模型的基線危險設定。
| 設定 | 參數數 | relapse 的 AIC | 何時使用 |
|---|---|---|---|
| 時間虛擬變項 | 每期一個 | 1488.9 | 期數少;不假設形狀;重現 Kaplan-Meier |
| 多項式(三次) | 3 | 1483.2 | 平滑的基線;精簡;有邊緣假象的風險 |
| 自然樣條(df 4) | 4 | 1484.3 | 平滑又有彈性;尾端受控;建議的預設 |
| 單一常數 | 1 | (配適最差) | 只在危險真的隨時間持平時 |
註:參數數不含共變項。AIC 越低越好。在 relapse 資料上,平滑的設定(多項式、樣條)配適得比飽和的虛擬基線好,因為真實的危險是週的一個平滑駝峰函數;而估出來的治療與嚴重度效果在三種設定下都很穩定,那正是該檢查的性質。
共變項係數是對數危險勝算比,而它們讀起來就像任何一個羅吉斯係數,只是附上風險集的解讀。在 relapse 資料中,大約 \(-0.90\) 的治療係數說的是:在任何一週之內、在那一週仍處於風險中的病人之間,被分派到治療會把「那一週復發」的勝算乘上 \(\exp(-0.90)\approx 0.41\)。因為每週的危險都很小,這個危險勝算比與一個連續時間模型會報出的危險比很接近,而換一種連結函數 (link function) 可以讓這個對應變成精確的。互補雙對數連結 (complementary log-log link),\(\log(-\log(1-h(t)))=\alpha(t)+\mathbf{x}'\boldsymbol\beta\),就是那個「與一個只在期間邊界上被觀察到的底層連續時間比例危險歷程相容」的離散時間連結,而它的係數直接估計的就是 Cox 的對數危險比 (log hazard ratio)。以互補雙對數連結配適 relapse 的危險,得到 \(-0.876\) 的治療係數,與下一節 Cox 估計的 \(-0.879\) 在四捨五入之內相同,而 logit 連結給的是 \(-0.898\);三者一致是因為危險低,而當那些離散期間是連續時間的一次粗化、而不是真正離散的事件機會時,互補雙對數才是有原則的選擇。
預測出來的曲線是一份離散時間分析的交付物,也是讀者會記住的東西。由配適好的模型,任何一個共變項剖面 (profile) 的危險都可以逐期讀出,而那個剖面的存活函數則由那些危險累積出來。圖 29.4 呈現六個剖面的配適每週危險與隱含的存活曲線,那六個剖面是治療組別與低、平均、高三種基線嚴重度的交叉。這個呈現把模型的主張變得具體:基線危險在研究中段隆起,高基線嚴重度把整條危險剖面往上推,而治療把它往下推,於是一位低嚴重度的治療組病人,他的存活曲線一直很高,而一位高嚴重度的控制組病人,他的存活曲線陡降。一句寫作文字可以直接由這張圖與那個係數推出來,而第 29.7 節會示範它。
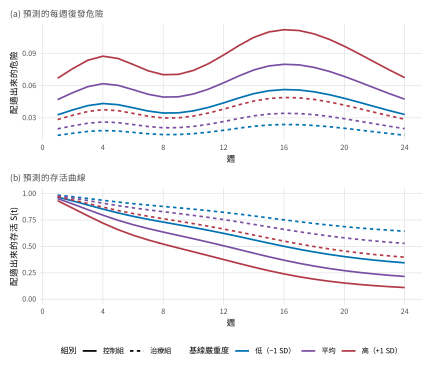
註:曲線來自配適到 relapse 個人期間檔的自然樣條基線羅吉斯危險模型。(a) 給出配適出來的每週復發危險,(b) 給出隱含的存活函數 \(S(t)=\prod_{k\le t}(1-h(k))\),分別對治療組與控制組(線型)交叉基線嚴重度在負一、零與正一個標準差(顏色)。那個隆起的基線、隨嚴重度往上的位移,以及隨治療往下的位移,全都直接由配適好的模型讀出來。
多層次的延伸,是第 15 章的回報準時抵達。relapse 研究的病人巢套 (nested) 在二十五個治療場域裡,而場域層次在復發風險上的差異,也就是未測量的治療師技巧、當地的個案組成、轉介型態,會在同一場域的病人之間誘發依賴,那是一個單層模型會忽略的。在離散時間危險模型上為場域加一個隨機截距 (random intercept),也就是把 glm 換成 glmer 這一行改動,還原出 \(0.485\) 的場域層次標準差(在 logit 尺度上),與生成歷程裡放進去的 \(0.50\) 很接近,並為那份群集 (clustering) 調整了共變項的標準誤 (standard error)。這個隨機截距就是第 29.5 節共享脆弱性模型在離散時間裡的面貌;兩者是同一個想法,一個「在一個群集之內共有的、乘在危險上的潛在乘數」,一次以羅吉斯的做法表達、一次以 Cox 的做法表達。
29.3 連續時間:Kaplan-Meier 與 Cox
當時間量得夠細、以致同分 (tie) 很少時,連續時間那一套做法就更自然、也更有力。它的兩件工具是存活函數的 Kaplan-Meier 估計式與共變項對危險之效果的 Cox 模型。Kaplan-Meier 估計式 (Kaplan & Meier, 1958) 把存活曲線建成一個「在各個相異事件時間上的連乘」:在每一個有事件發生的時間,存活被乘上「一減去那一瞬間事件數對風險集的比值」,而被設限的個案離開風險集時不會觸發任何下降。結果就是那條「把每一個個案都用足了他被觀察到的期間」的無母數 (nonparametric) 存活曲線,也就是第 29.1 節那些天真平均數產生不出來的誠實圖像。圖 29.5 以本書的版面風格呈現 relapse 資料兩個治療組別的 Kaplan-Meier 曲線,附上逐點 (pointwise) 的信賴帶,以及圖下方那張每一份存活圖都該帶著的風險人數表 (risk table)。控制組的中位無復發時間是十一週,治療組是二十二週,而兩條曲線之間的分離就是治療效果被看見的樣子。
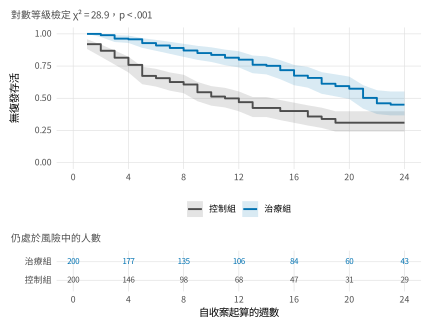
註:階梯函數 (step function) 是「仍維持無復發」機率的 Kaplan-Meier 估計;陰影帶是逐點的百分之九十五信賴區間 (confidence interval)。座標軸下方的風險人數表,報告每四週有多少病人仍未發生事件且仍在觀察中,那是一份存活圖的必要元素,因為右尾的可靠性取決於那裡還有多少人處於風險中。對數等級檢定比較的是整條曲線。
對數等級檢定 (log-rank test) 比較兩條或更多條存活曲線的方式,是在每一個事件時間上累積「某一組被觀察到的事件數」與「若各組危險相同時所期望的事件數」之差,再把總和加以標準化 (standardization)。在 relapse 的兩組上,它回傳一個自由度為一、值為 \(28.9\) 的卡方 (chi-square),決定性地拒絕曲線相等。這個檢定在危險成比例時最有力,那個條件下面會精確定義;當曲線交叉時,累積起來的差會部分互相抵銷,於是對數等級檢定失去檢定力 (power),這項限制促成了它那些加權 (weighted) 的親戚,而更重要的是,它促使我們去看曲線,而不是去信任單一個 \(p\) 值。
Cox 比例危險模型 (Cox, 1972) 是連續時間存活分析的主力,而它的設計是一件值得理解、而不只是拿來引用的統計學上的優雅。這個模型把一位共變項為 \(\mathbf{x}\) 的病人的危險寫成 \(h(t\mid\mathbf{x})=h_0(t)\exp(\mathbf{x}'\boldsymbol\beta)\),也就是「一個大家共有、但形式完全未指定的基線危險 \(h_0(t)\)」乘上「一個依賴共變項但不依賴時間的乘數」。基線危險被完全留白,然而係數 \(\boldsymbol\beta\) 卻可以在沒有它的情況下被估計出來,靠的是偏概似 (partial likelihood)。那個想法是以事件時間的集合為條件,並在每一次事件時問:當下風險集裡的哪一位成員是發生事件的那一個;在這個模型之下,那個機率就是這個個體的危險除以風險集內所有危險的總和,而那個未知的基線危險,因為分子分母都有,就約掉了。把這些條件機率在所有事件上乘起來就是偏概似,而最大化它就估出了那些危險比,同時把基線的形狀當成一個「想要時可以另外還原」的贅餘 (nuisance) 留著。在 relapse 資料上,Cox 模型回傳的治療危險比是 \(0.415\)、嚴重度每一個標準差的危險比是 \(1.44\),與離散時間及互補雙對數的配適一致,本來就該如此。
基礎概念 • 基線危險為什麼會掉出去
在一個事件時間 \(t_{(j)}\) 上,令 \(R_j\) 為風險集,也就是那些在 \(t_{(j)}\) 之前仍未發生事件且仍在觀察中的人。在 Cox 模型之下,「已知在 \(R_j\) 中恰好發生了一次事件,而發生事件的正是那位特定個體 \(i_j\)」的機率是 \(\dfrac{h_0(t_{(j)})\exp(\mathbf{x}_{i_j}'\boldsymbol\beta)}{\sum_{\ell\in R_j} h_0(t_{(j)})\exp(\mathbf{x}_\ell'\boldsymbol\beta)}=\dfrac{\exp(\mathbf{x}_{i_j}'\boldsymbol\beta)}{\sum_{\ell\in R_j}\exp(\mathbf{x}_\ell'\boldsymbol\beta)}\)。基線危險 \(h_0(t_{(j)})\) 在每一項裡都相同,於是約掉,只留下一個「只依賴共變項與 \(\boldsymbol\beta\)」的量。把這些跨所有事件時間乘起來,就得到偏概似。事件時間的同分,在粗略測量的心理學資料裡很常見,會破壞這個乾淨的推導;Efron 近似對中等程度的同分處理得不錯,是一個合理的預設,而同分很嚴重就是一個訊號,表示離散時間模型才是比較誠實的選擇。
危險比必須以一種「它的方便本身會侵蝕掉」的紀律去解讀。一個危險比是一個瞬時率的比值,在每一瞬間仍處於風險中的人之間,而風險集的組成會隨時間以「共變項沒有完全捕捉到」的方式改變。即使一項治療對每一位病人的效果都完全相同,風險集被差別耗竭 (differential depletion),也就是最脆弱的病人先復發並離開、留下比較耐受的剩餘者,也可能使危險比在追蹤期間往一漂移,於是一個固定的危險比是一項很強的假設,而一個時變的危險比並不是「生理效果在改變」的證據。Hernán (2010) 把這一點推到它的結論:因為危險比以「存活到每一瞬間」為條件,而存活又被治療影響,所以較晚時間的危險比比較的是兩群「已經不再可交換 (exchangeable)」的人,它並沒有一個「治療對事件時機之效果」的乾淨因果解讀。實務上的建議是:把危險比讀成一個有用的關聯摘要,把存活曲線與它並列報告好讓讀者看到絕對的圖像,而且絕不要把一個危險比翻譯成一個「彷彿它是風險比」的、關於事件機率的陳述。
常見陷阱 • 誤讀一個 Cox 模型的三種方式
危險比不是風險比。一個 \(0.4\) 的危險比,並不表示治療組發生事件的機率是控制組的百分之四十。它是一個以「存活」為條件的瞬時率比值;對累積發生率的效果取決於基線危險與追蹤長度,必須由存活曲線或累積發生曲線上讀出來。危險比未必是固定的。一個單獨報出來的危險比假設了比例危險;如果那個假設不成立,這個數字就是「一個隨時間改變的效果的時間平均」,可能誤導得很嚴重,下一張圖就會顯示這一點。追蹤後期的一個危險比不是一個乾淨的因果對比。以「存活到時間 \(t\)」為條件,就是以一個治療後 (post-treatment) 變項為條件,所以後期的危險比比較的是兩群「被治療本身弄得不再可交換」的人 (Hernán, 2010)。
比例危險假設是可以檢驗的,而且檢驗它並不是可有可無的步驟。Schoenfeld 殘差 (Schoenfeld residuals),每個共變項在每次事件上各一個,是「一位病人的共變項值」與「事件那一刻以風險集加權的平均」之差;在比例危險成立時它們對時間沒有趨勢,而一個趨勢就是「某個共變項的效果隨追蹤而改變」的指紋 (Grambsch & Therneau, 1994)。relapse 資料被做成帶著一個植入的違反:治療的保護效果在早期很強,並在六個月間淡去,在最後幾週跨過去成為略微有害,那是一個「沒有維持治療、好處就會消退」的療法會有的現實型態。Schoenfeld 檢定決定性地偵測到它,治療效果的卡方為 \(24.4\)、自由度為一(而被做成成比例的嚴重度效果通過了檢定,卡方為 \(0.76\))。圖 29.6 把這項診斷 (diagnostic) 與它的解法一起呈現。治療的縮放後的 Schoenfeld 殘差隨時間往上斜,而那條固定危險比的線錯過了那個斜率;解法是讓治療係數隨時間變化,可以是跨區間的階梯函數、也可以是一個平滑函數 (smooth function),而兩者都還原出那個植入的消退,治療的對數危險比由前六週的大約 \(-1.6\) 上升到最後六週的大約 \(+1.0\),在第十六週附近跨過零。表 29.3 把那些補救整理起來。
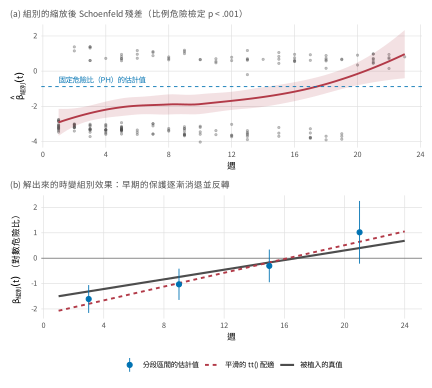
註:(a) 把治療效果的縮放後的 Schoenfeld 殘差對時間畫出來,並附一條 loess 平滑線;那個往上的趨勢,以及低於萬分之一的比例危險檢定 \(p\) 值,都標示出治療效果不是固定的。虛線是那個單一的固定危險比估計值,而那個趨勢與它相牴觸。(b) 解決了那項違反:分區間的估計值(帶區間的點)與平滑的時變配適(虛線)都跟上了植入的真值(實線),一個早期強力保護、之後消退到零甚至越過零的治療效果。在這裡報出單一個危險比,等於把一個早期的保護效果與一個晚期的有害效果平均在一起。
表 29.3 比例危險違反的補救階梯。
| 補救 | 它做什麼 | 何時優先 |
|---|---|---|
| 分層 | 讓基線危險在各層之間不同;把那個惹麻煩的變項移出危險比模型 | 贅餘變項;對它的效果沒有興趣 |
| 時變係數 | 把 \(\beta(t)\) 估成時間的階梯或平滑函數 | 那個改變中的效果本身有實質意義 |
| 分區間的效果 | 把追蹤切開,逐區間報一個危險比 | 溝通;有可解讀的時期 |
| 加速失效時間 | 直接對時間建模;一個不同、往往更穩定的摘要 | 當時間尺度上的效果比較自然時 |
| 照原樣報告並加註 | 保留那個平均效果,但明說它是一個時間平均 | 只在違反輕微、而且已揭露時 |
註:一項比例危險的違反並不會使一份研究失效;它改變的是估計標的 (estimand),由單一個危險比變成一個時變的危險比。在各種補救之間的選擇,取決於那個惹麻煩的變項是「一個該被吸收掉的贅餘」還是「一個該被描述的效果」。把整份分析丟掉,從來都不是正確的反應。
函數形式 (functional form) 值得與比例性 (proportionality) 同等的檢視。一個省略了某個連續共變項的 Cox 模型,它的 Martingale 殘差對著那個共變項畫出來,會揭示那個共變項應該以什麼形狀進入模型;一個線性的趨勢支持一個線性項,而彎曲則呼喚一個樣條,接上第 30 章的加法模型 (additive model) 做法。在 relapse 資料上,Martingale 殘差對基線嚴重度接近線性,支持了全章所用的線性嚴重度項。
29.4 時變共變項與它們的陷阱
共變項不必固定在基線。一位病人的症狀水準、睡眠品質或服藥遵從度會隨追蹤而變,而一個時變共變項讓每一瞬間的危險依賴那個共變項當下的值。支撐這件事的資料結構 (data structure) 是計數歷程 (counting-process) 格式,其中每位病人貢獻一串區間 \((t_{\text{start}},t_{\text{stop}}]\),每個區間帶著那段時間裡有效的共變項值,以及一個關於它右端點的事件指標。這與離散時間檔是同一套個人期間邏輯,只是推廣到任意的區間邊界。本書那些密集測量的章節讓時變共變項變得格外有力:一串生態瞬時評估 (ecological momentary assessment) 的每日症狀或渴求報告,可以對齊到一個臨床事件 (clinical event) 的危險上,於是「瞬間的狀態能不能預報事件」這個密集設計獨有的貢獻,就成了一個帶時變共變項的存活模型。在 relapse 資料中,每週的症狀分數作為一個時變共變項進入模型,而計數歷程的 Cox 模型把它的係數估在每分 \(0.29\),於是某一週高一分的症狀分數,與那一週高出百分之三十四的復發危險有關。這個時變的症狀勝過同一位病人的基線症狀分數,後者的係數是 \(0.26\),因為當下的狀態帶著基線值已經失去的訊息。圖 29.7 呈現六位復發病人的展示,他們每週的症狀條朝著復發那一週攀升。
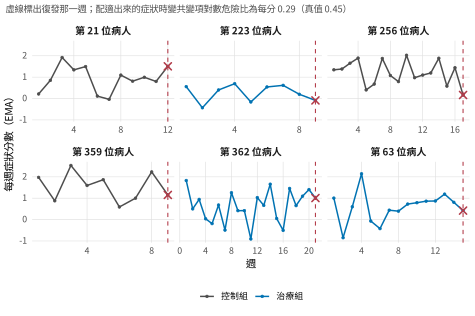
註:六位復發的病人,把他們每週的症狀(生態瞬時評估)分數畫到復發那一週(虛線、叉號)。當下那一週的症狀以一個時變共變項進入危險;它配適出來的對數危險比是每分 \(0.29\)。這個估計值相對於生成歷程裡放進去的 \(0.45\) 是被衰減過的,因為被觀察到的每週症狀是「真正驅動危險的那個潛在狀態」的一個帶誤差的讀數,那是一種迴歸稀釋 (regression dilution) 效應,而第 29.6 節的聯合模型會處理它。這裡呈現的病人是在復發者中挑出「後期症狀偏高」者,好讓那份耦合看得見。
時變共變項分成兩類,而它們的差別是整節的樞紐。一個外生 (exogenous) 的時變共變項,走的是一條「不受這位病人事件狀態影響」的路徑,例如季節、年齡,或一份由外部設定的劑量排程;它可以直接放進 Cox 模型並被乾淨地解讀。一個內生 (endogenous) 的時變共變項是由病人自己產生的、帶著測量誤差 (measurement error),而且可能自己就對即將發生的事件有反應;每週的症狀分數就是內生的,因為一位滑向復發的病人症狀分數會上升,理由與他即將復發是同一個。把一個內生共變項放進一個普通的 Cox 模型,與其說是錯,不如說是受限:那個係數會被測量誤差衰減,而那個共變項自己的軌跡被留著沒建模,丟掉了訊息,也錯誤處理了「這個共變項恰恰在病人發生事件時就不再被觀察」這件事。第 29.6 節的聯合模型才是內生共變項正確的歸宿,而症狀分數在這裡出場,正是為那個回報刻意鋪的路。
整個存活分析裡最具破壞力的陷阱,住在對時變暴露 (exposure) 的錯誤處理上,而它值得一段獨立的處理。不朽時間偏誤 (immortal-time bias) 發生在「一段依構造而言病人不可能發生事件的追蹤時間,被錯誤地歸給一項病人當時還沒有接受的暴露」時。標準的例子是「奧斯卡得獎者比沒得獎的入圍者長壽」這項主張,而它正是栽在這個錯誤上:一位演員必須活到頒獎典禮才可能得獎,所以得獎之前那些年保證是無事件的,把它們算給「得獎者」那一組,等於單憑記帳就製造出一項存活優勢。當 Sylvestre et al. (2006) 把得獎狀態當成它本來的樣子,也就是一個時變共變項,重新分析那份資料,把每位演員在得獎之前歸給未暴露組、得獎之後才歸給暴露組,那項優勢就大致蒸發了。同樣的結構在「暴露是由某件需要時間才會發生的事所定義」的每一個地方重現:反應者分析把病人依「只有存活者才展現得出來的反應」分類、依方案分析要求完成一整個療程、移植分析把等待時間算給被移植者 (Suissa, 2008)。圖 29.8 解剖這項偏誤,而一次聚焦的模擬確認了它:以一項被做成完全沒有效果的暴露來說,那個「把病人依曾否暴露分類、並把他們暴露前的時間算給暴露組」的天真分析回傳一個 \(0.28\) 的假危險比,一項憑空變出來的巨大保護效果;而那個「在真正的時刻把每位病人由未暴露轉到暴露」的正確計數歷程分析,還原出 \(1.03\) 的危險比,也就是它該有的虛無值。
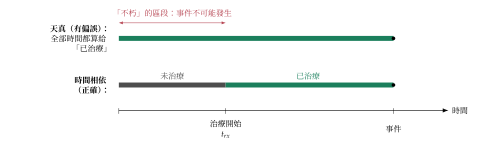
註:一位在時間 \(t_{rx}\) 開始治療的病人,必須由收案起無事件地存活到 \(t_{rx}\) 才可能被治療。天真的分析(上)把這位病人在整段追蹤中都歸類為已治療,把 \(t_{rx}\) 之前那段保證無事件的「不朽」區段算給治療組,於是製造出一項存活優勢。正確的分析(下)把暴露當成時間相依的,把治療前的區段歸給未治療狀態、只把治療後的區段歸給已治療狀態。在一次沒有真實效果的模擬中,天真的分析回傳 \(0.28\) 的危險比,正確的分析回傳 \(1.03\)。
29.5 多層次、重複與競爭事件
真實事件資料的三項複雜性,群集、重複與競爭,各自以「由實質問題決定」的方式改變模型。共享脆弱性 (shared frailty) 處理群集的方式,是把一個群集中每位成員的危險乘上一個共同的潛在因子,也就是那個脆弱性,它由一個平均數為一的分配抽出、變異數 (variance) 則被估計出來;伽瑪 (gamma) 脆弱性因為解析上的方便而是慣例的選擇。在 relapse 資料上,為治療場域在 Cox 模型上加一個伽瑪脆弱性,估出 \(0.22\) 的脆弱性變異數,與生成歷程所隱含的值接近,而一個對照無脆弱性模型的概似比檢定 (likelihood-ratio test) 是決定性的,確認了各場域在共變項所解釋之外的復發風險確實不同。脆弱性變異數可以解讀為「危險上未被解釋的群集間異質性有多少」,而它是第 29.2 節離散時間模型那個場域隨機截距在連續時間中的雙胞胎;治療效果因加了脆弱性而幾乎沒有變,在治療於各場域間平衡時本來就該如此,但它的標準誤誠實地變大了。
重複問題要先問一個更前面的問題:什麼算作那個事件。當事件可以重複發生時,一次戒除嘗試中的破戒、攻擊事件、再住院,分析者就必須決定關心的量是「事件的整體率」還是「在已經經歷過若干次之後、下一次事件的風險」,而這兩個問題呼喚不同的模型。表 29.4 攤開那些選擇。Andersen-Gill 模型 (Andersen & Gill, 1982) 把每位病人當成一個計數歷程,共有一個基線危險,而連續事件之間的區間全部貢獻到單一個風險集裡;它估的是一個整體的率比 (rate ratio),回答的是母體率的問題,並以穩健 (robust) 標準誤容納病人內的依賴。Prentice-Williams-Peterson 模型 (Prentice et al., 1981) 依事件次序分層,於是第一次、第二次與第三次事件的風險由各自的基線危險支配,回答的是條件式的、逐次事件而定 (episode-specific) 的問題。圖 29.9 對比它們的風險集構造。一次「共變項被做成把破戒率減半」的重複破戒聚焦模擬,在兩種模型下都還原出真相,Andersen-Gill 的對數率比是 \(-0.47\)、Prentice-Williams-Peterson 是 \(-0.45\),對照植入的 \(-0.50\);但如果那個共變項的效果在各次事件之間不同,兩個估計標的就會分歧,而在兩者之間的選擇應該由問題決定,不是由哪一個配適得比較好決定。
表 29.4 依問題選擇一個重複事件模型。
| 模型 | 估計標的 | 何時使用 |
|---|---|---|
| Andersen-Gill | 整體的事件率比 | 事件的總負荷或總率是結果;假設效果在各次事件間相同 |
| Prentice-Williams-Peterson | 依事件次序分層的、各次事件特定的危險比 | 已知過去史之下、下一次事件的風險;效果可能依次序而異 |
| 脆弱性(隨機效果) | 帶著明確個體內異質性的率比 | 傾向性上的個體間變異本身有興趣 |
註:三者都用計數歷程的資料版面。Andersen-Gill 與脆弱性瞄準的是一個率;Prentice-Williams-Peterson 瞄準的是「以事件次序為條件的風險」。穩健或模型本位的標準誤容納一個人重複事件之間的依賴。這些模型回答不同的問題,也可能給出不同的答案;問題要先來。
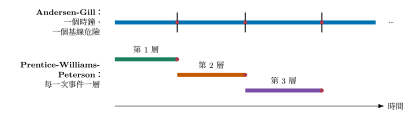
註:紅點是同一位病人接連發生的事件。Andersen-Gill 模型(上)把所有事件間區間放在同一個時鐘上、共用一個基線危險,估出一個整體的率比。Prentice-Williams-Peterson 模型(下)把每一次接續的事件指派到它自己的層、各有自己的基線危險,於是第二次事件的風險與第一次分開建模,回答的是一個以事件次序為條件的問題。這兩種版面編碼的是不同的估計標的,不是同一個估計標的的不同配適。
競爭是三者中最微妙的一項,因為它會默默地讓多數分析者第一個伸手去拿的工具失效。競爭風險 (competing risks) 出現在「不只一種事件可以結束追蹤,而其中一種的發生會讓另一種不再可能」時:在 relapse 資料中,一位脫離照護的病人就不可能再被觀察到復發,所以退出與復發競爭。要避免的錯誤,是把退出當成一般的設限、再以「一減去 Kaplan-Meier 曲線」估計復發的累積發生率,因為那等於把退出的病人當成「他們仍處於我們本來會看到的那種復發風險之中」,於是高估了估出來的復發發生率。正確的物件是累積發生函數 (cumulative incidence function),它只計算真正到達的那些復發,並把「風險集被競爭事件耗竭」這件事算進去。圖 29.10 呈現那道落差:一減 Kaplan-Meier 的曲線在兩組中都明顯落在累積發生函數之上,而隨著退出累積,那道差距還在擴大,於是一份報告前者的研究會高估復發的負荷。
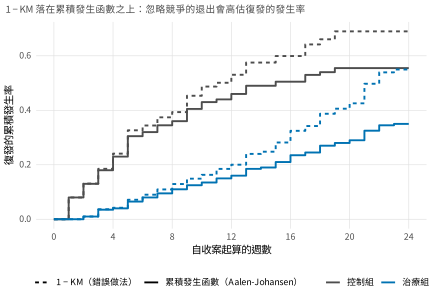
註:在每一個治療組別中,實線是把競爭的退出風險算進去的復發累積發生函數,而虛線是一減 Kaplan-Meier 的估計,後者把退出當成彷彿它是對復發的無訊息設限。虛線落在實線之上,因為它把「從未被觀察到的復發」記到那些退出的病人頭上;而隨著追蹤加長、退出累積,那道差距還會擴大。在有競爭風險時報告一減 Kaplan-Meier,會高估關心事件的發生率。
競爭風險這個標題底下住著兩個估計標的,而它們回答的是不同的科學問題。病因特定危險 (cause-specific hazard) 是「在那些仍未復發且仍在照護中的人裡」復發的瞬時率;它由一個「把競爭的退出當成設限」的 Cox 模型估出,回答的是「一個共變項如何影響導向復發的生理歷程」這個病因學問題。Fine and Gray (1999) 的次分配危險 (subdistribution hazard) 則把發生了競爭事件的病人以一個遞減的權重留在風險集裡,於是它的係數直接對映到累積發生函數上;它回答的是「在一個也會發生退出的母體中,一個共變項如何影響復發的實際機率」這個預後問題。在 relapse 資料上,病因特定的治療對數危險是 \(-0.88\)、Fine-Gray 的次分配對數危險是 \(-0.81\),在這裡很接近,因為治療對退出的影響不大;但它們是不同的估計標的,而在一個共變項會影響競爭事件時可以分歧得很厲害,表 29.5 把這一點列了出來。規則是先把問題說清楚:要機制,用病因特定;要預測、以及要臨床需要的那個累積發生率,用 Fine-Gray (Austin et al., 2016)。
表 29.5 病因特定危險與次分配危險的對照。
| 特徵 | 病因特定危險 | 次分配危險(Fine-Gray) |
|---|---|---|
| 風險集 | 在競爭事件發生時把那些個案移除(設限) | 把競爭事件的個案以遞減的權重留著 |
| 對映到 | 仍處於風險中者之間的事件率 | 累積發生函數 |
| 回答 | 病因學:對「產生事件的歷程」的效果 | 發生率/預後:對「實際機率」的效果 |
relapse 的組別效果 | \(-0.88\)(對數危險) | \(-0.81\)(對數次分配危險) |
| 何時報告 | 研究機制;兩個病因一起建模 | 預測絕對風險;臨床的發生率 |
註:兩種危險只有在共變項對競爭事件沒有效果時才會重合。因為它們回答不同的問題,一份完整的競爭風險分析往往兩者都報:每個病因的病因特定危險用來描述機制,累積發生函數(連同 Fine-Gray 的效果)用來描述由此產生的絕對風險。
實務要點 • 罕見事件與「每變項事件數」的經驗法則
心理學的事件研究常常樣本小、事件罕見,而束縛住分析的不是樣本數而是事件數。一條被廣泛使用的經驗法則要求在一個 Cox 或離散時間模型中,每一個被估計的係數至少要有十到十五個事件;低於此,係數不穩定,而它們的標準誤過於樂觀。以一個三百人樣本、百分之七的事件率來說,只有大約二十一個事件可用,夠一到兩個共變項,不夠五個。誠實的回應是:以事前指定 (prespecification) 減少共變項數、以懲罰化(脊 (ridge) 或 lasso)偏概似穩定估計、粗化成一個「跨期間彙整訊息」的離散時間模型,或把這份分析報告成探索性的。在二十個事件上報告一個十共變項的 Cox 模型、並把它的 \(p\) 值當真,正是這條經驗法則存在所要防止的那種失敗。
29.6 縱貫存活聯合模型
本章最後這個模型一次收攏兩個迴路。第 29.4 節那個內生的時變共變項被留在一個不妥當的處理裡,帶著它的測量誤差進入危險、而它自己的軌跡沒有被建模。第 6 章那個依賴結果的退出,當時承諾了一個共享參數的處理,也被留成一項假設。縱貫存活聯合模型 (joint longitudinal-survival model) 同時配適兩個次模型、並以共享的隨機效果把它們連起來,一次解決兩者。縱貫次模型就是第 13、14 章的成長模型,一個帶著隨機截距與隨機斜率的重複測量混合模型。存活次模型則是一個關於事件的危險模型,這裡的事件是帶訊息的退出,而它的線性預測式裡包含了「生成那條軌跡的同一批隨機效果」的一個函數。因為兩個次模型共享那些隨機效果,「一位病人的症狀軌跡」與「他的退出風險」之間的關聯就是被估計出來的,而不是被忽略;而縱貫的參數也就為「退出所施加的選擇」作了校正。圖 29.11 畫出這個架構、並呈現它的回報。
這個關聯可以用好幾種方式參數化,而那個選擇編碼的是一項「軌跡如何驅動事件」的假設。表 29.6 把它們攤開。當下值 (current-value) 參數化把危險連到軌跡在每一瞬間的配適水準上,適合「重要的是當下的狀態」時,例如一個症狀水準跨過一個門檻。斜率 (slope) 參數化把危險連到變化率上,適合「不管水準如何、驅動事件的是惡化或改善」時。共享隨機效果 (shared-random-effects) 參數化把危險直接連到那些隨機效果上,是那個精簡的選擇,把事件綁在一位病人穩定的個人傾向上。relapse 的生成歷程被做成「退出依賴一位病人的隨機斜率」,於是惡化最快的病人最早離開,那是非隨機遺漏流失 (attrition) 的典範案例,而共享隨機效果參數化就是那個相配的模型。因為復發這個競爭的終端事件使完整的 relapse 資料比一個兩部分模型所設定的更難處理,這項回報改在一次「把退出機制隔離出來」的聚焦模擬上示範,與不朽時間與重複事件那兩段獨立處理的精神相同。
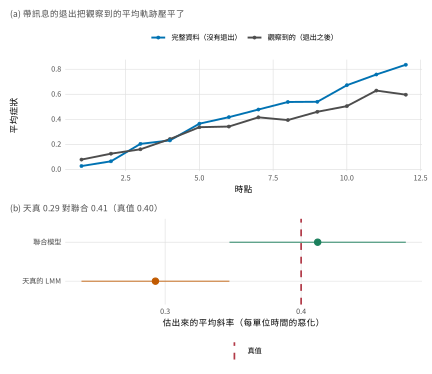
註:上:縱貫(成長)次模型與存活(退出)次模型共享病人的隨機效果,於是「軌跡與退出之間的關聯」是被建模的,而不是被假設為不存在。下 (a):因為惡化最快的病人最早退出,觀察到的平均軌跡(退出之後)相對於完整資料的平均軌跡變平了,那是非隨機遺漏流失的指紋。下 (b):只配適觀察資料的天真混合模型,把平均惡化斜率估在 \(0.29\),低於真值 \(0.40\);共享參數的聯合模型還原出 \(0.41\),而關聯參數也估在它的真值上。天真的分析低估惡化,恰恰是因為那些正在惡化的病人就是離開的那些人。
那個回報就是為這套做法背書的展示。在這次聚焦模擬中,母體的平均惡化斜率依構造是 \(0.40\),而一個完整資料的混合模型把它還原在 \(0.395\)。但退出移走了那些惡化最快的人,於是被觀察到的軌跡是一個被選擇過的樣本,而只配適觀察資料的天真混合模型把斜率估在 \(0.29\),低估惡化超過四分之一,因為那些「本來會把平均往上拉」的病人已經離開。共享參數的聯合模型,把退出危險與軌跡一起配適、並讓隨機斜率在兩者之間共享,把斜率還原在 \(0.41\),並把關聯參數估在它的真值上。這就是第 6 章承諾過的「非隨機遺漏資料的共享參數取向」的具體意義:退出不是被假設為可忽略 (ignorable),它是被建模的,而那份建模修補了忽略它會造成的偏誤。這項修正只跟「被假設的關聯結構」一樣好,而那個結構與隨機遺漏假設一樣,由觀察資料是檢驗不出來的,所以一份聯合模型分析恰當的報告方式是把它當成一項有原則的敏感度分析 (sensitivity analysis),回答的是「若退出以所設定的方式依賴那些隨機效果,那條軌跡看起來會是什麼樣子」,並與那個「假設它不依賴」的天真答案並列。
表 29.6 聯合模型中的關聯參數化。
| 參數化 | 危險依賴什麼 | 實質讀法 |
|---|---|---|
| 當下值 | 時間 \(t\) 上配適的軌跡水準 \(m_i(t)\) | 當下的狀態驅動事件(跨過門檻) |
| 斜率 | 變化率 \(m_i'(t)\) | 不管水準如何,惡化或改善驅動事件 |
| 共享隨機效果 | 直接依賴那些隨機效果 \(b_i\) | 穩定的個人傾向驅動事件 |
| 當下值 + 斜率 | 水準與變化率都算 | 水準與它的方向都重要 |
註:參數化是一項關於「軌跡如何與事件耦合」的科學假設,不是一項技術細節。它應該由理論事前選定;而在幾種形式都說得通時,以訊息準則比較。relapse 的生成歷程把退出耦合到隨機斜率上,所以共享隨機效果那一種才是相配的設定。
軟體提示 • 在 R 裡配適聯合模型
把聯合模型配適好需要專用的軟體,因為那個概似要同時對兩個次模型的隨機效果作積分。在 R 裡成熟的選擇是 JM 套件與它的貝氏 (Bayesian) 後繼者 JMbayes2,它們配適得了很多種關聯結構、競爭與重複事件,以及多變量的縱貫標記;joineRML 則以最大概似 (maximum likelihood) 處理多個縱貫結果。套件的能力與預設值會變,所以應該查閱當前的說明文件,而不是憑記憶中的介面。本章的工作範例用的是一個手寫的最大概似配適,對兩個隨機效果作 Gauss-Hermite 積分,對「單一個縱貫標記加單一個事件」來說夠用,而且它的概似裡有什麼是透明的;但帶著好幾個標記或好幾種事件的生產分析,屬於那些專用套件,它們的數值做法是為那個規模而建的。
29.7 報告一份存活分析
一份存活分析要報告到「讓它對設限的處理與它對估計標的的選擇都變得明白」的標準,因為那正是它的效度 (validity) 所繫的兩項決定,也是讀者無法單從一個危險比重建出來的兩項決定。表 29.7 是那份檢核表。時間的起點與事件的定義必須精確陳述,因為一個危險離開它們就沒有意義。設限必須被描述、它的程度必須被量化,而它可能帶訊息這件事必須被討論而不是揮手帶過,競爭事件必須被點名、並以一個與問題相配的估計標的處理。若使用了 Cox 模型,比例危險假設必須被檢查、檢查結果必須被報告,若假設不成立,補救也必須被點名。那些圖承擔論證:一張帶風險人數表的 Kaplan-Meier 或累積發生率呈現,以及一張關心之共變項效果的預測曲線呈現,傳達的是一張危險比表格傳達不了的東西。
表 29.7 存活分析的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 時間起點與事件 | 時鐘精確的起點與事件的定義;時間的計量(連續或離散) |
| 設限 | 程度(設限的百分比)、出現的種類,以及一個支持或反對無訊息性的論證 |
| 風險集 | 樣本數、事件數,以及每變項事件數;曲線上的風險人數表 |
| 模型與估計標的 | 離散時間、Cox 或參數化模型;危險比與區間;點名那個估計標的 |
| 比例危險 | 作了哪一項診斷與它的結果;若違反,補救是什麼 |
| 競爭風險 | 點名競爭事件;病因特定與/或 Fine-Gray,與問題相配 |
| 圖 | 帶風險人數表的存活或累積發生曲線;預測曲線的呈現 |
註:存活分析的報告標準,是圍繞著讀者無法自行驗證的那兩項決定組織起來的:設限是怎麼處理的,以及所報告的效果瞄準的是哪一個估計標的。陳述時間起點、量化設限、檢查比例危險,以及點名競爭風險的估計標的,是最常缺席、缺席時後果也最嚴重的幾個元素。
一段依此標準寫成的 relapse 分析結果段落如下。在四百位由收案起追蹤最多二十四週的病人中,一百八十一位(百分之四十五)復發、一百四十八位(百分之三十七)在復發之前離開照護(一個競爭事件),而七十一位(百分之十八)在行政結束時仍在緩解中;中位無復發時間在控制組是十一週、在治療組是二十二週。一個 Cox 模型估出 \(0.42\) 的治療危險比,但比例危險假設對治療是違反的(Schoenfeld 檢定,\(p<.001\)),因此該效果被建模為時變的:治療在最初幾週強力保護(對數危險比接近 \(-1.6\)),而它的好處到研究結束時消退為零,顯示那份保護沒有被維持。基線嚴重度提高了復發危險(每標準差危險比 \(1.44\)),效果是成比例的。把退出這個競爭風險算進去之後,二十四週時復發的累積發生率明顯低於一減 Kaplan-Meier 的估計所暗示的;而一個縱貫存活聯合模型指出退出與較快的症狀惡化有關,於是一個忽略退出的成長模型會低估平均的惡化。這一段陳述了起點、量化了設限與競爭事件、點名了比例危險的違反與它的解決、區分了估計標的,並報告了非隨機遺漏的敏感度分析,而那就是本章所教的整套紀律。
本章摘要
關於事件時機的問題需要它自己的做法,因為設限,也就是研究結束時尚未發生事件者「只知道超過某個時間」的狀態,會使每一個天真的摘要產生偏誤:在 relapse 資料上,被觀察到之復發時間的平均數、把設限當成事件的平均數,以及把追蹤時間拿去作普通迴歸,全都與 Kaplan-Meier 的中位數差得很遠。危險是核心的量,因為它是在仍處於風險中的人裡定義的,因而吸收了設限,而存活函數由它累積出來。離散時間存活是心理學家的入口:個人期間檔把事件資料變成一個羅吉斯迴歸,基線危險以虛擬變項、多項式或樣條設定,共變項效果讀成危險勝算比,而互補雙對數連結還原出連續時間的危險比;一個場域隨機截距用第 15 章的工具加上多層次結構。在連續時間裡,Kaplan-Meier 估計式與對數等級檢定摘要並比較存活曲線,而 Cox 模型透過一個「未指定的基線危險會約掉」的偏概似估出危險比。危險比必須讀成一個「以存活為條件、在存活者之間」的率比,絕不能讀成風險比,而它的固定性要以 Schoenfeld 殘差檢查;relapse 資料帶著一個植入的比例危險違反,殘差偵測得到、而一個時變係數解決得了,還原出一個「隨追蹤而消退」的治療好處。時變共變項透過計數歷程資料進入模型,讓密集測量的資料流得以預報事件,但內生的共變項會被衰減、屬於聯合模型;而不朽時間偏誤,也就是把「保證無事件的時間」錯誤歸給一項尚未接受的暴露,會憑空製造效果,一次回傳 \(0.28\) 假危險比的虛無模擬示範了這一點。群集以共享脆弱性處理,重複以 Andersen-Gill 或 Prentice-Williams-Peterson 模型處理、依「率」還是「事件次序特定的風險」是問題而選,而競爭以累積發生函數而非一減 Kaplan-Meier 處理,病因特定危險與 Fine-Gray 危險分別回答病因學與預後的問題。縱貫存活聯合模型以共享的隨機效果把一個成長次模型與一個危險次模型連起來,交出第 6 章承諾過的非隨機遺漏退出的共享參數處理:當退出依賴症狀斜率時,一個天真的成長模型低估惡化,而聯合模型把它還原了回來。報告則圍繞著讀者無法自行驗證的那兩項決定組織:設限是怎麼處理的,以及那些效果瞄準的是哪一個估計標的。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 設限 | censoring | 事件時間只知道落在觀察窗之外(承第 24 章);第 29.1 節 |
| 無訊息設限 | noninformative censoring | 設限機制不帶關於危險的額外訊息;隨機遺漏的表親;第 29.1 節 |
| 存活函數 | survivor function | \(S(t)=P(T>t)\),到 \(t\) 為止尚未發生事件的機率;第 29.1 節 |
| 危險 | hazard | 在仍處於風險中的人裡發生事件的條件率或條件機率;第 29.1 節 |
| 風險集 | risk set | 某一瞬間仍未發生事件且仍在觀察中的那群人;第 29.1 節 |
| 個人期間檔 | person-period file | 每人每一個處於風險中的期間各一列;把存活變成羅吉斯迴歸;第 29.2 節 |
| 基線危險 | baseline hazard | 共變項在參照值時風險跨各期的形狀;第 29.2 節 |
| 互補雙對數連結 | complementary log-log link | 與底層連續時間比例危險相容的離散時間連結;第 29.2 節 |
| 偏概似 | partial likelihood | Cox 的概似,基線危險在其中約掉;第 29.3 節 |
| 危險比 | hazard ratio | 危險的比值;不是風險比 (risk ratio)(承第 15 章);第 29.3 節 |
| 不朽時間偏誤 | immortal-time bias | 把保證無事件的時間錯誤歸給尚未接受的暴露;第 29.4 節 |
| 共享脆弱性 | shared frailty | 群集內共有的、乘在危險上的潛在因子;第 29.5 節 |
| 累積發生函數 | cumulative incidence function | 把競爭事件算進去的事件累積機率;第 29.5 節 |
| 次分配危險 | subdistribution hazard | Fine-Gray 的危險,直接對映到累積發生函數;第 29.5 節 |
參考文獻
Allison, P. D. (1982). Discrete-time methods for the analysis of event histories. Sociological Methodology, 13, 61–98. https://doi.org/10.2307/270718
Andersen, P. K., & Gill, R. D. (1982). Cox’s regression model for counting processes: A large sample study. The Annals of Statistics, 10(4), 1100–1120. https://doi.org/10.1214/aos/1176345976
Austin, P. C., Lee, D. S., & Fine, J. P. (2016). Introduction to the analysis of survival data in the presence of competing risks. Circulation, 133(6), 601–609. https://doi.org/10.1161/CIRCULATIONAHA.115.017719
Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
Fine, J. P., & Gray, R. J. (1999). A proportional hazards model for the subdistribution of a competing risk. Journal of the American Statistical Association, 94(446), 496–509. https://doi.org/10.1080/01621459.1999.10474144
Grambsch, P. M., & Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515–526. https://doi.org/10.1093/biomet/81.3.515
Henderson, R., Diggle, P., & Dobson, A. (2000). Joint modelling of longitudinal measurements and event time data. Biostatistics, 1(4), 465–480. https://doi.org/10.1093/biostatistics/1.4.465
Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/EDE.0b013e3181c1ea43
Hougaard, P. (2000). Analysis of multivariate survival data. Springer. https://doi.org/10.1007/978-1-4612-1304-8
Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
Muthén, B., & Masyn, K. (2005). Discrete-time survival mixture analysis. Journal of Educational and Behavioral Statistics, 30(1), 27–58. https://doi.org/10.3102/10769986030001027
Prentice, R. L., Williams, B. J., & Peterson, A. V. (1981). On the regression analysis of multivariate failure time data. Biometrika, 68(2), 373–379. https://doi.org/10.1093/biomet/68.2.373
Rizopoulos, D. (2010). JM: An R package for the joint modelling of longitudinal and time-to-event data. Journal of Statistical Software, 35(9), 1–33. https://doi.org/10.18637/jss.v035.i09
Rizopoulos, D. (2012). Joint models for longitudinal and time-to-event data: With applications in R. Chapman & Hall/CRC.
Singer, J. D., & Willett, J. B. (1991). Modeling the days of our lives: Using survival analysis when designing and analyzing longitudinal studies of duration and the timing of events. Psychological Bulletin, 110(2), 268–290. https://doi.org/10.1037/0033-2909.110.2.268
Singer, J. D., & Willett, J. B. (1993). It’s about time: Using discrete-time survival analysis to study duration and the timing of events. Journal of Educational Statistics, 18(2), 155–195. https://doi.org/10.3102/10769986018002155
Singer, J. D., & Willett, J. B. (2003). Applied longitudinal data analysis: Modeling change and event occurrence. Oxford University Press.
Stoolmiller, M., & Snyder, J. (2006). Modeling heterogeneity in social interaction processes using multilevel survival analysis. Psychological Methods, 11(2), 164–177. https://doi.org/10.1037/1082-989X.11.2.164
Suissa, S. (2008). Immortal time bias in pharmacoepidemiology. American Journal of Epidemiology, 167(4), 492–499. https://doi.org/10.1093/aje/kwm324
Sylvestre, M.-P., Huszti, E., & Hanley, J. A. (2006). Do Oscar winners live longer than less successful peers? A reanalysis of the evidence. Annals of Internal Medicine, 145(5), 361–363. https://doi.org/10.7326/0003-4819-145-5-200609050-00009
Therneau, T. M., & Grambsch, P. M. (2000). Modeling survival data: Extending the Cox model. Springer. https://doi.org/10.1007/978-1-4757-3294-8
Willett, J. B., & Singer, J. D. (1995). It’s déjà vu all over again: Using multiple-spell discrete-time survival analysis. Journal of Educational and Behavioral Statistics, 20(1), 41–67. https://doi.org/10.3102/10769986020001041