
研究
心理科學的統計與心理計量方法學
這個研究計畫的總體目標,是強化心理科學的推論基礎。研究工作在於發展、評估並比較統計模型與心理計量方法,追問一個方法在什麼條件下能夠找回它應當找回的結構與效果,以及當其假設不成立時,實質結論會如何改變。研究發現進一步轉化為研究設計、樣本數、模型選擇與結果報告的具體建議,以及讓方法在實務上可用的軟體工具。
審查中的稿件不在此列出。本頁說明研究計畫的方向;已發表的成果請見著作。
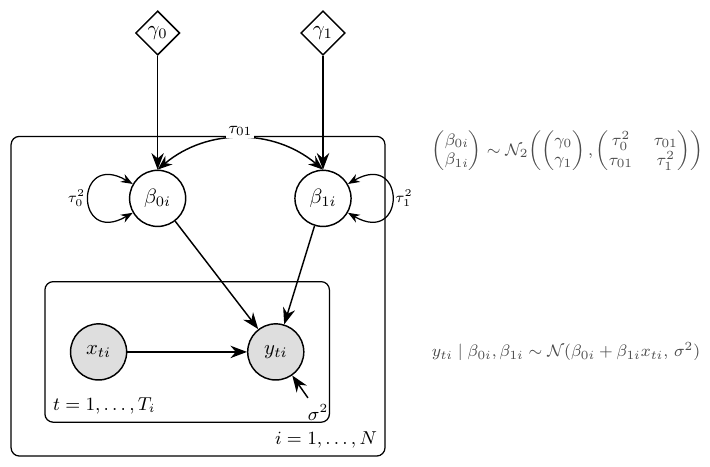
巢套與相依資料
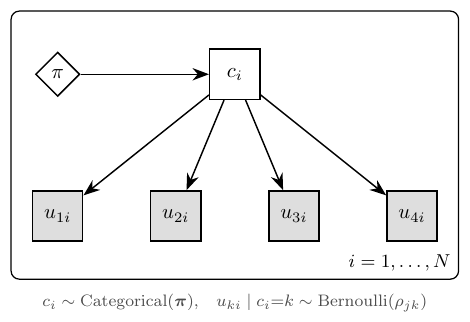
長期耕耘的主題是巢套資料的離散潛在變項模型,特別是多層次潛在類別模型與潛在轉移模型。具體貢獻包括樣本數建議、共變項的納入方式、潛在群集數與潛在類別數的同時決定,以及忽略巢套結構的後果分析。相關研究亦處理線性混合效果模型中隨機效果結構的設定、組內相關係數等相依性指標在群集結構下的穩健性,以及多層次混合模型的訊息準則。
代表著作:Park & Yu(2018,Educational and Psychological Measurement);Park & Yu(2018,Structural Equation Modeling);Yu & Park(2014,Multivariate Behavioral Research);Park, Cardwell, & Yu(2020,Methodology);Yu(2013,Behavior Research Methods)。
構念的表徵:因素與網絡
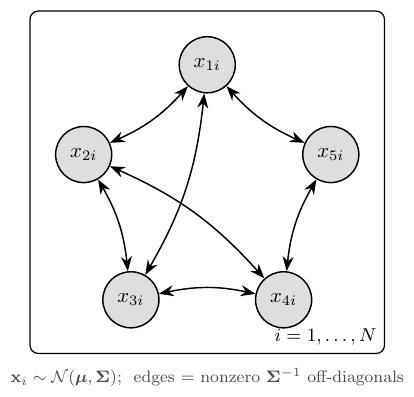
這條軸線探討潛在變項模型與心理計量網絡模型之間的關係:兩種表徵在什麼情況下可由資料區辨、當資料由共同因素生成時偏相關網絡會呈現什麼樣貌,以及網絡如何跨群體、跨層次、跨母群進行有校準的比較。目前的工作發展差異網絡功能(differential network functioning)的統一架構、讓因素結構與網絡結構在同一母群中並存的混合模型,並提出以證據而非慣例來選擇潛在變項結構形式(連續或類別、反映性或形成性、因素或網絡)的一般性論述。
國科會計畫「以潛在變項模型探索資料潛在結構的另徑:心理計量網絡分析取向」(2020 至 2022)補助。早期基礎:Anderson & Yu(2007,Psychometrika)探討對數乘積關聯模型作為試題反應模型。
個體內的動態
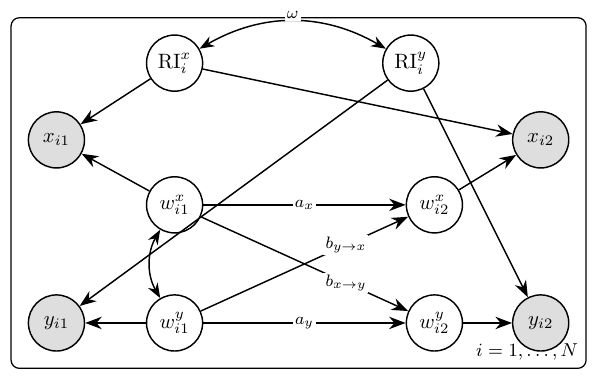
這個領域的研究追問變化如何在一個人之內展開,以及研究設計如何限制我們對它的認識。主題包括經驗取樣(EMA)等密集縱貫資料的分析、個人變化軌跡及其形狀的刻畫、跨兩種時間尺度的取樣設計,以及連續時間與離散時間模型架構的比較。另一條並行的研究線量化並評估單一受試者實驗設計中的介入效果,檢視非重疊效果量指標及推論方法在序列相依下的表現。
代表著作:Yu(in press,Psychological Methods)。國科會計畫「探討生態瞬間評估設計下資料分析的統計與方法學議題」(2025 至 2027)與「單一受試者研究設計下介入效果的量化與評量」(2022 至 2023)補助。另見教科書《變化的分析》。
證據品質、測量與整合
這條軸線關注心理學研究所產生並彙整之證據的品質。在研究整合方面,處理效果量之間的相依、已發表文獻的選擇偏誤,以及稀疏後設迴歸中調節效果推論的檢定力規劃。在測量方面,涵蓋李克式量表標示語的心理計量尺度化、量表發展與效度驗證、簡式量表的信度報告、性向測驗在國家考試的應用,以及問卷資料中無效作答與低投入作答的偵測。
國科會計畫「統合分析的統計與方法議題探討:發表偏誤和相依效果量」(2023 至 2024)與「調查研究中無效作答:影響與偵測方法研究」(2024 至 2025)補助。代表著作:Yu(2022,《調查研究:方法與應用》);Yu, Tsai, & Yu(2015,《測驗學刊》);Weng, Chen, & Yu(2019,《中華心理學刊》)。
表徵與工具
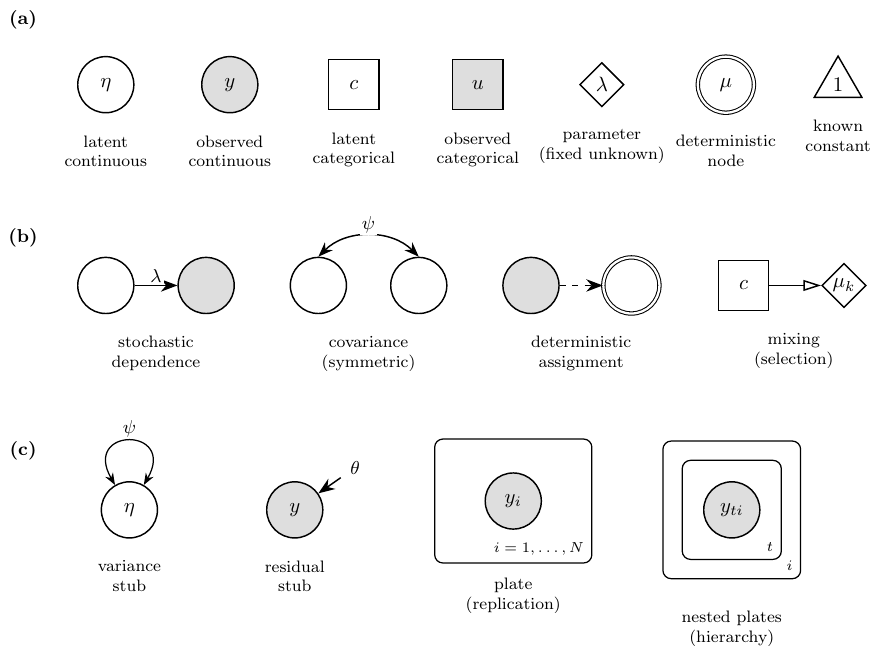
每一條軸線都仰賴一件事:能夠精確地陳述模型,並清楚地傳達它。umg 計畫發展統計模型的統一圖形語法:以一小套語意明確的節點(潛在與觀察、連續與類別)、邊(隨機相依、共變、確定性指派、混合)與 plate(複製與階層)詞彙,讓 CFA、IRT 模型、多層次模型、成長混合模型與貝氏階層模型能以同一套記號繪製,並在圖、模型語法與程式碼之間互相轉換。這套語法以 R 套件實作,支援 TikZ、ggplot2 與 DiagrammeR 輸出。本網站的模型圖皆以它繪製。
軟體:umg(R;已提交 CRAN);silentema(R;已提交 CRAN);MDLV toolbox(MATLAB;Yu, 2013)。
新興方向:生成式 AI 與心理學推論的邊界
大型語言模型正以受試者、評分者、題目撰寫者與分析者的身分進入心理學研究。近期的一條研究線追問這對學科的推論條件意味著什麼:模型生成的反應何時可以代替人類反應、測量恆等性與效度論證如何轉移、推論的邊界應在何處重新劃定(游琇婷、游廷碩,2026,《中華心理學刊》)。更早期的研究則探討多位顧問機率判斷的彙整(Budescu & Yu, 2006, 2007)。
主持之研究計畫
| 年度 | 計畫名稱 | 補助單位 |
|---|---|---|
| 2025 至 2027 | 探討生態瞬間評估設計下資料分析的統計與方法學議題 | 國科會 114-2410-H-004-174-MY2 |
| 2024 至 2025 | 調查研究中無效作答:影響與偵測方法研究 | 國科會 113-2410-H-004-184 |
| 2023 至 2024 | 統合分析的統計與方法議題探討:發表偏誤和相依效果量 | 國科會 112-2410-H-004-136 |
| 2022 至 2023 | 單一受試者研究設計下介入效果的量化與評量 | 科技部 111-2410-H-004-168 |
| 2020 至 2022 | 以潛在變項模型探索資料潛在結構的另徑:心理計量網絡分析取向 | 科技部 109-2410-H-004-075-MY2 |
| 2019 至 2020 | 多層次結構資料分析中方法學議題的綜整研究:相依性指標、樣本數、效果量及統計檢驗力 | 科技部 108-2410-H-004-100 |
| 2018 至 2019 | 多層次潛在類別模型中解釋變項的效果設定與參數估計方式之比較探討 | 科技部 107-2410-H-004-102 |
| 2017 至 2018 | 多層次潛在類別模型:樣本大小的取決及區辨力和關聯度指標的建立 | 科技部 106-2410-H-004-064 |
| 2010 至 2015 | Generalizations and Extensions of Multilevel Latent Transition Models | 加拿大 NSERC Discovery Grant |
另曾擔任多項計畫之共同主持人,主題包括情緒動態與憂鬱的經驗取樣研究、HiTOP 精神病理模型在台灣的應用、公益導向的人工智慧,以及台灣安心專線的自殺風險模型。