第 30 章
彈性曲線:GAMM、TVEM 與函數型資料取向
第 13、14 章的成長模型,要求分析者在看到資料之前就先認定變化的代數形式:線性、二次、分段或指數。認定對了,參數化成長既有效率又好解讀;認定錯了,那份不合就不是隨機的而是系統性的,而一個被硬套到它並不符合之曲線上的多項式 (polynomial),會在尾端造出一些「屬於基底 (basis)、不屬於發展本身」的特徵。本章發展的,是一套「讓資料自己說出形狀、同時把推論守住」的做法。懲罰樣條 (penalized spline) 把一條曲線寫成一組夠豐富的基底,讓它在資料要求的地方隨處彎折,再以一個擺動度懲罰 (wiggliness penalty) 管住那份自由,而懲罰的強度由資料決定、不由分析者的眼睛決定,於是配適出來的曲線帶著一條真正的信賴帶 (confidence band),而不是「假設參數形式正確」所給的虛假精確。廣義加法混合模型 (generalized additive mixed model) 把這份彈性嫁接到全書的隨機效果 (random effect) 結構上,而這個接點是深的:一個平滑就是一個隨機效果,而平滑參數 (smoothing parameter) 就是一個變異數比值,於是彈性與手上已有的混合模型思維是連續的,不是一次背離。接著本章把彈性轉到係數本身。時變效果模型 (time-varying effect model) 問的不是結果變項描出什麼形狀,而是一個預測變項的效果描出什麼形狀:一項治療的好處會不會浮現又消退,一個壓力源的箝制會不會在研究過程中習慣化 (habituation)。最後它給出函數型資料分析 (functional data analysis) 的實作導論,在那裡整條曲線就是分析的單位,對位 (registration) 把一個事件的「時間」與它的「幅度」分開,而函數型主成分 (functional principal component) 扮演的正是第 19 章成長因子的角色。全篇之中,紀律與做法同等重要:一個找到凹陷的平滑,是關於凹陷的一項假設,不是關於凹陷的一項發現,而本章要教的正是那些「讓彈性模型不至於敘述雜訊」的診斷與報告。
學習目標
讀完本章之後,你應該能夠:(1) 把懲罰樣條解釋成「一組豐富的基底加上一個擺動度懲罰」,把有效自由度 (effective degrees of freedom) 讀成「資料買到了多少形狀」,並說明受限最大概似 (restricted maximum likelihood) 如何選出平滑參數;(2) 配適把母體平滑與隨機截距 (random intercept)、隨機斜率 (random slope) 以及非參數 (nonparametric) 的逐人平滑結合起來的廣義加法混合模型,並知道 mgcv 提供的兩條路;(3) 以逐點 (pointwise) 帶與同時 (simultaneous) 帶對平滑作推論,並以差異平滑 (difference smooth) 比較組別;(4) 以循環樣條 (cyclic spline) 為週期性現象建模,並權衡它與第 23 章三角函數 (trigonometric) 做法之間的取捨;(5) 設定「係數是時間的一個平滑函數」的時變效果模型,並說出它回答了什麼參數化交互作用 (interaction) 回答不了的問題;(6) 在實作深度上理解函數型資料分析,包含對位、作為成長因子類比的函數型主成分,以及這套做法何時值得它的代價;(7) 辨認並預防彈性模型的濫用,由共曲性 (concurvity) 到「敘述一條信賴帶並不支持的擺動」。
30.1 為什麼要彈性,又為什麼要紀律
彈性曲線估計的理由,要由「參數化的那個替代方案會如何失敗」講起。當一個發展歷程真的以任何低階多項式都抓不住的方式非線性 (nonlinear) 時,配適一個多項式並不只是損失一點效率而已;它產出的是一條「形狀由基底而非由現象決定」的曲線,為了遷就一個它搆不到的中段而在兩端往上彎,並且把這些基底造出來的假象 (artifact),用它加在真實結構上的同一組信賴區間 (confidence interval) 報告出來。另一個替代方案,也就是事先把時間切成命名好的階段,早期一段、晚期一段、各給一個平均數,更糟,因為它把一個階梯函數 (step function) 強加在一個連續歷程上,還把這份強加藏進階段的定義裡。growth_gam 資料是一份模擬 (simulation) 研究,兩百五十位兒童在六到十五歲之間以不等距的年齡受測,並巢套 (nested) 在二十所學校裡,資料由一個羅吉斯 (logistic) 成長衝刺生成:學業成就在早年幾乎持平,在十歲前後陡升,然後趨於平緩,是一個「尾端平、中段陡」而二次式表徵不出來的形狀。配適到這份資料上,二次式對照已知真相的均方根誤差 (root-mean-squared error) 是 \(0.94\)、分段線性模型是 \(0.99\),而底下要發展的懲罰平滑是 \(0.17\)。教訓不是多項式永遠不對,而是它的對是一件要掙來的假設,而當理論並未把形式釘死時,一個「讓資料選形狀、並對那個選擇報告誠實不確定性」的方法,是比較安全的預設。
懲罰樣條就是那個方法,而在用它那套做法之前,值得先看它的解剖。一個平滑函數被寫成一組固定基底函數的加權和,那些基底函數 (basis function) 是散布在預測變項 (predictor) 值域上的小型局部隆起,於是任何夠豐富的基底,都能靠適當的權重逼近任何平滑形狀。以豐富的基底用最小平方 (ordinary least squares) 去配權重會把雜訊也內插 (interpolate) 進來,因此配適加上一個對擺動度的懲罰,典型是曲線二階導數 (second derivative) 平方的積分 (integral),也就是曲線彎折程度的度量 (measure)。估計式最小化的是「不合的程度」加上「懲罰乘以一個平滑參數」,而那個平滑參數就是在偏誤 (bias) 與變異數 (variance) 之間取捨的唯一一個旋鈕:它等於零時回傳那條擺動的內插曲線,趨於無限時回傳懲罰碰不到的那條直線,落在中間時回傳一條「資料撐得住多少彈性就有多少彈性」的曲線。圖 30.1 在一個模擬函數上呈現那組基底與那三種狀態。把懲罰迴歸與探索式的畫曲線分開的關鍵一步,是平滑參數由資料以受限最大概似估計出來,而不是由分析者對「曲線該有多平滑」的判斷設定。有效自由度 (effective degrees of freedom) 是平滑矩陣 (smoother matrix) 的跡 (trace),摘要的是資料買到了多少形狀:一條結果是線性的曲線花掉一個自由度,一條輕微彎曲的花掉三到四個,而圖中那個模擬函數在受限最大概似的最適點上掙到大約七個,對照基底裡可用的十九個。
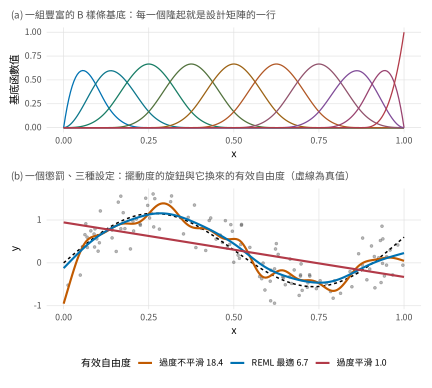
註:(a) 呈現一組豐富的 B 樣條 (B-spline) 基底;一個平滑就是這些隆起的加權和。(b) 呈現在三種平滑參數設定下對一個模擬函數(虛線)的懲罰配適。過度平滑(有效自由度為一)回傳一條錯過形狀的直線;過度不平滑(有效自由度十八)追著雜訊跑;而受限最大概似的選擇(大約七)還原了真相。平滑參數就是那個偏誤與變異數的旋鈕,而它由資料選,不由眼睛選。
這個想法的深處在於:懲罰就是一個先驗 (prior),而平滑就是一個隨機效果。把基底拆成不受懲罰的那一部分,也就是懲罰放過的那些函數,以及受懲罰的那一部分,懲罰把受罰係數往零收縮 (shrinkage),正如一個混合模型把隨機效果往它們的平均數收縮,而平滑參數結果就是「殘差變異數對那些隨機係數變異數」的比值。這不是一個類比而是一個等同:一個懲罰樣條就是一個線性混合模型,其中曲線擺動的那一部分是隨機效果,而第 13 章的受限最大概似做法選平滑參數的方式,與它選任何一個變異數成分 (variance component) 的方式相同。這個等同正是廣義加法混合模型之所以融貫的原因,因為一旦平滑是隨機效果,它就自然地與本書一路建起來的縱貫模型裡的隨機截距與隨機斜率並列而居,而整套裝置一起估。表 30.1 把本章後面用到的基底類型整理起來,而基礎方塊精確地陳述那個混合模型表徵。
表 30.1 mgcv 樣條基底類型的選用表。
基底(bs=) | 名稱 | 用於 |
|---|---|---|
"tp" / "cr" | 薄板/三次 | 一個連續預測變項(年齡、時間)的預設平滑 |
"cc" | 循環三次 | 一個會繞回來的預測變項:一天中的時刻、一年中的日子、相位 |
"fs" | 因子平滑 | 每人或每組各一條平滑、共用一個懲罰:非參數的隨機軌跡 |
"re" | 隨機效果 | 寫成平滑的隨機截距或隨機斜率(混合模型那條路) |
by= | by 變數 | 一個乘上某個共變項的平滑(變動係數),或依某個因子而不同的平滑(差異平滑) |
註:by= 引數是第 30.2 與第 30.3 節的主力:搭配一個因子,它產生逐組的分別平滑或差異平滑;搭配一個數值共變項,它產生一個變動係數 (varying coefficient),也就是一條「讓共變項的效果隨時間伸縮」的平滑。因子平滑("fs")與隨機效果("re")基底,就是隨機效果進入廣義加法混合模型的方式。
基礎概念 • 一個平滑就是一個隨機效果
把一個懲罰平滑寫成 \(f(x)=X\boldsymbol\beta\),帶擺動度懲罰 \(\lambda\,\boldsymbol\beta'S\boldsymbol\beta\)。重新參數化 (reparameterization) 使懲罰成為對角 (diagonal),並把 \(S\) 的零空間 (null space)(懲罰為零的那些函數,典型是常數項與線性項)與它的值域(受懲罰的、會擺動的那些函數)分開。受懲罰的那些係數,進入配適的方式恰恰就是共變異數為 \(\sigma^2/\lambda\) 乘上單位矩陣 (identity matrix) 的隨機效果,因此懲罰後的對數概似 (log-likelihood),等於「曲線擺動的那一部分是隨機的」那個線性混合模型的對數概似。平滑參數是一個變異數比值,\(\lambda=\sigma^2_\varepsilon/\sigma^2_b\):隨機係數的變異數小,曲線就硬;大,曲線就有彈性。因此受限最大概似選平滑參數的方式,就是第 13 章估變異數成分的方式;這正是廣義加法混合模型與線性混合模型是同一套架構的原因,也是隨機效果的收縮直覺可以直接搬到「一條曲線往平滑收縮」上的原因。
30.2 縱貫資料的廣義加法混合模型
一個廣義加法混合模型,在一個混合模型的隨機效果結構上加進預測變項的平滑,而 mgcv 提供兩條路。函式 gamm 透過它的線性混合模型表徵、借用 nlme 來配適,這條路讓相關殘差 (correlated residual) 結構可用;而 gam 搭配隨機效果基底(bs="re")或因子平滑基底(bs="fs"),以懲罰概似配適同一類模型,比較快,而且在 bam 這個變體下,能擴展到密集縱貫設計所產生的大型資料集。對 growth_gam 資料,第一順位的模型是「年齡的一個母體平滑加上學校的隨機截距」,而它還原了那個羅吉斯真相:年齡平滑的有效自由度是 \(7.4\),學校標準差是 \(1.04\)、對照真值 \(1.2\)。守住這份配適的診斷是基底維度檢查:基底大小 \(k\) 是彈性的天花板,不是彈性本身的選擇,而 mgcv 的 gam.check 會以「在平滑的尺度上檢驗殘差還有沒有剩下的型態」來回報天花板有沒有卡住。這裡的檢查回傳 \(k\) 指數 \(1.02\)、\(p\) 值不顯著,表示基底夠大,做平滑的是懲罰、不是天花板。圖 30.2 把那個平滑與那些參數化的替代方案一起對照已知真相。
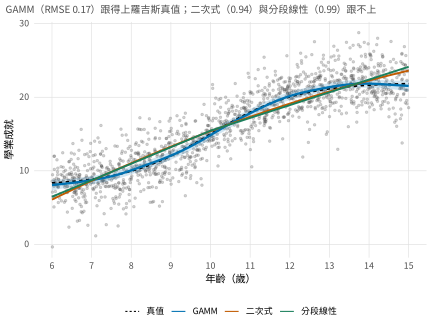
註:growth_gam 資料中學業成就隨年齡的變化。廣義加法混合模型(藍,附信賴帶)以 \(0.17\) 的均方根誤差跟上了羅吉斯真相(虛線);二次式(橘)與分段線性模型(綠)被迫在真相持平之處彎曲、在真相陡峭之處拉直,誤差分別是 \(0.94\) 與 \(0.99\)。那個平滑的信賴帶在資料稀疏的地方變寬,這份誠實是「到處都報同一個窄區間」的參數化配適給不出來的。
有少數幾個實務設定決定一個廣義加法混合模型會不會乖,表 30.2 把它們連同理由一起收齊。反覆出現的原則是:基底大小是一個要慷慨設定並加以檢查、而不是要調校的天花板;受限最大概似是最不容易過度配適的平滑參數選法;而項目選擇 (term selection) 可以打開,好讓一個平滑在某個預測變項完全掙不到形狀時收縮到零。
表 30.2 在 mgcv 中配適廣義加法混合模型的實務設定。
| 設定 | 建議 | 理由 |
|---|---|---|
基底大小 k | 慷慨設定;若 gam.check 示警就調高 | 它是彈性的天花板,不是彈性本身;做平滑的是懲罰 |
method="REML" | 平滑參數選法的預設 | 比廣義交叉驗證 (generalized cross-validation) 更不容易過度配適;穩定 |
select=TRUE | 某個平滑可能是空的時候使用 | 對零空間也加上懲罰,讓一個項可以收縮到恰好為零 |
bs="fs" / bs="re" | 逐人平滑/隨機效果 | 混合模型的那些項;一個共用的懲罰正則化 (regularization) 所有逐人曲線 |
bam(discrete= TRUE) | 大型(生態瞬時評估規模)資料 | 比 gam/gamm 快上與輕上好幾個數量級 |
gam.check / k.check | 永遠要跑、也要報告 | 偵測「卡住的基底天花板」,那會靜默地過度平滑 |
註:這些設定編碼的是同一套主張:把基底做得夠大,好讓天花板不會卡住;讓受限最大概似去選彈性;以基底維度檢查驗證那個選擇;資料大的時候伸手拿 bam。項目選擇(select=TRUE)是彈性模型版的變項選擇 (variable selection),讓一個平滑可以消失,而不是配出一個假的形狀。
母體平滑 (population smooth) 抓的是平均軌跡,但縱貫的問題通常是關於異質性 (heterogeneity) 的,而因子平滑基底提供了第 14 章隨機斜率的非參數對應物。一個「年齡的母體平滑加上年齡依兒童的因子平滑」的模型,給每個孩子一條自己的平滑軌跡,而全部共用單一個平滑參數,於是個別曲線是由母體、也由彼此借力,而不是把每個孩子那少少幾筆觀察配到過度配適。圖 30.3 呈現四十位兒童的那面畫廊:每一條細線是一個人的非參數軌跡,在紅色的母體平滑周圍擺動,擺多少由那個共用的懲罰允許多少決定。這是隨機斜率成長模型的彈性手足,適用於「理論並未指定個體變化的函數形式」、且「每個人的資料太少而估不出一條自由曲線」的時候。第 14 章關於殘差自我相關 (autocorrelation) 的告誡原封不動地移植過來:來自一個平滑的個體內殘差通常是相關的,而如果那份相關本身有意思,可以透過 gamm 以自我迴歸 (autoregressive) 結構為它建模;但那個混淆 (confounding) 的警告仍然成立,因為一個時間的彈性平滑與一個自我迴歸的殘差,會競相解釋同一份個體內依賴,而讓兩者都自由浮動而不加檢視,可能在實務上讓模型不可識別 (unidentified)。
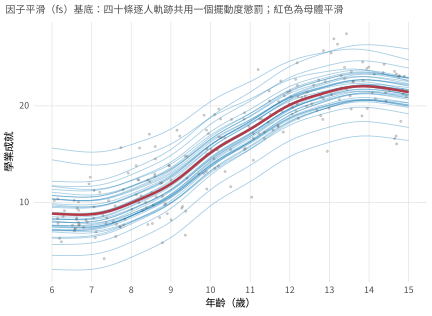
註:來自因子平滑("fs")基底的四十位兒童個別平滑軌跡(細線),紅色為母體平滑,灰色為原始觀察值。每個人的曲線都是非參數的,但與其他所有人共用一個平滑參數,於是個別軌跡是被往母體形狀正則化,而不是被自由配適。這是第 14 章隨機斜率成長模型的彈性對應物,用於「個體變化不假設任何函數形式」的時候。
組別的比較,正是彈性曲線交出一個「參數化模型難以表達的估計標的 (estimand)」的地方:不是兩組平均而言有沒有差,而是它們在時間上的何處有差。差異平滑為每一組配一條分別的曲線,並把它們的差估計成預測變項的一個函數,而它的推論必須把「這個差是一整條曲線、不是單一個數字」這件事算進去。一條逐點信賴帶,也就是每個時點上的估計值加減大約兩個標準誤 (standard error),在任何單一時點上都有正確的涵蓋率 (coverage),但它低估了「整條曲線作為一個整體」的不確定性,因為一條在許多時點中的每一個都待在自己逐點帶之內的曲線,依那條帶自己的邏輯來看是不太可能的。同時信賴帶 (simultaneous confidence band) 修正這一點:它把區間加寬到「一次整條曲線的偏離」所需要的那個乘數,做法是由係數的後驗 (posterior) 抽樣,並取「整條曲線上最大標準化偏離」的分配。對 tvem_rct 資料,一份「治療效果被做成會浮現、然後部分消退」的兩組試驗,同時帶用的乘數 (multiplier) 大約是 \(2.5\)、而不是逐點的 \(1.96\),而兩組之間的差異在同時的意義下,於第六到第二十週之間顯著。圖 30.4 呈現那條差異平滑連同兩種帶與那個顯著區間,而基礎方塊勾勒它的構造。
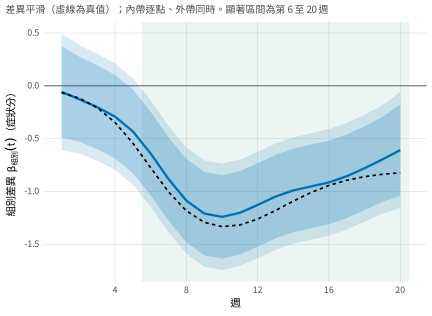
註:tvem_rct 資料中組別差異作為週的函數,已知真相為虛線。內側的帶是逐點的(乘數 \(1.96\));外側的帶是同時的(乘數大約 \(2.5\)),那才是「在整條曲線上何處兩組有差」這個問題的正確帶。差異在同時的意義下於陰影區間內顯著,也就是第六到第二十週。這個估計標的,也就是一個組別差異的位置與時機,是單一個對比表達不出來的。
基礎概念 • 以後驗模擬建構同時帶
令 \(\hat{f}(t)=X_t\hat{\boldsymbol\beta}\) 是一條配適出來的曲線,係數共變異數為 \(V_\beta\),於是逐點標準誤是 \(s(t)=\sqrt{X_t V_\beta X_t'}\)。一條逐點帶是 \(\hat{f}(t)\pm 1.96\,s(t)\),在每一個 \(t\) 上正確,但對整條曲線並不正確。要建一條在整條曲線上同時正確 (valid) 的帶,就由後驗 \(N(\hat{\boldsymbol\beta}, V_\beta)\) 抽出許多個係數向量 \(\boldsymbol\beta^{(m)}\),構成標準化偏離曲線 \(|X_t(\boldsymbol\beta^{(m)}-\hat{\boldsymbol\beta})|/s(t)\),並記下它在 \(t\) 上的最大值。這些最大值的 \((1-\alpha)\) 分位數就是乘數 \(c\);同時帶是 \(\hat{f}(t)\pm c\,s(t)\)。因為 \(c\) 大於 \(1.96\),同時帶比較寬,而它才是「這條曲線在哪一段區間裡不等於零」這個問題的誠實答案,也正是一條差異平滑或一個時變係數通常被問到的問題。
週期性現象是本節縱貫應用的最後一項,也是與第 23 章的接觸點。一個日內節律 (diurnal rhythm),例如一種在午間下沉、到傍晚又回升的心情,是週期的,而一個循環樣條強制「配適曲線與它的斜率在週期的兩端相合」,於是節律接得平順,不會由最後一小時跳到第一小時。diurnal_ema 資料帶著這樣一個節律,而圖 30.5 以兩種方式配適它:一個循環樣條,花掉大約五個有效自由度、貼著那道弧走;以及第 23 章那一對三角函數,也就是日頻率上的一個正弦與一個餘弦,恰好花掉兩個,抓到了大致的形狀但彎不到那道弧的細部。取捨就是本章反覆出現的那一個。三角函數對是參數化的、可以解讀成一個振幅 (amplitude) 與一個相位 (phase),而且在節律接近正弦時有效率;循環樣條有彈性、忠於偏離純正弦之處,而在節律本身的形狀就是待答問題時是比較安全的選擇。兩者都不佔絕對優勢,而這個決定屬於「循環的形狀」還是「振幅的一個摘要」才是科學標的。
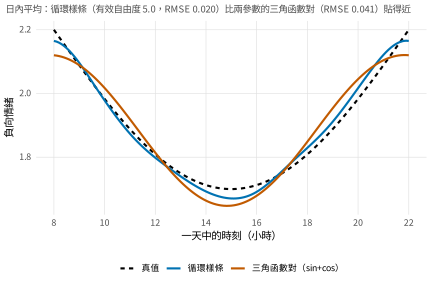
註:diurnal_ema 資料中負向情緒的母體日內平均(虛線為真相)。循環樣條(藍,大約五個有效自由度)忠實地跟著那道弧,均方根誤差為 \(0.020\);那一對三角函數(橘,兩個參數)抓到了大致的節律,但被限制在一個純正弦上,均方根誤差為 \(0.041\),是循環樣條的兩倍,端點上的誤差也由 \(0.035\) 拉大到 \(0.080\),而那道弧的整體振幅只有 \(0.50\)。循環樣條以彈性買到忠實度;三角函數對以剛性買到可解讀性。
軟體提示 • 兩條路,以及擴展到密集資料
mgcv 兩條路之間的選擇是實務性的。gamm 透過 nlme 配適,讓 corAR1 這類相關殘差結構得以使用,代價是速度,以及在隨機效果結構與相關結構都很豐富時偶爾出現的收斂 (convergence) 麻煩。gam 搭配 bs="re" 與 bs="fs" 以懲罰概似配適同一批模型,比較快,而且對那些平滑回傳比較乾淨的不確定性,但它只透過平滑與隨機效果本身處理相關。對生態瞬時評估 (ecological momentary assessment) 那種數以萬列計的大型資料集,bam 搭配 discrete=TRUE 與 method="fREML",把記憶體 (memory) 與時間降低好幾個數量級,是實務上的預設;本章分析裡的逐人模型與習慣化模型用的正是它。gratia 與 itsadug 這兩個視覺化套件,讓「由配適好的 mgcv 物件繪圖與抽取差異平滑」變得簡便;在它們不可得的地方,同樣的呈現可以靠「在一個網格 (grid) 上作預測並取得標準誤、再直接模擬同時帶」建出來,本章的配套腳本走的正是這條路。
30.3 時變效果模型
到目前為止的模型,讓一個結果變項的形狀變得有彈性。一個時變效果模型讓一個係數的形狀變得有彈性,而問題的這一次轉移是真的。它問的不是一個結果變項如何隨時間變化,而是一個預測變項的效果如何隨時間變化:壓力與負向情緒之間的關聯 (association) 在青春期是加強還是減弱,渴求對復發的箝制在一次戒除嘗試中是否鬆開,一項治療的好處是否逐漸浮現然後淡去。它的設定就是 Hastie and Tibshirani (1993) 的變動係數模型:一個預測變項上的係數,本身是時間的一個平滑函數,\(y = \cdots + \beta(t)\,x + \cdots\),其中 \(\beta(t)\) 是一個懲罰樣條。在 mgcv 裡變動係數寫成 s(time, by = x),也就是一個時間的平滑乘上共變項 \(x\),而承自 Methodology Center 一脈的專用套件 tvem 把同一個想法包起來,並為密集縱貫資料加上便利設施。輸出的讀法是一條曲線、不是一個係數,而它的帶就是上一節那條同時帶,因為問題再一次是關於一整條曲線的。
本章的招牌圖還原了兩種不同的時變效果。在 tvem_rct 資料中,治療效果 \(\beta_{\text{arm}}(t)\) 被做成在起點附近接近零,在第六週前後浮現,在第十週附近到達約 \(1.3\) 個症狀分的削減高峰,並在第二十週之前部分消退;變動係數模型以 \(0.10\) 的均方根誤差還原了這條曲線,把浮現放在第六週、把高峰放在第十週,兩者都恰好落在真相上。在 diurnal_ema 資料中,連結當下壓力與當下負向情緒的個體內係數被做成會習慣化,由研究第一天的大約 \(0.65\) 平順地下降到第十四天的大約 \(0.30\),因為那個人適應了監測、也適應了那些壓力源;模型幾乎分毫不差地還原了那份下降,由 \(0.65\) 到 \(0.29\)。圖 30.6 呈現兩者。這兩格讓這個想法的普遍性變得具體:一個係數可以沿著一項治療的時間軸 (time axis) 變動,也可以沿著一份研究的時間軸變動,而在每一種情形裡,交付物都是一條帶著信賴帶的曲線,說出效果何時在場、以及它如何移動。
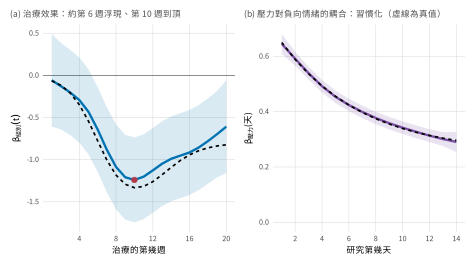
註:(a):tvem_rct 資料中的治療效果 \(\beta_{\text{arm}}(t)\)(藍,附同時帶;虛線為真相)在第六週附近浮現、第十週附近到頂(圓點),然後消退,這是一條單一個危險比或平均對比表達不出來的軌跡。(b):diurnal_ema 資料中個體內的「壓力對負向情緒」係數 \(\beta_{\text{stress}}(\text{day})\)(紫;虛線為真相)在研究過程中習慣化,由大約 \(0.65\) 下降到 \(0.30\)。兩者的估計標的,都是一個效果隨時間的形狀。
讓時變效果模型不至於被過度推銷的那個區分是:一個與時間的參數化交互作用,是時變效果的一個特例 (special case),不是它的等價物。放進一個 \(x\) 乘時間的乘積項 (product term),讓 \(x\) 的效果隨時間線性變化,那是一個被約束在直線上的時變效果;變動係數模型鬆開那道約束,讓效果取任何資料撐得住的平滑形狀,於是它找得到一個「浮現又消退」的效果,而那是任何單一個乘積項都做不到的。這個蘊含是有方向的:每當一個與時間的線性交互作用被配適,一個時變效果模型就把它巢套在內、並檢驗那份線性是否成立;而一個結果是直的時變效果,只不過是把那個交互作用重現一次,外加關於它自身線性的誠實不確定性。表 30.3 把這個方法放在它的鄰居之間。本節誠實標示出來的前沿 (frontier),是多層次的時變效果模型,也就是時變係數本身跨人變動,\(\beta_i(t)\);做法是有的,靠的是把因子平滑與 by 變數結合起來,但估計很細緻、文獻 (literature) 也還在沉澱,因此關於逐人時變效果的主張應該謹慎提出,並對照當前的方法學工作查核。
表 30.3 四種彈性曲線架構各自回答什麼。
| 架構 | 單位與問題 | 何時選它 |
|---|---|---|
| 參數化成長(第 14、19 章) | 結果變項的一條命名曲線;它的參數 | 理論把函數形式釘死了;可解讀性最要緊 |
| GAMM(本章) | 結果變項的一條彈性曲線;它的形狀 | 形狀未知或非標準;需要誠實的信賴帶 |
| TVEM(本章) | 一個係數的一條彈性曲線;一個預測變項何時要緊 | 一個預測變項的效果可能隨時間改變 |
| FDA(本章) | 整條曲線就是資料點;曲線變異的模態 | 每個單位都有密集曲線;標的是對位或曲線層次的推論 |
註:這些架構是依「什麼扮演分析單位的角色」排列的:一個參數、一條結果曲線、一條係數曲線,或一整個函數。一個與時間的參數化交互作用,是時變效果模型受約束的一個特例;函數型主成分是成長因子的函數型對應物(表 30.4)。這個選擇是由科學標的驅動的,不是由哪一個配適得比較好驅動的。
常見陷阱 • 把一個彈性模型讀得太急
一個落在帶之內的擺動不是一項發現。一個在第六週往下凹的平滑,並沒有在第六週建立起一個現象,除非那條帶在那裡排除了「沒有凹陷」的曲線;只敘述同時帶支持得住的特徵。基底太小會靜默地過度平滑。如果 \(k\) 被設在低於形狀的複雜度,懲罰就救不回來,而那份不合在沒有 gam.check 的情況下是看不見的;把 \(k\) 當成一個天花板,並檢查它沒有卡住。一個時變效果不是被某個測量到的變項調節。\(\beta(t)\) 說的是效果隨時間改變,不是時間造成了那個改變;一個隨時間一起移動的第三變項可以同時驅動兩者。一個時間的平滑與一個自我迴歸的殘差並置,會把個體內依賴算兩次。要決定哪一個結構承載那份依賴,並加以檢視、而不是逕自假設兩者沒有在競爭。
30.4 函數型資料分析:一份實作導論
函數型資料分析做了一個把一切重新框架的概念動作:資料點不是一個純量或一個向量,而是一整條曲線 \(y_i(t)\),一個人一個函數。一份日內心情的研究產出的不是一張提示的表格,而是一份「每日心情曲線」的樣本;一份動作的研究產出的是一份軌跡的樣本;一份生理的研究產出的是一份訊號的樣本。有兩條路可以進到曲線裡。先平滑的那條路把每一條曲線表徵在一組基底上,並把平滑後的函數當成分析的對象,那是古典的函數型資料立場;模型本位的那條路,也就是第 30.2 節的廣義加法混合模型,以平滑與隨機效果為逐點的資料建模,達到許多相同的目的。兩者一致的程度,足以讓一位工作中的研究者把廣義加法混合模型當成多數縱貫問題的足夠工具,而把完整的函數型裝置留給「它那些獨有的工具真的需要」的時候。第一件這樣的工具就是對位。
對位面對的是一個逐點方法看不見的問題。當一批曲線共有一個形狀、卻在那個形狀之特徵的時間上有所不同,例如一個高峰對某些單位來說來得早、對另一些來說來得晚,逐點的平均就會把那個高峰糊成一個又低又寬的隆起,像不出任何一條個別曲線的樣子,因為在每一個時點上它平均的是「處在共有軌跡不同位置上」的那些單位。這個區分是在振幅變異 (amplitude variation),也就是一個特徵高度上的差異,與相位變異 (phase variation),也就是它時間上的差異,兩者之間,而把它們分開就是對位的工作 (Marron et al., 2015)。圖 30.7 在一束「共有一個高度不一、位置也不一之單峰」的曲線上示範它。左邊那條紅色的未對位平均是糊掉而且偏低的;地標對位 (landmark registration) 把每條曲線的時間軸扭到讓它的高峰落在共同位置上,把高峰時間的標準差由 \(0.095\) 壓到 \(0.010\),並還原出一條紅色的平均,重新取回每一條個別曲線都擁有的那個銳利高峰。對位後的曲線與那些扭曲函數 (warping function) 接著成為分開的分析對象:對齊後的曲線承載振幅變異,而那些扭曲承載相位變異,各自都可以獨立分析。在事件的時間本身就是實質問題的地方,例如生理反應的對齊或一個發展序列的節奏 (tempo),對位是不可或缺的,而再多的逐點平滑都替代不了它。
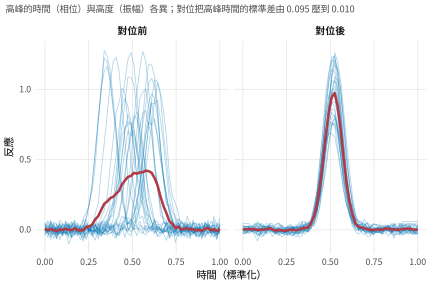
註:共有一個高度不一(振幅)、時間也不一(相位)之高峰的曲線。左:未對位,逐點平均(紅)被糊成一個「不符合任何個別曲線」的低隆起。右:以地標對位到共同的高峰位置之後,高峰時間的標準差由 \(0.095\) 落到 \(0.010\),而平均(紅)取回了那個銳利的高峰。在對位之前先平均,恰恰摧毀了這些曲線共有的那個特徵;逐點的方法看不見對位所移除的那份相位變異。
第二件獨有的工具是函數型主成分分析,而它是第 19 章成長因子的函數型對應物。一個成長模型以少數幾個潛在因子摘要每個人的軌跡,一個截距與一個斜率,它們是帶著逐人權重的共同形狀;函數型主成分分析以少數幾個函數型主成分 (functional principal component) 摘要每個人的曲線,那些是由實徵估計出來的共同形狀,也就是變異的模態 (mode of variation),帶著逐人的分數。那些模態是曲線共變異數的特徵函數 (eigenfunction),依它們解釋的變異數 (variance explained) 排序,而那些分數是每個人在它們上面的負荷量 (loading),是平均為零的特徵,可以像任何一個個人層次變項那樣被分析。應用到 diurnal_ema 資料的日內剖面 (profile) 上,那份資料是由三個植入的模態生成的,分析乾淨地還原了它們:領頭的成分解釋了百分之六十八的個體間變異數、對照植入的百分之六十五,是一個水準位移,一條幾乎持平的特徵函數,把一整天往上或往下抬;第二個,百分之二十對照百分之二十五,是一個由早到晚的傾斜;第三個,百分之九對照百分之十一,是一個「加深或填平午間凹陷」的午間曲度。還原出來的逐人分數與真正植入的分數相關達 \(0.999\)、\(0.995\) 與 \(0.986\)。圖 30.8 把那些模態呈現成對平均的擾動、把那些分數呈現成逐人的特徵,而表 30.4 把與成長因子的對應關係說明白。那些分數接著可以用在成長因子能用的每一個地方:當成迴歸在共變項上的結果變項、當成後續事件的預測變項,或當成一個兩階段分析裡的個人層次摘要;而函數對純量的迴歸 (function-on-scalar regression) 則把這個想法推廣成「直接把整條曲線迴歸在共變項上」。
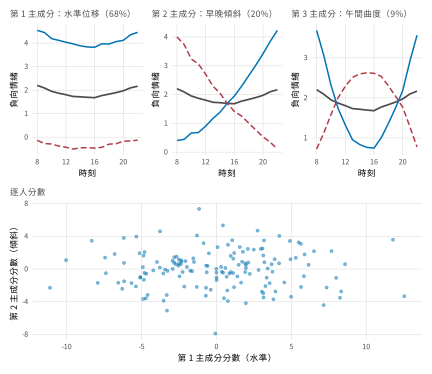
註:上排把 diurnal_ema 剖面領頭的三個函數型主成分呈現成對平均曲線(灰)的擾動:加上(藍)與減去(紅虛線)每一個模態。第一個(個體間變異數的百分之六十八)是一個水準位移,第二個(百分之二十)是一個由早到晚的傾斜,第三個(百分之九)是一個午間曲度。下格畫出逐人在前兩個模態上的分數,那是平均為零、可以像成長因子那樣使用的特徵。還原出來的分數與植入的真相相關都在 \(0.98\) 以上。
表 30.4 成長因子與函數型主成分。
| 成長模型(第 19 章) | 函數型主成分分析 | 共有的想法 |
|---|---|---|
| 固定的基底(截距、斜率、二次項) | 估計出來的特徵函數(變異的模態) | 共同的形狀 |
| 因子負荷量(固定) | 特徵函數在 \(t\) 上的值 | 一個形狀如何對映到時間上 |
| 因子分數(隨機,逐人) | 成分分數(逐人) | 逐人的權重 |
| 因子變異數 | 特徵值 | 每個形狀解釋的變異數 |
| 模型強加的形狀 | 資料驅動的形狀 | 參數化對實徵 |
註:函數型主成分分析就是成長因子的思維,只是那些形狀由資料估計出來、而不是由模型強加。那些分數是因子分數的函數型對應物,用法也完全相同:當成結果變項、預測變項或個人層次摘要。資料驅動的形狀所付的代價,是它們是描述性 (descriptive) 的變異模態、不是理論上命名好的因子,需要被解讀。
那麼,相對於「用熟悉的工具回答同一個實質問題」的廣義加法混合模型,函數型那一套做法何時值得它的代價?函數型裝置在以下情形付得起:資料是密集函數型的,每個單位有許多次測量、描出一條真正的曲線,例如生理 (physiology)、加速度計 (accelerometry)、眼動 (eye-tracking) 或滑鼠軌跡 (mouse-tracking);需要對位,因為特徵的時間跨單位變動而且那份變動本身就有意思;以及推論是關於整條曲線的,關於它們變異的模態或它們在共變項上的迴歸,而不是關於一條母體平均軌跡。它在以下情形付不起,而廣義加法混合模型就夠了:每個單位的資料稀疏 (sparse)、問題是關於一條平均軌跡或一個組別差異,以及特徵的時間由設計釘死。稀疏的情形值得對一個常見的誤解 (misconception) 加上一句告誡:函數型主成分分析並不需要密集而等距 (equally spaced) 的網格,因為 Yao et al. (2005) 的稀疏資料方法,是由不規則觀察的匯集共變異數估出那些模態的,這讓這套做法連生態瞬時評估那種參差 (ragged) 的取樣都用得上。
30.5 預防彈性的濫用
彈性模型以幾種特有的方式失敗,而使用它們的紀律,大體上就是預先擋住那些失敗的紀律。第一種是共曲性 (concurvity),也就是平滑世界的共線性 (collinearity):當兩個以分別平滑放進去的預測變項近乎函數相依,也就是其中一個近乎是另一個的平滑函數時,它們的平滑就聯合地不可識別,會盪向那些「合起來同樣配適得好、分開來卻毫無意義」的大而互相抵銷的形狀。圖 30.9a 呈現這項病理 (pathology),兩個近乎相依之預測變項的平滑盪向不同的形狀,其中一條的信賴帶比它自己的幅度還寬;mgcv 的 concurvity 函式會示警,對這一對回傳一個接近它的最大值一的最差情形指數。補救的不是一個更好的懲罰而是一個更好的模型:丟掉多餘預測變項的其中一個,或把它們合起來,因為再多的平滑都救不回一個資料裡本來就沒有的區分。第二種失敗是敘述雜訊。一個被配適得夠激進的平滑,在一個小的或吵的樣本上會造出結構,而危險不在那個擺動本身,而在關於它所講的故事。圖 30.9b 把一條過度不平滑的曲線配到一份完全沒有訊號的資料上,一個持平的真相,而那份配適樂於產出那些凹陷與隆起,配上一條逐點帶;紀律就是去要求一條同時帶,因為在這份純雜訊上,最大的標準化偏離只有 \(2.18\),遠低於一條同時帶所需的乘數,於是那些擺動一個也站不住,而逐點帶所邀請的那個敘事應該被拒絕。
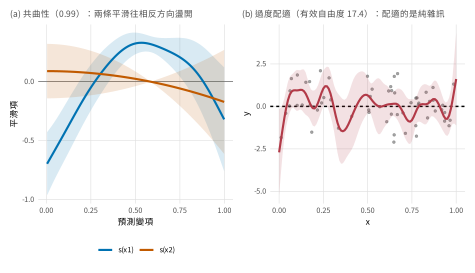
註:(a):共曲性。兩個近乎函數相依之預測變項的平滑(最差情形指數 \(0.99\))盪向不同的形狀,而 \(s(x_2)\) 的信賴帶比它整條曲線的幅度還寬,分開來看它們沒有意義;解方是丟掉或合併一個預測變項,不是平滑得更用力。(b):過度配適。一條配到純雜訊上(真相持平,虛線)的過度不平滑曲線,造出一些凹陷與高峰;本圖畫的是逐點帶(英文版與中文版的分析都只算到逐點帶),而最大的標準化偏離只有 \(2.18\),達不到一條同時帶所要求的乘數,因此那些擺動不該被敘述。
其餘的濫用,是一份報告標準管得住的衛生 (hygiene) 問題。外推 (extrapolation) 到資料範圍之外,對一個平滑而言就跟對一個多項式一樣沒有支撐,而且更為陰險,因為一個懲罰平滑在資料之外會退回它未受懲罰的零空間行為,典型是線性的,而且在那裡看起來會有騙人的自信。基底維度診斷 (diagnostic) 必須跑、也必須報告,因為一個過小的基底會毫無預警地過度平滑。平滑參數的選法應該說明,因為廣義交叉驗證與受限最大概似可以不同,而受限最大概似比較不容易過度配適,也是當前的預設建議。而「什麼被固定、什麼由資料選」的區分必須保留下來,一個彈性模型才可能被預先註冊 (preregistration):一份預先註冊可以固定基底類型、最大基底大小、平滑參數的方法與推論用的帶,只把形狀本身留給資料,而那正是「讓懲罰迴歸成為驗證性而非探索性」的那份分工。表 30.5 把報告的要素收齊,而實作方塊處理「在密集設計如今所達的規模上套用這些模型」的計算現實。
表 30.5 彈性曲線模型的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 基底與大小 | 每個平滑的基底類型與最大基底大小 \(k\);報的是天花板,不是實現出來的彈性 |
| 有效自由度 | 每個平滑估出來的有效自由度(掙到的形狀) |
| 平滑方法 | 受限最大概似(首選)或廣義交叉驗證 |
| 基底檢查 | 每個平滑的 gam.check \(k\) 指數與它的判定 |
| 信賴帶 | 逐點或同時,以及同時帶是怎麼建的 |
| 隨機結構 | 隨機效果、因子平滑,以及任何殘差相關模型 |
| 固定對選出 | 分析事前固定了什麼、又讓資料決定了什麼 |
註:分開報告最大基底大小與實現出來的有效自由度,是彈性模型版的「報告模型與它的配適」;前者是分析者設下的天花板,後者是資料買到的形狀。把事前固定的(基底、大小、平滑方法、帶的型別)與資料選出的(形狀)陳述清楚,正是一份懲罰樣條分析得以被預先註冊的原因。
實務要點 • 密集資料規模下的彈性模型
生態瞬時評估產出的是數萬到數十萬列的資料集,而天真的 gamm 配適會把記憶體或時間耗盡。bam 函式搭配 discrete=TRUE 把共變項值分箱 (binning),並利用那份結構在幾秒內配完 gam 要花幾分鐘到幾小時才配得完的模型,而 method="fREML" 是穩定的預設;本章分析裡的逐人模型與習慣化模型用的正是這一套。當需要跨數千人的因子平滑時,共用的平滑參數讓參數個數維持可管理,但記憶體仍然隨人數成長,而在跑完整版之前先抽樣一部分人作探索性配適是審慎的。gamm 與「gam 加隨機效果基底」之間的選擇,一部分是收斂的問題:懲罰概似那條路(gam、bam)在隨機結構豐富時比較穩健,而 gamm 是「必須為一個特定殘差相關結構建模」時的那條路。
本章摘要
彈性曲線方法讓資料決定變化的形狀、同時把推論守住,而它們與全書的混合模型思維是連續的,不是一次背離。一個懲罰樣條把一條曲線寫成基底函數的加權和,並以一個擺動度懲罰管住配適,而懲罰的強度,也就是平滑參數,是一個由資料以受限最大概似選出的偏誤與變異數旋鈕;有效自由度報告的是資料掙到了多少形狀。深處的事實是:一個平滑就是一個隨機效果,而平滑參數是一個變異數比值,因此廣義加法混合模型在一個架構裡同時估平滑與隨機效果。在 growth_gam 資料上,一個懲罰平滑還原了一個二次式與一個分段線性模型都錯得很離譜的羅吉斯成長衝刺;因子平滑給每個孩子一條被往母體正則化的非參數軌跡;而一條帶著同時帶的差異平滑,定位出兩組在何處分開,也就是第六到第二十週,那是單一個對比表達不出來的估計標的。循環樣條以彈性為節律建模,第 23 章的三角函數對則以參數化為它建模,而選擇取決於形狀還是循環的一個摘要才是標的。時變效果模型讓一個係數成為時間的平滑函數,回答一個預測變項何時要緊:在 tvem_rct 資料上,治療效果被還原成一條在第六週附近浮現、第十週附近到頂的曲線;在 diurnal_ema 資料上,壓力對情緒的耦合被還原成一條由大約 \(0.65\) 到 \(0.30\) 的習慣化下降;而一個與時間的參數化交互作用,是這些模型巢套在內並加以檢驗的直線特例。函數型資料分析把整條曲線當成資料點:對位把振幅與相位分開,救回一個逐點平均所摧毀的平均;而函數型主成分是成長因子的實徵 (empirical) 對應物,把日內剖面的水準、傾斜與午間曲度模態還原出來,分數與真相的相關在 \(0.98\) 以上。函數型那一套做法在密集曲線、需要對位、以及曲線層次的推論上值得它的代價;其餘情形廣義加法混合模型就夠了。那些濫用是特有而且可預防的:共曲性讓近乎相依的平滑不可識別,激進的平滑敘述出一條同時帶會否證的雜訊,外推沒有支撐;而「報告基底、有效自由度、平滑方法、基底檢查與信賴帶,並區分事前固定與資料選出」的那份紀律,正是讓一個彈性模型成為驗證性、而不是「一張在雜訊裡看見形狀的許可證」的原因。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 懲罰樣條 | penalized spline | 一組豐富基底加上一個擺動度懲罰;第 30.1 節 |
| 擺動度懲罰 | wiggliness penalty | 對曲線彎折程度的懲罰,典型為二階導數平方的積分;第 30.1 節 |
| 平滑參數 | smoothing parameter | 偏誤與變異數的旋鈕;等於一個變異數比值;第 30.1 節 |
| 有效自由度 | effective degrees of freedom | 平滑矩陣的跡;資料買到的形狀量;第 30.1 節 |
| 廣義加法混合模型 | generalized additive mixed model | 平滑加上隨機效果的同一套架構(承第 13、14 章);第 30.2 節 |
| 因子平滑 | factor-smooth | 每人一條、共用一個懲罰的非參數軌跡;第 30.2 節 |
| 差異平滑 | difference smooth | 把兩組的差估成一條曲線;第 30.2 節 |
| 同時信賴帶 | simultaneous confidence band | 對整條曲線而非單一時點正確的帶;第 30.2 節 |
| 循環樣條 | cyclic spline | 兩端的值與斜率相合的平滑,用於週期現象;第 30.2 節 |
| 時變效果模型 | time-varying effect model | 係數本身是時間的平滑函數;第 30.3 節 |
| 變動係數 | varying coefficient | s(time, by = x):一個乘上共變項的時間平滑;第 30.3 節 |
| 對位 | registration | 扭曲時間軸以對齊特徵,把相位與振幅分開;第 30.4 節 |
| 振幅變異/相位變異 | amplitude/phase variation | 特徵高度上的差異/特徵時間上的差異;第 30.4 節 |
| 函數型主成分 | functional principal component | 曲線共變異數的特徵函數;成長因子的實徵對應物;第 30.4 節 |
| 共曲性 | concurvity | 平滑世界的共線性:兩個平滑聯合地不可識別;第 30.5 節 |
參考文獻
Bringmann, L. F., Hamaker, E. L., Vigo, D. E., Aubert, A., Borsboom, D., & Tuerlinckx, F. (2017). Changing dynamics: Time-varying autoregressive models using generalized additive modeling. Psychological Methods, 22(3), 409–425. https://doi.org/10.1037/met0000085
Dziak, J. J., Li, R., Tan, X., Shiffman, S., & Shiyko, M. P. (2015). Modeling intensive longitudinal data with mixtures of nonparametric trajectories and time-varying effects. Psychological Methods, 20(4), 444–469. https://doi.org/10.1037/met0000048
Eilers, P. H. C., & Marx, B. D. (1996). Flexible smoothing with B-splines and penalties. Statistical Science, 11(2), 89–121. https://doi.org/10.1214/ss/1038425655
Goldsmith, J., Scheipl, F., Huang, L., Wrobel, J., Gellar, J., Harezlak, J., McLean, M. W., Swihart, B., Xiao, L., Crainiceanu, C., & Reiss, P. T. (2024). refund: Regression with functional data (R package version 0.1-40) [Computer software]. https://CRAN.R-project.org/package=refund
Hastie, T., & Tibshirani, R. (1993). Varying-coefficient models. Journal of the Royal Statistical Society: Series B (Methodological), 55(4), 757–796. https://doi.org/10.1111/j.2517-6161.1993.tb01939.x
Marron, J. S., Ramsay, J. O., Sangalli, L. M., & Srivastava, A. (2015). Functional data analysis of amplitude and phase variation. Statistical Science, 30(4), 468–484. https://doi.org/10.1214/15-STS524
Pedersen, E. J., Miller, D. L., Simpson, G. L., & Ross, N. (2019). Hierarchical generalized additive models in ecology: An introduction with mgcv. PeerJ, 7, e6876. https://doi.org/10.7717/peerj.6876
Ramsay, J. O., Hooker, G., & Graves, S. (2009). Functional data analysis with R and MATLAB. Springer. https://doi.org/10.1007/978-0-387-98185-7
Ramsay, J. O., & Silverman, B. W. (2005). Functional data analysis (2nd ed.). Springer. https://doi.org/10.1007/b98888
Ruppert, D., Wand, M. P., & Carroll, R. J. (2003). Semiparametric regression. Cambridge University Press. https://doi.org/10.1017/CBO9780511755453
Shiyko, M. P., Lanza, S. T., Tan, X., Li, R., & Shiffman, S. (2012). Using the time-varying effect model (TVEM) to examine dynamic associations between negative affect and self confidence on smoking urges: Differences between successful quitters and relapsers. Prevention Science, 13(3), 288–299. https://doi.org/10.1007/s11121-011-0264-z
Sørensen, Ø., Walhovd, K. B., & Fjell, A. M. (2021). A recipe for accurate estimation of lifespan brain trajectories, distinguishing longitudinal and cohort effects. NeuroImage, 226, 117596. https://doi.org/10.1016/j.neuroimage.2020.117596
Tan, X., Shiyko, M. P., Li, R., Li, Y., & Dierker, L. (2012). A time-varying effect model for intensive longitudinal data. Psychological Methods, 17(1), 61–77. https://doi.org/10.1037/a0025814
van Rij, J., Wieling, M., Baayen, R. H., & van Rijn, H. (2020). itsadug: Interpreting time series and autocorrelated data using GAMMs (R package version 2.4) [Computer software]. https://CRAN.R-project.org/package=itsadug
Wood, S. N. (2004). Stable and efficient multiple smoothing parameter estimation for generalized additive models. Journal of the American Statistical Association, 99(467), 673–686. https://doi.org/10.1198/016214504000000980
Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781315370279
Yao, F., Müller, H.-G., & Wang, J.-L. (2005). Functional data analysis for sparse longitudinal data. Journal of the American Statistical Association, 100(470), 577–590. https://doi.org/10.1198/016214504000001745