第 31 章
縱貫資料的機器學習與資料驅動探索
機器學習 (machine learning) 進入一本寫給心理學家的方法書,既不是救世主也不是威脅,而是一組工具,而它的價值就像任何工具一樣,由「它回答什麼問題、又避開什麼錯誤」決定。本章採取這個立場並且守住它。它由把預測 (prediction) 與解釋 (explanation) 分開講起,也就是 Breiman 所命名的那兩種文化 (culture),因為一個為了預報 (forecast) 某位新病人是否復發而最佳化的方法,接受的是與「一個為了解釋復發何以發生而建的模型」不同的證據檢驗,而把兩者混為一談,正好產出應用機器學習那些特有的病理:一個因為它給不出的洞見而受讚揚的黑箱 (black box),或者一個沒有任何預測技巧的漂亮因果故事。承重的那一節是誠實評估那一節,因為關於縱貫機器學習最要緊的單一事實是:為獨立資料所教的重抽樣 (resampling) 配置,在各列是同一批人的重複測量時會洩漏 (leakage)。一個以隨機切分各列來檢驗的模型,有一部分是在它已經看過的人身上受檢驗的,而它報出來的準確度是被灌大的,那是任何演算法上的精巧都修不掉的。本章以數字示範那道洩漏,接著建起修補它的重抽樣紀律:把摺 (fold) 依人分組,以估計模型對新的人的推廣程度;把摺沿時間串接,以估計模型對一個人未來的預報程度;各自對應它們所誠實評估的那項預測任務,而每一項都對照最卑微的那個基準 (baseline),也就是上一次的值。在這個基礎上,它發展那些真正做得了縱貫工作的方法:在不忽略巢套 (nesting) 的前提下切分異質性 (heterogeneity) 的混合效果樹與森林;作為第 22 章模型本位混合分配模型之演算法對手的軌跡分群 (trajectory clustering);為密集設計所造出之多預測變項問題而設的正則化 (regularization);以及逐人預報,而第 25 章的合併 (pooling) 教訓在那裡穿著預測的衣服回來。全篇之中,評估那一節所立下的紀律,被後面每一個方法繼承。
學習目標
讀完本章之後,你應該能夠:(1) 把預測、描述 (description) 與解釋區分成不同的研究目標,並辨認一個縱貫問題需要的是哪一個;(2) 設計尊重依賴 (dependence) 的重抽樣,選用依人分組交叉驗證 (person-grouped cross-validation) 來估計對新的人的推廣,選用前向串接 (forward-chaining) 來估計個體內的預報,並辨認出天真的逐列切分所造成的洩漏;(3) 配適並解讀為巢套資料調整過的樹 (tree) 與森林 (forest) 方法,包含用於次群體發現 (subgroup discovery) 的成長參數樹與混合效果樹;(4) 執行演算法式的軌跡分群,並說清楚它相對於模型本位混合分配模型的取捨;(5) 把正則化用在多預測變項的縱貫問題上,並對選擇後推論 (post-selection inference) 保持誠實;(6) 以適當的度量、校準 (calibration) 與必備的基準(含持續性 (persistence))評估預測表現;(7) 以排列重要性 (permutation importance) 與部分依賴 (partial dependence) 呈現負責任地解讀黑箱模型,並把它們讀成描述性的;(8) 依當前標準報告一份預測研究,把事前固定的與資料決定的分開。
31.1 兩種文化,一位研究者
Breiman (2001) 在統計實務的兩種文化之間畫了一條線。資料建模的那種文化,設定一個把輸入連到輸出的隨機模型,估計它的參數,並解讀它們;它的通貨 (currency) 是解釋,而它的效度 (validity) 建立在模型大致正確之上。演算法建模的那種文化,把資料生成機制 (data-generating mechanism) 當成未知而且不可知的,並尋找任何一個函數,不管它多麼無法解讀,只要它在新資料上準確地預測輸出;它的通貨是預測技巧 (predictive skill),而它的效度建立在誠實的樣本外 (out-of-sample) 評估 (evaluation) 之上。心理學幾乎完全活在第一種文化裡,而 Yarkoni and Westfall (2017) 主張這讓這個領域付出了代價,主張一份對解釋的過度投資 (overinvestment) 與對預測的相應忽視,產出了一些「配適得了既有資料、卻預報不了任何事」的理論,而借用機器學習的預測紀律會是一次矯正。這個論證有它的力道,也引來了深思熟慮的反駁,主要是:預測與解釋是不同的目標,而不是對同一個目標互相競爭的答案,因此一個領域在兩者之間的選擇,應該由它想學到什麼推出來 (Shmueli, 2010)。
本書的動作是它一路使用的那個「估計標的 (estimand) 優先」的調解:在選方法之前先把推論的標的講清楚,並讓那個標的同時決定方法與證據的標準。有些縱貫問題真的是預測性的。一位病人下個月會不會復發、哪些學生有輟學的風險、一次適時介入 (just-in-time intervention) 應該在何時觸發,這些都是關於「某一位特定的人身上會發生什麼」的問題,而它們由一個具備高度樣本外預測技巧的模型回答得很好,不管它的內部可不可解讀。另一些問題是結構性的或因果的,關於一個結果何以發生、或什麼會改變它,而對這些問題,一個預測性的黑箱是文不對題。錯誤不在使用機器學習,而在把它與問題錯配 (mismatch):把變項重要性讀成一個因果效果,或因為一個經過良好驗證之預測模型的係數缺少理論故事而否定它。表 31.1 把本章的方法對映到它們所服務的目標上,而圖 31.1 把那兩種文化連同它們之間那道估計標的優先的橋一起畫出來。
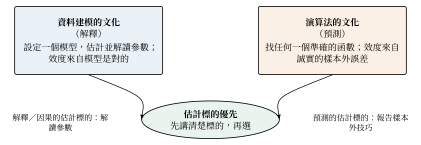
註:Breiman 的兩種文化追求的是不同的目標:透過一個被假設為正確的可解讀模型作解釋,以及透過任何一個經樣本外驗證的函數作預測。它們不是要被裁決的對手,而是要被選擇的目標。本書「估計標的優先」的規則化解了這份張力:先決定問題是預測性的還是結構性的,再挑選那個目標所要求的方法與證據標準。失敗的模式是那個錯配,也就是把一個預測模型的內部讀成解釋,或以預測技巧去評判一個解釋性的模型。
表 31.1 研究目標與本章的方法。
| 目標 | 問題的形式 | 方法與證據 |
|---|---|---|
| 預測 | 這個人身上會發生什麼? | 森林、正則化、逐人預報;證據是對照一個基準的誠實樣本外技巧 |
| 描述 | 這份資料裡有什麼型態? | 軌跡分群、重要性、部分依賴;證據是穩定度 (stability) 與複製 (replication) |
| 解釋 | 這個結果為什麼會發生? | 針對異質性的混合效果樹與 SEM 樹;證據是驗證與理論,不是配適 |
註:同一個演算法可以服務不同的目標;一個隨機森林 (random forest) 可以預報(預測)也可以把特徵排序(描述),但它的變項重要性不是一個因果效果(解釋)。估計標的釘住的是「哪一欄適用」,因而也釘住「需要哪一種證據」。把預測技巧報告得彷彿它示範了一個機制,或把一個機制報告得彷彿它保證了預測技巧,就是那個反覆出現的範疇錯誤 (category error)。
31.2 在依賴資料上作誠實評估
本章最重要的事實是:為獨立觀察所教的交叉驗證 (cross-validation),用在重複測量上是有偏誤 (biased) 的,而那份偏誤是樂觀的。當一份資料的各列是巢套在人之內的時機 (occasion) 時,把各列隨機指派到各摺,會把某個人的一部分時機放進訓練集、另一部分放進測試集,於是模型有一部分是在它已經學過的人身上被評估。因為一個人之內的各次時機是相關的、有時還相當強,一個看過某人其他時機的模型,會把被留出的那些預測得比它預測一位真正的新人時更好,而它報出來的交叉驗證準確度,就高於它在實際使用時所能達到的準確度。這就是洩漏 (leakage),而它不是一個「記一筆然後放到一旁」的細微偏誤;它是「一個在論文裡有效的模型」與「一個在部署時失效的模型」之間的差別。
這份示範用的是 affect_ema 資料,任務是由當下的預測變項與一個延宕 (lagged) 的結果變項預測當下的負向情緒,而學習器是一個隨機森林。圖 31.2 呈現三種重抽樣配置下的結果。天真的逐列十摺交叉驗證,它忽略巢套,並且額外用了一個「在完整樣本上算出來」的個人層次彙總特徵 (aggregate feature),報出的測試集 \(R^2\) 是 \(0.41\)。依人分組交叉驗證,它把整個人留出來,使得沒有任何測試中的人出現在訓練裡,報出的是 \(0.35\)。前向串接,它在每個人較早的時機上訓練、在他們較晚的時機上測試,報出的同樣是 \(0.35\)。天真的那個配置在 \(R^2\) 上樂觀了 \(0.06\),相對灌大百分之十七,而這道落差在重複切分之間是穩定的,使得兩個估計值相距七個標準誤 (standard error) 以上。持續性基準,它就只是預測「負向情緒等於它上一次的值」,報出的是 \(0.27\),而它所促成的比較才是那個令人清醒的比較:誠實的模型在 \(R^2\) 上只比上一次的值好了 \(0.08\)。一份報告了天真那個數字的研究,會宣稱它並不具備的技巧;而一份省略了持續性基準的研究,會為一個「只比什麼都不做好一點點」的模型宣稱新穎性。
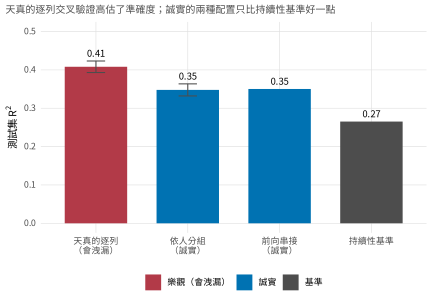
註:在三種重抽樣配置與一個基準之下,預測 affect_ema 資料中當下負向情緒的測試集 \(R^2\)。天真的逐列交叉驗證(紅)報出 \(0.41\);它之所以樂觀,是因為測試中的人也出現在訓練裡,也因為有一個個人彙總特徵是在完整樣本上算出來的。依人分組與前向串接交叉驗證(藍),它們尊重那份巢套與時間的箭頭,報出 \(0.35\),那才是誠實的估計。持續性基準(灰)預測上一次的值,報出 \(0.27\):誠實模型相對於什麼都不做的優勢並不大。誤差槓是重複切分之間的 \(\pm 1.96\) 個標準誤。
修補的做法是把重抽樣配置與預測任務配起來,而任務有兩種。預測一位新的人的結果,也就是篩檢 (screening) 與預後 (prognosis) 的情形,以依人分組交叉驗證 (person-grouped cross-validation) 評估,它把人而不是列切進各摺 (fold),使得每一位測試中的人在訓練期間都完全沒被看過;它的可交換性 (exchangeability) 論證是:測試摺裡的新人,代表的是模型實際使用時將面對的那些新人。由一個人的過去預測他的未來,也就是預報 (forecasting) 與適時介入的情形,以前向串接 (forward-chaining) 評估,也叫滾動起點 (rolling-origin) 評估,它對每個人以某個時間為界,在之前的時機上訓練、在之後的時機上測試,絕不讓未來告知過去。表 31.2 是那份選用表,而圖 31.3 把兩種配置畫出來。還有兩項紀律讓這幅圖完整。前處理 (preprocessing),任何的縮放 (scaling)、插補 (imputation) 或特徵建構 (feature construction),都必須只在訓練摺之內發生,因為一個在完整樣本上配出來的轉換,會把測試的訊息漏進訓練裡,正是上面那個個人彙總特徵所引進的那道漏。而當一個模型的超參數 (hyperparameter) 被調校時,那份調校本身也必須在訓練摺之內作交叉驗證,也就是一次巢套交叉驗證 (nested cross-validation),因為「以測試集表現挑超參數、再報告那份表現」是一種比較微妙的「在訓練資料上作測試」(Varma & Simon, 2006)。
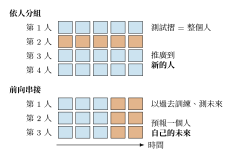
註:藍色格子是訓練的時機,橘色格子是測試的時機。依人分組交叉驗證(上)把整個人指派到測試摺,於是沒有任何測試中的人在訓練裡被看過;它估計的是對新的人的推廣。前向串接(下)在每個人較早的時機上訓練、在較晚的時機上測試,絕不用未來去預測過去;它估計的是個體內的預報。未在圖上的天真逐列切分,把一個人的各次時機散到訓練摺與測試摺兩邊,因而會洩漏。
表 31.2 縱貫預測的重抽樣選用表。
| 預測任務 | 配置 | R 的慣用寫法(分組/分塊) |
|---|---|---|
| 推廣到新的人 | 依人分組 \(k\) 摺 | group_vfold_cv(group=person) |
| 預報一個人的未來 | 前向串接/滾動起點 | sliding_period /逐人的時間切分 |
| 調校超參數 | 巢套交叉驗證(內層) | 每個訓練摺之內再一次 group_vfold_cv |
| 報告不確定性 | 重複交叉驗證 | 重複切分;報告離散程度 |
| 絕不(會洩漏) | 天真的逐列 \(k\) 摺 | (重複測量下不要使用) |
註:配置由任務決定,不由方便決定。依人分組的摺回答「這個模型預測一位新的人有多好」;前向串接回答「這個模型預報這個人自己的未來有多好」。前處理與調校都屬於訓練摺之內。rsample 與 tidymodels 的慣用寫法列在這裡供參照;它們的介面會變,所以要對照當前的說明文件查核。
基礎概念 • 為什麼分組交叉驗證估的是對新的人的誤差
假設每個人 \(j\) 貢獻一個隨機效果 \(u_j\),把他所有的時機一起位移,而目標是預測一位不在樣本中的人的時機。在天真的逐列切分下,第 \(j\) 人的一個測試時機,有同一個人的訓練時機在旁,任何一個學習器都能由那裡估出 \(u_j\);因此那份測試誤差反映的是「\(u_j\) 已知」下的預測,而那不是部署 (deployment) 時的條件。在依人分組的切分下,每一個測試時機都屬於一位沒有任何訓練時機的人,於是 \(u_j\) 是未知的,恰如它對一位未來的人也將是未知的,而那份測試誤差就是對新的人誤差的一個不偏估計。授權這件事的可交換性,是在被留出的那些人與模型將面對的那些未來的人之間:如果他們由同一個母體 (population) 抽出,分組交叉驗證估的就是那個真正要緊的量。同一套邏輯應用在時間而不是人上,就是「前向串接、而不是隨機切分,才估得出預報誤差」的原因。
常見陷阱 • 洩漏的分類
逐列洩漏:隨機切分重複測量的各列,把一個人同時放進訓練與測試;改用依人分組的摺。時間洩漏:讓未來的時機去預測過去的(隨機切分一個時間序列,或使用會偷看前方的特徵);改用前向串接。前處理洩漏:在切分之前就在完整樣本上作縮放、插補或特徵工程;每一個轉換都要在訓練摺之內配。調校洩漏:用來報告表現的同一個測試集,也被用來挑超參數;把調校巢套起來。每一道漏都灌大表面上的準確度,而每一道漏在報出來的數字裡都是看不見的,只有稽核 (audit) 那條流程才發現得了。讀者該要求的是那份稽核軌跡 (audit trail),不是那個準確度。
31.3 巢套資料的樹與森林
決策樹 (decision tree) 把預測變項空間切成若干區域,並在每個區域 (region) 裡配一個簡單模型,而它們的整體 (ensemble),也就是隨機森林,把許多在自助 (bootstrap) 樣本上、以隨機特徵子集 (feature subset) 長出來的樹平均起來,以降低變異數 (variance)。天真地應用到巢套資料上,它們會在兩個地方誤導。因為一個人之內的各次時機是相關的,一棵樹可以靠著實質上記住那些人來達成表面上的配適,而它的變項重要性會偏向「恰好跟著群集 (cluster) 結構走」的特徵、而不是承載個體內訊號的特徵。修補的做法是保住隨機效果結構,同時讓演算法在固定的那一部分上搜尋。混合效果樹以及 RE-EM 程序 (Sela & Simonoff, 2012),在「給定一棵樹估隨機效果」與「給定隨機效果長一棵樹」之間交替,於是那份切分 (partition) 解釋的是次群體之間固定的差異,而隨機效果吸收個體內的依賴;廣義線性混合模型樹 (Fokkema et al., 2018) 在混合模型架構之內做同一件事,是「偵測固定效果有差異之次群體」這件事上成熟的工具。混合效果森林把這個想法延伸到預測 (Capitaine et al., 2021; Hajjem et al., 2014),不過縱貫森林的套件生態,仍然不如橫斷的那些穩定,這是一項值得白紙黑字寫下來的成熟度告誡。
工作範例對 growth_subgroups 資料問一個次群體發現的問題,那份資料中的成長斜率由一棵共變項的樹決定:低社經地位的都市兒童陡、低社經的鄉村兒童中等、高社經的兒童平緩,而它埋在四個不帶訊號的雜訊共變項之間。一棵成長參數樹,也就是先由一個混合模型估出每個人的成長斜率、再以共變項對那些斜率作切分,還原了那個結構:它先切在社經地位上、再切在都市居住上,完全忽略那四個雜訊共變項,而它在一個留出來的驗證 (validation) 半份上的終端節點 (terminal node) 斜率 \(1.84\)、\(1.10\) 與 \(0.65\),在「估計逐人斜率所引致的收縮」之內與植入的真值 \(2.0\)、\(1.2\)、\(0.5\) 相符。圖 31.4 把找出來的次群體疊在原始軌跡上呈現。對一個斜率森林作的排列重要性分析確認了這項發現,把社經地位與都市居住排在那四個雜訊共變項之上很遠的地方,如圖 31.5 所示。Brandmaier et al. (2013) 與 Brandmaier et al. (2016) 的結構方程模型樹把這個想法由一個斜率推廣到一整個潛在成長模型,以「預測任何一個成長參數之差異」的共變項來切分樣本,而它繼承了第 22 章對混合分配模型所要求的同一份紀律:一個被發現的次群體是一項假設,要在新鮮的資料上驗證,不是一項被「找到它的那份配適」所認證的發現。
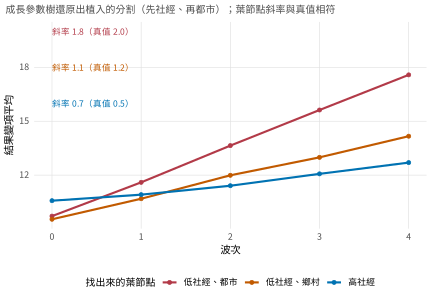
註:一棵成長參數樹在 growth_subgroups 資料中所發現之三個次群體的平均軌跡。這棵樹先切在社經地位上、再切在都市居住上,那正是兩個真正的調節變項 (moderator),並忽略了四個雜訊共變項;它在留出的驗證半份上還原出來的葉節點 (leaf) 斜率(\(1.8\)、\(1.1\)、\(0.7\))與植入的真值(\(2.0\)、\(1.2\)、\(0.5\))在「估計逐人斜率的收縮」之內相符。一個被發現的次群體是一項待驗證的假設,不是一項被「產出它的那次搜尋」所認證的發現。
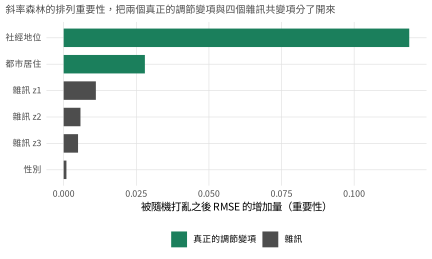
註:排列重要性,也就是把一個預測變項打亂之後預測誤差的增加量,來自一個在 growth_subgroups 資料中預測逐人成長斜率的森林。社經地位與都市居住這兩個真正的調節變項佔了主導;四個雜訊共變項都貼近零。重要性排的是預測上的貢獻,而且要讀成描述性的:它辨認的是模型用到的特徵,不是結果變項的原因。
表 31.3 巢套縱貫資料的樹與森林變體。
| 方法 | 它切分什麼 | 說明與成熟度 |
|---|---|---|
| 天真的 CART/隨機森林 | 固定的那一部分,忽略巢套 | 重要性偏向與群集相關的特徵;巢套資料下避免使用 |
| RE-EM 樹 | 固定的那一部分,隨機效果保留 | 在樹與隨機效果之間交替;成熟(Sela 與 Simonoff) |
| GLMM 樹 | 固定效果的次群體,混合模型完好 | 次群體發現;成熟(glmertree) |
| 混合效果森林 | 帶隨機效果的預測 | 縱貫隨機森林;生態較不穩定(要查核) |
| SEM 樹/森林 | 任何一個潛在成長參數 | 成長模型裡的異質性;發現要驗證 |
註:統一的原則是:讓演算法去搜尋固定的那一部分,而由一個混合模型吸收那份依賴,於是被發現的次群體反映的是真正固定的差異、而不是群集造成的假象 (artifact)。套件的成熟度 (maturity) 各不相同、而且會變動;把工具與它的狀態寫進印出來的文章裡,因為讀者被引到一個已經停止維護的軟體上是幫倒忙。
31.4 軌跡分群:演算法這一邊的對手
軌跡分群依「一個人隨時間變化的形狀」把人分群,而它是第 22 章模型本位成長混合分配模型 (growth mixture model) 在演算法這一邊的對應物。成長混合分配模型設定的是一個機率生成模型,也就是各自帶著自己成長參數的潛在類別 (latent class),並以最大概似 (maximum likelihood) 連同那一整套列舉 (enumeration) 與配適做法去估它;而一個分群演算法計算軌跡之間的距離 (distance),並把近的分到一起,完全沒有生成模型。縱貫資料的 k-means 做法 (Genolini & Falissard, 2010) 把每個人的序列當成一個向量 (vector) 並套用 k-means;距離本位的變體則以一個知覺形狀的距離取代歐氏 (Euclidean) 距離,例如動態時間扭曲 (dynamic time warping),它在比較之前先把「共有一個形狀但時間不同」的序列 (sequence) 對齊 (alignment),適用於「特徵的時間是一項要移除的干擾 (nuisance)、而不是訊號 (signal) 本身」的時候,也就是第 30 章為對位所畫的那同一個相位對振幅的區分。
這場對決讓兩種哲學對上一個已知的真相。classes_sim 資料由三個潛在成長類別生成,而圖 31.6 以「還原真實類別標籤 (label) 的程度」,也就是調整後 Rand 指數 (adjusted Rand index),比較一個高斯混合分配模型、軌跡 k-means 與動態時間扭曲分群。模型本位的混合分配模型勝出,以 \(0.90\) 的調整後 Rand 指數還原那些類別,因為它的生成模型與資料生成歷程相符;軌跡 k-means 以 \(0.78\) 居次;而動態時間扭曲分群以 \(0.71\) 落後,因為它那份扭曲的彈性所解的是一個「這份資料並不具有的相位錯位」問題,於是為了一份從來就不需要的對齊,丟掉了有用的振幅 (amplitude) 訊息。這個次序不是一個普遍的排名,而是一堂關於「把方法與結構配起來」的課:當生成模型已知而且正確時,模型本位的方法最有效率;當它未知或設定錯誤時,演算法的方法比較穩健 (robust);而動態時間扭曲只有在時間錯位是真的時候才掙得到它的位置。表 31.4 陳述這份取捨,而它一字不改地承載第 22 章的主張:混合分配模型與分群都沒有發現真實的類型,而一個還原出來的分群結果是一項要在外部驗證的描述,絕不是一份被「產出它的那個演算法」所認證的分類。
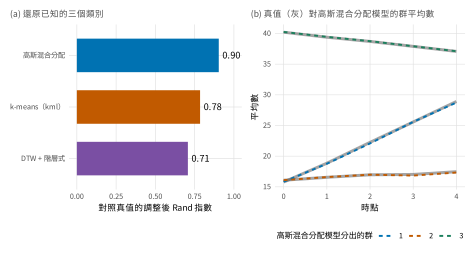
註:(a):以調整後 Rand 指數表示的、對 classes_sim 資料三個真實類別的還原。高斯混合分配模型(\(0.90\))勝出,因為它的生成模型與資料相符;軌跡 k-means(\(0.78\))居次;動態時間扭曲分群(\(0.71\))落後,因為它的扭曲處理的是一個這份資料並不含有的時間錯位。(b):真實的類別平均軌跡(灰)與還原出來的混合模型群平均(虛線)幾乎重合。這個排名是一堂「把方法與結構配起來」的課,不是一個普遍的次序。
表 31.4 模型本位混合分配模型對照演算法分群。
| 特徵 | 成長混合分配模型(第 22 章) | 軌跡分群 |
|---|---|---|
| 基礎 | 一個機率生成模型 | 軌跡之間的距離 |
| 輸出 | 類別機率、參數、配適指標 | 硬性指派 (hard assignment) |
| 強項 | 正確時既有效率又能推論 | 模型未知時穩健 |
| 時間 | 由模型指定 | 相位若是干擾,DTW 可對齊 |
| 共有的告誡 | 兩者都沒有發現「真實的類型」;一個分群結果是一項需要外部驗證的描述 | |
註:這個選擇是在「一個與資料相符時就有回報的生成模型」與「一個在沒有模型可信任時仍然穩健的演算法」之間。兩者產出的分群結果都看起來像被發現的種類,而它們不是:群數是一個建模上的選擇,而一個分群結果在實質上的真實性,必須由複製與外部相關 (external correlate) 來論證,這是與第 22 章共有的主張。
31.5 縱貫問題的正則化
密集設計造出多預測變項的問題:數十個當下題目、它們的延宕、它們的交互作用與它們的個人層次彙總 (aggregate),加起來可以產生比一個古典迴歸估得動還多的候選預測變項。正則化以懲罰 (penalty) 係數大小來處理這件事,把小的效果往零收縮 (shrinkage),而在套索 (lasso) 裡把其中一些設成恰好為零,於是一次同時完成選擇與估計。這個懲罰就是隨機效果所施加的那同一件收縮裝置,而它是第 17 章貝氏 (Bayesian) 先驗 (prior) 的頻率學派 (frequentist) 表親,這個接點值得記住,因為它把正則化去神祕化成一份有紀律的收縮、而不是一門黑魔法。應用到「由當下預測變項、它們的延宕與所有成對交互作用 (interaction) 構成的設計矩陣 (design matrix),篩檢 affect_ema 資料下一個時機的負向情緒」上,套索在依人分組交叉驗證之下選出一個七個預測變項的稀疏 (sparse) 模型,保留了當下壓力、正向情緒與延宕的結果變項,連同少數幾個交互作用,其餘全部捨棄。圖 31.7 呈現那條交叉驗證路徑,以及那個選出稀疏誠實模型的「一個標準誤法則 (one-standard-error rule)」。
有兩項縱貫上的複雜情況值得小心。第一,當一個預測變項如第 7 章所建議的那樣被分解成它的個體內與個體間成分時,那兩個成分應該成對地懲罰,或者要意識到分開懲罰它們可能會扭曲那份分解。第二,也更有後果的是:在選擇中存活下來的那些係數,並不帶著一個普通迴歸的標準誤與 \(p\) 值,因為它們是靠看資料選出來的,而一個忽略這件事的選擇後推論是無效的。誠實的選項有三個:把正則化模型純粹用於預測,只報告樣本外技巧;把選出來的模型鎖定,並在一份新鮮樣本上重配,那裡的推論是有效的;或者把資料切開,在一部分上選擇、在另一部分上推論。務實的主張是把選擇與推論放在分開的隔間裡,而且絕不把一個套索係數配上一個天真的信賴區間 (confidence interval) 報出去,彷彿那次選擇不曾發生過。
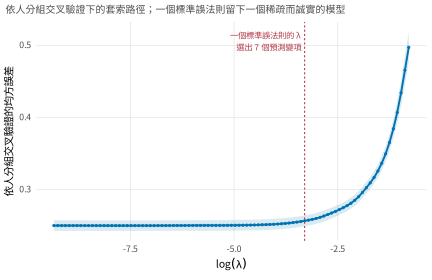
註:在 affect_ema 資料上篩檢下一個時機負向情緒的套索交叉驗證路徑,各摺依人分組,使得選出來的模型對新的人是誠實的。誤差在很寬的一段懲罰範圍上都很平,而在懲罰變大時上升;一個標準誤法則(虛線)在「稀疏開始要付出準確度代價」的那一點附近,選出一個七個預測變項的稀疏模型。選出來的係數是給預測用的;要對它們作推論,需要一個鎖定的模型或一份新鮮的樣本。
31.6 個殊取向的預測與逐人的前沿
預測的問題可以往內轉,由「跨人推廣」轉成「預報單一個人的未來」,而第 25 章的合併教訓在這裡穿著預測的衣服回來。有兩種策略在競爭。一個逐人模型配到每一位個體自己的歷史上、並用來預報他們的未來,完整地尊重個殊取向 (idiographic) 的變異;一個合併模型跨人借力,配一個模型給所有人並套用到每一個人身上。哪一個勝出,取決於每個人有多少歷史,因為一個逐人模型必須單獨由那個人的資料估出它的參數,而在資料少的時候並不可靠。圖 31.8 呈現 affect_ema 資料裡的那個交叉點。在只有六次時機的短歷史下,逐人模型預報得很差,均方根誤差是 \(0.83\)、對照合併模型的 \(0.47\),因為六個點釘不住一個個體模型;隨著歷史加長,逐人的誤差下降,在二十四次時機附近追過合併模型,而在四十次時機時逐人模型明顯勝出。這堂課恰恰就是那堂收縮的課:資料稀疏時,往母體合併是比較好的賭注,而只有當一個人累積了夠多自己的資料時,一個個殊取向的模型才掙得到它的獨立。持續性基準一路跑在合併模型之上,也就是誤差一路較高,但相對於逐人模型只在歷史夠長之後才如此:在 \(k=6\) 時它輸給合併模型、卻贏過逐人模型(\(0.56\) 對 \(0.83\)),而由 \(k=16\) 起兩個模型都勝過它。它仍然是那個必須先被跨過的門檻,只是這份資料上它並不是最強的那個競爭者。
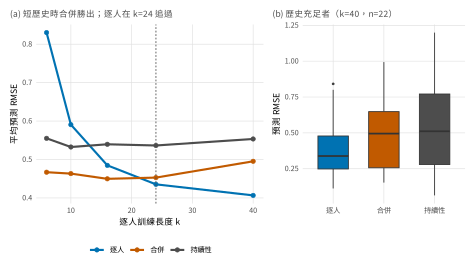
註:(a):affect_ema 資料中,逐人模型、合併模型與持續性隨著逐人訓練歷史加長的個體內平均預報誤差。逐人模型在短歷史時不可靠,並隨資料累積而改善,在二十四次時機附近(虛線)追過合併模型。(b):在一份豐富的四十次時機歷史下,逐人的誤差分配最低;不過只有二十二位參與者累積到這麼長的歷史,這一格的樣本因此遠小於全體的一百二十人。這個交叉點就是第 25 章收縮教訓的預測版:資料稀疏時合併,資料豐富時個體化。
解讀由此得出的那些模型,不管是合併的森林還是逐人的配適,都需要「在不過度宣稱的前提下摘要一個黑箱」的工具。上面用過的排列重要性,依「打亂一個特徵會讓預測退化 (degrade) 多少」把特徵排序,而它必須在尊重分組的前提下計算,也就是在重抽樣結構之內、而不是跨結構地作排列。部分依賴與個體條件期望 (individual conditional expectation) 呈現,畫出「當一個特徵變動、其他特徵固定或平均掉時,預測出來的結果如何移動」,而圖 31.9 呈現預測出來的負向情緒對當下壓力那份上升的依賴,個別曲線則顯示出平均之外的異質性。本質的紀律是這些呈現是描述性的、不是因果的:部分依賴曲線呈現的是模型的預測如何回應一個特徵,而那只有在「模型並未驗證、通常也無法驗證」的假設下,才等於那個特徵的因果效果。一條上升的壓力部分依賴曲線,意思是模型在壓力較高時預測較高的情緒,不是說降低壓力就會降低情緒,而那兩種讀法之間的距離,就是本章開篇所畫的描述與解釋之間的距離。最後,預報的呈現必須永遠錨定在一個基準上,並且與區辨 (discrimination) 一起報告校準;圖 31.10 把每一種配置的誤差擺在持續性那條線旁邊,而表 31.5 列出一份預測報告所需要的度量與基準。
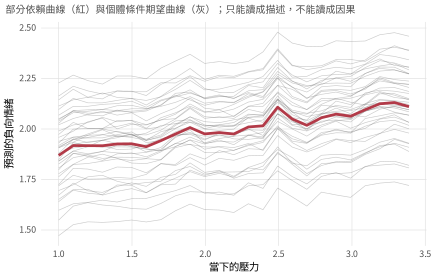
註:部分依賴曲線(紅)呈現森林預測出來的負向情緒如何隨當下壓力上升,其他特徵已被平均掉;灰色的個體條件期望曲線顯示那份依賴在各筆觀察之間有所不同。這些呈現描述的是模型的行為,不是世界的因果結構:那條曲線是模型對一個特徵的回應,只有在未經檢驗的假設下才等於一個因果效果。讀成描述,它們揭露的是模型學會了使用什麼。
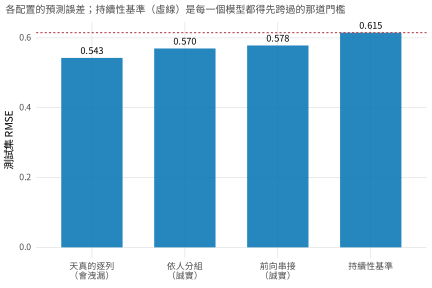
註:在每一種配置下,預測 affect_ema 當下負向情緒的測試集均方根誤差,持續性基準(虛線)標出「預測上一次的值」的誤差。天真那個配置偏低的誤差,就是圖 31.2 那道洩漏換成誤差度量的樣子;誠實的那兩種配置只落在持續性稍下。一項預測主張的強度,不會超過它相對於最簡單基準的邊際,而對縱貫結果變項來說,那個基準幾乎總是持續性。
表 31.5 表現度量與必備的基準。
| 結果變項類型 | 度量(區辨 + 校準) | 必備的基準 |
|---|---|---|
| 連續 | RMSE、\(R^2\);預測值對觀察值的校準 | 持續性(上一次的值);個人平均數 (person mean) |
| 二元事件 | AUC、Brier 分數 (Brier score);校準曲線 | 基礎率 (base rate);最後一次觀察 |
| 事件時間 | 一致性指數 (concordance);各時程 (horizon) 上的校準 | Kaplan-Meier(第 29 章) |
註:區辨(把個案排序)與校準(讓預測值對上觀察到的量級)是不同的;一個模型可以區辨得好卻校準不良,因此兩者都要報告 (Steyerberg, 2019)。每一項預測主張都陳述成「相對於一個基準的邊際」;對縱貫結果變項來說,持續性基準,也就是預測沒有變化,就是一個模型必須勝過才算示範了什麼的那一個。
31.7 報告與預先註冊
一份預測研究靠「報告那些決定它的準確度是否為真的決策」贏得信任,而為臨床預測模型所發展的報告標準可以直接移植 (Collins et al., 2015)。表現必須連同來自重複重抽樣的不確定性一起報告,也必須對照那個必備的基準,好讓讀者同時看到模型有多準、以及它相對於什麼都不做改善了多少。重抽樣配置必須被指名並說明理由,而那份洩漏稽核必須明白寫出:各摺如何尊重了人與時間、前處理相對於切分坐在哪裡、以及調校是如何被巢套起來的。「事前固定了什麼」與「資料選了什麼」的區分必須保留下來,因為那正是一份機器學習分析得以被預先註冊的原因。一份預先註冊可以固定重抽樣配置、度量、基準、調校網格與特徵集合,只把配適出來的模型留給資料,而一份這樣進行的分析,佔的正是本書在第 36 章要回到的那條誠實的探索性車道:在模型是被發現的這一點上是探索性的,在評估是在看到模型之前就指定好的這一點上是驗證性的。表 31.6 是那份檢核表,軟體方塊陳述本章承諾過的套件成熟度稽核,而實作方塊處理在規模上執行這些分析的計算與可複製性現實。
表 31.6 縱貫機器學習的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 估計標的與任務 | 預測、描述還是解釋;新的人對個體內 |
| 重抽樣 | 配置(分組/前向串接)、為什麼,以及那份洩漏稽核 |
| 基準 | 持續性與其他基準,以及模型相對於它們的邊際 (margin) |
| 表現 | 區辨與校準,附來自重複交叉驗證的不確定性 |
| 調校 | 超參數網格 (grid),以及它如何被巢套在訓練摺之內 |
| 固定對選出 | 什麼被預先註冊、什麼由資料決定 |
| 軟體 | 套件與版本 (version),並坦白陳述成熟度狀態 |
註:這份報告是圍繞著「讀者無法自行驗證的那些決策」組織起來的:洩漏是怎麼避開的,以及模型勝過基準多少。一份事前固定配置、度量、基準與網格,只讓資料選模型的分析,同時是探索性的也是誠實的,那正是第 36 章要形式化的那條車道。
軟體提示 • 一份套件成熟度稽核
縱貫機器學習的工具在成熟度上差異很大,而對此坦白,是在替那些否則會引用到停止維護軟體的讀者著想。混合效果樹方面,glmertree 與 partykit 成熟且有人維護;RE-EM 樹有一份歷時較久的參照實作。縱貫森林方面,LongituRF 實作了那些方法,但沒有橫斷森林套件那樣久經考驗。軌跡分群方面,kml 已經確立,而 dtwclust 是距離本位分群的標準;latrend 想要統一那些介面,但應該查核它當前的狀態。正則化結構模型方面,regsem 實作了 Jacobucci et al. (2016) 的方法。分組重抽樣方面,tidymodels 之內的 rsample 提供了那些慣用寫法,不過它的介面會演變。因為這些沒有一個在基本工具箱裡、而且有幾個在產生本章的環境中不可得,這裡的分析把核心邏輯,也就是那個森林、那個動態時間扭曲距離、那個混合模型與每一種重抽樣配置,都手工建在 rpart、glmnet 與 base R 之上,這既是一道可複製性的防護,也示範了那些想法比它們的套件簡單。
實務要點 • 計算、種子與可複製性
交叉驗證過的機器學習,在它的切分、它的自助樣本與它的特徵子集上都是隨機的,因此可複製性要求在每一個隨機步驟上設定並記錄種子 (seed),而誠實的不確定性要求把整套重抽樣重複好幾次,不是信任單一次切分。計算量隨「摺數乘重複次數乘樹數乘調校網格點數」成長,而依人分組與前向串接的配置,還加上一份天真的迴圈 (loop) 所沒有的記帳;在一次大型執行之前先估算這件事,並以「每個工作者各自的種子」跨摺平行化 (parallelize) 以維持可複製性,可以同時避免浪費時間與不可複製的結果。這份紀律就是本書的實驗室標準:種子設好、條件排成網格、結果連同產出它的程式碼一起封存 (archive),好讓一張表裡的一個數字可以被完全一樣地重新產生 (regenerate)。
本章摘要
機器學習在「與研究目標配對、並對依賴資料所招來的洩漏保持紀律」時,才為縱貫研究服務。Breiman 的兩種文化,透過一個可解讀模型的解釋與透過任何一個經驗證函數的預測,是要選擇的目標、而不是要裁決的對手,而估計標的優先的規則為每一個問題指派它的方法與它的證據標準,防住「把預測讀成解釋」那個範疇錯誤。承重的紀律是誠實評估:對重複測量作天真的逐列交叉驗證會洩漏,讓模型有一部分在它看過的人身上受檢驗,而在 affect_ema 資料上,它相對於依人分組交叉驗證把預測 \(R^2\) 高估了百分之十七;依人分組把整個人留出以估計對新的人的誤差,前向串接在過去上訓練以估計預報誤差;而持續性基準顯示誠實模型只小幅勝過上一次的值。前處理與調校屬於訓練摺之內,而讀者該要求的是那份洩漏稽核、不是那個準確度。巢套資料的樹與森林在搜尋固定那一部分的同時保住隨機效果結構:一棵成長參數樹在 growth_subgroups 資料裡還原出植入的次群體,切在兩個真正的調節變項上並忽略四個雜訊共變項,經驗證的葉節點斜率與真值相符;而排列重要性把訊號與雜訊分開,同時保持描述性、不是因果性。軌跡分群是第 22 章混合模型在演算法這一邊的對手,而對照一個已知的三類別真相,模型本位的混合分配模型勝出(調整後 Rand 指數 \(0.90\)),因為它的模型與資料相符,k-means 居次,而動態時間扭曲分群落後,因為它的扭曲解的是一個資料並不具有的時間問題;兩種方法都沒有發現真實的類型,而一個分群結果是一項要驗證的描述。正則化把多預測變項問題當成有紀律的收縮來處理,在分組交叉驗證下選出一個稀疏而誠實的模型,但它選出來的係數不帶普通的推論,在附上 \(p\) 值之前必須先鎖定或先切分。逐人預報重演那堂收縮的課:短歷史時合併模型勝過逐人模型,而在一個人累積夠多資料之後就輸給它,交叉點落在二十四次時機附近,而每一次預報都對照持續性受評判。部分依賴與重要性呈現以描述、絕不以因果解讀黑箱,而報告標準事前固定配置、基準、度量與網格,好讓一個被發現的模型是依一條事先指定的規則受評估,在它的模型上是探索性的、在它的評估上是驗證性的。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 洩漏 | leakage | 測試的訊息漏進訓練,灌大表面上的準確度;第 31.2 節 |
| 依人分組交叉驗證 | person-grouped cross-validation | 把人而不是列切進各摺;估計對新的人的誤差;第 31.2 節 |
| 前向串接 | forward-chaining | 以過去訓練、以未來測試;估計個體內的預報誤差;第 31.2 節 |
| 持續性基準 | persistence baseline | 預測「等於上一次的值」;縱貫預測必備的比較對象;第 31.2 節 |
| 巢套交叉驗證 | nested cross-validation | 把超參數調校放進訓練摺之內再作一次交叉驗證;第 31.2 節 |
| 隨機森林 | random forest | 在自助樣本與隨機特徵子集上長出的樹的整體;第 31.3 節 |
| 混合效果樹 | mixed-effects tree | 在保住隨機效果的同時切分固定的那一部分;第 31.3 節 |
| 排列重要性 | permutation importance | 打亂一個特徵所造成的預測退化;描述性、非因果;第 31.3 節 |
| 軌跡分群 | trajectory clustering | 依變化形狀的距離把人分群,無生成模型;第 31.4 節 |
| 動態時間扭曲 | dynamic time warping | 比較之前先對齊相位的形狀距離(承第 30 章的對位);第 31.4 節 |
| 調整後 Rand 指數 | adjusted Rand index | 兩份分群結果一致程度的校正後度量;第 31.4 節 |
| 套索 | lasso | 把部分係數收縮到恰好為零的懲罰;同時選擇與估計;第 31.5 節 |
| 選擇後推論 | post-selection inference | 對「靠看資料選出來」的係數作推論;天真做法無效;第 31.5 節 |
| 部分依賴 | partial dependence | 預測隨一個特徵變動的曲線;描述模型、非世界;第 31.6 節 |
| 校準 | calibration | 預測值與觀察到的量級相符的程度,與區辨不同;第 31.6 節 |
參考文獻
Brandmaier, A. M., Prindle, J. J., McArdle, J. J., & Lindenberger, U. (2016). Theory-guided exploration with structural equation model forests. Psychological Methods, 21(4), 566–582. https://doi.org/10.1037/met0000090
Brandmaier, A. M., von Oertzen, T., McArdle, J. J., & Lindenberger, U. (2013). Structural equation model trees. Psychological Methods, 18(1), 71–86. https://doi.org/10.1037/a0030001
Breiman, L. (2001). Statistical modeling: The two cultures. Statistical Science, 16(3), 199–231. https://doi.org/10.1214/ss/1009213726
Capitaine, L., Genuer, R., & Thiébaut, R. (2021). Random forests for high-dimensional longitudinal data. Statistical Methods in Medical Research, 30(1), 166–184. https://doi.org/10.1177/0962280220946080
Collins, G. S., Reitsma, J. B., Altman, D. G., & Moons, K. G. M. (2015). Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis (TRIPOD): The TRIPOD statement. BMJ, 350, g7594. https://doi.org/10.1136/bmj.g7594
Fokkema, M., Smits, N., Zeileis, A., Hothorn, T., & Kelderman, H. (2018). Detecting treatment-subgroup interactions in clustered data with generalized linear mixed-effects model trees. Behavior Research Methods, 50(5), 2016–2034. https://doi.org/10.3758/s13428-017-0971-x
Genolini, C., & Falissard, B. (2010). KmL: K-means for longitudinal data. Computational Statistics, 25(2), 317–328. https://doi.org/10.1007/s00180-009-0178-4
Hajjem, A., Bellavance, F. C., & Larocque, D. (2014). Mixed-effects random forest for clustered data. Journal of Statistical Computation and Simulation, 84(6), 1313–1328. https://doi.org/10.1080/00949655.2012.741599
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
Jacobson, N. C., & Nemesure, M. D. (2021). Using artificial intelligence to predict change in depression and anxiety symptoms in a digital intervention: Evidence from a transdiagnostic randomized controlled trial. Psychiatry Research, 295, 113618. https://doi.org/10.1016/j.psychres.2020.113618
Jacobucci, R., Grimm, K. J., & McArdle, J. J. (2016). Regularized structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 23(4), 555–566. https://doi.org/10.1080/10705511.2016.1154793
James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An introduction to statistical learning with applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
Molnar, C. (2022). Interpretable machine learning: A guide for making black box models explainable (2nd ed.). Independently published. https://christophm.github.io/interpretable-ml-book/
Roberts, D. R., Bahn, V., Ciuti, S., Boyce, M. S., Elith, J., Guillera-Arroita, G., Hauenstein, S., Lahoz-Monfort, J. J., Schröder, B., Thuiller, W., Warton, D. I., Wintle, B. A., Hartig, F., & Dormann, C. F. (2017). Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography, 40(8), 913–929. https://doi.org/10.1111/ecog.02881
Sardá-Espinosa, A. (2019). Time-series clustering in R using the dtwclust package. The R Journal, 11(1), 22–43. https://doi.org/10.32614/RJ-2019-023
Sela, R. J., & Simonoff, J. S. (2012). RE-EM trees: A data mining approach for longitudinal and clustered data. Machine Learning, 86(2), 169–207. https://doi.org/10.1007/s10994-011-5258-3
Shmueli, G. (2010). To explain or to predict?. Statistical Science, 25(3), 289–310. https://doi.org/10.1214/10-STS330
Steyerberg, E. W. (2019). Clinical prediction models: A practical approach to development, validation, and updating (2nd ed.). Springer. https://doi.org/10.1007/978-3-030-16399-0
Varma, S., & Simon, R. (2006). Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics, 7, 91. https://doi.org/10.1186/1471-2105-7-91
Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: Lessons from machine learning. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393