多層次模型:心理與社會科學的建模、圖解與實作游琇婷 Hsiu-Ting Yu 游琇婷Hsiu-Ting Yu
EN
網頁版 · 2026

多層次模型

心理與社會科學的建模、圖解與實作

繁體中文版

游琇婷Hsiu-Ting Yu
國立政治大學心理學系

原書:Multilevel Modeling for Psychology and the Social Sciences: Models, Graphs, and Practice

多層次結構的每一層都有自己的單位與變異。在第 8 章的三層次虛無模型中,學生分數圍繞所屬班級的平均數變動,班級平均數圍繞所屬學校的平均數變動,學校平均數則圍繞總平均數變動。

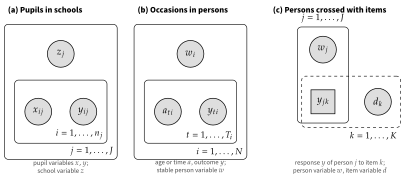
學生巢套於班級、班級巢套於學校 以三個疊起的平面表示多層次結構的三個層次:第三層是學校,第二層是班級,第一層是學生。每所學校連到它的班級,每個班級連到它的學生;同一所學校的單位使用同一種顏色。 第三層 學校 k β00k ~ 𝒩(γ000, φ02) 第二層 班級 j π0jk ~ 𝒩(β00k, τ02) 第一層 學生 i yijk ~ 𝒩(π0jk, σ2)
學生巢套於班級、班級巢套於學校,每一層一個平面。同一所學校的單位使用同一種顏色;將游標移到某所學校上,即可追蹤它的班級與學生。
01

關於本書

心理學、教育與社會科學的資料幾乎總是分組的:學生在學校的班級裡上課,病人在診所裡接受治療師的治療,員工在公司的團隊裡工作,重複測量則巢套於個人之內。多層次模型同時表徵每一個層次的變異,把這些變異與在相應層次測得的解釋變項連結起來,並在推論時尊重分組所造成的相依性。

本書從巢套資料與隨機截距模型出發,逐步發展到成長模型、廣義線性混合模型、交叉分類與多重隸屬結構、位置-尺度模型、多層次結構方程模型與測量模型,以及叢集資料的因果推論。每一個模型都以三種方式寫出:各層次的方程式、單一的混合模型,以及描述結果變項平均數與共變數的邊際模型;每一個模型在配適之前,也都先畫成統一模型圖(Unified Model Graph, UMG)。

全書的範例以 R 示範;每章最後都有對照 SAS、SPSS、Stata、Mplus、HLM 與 JASP 的軟體對照、本章摘要、關鍵詞、五類習題,以及自學上機實作的指引。推導放在「技術細節」方塊與附錄 B,因此正文可以用研究所第一門課的程度閱讀。

適用讀者修過迴歸課程的心理學、教育學、社會學及相關領域研究生;迴歸基礎扎實的大學部高年級學生;量化方法的博士生;以及需要查閱特定延伸模型的應用研究者。
先備知識含交互作用與虛擬編碼的多元迴歸、變異數分析、基本機率,以及願意閱讀矩陣符號(附錄 A 提供複習)。
中英術語對照附錄 F 收錄 676 條術語的雙向對照(英中、中英),另附一張台灣與中國常見統計術語譯名的對照表,方便查閱中國出版的文獻。
關於中文版繁體中文版與英文版逐段對應,使用台灣的學術用語,專有名詞保留英文;圖形目前沿用英文版。每一頁右上角的 EN 可切換到英文網頁版的同一頁。
02

先畫圖,再配適:UMG 圖形語彙

統一模型圖以一種視覺管道表示模型的一個部分:填色表示變項是否被觀察到,形狀表示取值型態,菱形標示固定參數,plate 表示重複,因此巢套的 plate 就是階層的各個層次。完整的說明見附錄 D。
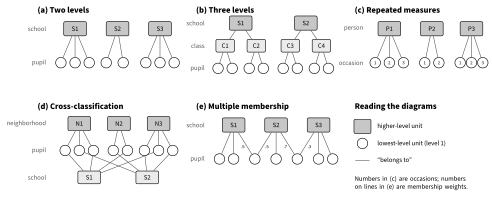
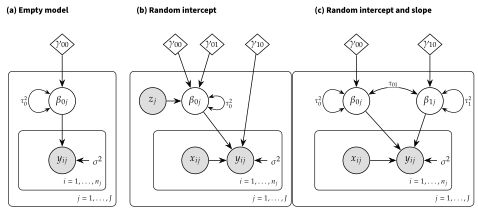
觀察變項灰底圓形:測得的連續隨機變數。
潛在變項白色圓形:未觀察到的隨機變數,例如隨機效果。
固定參數菱形:待估計的未知常數,例如固定效果。
類別變項方形:觀察到的(例如試題反應)塗灰底,潛在的(例如潛在類別)為白色。
Plate圓角方框:可交換的重複;巢套的 plate 就是階層的各個層次。
邊單向箭頭:迴歸或負荷量。雙向箭頭:共變數;畫成單一頂點上的迴圈時,表示變異數。
03

閱讀路徑

每一章核心內容大約對應一次三小時的課;每一章也都會重述所用的符號,因此本書可以依不同的順序閱讀。

研究所一學期課程

第 1–18 章,以及第 19、20、23 章

依課程順序閱讀,第 13、16、17 章作為入門;共十四週的授課內容。

大學部進階課程

第 1–7、10–12、14、19 章

核心模型、推論、模型建立與成長模型,略過「技術細節」方塊。

研究所第二學期進階課程

第 13、16、17、21、22、24–32 章

貝氏估計、研究設計與遺漏資料、密集縱貫資料,以及第 VI 篇與第 VII 篇的延伸模型。

參考用途

附錄 E 與任何一章

軟體對照與疑難排解指引,可搭配任何一章閱讀;每一章都會重述它的符號。

04

目次

全書共七篇三十二章,另有七個附錄。每一頁左側的面板也列有目次。

第 5–32 章需要密碼,各章的密碼不同。第 1–4 章與附錄 A–F 開放所有讀者閱讀。在此處或在該章頁面輸入該章的密碼,即可在這台裝置上開啟那一章。附錄 G(習題解答)另有獨立的密碼,目前暫不開放。
05

每一章的固定元素

每一章都依同一個範本編排,反覆出現的元素在全書都以相同的方式標示。

學習目標讀完本章後應該能做到的事。
同一個模型,三種寫法階層式、線性混合式與邊際式並列。
核心概念一段或一節所要確立的那一個主張。
技術細節初讀時可以略過的推導。
常見陷阱模型設定、估計與解釋上的常見錯誤。
審查委員會問嚴謹的審查委員會向這項分析提出的問題。
台灣案例使用台灣資料與研究問題的應用。
軟體對照本章的模型在 SAS、SPSS、Stata、Mplus、HLM 與 JASP 中的寫法。
本章摘要以幾則陳述整理本章的主要結果。
習題與上機實作觀念題、推導題、計算題、模擬題與應用小專題,以及上機實作。
06

著作權與使用說明

© 2026 游琇婷(Hsiu-Ting Yu)。保留所有權利。

本網頁版供個人閱讀與教學參考。歡迎連結至本網站各頁,並依「引用本書」的格式引用;未經作者書面同意,請勿重製、轉載或改作本書的文字、圖表與習題解答。

書中的 R 程式碼範例採 MIT 授權,可自由使用與修改。各資料集的著作權與使用條件屬原提供者,詳見附錄 C。