探索與管理多層次資料
本章架構第一層與第二層檔案、合併與長寬格式轉換;識別碼與資料稽核;衍生變項及其陷阱;把探索性圖示當作模型所隱含的圖示來閱讀;探索固定部分;探索隨機部分;模擬多層次資料;可重現的專案架構。
多層次分析結果中的錯誤,大多不是罕見的估計問題造成的,而是來自用錯鍵值的合併、用錯觀察值算出的組平均數,或是在還沒有人看過資料之前就配適的模型。本章處理第一個模型之前的工作:從學生層次與學校層次的資料來源建立分析檔,計算多層次模型會用到的衍生變項,並用能回答待配適模型之具體問題的圖示來探索資料。探索的部分依循本課程「模型建立」一講的前半,而這一講又依循 Raudenbush 與 Bryk (2002, 第 9 章) 與 Snijders 與 Bosker (2012, 第 10 章) 的邏輯:先研究平均數結構,把它移除,再研究剩下的部分。
本章以第 2 章的模型與資料對偶性(model-data duality)作為組織主軸。統一模型圖(Unified Model Graph, UMG)的每一個元素都對資料提出一項主張,而每一項主張都有一種可以檢查它的圖示。plate 主張各叢集是可交換的重複單位,因此需要每個叢集一個小圖。隨機係數主張某個量在叢集之間變動,因此需要逐一呈現各叢集該量的圖示。以這種方式閱讀圖示,探索性資料分析 (Tukey, 1977) 就不再是一堆零散的圖,而成為對預定模型每個部分的系統性檢查。這項檢查的結果是關於模型的假設,而不是研究發現;這些假設要到第 III 篇才會接受正式檢定。
4.1資料結構與檔案#
4.1.1第一層與第二層檔案#
多層次資料很少以單一檔案的形式取得。大型調查會為每一種單位分別釋出檔案;研究者自己的研究通常也會產生一個學生問卷檔、一個教師或學校檔,或許再加上一個行政資料檔。課程上機實作所用的 TIMSS 資料是最簡單的例子。第一層檔案(level-1 file)每位學生一列:3 年級與 4 年級共 7,097 名學生,內含學校識別碼(idschool)、學生識別碼(idstud)、年級、性別,以及數學與科學成績。第二層檔案(level-2 file)每所學校一列:共 146 所學校,內含學校識別碼,以及一項取自校長問卷的學校特徵,即校長所報告的教學材料短缺程度(shortages,編碼從 0 = 沒有 到 3 = 很多)。同時出現在兩個檔案中的識別碼,就是連結兩者的鍵值(key)。
4.1.2多對一合併#
圖 4.1 的 (a) 圖呈現建立分析檔的操作。每一列學生資料都與鍵值相同的那一列學校資料配對,學校的變項值則複製到該校每一位學生的列上。合併結果的列數與學生檔相同,而學校變項在每所學校內都是常數。這就是多對一合併(many-to-one merge):許多學生列對應到同一列學校資料。在 R 中寫成 left_join(pupils, schools, by = "idschool");在 SAS 中,先把兩個檔案依鍵值排序,再使用帶有 BY 變項的 MERGE 敘述;在 SPSS 中使用帶有 /TABLE 子命令的 MATCH FILES;在 Stata 中則是 merge m:1。
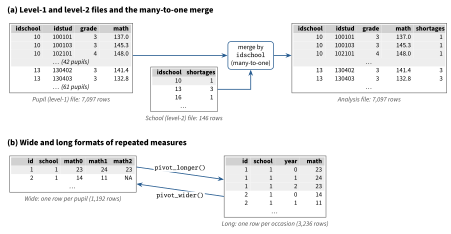
註:(a) 圖:課程上機實作所用 TIMSS 學生檔與學校檔的前幾列,以及合併後分析檔的前幾列;灰底的列屬於學校 10。(b) 圖:Junior School Project 數學成績的前幾列,分別以寬格式(每位學生一列,每年一欄)與長格式(每位學生每年一列)呈現;NA 表示遺漏值。
每一次合併都應該做三項檢查。第一,鍵值在第二層檔案中必須唯一;如果某所學校出現兩次,該校每一位學生的資料都會重複出現(變成多對多合併)。第二,合併後的列數必須等於學生檔的列數。第三,找不到對應學校的學生,以及沒有任何學生的學校,都必須清點並說明原因,而不是悄悄捨棄。在 R 中,left_join() 的引數 relationship = "many-to-one"(dplyr 1.1.1 以後的版本)會在某位學生的鍵值對應到不只一列學校資料時,以錯誤訊息中止執行;這落實了第一項檢查,也因此落實了第二項。程式 prepare_timss_V01.R 就使用了這個引數。沒有配對到的單位仍須另外清點,例如使用 anti_join()。
4.1.3長格式與寬格式#
重複測量資料有兩種儲存方式(圖 4.1 的 (b) 圖)。在寬格式(wide format)中,每個人占一列,每個測量時間點各有自己的一欄(Junior School Project 三個年度的 math0、math1、math2)。在長格式(long format)中,每個測量時間點各占一列,並以一個變項記錄是哪一個時間點(year)。大多數多層次軟體要求使用長格式;在長格式中,測量時間點是第一層單位,正如學生在 TIMSS 檔中是第一層單位一樣。長格式也是 Wickham (2014) 所說的整齊(tidy)資料排列:每個變項是一欄,每個觀察值是一列,每一種單位各有自己的表格。長格式有兩個特點在後面的章節很重要。缺少的測量時間點只是少了一列(學生 2 沒有 year 為 2 的那一列),因此資料不完整的人仍然留在分析中(第 17 與第 19 章)。而隨時間變動的預測變項,例如每個時間點的年齡,就成為一般的第一層變項。在 R 中,tidyr::pivot_longer() 與 pivot_wider() 可以在兩種格式之間轉換 (Wickham et al., 2023, 第 5 章)。
4.1.4識別碼#
識別碼比其他任何變項都更需要細心處理,因為識別碼一旦出錯,資料的結構就會改變,分數卻一個也沒有變。三條規則可以避免大多數問題。第一,每個單位都需要一個在整筆資料中唯一的識別碼,而不只是在所屬叢集內唯一。在 NELS:88 檔中,學生編號在每所學校重新起算(519 名學生共用 100 個不同的學生編號),因此唯一的學生識別碼必須結合學校編號與學生編號;在 Junior School Project 中,班級編號則在每所學校內從 1 編到 4。第二,帶有結構資訊的識別碼應該加以解碼並檢查。TIMSS 的學生識別碼依序由學校、班級、學生組成:學生 102101 是學校 10 班級 21 的第 01 號學生。因此,去掉最後兩位數(除以 100 取整數)就得到一個在各校之間唯一的班級識別碼,而資料原來還有第三個層次:414 個班級,上機實作的檔案卻沒有提到。第三,第二層變項在叢集內必須是常數;某個學校變項若在同一所學校內出現兩個值,就表示編碼或合併有錯。程式 prepare_timss_V01.R 會檢查這三點。
4.1.5資料稽核#
在配適任何模型之前,先以一份簡短的資料稽核(data audit)描述資料結構:第一層與第二層單位的數目、叢集大小的分布、單一觀察值叢集(singleton)(只有一個第一層單位的叢集)的數目,以及結果變項的組內相關係數(ICC)。表 4.1 列出本章各筆資料的稽核結果,值得仔細一看。TIMSS 的學校規模很大(中位數為 48.5 名學生),但校內的班級很小,而且有一個班級只有一名學生。Junior School Project 平均每位學生約有 2.7 個測量時間點,其中 35 名學生只有一個時間點。睡眠剝奪研究則完全平衡,18 名受試者每人都有 10 天的資料。各筆資料的組內相關係數從 .20 到 .63 不等。這些事實都會影響後續的決定:叢集小,能得知的叢集內斜率資訊就有限;單一觀察值叢集對叢集內估計值毫無貢獻;叢集數目少(18 名受試者、23 所學校),能得知的變異成分資訊就有限(第 16 章)。
| 單位 | 叢集大小 | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| 資料 | 第一層 | 第二層 | 最小值 | 中位數 | 最大值 | ICC | |||
| NELS:88 | 學生 | 學校 | 519 | 23 | 5 | 21 | 67 | 0 | .24 |
| TIMSS | 學生 | 學校 | 7,097 | 146 | 7 | 48.5 | 83 | 0 | .20 |
| TIMSS | 學生 | 班級 | 7,097 | 414 | 1 | 17 | 30 | 1 | .32 |
| JSP | 測量時間點 | 學生 | 3,236 | 1,192 | 1 | 3 | 3 | 35 | .63 |
| 睡眠研究 | 天 | 受試者 | 180 | 18 | 10 | 10 | 10 | 0 | .39 |
註:NELS:88 = National Education Longitudinal Study of 1988(1988 年全國教育長期追蹤研究),23 所學校的子樣本;TIMSS = 課程上機實作檔中的美國 3 年級與 4 年級學生;JSP = Junior School Project,第 0 至 2 年的數學成績(測量時間點巢套於學生之內,此處不考慮學校);睡眠研究 = 睡眠剝奪研究,第 0 至 9 天的反應時間。 為第一層單位數; 為第二層單位數; 為叢集大小; 一欄為單一觀察值叢集的數目。ICC 為結果變項的組內相關係數,取自以限制最大概似法估計的虛無模型。TIMSS 的班級由學生識別碼解碼而得。
4.2衍生變項#
多層次模型會用到少數幾個從原始資料計算出來的變項(表 4.2)。最重要的是:第一層變項的組平均數(cluster mean) ,可以作為第二層預測變項;組平減(group-mean-centered)變項 ,只包含叢集內的變異;以及總平減(grand-mean-centered)變項 ,只移動原點。TIMSS 上機實作為數學成績計算了這三個變項:grpMmath(學校平均數)、grpCmath(數學成績減去學校平均數),以及 OCmath(數學成績減去總平均數 151.09)。這些變項在模型中的意義,以及如何在它們之間做選擇,是第 7 章的主題 (Enders & Tofighi, 2007; Kreft et al., 1995);這裡關心的是如何正確地計算它們。
| 衍生變項 | 定義 | R(在 group_by(cluster) 之後)
| 用途與注意事項 |
|---|---|---|---|
| 叢集大小 | n_j = n()
| 報告其分布;標記單一觀察值叢集()與極小的叢集。 | |
| 組平均數 | x_mean = mean(x, na.rm = TRUE)
| 第二層(組成)預測變項。決定並報告哪些觀察值納入平均數。 | |
| 組平減變項 | x_cwc = x - mean(x, na.rm = TRUE)
| 純粹的叢集內預測變項;其組平均數為零。單一觀察值叢集的值一律為 0。 | |
| 總平減變項 | x_cgm = x - mean(x)(不分組)
| 只移動原點;模型配適不變。 | |
| 平減後的組平均數 | x_mean - mean(x)(不分組)
| 零點有意義的第二層預測變項。 | |
| 叢集比例 | = 0/1 指標變項的平均數 | p_white = mean(white)
| 叢集的組成(例如女生的比例)。 |
| 叢集標準差 | x_sd = sd(x)
| 組成的異質性; 時無定義。 | |
| 叢集內相對位置 | 或 rank | x_rank = rank(x) / n()
| 單位在所屬叢集內的相對位置(「大魚小池塘」)。 |
註: 為叢集 中第一層單位 的值; 為組平均數; 為所有第一層單位的總平均數; 為叢集內標準差。R 運算式假定使用 tidyverse(dplyr)。
這三個變項之間有一個值得記住的恆等式,因為它顯示平減並不會損失任何資訊:
因此,同時納入組平減變項與組平均數的模型,使用了 的全部資訊,卻讓它的叢集內部分與叢集間部分可以有不同的係數。這就是第 3 章組內迴歸與組間迴歸以模型為基礎的版本。
4.2.1計算上的陷阱#
實務上有四個陷阱反覆出現。第一個是組平均數中的遺漏值。如果有些學生缺少數學成績,學校平均數可以用所有有成績的學生計算,也可以只用進入最終分析的學生(在每一個模型變項上都有完整資料者)計算。兩個平均數並不相同,而這個選擇會改變學校間係數。兩種做法都不是永遠正確,但選擇必須經過深思並加以報告;一般的建議是,若某個叢集特徵是用來描述叢集本身,就使用該叢集所有可用的第一層資訊。第二個陷阱是取子集後未重新計算。在排除觀察值之前算出的平均數(例如在把樣本限定為 4 年級之前)描述的是與分析樣本不同的母群,而且平減後的變項在子集中的組平均數也不再是零。應該在分析流程中分析樣本確定下來的那一步計算衍生變項,並檢查組平減變項在每個叢集中的平均都是零。第三個陷阱是單一觀察值叢集與極小的叢集。單一觀察值叢集的組平減變項恰好為零,而只有兩個單位的叢集,其平均數也很難代表該叢集。這些叢集是資料中正當的成員(它們對模型的叢集間部分有貢獻),但稽核時應該清點它們。第四個陷阱是組平均數的抽樣誤差。20 名學生的觀察平均數是該校真實平均數的估計值,而不是真實平均數本身;把它當作預測變項,會使叢集間係數偏向叢集內係數(因而使脈絡效果偏向零);叢集愈小、預測變項的 ICC 愈低,這個偏誤就愈大。第 7 章會介紹以潛在平均數處理的方法。
4.3把資料圖示當作模型所隱含的圖示#
第 2 章介紹了模型與資料的對偶性:模型的每一個元素都隱含一種資料圖示。表 4.3 把這個想法化為隨機截距與斜率模型的檢核清單;本書大多數兩層次分析都從這個模型出發。左欄列出它的統一模型圖(圖 2.4(c))中的各個元素,中間兩欄說明每個元素對資料提出什麼主張、以哪一種圖示檢查這項主張,右欄則指出本章中的例子。
| UMG 元素 | 對資料的主張 | 圖示與觀察重點 | 例子 |
|---|---|---|---|
| 學生 plate 巢套於學校 plate 之內 | 學生在學校內可交換,學校在母群中可交換 | 資料稽核;每個叢集一個小圖的格狀圖:每個小圖是否都出現同一類關係? | 表 4.1、圖 4.3 |
| 邊 與菱形 | 的平均數隨 線性變化,且在所有次母群中變化方式相同 | 附平滑曲線的合併散佈圖;依次母群分開的 各等級平均數:直線、彎曲、平行,還是交叉? | 圖 4.2、4.4 |
| 白色圓形 與迴圈 | 各叢集截距圍繞 變動 | 叢集截距的毛毛蟲圖:分散程度是否大於區間所隱含的程度? | 圖 4.5a |
| 白色圓形 與迴圈 | 各叢集斜率圍繞 變動 | 義大利麵圖與格狀圖中的線、斜率的毛毛蟲圖:線條散開的程度是否超過抽樣誤差所能容許的? | 圖 4.3、4.5b、4.6 |
| 共變數邊 | 截距與斜率之間有關聯 | 叢集截距對斜率的散佈圖:是否有趨勢? | 圖 2.6c |
| 殘差短箭頭 搭配隨機斜率 | 邊際變異數是 的二次函數(變異數函數) | OLS 殘差平方對 :平坦的帶狀,還是 U 形? | 圖 4.7 |
| 所有隨機項合在一起(邊際 ) | 某種特定的叢集內相關型態 | 殘差的相關矩陣圖:固定不變、隨間隔遞減,還是隨時間上升? | 圖 4.8 |
註:UMG 為統一模型圖(第 2 章)。 為固定效果; 為各叢集的截距與斜率; 為其變異數與共變數; 為第一層殘差變異數; 為叢集 結果變項的邊際共變數矩陣。OLS 為普通最小平方法。
這張表建議一個與模型順序相呼應的工作順序:先處理固定部分(菱形,以及從預測變項指向結果變項的邊),再處理隨機部分(白色圓形、它們的迴圈與共變數邊),最後是隨機部分所隱含的相依型態。這個順序很重要,因為隨機部分的圖示使用殘差,而殘差只有在移除了合理的固定部分之後才有意義。
4.4探索固定部分#
4.4.1為什麼先處理固定部分#
多層次模型的隨機部分,描述的是固定部分沒有解釋的變異。例如,模型之所以需要隨機斜率,可能只是因為把一條曲線配適成直線,或是遺漏了某個跨層級交互作用。因此,本課程「模型建立」一講一開始就刻意採用從寬的初步固定部分(preliminary fixed part):納入理論或圖示所提示的所有第一層與第二層預測變項、曲線與交互作用。它的目的是從資料中移除系統性的變異,以便研究剩下的變異。初步固定部分可以忽略叢集、以普通最小平方法估計,因為只要固定部分設定正確,而且預測變項與隨機效果及第一層殘差無關,在多層次模型下,OLS 的固定效果估計值就是不偏且一致的;錯的只有它們的標準誤(第 1 章)。這個 OLS 配適的殘差,就是探索隨機部分的原料(第 4.5 節)。
4.4.2合併圖示#
第一批圖示忽略叢集。圖 4.2 的 (a) 圖把全部 519 名 NELS:88 學生的數學成績對每週作業時間作圖,並畫出各作業時間類別的平均數、OLS 迴歸線,以及作為彈性平滑曲線、自由度為 3 的自然三次仿樣函數。自陳作業時間最多一小時的學生(類別 0 至 2),數學平均數大致持平,約在 48 到 50 分之間;從三小時以上(類別 4 至 7)則陡升到約 61 分,並在那裡趨於平穩。直線(斜率為每個作業時間類別 3.13 分)沒有掌握這個形狀:它在類別 0 與 4 比平均數低約 3 分,在類別 1 與 2 略高於平均數,而在人數很少的類別 6 與 7,則比平均數高出 3 到 6 分。由於各類別在時數上並不等距(光是類別 5 就涵蓋四到六小時),每個類別的斜率並不等於每小時的斜率。仿樣函數則緊貼著各類別的平均數。正式比較兩個 OLS 配適,結果偏向仿樣函數,,但它的 值(.008)忽略了叢集,因此太小(第 1 章);在這個階段,這項比較只是描述性的。也請注意,自陳每週作業七小時以上的學生非常少(類別 6 與 7,分別只有 6 名與 3 名學生):上端的形狀所依據的資料非常有限。
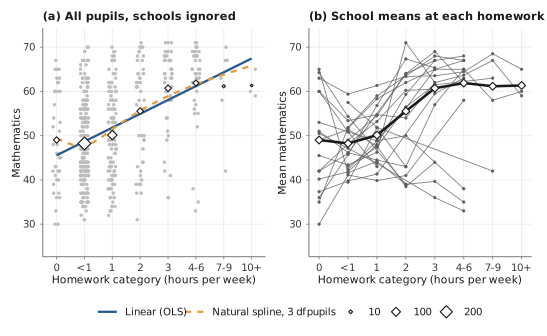
註:(a) 圖:灰點為學生(在水平方向加入抖動);菱形為各作業時間類別的平均數,面積與學生人數成正比;實線為 OLS 迴歸線,虛線曲線為自由度 3 的自然三次仿樣函數。(b) 圖:每一條細線連接一所學校在該校出現過的各作業時間類別上的數學平均分數;粗線與菱形為 (a) 圖的整體平均數。作業時間以有次序的類別記錄;刻度標籤標示每個類別所代表的每週時數。
圖 4.2 的 (b) 圖朝叢集跨出第一步:為每所學校連接各作業時間類別的平均分數。整體平均數(粗線)掩蓋了大量的差異。有些學校的平均數隨作業時間上升,有些則下降,還有許多學校太小,根本看不出清楚的型態。這個圖示主要的用處是提出警告:(a) 圖的合併曲線是各校不同曲線的平均;要適當地呈現這些曲線,得靠格狀圖。
4.4.3格狀圖#
格狀圖(trellis display)(又稱小倍數圖或 lattice 圖)為每個叢集畫一個小圖,所有小圖使用相同的座標軸 (Becker et al., 1996);它建立在 Cleveland (1993) 的條件圖(conditioning plots)之上。它是 plate 所隱含的圖示:如果各叢集是同一個模型的可交換重複單位,每個小圖都應該呈現同一類關係,只是細節因叢集而異。圖 4.3 呈現全部 23 所 NELS:88 學校,並依校內以作業時間預測數學成績之 OLS 迴歸的斜率排序。排序是關鍵。若依字母或識別碼順序排列,這些小圖看起來就像一堆隨機的組合;依斜率排序,則顯示出有系統的漸進變化:從 8 所數學成績隨作業時間下降的學校(斜率從每個作業時間類別 到 分),到 15 所數學成績隨作業時間上升的學校(從 到 )。
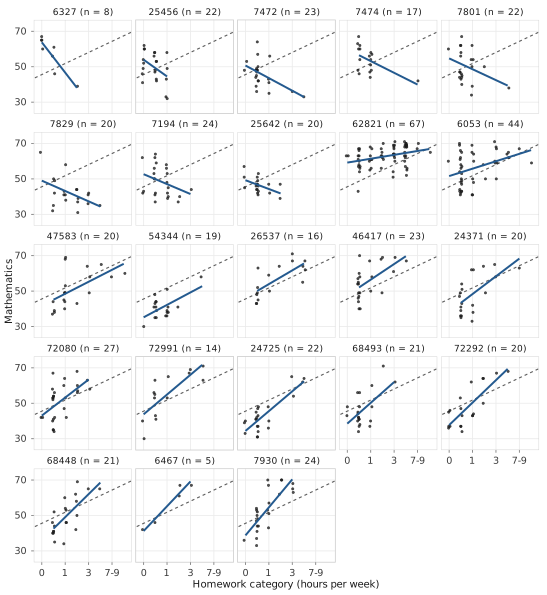
註:每所學校一個小圖,標示學校識別碼與學生人數,依校內 OLS 斜率由小(左上)到大(右下)排列。點為學生(在水平方向加入抖動);實線段為校內 OLS 迴歸線,只畫在該校觀察到的作業時間範圍內;虛線為全部 519 名學生的合併 OLS 迴歸線。
圖 4.3 有三個特徵可以引導模型的建立。第一,在大多數學校內,關係看起來大致呈線性;幾乎看不出圖 4.2(a) 中的曲線存在於學校內。因此,這條曲線可能是學校間的現象:學生寫較多作業的學校,平均數較高(這是第 7 章要處理的問題)。第二,各校斜率差異極大,連正負號都不同,因此共同斜率的模型(隨機截距模型)會錯誤描述大多數學校。第三,各小圖的人數與所涵蓋的作業時間範圍各不相同:學校 6467 有 5 名學生,學校 62821 有 67 名;有三所學校沒有任何學生自陳作業時間超過兩小時(沒有人高於類別 3)。每個小圖能提供多少關於該校斜率的資訊,取決於這些特徵,第 4.5 節會再討論這一點。
4.4.4對次母群取平均#
格狀圖呈現的是叢集。依共變項分組的平均數圖(means-by-covariate display)呈現的則是由其他預測變項界定的次母群:它畫出某個預測變項每個等級上的結果變項平均數,並依第二個預測變項的組別分開呈現。平行的剖面線提示效果是可加的;分岔或交叉的剖面線則提示有交互作用。圖 4.4 把它用在課程講義所檢視的三個預測變項上:學生種族(白人與否)、性別與學校公私立別。
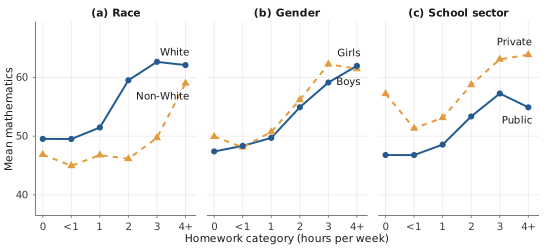
註:每一點為某一組學生在某一作業時間類別的數學平均分數;作業時間類別 5、6、7(每週四小時以上)合併並標示為 4+,其他刻度標籤標示各類別的每週時數。實線加圓點與虛線加三角形區分每個小圖中的兩組;組名標示在每條剖面線最後一點的旁邊。
三個小圖說了三個不同的故事。在 (a) 圖中,白人學生在每個作業時間類別的分數都高於非白人學生;兩者的差距在自陳作業最多一小時的學生之間(類別 0 至 2)約為 3 到 5 分,在兩小時與三小時(類別 3 與 4)超過 12 分,到了四小時以上又縮小到約 3 分。這提示作業時間與種族之間有交互作用,但證據薄弱:129 名非白人學生中只有 26 名自陳作業兩小時以上(類別 3 至 7),而非白人學生在四小時以上(類別 5 至 7 合併)的平均數只根據 5 名學生。在 (b) 圖中,女生與男生的剖面線幾乎重疊,既不提示性別效果,也不提示性別與作業時間的交互作用。在 (c) 圖中,私立學校學生在每個作業時間類別的分數都高於公立學校學生,在類別 1 至 4 高出 4.5 到 6 分,在兩端則高出約 9 到 10 分;而在兩端,兩個平均數之一只根據少數學生(類別 0 的私立學校學生 9 名、四小時以上的公立學校學生 11 名)。在人數充足的中段範圍,兩條剖面線大致平行,提示公私立別的效果是可加的。由於私立學校學生自陳的作業時間也較多(平均作業時間類別 2.5 對 1.6),圖 4.2 中合併的作業時間斜率可能有一部分反映的是公私立別而非作業時間;這是區分校內關係與學校間關係的另一個理由。
公私立別是學校層次的變項,因此 (c) 圖比較的是兩組學校,而不是兩組學生;關於公私立差異的資訊量,主要取決於學校數(8 所私立、15 所公立),遠甚於學生人數。因此,第二層預測變項的圖示應該以學校為單位來閱讀,例如把學校平均數或學校斜率對學校變項作圖,就像第 3 章兩階段分析的第二階段那樣。
4.4.5曲線:多項式與仿樣函數#
圖示提示有曲線時,有兩種工具可以用來探索。多項式(polynomial)在模型中加入 (或許再加上 );它在資料中心附近很容易解釋,但在邊緣可能表現很差。迴歸仿樣函數(regression spline)在選定的點(節點,knots)把低次多項式片段接起來;自然三次仿樣函數(如圖 4.2(a))限制在最外側節點之外為線性,因此在邊緣比較穩定。兩者都是固定效果項,可以帶進多層次模型中。在探索階段,它們主要用來回答一個是非題:是否存在直線會錯過的彎曲?如果答案是肯定的,最終模型可以採用最容易解釋的形式,第 14 章會討論如何選擇。
4.5探索隨機部分#
4.5.1叢集內迴歸及其精確度#
模型中的隨機係數 與 在資料中有自然的估計值:每個叢集內 OLS 迴歸的截距與斜率,也就是第 3 章兩階段法的第一階段估計值。毛毛蟲圖(caterpillar display)把這些估計值依大小排序,連同信賴區間一起畫出(圖 4.5)。作業時間以其總平均數 1.97 平減,這個值幾乎恰好是類別 2(「一小時」),因此每個截距估計的是該校中作業時間等於總平均數的學生的期望分數。
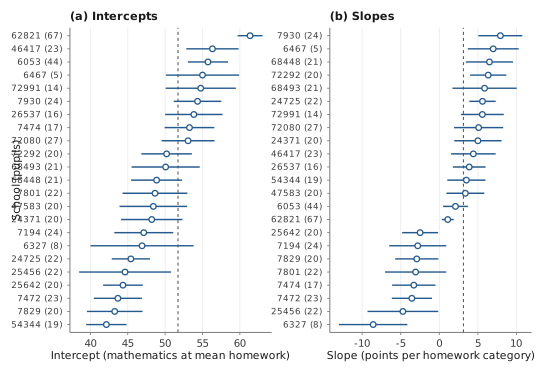
註:每一列為一所學校,標示學校識別碼,括號內為學生人數;各小圖內的列依估計值排序。空心圓為校內以作業時間預測數學成績之迴歸的 OLS 估計值(作業時間類別以其總平均數 1.97 平減);水平線段為以 分配為基礎的 95% 信賴區間。垂直虛線為合併 OLS 估計值。
毛毛蟲圖回答了格狀圖無法回答的問題:估計值的分散程度,是否大於光靠抽樣誤差所能產生的程度?如果所有學校的真實斜率都相同,估計斜率仍然會有差異,但分散程度會與其標準誤相當,而且大多數區間都會涵蓋合併值。(b) 圖的情況恰好相反。23 所學校中有 14 所的區間不包含合併斜率(有 21 所不包含零),而負斜率學校與正斜率學校的區間幾乎沒有重疊。依照第 3 章的邏輯,可以把同樣的比較粗略地量化:23 個 OLS 斜率的變異數為 21.8,而平均的標準誤平方只有 1.9,因此約有 的變異數看來反映了學校之間的真實差異。這個動差型估計值接近第 2 章隨機斜率模型的 REML 估計值 (表 2.2)。對截距做同樣的比較,得到 。兩項比較都顯示,隨機截距與斜率模型是分析這筆資料合理的起點。
毛毛蟲圖也提醒我們,各叢集的精確度並不相同。一所學校的區間取決於它的大小、殘差變異數,以及校內作業時間的分散程度。學校 62821 有 67 名學生,作業時間的範圍很廣,它的斜率區間最窄;在估計平均斜率時,多層次模型會給它最大的權數。不過在本例中, 遠大於每一所學校的抽樣變異數,因此各校權數的差異最多只有約四分之一,多層次估計值也與未加權的兩階段平均相差不遠;真實斜率差異很小時,加權的影響才最大。
4.5.2縱貫性資料的義大利麵圖#
對重複測量資料而言,隨機斜率所隱含的圖示是義大利麵圖(spaghetti display):每個人一條跨越時間的線。圖 4.6 呈現睡眠剝奪研究 (Belenky et al., 2003) 中 18 名受試者的反應時間,這筆資料隨 lme4 一起發布 (Bates et al., 2015)。lme4 的說明文件指出,第 0 天與第 1 天是適應與訓練日,第 2 天是基準線,睡眠剝奪從第 2 天之後才開始;和大多數教科書的分析一樣,這裡的圖示使用全部 10 天的資料。(a) 圖呈現觀察到的軌跡,(b) 圖呈現每位受試者的 OLS 迴歸線,兩個圖都畫出合併 OLS 迴歸線(反應時間平均每天增加 10.5 毫秒)。
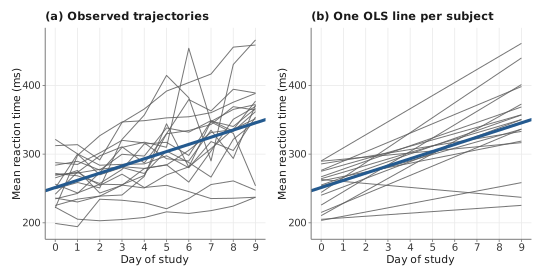
註:(a) 圖:每一條灰線連接 18 名受試者之一的每日平均反應時間。(b) 圖:每一條灰線為一名受試者的 OLS 迴歸線。兩個圖中的粗線皆為全部 180 筆觀察值的合併 OLS 迴歸線。
兩個圖的用途不同。(a) 圖中觀察到的軌跡呈現原始資料,包括逐日的雜訊與少數不規則的受試者;檢查資料錯誤與非線性變化時,應該看的就是這個圖示。(b) 圖中的配適線移除了雜訊,呈現隨機斜率模型所描述的兩個特徵:受試者的起始水準不同(OLS 截距的標準差為 29 毫秒),反應時間的變化速度也不同(斜率從每天 到 毫秒不等)。對學校所做的動差比較在這裡同樣適用:18 個 OLS 斜率的變異數為 43.0,而平均的標準誤平方只有 7.9。
4.5.3變異數函數#
隨機斜率還有第二個比較不明顯的後果。第 2 章說明過,這時結果變項的邊際變異數是預測變項的二次函數:
而在隨機截距模型下,它是常數 。由於初步固定部分的 OLS 殘差估計的是 ,殘差平方的期望值近似於式 (4.2)。因此,把殘差平方對 作圖,就能從不同於格狀圖與毛毛蟲圖的角度檢查隨機斜率。表 4.4 彙整了兩種模型下,殘差及其摘要統計量應該呈現的樣子;此表改編自課程講義的內容。
| 統計量 | 隨機截距 | 隨機截距與斜率 | 圖示 |
|---|---|---|---|
| 各叢集內 對 :平坦且平行,還是傾斜且呈扇形散開 | |||
| 對 :分散程度固定,還是隨 改變 | |||
| 附平滑曲線的 對 :平坦,還是二次曲線 | |||
| (給定 ) | 叢集內殘差變異數:各叢集相近 | ||
| 取決於 與 | 相關矩陣圖(縱貫性資料) |
註: 為叢集 中第一層單位 的殘差; 與 分別為殘差與預測變項的組平均數。這些式子忽略了 的估計誤差;叢集數目很多時,這項誤差很小。
圖 4.7 把這個圖示畫了三次。(a) 與 (b) 圖使用依課程講義中的模型所模擬的資料,有 100 個叢集、每個叢集 10 個單位,因此真相是已知的:(a) 只有截距有變異,(b) 斜率也有變異(,,,)。殘差平方嚴重右偏,因此眼睛必須依賴平滑曲線,而不是點雲。在 (a) 中,平滑曲線平坦,貼近真實的變異數 5;在 (b) 中,它沿著真實變異數函數 的 U 形變化,在觀察值很少的兩端則有預期中的雜訊。
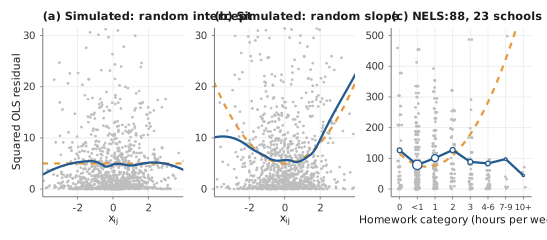
註:灰點為忽略叢集、以預測變項預測結果變項之 OLS 迴歸的殘差平方(NELS:88 的點在水平方向加入抖動)。(a) 與 (b) 圖:以 100 個叢集、每個叢集 10 個單位模擬的資料;實線曲線為 loess 平滑曲線,虛線曲線為真實的變異數函數。(c) 圖:實線連接各作業時間類別的殘差平方平均(圓圈面積與學生人數成正比);虛線曲線為第 2 章隨機截距與斜率模型之 REML 估計值所隱含的變異數函數。縱軸經過截斷。
(c) 圖把這個圖示用在 NELS:88 的學校上,畫出各作業時間類別的殘差平方平均。結果出人意料:沒有 U 形。除了類別 7(10 小時以上)的 3 名學生之外,殘差平方平均在約 80 到 127 之間變動,看不出趨勢;而第 2 章所配適的隨機斜率模型所隱含的變異數,則從類別 2(一小時)的約 76 上升到類別 5(四到六小時)的 283(虛線曲線)。格狀圖與毛毛蟲圖都強烈提示斜率差異很大,變異數函數卻沒有反映出來。這個不一致很有啟發性,至少有兩種解釋。第一,變異數函數描述的是各校迴歸線在作業時間每個值上的分散程度,而且每所學校的迴歸線都外推到整個範圍;圖示卻只看得到真正自陳有那麼多作業時間的學生。自陳四小時以上的 47 名學生(類別 5 至 7)中,有 22 名就讀同一所學校(62821),而 8 所負斜率學校在這個範圍內總共只有 4 名學生。在模型外推陡峭負斜率迴歸線的地方,資料幾乎沒有學生。第二,線性隨機斜率本身可能就不是正確的描述:校內關係可能在作業時間高時趨於平緩,正如合併平均數所顯示的。第三個比較平凡的因素也會使圖示變得模糊:殘差來自線性的初步固定部分,而合併平均數卻是彎曲的,因此配適不良會在某些作業時間類別上墊高殘差平方平均(這也是初步固定部分應該從寬的另一個理由)。不過,配適不良的平方最多約為 12(在類別 0),在類別 5 則幾乎為零,因此它無法解釋 U 形為何消失。這個圖示無法在這些解釋之間做出判斷,但它把隨機斜率的設定標記為第 6 與第 14 章需要仔細檢視的問題,例如另外為作業時間的學校間部分建立模型。
4.5.4相關矩陣圖#
模型的隨機部分也隱含同一叢集內各結果之間某種特定的相關型態,也就是第 2 章的邊際共變數矩陣 。在橫斷面資料中,叢集內的單位沒有自然的順序,而在隨機截距模型下,這個型態可以化約為單一個數字,也就是 ICC。在縱貫性資料中,測量時間點是有順序的,這個型態可以直接畫出來。把 OLS 殘差轉換成寬格式(每個時間點一欄),再計算它們跨受試者的相關:這就是圖 4.8 的 (a) 圖所示的相關矩陣圖(correlation map)。(b) 與 (c) 圖呈現兩個配適模型所隱含的相關:隨機截距模型對每一對日子都隱含相同的相關(.59,即複合對稱);隨機截距與斜率模型所隱含的相關,則隨兩天的間隔拉大而遞減,並隨研究進行而增加,正如圖 4.6(b) 中的線條呈扇形散開。
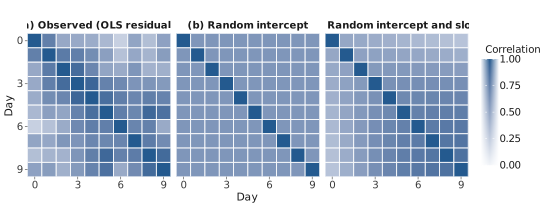
註:每一格呈現兩天之間的相關,值愈大顏色愈深。(a) 圖:以天數預測反應時間之合併 OLS 迴歸的殘差,在 18 名受試者之間的相關。(b) 與 (c) 圖:分別為隨機截距模型與隨機截距與斜率模型的 REML 估計值所隱含的相關。
觀察到的相關矩陣圖比較像 (c) 圖,而不像 (b) 圖:相隔遙遠的日子之間的相關(第 0 天與第 9 天:.52)低於相鄰日子之間的相關(平均 .80),而第 5 至 9 天之間的相關(平均 .74)略高於第 0 至 4 天之間的相關(平均 .68),不過差距遠小於隨機斜率模型所隱含的差距(.78 對 .51)。然而,這種相似並不全面:早期日子之間的相關比隨機斜率模型所隱含的更強;而就相隔最遠的那一對日子而言,觀察值比較接近隨機截距模型的值(.59),而不是隨機斜率模型的值(.30)。隨機斜率模型重現了大致的型態,卻沒有重現對角線附近的強度:相鄰日子的觀察相關(.80)超過模型所隱含的相關(.67)。這表示相鄰日子的殘差之間,存在隨機截距與隨機斜率所無法產生的額外相關;第 20 章會以自我相關的第一層誤差為這種型態建立模型。只有 18 名受試者時,每個觀察相關的標準誤大約在 .10 到 .20 之間,因此閱讀這張圖時應該看整體型態,而不是個別的格子。
4.6模擬多層次資料#
要了解多層次資料長什麼樣子,模擬是最快的方法。當資料由已知的模型產生時,每一個圖示與每一個估計值都可以和真相比較:圖 4.7 的 (a) 與 (b) 圖之所以能放心解讀,正是因為真實的變異數函數是已知的。在本書中,模擬還有另外三種用途。它可以檢查分析(軟體能否找回放進資料中的參數?)、評估方法(估計式的偏誤有多大?區間涵蓋真值的頻率有多高?),以及協助研究設計(要達到某個檢定力,需要多少個叢集?第 16 章)。
4.6.1plate 就是迴圈#
從模型圖出發,寫模擬程式最容易。圖 4.9 把隨機截距與斜率模型呈現兩次:一次是統一模型圖,一次是程式。兩者直接對應。代表固定參數的菱形,在任何迴圈開始之前設定一次。每一個 plate 都成為一個迴圈:學校 plate 是 的外層迴圈,巢套在其中的學生 plate 則是 的內層迴圈。每個節點都在包含它的最內層 plate 所對應的迴圈中產生。白色圓形 與 位於學校 plate 內,因此每所學校抽取一次,並從共變數矩陣為 的二元常態分配中聯合抽取(圖中的迴圈 、 與邊 )。灰底圓形 與 位於學生 plate 內,因此每位學生抽取一次; 則由它在圖中的父節點,加上一個變異數為 的殘差計算而得。同樣的讀法適用於本書的任何模型:三層次模型多一個第三層迴圈,交叉因子加入彼此不巢套的迴圈,二元結果變項則把最後一行改成從伯努利分配抽取。
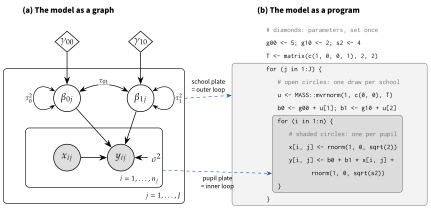
註:(a) 圖:隨機截距與斜率模型的統一模型圖(同圖 2.4(c))。(b) 圖:以明確的迴圈從該模型產生資料的 R 程式碼;淺灰色方框為學校迴圈,深灰色方框為學生迴圈。虛線箭頭把每一個 plate 連到它對應的迴圈。程式註解標示每一行所產生的圖形元素。
實務上,迴圈會改寫成向量化的程式碼,較短也快得多。本書模擬範本中的資料生成函式 gen_mlm() 以一次呼叫抽出全部 個叢集的隨機效果,一次抽出所有的 與 ,再利用每一列的叢集索引取出該叢集的隨機效果:
gen_mlm <- function(J, n, g00, g10, tau0sq, tau1sq, tau01, sigma2, var_x) {
  T <- matrix(c(tau0sq, tau01, tau01, tau1sq), 2, 2)
  u <- MASS::mvrnorm(J, mu = c(0, 0), Sigma = T)        # school plate
  d <- data.frame(cluster = rep(seq_len(J), each = n),   # pupil plate
                  x = rnorm(J * n, 0, sqrt(var_x)))
  d$y <- g00 + u[d$cluster, 1] + (g10 + u[d$cluster, 2]) * d$x +
         rnorm(J * n, 0, sqrt(sigma2))
  d
}4.6.2模擬範本#
模擬研究是一個小型實驗,應該像實驗一樣規劃與報告。Morris et al. (2019) 把規劃歸納為五個部分:目的(aims)、資料生成機制(data-generating mechanisms;母群模型與所操弄的條件)、估計目標(estimands;要估計的量)、所比較的方法(methods),以及表現指標(performance measures;偏誤、實徵標準誤與以模型為基礎的標準誤、涵蓋率,以及它們的蒙地卡羅標準誤)。本書的範本 sim_ch04_template_V01.R 以六個有標籤的區塊實作這項規劃,後續各章的每一個模擬程式都使用相同的區塊:套件與設定;模擬條件(每個條件一列,各有自己的亂數種子);資料生成函式;分析函式;主迴圈,它把每個完成的條件存成檢查點檔案、重新啟動時略過已儲存的條件,並顯示進度;以及結果匯出,它把每一次重複的結果連同條件、亂數種子與 R 工作階段資訊,以 .rds 與 .csv 格式儲存。另一個分析程式(analysis_ch04_template_V01.R)讀取儲存的結果並產生摘要表,因此要修改表格時,永遠不必重新執行耗時的模擬。SimDesign (Chalmers & Adkins, 2020) 等套件以現成的形式提供相同的結構。
範本的示範研究探討第 3 章提出的一個問題:如果斜率有變異,模型卻只有隨機截距,平均斜率 的推論會發生什麼事?資料由圖 4.9 的隨機截距與斜率模型產生,參數值取自課程講義(,,,,,);叢集數為 20 或 100,每個叢集 5 或 20 個單位,每個條件重複 500 次。每一個資料集都分別以隨機截距模型與正確的隨機截距與斜率模型分析(REML,lme4)。整個研究大約兩分鐘就能跑完。
| 模型 | 偏誤 | 實徵 | 模型 | 涵蓋率 (%) | 奇異 (%) | 平均 | ||
|---|---|---|---|---|---|---|---|---|
| 20 | 5 | RI | 0.013 | 0.306 | 0.179 | 75.8 (1.9) | ||
| RIS | 0.012 | 0.278 | 0.274 | 94.2 (1.0) | 8.8 | 0.99 | ||
| 20 | 20 | RI | 0.010 | 0.240 | 0.087 | 52.6 (2.2) | ||
| RIS | 0.005 | 0.234 | 0.232 | 91.8 (1.2) | 0.0 | 0.99 | ||
| 100 | 5 | RI | 0.008 | 0.136 | 0.081 | 73.2 (2.0) | ||
| RIS | 0.003 | 0.126 | 0.126 | 93.4 (1.1) | 0.0 | 1.00 | ||
| 100 | 20 | RI | 0.002 | 0.112 | 0.039 | 49.4 (2.2) | ||
| RIS | 0.002 | 0.108 | 0.105 | 94.4 (1.0) | 0.0 | 1.00 |
註: 為叢集數; 為叢集大小;RI 為隨機截距模型;RIS 為隨機截距與斜率模型(真實模型)。資料由 、 的隨機截距與斜率模型產生;每個條件重複 500 次。偏誤為估計值的平均減去 2;實徵 為估計值的標準差;模型 為估計標準誤的平均;涵蓋率為名目 95% Wald 區間包含 2 的百分比,括號內為其蒙地卡羅標準誤;奇異為變異數或相關估計值落在參數空間邊界上的配適所占的百分比;平均 為斜率變異數 REML 估計值的平均。
表 4.5 呈現結果。兩個模型估計平均斜率的偏誤都可以忽略:相對於真值 2,偏誤的絕對值從未超過 0.013。主要的差別在標準誤。隨機截距模型報告的標準誤遠遠太小:在最大的條件中為 0.04,而其估計值的實際變異是 0.11;因此它的名目 95% 區間只在 49% 到 76% 的情況下涵蓋真值。隨機截距與斜率模型報告的標準誤與實徵標準誤相符,涵蓋率也接近 95%,只在 20 個叢集、每個叢集 20 個單位時略低(91.8%),這是第 10 章要處理的小樣本問題。在 20 個叢集、每個叢集 5 個單位時,正確模型的配適有 8.8% 是奇異的:即使隨機效果的共變數矩陣在母群中並不奇異,資料也太稀少,無法估計它(第 9 與第 11 章)。在每個條件下, 的 REML 估計值平均都接近真值 1。
4.7可重現的專案架構#
多層次分析會產生許多檔案:原始資料、衍生資料、資料管理、探索、模型與繪圖的程式,以及這些程式產生的輸出。每個專案都使用固定的資料夾架構,能讓他人、也讓作者自己在一年後重現這些工作。本書使用、也建議習題與上機實作使用的架構如下:
project/
  README.md          purpose, data sources, build order, software versions
  Data/raw/          original files, never edited (read-only)
  Data/              analysis files built by scripts (.rds and .csv)
  Scripts/           one script per task, numbered in run order
  Results/           model objects, simulation output, checkpoints
  Figures/  Tables/  outputs, always regenerated from scripts
  Notes/             decisions, open questions, the EDA memo
有幾個習慣能讓這套架構發揮作用 (Wilson et al., 2017)。原始資料永遠不編輯;所有更動都在程式中進行,由程式讀取原始檔案並寫出新檔,如此一來,從原始資料到報告中的每一個數字,路徑都可以追溯。每一張圖與每一個表格都由程式產生,輸出檔永遠不手動修改。程式透過一個根目錄變數(本書為 MLM_BOOK_ROOT)指向檔案,因此只要改一行,專案就能在另一台電腦上執行。會抽取亂數的程式要設定亂數種子。程式有實質修改時,以新的版本字尾(_V01、_V02)另存,而不是覆寫先前的版本,如此一來,產生已發表結果的那個程式就能一直保留。最後,把所使用的 R 與套件版本和結果一起記錄下來,例如像模擬範本那樣使用 sessionInfo(),或使用 renv 套件完整記錄整個套件庫。
關鍵詞#
- 毛毛蟲圖(caterpillar display)
- 組平均數(cluster mean)
- 相關矩陣圖(correlation map)
- 資料稽核(data audit)
- 組平減與總平減(group-mean and grand-mean centering)
- 作為鍵值的識別碼(key (identifier))
- 第一層與第二層檔案(level-1 and level-2 files)
- 長格式與寬格式(long and wide format)
- 多對一合併(many-to-one merge)
- 依共變項分組的平均數圖(means-by-covariate display)
- 初步固定部分(preliminary fixed part)
- 迴歸仿樣函數(regression spline)
- 單一觀察值叢集(singleton cluster)
- 義大利麵圖(spaghetti display)
- 格狀圖(trellis display)
- 變異數函數(variance function)
- 模擬範本(simulation template)
- plate 就是迴圈(plates as loops)
習題#
A. 觀念題#
針對下列每一個模型元素,說出可以檢查它的圖示,並描述若不需要該元素,圖示會呈現什麼樣子:(a) 隨機截距;(b) 隨機斜率;(c) 共變數 ;(d) 學生層次預測變項與學校層次預測變項之間的交互作用。
一位研究者把 4,800 列的學生檔與 120 列的學校檔合併,得到一個 5,230 列的分析檔。請列出可能的原因,以及能找出問題的檢查方法。
請說明為什麼組平減預測變項在每一個單一觀察值叢集中都恰好為零,以及這對單一觀察值叢集能為叢集內斜率提供多少資訊有何意涵。
在圖 4.4 的 (c) 圖中,公私立比較的精確度取決於 23 所學校,而不是 519 名學生。請說明原因,並舉出一種以學校為單位的圖示。
B. 推導題#
請證明:把組平減變項 與總平減的組平均數 相加,可以得到總平減的原始變項;並證明在樣本中,組平減變項與每一個叢集層次變項都不相關。 解答 →
請利用第 4.4 節的「技術細節」方框「多層次模型下的 OLS」,證明在隨機截距與斜率模型下, 的 OLS 估計式是不偏的,並推導其共變數矩陣。在什麼條件下,一般的 OLS 共變數矩陣才是正確的? 解答 →
在隨機截距與斜率模型下,把 視為已知,推導 ,並證明變異數函數的最小值位於 。就第 2 章的 NELS:88 估計值而言,最小值位於何處? 解答 →
若各叢集大小相等、 的分散程度也相同,請證明叢集內 OLS 斜率的期望變異數為 ,其中 為斜率共同的抽樣變異數。請利用這個結果,說明第 4.5 節中動差比較的合理性。 解答 →
C. 計算題#
從
timss_pupils.csv與timss_schools.csv以經過檢查的多對一合併建立 TIMSS 分析檔。計算n_j、grpMmath、grpCmath與OCmath,並驗證grpCmath在每所學校的平均都是零。請重現表 4.1 中 TIMSS 的各列。 解答 →以科學成績為結果變項、數學成績為預測變項,畫出 TIMSS 版本的圖 4.3(隨機抽取 25 所學校)、圖 4.5 與圖 4.7(c)。這些圖示提示了哪一種模型?
把 Junior School Project 資料從長格式轉換成寬格式,再轉換回來,並檢查沒有遺失任何資訊。為某一所學校的學生畫一張義大利麵圖。
只使用睡眠剝奪研究第 2 至 9 天的資料,畫出圖 4.8(a) 的相關矩陣圖。型態有改變嗎?
D. 模擬題#
使用
gen_mlm(),以 (其他參數值同圖 4.7b)模擬一個資料集,並畫出變異數函數圖示。它的最小值在哪裡?與習題 B3 的結果一致嗎? 解答 →把
sim_ch04_template_V01.R另存一份_V02,並加入 個叢集的條件。隨機截距與斜率模型的涵蓋率與奇異配適的百分比如何改變?請報告蒙地卡羅標準誤。
E. 應用小專題#
為 TIMSS 科學成績寫一份一頁的探索性備忘錄。內容包括資料稽核、你認為最有資訊量的圖示(不超過四個),以及這些圖示所提示的模型項清單,每一項都註明是哪一個圖示提示的。說明其中哪些項你會在驗證性分析中檢定,以及理由。
上機實作#
延伸閱讀#
- Tukey (1977)
-
經典之作,把探索性資料分析確立為一個獨立的階段。
- Cleveland (1993)
-
條件圖、多向點圖、平滑曲線,以及格狀圖所依據的圖形知覺原則。
- Raudenbush 與 Bryk (2002, 第 9 章); Snijders 與 Bosker (2012, 第 10 章)
-
檢查階層線性模式的假定,包括如何運用叢集內 OLS 估計值與殘差。
- Wickham (2014); Wickham et al. (2023)
-
整齊資料,以及用於合併、長寬格式轉換與分組計算的 R 工具。
- Enders 與 Tofighi (2007)
-
橫斷面多層次模型中平減的標準參考文獻;可作為第 7 章的預習。
- Morris et al. (2019)
-
如何規劃、執行與報告模擬研究。
- Wilson et al. (2017)
-
組織資料、程式碼與結果的實用習慣。