從變異數分析與迴歸到多層次模型
本章架構固定效果與隨機效果變異數分析;忽略叢集的迴歸;組內、組間與整體迴歸;兩階段法及其問題;以多層次模型作為修補;替代做法:固定效果迴歸與叢集穩健標準誤。
本書讀者已經熟悉兩種經常用來分析分組資料的工具:變異數分析(analysis of variance, ANOVA)比較各組平均數,迴歸則描述結果變項與預測變項之間的關係。本章把這兩種工具依序用在同一筆小型資料上:NELS:88 中十所學校、260 名學生的數學成績與作業時間。每一種分析都能把一個問題回答得很好,卻在另一個問題上失靈。這些失靈很有啟發性,因為每一個都指向多層次模型的某項特徵;讀到本章結尾,多層次模型看起來不再是一種新技術,而是對這些熟悉方法自然而然的修補。本章的鋪陳依循多年來作為本課程開場的「叢集資料的模型」(Models for clustered data)一講 (另見 Snijders & Bosker, 2012, 第 3 章)。
3.1十所學校#
本章的資料取自第 1 章介紹的 23 所 NELS:88 學校中的十所:九所公立學校與一所私立學校,共 260 名學生(表 3.1)。各校學生人數從 20 到 67 人,數學平均分數從 42.1 到 62.8。表中最後兩欄預告了第 3.6 節的內容:它們是在每所學校內以作業時間預測數學成績的普通最小平方法(ordinary least squares, OLS)迴歸所得的截距與斜率,以及各自的標準誤。
| 數學 | 第一階段 OLS | ||||||
|---|---|---|---|---|---|---|---|
| 學校 | 公私立別 | 平均數 | SD | 平均 SES | (SE) | (SE) | |
| 7472 | 公立 | 23 | 45.7 | 7.5 | 0.48 | 50.7 (2.2) | 3.55 (1.25) |
| 7829 | 公立 | 20 | 42.1 | 8.3 | 0.85 | 49.0 (3.6) | 2.92 (1.33) |
| 7930 | 公立 | 24 | 53.2 | 11.5 | 0.15 | 38.8 (2.9) | 7.91 (1.37) |
| 24725 | 公立 | 22 | 43.5 | 10.0 | 0.70 | 34.4 (1.8) | 5.59 (0.82) |
| 25456 | 公立 | 22 | 49.9 | 8.4 | 0.20 | 53.9 (2.5) | 4.72 (2.20) |
| 25642 | 公立 | 20 | 46.4 | 4.3 | 1.07 | 49.3 (1.5) | 2.49 (1.11) |
| 62821 | 私立 | 67 | 62.8 | 5.7 | 1.04 | 59.2 (1.4) | 1.09 (0.39) |
| 68448 | 公立 | 21 | 49.7 | 10.3 | 0.17 | 36.1 (3.5) | 6.50 (1.46) |
| 68493 | 公立 | 21 | 46.3 | 9.6 | 0.46 | 38.5 (3.2) | 5.86 (1.99) |
| 72292 | 公立 | 20 | 47.9 | 11.3 | 0.50 | 37.7 (2.4) | 6.34 (1.12) |
註: 為學生人數;SES 為社經地位(socioeconomic status,在完整的 NELS:88 樣本中標準化); 與 為各校內以作業時間類別預測數學成績之 OLS 迴歸的截距與斜率,括號內為標準誤。
圖 3.1 呈現接下來各種分析的兩個極端。(a) 圖是對全部 260 名學生配適的一條迴歸線,彷彿學校並不存在;(b) 圖則為每一所學校各畫出一條迴歸線。單一迴歸線顯示,作業時間每增加一個類別,數學成績約提高 3.6 分。各校的迴歸線說的則是比較複雜的故事:有五所學校的線陡峭上升,四所下降,而那所私立學校(最上方那條長線)的線只略微上升。
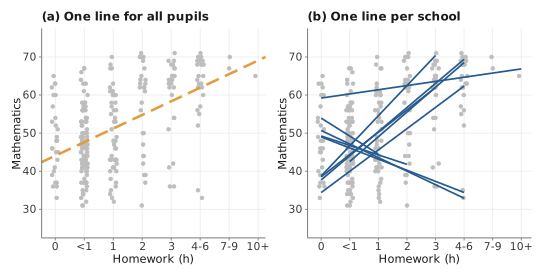
註:灰點為學生,並在水平方向加入抖動(jitter)。(a) 圖:虛線為全部 260 名學生的 OLS 迴歸線。(b) 圖:每一條實線為一所學校的 OLS 迴歸線,只畫在該校觀察到的作業時間範圍內。
3.2將學校視為固定的變異數分析#
先暫時不管作業時間,只問十所學校的數學平均數是否不同。單因子 ANOVA 模型為
其中 為總平均數, 為學校 的效果(須加上限制條件,例如 ), 為學生 與學校 平均數的離差。學校平均數 以觀察到的平均數 估計, 則以校內均方估計。若寫成迴歸,式 (3.1) 為每一所學校各設一個虛擬變項、不設截距(或設一個截距再加上 個虛擬變項),學校效果就是一般的迴歸係數。
表 3.2 的 (a) 部分是 ANOVA 表。十所學校平均數之間的差異,遠大於校內學生之間的變異所能預期的程度,,;校內變異數的估計值為 。
| (a) 變異數分析 | |||||
|---|---|---|---|---|---|
| 變異來源 | df | SS | MS | F | p |
| 學校間 | 9 | 14,031 | 1,558.9 | 21.55 | |
| 校內 | 250 | 18,086 | 72.3 | ||
| (b) 隨機效果估計值 | |||||
| 估計式 | ICC | ||||
| ANOVA(動差法) | 59.00 | 72.34 | .45 | ||
| REML | 34.01 | 72.26 | .32 | ||
註:df 為自由度;SS 為平方和;MS 為均方。 為學校間變異數的估計值; 為校內變異數的估計值;ICC 為組內相關係數。ANOVA(動差法)估計式為 ,其中 ;REML 為限制最大概似估計。
這個分析把學校視為固定(fixed):這十所學校就是我們關心的整個母群,結論只涉及這十所學校,不及於其他學校。如果某個學區想比較轄下的十所學校,這樣做很恰當。但如果這十所學校只是一個樣本,而研究問題關心的是一般的學校,例如學校在母群中差異有多大,或某項學校特徵與學業成就有何關係,這樣做就不恰當。固定效果 ANOVA 沒有任何參數代表「學校之間一般而言差異多大」;而且因為每所學校都有自己的參數,它無法納入學校層次的預測變項,例如公私立別或平均 SES:每一個學校層次變項都和學校虛擬變項完全共線。
3.3將學校視為隨機的變異數分析#
如果把這些學校視為從學校母群中抽出的隨機樣本,學校效果就成為隨機變數。隨機效果變異數分析(random-effects ANOVA)的模型為
其中 與 相互獨立。這就是第 1 與第 2 章的虛無多層次模型(empty model)。不論學校有幾所,它都只有三個參數:母群平均數 、學校間變異數 與校內變異數 。如第 2 章所示,這個模型意味著每位學生分數的變異數都是 ,同校任兩位學生的共變數都是 (複合對稱),因此組內相關係數(intraclass correlation coefficient, ICC) 就是同校兩位學生分數之間的相關。
3.3.1估計變異成分#
古典的估計式來自 ANOVA 表。校內均方的期望值為 ,學校間均方的期望值為 ,其中 是一種平均學校大小,當每所學校都有 名學生時就等於 (Searle et al., 1992)。令均方等於各自的期望值,便得到動差法(ANOVA)估計式
就這十所學校而言,,ICC 為 .45。許多多層次軟體預設使用的限制最大概似估計(restricted maximum likelihood, REML;第 9 章)則得到 ,ICC 為 .32(表 3.2 的 (b) 部分)。
兩個估計值為什麼差這麼多?如果各校人數相等,而且 ANOVA 估計值為正,兩種方法的結果會一致;人數不等時,兩者對各校的加權方式就不同。學校間均方以學校人數為權數,加權各校平均數與總平均數的離差,因此那所大型私立學校(67 名學生,平均數比其他九校平均數的未加權平均高出約 15.6 分)主導了這個均方。REML 則依各校平均數估計母群平均數的精確度來加權;一旦 相對於 很大,精確度的成長就遠比學校人數慢。同樣的加權方式也反映在總平均數的估計上:全部 260 名學生的平均數為 51.3,十個學校平均數的未加權平均為 48.8,而 REML 估計值 ()介於兩者之間,而且明顯更接近未加權平均。只有十所學校時,任何 的估計值都不精確,第 16 章會進一步討論這一點。
3.3.2完全合併、不合併與部分合併#
圖 3.2 把到目前為止的分析放在同一個尺度上。(a) 圖是完全合併(complete pooling):忽略學校,對所有學生只估計一個平均數。(b) 圖是不合併(no pooling):為每所學校各估計一個彼此無關的平均數;圖中的平均數 是學校 plate 內的一個菱形,每校一個固定參數,彼此之間沒有任何連結。(c) 圖是部分合併(partial pooling):把學校平均數 視為從同一個分配中抽出的值;菱形已提升為白色圓形,並有父節點 與變異數 (第 2 章)。這些名稱出自 Gelman 與 Hill (2007)。
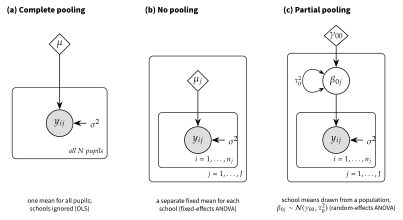
註: 平均數之三個模型的統一模型圖(Unified Model Graph, UMG)。菱形為固定參數;白色圓形為隨機的學校平均數,其變異數以迴圈 表示;灰底圓形為觀察到的結果變項;短箭頭代表殘差變異數 。(a) 圖中,單一個 plate 涵蓋所有學生;(b) 與 (c) 圖中,學生 plate 巢套在學校 plate 之內。
部分合併的模型會在學校之間借用資訊。每所學校的平均數,部分由該校自己的學生估計,部分借助其他學校;一所學校的學生人數愈少、校內變異數 相對於學校間變異數愈大,它的估計值就愈被拉向總平均數。第 12 章會推導這些估計值,也就是所謂的經驗貝氏(empirical Bayes)估計值或收縮(shrinkage)估計值。這裡只需指出:正是部分合併,讓模型能夠納入學校層次的預測變項(學校平均數的變異由模型來描述,而不是被虛擬變項吸收),並能對學校母群做出推論。
3.4忽略學校的迴歸#
現在把作業時間加回來。以作業時間預測全部 260 名學生數學成績的 OLS 迴歸(圖 3.1a),得到斜率 3.57,標準誤 0.39。這個結果有兩個問題。第一個是標準誤。OLS 假定 260 個殘差彼此獨立,但同校學生共享了讓自己學校與眾不同的種種因素,因此同一所學校內的殘差彼此相關。如第 1 章所示,這時 OLS 標準誤通常會太小。叢集穩健標準誤(cluster-robust standard error)(又稱三明治標準誤)允許同校殘差之間有任意形式的相關 (Liang & Zeger, 1986),其值為 0.77(採用 CR1 小樣本校正),是 OLS 值的兩倍;換句話說,資料中關於這個斜率的資訊,只有 OLS 所假定的四分之一左右。此外,只有十個叢集時,即使是叢集穩健標準誤,也很可能仍然太小(第 10 章)。
第二個問題是斜率的意義。即使標準誤正確,這個合併(pooled)斜率描述的也是這 260 名學生中作業時間與數學成績之間的整體(total)關係。這個關係混合了兩件不同的事:比同校同學寫更多作業的學生,和這些同學有何不同;以及學生寫較多作業的學校,和其他學校有何不同。下一節就把兩者分開。
3.5組內、組間與整體迴歸#
在迴歸中加入式 (3.1) 的學校虛擬變項,就得到共變數分析(analysis of covariance, ANCOVA)模型
其中每所學校有自己的截距 ,所有學校則共用同一個斜率 。由於學校截距吸收了學校之間的一切差異, 只能由學校內學生之間的差異來估計;它是合併校內斜率(pooled within-school slope)。就這十所學校而言,()。這個模型也稱為固定效果迴歸(fixed-effects regression),是「控制」叢集時廣為使用的做法(第 3.8 節)。
與此互補的分析,是以十所學校的作業時間平均數預測十所學校的數學平均數。這個學校間迴歸(between-school regression)只利用學校之間的差異,斜率為 4.98(,自由度為 8)。學生寫較多作業的學校,數學平均數高出許多;但只有十所學校,這個斜率非常不精確,而且學校間的關聯可能反映了學校之間的許多其他差異(作業時間最多的學校就是那所私立學校,而它的平均 SES 也最高)。
整體斜率 3.57 介於組內斜率(2.14)與組間斜率(4.98)之間。更精確地說,整體 OLS 斜率是組內斜率與某個組間斜率的加權平均。這個組間斜率以學校人數為權數加權各校平均數,本例為 7.01,比 4.98 陡得多,因為最大的那所學校在作業時間與數學成績上的平均數都最高;兩個斜率的權數則是作業時間的組內與組間平方和各自所占的比例(.706 與 .294:)(Cronbach, 1976; Snijders & Bosker, 2012)。習題 B3 推導這個恆等式,解答見附錄 G。若預測變項的變異大多位於學校內,整體斜率就接近組內斜率;若大多位於學校間,整體斜率就接近組間斜率。第 7 章說明多層次模型如何藉由納入預測變項的學校平均數同時估計這兩個斜率,以及為什麼兩者之差,也就是脈絡效果(contextual effect),常有實質的研究意義。
3.6兩階段法#
在多層次軟體普及之前,研究者若想探討某個關係在各校之間如何變化,常見的做法是分兩個階段進行,也就是兩階段法(two-stage approach)(Burstein, 1980)。在第一階段,於每所學校內分別配適一個迴歸。在第二階段,把估計出來的截距與斜率當作結果變項,再以學校特徵對它們進行迴歸。這就是第 2 章「以斜率為結果變項」(slopes as outcomes)的想法,只是改以手動方式執行。
3.6.1第一階段#
表 3.1 的最後兩欄是第一階段的結果。斜率從每個作業時間類別 分到 分不等;標準誤則從 0.39(私立學校,有 67 名學生,作業時間的分布範圍也很廣)到 2.20(學校 25456,22 名學生自陳的作業時間都很少)。六個斜率明顯為正,四個為負。十個斜率的未加權平均為 1.96,標準誤為 。
3.6.2第二階段#
圖 3.3 把第一階段的估計值對學校平均 SES 作圖;學校平均 SES 是一個學校層次的(組成)變項。由於作業時間沒有平減,截距是作業時間類別為 0 時預測的數學成績。以未加權 OLS 用平均 SES 預測十個截距,得到的係數為 5.12();預測十個斜率則為 1.73()。兩者都不顯著,而且只有十個資料點,兩者也都不可能精確。
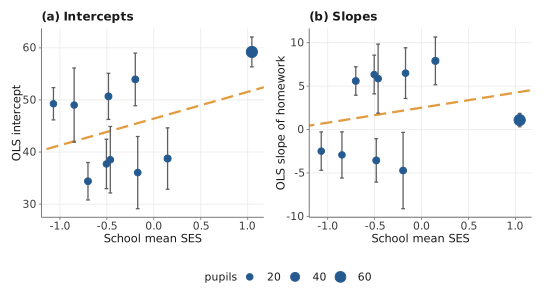
註:每一點為一所學校在第一階段的 OLS 估計值(點的面積與學生人數成正比);垂直線段向上下各延伸兩個標準誤。虛線為十個估計值對學校平均 SES 的未加權 OLS 迴歸線。
3.6.3兩階段法的問題#
從圖中可以一眼看出主要的問題。第一,十個估計值的精確度並不相同:各校斜率的標準誤相差超過五倍,第二階段迴歸卻給每所學校相同的權數。第二,估計斜率之間的變異有兩個來源,即各校真實斜率的差異與每個估計值的抽樣誤差,而兩階段法並不會把兩者分開;因此,估計斜率的標準差(5.0)會高估真實斜率之間的差異。第三,學生人數少或預測變項變異小的學校,估計值並不穩定;學生人數比迴歸係數還少的學校完全無法分析,人數恰好等於係數個數的學校則得不到標準誤。第四,若某個第一層變項在某所學校中剛好沒有變異(例如單一性別學校中的性別變項),該校的第一階段迴歸就無法估計。第五,整筆資料沒有單一的模型,因此沒有概似函數、沒有整體檢定,也無法加上限制條件,例如讓某些變項有共同的斜率。以抽樣變異數的倒數為權數進行第二階段迴歸,也只能部分解決第一個問題,因為正確的權數還取決於真實斜率的變異數,而這個變異數是未知的 (Raudenbush & Bryk, 2002)。
兩階段迴歸作為探索性工具,仍然很有價值。在配適多層次模型之前,用它來檢視資料是很自然的做法(第 4 與第 14 章);表 3.1 與圖 3.3 正是任何多層次分析之前都應該先做的那種呈現。但作為推論性工具,它已由多層次模型取代。
3.7修補之道:用一個模型處理兩個階段#
多層次模型同時估計兩個階段。以第 2 章的隨機截距與斜率模型為例,
第一階段對應第一層方程式,第二階段則對應第二層方程式。差別在於,多層次模型把學校係數視為無法觀察的隨機量,其變異數為 與 、共變數為 ;它把這些變異數與抽樣誤差分開估計,並據此為每所學校加權。
就這十所學校而言,隨機截距與斜率模型估計的平均斜率為 2.04()。這個大標準誤是誠實的:各校斜率差異很大,而用來估計其平均的學校只有十所。表 3.3 與圖 3.4 彙整了本章得到的七個「作業時間效果」估計值。
| 方法 | 估計值描述的對象 | 估計值 | SE |
|---|---|---|---|
| 合併 OLS | 整體關係 | 3.57 | 0.39 |
| 合併 OLS,叢集穩健標準誤 | 整體關係 | 3.57 | 0.77 |
| 學校間(學校平均數) | 學校間關係 | 4.98 | 2.42 |
| 固定效果(學校虛擬變項) | 合併校內關係 | 2.14 | 0.38 |
| 兩階段(各校斜率的平均) | 各校斜率的平均 | 1.96 | 1.57 |
| 隨機截距模型 | 組內與組間關係的加權混合 | 2.21 | 0.38 |
| 隨機截距與斜率模型 | 各校斜率的平均 | 2.04 | 1.55 |
註:估計值的單位為每個作業時間類別的數學分數。SE 為標準誤:OLS 與固定效果採用以模型為基礎的標準誤;第二列為叢集穩健標準誤(CR1);學校間一列為以十個學校平均數進行迴歸的 OLS 標準誤(自由度 8);兩階段平均為 ;兩個多層次模型為 REML 以模型為基礎的標準誤。
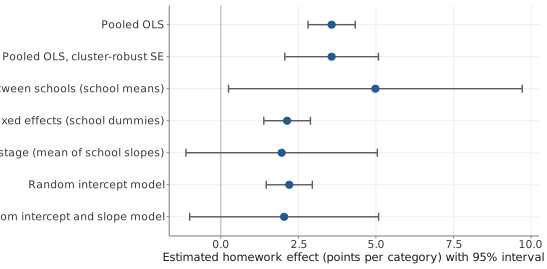
註:點為表 3.3 中的估計值;水平線段向左右各延伸 1.96 個標準誤(學校間與兩階段兩列若改用 區間,自由度分別為 8 與 9,區間會寬 15% 至 18%)。垂直線標示零的位置。
這七列之所以不同,有兩種原因,而且務必把兩者分清楚。有些列不同,是因為它們估計的是不同的量:整體關係(3.57)、學校間關係(4.98)、合併校內關係(2.14),以及各校斜率的平均(1.96 與 2.04)。隨機截距模型(2.21)估計的是組內關係與組間關係依精確度加權的混合;由於作業時間的資訊大多位於學校內,此處這個值接近組內斜率。第 7 章說明如何在多層次模型中把兩者分開。它們的標準誤之所以也不同,則是因為各方法對誤差做了不同的假定:合併 OLS 的標準誤(0.39)假定獨立,因而太小;叢集穩健標準誤(0.77)允許相依;隨機截距模型的標準誤(0.38)只有在每所學校的作業時間斜率都相同時才正確,而圖 3.1(b) 顯示這並不合理。在以模型為基礎的標準誤中,只有隨機斜率模型的標準誤考慮了斜率的變異,它是隨機截距模型標準誤的四倍。第 6 章會再回到這個結果,它是應用多層次模型中最重要的結果之一:遺漏了實際存在的隨機斜率,會使對應的固定效果標準誤太小。
3.7.1修補帶來多少好處?一個模擬#
叢集大小相等、且預測變項在各叢集內的分散程度相近時,兩階段平均與多層次估計值幾乎相同;叢集大小不等時則不然。一個小型模擬可以呈現兩者的差異(圖 3.5、表 3.4)。模擬產生 20 個叢集,第一層預測變項服從標準常態分配,真實平均斜率為 0.30,隨機截距的變異數為 0.25,第一層變異數為 1。叢集大小分為平衡(22 或 23)與不平衡(10 個叢集各有 5 個單位、10 個叢集各有 40 個單位)兩種,總單位數同為 450;斜率變異數則為 0 或 0.05。每個條件重複 1,000 次,比較平均斜率的三種估計式:兩階段平均、合併 OLS,以及隨機截距與斜率模型。
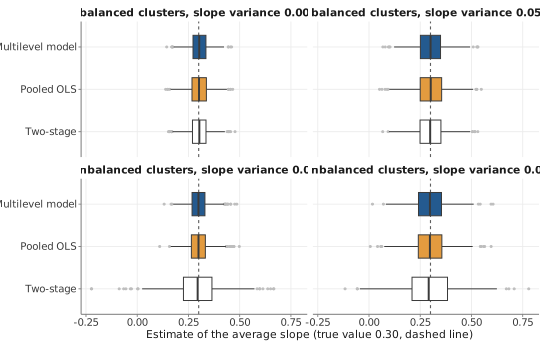
註:每種估計式在每個條件下 1,000 個估計值的盒形圖;盒子表示四分位數,鬚線最多延伸至盒子外 1.5 倍四分位距,點標示超出鬚線的估計值。垂直虛線標示真值 0.30。每個條件都有 20 個叢集、450 個單位。
| 叢集大小 | 估計式 | 偏誤 | 實徵 SD | 平均 SE | 涵蓋率 | |
|---|---|---|---|---|---|---|
| 0.00 | 平衡 | 兩階段 | 0.002 | 0.050 | 0.050 | .948 |
| 0.00 | 平衡 | 合併 OLS | 0.002 | 0.052 | 0.052 | .952 |
| 0.00 | 平衡 | 多層次模型 | 0.002 | 0.048 | 0.052 | .959 |
| 0.00 | 不平衡 | 兩階段 | 0.004 | 0.112 | 0.108 | .965 |
| 0.00 | 不平衡 | 合併 OLS | 0.001 | 0.053 | 0.052 | .949 |
| 0.00 | 不平衡 | 多層次模型 | 0.001 | 0.049 | 0.052 | .957 |
| 0.05 | 平衡 | 兩階段 | 0.000 | 0.073 | 0.070 | .949 |
| 0.05 | 平衡 | 合併 OLS | 0.001 | 0.078 | 0.054 | .836 |
| 0.05 | 平衡 | 多層次模型 | 0.001 | 0.074 | 0.069 | .926 |
| 0.05 | 不平衡 | 兩階段 | 0.004 | 0.127 | 0.120 | .941 |
| 0.05 | 不平衡 | 合併 OLS | 0.002 | 0.085 | 0.053 | .788 |
| 0.05 | 不平衡 | 多層次模型 | 0.003 | 0.081 | 0.075 | .912 |
註: 為真實的斜率變異數。偏誤為估計值的平均減去 0.30;實徵 SD 為 1,000 個估計值的標準差;平均 SE 為估計標準誤的平均;涵蓋率為名目 95% 區間包含 0.30 的比例(兩階段平均使用自由度為 19 的 區間,合併 OLS 使用 OLS 的 區間,多層次模型使用 Wald 區間)。
三種估計式基本上都是不偏的,差別在於精確度,以及標準誤是否誠實。叢集大小平衡時,兩階段平均與多層次估計值同樣精確。叢集大小不平衡時,兩階段平均的精確度就差得多:斜率沒有變異時,它的實證標準差是多層次估計值的兩倍以上(0.112 對 0.049),斜率有變異時約為 1.6 倍(0.127 對 0.081),因為它給只有 5 個單位的叢集與有 40 個單位的叢集相同的權數。合併 OLS 的精確度與多層次估計值相當,但斜率有變異時,它的標準誤遠遠太小,95% 區間只在 79% 至 84% 的樣本中包含真值。多層次模型則既有效率又近乎誠實:它的 Wald 區間在 91% 至 96% 的樣本中涵蓋真值。在 20 個叢集且斜率有變異的情況下略有涵蓋不足,這是小樣本問題,第 10 章介紹的校正方法可以處理。
3.8另外兩種修補方式#
多層次模型並不是處理叢集資料的唯一方法,有兩種替代做法值得在此先初步認識;第 7 與第 32 章會詳細比較它們 (Huang, 2016; McNeish et al., 2017)。
固定效果迴歸(式 (3.4))為每一個叢集納入一個虛擬變項。它移除了所有組間差異,因此它的第一層斜率是純粹的組內效果,不受任何叢集特徵的混淆,不論這些特徵是否觀察得到。代價是:無法研究任何叢集層次的變項(它們會被虛擬變項吸收);無法對樣本以外的叢集做出推論;而且除非加入與每一個叢集的交互作用,否則就得假定第一層斜率在所有叢集中都相同。若斜率並不相同,合併組內斜率就是各叢集斜率的加權平均;它的標準誤就像表 3.3 中隨機截距模型的標準誤一樣,只描述樣本中的這些叢集,因而低估了叢集母群中平均斜率的不確定性。
叢集穩健標準誤仍使用一般的迴歸(或其他任何單一層次模型),但計算標準誤時允許同一叢集的殘差以任何方式相關。它修正了標準誤,卻沒有為相依性建立模型。它不改變 OLS 估計值,因此估計的仍是整體關係;需要足夠多的叢集才能表現良好(叢集太少時,它本身也會太小;見第 10 章);而且不提供任何關於叢集之間變異的資訊。
多層次模型則明確地表示相依性。視預測變項如何設定,它的固定效果可以是組內、組間或總效果(第 7 章);它估計叢集之間差異多大、關係在叢集之間如何變化;並支持對叢集母群的推論。代價是它對隨機效果的分配,以及隨機效果與預測變項之間的獨立性做了假定;這些假定都必須加以檢查(第 7 與第 15 章)。
關鍵詞#
- 共變數分析(analysis of covariance, ANCOVA)
- 組間迴歸(between-cluster regression)
- 叢集穩健標準誤(cluster-robust standard error)
- 完全合併、不合併與部分合併(complete, no, and partial pooling)
- 固定叢集與隨機叢集(fixed versus random clusters)
- 固定效果迴歸(fixed-effects regression)
- 動差法估計式(method-of-moments (ANOVA) estimator)
- 合併組內斜率(pooled within-cluster slope)
- 隨機效果變異數分析(random-effects ANOVA)
- 第一階段與第二階段迴歸(stage-one and stage-two regressions)
- 整體迴歸(total regression)
- 兩階段法(two-stage approach)
習題#
A. 觀念題#
某個診所體系比較旗下八家診所的病人滿意度,想知道哪些診所需要加強。另一位研究者使用同一筆資料,想知道診所之間一般而言差異多大,以及診所規模能否解釋這些差異。哪一位應該把診所視為固定、哪一位應該視為隨機?為什麼?
請用自己的話說明,為什麼固定效果 ANOVA 無法估計學校層次變項(例如公私立別)的效果。
請利用表 3.3,向同事解釋為什麼「作業時間的效果」會有七個不同的估計值,以及哪一個估計值回答了「比同校同學寫更多作業的學生,分數是否比較高?」這個問題。
請舉出兩種會使某些叢集無法進行兩階段分析的情況。
B. 推導題#
請證明:在 對 的迴歸中,若每個叢集各有一個虛擬變項,OLS 斜率等於 ,也就是合併組內斜率。 解答 →
請證明整體 OLS 斜率可以寫成 ,其中 為 的平方和中位於叢集之間的比例, 為以叢集大小加權之組間迴歸的斜率。 解答 →
請利用「技術細節」方框中的權數證明: 的多層次估計式在所有 都相等時,會化簡為未加權的兩階段平均;在 時,則化簡為依精確度加權的平均。 解答 →
C. 計算題#
請重現表 3.2。接著以完整的 23 校資料重做隨機效果分析,並比較 的 ANOVA 估計值與 REML 估計值。
請以這十所學校的資料,用數值驗證習題 B3 的分解。
請在第二階段改用公私立別(公立或私立)取代平均 SES,進行兩階段分析。只有一所私立學校時,哪些結論可以成立、哪些不能?
D. 模擬題#
請修改
sim_ch03_twostage_V01.R(另存為_V02),把叢集數從 20 改為 10,並加入習題 C2 的加權兩階段估計式。四種估計式的精確度與涵蓋率如何改變?請把結果與十所學校的例子相互對照。
E. 應用小專題#
請找一篇已發表的研究,它使用的是聚合資料(叢集平均數),或是忽略叢集的個人層次迴歸。請把它的主要分析改寫成多層次模型,並以第 2 章的三種寫法呈現。說明原研究估計的是表 3.3 中的哪一個量,以及它的標準誤是否可能太小。
上機實作#
延伸閱讀#
- Snijders 與 Bosker (2012, 第 3 章)
-
固定效果與隨機效果、聚合,以及組內與組間迴歸。
- Raudenbush 與 Bryk (2002, 第 2–3 章)
-
兩階段法的邏輯,以及階層線性模式為什麼比它更好。
- Gelman 與 Hill (2007, 第 12 章)
-
以大量圖形解說完全合併、不合併與部分合併。
- Burstein (1980)
-
一篇經典回顧,介紹多層次軟體出現之前的多層次資料分析,包括以斜率為結果變項。
- Searle et al. (1992)
-
變異成分估計的理論,包括不平衡資料中的 ANOVA 估計式與概似估計式。
- Huang (2016); McNeish et al. (2017)
-
主張採用叢集穩健與固定效果等替代做法的論點,以及這些做法在什麼情況下就已足夠。