同一個模型的三種觀點:符號、方程式與圖形
本章架構本書使用的符號;多層次模型的階層、混合與邊際三種寫法;統一模型圖(Unified Model Graph, UMG);參數提升;模型所隱含的資料圖示;需要告訴軟體哪些資訊。
一位學生用三套軟體配適同一個多層次模型,卻得到三份看起來毫不相干的報表。第一套軟體報告「第一層」與「第二層」係數,第二套報告「固定效果」與「隨機效果」,第三套則報告一個叫做 的共變數矩陣。這位學生因此認為三套軟體配適的是不同的模型。其實不然。每套軟體呈現的,都是同一個模型三種等價寫法中的一種:寫成一組方程式,每個層次各一條(階層觀點,即分層方程式);寫成一條包含固定部分與隨機部分的單一方程式(混合觀點,即合併方程式);或寫成對結果變項平均數與共變數的陳述(邊際觀點)。本章介紹全書使用的符號,說明這三種觀點如何互相推導,並加入第四種觀點,也就是圖形觀點:統一模型圖(UMG)。能在這四種觀點之間來回轉換,是閱讀多層次模型最有用的一項能力,後面每一章都以此為基礎。
2.1符號#
表 2.1 列出本書使用的符號。本書的符號大致依循 Snijders 與 Bosker (2012) 與 Raudenbush 與 Bryk (2002),只做了一項簡化:隨機變數一律以小寫表示(、、),讓方程式、圖與 R 程式碼都能使用同樣的字母。表中最後一欄列出其他書籍與軟體報表使用的符號,方便讀者在不同來源之間對照。
| 符號 | 意義 | 其他常見符號 |
|---|---|---|
| 下標與樣本數 | ||
| , | 第一層單位(學生、測量時間點)、第二層單位(學校、個人) | 部分書籍中 與 對調 |
| , , | 群組 的單位數;群組數; | S&B 以 表示群組數 |
| 變項 | ||
| 群組 中單位 的結果變項 | (S&B、R&B) | |
| , | 第一層預測變項, | |
| , | 第二層預測變項, | (R&B)、 |
| 係數與隨機效果 | ||
| , | 群組 的截距與斜率(第一層係數) | 、 |
| 固定效果:第一個下標表示第一層係數,第二個下標表示第二層預測變項 | ||
| , | 第二層隨機效果(群組離差) | (S&B)、(R&B) |
| 第一層殘差 | (S&B)、(R&B)、 | |
| 變異成分 | ||
| , | 與 的變異數 | 、(R&B、HLM) |
| 與 的共變數 | ||
| 的變異數 | ||
| 組內相關係數, | ICC、 | |
| 群組 的矩陣 | ||
| , | 的結果變項向量與殘差向量 | |
| , | 固定部分與隨機部分的設計矩陣 | |
| , | 固定效果向量;群組 的隨機效果向量 | 、(統計文獻) |
| , | 的共變數矩陣; 的邊際共變數矩陣 | 、(SAS:、) |
有兩項慣例一開始就值得留意。第一,下標 一律指第一層單位, 指第二層單位,因此 是單位 的結果變項,該單位屬於群組 。在縱貫性資料中(第 V 篇),第一層單位是測量時間點,第二層單位是個人;下標的意義不變。第二,固定效果 帶有兩個下標。第一個下標表示建模的對象是哪一個第一層係數( 代表截距, 代表第一個斜率,依此類推),第二個下標表示它所乘的是哪一個第二層預測變項( 代表常數項)。因此, 是整體截距, 是 的平均斜率, 是第二層預測變項 對截距的效果, 則是 對斜率的效果(跨層級交互作用)。
2.2階層觀點#
階層觀點為每個群組內的第一層單位寫一條方程式,再為每一個群組特有的係數各寫一條方程式。這是陳述多層次理論最自然的方式,因為它把每個變項放在所屬的層次。若模型有一個第一層預測變項 與一個第二層預測變項 ,第一層模型(level-1 model)就是群組 內的一般迴歸:
每個群組有自己的截距 與斜率 。殘差 是單位 偏離所屬群組迴歸線的量, 是組內殘差變異數,並假定在每個群組都相同。
第二層模型(level-2 model)把各群組的係數當作結果變項,並以群組的特徵來解釋它們:
其中
且隨機效果 與殘差 獨立,不同群組之間也彼此獨立。換句話說:群組的截距由 預測, 是預測後剩下的部分;群組的斜率同樣由 預測, 也是剩下的部分。變異數 與 描述考慮 之後,截距與斜率在群組之間的變異有多大;共變數 則描述截距較高的群組,斜率傾向於較高還是較低。
階層觀點把每個參數的實質意義表達得很清楚。它也讓人一眼看出第二層變項可以從哪裡進入模型(只能出現在第二層方程式中),以及跨層級交互作用是什麼(出現在斜率方程式中的第二層變項)。它的弱點是隱藏了模型對結果變項本身的陳述:式 (2.1) 至 (2.3) 並沒有直接顯示 如何隨 而變,也沒有顯示同一群組內兩個結果之間的關係。
2.3混合觀點#
把第二層方程式代入第一層方程式,就得到單一方程式:
這就是線性混合效果模型(linear mixed model)。固定部分(fixed part)包含迴歸係數 ,它們在所有群組都相同;隨機部分(random part)則包含在群組之間變動的隨機效果 、,以及殘差 。混合觀點揭示了三件階層觀點所隱藏的事。跨層級交互作用以一般的乘積項 出現。第二層預測變項以結果變項的一般預測變項 出現。最後,誤差項不再是單一殘差,而是一個總和 ,其中的隨機效果項 與 為群組 的所有單位所共有。這個複合誤差,正是第 1 章所討論之相依性的正式來源。
混合觀點也是大多數軟體撰寫模型的形式。例如,在 R 套件 lme4 (Bates et al., 2015)中,式 (2.5) 的模型寫成 y ~ x * z + (x | school):括號外是固定部分,括號內是隨機部分,分組因子則寫在直線符號之後。
2.3.1混合效果模型的矩陣形式#
為了計算,也為了後續章節,把屬於同一群組的 條方程式堆疊成群組 的向量與矩陣會很方便 (Laird & Ware, 1982):
其中 是 的結果變項向量, 是固定部分的設計矩陣, 是固定效果向量, 是隨機部分的設計矩陣, 是隨機效果向量, 則是第一層殘差向量。以一個有三個單位的群組為例,式 (2.5) 的模型可寫成
的各欄是具有隨機係數的變項(此處為常數項與 ),通常是 各欄的子集合。在只有隨機截距的模型中,,也就是一欄全為 1 的向量。
2.4邊際觀點#
隨機效果 與 無法觀察,能觀察到的是結果變項;模型對結果變項的分配有所陳述,而這個分配是把隨機效果積分消去之後得到的。這就是邊際模型(marginal model)。由式 (2.6),並因為 與 的平均數為零且彼此獨立,可得
且不同群組的結果彼此不相關。邊際平均數就是混合效果模型的固定部分;邊際共變數矩陣 則彙整了隨機部分對變異數與共變數的全部意涵。由於各群組彼此獨立,全部 個結果的共變數矩陣是區塊對角矩陣,每個群組對應一個區塊 。
2.4.1隨機截距模型:複合對稱#
只有隨機截距時, 且 ,因此 。不論預測變項的值是多少,每個結果的變異數都相同,為 ;同一群組內每一對結果的共變數也都相同,為 。這種型態稱為複合對稱(compound symmetry)。同一群組內任兩個單位之間的相關,就是第 1 章的組內相關係數(ICC),只是現在是在考慮固定部分的預測變項之後才計算(殘差 ICC 或條件 ICC)。
2.4.2隨機斜率模型:變異數函數#
加入隨機斜率之後,情況就不同了。把式 (2.8) 寫成個別元素,可得
結果變項的變異數現在是 的二次函數,稱為變異數函數(variance function);同一群組內兩個單位之間的共變數,也取決於它們的 值。因此,隨機斜率在模型結構上就會使邊際模型的變異數異質:在各群組迴歸線呈扇形散開的 值,結果變項的變異較大;在迴歸線彼此最靠近之處,變異較小。變異數函數的最小值位於 。第 6 章會詳細發展這些結果。
圖 2.1 把式 (2.8) 具體呈現出來。圖中是九位 NELS:88 學生數學成績的模型隱含相關矩陣;這九位學生來自三所學校,每校三位,分別是該校作業時間最少、居中與最多的學生。估計值來自第 2.5 節所配適的模型。(a) 圖為隨機截距模型,矩陣呈現複合對稱的型態:學校內是相關係數相等的區塊(.23),學校之間則為零。(b) 圖為隨機截距與斜率模型,學校內的相關取決於作業時間。同一所學校中,作業時間相近且偏多的兩位學生高度相關(第 2 校與第 3 校分別為 .59 與 .78),但同校中一位完全不寫作業的學生和一位作業很多的學生卻呈負相關(、)。這些負值反映的是第 1 章圖 1.3 中各校迴歸線交叉的現象:在不寫作業的學生也表現良好的學校,作業很多的學生表現相對較差,反之亦然。
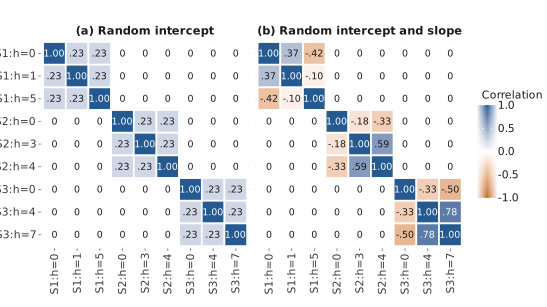
註:列與欄都是學生,以學校(S1 = 24725、S2 = 6467、S3 = 62821)與作業時間類別 標示。儲存格的色階從橘色(負值)經白色(零)到藍色(正值),每格並印出相關係數。不同學校的兩位學生,模型隱含的相關為零。
圖 2.2 呈現對應的變異數函數。在隨機截距模型下,不論作業時間多少,數學成績的變異數都相同(92.6)。在隨機截距與斜率模型下,不寫作業的學生變異數為 115.7,在「少於一小時」與「一小時」兩個類別之間降到最小值 72.8,對作業很多的學生則急遽上升。點線標示組內部分 ,它是常數;點線以上的部分都來自學校之間的差異,而在隨機斜率模型下,學校之間這部分所占的比例取決於預測變項的值。
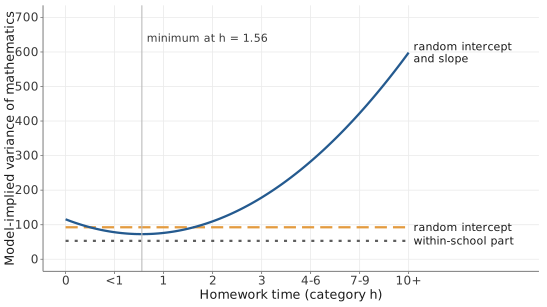
註:虛線為隨機截距模型所隱含的變異數;實線為隨機截距與斜率模型的變異數函數(式 (2.9));點線為後者的第一層變異數 。細垂直線標示變異數函數的最小值。刻度標籤為各作業時間類別所代表的每週時數。
2.5在三種觀點之間轉換:實例演練#
本節以第 1 章的 NELS:88 資料(23 所學校的 519 位學生)配適三個模型,並代入估計值,把每個模型寫成三種觀點。結果變項是數學成就,第一層預測變項是作業時間類別 (0 = 不寫作業,1 = 少於一小時,2 = 一小時,依此類推,直到 7 = 每週十小時以上)。三個模型分別是虛無模型(empty model;M0)、加入作業時間的隨機截距模型(M1),以及加入作業時間的隨機截距與斜率模型(M2)。表 2.2 列出以 lme4 的限制最大概似估計(REML;第 9 章)所得的估計值。
| 參數 | 符號 | 虛無模型 (M0) | 隨機截距 模型(M1) | 隨機截距與 斜率模型(M2) |
|---|---|---|---|---|
| 固定效果 | ||||
| 截距 | 50.76 (1.15) | 46.36 (1.16) | 46.33 (1.76) | |
| 作業時間 | 2.40 (0.28) | 1.98 (0.93) | ||
| 變異成分 | ||||
| 截距變異數 | 26.12 | 21.34 | 62.42 | |
| 斜率變異數 | 17.73 | |||
| 截距與斜率的共變數 | 27.59 | |||
| 第一層變異數 | 81.24 | 71.28 | 53.29 | |
| REML 離異數 | 3,798.7 | 3,729.3 | 3,635.6 | |
| 參數個數 | 3 | 4 | 6 | |
註:表中為 REML 估計值,括號內為標準誤。 = 估計參數的個數(固定效果與變異成分)。只有固定部分相同的模型(此處為 M1 與 M2;見第 11 章)才能比較 REML 離異數。
library(lme4)
nels <- read.csv("nels88_school23.csv")
M0 <- lmer(math ~ 1 + (1 | school), data = nels)                   # empty model
M1 <- lmer(math ~ homework + (1 | school), data = nels)            # random intercept
M2 <- lmer(math ~ homework + (homework | school), data = nels)     # random intercept and slope
summary(M2)       # fixed effects, variance components, correlation of random effects
VarCorr(M2)$school # the matrix T; sigma(M2)^2 gives sigma^2每種觀點回答不同的問題。階層觀點說明典型的學校裡發生什麼事,以及學校之間有何差異。在平均的學校中,作業時間每增加一個類別,數學成績的期望值約提高 2 分;但學校之間的差異很大:斜率的標準差為 4.2,因此在高於平均一個標準差的學校,斜率約為 ,在低於平均一個標準差的學校則約為 。若斜率呈常態分配,母群中約有三分之一的學校()斜率為負。截距與斜率之間強烈的負相關()表示:學生不寫作業也表現良好的學校,作業斜率往往平坦甚至為負,與圖 1.3 中那兩所學校的型態相符。
混合觀點說明軟體把哪些量估計為固定效果(46.33 與 1.98),以及哪些項是隨機的。比較表 2.2 中的 M1 與 M2,可以看到一個在第 6 章還會再出現的現象:一旦允許斜率變動,估計的平均斜率就會改變(從 2.40 變為 1.98),其標準誤也增為原來的三倍以上(從 0.28 增為 0.93)。隨機截距模型把作業時間的效果視為在每所學校都相同,因而高估了平均效果的精確度。
邊際觀點說明模型對觀察分數有何意涵:母群平均的迴歸線,以及圖 2.1 與 2.2 中的變異數與相關。它也顯示各變異成分如何構成總變異數。在虛無模型中,總變異數為 ,其中 24% 位於學校之間。把作業時間加入為固定效果(M1)後,兩個成分都變小( 降為 21.3, 降為 71.3)。讓斜率變動(M2)則把變異從 移出(降為 53.3),移入學校層次的部分,而這部分現在取決於作業時間。如何把這類變化摘要成「解釋變異量」,留待第 11 章討論。
2.6繪製模型:統一模型圖#
方程式精確,卻不容易一眼看懂;路徑圖一目了然,但依照常見的畫法,無法表現哪些係數在群組之間變動。本書把每個模型都畫成統一模型圖(Unified Model Graph, UMG)。這是一套有正式定義的圖形語法,每一張合乎語法的圖都對應到一個特定的統計模型 (Yu, 2026a)。R 套件 umg (Yu, 2026b)可以建立、檢查並繪製這類圖。這套語法針對模型中的每個量回答三個問題,每個答案各用一種視覺管道來表示。
2.6.1關於每個量的三個問題#
圖 2.3(a) 呈現頂點。這個量是否被觀察到?觀察變項塗上灰底;未觀察到的(潛在)量,包括隨機效果,則為白色。它是連續的還是類別的?連續量畫成圓形;類別量(例如二元反應、潛在類別)畫成方形。它扮演什麼角色?隨機變數使用單線外框;固定的未知參數,也就是頻率學派估計的對象,畫成菱形;已知常數畫成三角形;由其他量確定地計算出來的量,例如組平均數 ,則使用雙線外框。
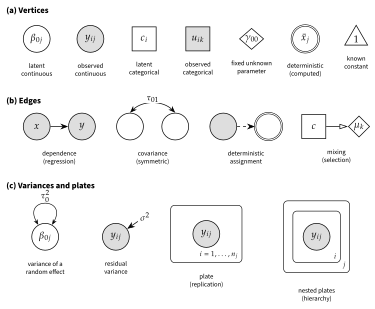
註:(a) 圖:頂點類型。填色表示可觀察性(灰底 = 觀察到,白色 = 潛在),形狀表示取值型態(support;圓形 = 連續,方形 = 類別),外框表示角色(菱形 = 固定的未知參數,三角形 = 已知常數,雙線外框 = 確定性)。(b) 圖:邊的類型。(c) 圖:隨機效果上的變異數迴圈、觀察結果變項上的殘差短箭頭、一個 plate,以及巢套的 plate。改編自 Yu (2026a)。
圖 2.3(b) 呈現邊。單向箭頭表示依賴:箭頭端的量依賴於箭尾端的量,如同迴歸。彎曲的雙向箭頭表示共變數,即沒有方向的對稱關聯。指向雙線外框頂點的虛線箭頭表示確定性指派。從潛在類別指向一組參數、箭頭為空心的箭線是混合邊(mixing edge),用於混合模型(mixture model;第 22 章)。圖 2.3(c) 呈現兩種簡寫記號:表示隨機效果變異數的迴圈,以及表示殘差變異數的短箭頭;另外還有第 1 章介紹過的 plate。
2.6.2以 UMG 表示核心模型#
圖 2.4 畫出三個模型:虛無模型 M0((a) 圖)、含一個學生預測變項 與一個學校預測變項 的隨機截距模型((b) 圖;去掉 與 就是 M1),以及隨機截距與斜率模型 M2((c) 圖)。在每一張圖中,學生 plate()都巢套在學校 plate()之內;觀察到的學生變項是學生 plate 內的灰底圓形;觀察到的學校變項 ((b) 圖)是位於學校 plate 內、學生 plate 外的灰底圓形;隨機係數((a) 與 (b) 圖中的 ,(c) 圖中的 與 )是學校 plate 內的白色圓形;固定效果 則是位於所有 plate 之外的菱形。(b) 圖中的斜率是固定的,因此代表它的菱形 直接指向 。由上而下閱讀 (c) 圖,就重現了階層觀點:母群參數 與 生成學校係數 與 ,這些係數在學校之間變動,變異數為 與 ,共變數為 ;學校係數與學生的預測變項 (作業時間,在實例演練中寫成 )再生成學生的分數 ,殘差變異數為 。
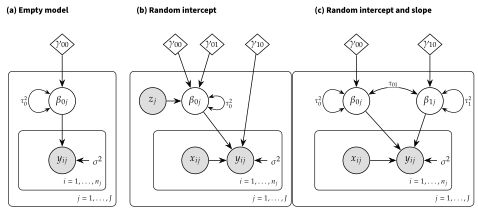
註:菱形為固定效果,位於所有 plate 之外。學校 plate 中的白色圓形是各校特有的係數;其上的迴圈表示它們的變異數,(c) 圖中彎曲的雙向箭頭則表示它們的共變數。學生 plate 中的灰底圓形是觀察到的學生變項;(b) 圖中的灰底圓形 是觀察到的學校變項。指向 的短箭頭表示第一層殘差變異數。
UMG 不只是一張圖。每一個有箭頭指入的頂點,在給定指向它的那些頂點之下都有一個分配;在給定參數與觀察到的預測變項之下,圖中所有隨機量的聯合分配,就是這些條件分配的乘積,並依 plate 所示重複。以 (c) 圖為例,這個乘積是
這正是式 (2.1) 至 (2.4) 中去掉 的階層模型。把白色(未觀察)的隨機係數從式 (2.11) 中積分消去,就得到邊際模型。就這個意義而言,一張圖承載了全部三種觀點:箭頭得出分層方程式,白色頂點標示混合效果模型的隨機部分,而以積分把它們消去,就得到邊際模型。
2.7參數提升:固定與隨機是兩種位置#
UMG 語法中最有用的一個概念是參數提升(parameter promotion) (Yu, 2026a)。圖 2.5 呈現同一個係數( 對 的效果)在四種位置上的樣子。在 (a) 圖中,係數 是位於兩個 plate 之外的菱形:所有學校共用一個固定斜率。在 (b) 圖中,菱形移到學校 plate 內,成為白色圓形 ,在學校之間有一個分配 ;原來的菱形保留下來,作為這個分配的平均數。固定效果與隨機效果的差別,就只是這一步移動。在 (c) 圖中,係數有一個由已知常數(三角形)設定的先驗分配,這正是貝氏估計處理每個參數的方式(第 13 章)。在 (d) 圖中,一個潛在類別頂點透過混合邊,從數個類別特定的係數版本中選出一個,這就是混合模型的運作方式(第 22 章)。
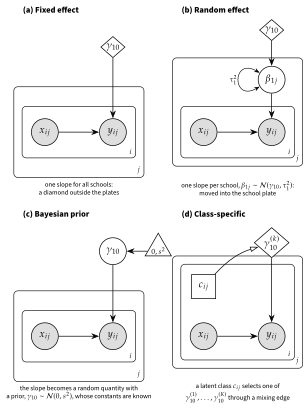
註:每張圖中,學生 plate()都巢套在學校 plate()之中。(a) 固定效果:位於 plate 之外的菱形。(b) 隨機效果:學校 plate 中帶有變異數迴圈的白色圓形,其平均數就是那個菱形。(c) 貝氏先驗:係數是一個隨機頂點,其父頂點是代表已知先驗常數的三角形。(d) 類別特定:潛在類別(白色方形)透過空心箭頭的混合邊,在類別特定的菱形之間做選擇。改編自 Yu (2026a)。
這個概念的統計內容並不新。隨機效果就是潛在變項 (Curran, 2003; Mehta & Neale, 2005; Skrondal & Rabe-Hesketh, 2004),先驗分配把參數變成隨機變數,混合模型則以潛在類別切換參數。圖形的貢獻在於:四種情形在紙面上看起來各不相同,彼此之間的轉換卻只是一次搬移。理解了 (b) 圖的讀者,就理解了什麼是隨機效果;當同樣的搬移再次出現在隨機截距(第 5 章)、隨機斜率(第 6 章)、貝氏估計(第 13 章)、成長混合模型(第 22 章),以及多層次結構方程模型中的潛在變項(第 29 章)時,他們也能一眼認出。
2.8模型所隱含的資料圖示#
UMG 的每個元素都隱含一種資料圖示,可用來判斷該元素是否必要 (Yu, 2026a)。一個 plate 隱含小倍數圖(small multiples):每個群組一個小圖,讓人能在每個群組中看到組內關係。隨機係數隱含該係數各群組估計值的圖示:以隨機斜率而言,就是由各群組迴歸線構成的「義大利麵圖」(spaghetti plot)。兩個隨機係數之間的共變數邊,隱含把一組群組估計值對另一組作圖的散佈圖。隨機斜率還隱含一個變異數函數,如圖 2.2 所示。順著讀,一張圖是待配適的模型;倒過來讀,它是配適前後應該檢視之圖示的檢核清單。
圖 2.6 以 NELS:88 資料,呈現圖 2.4 的 (c) 圖所隱含的三種圖示。(a) 圖的小倍數圖顯示,學校內作業時間與數學成績的關係大致呈線性,但各校之間明顯不同。(b) 圖的各校最小平方迴歸線,顯示截距與斜率圍繞合併迴歸線的分散情形,這正是納入隨機截距與隨機斜率的理由。(c) 圖是學校截距對學校斜率的散佈圖,顯示強烈的負相關(23 組最小平方估計值的相關為 ),這就是共變數邊 所代表的關係;模型扣除抽樣誤差之後,估計這個相關為 。第 4 章會有系統地發展這些圖示;umg 套件中的函式 umg_eda_scaffold() 則可以根據一張圖與一份資料自動產生這些圖示。
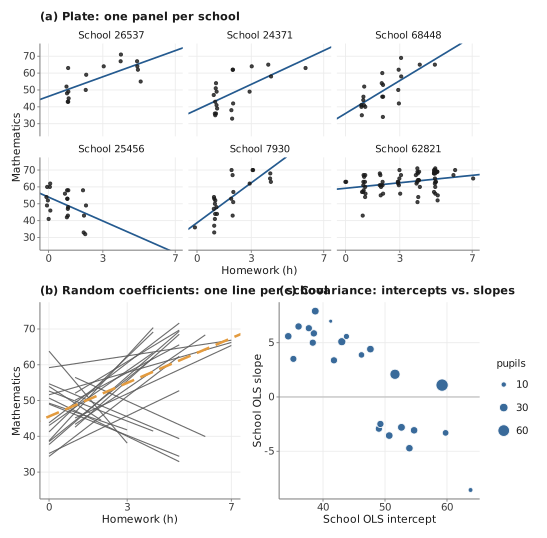
註:(a) 圖:六所學校的數學成績對作業時間類別的散佈,並附上各校的最小平方迴歸線;資料點在水平方向加了隨機抖動(jitter)。(b) 圖:全部 23 所學校的最小平方迴歸線,每條線只畫在該校觀察到的作業時間範圍內;虛線為合併的最小平方迴歸線。(c) 圖:各校的最小平方截距對最小平方斜率;點的面積與該校學生人數成正比。
2.9需要告訴軟體什麼#
每一套多層次模型軟體都要求同樣的四項資訊,只是方式各不相同:(1) 結果變項與固定部分(哪些預測變項、哪些交互作用);(2) 定義群組的分組變項;(3) 隨機部分(哪些係數在群組之間變動);(4) 隨機效果共變數矩陣 的結構(隨機截距與斜率是否可以相關)。多數軟體也允許為第一層殘差設定共變數結構,這對縱貫性資料很重要(第 20 章);而且所有軟體都需要一種估計方法,可以明確指定,也可以採用預設值(第 9 章)。
以混合觀點為核心設計的軟體(R、SAS、SPSS、Stata、JASP)接受一個包含固定部分與隨機部分的模型敘述。以階層觀點為核心的軟體(HLM)接受一條第一層方程式與數條第二層方程式。以潛在變項為核心的軟體(Mplus)接受一個組內模型與一個組間模型,其中隨機係數以潛在變項的形式出現,這正是圖 2.4(c) 所呈現的圖像。本節最後的軟體對照列出 M2 在各軟體中的語法,表 2.3 則列出各個變異成分在各軟體報表中出現的位置。
| 軟體 | , | ||
|---|---|---|---|
R (lme4)
| school (Intercept) 與 homework,列於 Variance 之下;也會印出標準差
| 以相關(Corr)而非共變數的形式印出 | Residual
|
SAS (MIXED)
| UN(1,1)、UN(2,2),列於 Covariance Parameter Estimates 中
| UN(2,1)
| Residual
|
SPSS (MIXED)
| UN (1,1)、UN (2,2)
| UN (2,1)
| Residual
|
Stata (mixed)
| var(_cons)、var(homework)
| cov(homework,_cons)
| var(Residual)
|
| Mplus | MATH 與 S 的組間層次變異數
| MATH 與 S 的 WITH 敘述(組間層次)
| MATH 的組內層次殘差變異數
|
| HLM 8 | 矩陣中的 與 |
註:表中的標籤是下方軟體對照方框中的模型所印出的名稱;它們可能隨模型敘述中各項的順序以及軟體版本而改變。 = 截距變異數; = 斜率變異數; = 截距與斜率的共變數; = 第一層殘差變異數。
2.10如何閱讀本書其餘章節#
從現在起,每一個新模型都會以類似第 2.5 節的「三種觀點」方框呈現,畫成 UMG,並附上它所隱含的資料圖示。某個結果在哪一種觀點下比較容易看出,內文就採用那一種觀點。係數的解釋與模型背後的理論,通常在階層觀點下最清楚。軟體語法、交互作用與平減的效果(第 7 章),在混合觀點下最清楚。估計(第 9 章)、變異成分的檢定(第 11 章)、縱貫性資料的共變數結構(第 20 章),以及與廣義估計方程式等母群平均模型的比較(第 23 與 32 章),則在邊際觀點下最清楚。模型一旦變得複雜,UMG 就是值得回頭參照的觀點,因為它能讓人一眼看出哪些量在哪個層次上變動。
關鍵詞#
- 複合對稱(compound symmetry)
- 隨機效果共變數矩陣(covariance matrix of random effects, )
- 設計矩陣(design matrix, , )
- 固定效果(fixed effect)
- 固定部分(fixed part)
- 階層觀點(hierarchical (level-specific) view)
- 第一層模型(level-1 model)
- 第二層模型(level-2 model)
- 線性混合效果模型(linear mixed model)
- 邊際共變數矩陣(marginal covariance matrix, )
- 邊際模型(marginal model)
- 模型隱含的資料圖示(model-implied data display)
- 參數提升(parameter promotion)
- plate
- 隨機效果(random effect)
- 隨機部分(random part)
- 以斜率為結果變項(slopes as outcomes)
- 統一模型圖(Unified Model Graph, UMG)
- 變異數函數(variance function)
習題#
A. 觀念題#
判斷下列每一句陳述屬於階層觀點、混合觀點還是邊際觀點:(a)「每所學校都有自己的一條焦慮對工作負荷的迴歸。」(b)「焦慮的變異數隨工作負荷增加而增加。」(c)「模型包含學校氣氛與工作負荷的乘積。」(d)「同一所學校的兩位教師,焦慮分數彼此相關,而且兩人的工作負荷都高時,這個相關更大。」(e)「工作負荷的斜率由學校氣氛預測。」(f)「誤差項是 。」
在圖 2.4(b) 中,請說明為什麼 畫在學校 plate 內、學生 plate 外,而 畫在兩個 plate 之外。
一位同事報告隨機截距與斜率之間的相關為 ,並據此認為「成就高的學校從作業中獲益較少」。要評斷這個解釋,還需要哪些額外資訊?(提示:參考關於 位置的常見陷阱方框。)
當具有隨機斜率的第一層預測變項平移一個常數時,下列哪些量會改變:、、、、、、離異數?
B. 推導題#
考慮階層模型 ,其中 、,且 。(a) 寫出混合效果模型,並指出其固定部分與隨機部分。(b) 寫出有三個單位之群組的 、 與 。(c) 推導這個群組的 。 解答 →
證明在隨機截距模型下, 具有複合對稱,並求出同一群組內任兩個單位之間的相關。 解答 →
對隨機斜率模型,證明變異數函數式 (2.9) 的最小值位於 ,並計算這個最小值。再利用 M2 的估計值,驗證內文所報告的 115.7( 時)與 72.8(最小值)。 解答 →
證明若把 換成 ,參數為 的隨機斜率模型,等價於 、、 的模型。 解答 →
C. 計算題#
在 R 中以 NELS:88 資料配適 M0、M1 與 M2,並重現表 2.2。接著從軟體對照中另選一套軟體配適 M2,一次使用預設的共變數結構,一次使用無結構矩陣,並解釋兩者的差異。
利用 M2 的估計值,為一所有四位學生、作業時間類別分別為 0、1、3、6 的學校計算模型隱含共變數矩陣 ,並轉換成相關矩陣。哪幾對學生呈負相關?為什麼? 解答 →
以總平均數將作業時間平減後,重新配適 M2。把 、 與離異數和表 2.2 的結果比較,並以習題 B4 的結果加以驗證。
以
umg套件把 M2 畫成 UMG,做法有兩種:用umg_model()手動建立,以及用umg_from_lmer()自動建立;並對兩者各執行一次umg_validate()。接著以umg_eda_scaffold()產生圖 2.6 中的圖示。
D. 模擬題#
寫一個程式腳本(依照本書的檔頭與區塊結構),以 M2 的估計值為真值,從 M2 模擬 5,000 所學校、每校四位學生的資料,每所學校的作業時間都固定為 0、1、3 與 6。計算四個分數在各校之間的經驗共變數矩陣,並與你在習題 C2 推導出的矩陣比較。模擬的學校數要多大,兩者才會在小數點後第一位一致? 解答 →
E. 應用小專題#
選一篇已發表、報告了兩層次模型(至少含一個隨機斜率)的論文。(a) 以三種觀點寫出該模型,論文有報告估計值之處就代入已發表的估計值。(b) 把它畫成 UMG。(c) 列出完成 (a) 所需、但論文沒有報告的資訊,例如隨機效果的共變數或預測變項的平減方式。(d) 針對這些遺漏的資訊,寫一段兩句話的意見給作者。
上機實作#
延伸閱讀#
- Snijders 與 Bosker (2012, 第 4–5 章)
-
以本書所依循的符號介紹隨機截距模型與隨機斜率模型,並把階層形式與混合效果模型的形式並列對照。
- Raudenbush 與 Bryk (2002, 第 2 章)
-
逐層建構模型的寫法與「以斜率為結果」的概念,也就是 HLM 軟體所實作的方式。
- Laird 與 Ware (1982)
-
為縱貫性資料奠定矩陣形式 的論文。
- Verbeke 與 Molenberghs (2000, 第 3 章)
-
細緻討論階層模型與邊際模型之間的差異。
- Singer (1998)
-
一篇經典的教學文章,把階層觀點對應到 SAS
PROC MIXED的語法;對 SAS 使用者而言,至今仍是連接兩者最好的橋梁。 - Bates et al. (2015)
-
lme4的公式語法與計算方法。 - Curran (2003);Mehta 與 Neale (2005)
-
為什麼隨機效果就是潛在變項,以及這對連結多層次模型與結構方程模型有何意義。
- Yu (2026a)
-
統一模型圖,包括參數提升與模型隱含的資料圖示。