UMG 符號參考與圖形風格指南
本附錄內容統一模型圖(Unified Model Graph, UMG)的圖形詞彙及其 TikZ 樣式;本書的繪圖規則;各章中的參數提升;模型圖所隱含的資料圖示;資料圖與 TikZ 圖的風格;圖表標題、註與編號;本書模型圖的目錄;樣式檔與一張模型圖的原始碼。
本書的每一個模型都畫成統一模型圖(UMG),也就是第 2 章介紹的圖形語法 (Yu, 2026a);每一張資料圖也都遵循同一套視覺風格。本附錄把這些慣例集中在一處,寫給兩類讀者:一類想精確讀懂書中的某張模型圖或某張圖,另一類想用同樣的方式,為學位論文、期刊論文或課程繪製自己的模型圖與圖形。本書的模型圖以 TikZ 繪製,並使用一個小型樣式檔 Style/umg-style.tex,由它實作 UMG 的圖形詞彙;R 套件 umg (Yu, 2026b) 則可以在 R 中建立、檢查並繪製同樣的圖。
D.1圖形詞彙#
對於模型中的每一個量,UMG 都回答三個問題,每個答案各用一種視覺管道表示(第 2 章)。填色表示這個量是觀察到的(灰底)還是潛在的(白色);形狀表示它是連續的(圓形)還是類別的(方形);外框則表示它的角色:隨機變數使用單線外框,由其他量計算而得的量使用雙線外框,固定的未知參數畫成菱形,已知常數畫成三角形。由於這些管道彼此獨立,知道這三個問題的讀者不需要圖例,就能讀懂幾乎任何一個頂點;例外是確定性頂點一律為白色,即使它是由觀察資料計算而得。表 D.1 列出每一個元素,圖 D.1 則逐一畫出每個元素,並附上其 TikZ 樣式的名稱。
| 元素 | 畫法 | 意義與典型用途 | 樣式 |
|---|---|---|---|
| 潛在連續變項 | 白色圓形 | 隨機效果、潛在因素、潛在組平均數 | vCL
|
| 觀察連續變項 | 灰底圓形 | 以連續尺度測量的結果變項或預測變項 | vCO
|
| 潛在類別變項 | 白色方形 | 混合模型中的潛在類別 | vDL
|
| 觀察類別變項 | 灰底方形 | 二元、次序或名義的反應變項或預測變項 | vDO
|
| 固定的未知參數 | 菱形 | 固定效果或其他固定參數,例如類別比例,或對數變異數的係數;變異數與共變數則寫成標籤 | vP
|
| 確定性的量 | 雙線外框(圓形或方形),白色 | 由其他量計算而得的量,例如觀察到的組平均數或加權總和 | vDetC, vDetD
|
| 已知常數 | 三角形 | 平均數結構中的常數 1、已知的先驗常數、已知的抽樣變異數、指示變項的代碼 | vK
|
| 明確畫出的殘差 | 白色小圓 | 本身具有結構的殘差,例如具有自我相關的殘差 | vEps
|
| 依賴 | 單向箭頭 | 箭頭端依賴於箭尾端(迴歸、負荷量) | eReg
|
| 共變數 | 彎曲的雙向箭頭 | 沒有方向的對稱關聯 | eCov
|
| 確定性指派 | 虛線箭頭 | 箭頭端由箭尾端計算而得 | eDet
|
| 混合邊 | 箭頭為空心的箭線 | 潛在類別在多組參數之間做選擇 | eMix
|
| 變異數迴圈 | 頂點上的雙向迴圈 | 隨機效果的變異數 | eVar
|
| 殘差短箭頭 | 指向頂點的短箭頭 | 結果變項的殘差變異數 | \umgstub
|
| plate | 圓角方框 | 對其索引所指的各單位重複 | plate
|
| 因果標記 | 淺灰底色的方框標籤 | 使一條邊具有因果意義的假定 | causalbadge
|
註:樣式:Style/umg-style.tex 中 TikZ 樣式(或巨集)的名稱;邊與 plate 的標籤使用 elab、elabplain 與 platelab。代表常數的三角形借自結構方程模型的路徑圖,plate 則借自用於學習的圖模型 (Buntine, 1994)。
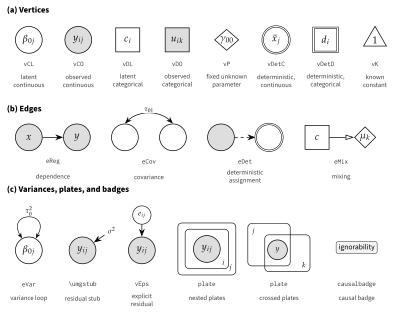
註:每個元素各畫一次;元素下方以打字機字型標示的是它在 Style/umg-style.tex 中的樣式名稱,再下一行則是對它的說明。(a) 圖:頂點。(b) 圖:邊。(c) 圖:變異數記號、明確畫出的殘差、plate 與因果標記;右側的一對 plate 彼此重疊,用來表示交叉分類。
D.2繪圖規則#
圖形詞彙說明每個記號的意義;繪圖規則則說明記號應該放在哪裡。圖 D.2 呈現一個隨機截距與斜率模型,其中含一個學校預測變項、觀察到的學校平均數的脈絡效果,以及一個跨層級交互作用;圖中的編號標記對應表 D.2 中的規則。這些規則讓模型圖不致產生歧義:依照規則閱讀的讀者,可以從圖中寫出模型的結構;而依照規則畫出的圖,只對應一個模型。這些規則描述的是本書的一般做法;表後的兩段則說明模型圖必須通過的檢查,以及某些章節需要的變化畫法。
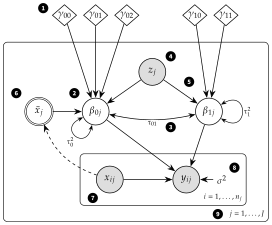
註:含學校預測變項 、學生預測變項之觀察學校平均數 與跨層級交互作用的隨機截距與斜率模型。黑色編號標記對應表 D.2 中的規則。 的係數為 , 的係數為 。
| 規則 | 內容 | 首次出現 |
|---|---|---|
| 1 | 對每個單位都相同的固定未知參數,是位於所有 plate 之外的菱形;固定斜率也可以改寫成它所乘之邊上的標籤。在某個 plate 的各單位之間不同的固定參數,例如固定學校效果或類別特定參數,則是位於該 plate 內的菱形。變異數與共變數參數作為迴圈、彎曲箭頭與短箭頭的標籤。 | 圖 2.4 |
| 2 | 在群組之間變動的係數,是位於其所跨群組之 plate 內的白色圓形,並附有變異數迴圈;指向它的菱形是它的平均數。 | 圖 2.4 與圖 2.5 |
| 3 | 同一群組的各隨機係數以彎曲的雙向箭頭相連,並標上它們的共變數。 | 圖 2.4 |
| 4 | 觀察到的群組層次預測變項,是位於群組 plate 內、單位 plate 外的灰底頂點;它對該群組平均結果的效果,是一條指向隨機截距的箭頭,而不是指向單位層次結果變項的箭頭。 | 圖 2.4 |
| 5 | 跨層級交互作用是一條從群組層次預測變項指向隨機斜率的一般箭頭;沒有任何箭頭指向另一個箭頭。 | 圖 1.7(命題)與圖 6.6(模型) |
| 6 | 由資料計算而得的量,例如觀察到的組平均數,使用雙線外框,並由虛線箭頭指入;潛在組平均數則改畫成白色圓形。 | 圖 5.6 |
| 7 | 觀察到的單位層次變項,是位於最內層 plate 內的灰底頂點。 | 圖 1.2 |
| 8 | 結果變項的殘差變異數是一個標上該變異數的短箭頭;本身具有結構的殘差則明確畫成一個頂點。 | 圖 2.4 與圖 20.5 |
| 9 | plate 以其索引標示,在有幫助時也標出其範圍,通常標在右下角;若 plate 彼此重疊或共用一角,或該角已被其他元素占用,標籤就移到空著的角落。巢套的 plate 表示階層。 | 圖 1.2 |
一張合乎語法的模型圖也定義了一個機率模型。每一個隨機頂點,在給定指向它的那些頂點之下都有一個分配;在給定參數與觀察到的預測變項之下,隨機量的聯合分配就是這些條件分配的乘積,並依 plate 所示重複(第 2 章)。這種讀法為任何一張模型圖提供三項檢查:每一個隨機頂點,在給定其父頂點之下都必須有明確陳述的分配;任何一串單向箭頭都不得從一個頂點回到它自己;模型方程式中的每一個量,都必須以頂點或標籤的形式出現在圖中。
有幾章為了其中的模型而擴充了這些規則。在第 26 章的交叉分類模型與多重隸屬模型中,以及後面的幾章裡,模型圖採用一種混合形式(mixed form):各分類的可加隨機效果與群組預測變項直接指向結果變項(圖 26.2),或經由加權總和指向結果變項(圖 26.5),固定斜率則寫成邊上的標籤;圖 1.7 畫的是實質命題而非模型,也使用同樣的簡化形式。巢套在個人之內的測量時間點,和其他層次一樣構成一個 plate(圖 19.3);但當相繼的殘差彼此相依時,測量時間點 plate 就要展開,因為 plate 無法表現其各個重複之間的相依(圖 20.5)。交叉分類畫成相互重疊的 plate,同時屬於兩種分類的單位,則放在交集處一個點線的 plate 中(圖 26.2)。多重隸屬以標示隸屬權數的虛線邊,把分離的單位 plate 與群組 plate 連接起來,這些虛線邊指向雙線外框的加權總和(圖 26.5)。在貝氏模型中,每一個參數都成為一個隨機頂點,其父頂點是代表已知先驗常數的三角形(圖 13.1);在混合模型中,潛在類別則透過混合邊,在類別特定的參數之間做選擇(圖 22.4)。組內–組間分解的畫法,是以虛線箭頭從觀察到的預測變項指向雙線外框的組平均數(圖 5.6b、圖 7.3a 與圖 21.2a),預測變項經過平減時,也指向雙線外框的離差(圖 5.6b 與圖 21.2a);採用潛在平減時,則改由潛在組平均數與潛在離差指向觀察到的預測變項(圖 7.3b 與圖 21.2b)。成長模型也可以畫成展開形式,把測量時間點 plate 展開成每個測量時間點一個指標(圖 22.1b);兩層次因素模型也可以不用巢套的 plate,而畫成兩張單一層次的圖,一張對應組內共變數矩陣,一張對應組間共變數矩陣(圖 29.1b)。指向類別結果變項的邊可以帶有連結函數或閾值的標籤,因素負荷量則寫在其所屬的邊上。當變異數不是一張圖的重點時,迴圈與短箭頭的標籤會省略。有些模型圖把二元預測變項畫成圓形,例如圖 5.6 與圖 6.6 中的學校公私立別,以及圖 31.3 中的處理;圖 18.1 則依照圖形詞彙的規定,把公私立別畫成方形。因果標記把識別假定附加在係數上,而該係數的因果解讀正取決於這個假定(圖 31.3)。最後,呈現已配適模型的模型圖,會把估計值印在參數、邊與迴圈旁邊,其原始檔也會註明這些數字的來源(圖 18.1 與圖 19.3)。
D.3全書的參數提升#
參數提升的概念是:固定效果與隨機效果是同一個參數的兩種位置(第 2 章)。同一個係數若是固定的,就是位於 plate 之外的菱形;若在某個 plate 的各單位之間變動,就是位於該 plate 內的白色圓形;若以貝氏方法估計,就是帶有先驗分配的隨機頂點;在混合模型中,則是數個類別特定菱形中的一個。表 D.3 追蹤這種移動在全書中的軌跡;每一列是一種位置,所列的圖則呈現該位置在某個特定模型中的樣子。
| 位置 | 圖中的畫法 | 圖 |
|---|---|---|
| 固定效果 | 位於所有 plate 之外的菱形 | 2.5(a), 5.2(b) |
| 固定群組效果 | 群組 plate 內每個群組一個菱形 | 3.2(b), 5.2(a) |
| 隨機係數 | 群組 plate 內附變異數迴圈的白色圓形;菱形則成為它的平均數 | 2.4, 2.5(b) |
| 受預測的隨機係數 | 群組層次的頂點指向隨機係數(第二層效果與跨層級交互作用) | 5.6, 6.6 |
| 帶有先驗分配的係數 | 隨機頂點,其父頂點是代表已知先驗常數的三角形 | 2.5(c), 13.1 |
| 類別特定係數 | 潛在類別透過混合邊,在類別特定的菱形之間做選擇 | 2.5(d), 22.4 |
| 變異數的隨機係數 | 隨機效果指向殘差變異數的對數 | 28.2 |
| 作為潛在變項的隨機係數 | 數個結果變項在群組層次的隨機截距是潛在變項,作為一個組間層次因素的指標 | 29.1, 30.1 |
| 交叉分類的隨機係數 | 試題或第二種分類的隨機效果,位於各自的 plate 中 | 26.2, 30.3 |
| 隨機處理效果 | 處理係數在場域之間變動 | 16.4(b), 31.6 |
註:圖:本書各章中的圖編號;字母代表小圖。
D.4模型圖所隱含的資料圖示#
倒過來讀,一張模型圖就是一份資料圖示的檢核清單:每個元素都隱含一種圖示,顯示該元素是否必要,以及它的假定是否合理(第 2 與第 4 章)。表 D.4 把各元素與其圖示配對,並指出書中的範例。這些圖示最有用的時機有二:在配適模型之前,用來決定模型需要哪些元素;在配適之後,用來檢查模型已有的元素。
| 元素 | 圖示 | 範例 |
|---|---|---|
| plate | 小倍數圖:每個群組一個小圖 | 2.6(a), 4.3 |
| 隨機截距 | 排序後並附區間的組平均數或截距(毛毛蟲圖) | 4.5, 5.1, 12.6 |
| 隨機斜率 | 畫在共同座標軸上的各群組迴歸線(義大利麵圖) | 2.6(b), 4.6, 6.1 |
| 隨機斜率(變異數) | 結果變項的變異數對帶有隨機斜率之預測變項的圖(變異數函數) | 2.2, 4.7, 6.2 |
| 隨機係數的共變數 | 各群組截距對各群組斜率的圖 | 2.6(c) |
| 群組層次預測變項 | 組平均數對該預測變項的圖,或依組別呈現的組平均數 | 4.4(c), 5.1, 5.4 |
| 跨層級交互作用 | 依群組層次預測變項呈現的各群組斜率或預測線 | 4.4(c), 6.7 |
| 殘差短箭頭 | 第一層殘差對配適值與預測變項的圖 | 15.1, 15.4 |
| 展開的測量時間點 | 依延宕呈現的殘差相關,以及變異圖 | 4.8, 20.3 |
| 確定性的組平均數 | 組內迴歸與組間迴歸 | 5.4 |
註:範例:本書各章中的圖編號;字母代表小圖。
D.5資料圖的風格#
本書的資料圖以 ggplot2 (Wickham, 2016) 繪製,共用一個主題、一組配色與一個匯出函式,三者都定義在 Style/mlmbook_figtheme_V01.R 中;每一個繪圖程式都先以 source 載入這個檔案。這個主題是以 Source Sans Pro 字型排版的極簡主題:格線低調、座標軸線細,圖例放在下方,除非直接標示或小圖中空著的角落更合適。主題的預設基本字級是 10 點;大多數圖使用 8.5 或 9 點,使刻度標籤與圖例文字在印刷尺寸下約為 7 點,匯出得比版心寬、再縮小置入的圖也是如此。這個主題的用意,是讓墨水落在資料上,而不是落在框架上。
配色(表 D.5)的選擇,讓每一張圖無論在灰階印刷或在螢幕上都能正確閱讀。兩種系列顏色的明度差異很大:在 CIE (它近似於一個顏色在灰階印刷中呈現的灰度)上,藍色為 37,橙色為 70。系列的辨識從不只依靠顏色。含兩個系列的圖同時使用藍色與橙色,並搭配不同的點形狀(依序為實心圓、實心三角形、實心方形、空心圓)或線型(實線、虛線、長虛線、點線),再以直接標示或圖例標出各系列。單一系列畫成藍色或灰色;許多背景系列,例如 160 所學校的迴歸線,畫成細而部分透明的灰色(例如圖 4.6 與圖 6.1)或淺灰色(圖 5.4);帶狀區域與填色則用淡灰色。橙色與白色的對比太低,不能用於文字,因此只用於圖形標記。
| 名稱 | 十六進位色碼 | 色樣 | 用途 | |
|---|---|---|---|---|
blue
| #245A8F
|
| 37 | 第一個系列或單一系列;在灰階中呈深色 |
orange
| #E39B3F
|
| 70 | 第二個系列;在灰階中呈淺色,一律搭配第二種編碼 |
grey
| #5E5E5E
|
| 40 | 單一系列、多群組的線、參考線 |
ink
| #1A1A1A
|
| 9 | 文字與座標軸 |
light
| #BDBDBD
|
| 77 | 背景資料、多群組的義大利麵圖 |
pale
| #E6E6E6
|
| 91 | 填色與帶狀區域 |
註:名稱:mlm_col 中的名稱。:由十六進位色碼計算的 CIE 明度(D65 白點),從 0(黑)到 100(白);作為經驗法則,相差超過約 20 個單位的顏色,在灰階印刷中仍可區分。
每一張資料圖都由 save_mlm_fig() 匯出三次:PDF(向量格式,供本書與印刷使用)、300 dpi 的 PNG(供投影片與網頁使用),以及 SVG(供規劃中的網頁版使用)。預設寬度為 5.7 英吋,也就是版心的寬度,高度則依每張圖個別設定;半數的資料圖以較寬的尺寸匯出,最寬到 6.3 英吋,置入時再縮小。幾條實用規則可以讓各圖保持一致。座標軸範圍最好用 coord_cartesian() 設定,而不要用尺度範圍(scale limits)設定,因為尺度範圍會移除範圍外的資料,並改變由資料計算的平滑曲線與摘要;本書許多繪圖程式仍使用尺度範圍,但只有在沒有資料落在範圍之外時,這樣做才安全。數學標籤使用 plotmath 運算式,例如 expression(tau[0]^2),它在每一種繪圖裝置上都以相同的方式排出上標與下標;Unicode 的上下標字元則取決於字型,而 R 預設的 pdf() 裝置會把其中大部分(例如下標數字)換成點。程式以 ASCII 撰寫,需要希臘字母或減號的地方使用 Unicode 跳脫序列,並在 UTF-8 語系環境(locale)下執行。兩個美學映射(aesthetics;例如顏色與線型)只有在標題、分界點與標籤都一致時,才共用一個圖例;圖例符號不同的圖層(例如誤差線)則以 show.legend = FALSE 繪製,以免它改變圖例符號。
D.6TikZ 圖的風格#
示意圖、流程圖、加註的軟體輸出,以及其他不是資料圖的圖,都以 TikZ 繪製。在第 1 至 32 章與附錄 A 至 C 的 203 張圖中,71 張是 TikZ 圖,132 張以 R 繪製;TikZ 圖中有 48 張是統一模型圖,分布於 27 章。每一張 TikZ 圖都是 Scripts/ChNN/ 中的一份獨立文件,標籤使用 Source Sans Pro 字型;除了五張沒有模型記號的圖(圖 9.6、圖 14.1、圖 16.2 與圖 17.5 的流程圖,以及圖 18.4 的資料夾樹狀圖)之外,內文與數學式使用 New PX 字型;所有統一模型圖與另外四張示意圖,也都載入樣式檔 umg-style.tex。每一張圖都由 Scripts/Shared/build_tikz_figure.sh 編譯成與資料圖相同的三種格式:
bash Scripts/Shared/build_tikz_figure.sh \
     Scripts/Ch06/fig06_06_crosslevel_umg_V01.tex Figures/Ch06/fig06_06_crosslevel_umg
模型圖只以黑色與灰色繪製,因此完全不需要顏色;觀察頂點以 13% 的黑色填色。四張報告結果的 TikZ 圖(圖 11.3、圖 13.3、圖 30.4 與圖 32.4)由計算這些結果的 R 程式寫出,使圖中的數字不可能與結果脫節;兩張印出估計值的模型圖(圖 18.1 與圖 19.3)則在檔頭註明數字取自哪一個結果檔。第 D.9 節收錄樣式檔,以及圖 D.2 的原始碼。
D.7圖表標題、註與編號#
圖與表遵循 APA Publication Manual (American Psychological Association, 2020) 的格式。編號(例如 圖 6.6)以粗體排在圖或表的上方,標題排在下一行,使用斜體與標題式大小寫(title case);接著是圖或表本身,下方再放以 Note.(中文版為「註:」)開頭、靠左對齊的註。在 LaTeX 中,標題與標籤放在圖片之前,註則放在置中的區塊之外,如下面這個示意範例:
\begin{figure}[tbp]
\caption{Unified Model Graph of the Cross-Classified Random-Effects Model}
\label{fig:ch26-crossed}
{\centering\includegraphics[width=\linewidth]{fig26_02_crossed_umg.pdf}\par}
\fignote{Overlapping plates: ... (mechanics only)}
\end{figure}圖註說明圖的構成方式:座標軸、符號、線型、灰底與縮寫各代表什麼。圖註不報告結果,結果屬於正文。表格只使用水平線(\{}toprule、\{}midrule、\{}bottomrule),註放在表的下方;表註定義符號與縮寫,不重複正文的內容。
圖與表依章編號,通常依它們在正文中第一次被引用的順序;但在第 20 與第 23 章中各有一張較後面的圖、在第 10、18 與第 32 章中各有一張較後面的表,在較前面的圖或表之前就被順帶提及。檔案也採用相同的編號:檔案 fig06_06_crosslevel_umg 就是圖 6.6,其原始檔為 Scripts/Ch06/fig06_06_crosslevel_umg_V01.tex;資料圖則由 R 程式寫出,這個程式或是主檔名相同的繪圖程式,或是計算該圖內容的分析程式或製表程式。檢查全部 203 張圖,檔案編號與圖編號不一致的圖為 0 張。在後續版本中插入一張圖時,其後的檔案會與圖一起重新編號,使檔名永遠能指出一張圖出現在哪裡。
D.8模型圖目錄#
表 D.6 列出本書的 48 張統一模型圖及其原始檔。它們合起來構成一份模型的視覺索引:第 II 篇的隨機截距、隨機斜率與三層次模型,後面幾章的縱貫模型與廣義線性混合效果模型,以及第 VII 篇的潛在變項、測量與因果模型,全都以同一套圖形語法呈現;其中任何一張圖的原始檔,都可以作為繪製新模型圖的起點。
| 圖 | 標題 | 原始檔 |
|---|---|---|
| 1.2 | 變項在哪一層:以 plate 呈現的三種資料結構 | fig01_02_plates_preview
|
| 1.7 | 以 plate 呈現的多層次命題類型 | fig01_07_propositions_umg
|
| 2.3 | 統一模型圖的圖形詞彙 | fig02_03_umg_lexicon
|
| 2.4 | 以統一模型圖表示虛無模型、隨機截距模型,以及隨機截距與斜率模型 | fig02_04_three_models_umg
|
| 2.5 | 參數提升:同一個係數的四種位置 | fig02_05_parameter_promotion
|
| 3.2 | 學校平均數的完全合併、不合併與部分合併 | fig03_02_pooling_umg
|
| 4.9 | plate 就是迴圈:隨機截距與斜率模型的圖形與資料生成程式 | fig04_09_plates_as_loops
|
| 5.2 | 帶有固定學校效果的共變數分析與隨機截距模型 | fig05_02_ancova_vs_ri_umg
|
| 5.6 | 含學校層次預測變項的隨機截距模型 | fig05_06_level2_umg
|
| 6.6 | 以學校預測變項預測截距與斜率的隨機截距與斜率模型 | fig06_06_crosslevel_umg
|
| 7.3 | 隨機截距模型中的外顯組平均數與潛在組平均數 | fig07_03_manifest_latent_umg
|
| 8.2 | 以統一模型圖呈現的三層次虛無模型 | fig08_02_empty_threelevel_umg
|
| 8.4 | 各層次都有預測變項、且學生層次斜率在班級與學校之間變動的三層次模型 | fig08_04_threelevel_slopes_umg
|
| 10.1 | 以一對 UMG 呈現關於固定效果的聯合假設 | fig10_01_hypothesis_umg
|
| 12.1 | 在統一模型圖上預測隨機截距 | fig12_01_posterior_umg
|
| 13.1 | 以 ML 或 REML 估計的隨機截距與斜率模型,以及作為貝氏階層模型的同一模型 | fig13_01_bayes_umg
|
| 16.4 | 集群隨機試驗與多場域試驗的統一模型圖 | fig16_04_trial_umg
|
| 17.2 | 省略隨機斜率的插補模型,與實質模型相容的模型 | fig17_02_congeniality_umg
|
| 18.1 | 以統一模型圖呈現的 HSB 最終模型及其估計值 | fig18_01_hsb_final_umg
|
| 19.3 | 以統一模型圖呈現的無條件線性成長模型 | fig19_03_growth_umg
|
| 20.5 | 以統一模型圖呈現含一階自我迴歸殘差的隨機截距模型 | fig20_05_ri_ar1_umg
|
| 21.2 | 隨時間變動之預測變項個人內–個人間分解的統一模型圖 | fig21_02_decomposition_umg
|
| 21.4 | 含隨機慣性之多層次 AR(1) 模型的統一模型圖 | fig21_04_ar1_umg
|
| 21.6 | 兩層次動態結構方程模型的統一模型圖 | fig21_06_dsem_umg
|
| 21.7 | 隨機截距交叉延宕模型的統一模型圖 | fig21_07_riclpm_umg
|
| 22.1 | 線性成長模型的統一模型圖:plate 形式與展開形式 | fig22_01_plate_flat_umg
|
| 22.3 | 二階潛在成長模型的統一模型圖 | fig22_03_secondorder_umg
|
| 22.4 | 成長混合模型的統一模型圖 | fig22_04_gmm_umg
|
| 23.1 | 兩層次邏輯斯隨機截距模型的統一模型圖 | fig23_01_logistic_umg
|
| 24.2 | 兩層次累積勝算對數模型的統一模型圖 | fig24_02_ordinal_umg
|
| 24.4 | 兩層次基準類別勝算對數模型的統一模型圖 | fig24_04_multinomial_umg
|
| 24.6 | 零膨脹與 hurdle 計數模型的統一模型圖 | fig24_06_zero_umg
|
| 25.3 | 多層次離散時間存活模型的統一模型圖 | fig25_03_hazard_umg
|
| 26.2 | 交叉分類隨機效果模型的統一模型圖 | fig26_02_crossed_umg
|
| 26.5 | 多重隸屬模型的統一模型圖 | fig26_05_mm_umg
|
| 27.1 | 雙變量兩層次模型的統一模型圖 | fig27_01_mv_umg
|
| 27.2 | 行動者-伴侶相依模型的統一模型圖 | fig27_02_apim_umg
|
| 27.3 | 隨機效果後設迴歸模型的統一模型圖 | fig27_03_meta_umg
|
| 28.2 | 混合效果位置-尺度模型的統一模型圖 | fig28_02_mels_umg
|
| 29.1 | 兩層次因素模型的統一模型圖:plate 形式與展開形式 | fig29_01_twolevel_umg
|
| 29.2 | 雙重潛在脈絡模型的統一模型圖 | fig29_02_doubly_latent_umg
|
| 29.4 | 1-1-1 多層次中介效果的統一模型圖:組內與組間路徑 | fig29_04_mediation_umg
|
| 30.1 | 兩層次因素模型的統一模型圖 | fig30_01_mcfa_umg
|
| 30.3 | 含交叉之個人效果與試題效果的 Rasch 模型統一模型圖 | fig30_03_rasch_umg
|
| 30.6 | 解釋性試題反應模型的統一模型圖 | fig30_06_explanatory_umg
|
| 30.7 | 含跨學校 DIF 的多層次 Rasch 模型統一模型圖 | fig30_07_mlirt_umg
|
| 31.3 | 附因果標記的組內–組間模型統一模型圖 | fig31_03_wb_causal_umg
|
| 31.6 | 集群隨機試驗與多場域集群隨機試驗的統一模型圖 | fig31_06_trials_umg
|
D.9原始碼#
樣式檔定義了表 D.1 中的每一個元素。每一張統一模型圖以及另外四張示意圖,都在前置區(preamble)載入這個檔案;檔中的註解所指的是 UMG 手稿 (Yu, 2026a) 中的表與節:
% ============================================================
% Title:  UMG TikZ lexicon: visual primitives of the Unified
%         Model Graph (UMG) system
% File:   umg-style.tex
% Author: H.-T. Yu
% Date:   2026-06-12
% ============================================================
% Input this file in the preamble of any document (manuscript or
% standalone figure) that draws UMG diagrams. Requires TikZ.
%
% Channel-to-attribute mapping (see Table 2 of the manuscript):
%   Fill (luminance) -> observability  (shaded = observed; white = latent)
%   Shape            -> support        (circle = continuous; square = categorical)
%   Border           -> role           (single = random variable; double = deterministic)
%   Diamond          -> fixed unknown parameter (frequentist target of estimation)
%   Triangle         -> known constant (e.g., the unit constant for means)
%   Rounded box      -> plate (exchangeable replication; nesting = hierarchy)
% ------------------------------------------------------------
\usetikzlibrary{arrows.meta,positioning,fit,backgrounds,shapes.geometric,calc}

\tikzset{
  % ----- Vertex primitives -----------------------------------------
  % continuous latent random variable: white circle
  vCL/.style={draw, circle, minimum size=9.5mm, inner sep=1pt, line width=0.7pt, fill=white},
  % continuous observed random variable: shaded circle
  vCO/.style={draw, circle, minimum size=9.5mm, inner sep=1pt, line width=0.7pt, fill=black!13},
  % categorical latent random variable (e.g., latent class): white square
  vDL/.style={draw, rectangle, minimum size=8.5mm, inner sep=2pt, line width=0.7pt, fill=white},
  % categorical observed random variable (e.g., item response): shaded square
  vDO/.style={draw, rectangle, minimum size=8.5mm, inner sep=2pt, line width=0.7pt, fill=black!13},
  % fixed unknown parameter: open diamond
  vP/.style={draw, diamond, aspect=1.15, minimum size=7.5mm, inner sep=0.5pt, line width=0.7pt, fill=white},
  % deterministic node: double border (shape follows support)
  vDetC/.style={draw, circle, double, double distance=1.1pt, minimum size=9.5mm, inner sep=1pt, line width=0.5pt, fill=white},
  vDetD/.style={draw, rectangle, double, double distance=1.1pt, minimum size=8.5mm, inner sep=2pt, line width=0.5pt, fill=white},
  % known constant: triangle (RAM heritage); label inside
  vK/.style={draw, isosceles triangle, isosceles triangle apex angle=60,
             shape border rotate=90, minimum size=7mm, inner sep=0.5pt,
             line width=0.7pt, fill=white},
  % small disturbance/residual node (continuous latent, reduced size)
  vEps/.style={draw, circle, minimum size=6.5mm, inner sep=0.5pt, line width=0.6pt, fill=white},
  % ----- Edge primitives -------------------------------------------
  % stochastic/functional dependence (regression, loading)
  eReg/.style={->, >={Stealth[length=2.8mm]}, line width=0.7pt},
  % covariance / unanalyzed association (symmetric)
  eCov/.style={<->, >={Stealth[length=2.5mm]}, line width=0.7pt},
  % deterministic assignment
  eDet/.style={->, >={Stealth[length=2.8mm]}, line width=0.7pt, dashed},
  % mixing edge: latent class -> parameter set (open arrowhead)
  eMix/.style={->, >={Triangle[open, length=3mm]}, line width=0.7pt},
  % variance stub: double-headed self-loop on a node
  eVar/.style={<->, >={Stealth[length=2mm]}, line width=0.6pt, looseness=5},
  % edge parameter label
  elab/.style={font=\small, fill=white, inner sep=1pt, sloped=false},
  elabplain/.style={font=\small, inner sep=1.5pt},
  % ----- Plates ------------------------------------------------------
  plate/.style={draw, rounded corners=4pt, inner sep=9pt, line width=0.6pt},
  platelab/.style={anchor=south east, inner sep=4pt, font=\small\itshape},
  platelabnw/.style={anchor=north west, inner sep=4pt, font=\small\itshape},
  % ----- Auxiliary ---------------------------------------------------
  dist/.style={font=\footnotesize, text=black!70, inner sep=1pt},
  causalbadge/.style={draw, rounded corners=2pt, font=\footnotesize\sffamily,
                      inner sep=2.5pt, fill=black!5},
}

% Residual stub: arrow into #1 from direction #2 (angle), with label #3.
% Compact abbreviation for an explicit disturbance node; see Section 4.5.
\newcommand{\umgstub}[3]{%
  \draw[eReg] ($(#1)+(#2:0.95)$) -- (#1);
  \node[elabplain] at ($(#1)+(#2:1.25)$) {#3};%
}
圖 D.2 的原始碼呈現一張完整的模型圖。頂點放在明確指定的座標上,使版面配置不依賴自動擺放;plate 在背景圖層上依其頂點的位置框出;plate 的標籤則放在各 plate 的右下角:
\documentclass[border=3pt]{standalone}
\usepackage[T1]{fontenc}
\usepackage{newpxtext,newpxmath}
\usepackage[scale=0.95]{sourcesanspro}
\usepackage{tikz}
\input{umg-style.tex}
\tikzset{mk/.style={circle, fill=black, text=white, font=\sffamily\bfseries\scriptsize, inner sep=0.6pt, minimum size=3.6mm}}
\begin{document}
\begin{tikzpicture}
% parameters outside all plates
\node[vP] (g00) at (0.0,6.0) {$\gamma_{00}$};
\node[vP] (g01) at (1.1,6.0) {$\gamma_{01}$};
\node[vP] (g02) at (2.2,6.0) {$\gamma_{02}$};
\node[vP] (g10) at (4.6,6.0) {$\gamma_{10}$};
\node[vP] (g11) at (5.7,6.0) {$\gamma_{11}$};
% cluster level
\node[vCL] (b0) at (1.1,2.6) {$\beta_{0j}$};
\node[vCL] (b1) at (5.1,2.6) {$\beta_{1j}$};
\node[vCO] (z)  at (3.1,4.0) {$z_j$};
\node[vDetC] (xb) at (-0.9,2.6) {$\bar x_j$};
% unit level
\node[vCO] (x) at (1.6,0.2) {$x_{ij}$};
\node[vCO] (y) at (4.3,0.2) {$y_{ij}$};
% edges
\draw[eReg] (g00) -- (b0); \draw[eReg] (g01) -- (b0); \draw[eReg] (g02) -- (b0);
\draw[eReg] (g10) -- (b1); \draw[eReg] (g11) -- (b1);
\draw[eReg] (z) -- (b0); \draw[eReg] (z) -- (b1);
\draw[eDet] (x) to[bend left=25] (xb);
\draw[eReg] (xb) -- (b0);
\draw[eReg] (b0) -- (y); \draw[eReg] (b1) -- (y); \draw[eReg] (x) -- (y);
\draw[eCov] (b0) to[bend right=12] node[elab, below]{\scriptsize $\tau_{01}$} (b1);
\draw[eVar] (b0.205) to[out=205, in=255, looseness=6] node[elabplain, below left]{\scriptsize $\tau_0^2$} (b0.255);
\draw[eVar] (b1.30) to[out=30, in=-30, looseness=6] node[elabplain, right]{\scriptsize $\tau_1^2$} (b1.330);
\umgstub{y}{0}{$\sigma^2$}
\begin{scope}[on background layer]
  \coordinate (yr) at ($(y)+(1.55,0)$);
  \node[plate, fit=(x)(y)(yr), inner xsep=16pt, inner ysep=12pt] (pi) {};
  \node[plate, fit=(pi)(b0)(b1)(z)(xb), inner xsep=22pt, inner ysep=16pt] (pj) {};
\end{scope}
\node[platelab, font=\scriptsize\itshape] at (pi.south east) {$i=1,\dots,n_j$};
\node[platelab, font=\scriptsize\itshape] (jlab) at (pj.south east) {$j=1,\dots,J$};
% numbered markers (Table D.2)
\node[mk] at (-0.75,6.25) {1};
\node[mk] at (0.35,3.25) {2};
\node[mk] at (3.75,2.05) {3};
\node[mk] at (3.75,4.55) {4};
\node[mk] at (4.4,3.65) {5};
\node[mk] at (-1.7,3.25) {6};
\node[mk] at (1.0,-0.45) {7};
\node[mk] at (6.0,0.62) {8};
\node[mk, left=2pt of jlab] {9};
\end{tikzpicture}
\end{document}