資料集目錄與編碼簿
本附錄內容檔案、格式與建立檔案的程式;來源、使用許可與引用;真實資料集概覽;核心資料集的編碼簿;其他資料集的變項;模擬資料集;模擬研究;有描述但未分析的資料。
本書使用 30 個真實資料集、14 個以檔案形式提供的模擬資料集,以及 35 項模擬研究的資料;模擬研究的資料不另外提供,因為其程式會重新產生這些資料。本附錄記錄每個資料集的來源、準備方式、使用它的章節,以及各變項的意義。圖 C.1 讓讀者一眼看出每一章使用哪些真實資料集:少數幾個資料集撐起核心章節,而討論延伸主題的各章則各自帶來自己的資料。圖中前 10 列是核心資料集,第 C.4 節逐一記錄它們的每個變項。
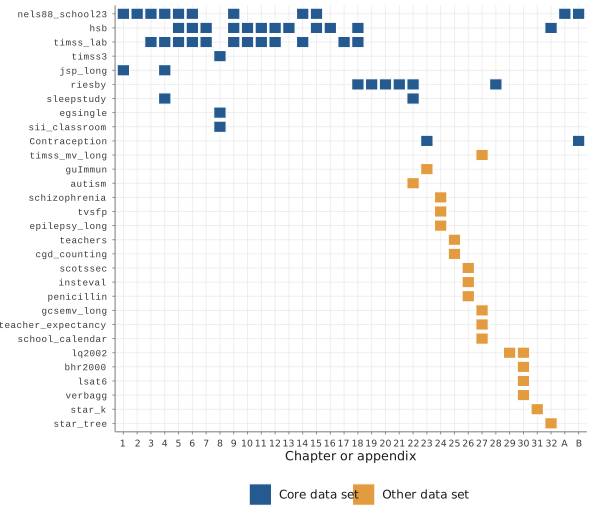
C.1檔案、格式與程式#
本書隨附的儲存庫把資料放在三個資料夾中。Data/ 為每個資料集存放一個分析檔,並以內容相同的兩種格式提供:一個是 R 資料檔(.rds),它保留變項的類型,也是本書程式所讀取的檔案;另一個是供其他程式使用的逗號分隔副本(.csv);模擬資料集的附屬檔案只有 .csv 檔,程式也以這個格式讀取它們。Data/raw/ 存放部分分析檔據以建立的原始檔案;Data/export/ 則存放三個 zip 壓縮檔,以 SPSS(.sav)、Stata(.dta)與 Mplus(.dat)檔收錄相同的資料:每個壓縮檔有 58 個檔案,也就是表 C.2 與 C.5 的 44 個資料集,加上 14 個附屬檔案,例如 HSB 分開的學生檔與學校檔,以及模擬日記資料中每個人的真實參數。直接從 R 套件讀取的資料集(真實資料集中有四個)在 Data/ 中沒有檔案,但壓縮檔中有收錄;檔案 export_manifest_V01.csv 列出每個匯出檔案的列數與欄數。Data/raw/ 也保留了課程的三個 SAS 程式(school10-data.sas、How_to_Simulate_Data.sas 與 SAS_MergeData.sas)供參考;沒有任何程式會讀取它們。
每個分析檔都由程式寫出,從不手動編輯。第 1 至 20 章的檔案由 Scripts/Shared/ 中的 prepare_*_V01.R 程式建立;第 21 至 32 章所引入的檔案,則由引入該檔案之章節的 data_chNN_*_V01.R 程式建立。每個準備程式都會說明其輸入與所做的重新編碼;Scripts/Shared/ 中的程式還會檢查結果,例如各層次的單位數,以及叢集層次變項在叢集內是否為常數。匯出的壓縮檔由 Scripts/AppC/appC_export_formats_V01.R 寫出;這個程式會把每個 SPSS 與 Stata 檔讀回,並把它的維度與來源比較。
在 R 中,資料集可以從其檔案讀取,也可以從其套件讀取:
book_root <- "path/to/Textbook"                  # the repository folder
hsb <- readRDS(file.path(book_root, "Data", "hsb.rds"))
hsb <- read.csv(file.path(book_root, "Data", "hsb.csv"))      # same content
data(sleepstudy, package = "lme4")               # package-only data sets
在 .csv 與 .rds 檔中,遺漏值為 NA;在 SPSS 與 Stata 檔中,遺漏值為系統遺漏值(system-missing);在沒有標題列的 Mplus 檔中,遺漏值則編碼為 。每個 Mplus 資料檔都附有一個輸入雛形檔(input stub,.inp),列出變項名稱與遺漏值代碼,並記錄在 R 中為文字或因子之變項的代碼。雛形檔中的 Mplus 變項名稱最多八個字元;有九個檔案為此縮短了名稱,雛形檔會列出每個原始名稱及其縮短後的名稱。含有句點的名稱,例如 hos.cat,在 SPSS 與 Stata 檔中改以底線書寫。匯出之前,識別碼以及其他類別為數字的類別變項會寫成這些數字;只有兩個類別的變項編碼為 0 與 1,並附值標籤(例如避孕措施使用的 N = 0、Y = 1);其他因子則保留從 1 起算的代碼,並附值標籤。超過兩個類別的文字變項,例如後設分析資料中的作者姓名,在 SPSS 與 Stata 檔中仍為文字,並排除在 Mplus 檔之外,改由雛形檔列出。在有 SAS/ACCESS Interface to PC Files 授權的環境中,SAS 可以用 PROC IMPORT 讀取 SPSS 與 Stata 檔;.csv 檔也可以匯入,但其以 NA 表示的遺漏值必須另行重新編碼。HLM 以每個層次一個檔案建立其多變量資料矩陣,檔案須依叢集識別碼排序;HSB(hsb_pupils、hsb_schools)與 TIMSS(timss_pupils、timss_schools)分開的學生檔與學校檔就是為此而設,其他任何資料集也可以用同樣的方式拆分,只要每個叢集只保留一次叢集層次變項即可。
在配適任何模型之前,都應該先留意識別碼(第 4 章)。在多數檔案中,單位的識別碼在各叢集之間是唯一的。例外的情形包括:NELS:88 的學生編號與 GCSE 資料的學生編號,都在每所學校重新起算;Junior School Project 的班級編號,在每所學校重新起算;學年行事曆資料的學校編號,在每個學區重新起算;以及在模擬資料中,med211_sim 的成員編號在每個團隊重新起算,did_sim 的學生編號則在每所學校的每個年度重新起算。在這些檔案中,單位要以它本身的編號與所屬叢集之編號的組合來識別。所有檔案都不含抽樣權數;第 17 章的加權範例使用模擬的母群。
C.2來源、使用許可與引用#
表 C.2 列出每個真實資料集的來源。在 30 個真實資料集中,有 23 個隨 R 套件發布(表 C.1)或由這類資料衍生而來,另外七個來自本書所依據之課程的檔案庫,或由其中的檔案衍生而來。使用任何資料集的人都應該引用其原始來源(列於表 C.2 的「來源」欄);若是套件中的資料,也應該引用該套件。
| 套件 | 版本 | CRAN | 授權 | 使用的資料物件 |
|---|---|---|---|---|
nlme
| 3.1-164 | 3.1-171 | GPL ( 2) | MathAchieve, MathAchSchool |
lme4
| 1.1-35.1 | 2.0-6 | GPL ( 2) | sleepstudy, InstEval, Penicillin, VerbAgg |
mlmRev
| 1.0-9 | 1.0-9 | GPL ( 2) | egsingle, Contraception, guImmun, ScotsSec, Gcsemv, star |
WWGbook
| 1.0.2 | 1.0.2 | GPL ( 2) | classroom, autism |
brms
| 2.23.0 | 2.23.0 | GPL-2 | epilepsy |
survival
| 3.5-8 | 3.8-12 | LGPL ( 2) | cgd |
metadat
| 1.2-0 | 1.6-0 | GPL ( 2) | dat.raudenbush1985, dat.konstantopoulos2011 |
multilevel
| 2.8 | 2.8 | GPL ( 2) | lq2002, bhr2000 |
mirt
| 1.47 | 1.47 | GPL ( 3) | LSAT6 |
mixor
| 1.0.4(CRAN 封存版) | 1.0.7 | GPL ( 2) | schizophrenia, SmokingPrevention |
註:版本:準備本書資料時所記錄的版本。CRAN:2026 年 10 月 4 日 CRAN 上的最新版本;本書使用的資料物件在兩個版本中完全相同。授權:套件 DESCRIPTION 檔中的 license 欄位。使用的資料物件:本書程式所讀取的 R 物件。目前的 mixor 需要 R 4.6 或更新的版本,無法安裝在本書的運算環境(R 4.3)中;其資料取自 1.0.4 版的原始碼封存檔。第 30 章的試題反應模型以 lme4 2.0-6 配適。
表 C.1 中的授權是各套件的軟體授權,沒有任何一個套件為其資料另訂條款。這些授權並不決定原始研究的使用條件;使用條件仍由原始研究者與機構決定。Kreft 與 de Leeuw (1998) 的 NELS:88 子樣本也隨 R 套件 influence.ME 發布,其說明文件指出,這份資料經 Jan de Leeuw 許可而重製 (Nieuwenhuis et al., 2012);本書使用的課程檔案,在兩者共有的每一個變項上,對全部 519 名學生都與該版本一致,其類別變項的代碼也已對照該說明文件中的標籤。其他課程檔案的取得方式如下:Junior School Project 檔案取自 Centre for Multilevel Modelling(現屬 University of Bristol)的網站 multilevel.ioe.ac.uk,如其檔頭所述;Riesby 檔案是 Hedeker 與 Gibbons (2006) 所發布的版本;教師流動檔案取自 UCLA Office of Advanced Research Computing 為 Singer 與 Willett (2003) 所設的資料網頁;TIMSS 上機實作檔案則來自課程的電腦上機實作。TIMSS 檔案的檔頭把資料年份標為 1997 年,然而 3 年級與 4 年級學生是在 1995 年那一輪的 TIMSS 中接受評量的;課程紀錄無法釐清這項出入。這些課程檔案保存在儲存庫中供教學使用;由於尚未取得原始發布者同意公開再散布,儲存庫若公開釋出,將只包含準備程式以及取得原始檔案的說明,而不包含這些檔案本身。
C.3真實資料集概覽#
表 C.2 列出 30 個真實資料集的結構、來源,以及使用它們的章節。單位數是在所提供的檔案中清點的,因此當模型排除有遺漏值的觀察值時,可能與某一章所分析的數目不同。有幾項分析使用的子集沒有自己的檔案,因為其程式會從所提供的檔案中抽取這些子集。第 3 章使用 NELS:88 其中 10 所學校(7472、7829、7930、24725、25456、25642、62821、68448、68493 與 72292)的 260 名學生。圖 5.3 呈現以亂數種子 5003 抽出的 30 所 HSB 學校。第 9 與 10 章使用 50 所 HSB 學校的隨機樣本,以及從這 50 所中抽出的 20 所學校隨機樣本,以亂數種子 20261020 抽出;第 13 章使用另一個 20 所學校的隨機樣本,以亂數種子 20261320 抽出,圖 13.2 與 13.4 則使用以亂數種子 6 抽出的八所學校,每校 10 名學生。第 9 與 10 章也讀取 TIMSS 資料的第二個課程檔案 Data/raw/timss_lab2new.txt,它為同一批學生加上他們自陳的看電視時間與玩電腦遊戲時間(hoursTV、hourscomputergames;各為五個有次序的類別,1 = 最少,5 = 最多),以及學校所在的社區類型(community:1 = 地理上孤立,2 = 村莊或農業地區,3 = 城鎮或都市的外圍,4 = 靠近城鎮或都市的中心)。第 17 章以一個有書面記錄的隨機機制在 TIMSS 資料中製造遺漏值,亂數種子為 20261701。
| 資料集(檔案) | 結構 | 來源 | 章 |
|---|---|---|---|
NELS:88,23 所學校(nels88_school23)
| 23 所學校的 519 名學生;八年級,1988 年 | National Education Longitudinal Study of 1988;Kreft 與 de Leeuw (1998) 的子樣本;也收錄於 influence.ME (Nieuwenhuis et al., 2012)
| 1–6, 9, 14, 15, A, B |
High School and Beyond(hsb)
| 160 所學校的 7,185 名學生;1982 年;90 所公立、70 所天主教學校 | Raudenbush 與 Bryk (2002) 所分析的子樣本;nlme::MathAchieve 與 MathAchSchool (Pinheiro & Bates, 2000)
| 5–7, 9–13, 15, 16, 18, 32 |
TIMSS 上機實作檔(timss_lab)
| 146 所學校的 7,097 名學生;美國 3 年級與 4 年級學生 | 課程從 Third International Mathematics and Science Study(第三次國際數學與科學研究)美國樣本摘錄的檔案 | 3–7, 9–12, 14, 17, 18 |
TIMSS 含班級(timss3)
| 146 所學校 414 個班級中的 7,097 名學生;由 timss_lab 衍生
| 衍生:由學生識別碼解碼出班級 | 8 |
Junior School Project(jsp_long)
| 49 所學校 1,192 名學生的 3,236 筆紀錄;每位學生最多三筆年度紀錄 | 內倫敦的小學 (Mortimore et al., 1988);Goldstein (1987) 分析過 | 1, 4 |
Riesby 憂鬱資料(riesby)
| 66 位病人的 396 個測量時間點;第 0 至 5 週;觀察到 375 次評定;21 個遺漏值 | Reisby et al. (1977),採用 Hedeker 與 Gibbons (2006) 發布的版本 | 18–22, 28 |
睡眠剝奪研究(lme4::sleepstudy)
| 18 名受試者的 180 個觀察值;第 0 至 9 天 | Belenky et al. (2003);lme4::sleepstudy (Bates et al., 2015)
| 4, 22 |
Sustaining Effects Study(egsingle)
| 60 所學校 1,721 名學生的 7,230 個分數;每年一次,最多六次 | Raudenbush 與 Bryk (2002) 第 8 章所分析的子集;隨 HLM 與 mlmRev::egsingle 發布 (Bates et al., 2026)
| 8 |
教學改進研究(sii_classroom)
| 107 所學校 312 個班級中的 1,190 名學生;一年級;109 個遺漏值 | Hill et al. (2005);WWGbook::classroom (West et al., 2014)
| 8 |
孟加拉避孕資料(mlmRev::Contraception)
| 60 個地區的 1,934 位婦女;已婚婦女 | 孟加拉生育調查(Bangladesh Fertility Survey)(Huq & Cleland, 1990);mlmRev::Contraception
| 23, B |
TIMSS,堆疊的結果變項(timss_mv_long)
| 146 所學校 7,097 名學生的 14,194 個分數;數學與科學堆疊 | 由 timss_lab 衍生
| 27 |
瓜地馬拉疫苗接種資料(mlmRev::guImmun)
| 161 個社區 1,595 個家庭中的 2,159 名兒童 | Rodríguez 與 Goldman (2001);mlmRev::guImmun
| 23 |
自閉症社會化資料(WWGbook::autism)
| 158 名兒童的 612 個測量時間點;2、3、5、9、13 歲;2 個遺漏值 | West et al. (2014);WWGbook::autism
| 22 |
NIMH 思覺失調症研究(schizophrenia)
| 437 名病人的 1,603 筆評定 | Hedeker 與 Gibbons (1994);mixor 1.0.4 (Hedeker & Gibbons, 1996)
| 24 |
電視吸菸預防計畫(tvsfp)
| 28 所學校 135 個班級中的 1,600 名學生;僅用於習題 | Flay et al. (1995);mixor 1.0.4
| 24 |
progabide 癲癇試驗(epilepsy_long)
| 59 名病人的 295 個計數;基準期與四個追蹤期 | Thall 與 Vail (1990);brms::epilepsy
| 24 |
特殊教育教師的職涯(teachers)
| 3,941 位教師;teachers_pp 中有 24,875 個人-年
| Singer 與 Willett (2003),第 10 章 | 25 |
慢性肉芽腫病試驗(cgd_counting)
| 13 家醫院 128 位病人的 203 個區間;計數過程格式 | International Chronic Granulomatous Disease Cooperative Study Group (1991);survival::cgd (Therneau & Grambsch, 2000)
| 25 |
蘇格蘭的中學(scotssec)
| 3,435 位學生;148 所小學 19 所中學(交叉) | Paterson (1991);mlmRev::ScotsSec
| 26 |
ETH 課程評鑑(insteval)
| 73,421 筆評分;2,972 位學生 1,128 位授課教師(交叉);14 個系所 | lme4::InstEval (Bates et al., 2015)
| 26 |
Penicillin 檢驗(penicillin)
| 144 個觀察值;24 個培養皿 6 個樣本(交叉) | Davies 與 Goldsmith (1972);lme4::Penicillin
| 26 |
GCSE 筆試與課業作品分數(gcsemv_long)
| 73 所學校 1,905 位學生的 3,428 個分數;兩個結果變項堆疊 | mlmRev::Gcsemv
| 27 |
教師期望實驗(teacher_expectancy)
| 19 項研究;後設分析 | Raudenbush (1984);metadat (White et al., 2022)
| 27 |
調整式學年行事曆(school_calendar)
| 11 個學區的 56 項研究;後設分析 | Konstantopoulos (2011);metadat (White et al., 2022)
| 27 |
派駐海地的美國陸軍士兵(lq2002)
| 49 個連的 2,042 名士兵 | P. D. Bliese et al. (2002);multilevel (P. Bliese, 2026)
| 29, 30 |
美國陸軍的領導與工作時數(bhr2000)
| 99 個連的 5,400 名士兵 | P. D. Bliese 與 Halverson (1996);multilevel (P. Bliese, 2026)
| 30 |
LSAT 第 6 部分(lsat6)
| 1,000 位受測者;五道二元試題 | Thissen (1982);mirt::LSAT6
| 30 |
言語攻擊資料(verbagg)
| 7,584 個反應;316 人 24 道試題(交叉) | De Boeck 與 Wilson (2004);lme4::VerbAgg
| 30 |
Tennessee STAR,幼兒園(star_k)
| 79 所學校 337 個班級中的 5,871 位學生;18 個遺漏值 | Finn 與 Achilles (1990; Krueger, 1999);mlmRev::star
| 31 |
Tennessee STAR,小班與一般班級(star_tree)
| 79 所學校 225 個班級中的 3,784 位學生;調節變項完整 | 同 star_k
| 32 |
C.4核心資料集的編碼簿#
10 個核心資料集承載核心章節中反覆使用的範例。表 C.3 記錄這些資料集檔案中的每一個變項,共 97 個,包括每個變項在哪一個層次上變動、其意義,以及其代碼或範圍。以下各段補充表格無法呈現的內容:每個檔案如何準備,以及讀者在分析之前應該知道什麼。
NELS:88,23 所學校。 National Education Longitudinal Study of 1988(1988 年全國教育長期追蹤研究)於 1988 年春季調查八年級學生;Kreft 與 de Leeuw (1998) 的子樣本包含 23 所學校的 519 名學生。結果變項是數學測驗分數。作業變項是每週花在數學作業上之時間的有次序類別,而不是時數:各類別在時間上的間距不相等,因此作業的斜率是每一個類別的差異。指標變項 female、white 與 public 在準備程式中衍生;SES 與作業時間的學校平均數,以及以學校平均數平減的版本,則在使用它們的分析程式中計算。
High School and Beyond。 HSB 檔案合併了 Raudenbush 與 Bryk (2002) 的學生檔與學校檔,採用隨 nlme 發布的版本 (Pinheiro & Bates, 2000):1982 年調查的美國 160 所高中的 7,185 名學生,結果變項是數學成就。檔案包含兩個版本的學校平均 SES。變項 meanses 是抽樣學生之 ses 的平均數,ses_cwc 是以它平減的 SES;meanses_rb 則是隨資料發布的值,在每一所學校都比樣本平均數高出 0.0055 至 0.0065。第 5 至 7、18 與 32 章使用樣本平均數;第 9 至 13 與 15 章的部分表格使用發布的值,如各該程式所示。由於兩個版本相差的量幾乎固定,這兩個變項的係數在任一版本下都幾乎相同,截距則會略為移動。
TIMSS 上機實作檔。 這個課程檔案包含 146 所學校中 7,097 名美國 3 年級與 4 年級學生的科學與數學分數(採用課程檔案的計分尺度),以及一項學校特徵,即校長對教學材料短缺程度的評定。它以合併檔的形式提供,並為了第 4 章的合併練習,另外提供分開的學生檔與學校檔。檔案 timss3 加上了由學生識別碼解碼而得的班級,以及第 8 章三層次模型所用的數學班級平均數與學校平均數;它保留了性別與短缺評定的數值版本 girl 與 shortages。
Junior School Project。 長格式檔案為每位學生每年一筆紀錄,涵蓋內倫敦 49 所小學的 1,192 名學生 (Mortimore et al., 1988),最多有三個年度的數學分數;寬格式檔案 jsp_wide 每位學生一列,分數為 math0、math1 與 math2。第 1 章使用前兩年都有分數的 1,093 名學生。來源檔案中的其他變項維持原樣,本書並未使用。
Riesby 憂鬱資料。 檔案有 66 位病人,每人預定接受六次每週一次的漢氏憂鬱量表(Hamilton Depression Rating Scale)評定(第 0 至 5 週);預定的 396 次評定中觀察到 375 次,46 位病人六次評定齊全,37 位為內因性憂鬱症 (Hedeker & Gibbons, 2006; Reisby et al., 1977)。遺漏的評定保留為 NA,讓檔案顯示哪些評定遺漏;分析程式會將它們移除。研究中所測量的血漿藥物濃度不在課程檔案中。
睡眠剝奪研究、Sustaining Effects Study 與教學改進研究。 睡眠研究的資料採用隨 lme4 發布的版本:18 名受試者連續 10 天的反應時間,完全平衡 (Belenky et al., 2003)。Sustaining Effects Study 的檔案是 mlmRev::egsingle,其中兩個類別的因子重新編碼為 0 與 1,識別碼則存為文字:60 所學校學生每年一次、最多六次的數學分數,測驗年度經過平減。教學改進研究(SII)的檔案是 WWGbook::classroom (West et al., 2014):學校內各班級的一年級學生,結果變項是數學的進步分數;有 109 名學生的教師數學知識為遺漏值。
孟加拉避孕資料。 資料採用隨 mlmRev 發布的版本:60 個地區的 1,934 位已婚婦女 (Huq & Cleland, 1990)。在發布的檔案中,年齡已平減於平均數;分析程式把它改以十歲為單位,加入其平方項,把存活子女數簡化為是否有任何存活子女的指標變項,並把是否住在都市地區編碼為 0 與 1。
| 變項 | 層次 | 說明 | 值 |
|---|---|---|---|
A. NELS:88,23 所學校(nels88_school23)
| |||
school
| 學校 | 學校識別碼(NELS:88 學校編號) | 23 個值 |
student
| 學生 | 學生編號(在每所學校重新起算) | 0 至 99 |
sex
| 學生 | 性別 | 1 = 男生,2 = 女生 |
race
| 學生 | 種族或族裔 | 1 = 亞裔,2 = 西班牙語裔,3 = 黑人,4 = 白人,5 = 美洲原住民 |
homework
| 學生 | 每週花在數學作業上的時間 | 0 = 完全沒有,1 = 不到 1 小時,2 = 1 小時,3 = 2 小時,4 = 3 小時,5 = 4–6 小時,6 = 7–9 小時,7 = 10 小時以上 |
schtype
| 學校 | 學校類型 | 1 = 公立,2 = 天主教,3 = 其他宗教背景的私立學校,4 = 無宗教背景的私立學校 |
ses
| 學生 | 社經地位(合成分數) | 2.41 至 1.85 |
pared
| 學生 | 父母的最高教育程度 | 1 = 未完成高中,2 = 高中或 GED,3 = 高於高中但未取得四年制學位,4 = 大學畢業,5 = 碩士或同等學歷,6 = 博士、醫學博士或其他 |
math
| 學生 | 數學測驗分數 | 30 至 71 |
classstr
| 學校 | 班級環境的結構化程度(愈高 = 愈結構化) | 2 至 5 |
schsize
| 學校 | 學校的在學學生人數 | 1 = 1–199,2 = 200–399,3 = 400–599,4 = 600–799,5 = 800–999,6 = 1,000–1,199,7 = 1,200 以上 |
urban
| 學校 | 都市化程度 | 1 = 都市,2 = 郊區,3 = 鄉村 |
geo
| 學校 | 地區 | 1 = 東北部,2 = 中北部,3 = 南部,4 = 西部(資料中未出現) |
minority
| 學校 | 學校中少數族群學生的百分比 | 0 = 沒有,1 = 1–5,2 = 6–10,3 = 11–20,4 = 21–40(資料中未出現),5 = 41–60,6 = 61–90,7 = 91–100 |
ratio
| 學校 | 學生與教師的人數比 | 10 至 28 |
female
| 學生 | 女生(由 sex 衍生) | 0 = 男生,1 = 女生 |
white
| 學生 | 白人(由 race 衍生) | 0 = 其他,1 = 白人 |
public
| 學校 | 公立學校(由 schtype 衍生) | 0 = 私立,1 = 公立 |
B. High School and Beyond(hsb)
| |||
school
| 學校 | 學校識別碼 | 160 個值 |
minority
| 學生 | 學生屬於種族或族裔上的少數族群 | 0 = 否,1 = 是 |
female
| 學生 | 女生 | 0 = 男生,1 = 女生 |
ses
| 學生 | 社經地位(標準化的合成分數) | 3.76 至 2.69 |
mathach
| 學生 | 數學成就 | 2.83 至 24.99 |
size
| 學校 | 學校的在學學生人數 | 100 至 2,713 |
catholic
| 學校 | 公私立別 | 0 = 公立,1 = 天主教 |
pracad
| 學校 | 修讀學術學程的學生比例 | 0.00 至 1.00 |
disclim
| 學校 | 紀律氣氛(學校量表) | 2.42 至 2.76 |
himinty
| 學校 | 少數族群比例高的學校(少數族群學生超過 40%) | 0 = 否,1 = 是 |
meanses_rb
| 學校 | 隨資料發布的學校平均 SES(MEANSES)
| 1.19 至 0.83 |
n_j
| 學校 | 學校中抽樣學生的人數(衍生) | 14 至 67 |
meanses
| 學校 | 學校中 ses 的樣本平均數(衍生)
| 1.19 至 0.82 |
ses_cwc
| 學生 | ses 減去 meanses(衍生)
| 3.65 至 2.86 |
C. TIMSS 上機實作檔(timss_lab)
| |||
idschool
| 學校 | 學校識別碼 | 146 個值 |
idstud
| 學生 | 學生識別碼(最後兩位數之前的數字代表班級) | 7,097 個值 |
grade
| 學生 | 年級 | 3 或 4 |
gender
| 學生 | 性別 | boy、girl |
girl
| 學生 | 女生(由 gender 衍生) | 0 = 男生,1 = 女生 |
science
| 學生 | 科學分數(課程檔案的計分尺度) | 103.4 至 185.0 |
math
| 學生 | 數學分數(課程檔案的計分尺度) | 104.3 至 189.0 |
gen_short
| 學校 | 校長對教學材料短缺程度的評定 | none、a_little、some、a_lot |
shortages
| 學校 | gen_short 的數值版本(衍生)
| 0 = 沒有,1 = 有一點,2 = 有一些,3 = 很多 |
D. timss3 新增的變項
| |||
class
| 班級 | 班級識別碼(衍生:idstud/100 的整數部分)
| 414 個值 |
grade4
| 班級 | 4 年級(衍生) | 0 = 3 年級,1 = 4 年級 |
math_cls
| 班級 | math 的班級平均數(衍生)
| 121.5 至 165.9 |
math_sch
| 學校 | math 的學校平均數(衍生)
| 133.5 至 162.6 |
math_wc
| 學生 | math 減去班級平均數(衍生)
| 35.83 至 41.44 |
cls_ws
| 班級 | 班級平均數減去學校平均數(衍生) | 11.98 至 10.76 |
math_sch_c
| 學校 | 學校平均數減去總平均數(衍生) | 17.61 至 11.49 |
n_class
| 班級 | 班級中的學生人數(衍生) | 1 至 30 |
n_school
| 學校 | 學校中的學生人數(衍生) | 7 至 83 |
k_classes
| 學校 | 學校中的班級數(衍生) | 1 至 8 |
E. Junior School Project(jsp_long)
| |||
school
| 學校 | 學校識別碼 | 49 個值 |
class
| 學生 | 校內班級編號(本書未使用) | 1 至 4 |
gender
| 學生 | 來源檔案所編碼的性別(本書未使用) | 0、1(來源檔案未提供標籤) |
soclass
| 學生 | 來源檔案所編碼的社會階層(本書未使用) | 1 至 9 |
ravens
| 學生 | 依來源檔案之命名為 Raven 測驗分數(本書未使用) | 4 至 36 |
id
| 學生 | 學生識別碼(在各校之間唯一) | 1,192 個值 |
english
| 測量時間點 | 依來源檔案之命名為英文測驗分數(本書未使用) | 0 至 98 |
math
| 測量時間點 | 數學測驗分數 | 1 至 40 |
jsyear
| 測量時間點 | 小學(junior school)的就讀年度 | 0、1、2 |
F. Riesby 憂鬱資料(riesby)
| |||
id
| 病人 | 病人識別碼 | 66 個值 |
week
| 測量時間點 | 研究中的週數 | 0、1 = 停藥期;2 至 5 = imipramine |
hamd
| 測量時間點 | 漢氏憂鬱量表總分 | 0 至 39(21 個遺漏) |
endog
| 病人 | 憂鬱症類型 | 0 = 非內因性,1 = 內因性 |
G. 睡眠剝奪研究(lme4::sleepstudy)
| |||
Reaction
| 測量時間點 | 平均反應時間(ms) | 194.3 至 466.4 |
Days
| 測量時間點 | 研究天數(第 0 與第 1 天:適應與訓練;第 2 天:基準線;第 2 天之後進行睡眠剝奪) | 0 至 9 |
Subject
| 受試者 | 受試者識別碼 | 18 個值 |
H. Sustaining Effects Study(egsingle)
| |||
schoolid
| 學校 | 學校識別碼 | 60 個值 |
childid
| 學生 | 學生識別碼 | 1,721 個值 |
year
| 測量時間點 | 測驗年度(已平減) | 2.50 至 2.50 |
grade
| 測量時間點 | 年級 | 0 至 5 |
math
| 測量時間點 | 數學分數(IRT 量尺) | 5.22 至 5.77 |
retained
| 測量時間點 | 學生在該年級留級 | 0 = 否,1 = 是 |
female
| 學生 | 女生 | 0 = 男生,1 = 女生 |
black
| 學生 | 黑人 | 0 = 否,1 = 是 |
hispanic
| 學生 | 西班牙語裔 | 0 = 否,1 = 是 |
size
| 學校 | 學校的在學學生人數 | 113 至 1,486 |
lowinc
| 學校 | 學校中低收入學生的百分比 | 0.0 至 100.0 |
mobility
| 學校 | 學校流動率(mlmRev 未說明;本書未使用)
| 8.80 至 67.00 |
I. 教學改進研究(sii_classroom)
| |||
schoolid
| 學校 | 學校識別碼 | 107 個值 |
classid
| 班級 | 班級識別碼 | 312 個值 |
childid
| 學生 | 學生識別碼 | 1,190 個值 |
sex
| 學生 | 性別 | 0 = 男生,1 = 女生 |
minority
| 學生 | 少數族群學生 | 0 = 否,1 = 是 |
ses
| 學生 | 社經地位 | 1.61 至 3.21 |
mathkind
| 學生 | 幼兒園春季的數學分數 | 290 至 629 |
mathgain
| 學生 | 從幼兒園到一年級的數學進步分數 | 110 至 253 |
yearstea
| 班級 | 教師的教學年資 | 0.00 至 40.00 |
mathknow
| 班級 | 教師的數學內容知識 | 2.50 至 2.61(109 個遺漏) |
mathprep
| 班級 | 教師的數學培育(修習課程數) | 1.00 至 6.00 |
housepov
| 學校 | 學校所在社區中家戶低於貧窮線的比例 | 0.01 至 0.56 |
J. 孟加拉避孕資料(mlmRev::Contraception)
| |||
woman
| 婦女 | 婦女識別碼 | 1,934 個值 |
district
| 地區 | 地區識別碼 | 60 個值 |
use
| 婦女 | 調查當時是否使用避孕措施 | N = 否,Y = 是 |
livch
| 婦女 | 存活子女數 | 0、1、2、3+ |
age
| 婦女 | 年齡(歲,已平減於平均數) | 13.56 至 19.44 |
urban
| 婦女 | 住在都市地區 | N = 否,Y = 是 |
C.5其他真實資料集#
表 C.4 列出本書從其他 20 個真實資料集所使用的變項;其餘變項見各套件的說明文件。多數檔案就是套件中的資料,最多加上少數幾個衍生變項,但有四個檔案經過重組。癲癇資料原本每位病人每次追蹤訪視一列,基準期計數則為一欄;這裡把八週的基準期計數另外加為一列(period 0),並以每個時期的長度作為暴露量。LSAT 資料由一張反應組型及其次數的表格,展開為每位受測者一列。GCSE 資料堆疊為每位學生每個結果變項一列,不含遺漏的分數。教師資料同時以每位教師一列,以及第 25 章的人-期格式提供。思覺失調症與吸菸預防資料取自 mixor 1.0.4 的原始碼封存檔 (Hedeker & Gibbons, 1996),因為目前的 1.0.7 版需要 R 4.6 或更新的版本(表 C.1);兩個版本的資料完全相同。吸菸預防檔案只用於一道習題。
| 資料集(檔案) | 本書使用的變項 |
|---|---|
TIMSS,堆疊的結果變項(timss_mv_long)
| score = 量尺分數;dv = 結果變項指標(數學或科學);grade4;girl;idstud;idschool
|
瓜地馬拉疫苗接種資料(mlmRev::guImmun)
| immun = 接種全套疫苗;kid2p = 兒童 2 歲或以上;mom25p = 母親 25 歲或以上;ord = 出生序;ethn = 母親的族裔;momEd、husEd = 母親與丈夫的教育程度;momWork = 母親曾在家庭以外工作;rural;pcInd81 = 1981 年社區中原住民的比例;kid、mom、comm = 兒童、家庭、社區
|
自閉症社會化資料(WWGbook::autism)
| vsae = Vineland 社會化年齡當量(Vineland Socialization Age Equivalent);age = 年齡(歲);sicdegp = 2 歲時的表達性語言組別(1 = 低,2 = 中,3 = 高);childid
|
NIMH 思覺失調症研究(schizophrenia)
| sev 與 sevf = 疾病嚴重度,分為四個有次序的類別(取自住院病人多向度精神量表 Inpatient Multidimensional Psychiatric Scale 的第 79 題,imps79);drug = 抗精神病藥物(1)或安慰劑(0);week;sweek = 週數的平方根;id
|
電視吸菸預防計畫(tvsfp)
| thks = 介入後的菸草與健康知識(四個有次序的類別);thkspre = 介入前的知識;cc = 班級課程;tv = 電視介入;class;school
|
progabide 癲癇試驗(epilepsy_long)
| count = 發作次數;weeks = 時期的長度(偏移項);period = 0 為基準期,1 為隨機分派之後;trt = progabide(1)或安慰劑(0);visit;age;obs = 觀察值(用於觀察值層次隨機效果);patient
|
特殊教育教師的職涯(teachers)
| t = 最後觀察到的年度;censor = 1 表示資料蒐集結束時仍在任教;人-年檔案:year、event = 該年離開教職;id
|
慢性肉芽腫病試驗(cgd_counting)
| tstart、tstop = 區間的起點與終點;status = 1 表示該區間以一次嚴重感染結束;treat = 丙型干擾素或安慰劑;enum = 區間編號;sex、age、inherit、steroids、propylac、hos.cat;id;center = 醫院
|
蘇格蘭的中學(scotssec)
| attain = 16 歲時的學業成就分數;verbal = 進入中學時的語文推理(verbal_c:平減後的版本);sex(female);social = 社會階層;primary、second = 小學與中學
|
ETH 課程評鑑(insteval)
| y = 評分,從 1(差)到 5(非常好);s = 學生;d = 授課教師;dept = 系所;service = 替其他系所開設的課程;studage、lectage = 學生已就讀的學期數,以及該課程至今經過的學期數
|
Penicillin 檢驗(penicillin)
| diameter = 生長抑制圈的直徑;plate;sample
|
GCSE 筆試與課業作品分數(gcsemv_long)
| score = 總分;dv = 筆試或課業作品;female(gender);id = 學生(學校與學生編號);school
|
教師期望實驗(teacher_expectancy)
| yi = 標準化平均數差異;vi = 抽樣變異數;weeks = 誘發期望之前教師與學生接觸的週數(weeks_c = 截斷於 3 的週數);study、author、year、setting、tester、n1i、n2i
|
調整式學年行事曆(school_calendar)
| yi = 標準化平均數差異;vi = 抽樣變異數;district;school(在學區內編號);study;year
|
派駐海地的美國陸軍士兵(lq2002)
| LEAD01 至 LEAD11 = 領導氛圍題目;TSIG01 至 TSIG03 = 任務重要性題目;HOSTIL01 至 HOSTIL05 = 敵意題目;LEAD、TSIG、HOSTILE = 量表分數;加上 G 與 W 字首的版本 = 連平均數與連內離差(衍生);COMPID = 連;SUB = 士兵
|
美國陸軍的領導與工作時數(bhr2000)
| AF06 至 AS28 = 11 個領導題目(軍官與士官);NCO、OFF、LEAD = 題目平均數(衍生);HRS = 平常每天的工作時數;RELIG = 從宗教信仰獲得的力量或慰藉;GRP = 連
|
LSAT 第 6 部分(lsat6)
| Item_1 至 Item_5 = 答對(1)或答錯(0);person(衍生)
|
言語攻擊資料(verbagg)
| y = 是或也許(1)相對於否(0);resp = 否、也許、是(no、perhaps、yes);Anger = 特質憤怒;Gender;btype = 咒罵、責罵、吼叫(curse、scold、shout);situ = 他人該負責或自己該負責(other、self);mode = 想要或實際去做(want、do);item;id
|
Tennessee STAR,幼兒園(star_k)
| math = 數學量尺分數;cltype = 小班、一般班級,或有教師助理的一般班級(指標變項 small、aide);freelunch;female;black;schtype = 市中心、郊區、鄉村、都市;id;tch = 班級(教師);sch = 學校
|
Tennessee STAR,小班與一般班級(star_tree)
| math;small = 小班(1)或一般班級(0);freelunch、female、black = 水準為 no 與 yes 的因子;schtype;texp = 教師的教學年資;tdeg_ma = 教師具碩士以上學位;id;tch;sch
|
C.6模擬資料集#
當沒有合適的公開資料集,或必須知道參數的真值時,各章就使用模擬資料。表 C.5 中的 14 個模擬資料集以檔案形式提供,讓習題不必執行生成程式就能使用它們;每個資料集都能由其程式以所列的亂數種子完全重現。有幾個檔案附有記錄真值或上層單位的附屬檔案:diary_sim_persons、mood_sim_persons 與 esm_sim_persons 包含每個人的真實參數;mlirt_sim_schools 與 mm_sim_schools 包含學校;mm_sim_membership 包含隸屬權數;dyads_sim_dyad 每對伴侶一列;dropout_sim_students 則每位學生一列。少數圖與表使用在其自身程式中產生的小型示範資料;這些資料只要重新執行程式就能重現,不另外提供。
| 檔案 | 結構 | 設計 | 程式與亂數種子 | 章 |
|---|---|---|---|---|
diary_sim
| 100 人的 2,495 天 | 每日壓力與負向情緒;受神經質調節的隨機個人內斜率;隨機刪除 10% 的日子 | data_ch21_simulated
| 21 |
mood_sim
| 100 人的 2,800 天 | 每日心情,依循多層次一階自我迴歸歷程,含個人特定的平均數、自我迴歸與殘差變異數 | data_ch21_simulated
| 21 |
track_sim
| 100 所學校的 2,522 名學生 | 在普通高中、高職與五專三種進路之間的選擇;學校效果在兩個基準類別勝算對數上彼此相關 | data_ch24_prepare
| 24 |
aggression_sim
| 60 個班級的 1,176 名兒童 | 攻擊行為次數,含結構性零值與負二項計數;以觀察時段數作為暴露量 | data_ch24_prepare
| 24 |
dropout_sim_pp
| 60 所學校 2,393 名學生的 12,300 個人-學期 | 六個學期內的離散時間輟學,含學校脆弱性與隨機轉學 | data_ch25_prepare
| 25 |
rt_sim
| 1,600 個反應;40 位參與者 40 個題項(交叉) | 參與者與高頻詞、低頻詞交叉的反應時間 | data_ch26_prepare
| 26 |
mm_sim_students
| 2,400 名學生;60 所學校(多重隸屬) | 在國中之間轉學的學生;多重隸屬權數存於 mm_sim_membership.csv
| data_ch26_prepare
| 26 |
dyads_sim_pairwise
| 180 對伴侶中的 360 位家長 | 母親與父親;教養壓力的行動者效果與伴侶效果 | data_ch27_prepare
| 27 |
esm_sim
| 150 人的 6,000 次提示 | 經驗取樣,含一個隨機位置效果與一個隨機尺度效果,兩者相關為 .40 | data_ch28_prepare
| 28 |
med211_sim
| 300 個團隊的 2,400 位成員 | 團隊層次的預測變項,個人層次的中介變項與結果變項(2-1-1 中介) | data_ch29_prepare
| 29 |
mlirt_sim
| 80 所學校 2,000 名學生的 24,000 個反應 | 12 道二元試題,其中一道試題有依學校課程而異的差異試題功能 | data_ch30_prepare
| 30 |
confound_sim
| 100 個叢集的 2,000 個單位 | 處理受到一個未觀察之叢集特徵的混淆;真實效果為 0.3 | data_ch31_prepare
| 31 |
did_sim
| 40 所學校的 2,000 名學生 | 兩個年度的學生重複橫斷面資料;20 所學校在第 1 年採行一項方案 | data_ch31_prepare
| 31 |
scale_sim
| 2,000 個叢集的 100,000 個觀察值 | 用於比較計算時間的隨機截距與斜率模型 | data_ch32_prepare
| 32 |
C.7模擬研究#
分布於 31 章的 35 項模擬研究(表 C.6)都依循第 4 章介紹的模擬範本,只有兩個補充執行例外:sim_ch28_design_V02.R 與 sim_ch29_mediation_J_V02.R,它們自行寫出摘要,沒有分析程式。其他每一項研究都有一個模擬程式(sim_chNN_*_V01.R 或 _V02.R),以及一個名稱相對應的分析程式(analysis_chNN_*);_V02 模擬程式以相同的亂數種子重新產生 _V01 程式的資料集,並以多種最佳化演算法或起始值重新配適,在第 19 章還另外以新的亂數種子增加重複次數。模擬程式在每個條件完成後立即儲存該條件的結果,重新啟動時略過已完成的條件,並把每一次重複的結果以 .rds 與 .csv 檔寫入 Results/ChNN/;分析程式讀取這些檔案,並產生表格與圖。因此,不必重新執行研究就能取得每一次重複的結果;而在相同版本的 R 與套件下,表 C.6 中的亂數種子能完全重現所產生的資料。每個條件的重複次數從 100 到 5,000 次不等;條件之間的差異以其蒙地卡羅標準誤來判斷,差距在約兩個蒙地卡羅標準誤以內的差異,不解讀為趨勢。第 10 章的參數拔靴法從配適於 HSB 資料的模型抽取 5,000 個樣本,屬於資料分析的一部分,不算作模擬研究。
| 章 | 名稱 | 問題 | 條件 | 亂數種子 | |
|---|---|---|---|---|---|
| 1 | typeI
| OLS 與叢集層次檢定的第一類型錯誤 | ICC(4) 叢集大小(4); | 5,000 | 20260925 (a) |
| 3 | twostage
| 兩階段法、合併 OLS 與混合效果模型的估計值 | 平衡性(2) (2); | 1,000 | 20260926 (a) |
| 4 | template
| 模擬範本(隨機截距模型與隨機斜率模型) | (2) (2) | 500 | 20260927 (b) |
| 5 | compromise
| 原始預測變項的斜率是一種折衷 | (5) (2); | 200 | 20260928 (b) |
| 6 | crosslevel
| 不含隨機斜率的跨層級交互作用 | (2) (3); | 500 | 20260929 (b) |
| 7 | contextual
| 外顯與潛在脈絡效果 | (3) 的 ICC(2); | 200 | 20260930 (b) |
| 8 | ignore_level
| 忽略一個層次 | 每校班級數(2) 班級變異數(2);30 所學校 | 500 | 20261008 (b) |
| 9 | ml_reml
| ML 與 REML | (3) 模型(3) | 500 | 20261015 (b) |
| 10 | smallsample
| 固定效果的小樣本檢定 | (3) 變異數情境(2); | 1,000 | 20261101 (b) |
| 11 | boundary
| 邊界上的概似比檢定 | 受檢定的成分(2) (2); | 1,000 | 20261201 (b) |
| 12 | eb
| 經驗貝氏估計值及其標準誤 | (4),;(4), | 500 | 20261301 (b) |
| 13 | fewclusters
| 叢集很少時的 REML 與貝氏估計 | (3);;兩種先驗分配 | 200 | 20261310 (c) |
| 14 | maximal
| 最大、精簡與資料導向的隨機部分 | (3) (2);, | 1,000 | 20261410 (c) |
| 15 | misspec
| 設定錯誤的後果 | 設計(3) (2); | 500 | 20261500 (c) |
| 16 | power
| 模擬檢定力與解析檢定力 | (5) (3) | 500 | 20261600 (c) |
| 17 | missing
| 多層次多重插補 | (2);;五種方法 | 300 | 20261700 (c) |
| 17 | weights
| 抽樣權數 | 期望 (2);500 所學校的有限母群 | 100 | 20267000 (c) |
| 18 | selfcheck
| 最終 HSB 模型的自我一致性檢核 | 觀察到的 HSB 設計 | 500 | 20261800 (d) |
| 19 | dropout
| 中途退出下的成長估計值 | MCAR、MAR、MNAR;100 位病人 | 5,000 | 20261900 (c) (e) |
| 20 | serial
| 序列相關與隨機斜率 | 生成模型(4) (2);100 人 | 500 | 20262000 (c) |
| 21 | nickell
| 多層次自我迴歸中的 Nickell 偏誤 | (4) (2);100 人 | 200 | 20262100 (c) |
| 22 | gmm
| 成長混合模型的類別數目判定 | 斜率分配(2);300 人 | 100 | 20262200 (c) |
| 23 | estimation
| PQL、拉普拉斯近似與適應性積分法 | 、 與 的九種組合 | 500 | 20262300 (c) |
| 24 | overdispersion
| 過度離散的來源 | 第一層異質性(3);, | 500 | 20262400 (c) |
| 25 | frailty
| 忽略叢集脆弱性 | (2) (2) | 300 | 20262500 (c) |
| 26 | stimuli
| 把刺激當作固定時的第一類型錯誤 | 題項數(2) 題項標準差(3);30 位參與者 | 1,000 | 20262600 (c) |
| 26 | mm
| 忽略多重隸屬 | 轉學者比例(3) | 1,000 | 20262610 (c) |
| 27 | dependent
| 相依效果量 | 研究數(2) 相關(2) | 1,000 | 20262700 (c) |
| 28 | scale
| 隨機尺度所需的測量時間點數 | 測量時間點數(3);100 人 | 500 | 20262810 (c) |
| 28 | design
| 總觀察值數固定為 1,500 時,較多人或較多測量時間點 | 人數 測量時間點數(2):300 5、50 30 | 200 | 20262810 (c) |
| 29 | mediation
| 多層次中介效果的估計式 | (3) ICC(2); | 500 | 20262910 (c) |
| 29 | mediation_J
| 以觀察平均數計算之組間間接效果隨 增加時的偏誤 | (3) (, ICC)(2) | 300 | 20263100 (f) |
| 30 | laplace
| Rasch 模型的拉普拉斯近似 | 試題數(3) 個人標準差(2);500 人 | 500 | 20263010 (c) |
| 31 | confounding
| 叢集混淆下的估計式 | (3); | 500 | 20263110 (c) |
| 32 | approaches
| 三種情境下的六種分析 | 情境(3); | 1,000 | 20263210 (c) |
C.8有描述但未分析的資料#
有些資料集出現在書中,卻沒有加以分析。「台灣案例」方框以台灣的調查作為思考設計的素材,其中包括台灣教育長期追蹤資料庫(TEPS)、台灣學生學習成就評量資料庫(TASA)、PISA、TIMSS 與 PIRLS 的台灣樣本、國中教育會考,以及台灣青少年成長歷程研究:它們說明真實研究的層次、抽樣與測量如何形塑分析,但本書並未分析這些研究的任何資料,其取得條件也必須向發布這些資料的資料庫或機構確認。少數習題指向不在儲存庫中的資料:台灣的 PISA 樣本(第 17 章)、隨 MIXREGLS 發布的青少年心情資料 (Hedeker & Nordgren, 2013)(第 28 章),以及 STAR 實驗的閱讀分數與一年級紀錄(第 31 與 32 章);後者屬於 mlmRev::star 的一部分,可以用準備 star_k 與 star_tree 的方式加以準備。第 18 章只以文字描述課程歷屆期末考的資料;其出處與再散布的許可都尚未確認。