多層次資料,多層次問題
本章架構為什麼巢套資料需要專屬的模型;多層次資料如何產生;相依性如何改變統計推論;如何陳述多層次的研究問題;本書其餘各章涵蓋哪些內容。
假設一位研究者想知道:花較多時間寫數學作業的學生,數學成績是否比較高?資料來自一項全國性調查,抽樣時先抽學校,再從每一所學校中抽學生。研究者把所有學生放在一起,以數學成績對作業時間跑一個普通迴歸,得到一個很大且高度顯著的斜率,便據此寫成論文。審查委員退回稿件,並提出三個問題:同一所學校的學生,真的是彼此獨立的觀察值嗎?這個斜率描述的是學生、學校,還是兩者的混合?答案會不會因學校而異?本章要說明的是:只要資料具有巢套結構,這三個問題就會出現;而且它們不是枝微末節的技術問題,而是研究問題實質內容的一部分。
1.1什麼是多層次分析#
Snijders 與 Bosker (2012) 把多層次分析描述為一套方法論,用來處理變異型態複雜的資料,並特別關注彼此巢套的變異來源。學生的分數在其班級平均數上下變動,班級在其學校平均數上下變動,學校則在母群平均數上下變動。這些變異來源各自都可能值得研究,也都可以和在相應層次上測量的解釋變項連結起來。多層次模型就是同時呈現所有這些變異來源的統計模型,模型中也納入一般認為能夠解釋這些變異的解釋變項。
多層次模型幾乎在同一時期於好幾個學科中各自發展,因此有好幾個名稱(表 1.1)。在教育與心理學領域,最常見的名稱是階層線性模式(hierarchical linear model) (Raudenbush & Bryk, 2002)與多層次模型(multilevel model) (Goldstein, 2011; Hox et al., 2018; Snijders & Bosker, 2012)。在統計學與生物統計學中,同樣的模型稱為線性混合效果模型(linear mixed model)或混合效果模型(mixed-effects model) (Laird & Ware, 1982; Verbeke & Molenberghs, 2000),因為它結合了兩種效果:在各組之間維持不變的固定效果,以及隨組而異的隨機效果。其他名稱還有隨機係數模型 (Longford, 1993)、變異成分模型 (Searle et al., 1992)、用於縱貫性資料的成長曲線模型 (Singer & Willett, 2003),以及階層貝氏模型 (Gelman & Hill, 2007)。這些名稱強調的面向不同,但就連續的結果變項而言,指的是同一族模型;其中階層貝氏的版本為參數加上先驗分配,並以貝氏方法估計(第 13 章)。廣義線性混合效果模型(generalized linear mixed model)則把同一族模型推廣到二元、次序與計數結果變項,是本書第 VI 篇的主題。
| 名稱 | 名稱所強調的面向 | 常見領域 |
|---|---|---|
| 階層線性模式(HLM) | 為巢套結構的每一個層次分別寫出方程式 | 教育、心理學 |
| 多層次模型 | 數個層次上的變項與變異 | 教育、社會學、心理學 |
| 線性混合效果模型 | 包含固定效果與隨機效果的單一方程式 | 統計學、生物統計學、語言學 |
| 隨機係數模型 | 隨組而異的迴歸係數 | 統計學、經濟學 |
| 變異成分模型 | 把結果變項的變異數分割成各層次的成分 | 統計學、遺傳學、測量 |
| 成長曲線模型 | 每個人各自的時間軌跡 | 發展心理學、臨床心理學 |
| 階層貝氏模型 | 參數服從某個分配,而該分配有自己的參數 | 統計學、認知科學 |
| 廣義線性混合效果模型(GLMM) | 二元、次序或計數結果變項模型中的隨機效果 | 以上所有領域 |
註:這些名稱彼此重疊;就連續結果變項而言,它們指的是同一族模型,只是寫法不同(見第 2 章)。
本書交替使用多層次模型、階層線性模式與線性混合效果模型這三個名稱,並視當下哪一種寫法最有助於說明而選用。第 2 章會說明,同一個模型可以用三種等價的方式寫出:一組分層方程式、單一的合併方程式,以及描述結果變項平均數與共變數的邊際模型;能在這三種寫法之間自由轉換,正是讀懂任何統計軟體輸出的關鍵。
1.2階層無所不在#
1.2.1巢套資料的例子#
心理學、教育、健康與社會科學的資料經常是分組的。學生在班級中上課,班級隸屬於學校;病人接受治療師的治療,治療師則在診所工作;員工在公司內的團隊中工作;調查受訪者由訪員訪問,並住在抽樣地區內的家戶中。表 1.2 列出幾個領域的例子。在每一列中,某一欄的單位都巢套於下一欄的單位之內,只有表中註明為交叉的分類例外。
| 領域 | 第一層 | 第二層 | 第三層(若有) |
|---|---|---|---|
| 教育 | 學生 | 班級 | 學校 |
| 發展心理學 | 兒童 | 家庭 | 鄰里 |
| 臨床心理學 | 病人 | 治療師 | 診所 |
| 組織心理學 | 員工 | 工作團隊 | 公司 |
| 調查研究 | 受訪者 | 訪員或家戶 | 抽樣地區 |
| 縱貫研究 | 測量時間點 | 個人 | 群組(如學校) |
| 經驗取樣 | 每日或即時報告 | 個人 | 伴侶或家庭 |
| 實驗心理學 | 試次 | 參與者(與刺激交叉) | 實驗室 |
| 測量 | 試題反應 | 個人(與試題交叉) | 學校或國家 |
| 後設分析 | 研究參與者 | 研究 | 研究團隊 |
| 跨國研究 | 個人 | 國家-年度調查 | 國家 |
註:每一列由最低層次(第一層)往較高層次排列。「與……交叉」表示第二種分類方式,它並不巢套於第一種分類之中(見圖 1.1)。
表中有兩項值得說明。第一,對同一批人的重複測量也構成階層:測量時間點(第一層)巢套於個人(第二層)之中。因此,縱貫性資料與重複測量資料都是多層次資料,而現代對改變的分析,大多就是多層次分析 (Hoffman, 2015; Singer & Willett, 2003)。第二,有些結構並非嚴格巢套。在每位參與者都要對每一個刺激作反應的反應時間實驗中,每個試次(trial)同時依參與者與刺激來分類,而兩種分類都不巢套於另一種之中 (Baayen et al., 2008; Judd et al., 2012)。
1.2.2五種資料結構#
圖 1.1 把五種常見結構畫成單位圖(unit diagram):每個方框或圓圈代表一個單位,每一條線代表「隸屬於」(另見 Browne et al., 2001)。在兩層次(two-level)結構中(小圖 a),每位學生都恰好隸屬於一所學校。在三層次(three-level)結構中(小圖 b),學生隸屬於班級,班級隸屬於學校。在重複測量(repeated-measures)或縱貫結構中(小圖 c),測量時間點隸屬於個人,而每個人的觀察次數可以不同。在交叉分類(cross-classified)結構中(小圖 d),學生同時隸屬於一個鄰里與一所學校;由於同一鄰里的學生分別就讀不同學校,而每一所學校的學生也來自好幾個鄰里,兩種分類都不巢套於另一種之中 (Rasbash & Goldstein, 1994)。在多重隸屬(multiple-membership)結構中(小圖 e),有些學生隸屬於不止一所學校,例如他們在學年中轉學,而每一段隸屬關係都有一個權數。
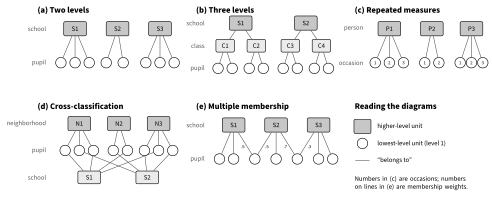
註:深色矩形代表較高層次的單位,淺色矩形代表中間層次的單位(小圖 b)或第二種分類(小圖 d),圓圈代表第一層單位。每個單位都以線連到它所隸屬的每一個單位。小圖 (c) 圓圈內的數字是測量時間點的編號;小圖 (e) 線上的數字是隸屬權數。
本書第 II 至 V 篇主要處理小圖 (a) 至 (c) 的巢套結構。交叉分類與多重隸屬結構在第 26 章討論;人與試題交叉的設計,則會在測量的那一章(第 30 章)再次出現。
1.2.3層次、單位與術語#
一個單位的層次(level),是它在階層中的位置。依慣例,最低的層次(通常也是測量結果變項的層次)稱為第一層。第一層單位也稱為微觀層次單位、基本單位或個體;第二層單位則稱為鉅觀層次單位、叢集或組。本書多半使用「第一層單位」與「叢集」(或直接使用實質名稱,例如學生與學校);當叢集的種類無關緊要時,則以「組」作為中性的用詞。第二層單位的個數記為 ,叢集 中第一層單位的個數記為 ,第一層單位的總數則為 。
變項(variable)也有層次,也就是測量該變項的單位所在的層次。數學成績與作業時間是學生層次(第一層)變項;學校公私立別與生師比則是學校層次(第二層)變項。學校層次變項也可以由學生資料聚合而成:一所學校學生的平均社經地位是學校層次變項,即使它是由學生層次的分數計算而來。反過來,研究者也常把學校層次變項附加到資料檔中每一位學生的那一列(即解構),因此同一個值會出現在許多列上。在叢集內有變動的欄位是第一層變項;但在叢集內維持不變的欄位,可能是第二層變項,也可能是剛好在這筆資料中沒有變動的第一層變項。變項的層次取決於研究設計與變項的定義,而不是檔案中數值的樣貌。
1.2.4變項在哪一層:初探 plate#
本書用同一套圖形語法來畫每一個模型,也就是統一模型圖(Unified Model Graph, UMG) (Yu, 2026a, 2026b),第 2 章會完整介紹。這套語法中有一個元素從一開始就很有用:plate 是一個圓角方框,意思是「對這個層次的每一個單位重複」(Buntine, 1994)。單位彼此巢套時,plate 也跟著巢套。一個變項帶有哪些 plate 的索引,就畫在這些 plate 之內,並位於其他所有 plate 之外。
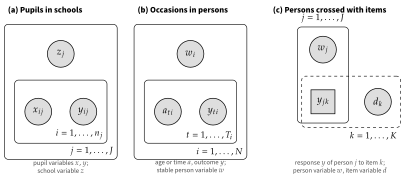
註:灰底圓圈代表觀察到的連續變項;小圖 (c) 中的灰底方形代表觀察到的類別反應。圓角方框(plate)表示「對這個層次的每一個單位重複」,並在角落標示索引的範圍。畫在其他 plate 之內的 plate 表示巢套;小圖 (c) 中彼此重疊的實線與虛線 plate 表示交叉。圖中沒有畫任何箭頭,因為還沒有設定模型。
圖 1.2 呈現三個例子。在小圖 (a) 中,學生 plate()位於學校 plate()之內。學生變項 與 畫在學生 plate 內,因為每位學生的值都不同;學校變項 則在學校 plate 內、學生 plate 外,因為每所學校只有一個值。在小圖 (b) 中,測量時間點()巢套於個人()之中:年齡或時間 與結果變項 隨測量時間點而改變,性別 這類穩定的特徵則不會改變。在小圖 (c) 中,人與試題交叉:反應 位於個人 plate 與試題 plate 重疊之處,因為每一種人與試題的組合都有一個反應;個人變項(如 )與試題變項(如 )則只位於兩個 plate 其中之一。方程式中的下標與圖中的 plate 傳達的是相同的資訊。能把研究中每一個變項放進正確 plate 的讀者,已經掌握了多層次分析與一般分析之間大部分的差別。
1.3為什麼同一組的成員彼此相似#
同一對親生父母所生的孩子,往往比從母群中隨機抽出的孩子更相像。他們之所以相像,是因為共享基因、共享環境,而且通常兩者兼有。同一所學校的學生也是如此,只是理由不同。同校學生處在相同的學校環境中,往往也有相同的老師;他們透過直接接觸與共同的規範彼此影響;而且他們多半來自同一個鄰里,所以在入學之前就已經相似。一般而言,一個組的成員彼此相似,有四類原因:他們共享共同的脈絡(學校資源、治療師的技巧、主管的風格);他們進入這個組的方式與自身特徵有關(家庭選擇鄰里與學校;病人選擇診所);他們彼此互動、相互影響(相互傳染、規範、競爭);以及他們的測量方式相同(同一位訪員、同一位評分者、同一場施測)。
不論機制為何,後果都一樣:同一組的觀察值在統計上彼此依賴。知道一位學生的分數,就能讓我們對同校另一位學生可能的分數多一些了解,而這是單憑母群平均數得不到的。表 1.3 以一種簡單的測量——血壓——在四種設計下的情形,把這個概念具體化。當設計從彼此無關的個人(設計 I)推進到對許多家庭成員的重複測量(設計 IV),新的變異來源會逐一加入,而每一個由數個測量值共享的新來源,都會在這些測量值之間帶來一種新的依賴。
| 設計 | 血壓的測量方式 | 變異來源 |
|---|---|---|
| I | 對許多彼此無關的人各測量一次 | 測量誤差;個人之間的差異 |
| II | 對許多家庭的每一位成員各測量一次 | 測量誤差;成員之間的差異;家庭之間的差異 |
| III | 對每個人在不同時間或條件下重複測量 | 測量誤差;序列(與時間有關的)變異;個人之間的差異 |
| IV | 對許多家庭的每一位成員重複測量 | 測量誤差;序列變異;成員之間的差異;家庭之間的差異 |
註:設計 II 與設計 III 各自在設計 I 之上增加一個變異來源,設計 IV 則同時包含這兩項增加。凡是由數個測量值共享的新增來源,都會使這些測量值之間產生依賴。
有人把相依性當成一種麻煩:一種必須「校正」的獨立性假定違反。把它看成資訊會更有用。學校之間的變異有多大,以及加入解釋變項之後這個變異如何改變,可以告訴我們各校的結果相差多少,以及哪些變項能解釋這些差異。重複測量資料中個人之間的變異,可以告訴我們個別差異有多穩定。在許多研究中,相依性本身就是研究所關注的現象。
1.4多層次資料從何而來#
資料集的結構取決於資料的蒐集方式。通往多層次資料的路大致有兩條:採用多階段抽樣的觀察研究,以及以群組為單位組成或分派的實驗。
1.4.1觀察研究與多階段抽樣#
大型調查很少直接從個人中抽取簡單隨機樣本。先隨機抽出學校,再從每一所抽中的學校隨機抽出班級,接著從每一個抽中的班級抽出學生,成本要低得多。這種多階段抽樣(multistage sampling)又稱叢集抽樣,符合成本效益,但它所產生的資料,其初級抽樣單位是叢集 (Kish, 1965)。多層次分析的常見假定正反映了這樣的抽樣設計:第二層單位是從第二層單位的母群中抽出的隨機(或至少具代表性的)樣本;而在每一個抽中的第二層單位內,第一層單位則是從該單位抽出的隨機(或具代表性的)樣本。當這些假定大致成立時,樣本中各校之間的變異就可以用來估計母群中學校之間的變異,推論也就能擴及一般的學校,而不只限於樣本中的學校。
本書使用的許多資料集都來自這類設計。National Education Longitudinal Study of 1988(NELS:88)先抽學校,再從學校中抽八年級學生;第 5 章使用的 High School and Beyond 調查也有相同的結構;PISA 等國際評量先抽學校,再從校內抽學生,TIMSS 則是先抽學校,再從校內抽出完整的班級。無論哪一種情形,分析都必須顧及樣本的各個抽樣階段。
1.4.2實驗#
實驗也會產生階層。把病人隨機分派到不同診所,或把學生隨機分派到不同班級時,隨機分派能確保各組在研究開始時沒有系統性的差異,卻不會讓同組成員在分派之後彼此獨立。在同一家診所接受治療的病人,面對相同的醫護人員與程序;同一班的學生有同一位老師,也會互相影響。分組在研究開始時或許是隨機的,但隨著研究進行,各組會逐漸分化,因為組會影響其成員,成員也會影響組。
若以整個群組(學校、診所、社區)為單位隨機分派到各個條件,這種設計稱為集群隨機試驗(cluster-randomized trial)或群組隨機試驗 (Murray, 1998; Raudenbush, 1997)。這時處理只在叢集之間變動;而且如第 1.6 節所示,研究對處理效果能提供多少資訊,主要取決於叢集的數目,其次才是個人的數目。
1.4.3縱貫、密集與交叉設計#
在縱貫研究中,同一批人接受重複測量,所以測量時間點巢套於個人之中。傳統的重複測量變異數分析要求平衡設計:所有人都在相同的時間點測量,而且沒有遺漏資料。多層次分析則允許不同的人在不同時間、以不同次數接受測量,可以納入隨時間改變的解釋變項,也可以為同一個人的殘差在時間上的相關建立模型 (Hedeker & Gibbons, 2006; Singer & Willett, 2003)。在日記研究與經驗取樣研究中,參與者在數週內每天多次報告自己的情緒或行為,每人會有數十甚至數百個測量時間點,分析時用的也是同樣的模型 (Bolger & Laurenceau, 2013)。在實驗心理學中,若每位參與者都要對許多刺激作反應,所產生的試次就同時依參與者與刺激分類;只要研究結論意在推論到其他刺激,就必須把刺激當成隨機因子 (Judd et al., 2012)。
1.5初探多層次資料#
1.5.1NELS:88 的兩所學校#
NELS:88 由美國教育部的國家教育統計中心(National Center for Education Statistics)執行。第一波資料於 1988 年春季蒐集,測量了約 1,000 所學校、約 25,000 位八年級學生。Kreft 與 de Leeuw (1998) 公開了其中 23 所學校、519 位學生的子樣本,本書會反覆使用這筆資料(資料說明見附錄 C)。結果變項是數學測驗分數;其中一個學生層次的解釋變項,是學生自陳每週花在數學作業上的時間,依序分為八個等級,從「完全沒有」到「10 小時以上」。
圖 1.3 畫出 23 所學校中兩所學校的數學成績與作業時間,表 1.4 則整理了這兩所學校的描述統計。學校 24725 是公立學校,學生的社經地位(socioeconomic status, SES)低於平均;學校 62821 是私立學校,學生的 SES 遠高於平均。兩所學校幾乎在每一方面都不同。它們的數學平均分數相差約 19 分;私立學校學生自陳的作業時間較多(作業等級代碼的平均數為 3.3 對 1.6;這些代碼是有次序的類別,不是時數);公立學校的分數分散程度較大。對本章開頭的問題而言,最重要的是作業與數學成績之間的關係也不同:公立學校的最小平方斜率約為每個作業等級 5.6 分,私立學校則約為 1.1 分。
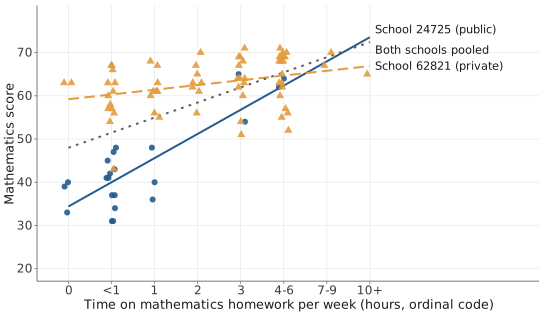
註:圓圈與實線代表學校 24725 的學生及其最小平方迴歸線;三角形與虛線代表學校 62821 的學生及其迴歸線;點線是兩校學生合併後的最小平方迴歸線。各點在水平方向加上了微小的隨機位移(jitter),以減少重疊。作業時間以次序等級記錄;刻度標籤標示每個等級所代表的每週時數。
| 數學成績 | 校內 OLS 迴歸 | ||||||
|---|---|---|---|---|---|---|---|
| 學校 | 平均數 | SD | 作業時間 | SES | 截距 | 斜率 | |
| 24725(公立) | 22 | 43.5 | 10.0 | 1.64 | 0.70 | 34.4 | 5.59 |
| 62821(私立) | 67 | 62.8 | 5.7 | 3.30 | 1.04 | 59.2 | 1.09 |
| 合併(兩校) | 89 | 58.1 | 10.9 | 2.89 | 0.61 | 48.0 | 3.49 |
註: = 學生人數;作業時間 = 八等級作業時間編碼(0–7)的平均數;SES = 標準化社經地位的平均數;截距與斜率 = 數學成績對作業時間編碼的普通最小平方(OLS)迴歸。
如果把兩校學生合併起來,配適單一條迴歸線,斜率約為 3.5。這條合併斜率兩所學校都描述不了。它把學校內作業與數學成績之間的關係,和學校之間的差異混在一起;而兩校在作業時間與數學成績上的差異,原因可能與作業本身沒什麼關係(公私立別、SES,以及其他任何使兩校不同的因素)。這個小例子已經引出了本章開頭審查委員的全部三個問題。
1.5.2Junior School Project 的五十所學校#
Junior School Project (JSP; Mortimore et al., 1988)追蹤內倫敦 50 所小學的近 2,000 位學生,涵蓋他們在初級學校(junior school)的四個學年(1980–1984);自 Goldstein (1987) 以來,這筆資料一直是示範多層次模型的常用資料。這裡使用的是流傳甚廣的版本,包含其中三個學年的測驗分數:49 所學校、1,192 位學生的 3,236 筆紀錄,其中 1,093 位學生同時有第 0 年與第 1 年的數學成績。
圖 1.4 以兩種方式呈現第 0 年與第 1 年數學成績之間的關係。小圖 (a) 呈現一所學校(學校 1)的學生。兩者的關係很強(這 32 位學生的 ),而且大致呈線性。小圖 (b) 呈現 49 所學校各自的最小平方迴歸線,每條線只畫在該校觀察到的第 0 年分數範圍內。各校的校內 約有 80% 介於 .35 與 .82 之間(第 10 與第 90 百分位數),因此在大多數學校,先前的成就都能很好地預測後來的成就。然而,這些線並不相同:它們的高度不同(第 0 年分數相同的學生,在某些學校的第 1 年分數往往高於在其他學校),斜率也不同(斜率的中位數是 0.85,但範圍從接近零到 1.3)。第一種差異是學校效能研究關心的問題:在考量入學程度之後,哪些學校的表現優於預期 (Aitkin & Longford, 1986)?第二種差異問的則是:學校對先前成就低與高的學生是否同樣有效。
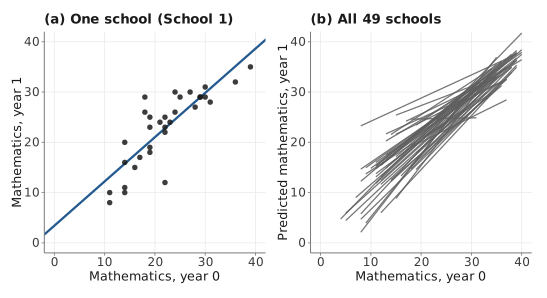
註:小圖 (a):各點代表學校 1 的學生,直線是他們的最小平方迴歸線。小圖 (b):每一條線段是一所學校的最小平方迴歸線,只畫在該校觀察到的第 0 年分數範圍內。兩軸都使用該測驗 0–40 的量尺。
只有兩所學校,甚至五所學校時,為每一所學校分別跑迴歸是描述資料的合理方式;如果研究者只對這幾所特定學校感興趣,這也是正確的分析。然而有 49 所學校時,各校分別估計的迴歸(在最小的幾所學校中雜訊最大)回答不了研究者通常會問的問題:一般而言,學校之間的差異有多大?哪些學校特徵可以解釋這些差異?考量到某一所學校只貢獻了少數學生,我們對這所學校效果的估計能有多少把握?一旦把這些學校視為從更大的學校母群中抽出的樣本,回答這些問題就需要一個模型,讓各校特有的截距與斜率本身成為具有某種分配的隨機量。這個模型就是多層次模型;隨機截距模型是第 5 章的主題,隨機斜率模型則是第 6 章的主題。
1.6相依性及其後果#
1.6.1組內相關係數#
描述巢套資料相依性最簡單的方式,是把結果變項的變異數拆成兩部分。把學生 在學校 的分數寫成整體平均數 、學校效果 與學生層次殘差 三者之和:
其中 與 彼此獨立。學校間變異數 衡量各校的真實平均數圍繞整體平均數變動的程度,學校內變異數 則衡量學生與自己學校平均數的差異有多大。式 (1.1) 是多層次的虛無模型(empty model),也稱為 null model 或 unconditional model;它就是第 3 章探討的單因子隨機效果變異數分析模型,也是第 5 章的起點。
組內相關係數(intraclass correlation, ICC)是總變異數中位於叢集之間的比例:
ICC 有兩種解讀,值得分開來看。它是結果變項的變異數中,可歸因於叢集間差異的變異數比例;它也是從同一個叢集中隨機抽出兩個不同的第一層單位時,兩者結果變項之間的相關。這兩種解讀都可以由式 (1.1) 推得:學校 中的兩位學生共享 這一項,因此他們的共變數是 ;又因為每個分數的變異數都是 ,兩人分數的相關就是 。
就 23 所 NELS:88 學校而言,虛無模型的估計值為 、,因此估計的 ICC 為 。數學成績的變異數約有四分之一位於學校之間;換個說法,同校兩位學生的分數,相關約為 .24。就美國全國性學校樣本的學業成就類結果變項而言,虛無模型(unconditional model)所得的 ICC 通常介於約 .15 至 .25 之間;在同質性較高的學校樣本中,數值則較小 (Hedges & Hedberg, 2007)。在重複測量資料中,ICC 往往大得多,因為個人之間穩定的差異占了變異數的很大一部分。
1.6.2設計效果與有效樣本數#
相依性會減少資料中獨立資訊的量。如果同一所學校的學生彼此是完全相同的複製品(),那麼一所有 25 位學生的學校,對母群平均數所提供的資訊並不比一位學生多。如果學生彼此完全獨立(),這所學校就提供 25 個獨立的觀察值。介於兩者之間時,資訊的損失可以用設計效果(design effect) (Kish, 1965)來概括。若各叢集大小相同,皆為 ,則
而有效樣本數(effective sample size)為 。設計效果是一個倍數:在總人數相同的情況下,叢集抽樣所得平均數的抽樣變異數,是簡單隨機抽樣的幾倍(見下方的「技術細節」方框)。以 NELS:88 為例,平均叢集大小為 22.6 位學生,取到小數第三位的 ICC 為 .243,設計效果約為 (這是近似值,因為各校人數不同),因此這 519 位學生對整體平均數所提供的資訊,大約只相當於 位獨立抽樣的學生。
1.6.3顯著性檢定會出什麼問題#
普通最小平方(OLS)迴歸、 檢定與變異數分析,都假定觀察值彼此獨立。如果資料具有叢集結構,分析時卻忽略這個假定,公式就會把 個觀察值當成 筆獨立的資訊。對本身具有叢集結構的預測變項而言,尤其是叢集層次的預測變項,估計的標準誤會因此太小,信賴區間會太窄,也會過於頻繁地拒絕虛無假設 (Barcikowski, 1981; Kenny & Judd, 1986)。
圖 1.5 與表 1.5 以一個小型模擬呈現這個問題有多嚴重(模擬程式連同亂數種子與每一次重複的結果,都放在本書的儲存庫中;見本章最後的「上機實作」一節)。我們產生 40 個叢集,一半分派到「處理」組、一半分派到「控制」組,就像集群隨機試驗一樣。真正的處理效果為零,所以每一個顯著的結果都是第一類型錯誤。結果變項的 ICC 設為 0、.05、.10 或 .20,叢集大小設為 5、10、25 或 50。每一種條件重複 5,000 次,每一筆資料都以兩種方式分析:一是對所有個人做 OLS 檢定,這忽略了叢集結構;二是對 40 個叢集平均數做 檢定,這顧及了叢集結構(在各叢集大小相同、且估計的叢集間變異數為正時,這個自由度為 的叢集層次檢定,與第 5 章隨機截距模型中自由度相同的處理效果 REML 檢定完全相同)。
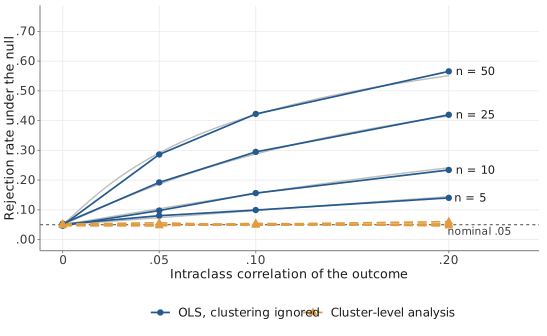
註:帶圓圈的實線是忽略叢集結構的普通最小平方 檢定之拒絕率,四條實線對應的叢集大小為 5、10、25 與 50(標籤在右側)。帶三角形的虛線是同樣叢集大小下,以叢集平均數進行 檢定的拒絕率;四條虛線幾乎重合。灰色細曲線是依設計效果所預測的拒絕率。水平點線標示名目 .05 水準。每一點都根據 5,000 次重複,每次 40 個叢集。
| 第一類型錯誤率() | |||||
|---|---|---|---|---|---|
| ICC | 設計效果 | 預測值(OLS) | OLS | 叢集層次 | |
| .00 | 5 | 1.00 | .050 | .051 | .052 |
| .00 | 10 | 1.00 | .050 | .046 | .046 |
| .00 | 25 | 1.00 | .050 | .053 | .050 |
| .00 | 50 | 1.00 | .050 | .048 | .049 |
| .05 | 5 | 1.20 | .074 | .080 | .056 |
| .05 | 10 | 1.45 | .104 | .098 | .046 |
| .05 | 25 | 2.20 | .186 | .192 | .050 |
| .05 | 50 | 3.45 | .291 | .286 | .049 |
| .10 | 5 | 1.40 | .098 | .099 | .049 |
| .10 | 10 | 1.90 | .155 | .156 | .054 |
| .10 | 25 | 3.40 | .288 | .295 | .052 |
| .10 | 50 | 5.90 | .420 | .422 | .049 |
| .20 | 5 | 1.80 | .144 | .140 | .050 |
| .20 | 10 | 2.80 | .241 | .234 | .046 |
| .20 | 25 | 5.80 | .416 | .420 | .060 |
| .20 | 50 | 10.80 | .551 | .566 | .053 |
註:ICC = 結果變項的組內相關係數; = 叢集大小(每一種條件都有 40 個叢集);設計效果 ;預測值(OLS)= 由設計效果推得的雙尾拒絕率 ;OLS = 忽略叢集結構、以個人為單位的檢定;叢集層次 = 以 40 個叢集平均數進行的檢定。蒙地卡羅標準誤最大為 .007。
當 ICC 為零時,兩種檢定都維持在名目 .05 水準,這是應該的。ICC 一旦為正,OLS 檢定就會過於頻繁地拒絕虛無假設,而且超出的幅度隨 ICC 與叢集大小而增加。ICC 只有 .05、每個叢集 50 人時,OLS 檢定在 29% 的樣本中拒絕了為真的虛無假設;ICC 為 .20、叢集大小為 50 時,拒絕率達 57%。這些拒絕率與依設計效果所預測的值非常接近,顯示在這裡設計效果幾乎能解釋所有的偏差:OLS 標準誤太小,必須乘上 才是正確的大小。叢集層次的檢定在全部 16 種條件下都介於 .046 與 .060 之間;只有一個值(.060,ICC = .20、)與 .05 的差距超過三個蒙地卡羅標準誤(每個約 .003)。這個教訓具有普遍性:對叢集層次變項的效果而言,限制有效樣本數的主要是叢集的數目,其次才是個人的數目。
1.6.4一個經典例子#
這個問題並不只存在於理論中。Bennett (1976) 研究不同教學風格的老師所教導的小學生在閱讀、數學與英語上的進步,並根據以學生為分析單位的分析報告:以「正式」(formal)風格教導的學生,進步顯著多於以其他風格教導的學生。Aitkin et al. (1981) 改用學生巢套於老師之內的變異成分模型,重新分析這筆資料。一旦模型呈現了同一位老師所教學生之間的相依性,不同教學風格之間的差異就不再具有統計顯著性。原因正如前文所述:同一班的孩子表現往往相似,因此每個孩子所提供的資訊,少於一個獨立抽樣的孩子所能提供的。教學風格是在老師之間變動,而不是在學生之間變動,因此比較教學風格,其實就是在比較老師。增加每位老師的學生人數,可以讓每位老師的平均數更精確;但老師之間比較的精確度,主要受限於老師的人數。這次重新分析以及隨後的討論,幫助多層次模型在教育研究中站穩了腳步 (Aitkin & Longford, 1986; Goldstein, 2011)。
1.7分析單位問題#
在多層次模型問世之前,擁有巢套資料的研究者只能在兩種不完美的分析之間二選一 (Burstein, 1980; Kreft & de Leeuw, 1998)。在解構分析(disaggregated analysis)中,研究者把叢集層次變項複製到每一個個人身上,然後在個人層次上分析資料,就像前述教學風格研究的做法。這種分析忽略了相依性,叢集層次變項的檢定會過於寬鬆,圖 1.5 已經顯示了這一點。在聚合分析(aggregated analysis)中,研究者先把個人分數在叢集內取平均,再分析叢集平均數。相依性的問題消失了,但叢集內的資訊也一併捨棄了;更嚴重的是,分析結果描述的是叢集,而不是個人。
1.7.1組內、組間與整體關係#
核心的困難在於:兩個個人層次變項之間的關係,可以拆解成兩種不一定相同的關係 (Cronbach, 1976)。一是組內關係(within-cluster relation),描述在 上偏離所屬叢集平均數的個人,在 上如何偏離所屬叢集平均數;二是組間關係(between-cluster relation),描述 平均數不同的叢集,其 平均數有何差異。把所有個人合併、忽略叢集所估計出的整體關係(total relation),則是這兩者的加權混合。
圖 1.6 以模擬資料呈現一個極端但很有啟發性的例子。在五個組的每一組內, 較高的個人 較低(組內斜率為 )。跨組來看, 平均數較高的組, 平均數也較高(組間斜率為 )。忽略組別的單一迴歸(小圖 a)得到 的正斜率;這個斜率受組間關係主導,錯誤地描述了同一組內個人之間 與 的關係。只有把組內與組間成分分開(小圖 b),資料的結構才會顯現出來。若某個關係在考慮分組變項之後正負號反轉,就是辛普森悖論(Simpson’s paradox)的實例 (Simpson, 1951)。
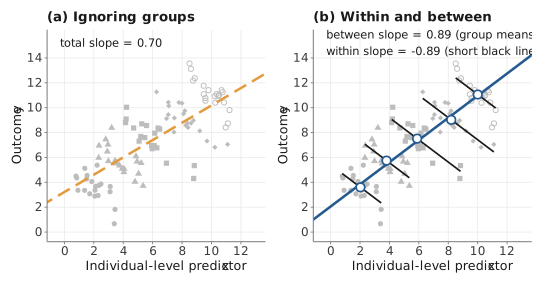
註:五組、每組 20 人的模擬資料;以點的形狀區分組別。小圖 (a):虛線是以全部 100 人配適的最小平方迴歸線。小圖 (b):黑色短線代表合併的組內斜率,分別穿過各組的資料畫出;空心圓圈是各組平均數,實線是通過各組平均數的最小平方迴歸線。
1.7.2生態謬誤與原子謬誤#
混淆層次會導致兩種推論錯誤。生態謬誤(ecological fallacy)是根據聚合單位之間觀察到的關係,對個人下結論的錯誤。Robinson (1950) 指出,由美國各地區或各州的平均數計算出的相關,可能與個人之間相應的相關相差甚大,甚至正負號相反。在圖 1.6 中,若根據組平均數之間的正向關係,就斷定 較高的個人 往往也較高,便犯了生態謬誤。相反的錯誤是原子謬誤(atomistic fallacy)(又稱個體謬誤,individualistic fallacy),也就是根據個人之間觀察到的關係,對群組下結論 (Alker, 1969; Hox et al., 2018)。若根據負的組內斜率,就斷定 平均數較高的組, 平均數必定較低,便犯了原子謬誤。
聚合與解構都無法解決這個問題,因為問題並不在於分析單位的選擇。兩種關係都存在,都可能具有實質意義,也都可以估計。多層次模型可以同時估計組內與組間關係,並允許兩者不同,也讓我們能夠檢驗兩者是否真的不同。具體該怎麼做,以及答案如何取決於預測變項的平減方式,是第 7 章的主題。
1.8多層次理論與命題#
多層次模型是一套涉及不止一個層次的實質理論在統計上的表徵。因此,在寫出任何方程式之前,值得先把理論陳述清楚。Snijders 與 Bosker (2012, 第 2 章) 提供了一個精簡的做法,其精神與 Coleman (1990) 的鉅觀–微觀圖相近。命題依其所連結之變項的層次來分類;在這套記號中,鉅觀層次(第二層)變項以大寫字母表示,微觀層次(第一層)變項以小寫字母表示。圖 1.7 以 UMG 的 plate 重新繪製幾種主要的類型。內層(學生)plate 的邊界,扮演 Snijders 與 Bosker 圖中那條區隔微觀與鉅觀層次之點線的角色:位於學生 plate 內的變項屬於微觀層次,位於學校 plate 內但在學生 plate 外的變項則屬於鉅觀層次。
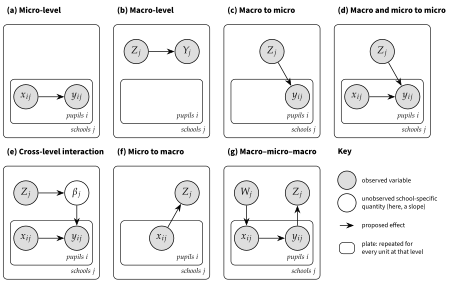
註:每一個小圖都是一個學生 plate 巢套在一個學校 plate 之中。灰底圓圈代表觀察變項;小圖 (e) 中的空心圓圈代表一個未觀察到的學校特定量,也就是 對 在學校 內的斜率。箭頭代表所提出的效果。依照 Snijders 與 Bosker (2012) 的做法,鉅觀層次(學校)變項以大寫表示,微觀層次(學生)變項以小寫表示。
微觀層次命題(micro-level proposition)(小圖 a)連結兩個微觀層次(學生)變項,例如在一項先抽學校、再於校內抽學生的研究中,學生的作業時間與同一位學生的數學成績。鉅觀層次在理論中不扮演任何角色;同一所學校內學生之間的相依性,只是需要處理的干擾,而不是研究的主題。鉅觀層次命題(macro-level proposition)(小圖 b)連結兩個叢集層次變項,例如一所學校學區的平均財富()與該校的平均成就()。當 不是直接觀察而得,而是像學校平均數那樣由學生測量值計算而來時,即使命題只涉及學校,資料仍然是多層次的。
更有意思的是跨越層次的命題。在鉅觀到微觀命題(macro-to-micro proposition)中(小圖 c),叢集變項影響個人的結果:平均 SES 較高之學校的學生,數學成就較高。在鉅觀與微觀到微觀命題(macro-and-micro-to-micro proposition)中(小圖 d),叢集變項與個人變項都影響個人的結果:在學生作業時間相同的條件下,平均 SES 較高之學校的學生成就較高;而在學校平均 SES 相同的條件下,花較多時間寫作業的學生成就較高。在跨層級交互作用(cross-level interaction)中(小圖 e),叢集變項會改變兩個個人變項之間的關係。Snijders 與 Bosker (2012) 舉了能力分組()的例子:在依能力分組的班級中,學生性向()對成就()的效果可能很小,而在未依能力分組的班級中則可能很大。在 UMG 中,這樣的命題畫法是:把 對 的斜率設為位於學校 plate 內的學校特定量 ,再讓 影響它。第 6 章正是以帶有跨層級交互作用的隨機斜率來估計這個結構。
命題也可以由下往上。在微觀到鉅觀命題(micro-to-macro proposition)(或稱浮現命題)中(小圖 f),個人特徵影響群組層次的結果,例如學生的成就影響老師所感受到的壓力;Kozlowski 與 Klein (2000) 討論了組織中這類浮現歷程。最後,命題也可以串連起來(小圖 g):老師對學習的態度()影響學生的態度(),學生的態度影響其成就(),而學生的成就又回過頭來影響老師的專業聲望()。這樣的命題鏈可以說明,兩個鉅觀層次變項之間的關聯是透過哪些微觀層次變項而產生的。向上命題與鏈狀命題的模型超出了基本多層次迴歸模型的範圍;它們留待討論多層次結構方程模型的第 29 章處理。
1.9多層次模型的優點與代價#
多層次模型之所以成為巢套資料的標準工具,是因為它相較於解構分析與聚合分析都有若干優點 (Hoffman & Walters, 2022; Raudenbush & Bryk, 2002; Snijders & Bosker, 2012)。
正確的推論。多層次模型呈現了觀察值之間的相依性,因此標準誤、信賴區間與顯著性檢定(在模型假定成立且叢集數目足夠的前提下)都是有效的,叢集層次變項的檢定也不例外。
有效率的估計。在模型設定正確時,它能有效率地結合叢集內與叢集間的資訊(第 7 章說明何時必須把這兩種資訊分開),並在叢集之間「借用資訊」(borrow strength),使小叢集的估計值能藉由其他叢集的資訊而穩定下來(第 12 章)。
各層次的變項。在階層中任何層次測量的解釋變項,都可以放進同一個模型,其效果也可以在適當的層次上檢定。
組內與組間效果。組內關係與組間關係可以分別估計,避免落入生態謬誤與原子謬誤(第 7 章)。
把異質性當成研究發現。隨叢集而異的關係(隨機斜率),以及以叢集特徵解釋這種變異(跨層級交互作用),都成為模型的一部分(第 6 章)。
不平衡與不完整的資料。大小不同的叢集,以及縱貫性資料中在不同時間、以不同次數測量的個人,都不必捨棄任何資料就能處理(第 17 章與第 19 章)。
豐富的理論。圖 1.7 中的許多命題都可以直接轉譯成模型,而模型也可以畫出來,當成它所代表的理論來閱讀。
這些優點是有代價的。一般迴歸的工具(估計、檢定、適配度指標、診斷)都必須修改,而修改的方式並不總是顯而易見(第 III 篇)。帶有多個隨機效果與跨層級交互作用的模型可能變得很複雜,可能的模型數目也會隨變項與層次的數目快速增加(第 14 章)。估計可能失敗或得到不合理的結果,在叢集很少或變異成分接近零時尤其如此(第 9 章)。此外,模型對隨機效果之分配的假定,以及對隨機效果與解釋變項彼此獨立的假定,都必須加以檢驗,而不能視為理所當然(第 7 章與第 15 章)。本書有很大一部分,就是在討論如何在這些代價之下,仍然把多層次模型用好。
1.10應用範圍與本書架構#
多層次模型的應用遠遠超出學校中的學生。同樣的模型可用於:採用多階段設計的抽樣調查;學校與教師效能研究;縱貫性資料與重複測量資料;離散的結果變項,例如及格率、是否畢業或症狀是否出現;多變量結果變項,也就是在每個人身上測量多個變項(每個反應成為巢套於個人之內的一個第一層單位);非線性的成長型態;交叉分類設計,例如參與者與刺激交叉;試題反應巢套於個人之內或與個人交叉的測量模型 (De Boeck & Wilson, 2004);在數個層次上都有潛在變項的結構方程模型;效果量(或參與者)巢套於研究之內的後設分析;以及結果變項的變異性(而不只是平均數)隨個人或群組而異的模型。這些應用大多在本書中有自己的專章。
表 1.6 列出本書的架構。第 I 篇奠定基礎:包括本章;一章介紹符號,以及多層次模型的三種寫法(與一種圖形畫法);一章從讀者已熟悉的變異數分析與迴歸模型推導出多層次模型;還有一章談多層次資料的探索與管理。第 II 篇發展核心模型。第 III 篇打開估計與推論的機制。第 IV 篇把這些機制轉化為建立、檢查、設計與報告分析的工作流程。第 V 至 VII 篇則把模型延伸到縱貫與密集資料、廣義結果變項與非巢套結構,以及潛在變項與因果問題。
| 篇 | 章 | 主要問題 |
|---|---|---|
| 第 I 篇:基礎 | 1–4 | 為什麼需要多層次模型?如何寫出、畫出與探索這些模型? |
| 第 II 篇:核心模型 | 5–8 | 隨機截距、隨機斜率、跨層級交互作用、平減、三層次模型 |
| 第 III 篇:估計與推論 | 9–13 | 模型如何估計與檢定?什麼是隨機效果的預測值?貝氏估計 |
| 第 IV 篇:建立、檢查、設計與報告 | 14–18 | 模型建立、診斷、統計檢定力、遺漏資料、權數、結果報告 |
| 第 V 篇:縱貫與密集資料 | 19–22 | 成長、共變數結構、個人內動態、潛在曲線模型 |
| 第 VI 篇:廣義與延伸模型 | 23–28 | 二元、次序、計數與存活結果變項;交叉與多重隸屬結構;多變量與後設分析模型;以變異性為結果變項 |
| 第 VII 篇:潛在變項、因果與前沿 | 29–32 | 多層次 SEM 與測量、因果推論、替代方法與延伸 |
之後的每一章都依循相同的模式:以一個實質問題與一筆資料開場,發展相關概念,用三種方式寫出每一個新模型,把它畫成 UMG,展示模型所蘊含的資料圖示,以附有註解的 R 程式碼完整演練一個範例,最後提供解釋與報告的建議、常見陷阱、SAS、SPSS、Stata、Mplus、HLM 與 JASP 的軟體對照(此處的 HLM 指與階層線性模式同名的軟體)、本章摘要與習題。較長的推導放在「技術細節」方框中,初讀時可以跳過。
關鍵詞#
- 聚合與解構(aggregation and disaggregation)
- 原子謬誤(atomistic fallacy)
- 組間關係(between-cluster relation)
- 叢集;集群隨機試驗(cluster; cluster-randomized trial)
- 交叉分類結構(cross-classified structure)
- 跨層級交互作用(cross-level interaction)
- 設計效果(design effect)
- 生態謬誤(ecological fallacy)
- 有效樣本數(effective sample size)
- 虛無模型(empty (null) model)
- 組內相關係數(intraclass correlation)
- 層次;第一層與第二層單位(level; level-1 and level-2 units)
- 鉅觀層次與微觀層次命題(macro-level and micro-level propositions)
- 微觀到鉅觀(浮現)命題(micro-to-macro (emergent) proposition)
- 多重隸屬結構(multiple-membership structure)
- 多階段抽樣(multistage sampling)
- plate
- 辛普森悖論(Simpson’s paradox)
- 整體關係(total relation)
- 分析單位問題(unit-of-analysis problem)
- 組內關係(within-cluster relation)
習題#
A. 觀念題#
針對下列每一項研究,指出其層次、各層次的單位,以及其結構是巢套、交叉分類還是多重隸屬:(a) 60 位治療師各治療 8 位個案,每位個案連續 12 週、每週填寫一次症狀檢核表;(b) 150 位參與者各自評定同樣 40 張臉孔的吸引力;(c) 員工評定所屬團隊的氣氛,而有些員工同時隸屬於兩個團隊;(d) 來自 90 個鄰里的 2,000 名青少年就讀 30 所高中。
在一項以學校中的學生為對象的研究中,說明下列每個變項的層次:數學成績、學校規模、學生性別、學校中女生的比例、教師的教學年資(每班一位老師,每校數個班級),以及一個班級中學生的平均作業時間。
某研究報告,在 60 所學校、每校 120 位學生的樣本中,某結果變項的 ICC 為 .08。一位同事據此認為:「叢集結構的影響微不足道,所以用一般迴歸就可以了。」請用兩三句話說明,為什麼這個結論並不可靠。
說明生態謬誤與原子謬誤的差異,並從你自己的研究領域中各舉一個例子。
依圖 1.7 中的類型,將下列每一個命題分類:(a)「班級氣氛較支持的班級,平均焦慮較低」;(b)「在班級氣氛較支持的班級中,學生的焦慮較低」;(c)「在班級氣氛較支持的班級中,學生先前成就對焦慮的效果較弱」;(d)「學生的干擾行為會增加老師的倦怠」。
B. 推導題#
依照「技術細節」方框中的步驟,推導式 (1.3) 的設計效果。接著證明有效樣本數 介於 與 之間,並說明兩個界限各在什麼情況下達到。 解答 →
一項集群隨機試驗將納入 30 個班級,每班 25 位學生。前導研究的資料顯示 。請計算設計效果與有效樣本數。班級數必須增加多少,才能得到與「30 個班級且沒有叢集效果」之試驗相同的有效樣本數? 解答 →
利用「技術細節」方框中的近似式 ,解釋為什麼忽略叢集結構時,叢集層次預測變項的檢定所受的影響,遠大於主要在叢集內變動之預測變項的檢定。 解答 →
C. 計算題#
使用
nels88_school23.csv,計算 23 所學校各自的學生人數、數學平均分數,以及校內數學成績對作業時間的 OLS 截距與斜率。仿照圖 1.4(b),把 23 條迴歸線畫在同一張圖中,並描述各校之間的差異。自選另外兩所學校,重做表 1.4,並討論合併斜率是否能描述其中任何一所學校。
以 R 以及軟體對照中的另一個程式,對 NELS:88 資料配適虛無模型。確認估計的 ICC 約為 .24,並以平均叢集大小計算設計效果。
使用
jsp_wide.csv,計算每一所學校第 0 年與第 1 年數學成績之間的相關,並以這些相關對各校的學生人數作圖。這張圖對於小型學校之學校特定估計值的信度,有什麼啟示? 解答 →
D. 模擬題#
打開
sim_ch01_typeI_V01.R。(a) 把叢集數由 40 改為 10,重新執行模擬。叢集層次的檢定是否仍維持在 .05 的水準?OLS 檢定的表現比 40 個叢集時更好還是更差?(b) 加入一個只在叢集內變動、真實效果為零的學生層次預測變項 (例如 ,其中 服從標準常態分配)。記錄這個預測變項的 OLS 檢定拒絕虛無假設的頻率,並以近似式 解釋結果。新的程式檔請加上字尾_V02另存。
E. 應用小專題#
選一篇你所屬領域中、資料具有巢套結構的已發表實徵論文。(a) 把資料結構畫成單位圖,也用 plate 畫出來,並把分析中使用的每一個變項放進正確的 plate。(b) 把主要的研究問題寫成圖 1.7 中的一種或多種命題類型。(c) 報告叢集的數目與叢集大小,並說明該分析是否顧及了研究設計。(d) 針對分析單位寫一段簡短的審查意見(約 300 字)。
上機實作#
延伸閱讀#
- Snijders 與 Bosker (2012, 第 1–2 章)
-
本章所用命題類型的出處,並仔細討論了聚合、解構與變項的層次。
- Raudenbush 與 Bryk (2002, 第 1 章)
-
回顧階層線性模式當初是為了解決哪些問題而發展出來的,並附有教育領域的應用。
- Kreft 與 de Leeuw (1998, 第 1 章)
-
簡短易讀的分析單位問題入門,使用的正是本章分析的 NELS:88 資料。
- Robinson (1950)
-
經典的示範:生態相關不一定等於個人層次的相關。
- Aitkin et al. (1981)
-
對教學風格研究的重新分析;論文後附的討論,清楚記錄了這個領域的想法如何轉變。
- Kenny 與 Judd (1986)
-
為心理學家撰寫,清楚說明觀察值不獨立如何使變異數分析的檢定產生偏誤。
- Kozlowski 與 Klein (2000)
-
組織研究中多層次理論的架構,包括浮現(微觀到鉅觀)歷程。
- Hoffman 與 Walters (2022)
-
近年為心理學家撰寫的多層次模型概論,並為許多後續章節的主題提供了延伸閱讀的線索。