矩陣代數與機率分配複習
本附錄內容符號;基本矩陣運算與平減矩陣;反矩陣、行列式與秩;二次式、特徵值與正定性;區塊矩陣與一個叢集的共變數矩陣;Kronecker 積;線性形式的期望值與共變數、GLS 與 REML 投影矩陣;多變量常態分配及其條件分配;導數、訊息與 Delta 法;卡方、t 與 F 分配;離散結果變項的分配;邊界上的檢定所用的混合分配。
本附錄以本書的符號,彙整各章所用的矩陣代數與機率分配理論。它是一份供查閱的參考資料,而不是一門課程:每一項結果都先加以陳述,簡短說明其來由,再連結到本書需要它的地方。一個小型的貫穿範例取自 23 所學校之 NELS:88 子樣本 (Kreft & de Leeuw, 1998) 中的三所學校,讓抽象的運算變得具體。更完整的討論,請見本附錄末尾的延伸閱讀。
A.1符號#
純量以斜體表示(、),向量以粗體小寫表示(、),矩陣以粗體大寫表示(、)。所有向量都是行向量,撇號(prime)表示轉置,因此 是列向量。對於含 個單位的叢集 (;總共 個單位), 是 的結果變項向量, 是具有固定效果 之預測變項的 矩陣, 是具有隨機效果 之預測變項的 矩陣, 是 的 共變數矩陣, 則是第一層殘差變異數。多層次模型的矩陣形式(第 2 章,式 (2.6))為
它隱含邊際模型 ,其中 。幾個特殊的向量與矩陣是:,由 個 1 組成的一行;, 的單位矩陣;以及 ,元素全為 1 的 矩陣。表示維度的下標,在由上下文即可明白時省略不寫。
A.2基本運算#
維度相同的矩陣逐元素相加。 矩陣 與 矩陣 的乘積 是一個 矩陣,其元素為 ;相乘的條件是 的行數等於 的列數,而且一般而言 。轉置會使乘積的順序反轉:。若 ,矩陣就是對稱的;共變數矩陣都是對稱矩陣。內積 是一個純量,而 ,因此組平均數為 。方陣的跡(trace)是其對角元素之和,;只要兩個乘積都存在,就有 ,這條規則可以簡化二次式的期望值(第 A.7 節)。平減矩陣 會減去平均數: 包含叢集內的離差,而 則把組平均數重複列出。這兩個矩陣都是對稱且冪等的(),兩者之和為 ,乘積為零;這就是第 3 與 7 章組內–組間分解的矩陣形式。
在貫穿範例中,學校 A(NELS:88 識別碼 6467)的前三位學生有結果變項向量 與預測變項矩陣 ;後者由兩行組成:代表截距、元素全為 1 的一行,以及作業時間類別的一行。隨機截距的設計矩陣為 :
表 A.1 列出摘錄中的十位學生:3 位來自學校 A,4 位來自學校 B(6327),3 位來自學校 C(7472)。這份摘錄只用來說明各種運算;下文所用的變異成分,來自以 REML 對 23 所學校全部 519 位學生配適的隨機截距模型(表 2.2 的模型 M1),其中 ,作業時間的 ,,。
| 學校(NELS:88 識別碼) | 學生 | 作業時間(類別) | 數學 |
|---|---|---|---|
| A (6467) | 3 | 3 | 61 |
| A (6467) | 43 | 0 | 42 |
| A (6467) | 56 | 3 | 67 |
| B (6327) | 4 | 1 | 61 |
| B (6327) | 9 | 1 | 56 |
| B (6327) | 13 | 1 | 46 |
| B (6327) | 15 | 0 | 60 |
| C (7472) | 3 | 1 | 48 |
| C (7472) | 8 | 0 | 48 |
| C (7472) | 13 | 0 | 53 |
註:23 所學校之 NELS:88 子樣本中三所學校的學生,依學生編號分別取各校的前三、前四與前三位。學生:學校內的學生識別編號。作業時間:每週寫數學作業之時間的類別(0 = 不寫作業,1 = 少於一小時,2 = 一小時,3 = 兩小時,4 = 三小時,5 = 四到六小時,6 = 七到九小時,7 = 10 小時以上);數學:成就測驗分數。
A.3反矩陣、行列式與秩#
方陣 的反矩陣,是滿足 的矩陣 。反矩陣存在,若且唯若行列式 不為零。此時 ;而對於階數相同的可逆矩陣 與 ,。對 矩陣而言,
乘積的行列式等於各行列式的乘積,;對角矩陣的行列式是其對角元素的乘積;區塊對角矩陣的行列式則是各區塊行列式的乘積。共變數矩陣的行列式是一種廣義變異數(generalized variance):它出現在常態概似中(第 A.8 節),並在變項接近共線時縮向零。矩陣的秩是線性獨立之行的最大個數(等價地,也是線性獨立之列的最大個數)。堆疊而成的 設計矩陣 必須是行滿秩(秩為 ),固定效果才能識別(單一的 則不必如此:叢集層次的變項在叢集內是常數,因此與其截距行共線);每個叢集各有一個虛擬變項再加上截距,或叢集層次變項再加上叢集虛擬變項(第 32 章),都違反這個條件。
A.4二次式、特徵值與正定性#
二次式是一個純量 ,其中 為對稱矩陣。若對每一個非零的 都有 ,此矩陣為正定矩陣;若 ,則為半正定矩陣。每一個共變數矩陣都是半正定的,因為 是線性組合 的變異數,不可能為負。對稱矩陣的特徵值 是使 對某個非零向量 成立的解;特徵值的乘積是行列式,總和是跡。正定矩陣的特徵值全為正,行列式為正,而且有反矩陣;半正定但非正定的矩陣至少有一個特徵值為零,它描述的是一個沒有變異的變項組合。這正是 lme4 回報奇異配適時的情形:估計的 是半正定但非正定,因而位於參數空間的邊界上,例如某個變異數為零、某個相關為 ,或者在有三個以上隨機效果時,隨機效果的某個線性組合變異數為零(第 9 章)。
每一個正定矩陣都有 Cholesky 分解 ,其中 是對角元素為正的下三角矩陣。軟體利用這個分解來穩定地計算反矩陣與行列式,,也用它把共變數矩陣參數化,使其在估計過程中保持半正定;例如,lme4 寫成 ,其中 是下三角的相對共變數因子(relative covariance factor),其對角元素限制為非負(第 9 章),因此 永遠是半正定的,而當 的某個對角元素為零時,它就是奇異的 (Bates et al., 2015)。二次式出現在全書各處:常態密度的指數、Wald 統計量,以及廣義殘差平方和 ,都是二次式。
A.5區塊矩陣與一個叢集的共變數矩陣#
把各叢集堆疊起來,得到 與 ,其共變數矩陣 是一個區塊對角矩陣:不同叢集的單位彼此獨立,所有的相依性都在區塊之內。由於區塊對角矩陣的反矩陣與行列式可以逐塊求得,即 與 ,估計時從來不必對完整的 矩陣求反矩陣。
對隨機截距模型而言, 且 ,因此
這就是複合對稱矩陣,對角線上為 ,對角線外為 。圖 A.1 呈現摘錄中十位學生的 :每個對角元素都是 92.63,同校兩位學生之間的每個共變數都是 21.34,其餘元素都是零;學校 A 的矩陣為
以作業時間為條件,同校兩位學生之間的相關就是殘差組內相關係數,21.34/92.63 = .23。複合對稱矩陣有兩個相異的特徵值: 出現一次,特徵向量為 ; 出現 次,特徵向量為與 正交的向量。學校 A 的這兩個特徵值為 135.31 與 71.28。因此,只要 且 ,這個矩陣就是正定的;所以在模型的邊際解讀下,略為負值的 是可以接受的(第 11 章)。
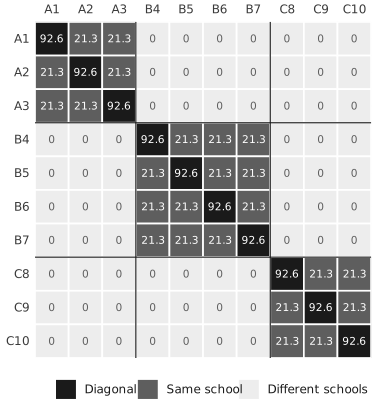
註:列與欄:摘錄中的學生,以學校(A、B、C)與排列位置標示。儲存格數值:隨機截距模型所隱含的變異數(對角線)與共變數,其中變異成分以全部 23 所學校估計,並四捨五入到小數一位。黑色:變異數;深灰色:同一所學校內的共變數;淺灰色:不同學校之間為零的共變數。黑線區隔各學校的區塊。
具特定型態之矩陣的反矩陣。 有兩個恆等式能得出這類矩陣之反矩陣與行列式的封閉形式。Woodbury 恆等式指出,對於維度相容、且 與 可逆的矩陣,
而 ,這是矩陣行列式引理(matrix determinant lemma)。令 、、、,Woodbury 恆等式得出 ,只需要對一個 矩陣求反矩陣。當 為奇異矩陣時,等價的形式 可以避開 。對隨機截距而言,
學校 A 的 , 的對角元素為 0.0118,非對角元素為 0.0022,而 ,也就是三個特徵值的乘積;直接以數值方法求反矩陣,結果與式 (A.5) 在每一個元素上的差異都在 以內,軟體所算的行列式與之相比,相對差異也在 以內。因子 是組平均數 之變異數的 倍(第 A.7 節),它會在第 A.8 節的收縮因子中再次出現。
A.6Kronecker 積與平衡設計#
矩陣 與矩陣 的 Kronecker 積是區塊矩陣 ,其第 個區塊為 。它的運算規則為:當乘積 與 存在時,;;對於可逆的 與 ,;而對於方陣 ()與 (),。在 個叢集、每個叢集 個單位的平衡設計中,隨機截距模型的共變數矩陣為
由此立即可見各叢集彼此獨立、結構相同,而且 。vec 運算子把矩陣的各行堆疊起來,它與 Kronecker 積的關係是 。Kronecker 積也可以描述可分離的共變數結構,例如用於多個結果變項的重複測量;它們也能表示第 27 章多變量多層次模型中一個叢集的共變數矩陣 (結果變項堆疊在單位之內,資料完整);第 3 與 16 章的平衡設計結果,例如均方的期望值與設計效果,都可以用它們推導出來。
A.7線性形式的期望值與共變數#
若 的平均數為 、共變數矩陣為 ,且 、 與 為常數,則
對二次式而言,;最大概似變異數估計式的偏誤,以及 REML 對此偏誤的校正,都以這個結果為基礎(第 9 章)。把式 (A.7) 應用於隨機截距模型,可得組平均數的變異數 ;再除以 ,就得到第 16 章的設計效果 ,其中 。
在 已知時,固定效果的廣義最小平方法(generalized least squares, GLS)估計式是 的線性形式:
利用第 A.5 節堆疊的 與 ,,且 ,其中 ;共變數矩陣可由式 (A.7) 得到,因為 。實務上以估計的 取代 ,而標準誤忽略了變異成分的不確定性;這就是為什麼叢集數少時,需要第 10 章的小樣本校正(Satterthwaite 或 Kenward–Roger 自由度,以及 Kenward–Roger 標準誤)。對摘錄中的十位學生,以全部資料的變異成分代入式 (A.8),得到截距 49.35(SE 4.67)與作業時間斜率 4.69(SE 2.70);普通最小平方法(OLS)對所有學生給予相同的權數,得到的則是 49.78 與 4.42。由於 的 REML 估計值就是在 處計算的 GLS 估計值,把式 (A.8) 應用於全部 519 位學生,可以在 以內重現 lme4 的估計值與標準誤。
投影矩陣。 在一般迴歸中,帽子矩陣 把 投影到配適值上;它是對稱且冪等的,而 產生殘差。在 GLS 中,配適值為 ,其中 是冪等的,但不對稱;殘差則在矩陣 中以 加權,也就是
它滿足 與 。REML 對數概似只透過 依賴 ,而這個量不涉及 :除了一個常數之外,(第 9 章)。叢集穩健標準誤的 CR2 校正(第 10 與 32 章)使用帽子矩陣的對角區塊 :OLS 用 ,GLS 用 。
A.8多變量常態分配#
平均數為 、共變數矩陣 為正定的 向量 ,若其密度為下式,就稱為多變量常態,記作 :
多層次模型的 ML 對數概似,是以 與 代入後,式 (A.10) 之對數在各叢集上的總和;第 A.5 節的行列式與反矩陣就是在這裡進入計算。第 A.7 節的 REML 對數概似則在 GLS 估計值處計算這個對數概似,再加上 (差一個常數;第 9 章)。有三個性質會反覆用到。第一,多變量常態向量 的線性函數 仍是多變量常態,其平均數與共變數如式 (A.7) 所示;邊際模型就是以這種方式由式 (A.1) 得到的,因為 與 彼此獨立,因此為聯合常態。第二,多變量常態向量中互不相關的元素或子向量彼此獨立;對於各自為常態但並非聯合常態的變項,相關為零並不表示獨立。第三,若把 分割為 與 ,其平均數與共變數為
則給定 時, 的條件分配為常態,且
條件平均數是 對 的線性迴歸,而條件變異數不依賴觀察到的 。矩陣 是 的 Schur 補(Schur complement),它也出現在分割矩陣的反矩陣中;第 12 章利用 Henderson 混合效果模型方程式之係數矩陣的這個反矩陣,求得隨機效果的預測誤差變異數,附錄 B 也用它求得 的共變數矩陣。
作為條件平均數的經驗貝氏預測值。 隨機效果 與結果變項 為聯合常態,且 。令 、 應用式 (A.12)(因此 、、、、),可得條件平均數與條件變異數
以估計值取代 、 與 之後,條件平均數就是經驗貝氏預測值,條件變異數則是 lme4 所報告的後驗變異數,它忽略了 的不確定性(第 12 章)。對隨機截距而言,式 (A.5) 把這兩個式子化簡為 與 ,其中 ,而 既是組平均數的信度(第 5 章,式 (5.3)),也是收縮因子。在摘錄中,學校 A 的 ,根據對十位學生的 GLS 配適,其平均殘差為 2.07,因此其預測效果為 0.98,後驗標準差為 3.35;有四位學生的學校 B,,平均殘差為 2.88,預測效果為 1.57。以同樣的方式計算全部 23 所學校,所得的預測值與 lme4 的預測值一致。
A.9導數、訊息與 Delta 法#
使概似達到最大的牛頓類演算法,以及由概似得出的標準誤,都要用到對參數的導數,而大部分的工作由兩條矩陣規則完成。對於依賴參數 的共變數矩陣 ,
對隨機截距而言,,。對數概似的一階導數向量稱為分數(score),二階導數矩陣之期望值的負值則是費雪訊息(Fisher information),其中 集合了固定效果與第 9 章的共變數參數 。在叢集數多、而且真值位於參數空間內部時(第 A.12 節),ML 估計式 近似常態,其共變數矩陣為 ;這就是固定效果與變異成分之標準誤的來源,而費雪計分法與牛頓-拉弗森法也用同樣的導數來尋找最大值(第 9 章)。
Delta 法為估計值的函數提供近似的標準誤。若 近似服從 ,而 是梯度為 的平滑函數,則 。多層次研究的報告中常見兩種應用:由變異數的標準誤求標準差的標準誤,;以及組內相關係數 的標準誤,其對 的梯度為 。由於叢集數少時,變異數估計值的抽樣分配是偏斜的,對變異成分而言,以剖面概似或拔靴法求得的區間優於 Delta 法區間(剖面區間與拔靴區間:第 10 章;變異數之 Wald 推論的失效:第 11 章)。
A.10卡方、t 與 F 分配#
若 是獨立的標準常態變項,則 服從自由度為 的卡方分配 ,其平均數為 ,變異數為 。更一般地說,若 有 個元素,則二次式 服從 。這是 個線性假設 之 Wald 檢定的基礎,其中 是秩為 的 對比矩陣;當叢集數多時,其統計量 近似服從 。相差 個參數的巢套模型,其概似比統計量 在這些參數的虛無值位於參數空間內部時,也有相同的近似分配;固定效果不同的模型必須以 ML 對數概似比較,不能用 REML 對數概似,而固定部分相同的模型則兩者皆可使用(第 10 與 11 章)。
若 為標準常態,且與 獨立,則 服從自由度為 的 分配;若 與 彼此獨立,則 服從自由度為 與 的 分配。在多層次模型中, 與 參考分配都只是近似,其自由度必須估計,例如使用第 10 章的 Satterthwaite 或 Kenward–Roger 方法,因為標準誤的平方並不恰好是與估計值獨立、乘上尺度常數的卡方變項。
A.11離散結果變項的分配#
第 23 與 24 章的廣義線性混合效果模型,以及第 25 章的離散時間存活模型,把給定隨機效果時結果變項的常態分配,換成適用於離散資料的分配。二元結果變項服從伯努利分配,成功機率為 ,平均數為 ,變異數為 ;在成功機率同為 的 次獨立試驗中,成功次數服從二項分配,平均數為 ,變異數為 。計數常以卜瓦松分配建模,其變異數等於其平均數 ;變異數大於平均數稱為過度離散,可由負二項分配或觀察值層次的隨機效果吸收(第 24 章)。伯努利、二項與卜瓦松分配的變異數都是平均數的函數,因此與常態模型不同,第一層變異數並不是另外的參數。二元結果變項的邏輯斯模型可以寫成一個連續潛在反應的閾值模型,該潛在反應的殘差服從標準邏輯斯分配,平均數為 0,變異數為 ,其中 是數學常數(圓周率);在第 23 章的潛在尺度組內相關係數 中,這個常數取代了 。
A.12邊界上的檢定所用的混合分配#
概似比檢定的卡方參考分配,要求受檢定參數的虛無值位於參數空間的內部。變異數的下界為零,因此虛無假設 把參數放在邊界上。在這個虛無假設下、而且叢集數多時,大約一半的樣本中估計值為零(叢集數少時,這種情形會稍微更常出現,在 ML 下尤其如此;第 11 章),此時概似比統計量為零;在另一半樣本中,它的表現像 。因此,它的大樣本分配是集中於零的點質量()與 以 50:50 組成的混合分配 (Self & Liang, 1987; Stram & Lee, 1994)。在含隨機截距的模型中加入隨機斜率時,會增加一個變異數與一個共變數,參考分配變成 與 以 50:50 組成的混合分配。更一般地說,在含 個相關隨機效果的模型中再加入一個隨機效果,會增加一個變異數與 個共變數,參考分配為 與 以 50:50 組成的混合分配,而觀察到的統計量 的 值為
其中 。表 A.2 列出臨界值,圖 A.2 則把混合分配的尾端機率與簡易卡方分配的尾端機率相比較。對一個變異數而言,混合分配在 的臨界值為 2.71,也就是 的 10% 臨界值:統計量 2.71 在 下的 ,在混合分配下則為 ,而通常的臨界值 3.84 對應於 。因此,簡易檢定是保守的,在這種情形下,它的 值可以減半。同時檢定數個變異數時,混合分配有更多成分,其權數取決於訊息矩陣,這時實務上可行的做法是模擬或參數拔靴法(第 11 章)。
| 下的 50:50 混合分配 | 下的簡易 | ||||||
|---|---|---|---|---|---|---|---|
| 參考混合分配 | 受檢定參數數 | .10 | .05 | .01 | .10 | .05 | .01 |
| 1 | 1.64 | 2.71 | 5.41 | 2.71 | 3.84 | 6.63 | |
| 2 | 3.81 | 5.14 | 8.27 | 4.61 | 5.99 | 9.21 | |
| 3 | 5.53 | 7.05 | 10.50 | 6.25 | 7.81 | 11.34 | |
註::自由度為 與 之卡方分配以 50:50 組成的混合分配,也就是在含 個相關隨機效果的模型中加入一個隨機效果時的參考分配;:集中於零的點質量。受檢定參數數:(一個變異數與 個共變數),這也是簡易卡方分配的自由度。:上尾機率。
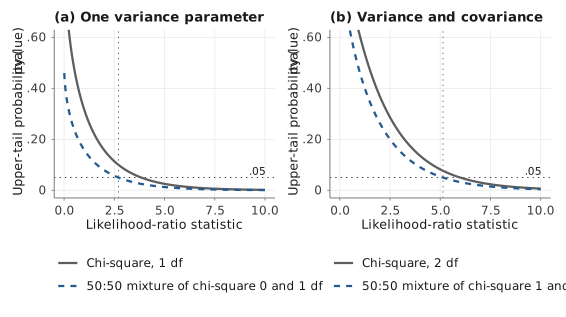
註:實線:自由度為 1((a) 圖)與 2((b) 圖)的簡易卡方分配;虛線:自由度為 0 與 1((a) 圖)以及 1 與 2((b) 圖)之卡方分配以 50:50 組成的混合分配。標示為 .05 的水平點線:上尾機率 .05;垂直點線:混合分配對應的臨界值。
延伸閱讀#
- Searle et al. (1992)
-
矩陣結果,以及變異成分模型的分配理論。
- Pinheiro 與 Bates (2000)
-
線性混合效果模型的矩陣表述及其計算。
- Self 與 Liang (1987); Stram 與 Lee (1994)
-
參數位於邊界上時的概似比檢定。