導讀
導讀:這本書怎麼讀
一本三十六章、七百多頁的方法書,沒有人真的從第一頁讀到最後一頁,假裝可以,只會讓讀者在第五章就放棄。這一章承認這件事,並且把它變成一件可以規劃的事。它不重複第 1 章 §1.7 已經給過的那份方法導引(routing):那份導引依資料結構(data structure)與問題家族(question family)把讀者導向章節,回答的是「我的資料長這樣、我想問這個,該用哪個方法」。這一章問的是另一個問題:讀者是誰、手上有多少時間、要達成什麼,因此該讀哪幾章、哪幾章可以放心跳過、哪幾章跳過之後後面會讀不懂。全書有一小群承重的章,第 13 章的線性混合效果模型(linear mixed-effects model)是其中最重的一根,被其後十五章當作前置;認出這幾根樑,比記住三十六個章名有用得多。這一章也把全書共用的約定一次講清楚:每一章長得一樣的六類方塊、章末的中英名詞對照、共用的書目資料庫,以及每一章都附的 R 腳本與模擬資料集(simulated dataset)。看懂這些約定,讀任何一章的成本都會下降。
學習目標
讀完本章之後,你應該能夠:(1) 說出本書八個部各自處理什麼、為何這樣分組,並判斷自己的研究落在哪一部;(2) 由四條閱讀路徑裡選一條適合自己的,並知道每一條為什麼略過某些章;(3) 指認出全書承重的那幾章,並理解跳過它們的代價;(4) 讀懂每一章共同的結構,包括六類教學方塊、章末的名詞對照與章末書目(chapter bibliography)各自的用途;(5) 使用全書一致的符號與術語約定,尤其是個體內(within-person)與個體間(between-person)這組貫穿全書的區分;以及 (6) 找到並執行任何一章所附的 R 腳本與它所使用的模擬資料集。
0.1 這本書的形狀
本書的三十六章不是三十六個獨立的技術,而是八個依序加深的部。認得這個形狀,比認得任何單一章都重要,因為它決定了「跳過某一章」的代價有多大。第一部(第 1 至 6 章)處理分析開始之前的一切:變化問題本身的分類、研究設計(research design)如何在蒐集資料的那一刻就決定了哪些估計標的(estimand)可得、測量工具能不能在各時點測到同一件事、檢定力(power)與精確度(precision)怎麼規劃、原始檔案怎麼整備,以及遺漏(missingness)怎麼處理。第二部(第 7 至 9 章)緊接在後,教的是建模之前用描述統計與圖示盤問資料:把總變異拆成個體內與個體間、把軌跡畫出來、把密集資料的時間結構看清楚。這兩部沒有一個模型,卻是全書最容易被跳過、也最不該被跳過的部分,因為它們決定的是主張上限(claim ceiling):後面每一個模型的可信度,都由這九章所作的決定封頂。
第三部到第五部是三種分析傳統,處理的是同一批問題。第三部(第 10 至 12 章)走古典路線,由兩個時點的比較出發,經重複量數變異數分析(repeated-measures ANOVA)到廣義估計方程(generalized estimating equations)。第四部(第 13 至 17 章)是本書的承重結構:線性混合效果模型,以及由它長出來的成長曲線(growth curve)、類別與計數結果變項的廣義線性混合模型(generalized linear mixed model)、把變異性本身當成結果變項的位置尺度模型(location-scale model),還有貝氏估計(Bayesian estimation)。第五部(第 18 至 22 章)把同一批問題搬進潛在變項(latent variable)與結構方程(structural equation)的架構:跨時間的測量恆等性(measurement invariance)、潛在成長曲線、潛在變化分數(latent change score)、交叉延宕(cross-lagged)追蹤設計,以及成長混合分配模型(growth mixture model)。這裡有一件事值得先知道:第四部與第五部在許多地方是同一個模型的兩種寫法,第 19 章會明白證明潛在成長曲線模型與多層次成長模型的等價性(equivalence),讀者不必兩邊都讀完才動手。
第六部(第 23 至 28 章)進入密集縱貫(intensive longitudinal)與動態系統,這是本書投注最多、也是這個領域近年變動最快的一塊:日記(diary)與經驗取樣(experience sampling)資料的多層次模型、單一受試者(single-subject)的時間序列(time series)、向量自我迴歸(vector autoregression)與動態結構方程(dynamic SEM)、狀態空間(state-space)形式、連續時間(continuous-time)模型,以及網絡(network)取向。最後兩部收尾。第七部(第 29 至 32 章)是專題與延伸:存活分析(survival analysis)、有彈性的曲線(flexible curve)方法、機器學習(machine learning)與非線性動力學(nonlinear dynamics),四章彼此獨立。第八部(第 33 至 36 章)是應用與工作流程,前三章從頭到尾走完三個領域的應用(臨床、發展與教育、社會與人格與組織),第 36 章把整套工作流程(workflow)整併起來。表 0.1 是這八個部的一覽。
表 0.1 八個部與它們各自回答的問題。
| 部 | 章 | 這一部處理什麼 | 跳過它的代價 |
|---|---|---|---|
| 第一部 | 1–6 | 問題的分類、設計、測量、檢定力、資料整備與遺漏 | 主張上限在這裡就封頂;跳過等於把它交給運氣 |
| 第二部 | 7–9 | 建模之前的變異數分解、描述統計與圖示 | 沒先把資料看過一遍,模型配出什麼都難以判斷合不合理 |
| 第三部 | 10–12 | 兩個時點的比較、重複量數變異數分析與廣義估計方程 | 想直接學混合模型的讀者代價最小;但第 10 章的差異分數陷阱誰都會遇到 |
| 第四部 | 13–17 | 多層次模型架構,全書的承重結構 | 第 13 章是全書最重的一根樑,跳過它,第六部大半讀不動 |
| 第五部 | 18–22 | 同一批問題在結構方程架構下的對應寫法 | 只做密集資料的讀者代價較小;但第 21 章的因果紀律(causal discipline)對誰都適用 |
| 第六部 | 23–28 | 密集縱貫與動態系統 | 只做三到八波追蹤的讀者可以整部略讀 |
| 第七部 | 29–32 | 存活分析、彈性曲線、機器學習與非線性動力學 | 四章彼此獨立,依題目取用,跳過不影響其他章 |
| 第八部 | 33–36 | 三章完整應用與全書工作流程 | 第 36 章不該跳:它是全書標準的稽核(audit)清單 |
註:八個部是本書的正式分部,與英文版一致。中文版各章以單章檔案排版,正文中不另立部標題,各章仍以連續章號編排。「跳過它的代價」一欄是對照各章自己宣告的前置章節(prerequisite)整理出來的,見 §0.3。
0.2 四條閱讀路徑
沒有一條路徑適合所有人,但也不必每個人都自己摸索。以下四條路徑對應四種常見的處境,每一條都指明必讀、選讀與可略過的章,並說明它為什麼那樣切。圖 0.1 把四條路徑畫在同一張圖上,表 0.2 給出逐章的清單。要強調的是,這四條路徑依讀者的處境切分。如果你已經有一份資料在手、只想知道該用哪個方法,該用的是第 1 章 §1.7 的表 1.1 與圖 1.5,那份導引依資料結構與問題家族切分,與這裡互補。
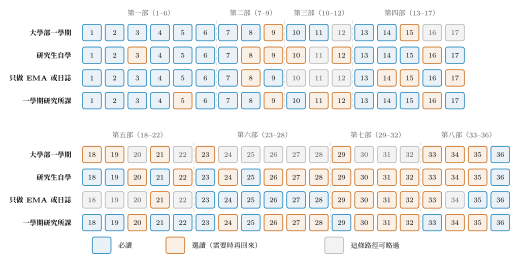
註:橫軸是章號,依八個部以虛線分隔:上排是第 1 至 17 章,也就是第一部至第四部;下排是第 18 至 36 章,也就是第五部至第八部。每一列是一條路徑,藍色為必讀、橘色為選讀、灰色為該路徑可以略過。四條路徑都以第 1 章開頭、第 36 章結尾,因為那兩章是全書的書擋(bookend):第 1 章畫出地圖,第 36 章走完同一張地圖並稽核它。四條路徑也都包含第 13 章,理由見 §0.3。略過不等於不重要,只表示在那條路徑所設定的目標下,它的邊際報酬較低。
表 0.2 四條閱讀路徑的說明。
| 路徑 | 適合誰 | 這樣切的理由 |
|---|---|---|
| 大學部一學期 | 修過基礎統計、第一次接觸重複測量的大學部學生 | 把時間全部投在第一、二部(第 1 至 9 章)與第 13、14 章:先建立個體內與個體間的區分,再學會一個真正用得上的模型,勝過認識十個只聽過名字的模型 |
| 研究生自學 | 有自己的資料、要在論文裡動手做的碩博士生 | 第一、二部只挑與自己資料相關的章,主線放在第 13 至 21 章這條由混合模型走到因果紀律的路上,第六部與第七、八部依題目取用 |
| 只做 EMA 或日誌 | 只處理密集縱貫資料、不做追蹤調查的研究者 | 第 10 至 12 章與第 19、20、22 章的多波追蹤技術用不上,但第 5、7、9 章的整備、描述與圖示以及第 16 章的變異性建模非讀不可 |
| 一學期研究所課 | 授課教師的骨幹排課 | 每週一章、十八週;捨去的是第五部的細節與第六部的進階模型,保留第 29 章與第 33 章,讓學生看過一次事件時機與一次從頭到尾的應用 |
註:逐章的必讀、選讀與略過見圖 0.1。四條路徑都不是規定,而是預設值;讀者一旦知道自己要什麼,就該偏離它。與第 1 章 §1.7 的差別在於切分的依據:那裡依資料與問題切,這裡依讀者與時間切。
0.3 承重的那幾章
三十六章之間的依賴並不均勻。把每一章自己宣告的前置章節整理起來,會浮現一個很不平均的入度(in-degree)分布:少數幾章被反覆引為前置,多數章只被一兩章引用。這件事對讀者很實用,因為它告訴你哪幾章跳不得。第 13 章線性混合效果模型被其後十五章引為前置,是全書最重的一根樑;第 1 章被十章引用,第 14 章成長曲線模型被九章引用,第 6 章遺漏資料被八章引用,第 25 章向量自我迴歸被七章引用。圖 0.2 畫出這根主幹與由它分出去的支線,表 0.3 列出被引用最多的九章。
一個實用的推論是:如果你只有時間讀五章,讀第 1、6、13、14 與 36 章。 第 1 章給你分解與詞彙,第 6 章讓你不至於把遺漏處理錯,第 13 章給你那個會反覆使用的模型,第 14 章把時間放進去、讓它成為成長模型,第 36 章讓你知道報告一份結果需要什麼。這五章不會讓你變成專家,但足以讀懂多數縱貫論文的方法一節,也不至於在自己的分析裡犯下最貴的那幾個錯。相對地,第 33 至 35 章這三章應用章的前置章節最多,第 34 章一章就宣告了十二章前置,因此它們適合當作驗收(consolidation)而不是入門。
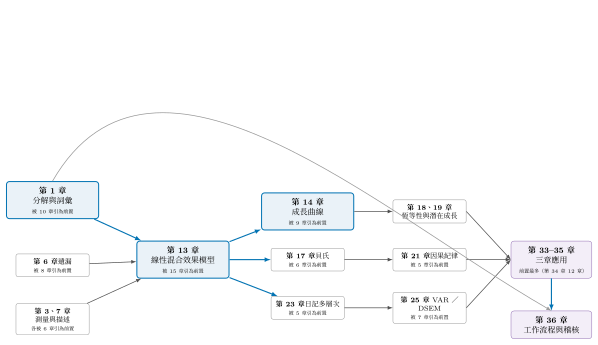
註:節點是被其他章反覆引為前置的章,粗藍箭頭是主幹、細灰箭頭是支線。「被 N 章引為前置」的數字由三十六章各自宣告的前置章節統計而來,不是編者的評價。上方那條由第 1 章繞到第 36 章的灰線,代表兩章互為書擋的關係:第 1 章畫下地圖作為承諾,第 36 章重走同一張地圖作為稽核。第 33 至 35 章是三章從頭到尾走完的應用,前置章節最多,適合放在最後作為驗收。
表 0.3 被最多章引為前置的九章。
| 章 | 標題 | 被引次數 | 它提供了什麼 |
|---|---|---|---|
| 13 | 線性混合效果模型:基礎 | 15 | 全書反覆使用的那個模型與它的中心化(centering)紀律 |
| 1 | 研究變化 | 10 | 個體內與個體間的分解,以及五個問題家族 |
| 14 | 多層次架構下的成長曲線模型 | 9 | 把時間放進第一層,使混合模型成為成長模型 |
| 6 | 遺漏資料與流失 | 8 | 依機制而非型態處理遺漏 |
| 25 | 向量自我迴歸、多層次 VAR 與動態 SEM | 7 | 多變量的個體內動態 |
| 3 | 跨時間與跨時間尺度的測量 | 6 | 分層次的信度(reliability)與構念的連續性 |
| 7 | 變異數分解與重複測量的描述統計 | 6 | 建模之前分層次的描述工具 |
| 4 | 規劃縱貫研究 | 6 | 以估計標的為單位的檢定力 |
| 17 | 縱貫模型的貝氏估計 | 6 | 小樣本與複雜隨機效果的估計引擎 |
註:被引次數是各章「承第 N 章」一類交互參照的統計,反映的是教學上的依賴,不是重要性的排序。第 33 至 35 章與第 36 章位於依賴鏈的末端,因此被引次數為零,那不表示它們可以略過。
0.4 每一章長得一樣
三十六章共用同一套結構,認得它,讀任何一章的成本都會下降。每一章以一段章首題引(epigraph)開場,說明這一章為什麼存在;接著是一個學習目標方塊,以六個編號項目寫出讀完之後應該做得到什麼,這個方塊也適合當作讀完之後的自我檢核。正文之中散布六類方塊(box),各有固定的用途:基礎方塊補充推導或統計背景,實務方塊給出真的會遇到的操作細節,陷阱方塊點名這個題目上最常見的錯誤,軟體方塊說明用什麼工具怎麼做。章末依序是摘要方塊、中英名詞對照表,以及該章的參考文獻。圖 0.3 呈現這份解剖。
三件事值得單獨說明。第一,章末的中英名詞對照表是為了讓讀者回得去英文文獻:中文譯名在不同教科書之間並不統一,因此每一個關鍵術語都附上英文原詞,以及它在本章的定義與出處小節,全書共 696 個條目。第二,參考文獻各章獨立,由一個共用的書目資料庫 LDA_refs.bib(523 筆)依該章實際引用到的文獻自動產生,因此影印任何一章都會拿到完整的書目。第三,每一章的圖都由一支可執行的 R 腳本產生,檔名為 chNN_figures_zh_V01.R,放在 Examples/R/;讀者可以改參數重跑,看某個結論對某個設定有多敏感,那正是第 36 章要形式化的敏感度(sensitivity)習慣。
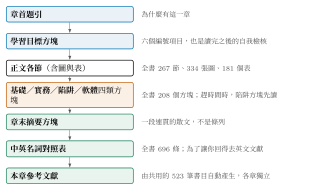
註:每一章都依這個順序組成。右側是各元件的用途與全書的總量。時間緊迫時的一個實用讀法是:先讀學習目標方塊與章末摘要方塊,再讀陷阱方塊,最後才決定正文哪幾節要細讀。名詞對照表與參考文獻是查閱用的,不必依序讀。
實務要點 • 怎麼跳讀而不迷路
跳讀是必要的,問題只在於怎麼跳才不會在第三章之後讀不懂。三個做法有效。第一,先讀章末摘要方塊再決定要不要細讀正文,那一段是連貫的散文,會告訴你這一章實際交付了什麼,而不是它宣稱要處理什麼。第二,遇到看不懂的地方,先查該章末的名詞對照表,多數卡住的地方是術語而不是概念,而對照表會直接指出那個詞在哪一節被定義。第三,把承重的那幾章當作可以回頭的錨點,而不是門檻:讀第 23 章時如果混合模型的語言變得陌生,回第 13 章翻那一節就好,不必從頭重讀。真正跳不得的只有一件事,就是第一部關於設計、測量與遺漏的那幾章所設下的限制;模型可以之後再學,但一份設計不良的資料,再高深的模型也救不回來。
0.5 符號、術語與版面的約定
全書共用一套約定,在此一次講清楚。最重要的一組是個體內與個體間的區分,它貫穿三十六章,在符號上也是明確的:以 \(i\) 標記人、\(t\) 標記時點,\(y_{it}\) 是第 \(i\) 個人在第 \(t\) 個時點的觀察值,\(\bar{y}_{i\cdot}\) 是那個人自己的平均數,\(y_{it} - \bar{y}_{i\cdot}\) 就是個體內偏離(within-person deviation)。這個減法看起來很小,卻是本書大半內容的樞紐,因為跨個體成立的關聯與個體之內成立的關聯在邏輯上彼此獨立,強度甚至方向都可能相反。表 0.4 列出全書一致的符號與術語約定。
譯名的處理有兩條規則。專有名詞首次在該章出現時,一律以半形括號附上英文原詞,例如參數(parameter);同一章之後再出現就不再標註。中文譯名採台灣的學術用語,同一個英文詞有多種通行譯法時擇一固定、全書貫徹,例如 centering 一律作中心化而不作置中,lag 一律作延宕而不作落後。少數概念在中文裡沒有簡潔對應時,本書寧可把句子調整得長一點,也不創造讀者查不到的新詞。
表 0.4 全書一致的符號與術語約定。
| 符號或體例 | 意義 | 說明 |
|---|---|---|
| \(i\)、\(t\) | 人的索引、時點的索引 | 三層資料另以 \(j\) 標記群集(cluster) |
| \(y_{it}\)、\(\bar{y}_{i\cdot}\) | 觀察值、該人自己的平均數 | \(y_{it}-\bar{y}_{i\cdot}\) 即個體內偏離 |
| \(\gamma\)、\(u\)、\(e\) | 固定效果、隨機效果、殘差 | 混合模型全書一致,見第 13 章 |
| \(\Phi\) | 動態係數矩陣 | 向量自我迴歸與動態 SEM,見第 25 章 |
| \(T\)、\(N\) | 每人的時點數、人數 | 個體內效果的有效樣本與 \(T \times N\) 有關 |
等寬字 | 資料集、檔名與程式碼 | 例如 affect_ema、lmer() |
| 無襯線 | R 套件名 | 例如 lme4、brms |
| 中文 (English) | 專有名詞首次出現 | 每章各自重新標註一次 |
註:各章另有該章特有的符號,一律在該章首次使用處定義,並收入章末的名詞對照表。數學式的編號在各章之內連續。
0.6 資料與程式碼
本書所有的例子都建立在模擬資料集上,這是刻意的選擇,不是權宜。模擬資料的好處是真值是已知的:讀者可以把模型估出來的數字與植入的真值(true value)直接對照,看見估計偏誤(bias)有多大、在什麼條件下變大,這是任何真實資料都給不了的教學條件。所有資料集都放在 Examples/data/,另附資料編碼簿(codebook)說明每一個變項的意義與生成方式;產生它們的腳本也一併附上,因此讀者可以改變樣本數、時點數或效果量,重跑同一章的分析,看結論怎麼隨之改變。這份習慣本身就是第 36 章要形式化的東西:一個撐不過合理設定變動的結論,本來就不該被當作發現。
第 36 章另有一個收尾的對稱值得先預告:教會這些方法的模擬資料集,同時也是安全分享真實資料的範本。密集縱貫的原始軌跡因為可再識別(re-identifiable)而不能公開時,一份由配適好的模型產生的合成(synthetic)伴隨資料,可以讓別人重建分析而不曝光任何一位參與者。
軟體提示
本書的程式碼一律使用 R。最小的環境需求是 R 本身加上 ggplot2、dplyr、tidyr 與 patchwork,這四個套件就足以跑完全書所有的圖形腳本。模型的部分依章需要 lme4(第 13 至 16 章)、lavaan 與 semTools(第 18 至 22 章)、mgcv(第 30 章)、survival(第 29 章)與 brms(第 17 章及各章的貝氏作法)。建議需要時再安裝,不必一開始就把全部裝齊。每一章的圖形腳本都可以獨立執行,只要工作目錄設在 Examples/R/;腳本會自行讀取 ../data/ 之下的資料,並把圖寫到 ../../figures/chNN/。所有腳本都設了亂數種子(seed),因此同一支腳本重跑得到的圖完全相同。
常見陷阱 • 三種讀法會讓你事倍功半
第一種是依章號順序硬讀。三十六章不是設計成連續閱讀的,第四部與第五部在許多地方是同一件事的兩種寫法,硬讀會在中段耗盡耐心,而真正該投入的第一、二部反而被當成前言草草帶過。第二種是跳過第一、二部直接找模型。這是最貴的一種讀法,因為設計、測量與遺漏所設下的限制不會因為模型高深而消失;一份每人只有兩個時點的資料,配任何動態模型都不會產生動態的知識。第三種是只讀正文、略過方塊。四類方塊承載的正是這個領域最不容易從論文裡學到的東西:陷阱方塊點名的錯誤,多半是已發表文獻裡反覆出現的那幾個。若真的沒有時間,正確的取捨是略讀正文而細讀陷阱方塊,不是相反。
本章摘要
這一章給的是一份閱讀的地圖,與第 1 章 §1.7 依資料與問題切分的方法導引互補。全書三十六章分成八個依序加深的部:分析之前的設計與測量、建模之前的描述與圖示、古典的變異數分析與迴歸傳統、多層次模型架構、結構方程架構、密集縱貫與動態系統、專題與延伸,以及應用與工作流程。四條閱讀路徑分別對應大學部一學期、研究生自學、只做密集縱貫資料,以及一學期的研究所課程,每一條都指明必讀、選讀與可略過的章。章與章之間的依賴很不平均,第 13 章的線性混合效果模型被其後十五章引為前置,是全書最重的一根樑;若只有時間讀五章,讀第 1、6、13、14 與 36 章。每一章共用同一套結構,包含章首題引、學習目標方塊、四類正文方塊、章末摘要、中英名詞對照表與該章的參考文獻,其中名詞對照表是為了讓讀者回得去英文文獻。符號的約定以個體內與個體間的區分為核心,而所有例子都建立在真值已知的模擬資料上,讓讀者對照得出估計偏誤。最後一件事最重要:跳讀是被鼓勵的,但第一、二部關於設計、測量與遺漏所設下的限制跳不得,因為模型可以之後再學,資料不能。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 承重章 | load-bearing chapter | 被其後多章引為前置的章;第 13 章被 15 章引用;第 0.3 節 |
| 前置章節 | prerequisite | 各章自己宣告、讀本章之前該讀過的章;第 0.3 節 |
| 書擋 | bookend | 第 1 章與第 36 章互為地圖與稽核的關係;第 0.2 節 |
| 個體內偏離 | within-person deviation | \(y_{it}-\bar{y}_{i\cdot}\);全書大半內容的樞紐;第 0.5 節 |
| 章首題引 | epigraph | 每章開場說明這一章為何存在的一段;第 0.4 節 |
| 中英名詞對照表 | glossary table | 章末條目,附英文原詞與定義出處;全書 696 條;第 0.4 節 |
| 資料編碼簿 | codebook | 說明每一個變項的意義與生成方式;第 0.6 節 |
| 模擬資料集 | simulated dataset | 真值已知,可直接對照估計偏誤;第 0.6 節 |
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。