第 2 章
縱貫研究設計:從追蹤調查到 EMA、日誌與隨身評估
第 1 章主張,關於變化的問題需要專屬的方法。本章談的是任何方法之前的那一步:設計。你最終估計得出什麼,早在決定「蒐集什麼、何時蒐集、向誰蒐集、多久蒐集一次」的那一刻就固定下來,事後無法挽回。設計得好,分析只是技術問題;設計得不好,再好的技術也救不回來。
學習目標
讀完本章之後,你應該能夠:(1) 區分趨勢(trend)、追蹤(panel)與世代(cohort)三種設計,並把任何一項研究定位在「時點數乘以間隔」這個二維設計空間裡;(2) 在間隔取樣(interval-contingent)、訊號取樣(signal-contingent)與事件取樣(event-contingent)之間作出選擇,並說清楚理由;(3) 陳述年齡、時期與世代(age-period-cohort)的識別問題,說明加速縱貫設計如何處理它,又付出了什麼假設代價;(4) 列舉「反覆測量同一群人」特有的效度威脅,並為每一項指出一種設計上的對策;(5) 讓研究的取樣時間尺度與所研究歷程的時間尺度相配;(6) 訂出一份站得住腳的經驗取樣方案,包含密度、期程、提示設計,以及一個實際可行的配合度目標;(7) 說明測量叢發設計與微隨機化試驗背後的邏輯。
2.1 設計空間
把縱貫研究歸進一份簡短的名稱清單,是很自然的念頭,但更有用的起點是認清一件事:每一種重複測量設計都座落在一個連續空間裡,而這個空間由兩個問題定義,也就是每個人測幾次、這些測量彼此相隔多遠。圖 2.1把這個空間攤開,橫軸是每人的時點數,縱軸是時點之間的典型間隔,兩軸都採對數尺度,因為兩者都橫跨好幾個數量級。兩波追蹤研究在左上角,兩個時點相隔數月或數年。每日日誌接近中間,幾十個時點,彼此相隔一天。生態瞬時評估(ecological momentary assessment)更低、更偏右,數百個時點,彼此相隔數小時。隨身生理測量與被動式手機感測在右下角,數千個時點,彼此相隔數秒或數分鐘。替一種設計命名,只是替這個空間中某一塊區域取個簡稱;區域之間連續漸變,並沒有截然的界線。
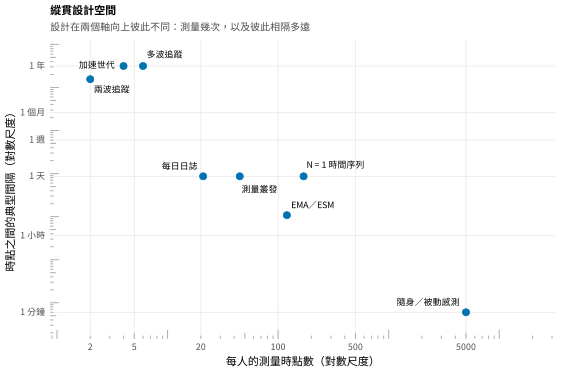
註:兩軸皆為對數尺度。各種有名字的設計佔據的是彼此重疊的區域,而不是離散的點;測量叢發設計(第 2.4 節)刻意把叢發之內的短間隔與叢發之間的長間隔結合起來,因此放不進單一位置。
有兩組彼此獨立的區分橫跨整個設計空間,值得一開始就先釐清。第一組是重複橫斷(repeated cross-section),有時稱為趨勢設計(trend design),與真正的追蹤設計(panel)之間的區別。重複橫斷在每個時點調查一批全新的樣本,因此它描述得了母體平均數如何隨時間改變,卻永遠觀察不到任何一個人正在改變,因為沒有人出現兩次。真正的追蹤設計跨時點追蹤同一批個體,攜帶的是個體內訊息。第 1 章那些個體內的問題只有追蹤設計答得出來;趨勢設計不管做了幾波,本質上都還是一連串個體間的快照。第二組區分是前瞻(prospective)與回溯(retrospective)測量。前瞻設計在狀態發生的當下就記錄下來,回溯設計則要求人事後回想。記憶是重建而不是重播,回溯報告因此帶有系統性的回憶偏誤(recall bias),而且回想的時間跨度愈長,偏誤愈大;把這種偏誤壓下來,正是本章後半那些密集前瞻設計最主要的動機之一 (Shiffman et al., 2008)。
2.2 古典的追蹤與世代設計
縱貫研究裡最古老的問題來自發展研究,而這個問題暴露出一個混淆:單一設計無論蒐集多少資料都解不開。假設觀察到五十歲的人在某項認知作業上的分數低於三十歲的人,有三種解釋纏繞在一起。這個差異可能反映年齡(age),也就是隨著變老而發生的真正個體內變化。可能反映世代(cohort),也就是出生於不同年代、接受不同教育與營養的人之間一種穩定的差異。也可能反映時期(period),也就是測量所處的那個歷史時刻對所有人一致的影響。Schaie (1965) 把這三種影響組織成一個框架,如圖 2.2所示,其邏輯至今仍主導發展研究的設計。方格表中的每一格是一個出生世代與一個測量時期的組合,該格的年齡則由另外兩者決定。橫斷研究取的是單一直欄,一個時期跨越數個世代,於是把年齡與世代混淆在一起。單一世代的縱貫研究取的是單一橫列,一個世代跨越數個時期,於是把年齡與時期混淆在一起。世代序列設計(cohort-sequential design)取的是多個世代乘以多個時期,也就是整個方格表;只有這樣的設計才有希望把三者分開。
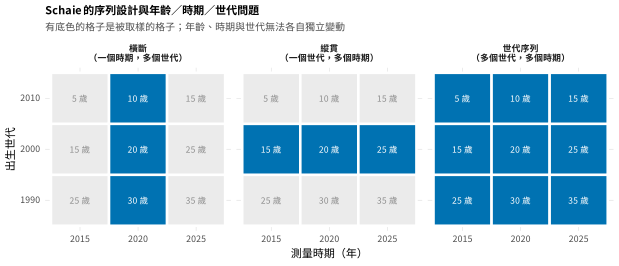
註:橫列是出生世代,直欄是測量時期,每一格中的標示是該組合下的年齡。有底色的格子是各設計取樣的格子。年齡等於時期減去世代,三個維度因此無法各自獨立操弄,每一種只取單一切片的設計都必然混淆其中兩者。
這三種影響切不開,原因不在統計方法不夠大膽,而在算術本身,值得攤開來看清楚。
基礎概念 • 年齡、時期與世代的線性相依
令某人受測時的年齡為 \(A\)、測量所在的曆年時期為 \(P\)、此人的出生世代為 \(C\)。依定義,年齡就是自出生以來經過的時間,因此
三個量恰好線性相依:任何一個都由另外兩個決定。現在考慮一個模型,試圖為三者各自估計一個線性效果,\(\;y = \beta_0 + \beta_A A + \beta_P P + \beta_C C + \varepsilon\)。把式 (2.1) 代入之後可以看出,三元組 \((\beta_A, \beta_P, \beta_C)\) 可以被任意常數 \(\delta\) 平移,換成 \((\beta_A + \delta,\; \beta_P - \delta,\; \beta_C + \delta)\),而配適值一個都不會改變。年齡、時期與世代的線性成分因此沒有被分別識別(identified):有無限多組參數值對同一筆資料的配適一樣好。任何估計方法再精巧,只要沒有外部假設,都打不破這個僵局(例如假設時期效果為零,或假設相鄰兩個世代相等)。這是識別問題,不是檢定力問題;在同一個設計下蒐集更多資料並不能解決。
實務上的脫身之道是加速縱貫設計(accelerated longitudinal design),也稱為世代序列設計或收斂設計(convergence design),圖 2.3以本書的 school_growth 資料示範。追蹤同一個世代的兒童走完三年級到八年級(譯註:約當台灣的小學三年級至國中二年級)的整整六年,要花六年的經費,也讓研究暴露在六年的流失風險之下;加速設計改為招募三個彼此重疊的世代,每個世代只追蹤四年。一個世代在三到六年級被觀察,第二個在四到七年級,第三個在五到八年級。把這些片段拼接起來,三個世代只用四個曆年就涵蓋三到八年級的整個範圍;三個世代都被觀察到的五、六年級是重疊區間,提供了檢驗各世代軌跡是否對得上的槓桿。這個設計用一個假設換來時間:它假設年齡軌跡的形狀在這些重疊的世代之間相同,各片段才接得成一條曲線。假設不是免費的,但與原始的年齡、時期與世代糾結不同,它可以檢驗,檢驗方式正是去看各世代在重疊區間內是否一致(建模方式在第 14 章發展,第 34 章再從發展研究的角度回訪)。
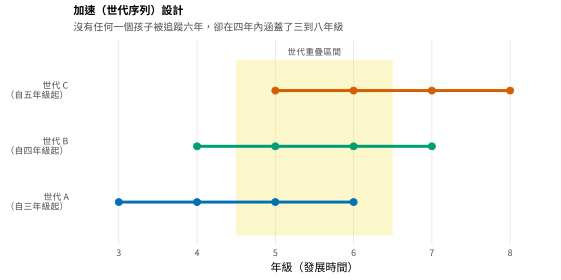
註:每一條橫向線段是 school_growth 中的一個世代,各被觀察四個年級。有底色的帶狀區域標示各世代重疊的年級;各世代在此區間內是否一致,正是容許把它們接成單一軌跡的那個可檢驗假設。
各種長度的追蹤設計都面臨第二族設計問題,關乎誰留在研究裡,以及測量本身如何改變了人。流失(attrition),也就是參與者隨時間退出,後果最嚴重,因為流失很少是隨機的:退出的人往往與留下的人有系統性的不同,留存下來的樣本於是逐漸偏離真正關心的母體。設計上的因應相當實務:仔細的追蹤聯繫流程、依留存程度遞增的誘因,以及在長期追蹤研究中以補充樣本(refreshment sample)加入新的參與者,補上流失的人。關鍵在於,決定偏誤大小的不是流失率本身,而是流失的機制(第 6 章深入發展):流失若只依賴先前已觀察到的數值,現代的估計方法處理得了;流失若依賴未被觀察到的結果變項本身,任何分析都無法完全校正。第二個問題是再測效果(retest effect),或稱練習效果,也就是反覆接觸同一份工具會因為與構念無關的理由而提升表現,這對認知類的結果變項是嚴重的混淆。設計上的補救包括使用複本(parallel forms)、刻意拉開評量之間的間隔,以及在下文的測量叢發設計中,以第一次叢發吸收掉最陡的那一段練習增益。第三個問題更隱微,是追蹤制約(panel conditioning):反覆被調查這件事本身改變了態度或行為,資深的受訪者於是不再像新受訪者那樣作答。
2.3 密集縱貫設計
設計空間中偏下、偏右的區域,在過去三十年間被一族設計徹底改變了;這族設計密集地、在情境之中取樣經驗,捕捉的是正在被經歷的生活,而不是事後被回想起來的生活。這些設計流傳著一堆令人困擾的名稱,第一件事就是把它們區辨清楚,這正是表 2.1要做的事。每日日誌(daily diary)一天取樣一次或數次,通常持續一到數週。經驗取樣法(experience-sampling method)與生態瞬時評估取樣更密集,一天數次,而且強調當下狀態而不是整日狀態;這兩個名稱分別起源於人格與臨床行為兩個不同的文獻傳統,如今幾乎完全重疊 (Csikszentmihalyi & Larson, 1987; Stone & Shiffman, 1994)。隨身評估(ambulatory assessment)是涵蓋最廣的名稱,明確納入生理與行為通道,例如隨身心率與活動記錄儀(actigraphy),而不只是自陳報告 (Trull & Ebner-Priemer, 2013)。被動感測(passive sensing),或稱數位表現型分析(digital phenotyping),則完全不需要參與者主動作答,直接從智慧型手機與穿戴式感測器連續蒐集資料 (Harari et al., 2016; Mohr et al., 2017)。這些不是同一件事的幾個競爭標籤,而是標示出密度、通道與參與者負擔上真實存在的差異。
表 2.1 密集縱貫設計的名稱對照。
| 設計 | 蒐集什麼 | 典型密度 | 通道 |
|---|---|---|---|
| 每日日誌 | 一天結束時回報當天的事件、心情與行為 | 每天 1–3 次,持續 1–4 週 | 自陳 |
| 經驗取樣(ESM) | 在提示的時刻回報當下狀態 | 每天 3–10 次,持續 1–2 週 | 自陳 |
| 生態瞬時評估(EMA) | 當下的狀態、症狀與行為(源於臨床) | 每天 3–10 次,持續 1–4 週 | 自陳 |
| 隨身評估(AA) | 自陳加上生理與身體活動 | 不一;感測器為連續 | 自陳+感測器 |
| 被動感測/數位表現型分析 | 感測器與裝置記錄,不需主動作答 | 連續 | 感測器/裝置記錄 |
註:表中的密度是典型值,不是定義;這些設計經常混用,例如每日日誌搭配少數幾次隨機的當下提示。
在自陳類的設計裡,最關鍵的單一決定是取樣方案(sampling scheme),也就是決定提示何時出現的規則。Wheeler and Reis (1991) 提出的三分法流傳至今,圖 2.4以連續三天的時間帶示範。間隔取樣(interval-contingent)依固定時程提示,例如每天晚上九點;做法簡單、可以預期,但捕捉不到落在提示之間的事件,也會誘使受訪者回溯整段間隔。訊號取樣(signal-contingent)在隨機時刻提示,通常是把清醒的一天切成數個等長區塊,在每個區塊內取一個隨機時刻;這種做法把預期心理降到最低,給出一份大致具代表性的「時刻樣本」,是研究情緒這類當下狀態時的預設選擇。事件取樣(event-contingent)則請參與者在某個已定義的事件發生時就回報,例如一次社會互動、一根菸或一次恐慌發作;稀有或邊界明確的事件只有這個方案捕捉得可靠,但它完全仰賴參與者辨識得出並記錄下該事件。三種方案並不互斥,混合設計相當常見,例如以訊號取樣蒐集情緒,同時以事件取樣回報衝突。表 2.2給出把方案對應到問題的指引。
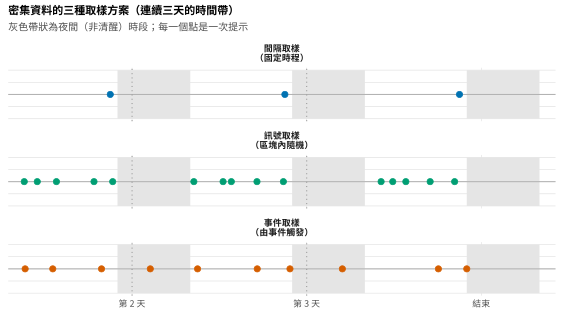
註:灰色帶狀區域標示夜間(非清醒)時段,每一個點是一次提示。間隔取樣的提示落在固定時程上;訊號取樣的提示落在清醒時段等長區塊內的隨機時刻;事件取樣的提示只在已定義的事件發生時出現。
表 2.2 取樣方案的選擇。
| 若問題關乎…… | 優先選擇…… | 理由 |
|---|---|---|
| 當下狀態的平均水準,以及片刻之間的動態 | 訊號取樣 | 取得一份不被預期的時刻的代表性樣本;支持個體內的延宕模型 |
| 規律的每日節律,或一天結束時的總結 | 間隔取樣 | 固定時點讓回報對齊自然的日循環;負擔較低 |
| 稀有、有明確邊界或由當事人自行界定的事件(衝突、破戒、恐慌) | 事件取樣 | 唯一捕捉得可靠的方案;避免樣本被無關的時刻稀釋 |
| 同時關乎狀態與事件 | 混合方案 | 以訊號取樣為骨幹,再疊上由事件觸發的回報 |
註:目標現象的基本率(base rate)是決定性的:現象越稀有、邊界越明確,採用事件取樣的理由就越強。
取樣方案選定之後,還要靠少數幾個設計參數才訂得出完整的研究方案,密集設計能不能成為實用工具就落在這裡。表 2.3列出這些參數與建議範圍。它們之間的核心張力是負擔與配合度的權衡(burden-compliance trade-off),圖 2.5把它勾勒出來:每多一次每日提示、每多一道題目、每多一週期程,都會提高受訪者負擔,並降低配合度(compliance),也就是實際作答的提示佔預定提示的比例。這個權衡不只是一個要盡量壓低的麻煩,因為配合度會與遺漏機制交互作用:最不配合的參與者若同時也是症狀最嚴重的人,低配合度就成了一種讓估計值產生偏誤的遺漏資料機制(第 6 章)。Stone et al. (2002) 是說明「為何前瞻式電子化蒐集如此重要」的歷史性基準:他們把帶有隱藏時間戳記的紙本日誌與電子日誌相比,發現參與者經常成批完成紙本日誌,事後回填或事先預填,卻回報接近完美的配合度;自陳的配合率約為 90%,由時間戳記推得的實際配合率則接近 11%。教訓是:配合度必須用時間戳記與作答記錄測量出來,不能從自陳去假定;而設計上的選擇(更短的題目、簡短的訓練、時機恰當的提醒、適當的誘因)是把整條配合度曲線往上推,不只是在提示之間彼此消長。
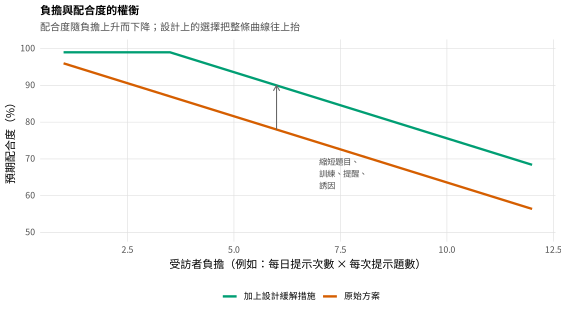
註:示意圖。配合度隨受訪者負擔上升而下降;縮短題目、訓練、提醒與誘因等設計上的緩解措施,是把整條曲線往上抬,不是改變它的斜率。垂直箭頭標示負擔固定時可以取得的配合度增益。
表 2.3 密集縱貫方案的設計參數檢核表。
| 參數 | 典型範圍 | 考量 |
|---|---|---|
| 研究期程 | 7–28 天 | 長到足以涵蓋目標動態;短到足以維持配合度 |
| 每日提示次數 | 3–10 次 | 提示越多越能解析較快的動態,但也提高負擔與反應性 |
| 作答時限 | 10–30 分鐘 | 短到能讓回報維持「當下」;長到讓人來得及作答 |
| 每次提示的題數 | 5–15 題 | 這是每次提示負擔的主要槓桿;要嚴加守住 |
| 訓練 | 1 次面對面或引導式 | 降低早期退出與題意誤解 |
| 提醒 | 遞增式、非懲罰性 | 提升配合度而不引發抗拒 |
| 誘因 | 遞增式或依完成度給付 | 獎勵持續的配合,而不只是獎勵報名 |
| 配合度目標 | 作答率 \(\geq 80\%\) | 事前明訂;過程中即時監控;誠實報告 |
註:表中的範圍是慣用的起點,不是規則;站得住腳的數值由估計標的決定,最好以第 4 章那種以模擬為基礎的規劃來確認。
實務要點 • 評估一個經驗取樣平台
遞送提示與蒐集回應的軟體很快就會過時,評估平台時因此要看能力,不看品牌。一個堪用的平台應該做到:遞送三種取樣方案及其混合;為每一次提示與每一次回應打上時間戳記,並記錄兩者之間的延遲;支援彈性的作答時限與遞增式提醒;依條件分支題目,讓後續題目只在相關時才出現;離線運作、事後再同步;以開放格式匯出帶時間戳記的原始資料;並且滿足當下資料所需的安全與同意要求,包括加密,以及使用敏感題目時的風險回應機制(見第 2.6 節的倫理提示)。研究計畫書裡請寫下能力的類別,不要寫某個產品名稱,計畫書才撐得過下一次廠商更替。
2.4 時間尺度的匹配與測量叢發
第 1 章提醒過,歷程有它的時間尺度,設計也有它的時間尺度,兩者不匹配可能製造出並不存在的表面趨勢,也就是圖 1.4 的疊頻(aliasing)問題。設計正是把那個提醒付諸實行的地方。取樣密度必須快到解析得了所關心的動態:一個在一天之內起伏的歷程,每天取樣一次還原不了,就像一段旋律無法從「每小節一個音」重建出來。但更快不等於更好:更密集的取樣會提高負擔與反應性,而對變動緩慢的構念來說,那是把力氣浪費在解析根本不存在的變異上。設計的任務是匹配,不是最大化。
測量叢發設計(measurement-burst design)解決的是一個真實的兩難:如何在同一項研究中,同時研究快速的個體內動態與緩慢的發展性變化。它的邏輯被 Nesselroade (1991) 用一個意象捕捉下來:發展是一塊織物,由緩慢變化的經線與快速波動的緯線織成。解法如圖 2.6所示,是把數段短期的密集取樣嵌進一個長期的追蹤研究。每一段叢發或許為期一週、每天數次提示,用來刻畫此人當前的動態與變異性;叢發以長間隔反覆施行,或許每年一次,動態本身的變化於是也能跨越發展階段被追蹤 (Sliwinski, 2008)。叢發設計獨有的估計標的因此不只是水準或趨勢,而是個體內變異性與動態的發展軌跡;這些量對稀疏的追蹤設計或單獨一段密集叢發都是看不見的。代價還是那個關於間隔依賴性的警告:延宕效果之類的動態估計量會隨觀察之間的間距而變,叢發之內的時程因此必須在各次叢發之間保持一致,否則就得改用第 27 章的連續時間方法,各次叢發才彼此可比。
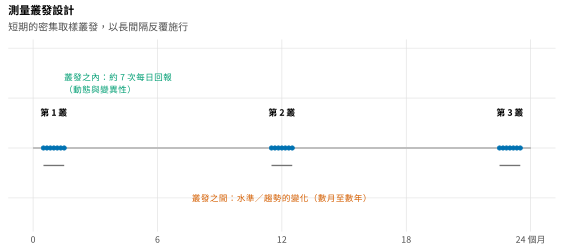
註:每一叢是一段彼此緊密相鄰的每日回報,各叢以長間隔重複出現。叢發之內的間距用來估計動態與變異性,叢發之間的間距則用來估計這些量如何跨越數月與數年而改變。
2.5 隨時間進行的介入研究設計
重複測量也是介入研究的骨幹,此時的設計問題是:處理與評量要如何在時間上安排,才能讓「對軌跡的因果效果」估計得出來。最熟悉的情形是帶有重複結果測量的隨機對照試驗(randomized controlled trial, RCT),本書的 therapy_rct 資料就是例子:病人隨機分派到各組,之後反覆評量,此處是在十二次每週回診中施測一份憂鬱量表,各組的軌跡(而不只是終點)於是可以互相比較(第 10 至 13 章)。這類試驗有兩個特徵本身就是設計問題,留待後文處理:一是各組退出程度不同,也就是差異性流失,這是 therapy_rct 刻意內建的(第 6 章);二是復發等事件的發生時機,需要第 29 章的存活分析(survival analysis)方法。階梯式楔形試驗(stepped-wedge trial)讓各群集(cluster)依隨機排定的先後順序從控制轉入介入;中斷時間序列(interrupted time series)則對單一單位在介入前後密集觀察(第 24 章)。兩者都把同樣的邏輯延伸到「同時隨機化並不可行」的情境。
另有一種較新的設計,專為行動裝置遞送的介入而發展,此時要問的不是某個處理平均而言有沒有效,而是某一則提示在某一個特定時刻送出去,對接下來的那些時刻有沒有幫助。微隨機化試驗(micro-randomized trial)如圖 2.7所示,隨機化的層次是決策時點而不是個人:研究期間眾多時刻中的每一個時刻,參與者都被隨機分派為收到或不收到一則介入提示,並在不久之後測量一個近端結果(proximal outcome) (Klasnja et al., 2015)。隨機化在每個人身上重複了數百次,這個設計因此估計得出當下介入那些隨時間變動、依情境而異的效果,而這正是建構及時調適性介入(just-in-time adaptive intervention, JITAI)所需要的:一種依當事人此刻的狀態決定遞送什麼、何時遞送的處理 (Nahum-Shani et al., 2018)。這類試驗的分析在第 33 章預告。
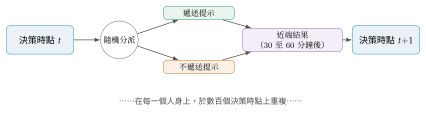
註:在每一個決策時點,參與者被隨機分派為收到或不收到一則介入提示,並在不久之後測量一個近端結果。同樣的程序在同一人身上重複進行,隨時間變動、依情境而異的當下效果因此估計得出來。
2.6 重複測量特有的效度威脅
反覆測量同一群人,會帶來單一時點研究從不面對的效度威脅,一份稱職的設計會預先設想這些威脅。第一個是反應性(reactivity):自我監測這個動作本身就可能改變被監測的行為,記錄自己的心情或抽菸量,就改變了心情或抽菸行為。既有證據顯示這類效果一般不大,但確實因領域而異,在受意志控制的行為上、以及在本來就想改變的參與者身上比較大;反應性因此應該評估,不能假設掉,做法例如比較前期與後期的回報,或錯開監測的起始時間。第二個是前面就認知結果變項提過的再測效果。第三個是高頻設計特有的題目順序與情境效果(item-order and context effects):在多次重複之下,題目的順序以及提示當下的情境都可能塑造回答,隨機化題目順序、把當下情境一併記錄下來,因此是合理的做法。第四個是持續負擔之下的隨意作答(careless responding),也就是疲乏的參與者不加注意地作答;偵測方式(作答時間、直線作答與內嵌檢核題)在第 5 章處理。表 2.4把這些威脅與設計上的對策配成對。
表 2.4 重複測量特有的效度威脅,以及設計上的對策。
| 威脅 | 它造成什麼 | 設計上的對策 |
|---|---|---|
| 反應性 | 監測改變了被監測的行為 | 比較前期與後期;錯開起始時間;設置只監測的基線期 |
| 再測/練習 | 反覆接觸使表現虛升 | 使用複本;拉開間隔;以第一次叢發吸收練習效果 |
| 追蹤制約 | 反覆被調查改變了態度 | 補充樣本;輪替題目;限制參與年限 |
| 題目順序/情境效果 | 回答取決於順序與所處情境 | 隨機化題目順序;記錄情境;保留固定的核心題 |
| 隨意作答 | 疲乏使資料品質下降 | 縮短提示;注意力檢核題;以作答時間篩檢(第 5 章) |
| 選擇性流失 | 退出與否取決於結果變項 | 追蹤聯繫;提高留存的誘因;為隨機遺漏/非隨機遺漏(MAR/MNAR)預作規劃(第 6 章) |
註:表中的對策都在設計端;分析端的對應做法(遺漏資料模型、隨意作答偵測)出現在所引的各章。
還有兩項威脅,關心的不是測量誤差,而是這項研究代表了誰、又因此承擔了什麼義務。選擇與可推論性(selection and generalizability)值得明確關注,因為密集設計招募到的是特定一類參與者:擁有合適裝置、忍受得了頻繁打斷、並且同意讓自己的生活被密集觀察的人。這種樣本得到的發現未必推論得到那些拒絕參與的人,設計上因此應該記錄涵蓋率與同意率,不要把已收案的樣本當成母體本身。最後,當下資料在倫理上的分量與偶爾一次的問卷完全不同:關於位置、行為與心情的密集記錄可能讓參與者被重新識別而暴露;當下評估敏感狀態,更帶著一份照護義務。
倫理提示 • 當下自殺風險的監測
關於自傷與自殺風險(自殺意念、計畫與行為)的研究,越來越多是在當下評估這些狀態,這帶出一個尖銳的設計問題:一位參與者獨自對著手機,回報自己此刻處於立即風險之中,接下來會發生什麼事?站得住腳的研究方案會事先把這件事決定好,不留到臨場。具體而言,這樣的方案會明訂:一道帶有已驗證切截分數的風險題目;切截被跨越時螢幕上立即出現的自動回應,提供危機協助資源,並在已取得同意的情況下提供一條與人聯繫的途徑;一份風險監控計畫,規定被標記的回應由合格的臨床專業人員依明訂的時程檢視,並把檢視的時間延遲向參與者揭露,讓任何人都不會誤以為這項研究是緊急服務;一套事先訂好、符合當地法規並經研究倫理審查委員會(IRB)核可的風險升級處置(escalation)與警告義務(duty to warn)程序;以及一份知情同意書,清楚說明回報風險之後「會發生什麼、不會發生什麼」。此處的設計原則是:一項會詢問風險的研究,就承擔了回應的責任,而這份責任必須在第一則提示送出之前就設計進方案裡。
常見陷阱 • 「取樣越快一定越好」
「資料越多只會有幫助」這個直覺,在密集設計上會以三種方式失效。第一是負擔:每多一次提示都會降低配合度,還可能把一項研究中訊息量最大的參與者,變成遺漏最多的參與者(圖 2.5)。第二是反應性:極為頻繁的提示本身就可能改變被研究的行為,測量於是扭曲了現象。第三,也最不明顯,是反向的疊頻:把一個緩慢的構念取樣得非常快,並不會讓它更清晰,只是把負擔花在解析雜訊上;把一個快速的構念取樣得太慢,也就是第 1 章那個典型的疊頻,則會徹底錯述它。目標不是可行範圍內的最高密度,而是與歷程時間尺度相配的密度,並盡可能以第 4 章那種以模擬為基礎的規劃加以確認。
2.7 選擇設計:三個實作決策
設計原則最好放在運作中看。以下三項研究各自從一個問題出發,最後落在一份站得住腳的規格上,摘要於表 2.5。第一項問的是每日壓力會不會擾亂當晚的睡眠,這是一個關於「在數小時到一天之內展開的歷程」的個體內問題。所關心的耦合以日為單位,所涉構念又是當下狀態而不是稀有事件,一份大約十四天的訊號取樣或間隔取樣每日日誌就很合適,內容是傍晚一次睡眠回報加上白天數次壓力提示;兩波資料解析不了這種每日耦合,逐秒的感測則遠遠超出所需。第二項問的是對壓力源的情緒反應性如何跨越青少年期而改變,這是一個關於「某個個體內動態的發展軌跡」的問題,也正是測量叢發設計存在的理由:一段為期一週的訊號取樣叢發,每年施行一次、貫穿青少年期,每一叢之內估計出來的反應性於是能跨叢被追蹤。第三項問的是哪些當下狀態能預測成癮治療結束後幾天內的破戒(lapse),事件稀有、邊界明確、臨床上又急迫,因此傾向採用混合方案:以訊號取樣為骨幹刻畫狀態,每次破戒時再加上事件取樣的回報,並由一個具備風險回應機制的平台遞送。這三個小案例會在第 4 章再次出現,屆時每一個都會被帶進正式的檢定力與精確度分析。
表 2.5 三份實作的設計規格。
| 壓力與睡眠 | 青少年情緒反應性 | 治療後破戒 | |
|---|---|---|---|
| 問題家族 | 個體內動態(以日為單位) | 動態本身的變化(發展性) | 動態+事件時機 |
| 設計 | 每日日誌 | 測量叢發 | 混合式 EMA |
| 取樣方案 | 訊號取樣+傍晚固定間隔 | 訊號取樣的叢發 | 訊號取樣+事件取樣 |
| 期程 | 14 天 | 為期一週的叢發,每年一次 | 出院後 21 天 |
| 每日提示 | 5 次+傍晚 1 次 | 叢發之內 6 次 | 5 次+事件觸發 |
| 主要威脅 | 自我監測的反應性 | 跨叢發的再測效果 | 流失;受傷害的風險 |
註:每一份規格都會在第 4 章發展成一份具備檢定力的研究方案。表中的提示次數是待模擬確認的起點。
要讓一份研究方案變得具體,圖 2.8展示本書 affect_ema 研究中兩個面向參與者的提示畫面。該研究的完整方案是十四天、每天六次的訊號取樣設計,作答時限十五分鐘,題目是一組簡短的當下題,涵蓋壓力、負向與正向情緒,以及社會情境。實際看到畫面是一種有用的紀律:題目的措辭、反應量尺、需要點按幾次,恰恰就是決定負擔與資料品質的那些設計細節,而方案只以文字存在時,這些細節很容易被忽略。
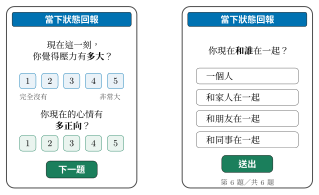
affect_ema 研究方案中面向參與者的提示畫面範例。註:這是示意稿,不是實際截圖。題目措辭、反應量尺的細緻程度,以及每次提示需要點按的次數,都直接決定受訪者負擔與資料品質。
2.8 在 R 中建立取樣時程
一份設計要成真,就得轉成一份具體的提示時程與一份具體的資料結構。本節同時展示這兩者,並且只用基本 R,讓邏輯保持透明。第一項任務是產生一份訊號取樣的時程:在每一個研究日,於清醒時段的數個等長區塊之內各抽一個隨機提示時刻,這正是圖 2.4與 affect_ema 研究方案背後的取樣方案。配套函式收在 Examples 的腳本裡,核心很短。
# 訊號取樣時程:每天 n_blocks 次隨機提示,在清醒時窗的每個等長區塊
# 之內各取一次,並要求最小間隔,避免兩次提示擠在一起。
make_schedule <- function(n_days = 14, n_blocks = 6,
                          wake = c(9, 22), min_gap = 0.75, seed = 1) {
  set.seed(seed)
  edges <- seq(wake[1], wake[2], length.out = n_blocks + 1)
  out <- data.frame()
  for (d in seq_len(n_days)) {
    repeat {
      times <- mapply(function(lo, hi) runif(1, lo, hi),
                      edges[-(n_blocks + 1)], edges[-1])
      if (all(diff(sort(times)) >= min_gap)) break   # 強制最小間隔
    }
    out <- rbind(out, data.frame(day = d, block = seq_len(n_blocks),
                                 prompt_hour = round(sort(times), 2)))
  }
  out
}

sched <- make_schedule(n_days = 14, n_blocks = 6, seed = 2026)
head(sched, 6)
nrow(sched)                       # 14 天共 84 次預定提示
第二項任務是在配適任何模型之前,先把一筆縱貫資料當成「設計物件」來看;就一項試驗而言,這是指檢查分組、評量時程,以及退出的樣態。以 therapy_rct 為例,先確認兩組的人數是否平衡、清點每週評量的次數,而對設計來說最重要的是列出每一週還有多少病人仍被觀察到:那條曲線的形狀就是這項研究的流失輪廓。
therapy_rct <- readRDS("Examples/data/therapy_rct.rds")

table(therapy_rct$arm[therapy_rct$week == 0])      # 實驗組與控制組各 120 人
length(unique(therapy_rct$week))                   # 12 次每週評量

# 流失輪廓:每一週仍被觀察到(hdrs 非遺漏)的人數
observed_by_week <- tapply(!is.na(therapy_rct$hdrs),
                           therapy_rct$week, sum)
round(observed_by_week / 240 * 100)                # 每週的留存百分比
執行之後會看到留存比例從基線的 100% 下降到最後一週的大約一半。這筆資料裡的退出被設定為依賴病人自身分數的惡化,因此它正是「流失作為機制」的具體實例:離開的病人不是隨機的一個子集,第 11 週被觀察到的樣本,比第 0 週被隨機分派的樣本更健康。這是一個必須在分析中正面處理的設計事實(第 6 章),而在設計階段就從留存曲線上看見它,正是本節想養成的習慣。
2.9 為縱貫設計撰寫方法段
一份縱貫設計的可信度,取決於它被報告得如何;如今審查密集設計與追蹤研究的審稿人,會期待一些橫斷研究的作者從來不必提供的具體細節。呼應第 1 章關於撰寫結果的建議,方法段也有一套簡短的紀律,圍繞四項承諾展開。第一,用圖 2.1的那兩個座標報告設計:明確寫出預定的時點數與其間距,例如「參與者在連續十四天內每天完成六次訊號取樣提示」,而不是「參與者完成了一項日誌研究」這種毫無訊息可言的寫法。第二,報告取樣方案及其參數:取樣依隨於什麼(間隔、訊號或事件)、一天如何切成區塊、作答時限、每次提示的題目數量預算,以及提醒與誘因的結構,讓另一個團隊重現得了這份方案。第三,報告實際測得的配合度,而不是原本預定的配合度:給出由時間戳記算出的達成配合率、它在參與者之間的分配,以及用來保留或排除低配合度個案的規則;如今沒有交代配合率,會被讀成警訊,而不只是禮貌上的疏漏。第四,報告流失及其處理方式:退出的人數與時間、任何比較完成者與未完成者的分析,以及預計採用的遺漏資料處理方法;正如本章一再強調的,威脅效度的是遺漏的機制,不是它的比率。
把這些承諾合在一起,針對 affect_ema 方案的一段示範文字可以這樣寫:「120 位成人完成了一項為期十四天的經驗取樣方案。行動應用程式採訊號取樣方案,在清醒時段(約上午 9 時至晚間 10 時)的六個等長區塊之內,各於隨機時刻遞送一次提示,每天共六次,每次的作答時限為十五分鐘。每次提示包含八道題目,測量當下的壓力、負向與正向情緒,以及社會情境。參與者完成一次簡短的訓練,並領取依配合程度遞增的報酬。由回應時間戳記算出的達成配合率為 73%(參與者之間的標準差見表 X);遺漏在高壓力提示之後較為頻繁,與隨機遺漏(missing at random, MAR)機制一致,並以完全訊息最大概似法(full-information maximum likelihood, FIML)處理(第 6 章)。」這一段的每一個子句都對應本章前面做過的某一項設計決定,而這正是重點:方法段就是一份好設計兌現為可信度的地方。
軟體提示 • 配套的設計工具
Examples 資料夾提供上面用到的排程函式 make_schedule(),以及本書各個與設計相關資料集的生成程式(均已設定隨機種子):圖 2.3加速世代範例所用的 school_growth,以及試驗範例所用的 therapy_rct,後者內建單調的隨機遺漏退出樣態,也內建供第 29 章存活分析使用的治療後復發時間。每一筆資料集都附有資料編碼簿,記錄它的設計與資料生成歷程,讓本章的設計概念不只讀得到,也能在資料中檢視。
2.10 常見的迷思
有四種看法反覆出現,也反覆造成誤導。第一,認為生態瞬時評估只是把日誌做得更頻繁而已:這忽略了取樣方案的邏輯,也忽略「以當下捕捉來對抗回憶偏誤」這個根本理由,把一項設計選擇當成單純的頻率旋鈕 (Shiffman et al., 2008)。第二,認為流失只有在比率超過某個門檻時才需要在意:如第 6 章所示,低比率但依賴結果變項的退出,可能比高比率的隨機退出造成更大的偏誤,主導偏誤的是機制,不是百分比。第三,認為加速設計什麼假設都不需要:它們用四年換到六年,唯一的憑藉就是假設年齡軌跡在重疊區間內不隨世代而異,而這個假設必須明白陳述並加以檢驗,不能默認。第四,也是實務上後果最嚴重的一項,是以為「我需要幾天、幾次提示?」這個問題有一個脫離脈絡的答案:所需的密度與期程取決於估計標的究竟是一個平均數、一個趨勢、一個變異數,還是一個延宕係數,最好由第 4 章那種以模擬為基礎的檢定力分析來決定,而不是靠經驗法則。
本章摘要
設計固定了分析後來還原得出什麼。每一項重複測量研究都座落在由時點數與其間距定義的空間裡(圖 2.1),而最初的兩組設計區分(趨勢對比追蹤、前瞻對比回溯)就決定了個體內的問題答不答得出來。發展研究的設計必須面對年齡、時期與世代的識別問題,那是一個算術上的糾結(式 2.1),任何只取單一切片的設計都解不開;加速設計能夠脫身,唯一憑藉的是一個可檢驗的「世代不變性」假設。密集設計依取樣方案(間隔、訊號或事件取樣)組織起來,並受負擔與配合度的權衡支配,「實測的配合度」與「誠實的流失報告」因此成為核心。測量叢發把快與慢兩種時間尺度結合起來,微隨機化試驗隨機化的是時刻而不是人。重複測量帶有自己的效度威脅,從反應性到選擇性流失;面對敏感的當下資料,還帶有一份必須設計進方案裡的照護義務。本章最後給出三個實作的設計決策、一個在 R 中建立時程的工具,以及一套報告縱貫設計的紀律。
接下來讀哪裡
接下來幾章跟著這些設計產生的資料走:第 3 章問一個被反覆測量的構念在每個時點上是否意謂同一件事;第 4 章把每一項設計決定轉成檢定力與精確度的量化問題,並延續本章的三個小案例;第 5 章處理這些方案產生的多重資料流該怎麼管理;第 6 章則面對流失與不完全配合留下的遺漏。第 1 章的線索在此延續:一份設計,就是一項承諾,承諾這項研究能談論誰的變異、以及在什麼時間尺度上談論。
習題
- 2.1 評論一份研究方案。取得一篇已發表的經驗取樣研究的方法段,依表 2.3的設計參數檢核表加以評估。哪些參數有報告、哪些沒有?讀者有哪些部分重現不了?
- 2.2 選擇一種取樣方案。你想研究大學生暴飲事件的前置因素。請訂出一種取樣方案,說明你在事件取樣與訊號取樣(或混合方案)之間如何權衡,並說明你會如何定義與偵測目標事件。
- 2.3 勾勒一份加速設計。在只有三年經費的條件下,設計一項涵蓋 10 歲到 18 歲的研究。請指定各世代及其重疊區間,依圖 2.3的樣式畫出涵蓋圖,並陳述你的設計必須倚賴的那個假設。
- 2.4 診斷混淆。閱讀本書提供的一份由橫斷資料主張年齡效果的摘要。請精確指出其中年齡、時期與世代的混淆,並描述支持該因果主張需要什麼樣的設計。
- 2.5 草擬一份倫理方案。為一項評估當下自殺意念的研究撰寫風險回應段落,依循第 2.6 節的倫理提示。請明訂切截分數、自動回應、檢視的時間延遲,以及風險升級處置的程序。
- 2.6 建立一份時程。使用
Examples腳本中的make_schedule(),產生一份每天 5 次提示、持續 10 天的訊號取樣時程,並依圖 2.4的樣式畫出提示時刻。請驗證沒有任何兩次提示落在你設定的最小間隔之內。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 設計空間 | design space | 由時點數與時點間隔定義的二維空間;第 2.1 節 |
| 時點 | occasion | 一次測量的時機;全書 |
| 重複橫斷/趨勢設計 | repeated cross-section / trend design | 每個時點調查一批新樣本,無個體內訊息;第 2.1 節 |
| 追蹤設計 | panel design | 跨時點追蹤同一批個體;第 2.1 節 |
| 前瞻/回溯 | prospective / retrospective | 當下記錄與事後回想;第 2.1 節 |
| 回憶偏誤 | recall bias | 回溯報告隨回想跨度加長而增大的系統性偏誤;第 2.1 節 |
| 年齡/時期/世代 | age-period-cohort (APC) | 三者線性相依,無法各自獨立識別;第 2.2 節 |
| 識別 | identification | 參數能否由資料唯一決定;第 2.2 節 |
| 世代序列設計 | cohort-sequential design | 多世代乘多時期的完整方格表;第 2.2 節 |
| 加速縱貫設計 | accelerated longitudinal design | 以重疊世代拼接出較寬的發展範圍;第 2.2 節 |
| 收斂設計 | convergence design | 加速縱貫設計的另一個名稱;第 2.2 節 |
| 流失 | attrition | 參與者隨時間退出研究;第 2.2 節 |
| 補充樣本 | refreshment sample | 長期追蹤中加入新參與者以取代流失者;第 2.2 節 |
| 再測效果 | retest effect | 反覆施測本身提升表現;第 2.2 節 |
| 複本 | parallel forms | 內容等值但題目不同的測驗版本;第 2.2 節 |
| 追蹤制約 | panel conditioning | 反覆被調查改變了受訪者的態度或行為;第 2.2 節 |
| 密集縱貫設計 | intensive longitudinal design | 每人時點數很多的設計族;第 2.3 節 |
| 每日日誌 | daily diary | 一天回報一次或數次;第 2.3 節 |
| 經驗取樣法 | experience-sampling method (ESM) | 在提示時刻回報當下狀態;第 2.3 節 |
| 生態瞬時評估 | ecological momentary assessment (EMA) | 同上,源於臨床與行為醫學傳統;第 2.3 節 |
| 隨身評估 | ambulatory assessment | 涵蓋自陳與生理、行為通道;第 2.3 節 |
| 活動記錄儀 | actigraphy | 以配戴裝置記錄身體活動與睡眠;第 2.3 節 |
| 被動感測 | passive sensing | 不需主動作答的感測器資料蒐集;第 2.3 節 |
| 數位表現型分析 | digital phenotyping | 以裝置資料刻畫行為表現型;第 2.3 節 |
| 取樣方案 | sampling scheme | 決定提示何時出現的規則;第 2.3 節 |
| 間隔取樣 | interval-contingent | 依固定時程提示;第 2.3 節 |
| 訊號取樣 | signal-contingent | 在等長區塊內的隨機時刻提示;第 2.3 節 |
| 事件取樣 | event-contingent | 由已定義的事件觸發回報;第 2.3 節 |
| 提示 | prompt | 一次要求作答的觸發;第 2.3 節 |
| 配合度 | compliance | 實際作答的提示佔預定提示的比例;第 2.3 節 |
| 受訪者負擔 | respondent burden | 參與所需付出的時間與注意力成本;第 2.3 節 |
| 作答時限 | response window | 提示送出後仍接受作答的時間長度;第 2.3 節 |
| 測量叢發設計 | measurement-burst design | 短期密集叢發嵌入長期追蹤;第 2.4 節 |
| 階梯式楔形試驗 | stepped-wedge trial | 各群集依隨機順序先後轉入介入;第 2.5 節 |
| 中斷時間序列 | interrupted time series | 對單一單位在介入前後密集觀察;第 2.5 節 |
| 微隨機化試驗 | micro-randomized trial (MRT) | 在決策時點層次重複隨機化;第 2.5 節 |
| 決策時點 | decision point | 可能遞送介入的時刻;第 2.5 節 |
| 近端結果 | proximal outcome | 介入後不久測量的短期結果;第 2.5 節 |
| 及時調適性介入 | just-in-time adaptive intervention (JITAI) | 依當事人當前狀態決定遞送內容與時機;第 2.5 節 |
| 反應性 | reactivity | 自我監測本身改變了被監測的行為;第 2.6 節 |
| 題目順序與情境效果 | item-order and context effects | 回答受題序與所處情境影響;第 2.6 節 |
| 隨意作答 | careless responding | 疲乏之下不加注意地作答;第 2.6 節 |
| 選擇性流失 | selective attrition | 退出與否取決於結果變項;第 2.6 節 |
| 可推論性 | generalizability | 研究發現能否延伸到未收案者;第 2.6 節 |
| 破戒 | lapse | 成癮行為的單次失守(復發為 relapse);第 2.7 節 |
參考文獻
Baltes, P. B. (1968). Longitudinal and cross-sectional sequences in the study of age and generation effects. Human Development, 11(3), 145–171.
Bolger, N., Davis, A., & Rafaeli, E. (2003). Diary methods: Capturing life as it is lived. Annual Review of Psychology, 54, 579–616. https://doi.org/10.1146/annurev.psych.54.101601.145030
Bolger, N., & Laurenceau, J.-P. (2013). Intensive longitudinal methods: An introduction to diary and experience sampling research. Guilford Press.
Csikszentmihalyi, M., & Larson, R. (1987). Validity and reliability of the Experience-Sampling Method. The Journal of Nervous and Mental Disease, 175(9), 526–536. https://doi.org/10.1097/00005053-198709000-00004
Harari, G. M., Lane, N. D., Wang, R., Crosier, B. S., Campbell, A. T., & Gosling, S. D. (2016). Using smartphones to collect behavioral data in psychological science: Opportunities, practical considerations, and challenges. Perspectives on Psychological Science, 11(6), 838–854. https://doi.org/10.1177/1745691616650285
Kirtley, O. J., Lafit, G., Achterhof, R., Hiekkaranta, A. P., & Myin-Germeys, I. (2021). Making the black box transparent: A template and tutorial for registration of studies using experience-sampling methods (ESM). Advances in Methods and Practices in Psychological Science, 4(1), 2515245920924686. https://doi.org/10.1177/2515245920924686
Klasnja, P., Hekler, E. B., Shiffman, S., Boruvka, A., Almirall, D., Tewari, A., & Murphy, S. A. (2015). Microrandomized trials: An experimental design for developing just-in-time adaptive interventions. Health Psychology, 34(Suppl.), 1220–1228. https://doi.org/10.1037/hea0000305
Mehl, M. R., & Conner, T. S. (Eds.). (2012). Handbook of research methods for studying daily life. Guilford Press.
Mohr, D. C., Zhang, M., & Schueller, S. M. (2017). Personal sensing: Understanding mental health using ubiquitous sensors and machine learning. Annual Review of Clinical Psychology, 13, 23–47. https://doi.org/10.1146/annurev-clinpsy-032816-044949
Myin-Germeys, I., & Kuppens, P. (Eds.). (2021). The open handbook of experience sampling methodology: A step-by-step guide to designing, conducting, and analyzing ESM studies (2nd ed.). Center for Research on Experience Sampling and Ambulatory Methods Leuven.
Nahum-Shani, I., Smith, S. N., Spring, B. J., Collins, L. M., Witkiewitz, K., Tewari, A., & Murphy, S. A. (2018). Just-in-time adaptive interventions (JITAIs) in mobile health: Key components and design principles for ongoing health behavior support. Annals of Behavioral Medicine, 52(6), 446–462. https://doi.org/10.1007/s12160-016-9830-8
Nesselroade, J. R. (1991). The warp and woof of the developmental fabric. In R. M. Downs, L. S. Liben, & D. S. Palermo (Eds.), Visions of aesthetics, the environment, and development: The legacy of Joachim F. Wohlwill (pp. 213–240). Lawrence Erlbaum Associates.
Schaie, K. W. (1965). A general model for the study of developmental problems. Psychological Bulletin, 64(2), 92–107.
Shiffman, S., Stone, A. A., & Hufford, M. R. (2008). Ecological momentary assessment. Annual Review of Clinical Psychology, 4, 1–32. https://doi.org/10.1146/annurev.clinpsy.3.022806.091415
Sliwinski, M. J. (2008). Measurement-burst designs for social health research. Social and Personality Psychology Compass, 2(1), 245–261. https://doi.org/10.1111/j.1751-9004.2007.00043.x
Stone, A. A., & Shiffman, S. (1994). Ecological momentary assessment (EMA) in behavioral medicine. Annals of Behavioral Medicine, 16(3), 199–202. https://doi.org/10.1093/abm/16.3.199
Stone, A. A., Shiffman, S., Schwartz, J. E., Broderick, J. E., & Hufford, M. R. (2002). Patient non-compliance with paper diaries. BMJ, 324(7347), 1193–1194. https://doi.org/10.1136/bmj.324.7347.1193
Trull, T. J., & Ebner-Priemer, U. (2013). Ambulatory assessment. Annual Review of Clinical Psychology, 9, 151–176. https://doi.org/10.1146/annurev-clinpsy-050212-185510
Wheeler, L., & Reis, H. T. (1991). Self-recording of everyday life events: Origins, types, and uses. Journal of Personality, 59(3), 339–354. https://doi.org/10.1111/j.1467-6494.1991.tb00252.x
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。