第 12 章
邊際模型與廣義估計方程
本章引進一個來自生物統計的傳統,它回答的是心理學常問、卻很少講清楚的問題:不是某一位特定的人結果會怎麼變,而是母體的平均結果會怎麼變。母體平均(population-average)與個體特定(subject-specific)是兩個不同的估計標的(estimand),這項區分就是本章的核心;對心理學常見的非線性結果變項而言,兩者不是同一個數字的兩種說法,而是兩個不同的量。承載母體平均估計標的最自然的工具是廣義估計方程(generalized estimating equations, GEE),它同時也是學習兩個現代縱貫分析反覆出現的觀念最乾淨的場合:把平均數的模型與依賴結構的模型分開處理的工作相關(working correlation)邏輯,以及用一項特定脆弱性換來有效推論的穩健三明治標準誤(robust sandwich standard error)。本章是從第三部的古典方法通往第四部混合模型的橋,也刻意與第 15 章的廣義線性混合模型(generalized linear mixed model)配成一對:後者正是它的個體特定對應項。
學習目標
讀完本章之後,你應該能夠:(1) 界定邊際(marginal)(即母體平均)與條件(conditional)(即個體特定)兩種估計標的,說明兩者何時一致、何時分歧,包括羅吉斯模型(logistic model)的衰減(attenuation)關係;(2) 以平均數模型(mean model)、連結函數(link)、變異數函數(variance function)與工作相關寫出一個廣義估計方程;(3) 說明工作相關即使設錯,係數估計值為什麼仍然一致(consistent);(4) 使用穩健三明治標準誤,並辨認它在小樣本下的脆弱性與對應的修正;(5) 選擇工作相關結構,並審慎使用模型選擇準則;(6) 認清未加權的廣義估計方程要求資料為完全隨機遺漏(missing completely at random),並會用逆機率加權(inverse-probability weighting)這帖解藥;(7) 依估計標的、資料與推論目的,在邊際取向與混合模型取向之間作選擇。
12.1 一條迴歸式裡藏著兩個問題
想像一個戒菸方案,以及兩個表面上一模一樣的問題。第一個問:整個母體都戒菸一個月,復發的風險會降低多少?第二個問:某一位吸菸者戒了菸,這個人的風險會降低多少?第一個是母體平均(population-average)或邊際(marginal)的問題,比較的是母體在不同狀態下的平均結果;第二個是個體特定(subject-specific)或條件(conditional)的問題,比較的是同一個人與自己的反事實(counterfactual)。連續結果變項用恆等連結(identity link)分析時,兩個問題的答案相同:取平均是線性運算,個體改變量的平均就等於平均數的改變量。二元結果變項用羅吉斯連結(logistic link)分析時則不然,差別出在幾何。圖 12.1 畫出一群個體羅吉斯曲線,每一條都很陡,彼此只差在隨機截距(random intercept),並把它們在母體上的平均一併畫出。平均曲線比任何一條個體曲線都平緩,因為把一群左右平移的 S 形曲線平均起來,只會得到一條較淺的 S 形;曲線越平緩,斜率就越小。母體平均的羅吉斯係數因此相對於個體特定的係數被衰減(attenuated)了。
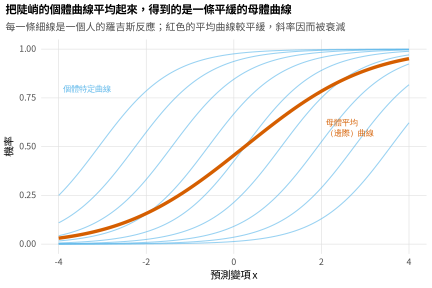
註:每一條細線是一個人的結果機率隨某個預測變項變化的羅吉斯曲線,各條之間只差在隨機截距。它們在母體上的平均是紅色的邊際曲線(marginal curve),比任何一條個體曲線都淺。母體平均斜率相對於個體特定斜率也就被衰減了;連結函數只要是非線性的,兩種估計標的就不相同。
衰減的幅度算得出來。隨機截距變異數為 \(\sigma_u^2\) 的羅吉斯模型,母體平均斜率大約等於個體特定斜率除以 \(\sqrt{1 + c^2\sigma_u^2}\),其中 \(c = 16\sqrt{3}/(15\pi) \approx 0.588\),來自以機率單位(probit)近似羅吉斯函數。圖 12.2 用模擬確認了這個關係:兩種模型都配適到隨機截距變異數已知的資料上,兩個斜率的比值緊貼著公式,並隨個體間變異數增大而穩定下降,從「所有人共用同一個截距」時的相等,一路降到個體間變異數很大時的大約一半。實務上的後果是:一個羅吉斯迴歸係數的意義取決於它出自哪一種模型,兩者不可以當成同一個量來比較或合併。表 12.1 把這項區分整理出來,而這一節真正要交付的是它與研究問題之間的對應:方案評估、流行病學與政策的問題關心母體會怎麼樣,要的是母體平均的估計標的;個體歷程與機制的問題關心一個人身上會怎麼樣,要的是個體特定的那一個。
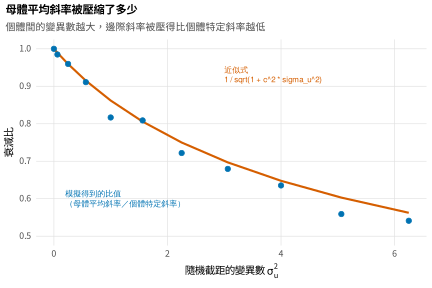
註:模擬得到的母體平均斜率與個體特定羅吉斯斜率比值(點),對隨機截距變異數作圖,並附上近似式 \(1/\sqrt{1 + c^2\sigma_u^2}\)(曲線)。個體間變異數越大,邊際斜率被壓得比個體特定斜率越低。兩者只有在完全沒有個體間變異數時才相等。
表 12.1 邊際與條件兩種估計標的。
| 面向 | 母體平均(邊際) | 個體特定(條件) |
|---|---|---|
| 問題 | 母體平均怎麼變? | 一個人怎麼變? |
| 模型 | GEE | 混合模型(GLMM) |
| 何時一致 | 恆等連結,或沒有個體間變異數 | |
| 何時分歧 | 非線性連結(例如羅吉斯):邊際斜率被衰減 | |
| 典型用途 | 方案評估、政策、流行病學 | 歷程、機制、個別差異 |
註:兩種估計標的沒有誰比較正確,它們回答的是不同的問題。真正的錯誤是配適其中一種、卻按另一種解讀;在羅吉斯模型裡,這就是把被衰減的母體平均係數讀成個體的效果。
12.2 廣義估計方程這套做法
一個廣義估計方程由三個彼此獨立的部件指定 (Liang & Zeger, 1986)。平均數模型(mean model)把平均結果的某個函數連到預測變項上,做法與一般的廣義線性模型(generalized linear model)完全相同:治療試驗的二元緩解(remission)結果,羅吉斯平均數模型就是把緩解的對數勝算(log-odds)寫成組別與週次的函數。變異數函數(variance function)說明結果變項的變異數如何隨平均數而變,同樣與廣義線性模型一致。工作相關(working correlation) \(R(\alpha)\) 描述重複測量之間的個體內依賴,這正是一般廣義線性模型缺的那個部件。圖 12.3 列出幾個標準選項:獨立(independence)完全不理個體內相關;可交換(exchangeable)假定任意兩個時點之間都是同一個相關;自我迴歸(autoregressive)讓相關隨時間間隔衰退;無結構(unstructured)把每一對相關都自由估計。這套方法最具定義性的性質在基礎概念方塊中推導:平均數模型的係數估計值即使工作相關設錯了仍然是一致的,因為平均數的估計方程不論假定什麼依賴結構都是不偏的。工作相關只影響效率(efficiency),不影響推論的有效性,這就是它叫「工作」相關的原因:它是提高精確度的裝置,不是結論倚賴的假設。治療試驗在實徵上也確認了這一點:不論假定獨立、可交換還是自我迴歸相關,組別與週次交互作用對緩解的效果在對數勝算量尺上都估在 \(0.14\) 附近,只有標準誤略有差異。表 12.2 依設計提供選擇指引。
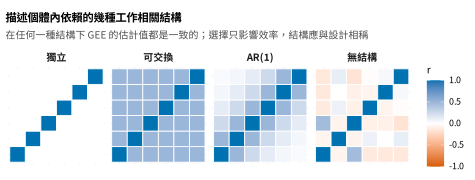
註:四種工作相關結構的熱圖(heatmap):獨立(沒有個體內相關)、可交換(共用單一個相關)、自我迴歸(隨時間間隔衰退)、無結構(每一對自由估計)。四種結構之下係數估計值都是一致的;選擇只影響效率,結構則應該與設計相稱。
基礎概念 • 估計方程與三明治變異數
一般的廣義線性模型靠求解分數方程(score equation) \(\sum_i D_i^\top V_i^{-1} (y_i - \mu_i) = 0\) 估計 \(\beta\):對第 \(i\) 個人而言,向量 \(y_i\) 收集這個人的重複結果,\(\mu_i\) 是模型化的平均數,\(D_i = \partial\mu_i/\partial\beta\),\(V_i\) 是共變數矩陣。廣義估計方程沿用同樣的形式,只是把 \(V_i\) 建構成 \(V_i = A_i^{1/2} R(\alpha) A_i^{1/2}\),由變異數函數 \(A_i\) 與工作相關 \(R(\alpha)\) 組成。只要平均數模型是對的就有 \(E[y_i - \mu_i] = 0\),這個估計方程的期望值為零,與 \(R(\alpha)\) 是不是真正的相關無關;工作相關即使被設錯,\(\hat\beta\) 仍然是一致的。代價是那個假定 \(V_i\) 正確的模型式變異數會跟著錯掉,推論改用三明治(sandwich)穩健估計式 \(\hat{\mathrm{Var}}(\hat\beta) = B^{-1} M B^{-1}\),其中 \(B = \sum_i D_i^\top V_i^{-1} D_i\) 是「麵包」,\(M = \sum_i D_i^\top V_i^{-1} \hat{e}_i \hat{e}_i^\top V_i^{-1} D_i\) 是由實徵殘差 \(\hat{e}_i = y_i - \hat\mu_i\) 建起來的「夾餡」。夾餡是拿資料去估計真正的殘差共變數:三明治之所以對設錯的工作相關穩健,理由在此;它之所以需要夠多群集(cluster)才能把那個共變數估好,理由也在此。
三明治估計式的穩健不是免費的,代價是一項小樣本脆弱性(small-sample fragility):夾餡是殘差乘積在各群集上的平均,群集數很少時,這個平均對真實變異數而言是很差的估計,還帶著向下的偏誤;標準誤太小,信賴區間太窄。圖 12.4 用一項涵蓋率模擬呈現後果:有一百個群集時,百分之九十五的區間涵蓋率幾乎達到名目水準;只有十個或十五個群集時,涵蓋率掉到百分之九十二。這種真實錯誤率的膨脹,讓許多已發表的小樣本廣義估計方程分析變得過度寬鬆。解藥是偏誤修正過的三明治估計式,它們調整殘差來移除向下的偏誤;實務上的建議很簡單:群集數低於大約四十到五十就套用一種修正 (Kauermann & Carroll, 2001; Mancl & DeRouen, 2001)。表 12.3 列出這些修正,以及各自何時必要。
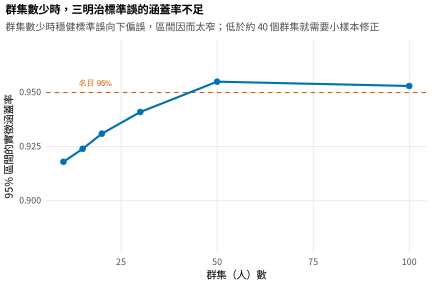
註:模擬中某個時間斜率的名目百分之九十五信賴區間,其實徵涵蓋率對群集數作圖。群集數少時穩健標準誤向下偏誤,區間涵蓋率也就低於名目水準;到大約五十個群集,落差已可忽略。低於大約四十個群集就需要小樣本修正。
表 12.2 依設計選擇工作相關結構。
| 結構 | 何時說得通 | 註記 |
|---|---|---|
| 獨立 | 只關心平均數;穩健性優先 | 一致;效率最低;三明治標準誤不可省 |
| 可交換 | 波次少、時間沒有自然順序 | 只有一個相關參數 |
| 自我迴歸 | 等間距波次、依賴隨時間衰退 | 與縱貫結構相稱 |
| 無結構 | 波次少、人數多 | 參數多;序列一長就不穩 |
註:任何一種結構之下係數估計值都是一致的,所以選擇考量的是效率,以及無結構到底可不可行(feasibility)。可交換對縱貫資料是很差的預設,因為縱貫資料的相關會隨時間衰退。
表 12.3 穩健標準誤的幾種修正。
| 估計式 | 做了什麼 | 何時必要 |
|---|---|---|
| 樸素三明治 | 實徵殘差共變數 | 群集多(\(> 40\)–\(50\)) |
| Mancl-DeRouen | 把殘差放大以移除偏誤 | 群集少 |
| Kauermann-Carroll | 另一種偏誤修正 | 群集少 |
| 群集穩健 CR2 | 偏誤縮減的群集穩健變異數 | 群集少;配小樣本 \(t\) 參照分配 |
註:這些修正對付的是同一個問題:群集少時樸素(naive)三明治低估變異數。群集夠多時各種修正都會收斂到樸素估計式,所以套用一種修正很少有害。
12.3 模型評估與選擇
廣義估計方程不是靠最大化概似(likelihood)配適出來的,那些熟悉的概似工具全都用不上。最接近的替代品是準概似訊息準則(quasi-likelihood information criterion, QIC) (Pan, 2001),它把 Akaike 訊息準則(Akaike information criterion, AIC)移植到準概似的情境,可以拿來比較工作相關結構,它的變形也可以比較平均數模型。這個準則必須審慎使用,絕不可奉為圭臬:它不是真正的概似,行為也不像它所模仿的 Akaike 準則那樣為人所理解,它是挑選工作相關的粗略指引,不是實質模型的裁判。沒有概似同時意味著沒有自然的決定係數(coefficient of determination)。誠實傳達一個廣義估計方程配適結果的方式,是報告模型在關心的量尺上所隱含的預測值,也就是母體平均的機率或平均數,而不是報告一個這套方法本來就給不出來的摘要統計量。
12.4 遺漏資料:這套方法的罩門
廣義估計方程帶著一項很容易被忽略的弱點,而且它和一個常見的誤解正好相反。這套方法不作完整的分配假設,不少人就以為它處理遺漏資料很優雅;實情剛好倒過來。未加權的估計方程只有在資料為完全隨機遺漏(missing completely at random)時才有效,這個要求遠比第 6 章那些概似方法所需的隨機遺漏(missing at random)嚴格。縱貫研究典型的退出是隨機遺漏式的,狀況較差的人比較可能離開;未加權的方法在這種情況下有偏誤,因為它取平均的對象,是留下來那個被選擇過的樣本。圖 12.5 是本章的招牌展示,一項真值已知的模擬:症狀隨時間下降,退出與否取決於前一次觀察到的值,病況較重的人於是先離開,留下來的人系統性地較健康。未加權的廣義估計方程跟著觀察到的存活者走,報告出來的平均軌跡遠低於真值,等於高估了改善。以完全訊息最大概似法(full-information maximum likelihood)估計的混合模型幾乎精確地還原了真實軌跡,因為概似在隨機遺漏之下仍然有效。留在邊際架構之內的解藥是逆機率加權(inverse-probability-weighted)的廣義估計方程 (Robins et al., 1995):把每一筆觀察到的紀錄,依「仍然留在研究中的估計機率」取倒數加權,容易退出的那類人權重放大,觀察到的樣本也就能代表完整的母體。圖 12.5 顯示這樣的加權修補了一部分偏誤,也只有一部分,理由很有啟發性:加權只用到邊際的觀察資料,丟掉了「一個已經離開的人,軌跡本來要往哪裡去」這種個體內訊息,而概似方法把這份訊息用滿了。這張展示一次交付兩個教訓:邊際方法在現實的遺漏機制之下很脆弱,而即使是它的解藥,表現仍然不如本書其餘部分所偏好的概似取向。
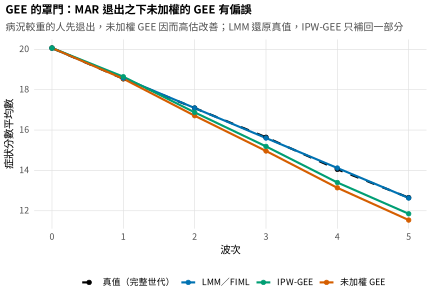
註:一項真值已知的模擬:症狀下降,病況較重的人先退出(隨機遺漏,取決於前一次觀察到的值)。未加權的廣義估計方程(橘)落在真實世代平均數(虛線)之下,高估了改善;以最大概似估計的混合模型(藍)還原了真值;逆機率加權的估計方程(綠)只修補了一部分偏誤,因為它丟掉了概似方法所用的個體內訊息。
12.5 廣義估計方程的實作
主要的實作範例,是把治療試驗中母體平均的緩解機率配適成組別與週次的函數。模型報告的是各組平均緩解率怎麼演變,圖 12.6 把模型所隱含的母體平均機率畫了出來:兩組都改善,實驗組的緩解機率上升得比較快,組別與週次的交互作用就是母體平均的治療效果。這正是方案評估要的那個量,也就是母體比率的改變。它以機率報告而不以對數勝算係數報告,是因為母體平均機率可以直接讀,被衰減的係數則會誘發上面警告過的那種個體特定式誤讀。第二個例子是把經驗取樣資料中的日層次二元結果對個體內預測變項建模,它標出這套取向誠實的界線:關心的若真的是個體內歷程,例如一個人在比自己平常更有壓力的日子裡是不是更可能出現某種行為,母體平均的估計標的回答的就是一個微妙地不同的問題,第 15 章與第 23 章的個體特定混合模型才是比較好的工具。表 12.4 是報告檢核表。
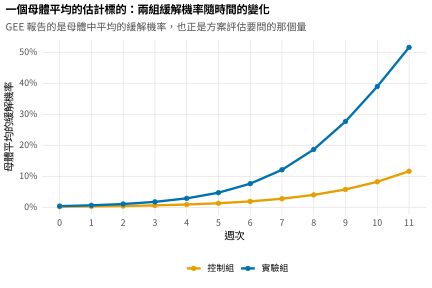
註:治療試驗中兩組跨週次的母體平均緩解機率,由一個羅吉斯廣義估計方程得到。兩組都改善,實驗組改善得比較快;組別與週次的交互作用就是母體平均的治療效果,也就是方案評估要問的那個量。
表 12.4 廣義估計方程的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 估計標的 | 明確寫出估計標的是母體平均 |
| 模型 | 平均數模型與連結函數;變異數函數;工作相關 |
| 標準誤 | 穩健(三明治);用了哪一種小樣本修正(small-sample correction)(若有),以及群集數 |
| 遺漏 | 完全隨機遺漏的假設,或用來放寬它的加權方式 |
| 解讀 | 在關心的量尺上(機率或平均數)呈現效果,而不是原始係數 |
註:最重要的是第一列:把估計標的點名為母體平均,可以防止讀者把被衰減的羅吉斯係數誤讀成個體特定(subject-specific)的效果。
12.6 在邊際模型與混合模型之間選擇
在廣義估計方程與混合模型之間作選擇,不是統計品味的問題,而是估計標的與假設的問題;圖 12.7 把這個決策攤開來。第一個也最主導的問題是研究要哪一種估計標的:要母體平均的答案就指向邊際模型,要個體特定的答案就指向混合模型;線性結果變項的兩種估計標的一致,用哪一個都行。第二個問題是遺漏機制:常見的隨機遺漏,以概似為基礎的混合模型可以有效處理,邊際模型則需要加權。第三個問題是分析必須交付什麼:隨機效果變異數(random-effect variance)只有混合模型估得出來,那是改變上的個別差異,往往正是實質上關心的量;邊際模型沒有這一項,既是一種簡化,也是一項真實的損失。剩下的考量是群集數與計算上的穩健性:群集很少、混合模型的隨機效果結構難以估計時,天平偏向邊際模型。表 12.5 摘要這項比較。兩種方法是協調的,不是對立的:第 15 章的廣義線性混合模型就是這裡所發展的邊際模型的個體特定對應項,第 12.1 節的衰減關係正是兩組係數之間的那座橋。
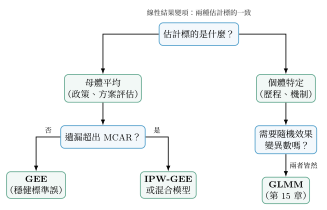
註:估計標的主導這項選擇:母體平均的問題指向廣義估計方程,個體特定的問題指向廣義線性混合模型。遺漏機制一旦超出完全隨機遺漏,就需要加權或改用概似方法;需要隨機效果變異數則非混合模型不可。線性結果變項的兩種估計標的一致。
表 12.5 廣義估計方程與混合模型的比較。
| 面向 | GEE(邊際) | 混合模型(條件) |
|---|---|---|
| 估計標的 | 母體平均 | 個體特定 |
| 遺漏資料的有效假設 | MCAR;加權後放寬到 MAR | MAR(靠概似) |
| 隨機效果變異數 | 不估計 | 會估計 |
| 依賴結構 | 工作相關(干擾項) | 由隨機效果模型化 |
| 群集少時 | 穩健;標準誤需修正 | 隨機效果變異數難估 |
| 非線性連結的係數 | 被衰減(邊際) | 較大(條件) |
註:兩種方法回答不同的問題,也在不同的遺漏假設之下才有效。選擇由估計標的與遺漏機制決定,不是由對某個統計傳統的偏好決定。
12.7 在 R 中執行廣義估計方程
geepack 套件可以配適廣義估計方程:群集識別碼由 id 引數傳入,工作相關由 corstr 指定,穩健標準誤是預設。母體平均的緩解模型,以及跨工作相關的比較,都只要幾行。
library(geepack); library(dplyr)
rct <- readRDS("Examples/data/therapy_rct.rds") |>
  mutate(arm = factor(arm, levels = c("Control","Treatment")),
         remit = as.integer(hdrs <= 7)) |>
  filter(!is.na(hdrs)) |> arrange(patient_id, week)

# --- 母體平均的羅吉斯模型;穩健標準誤是預設 ---
fit <- geeglm(remit ~ week * arm, id = patient_id, data = rct,
              family = binomial, corstr = "exchangeable")
summary(fit)                                   # week:armTreatment 就是母體平均效果

# --- 係數在各種工作相關之下都一致 ---
sapply(c("independence","exchangeable","ar1"), function(cs)
  coef(geeglm(remit ~ week * arm, id = patient_id, data = rct,
              family = binomial, corstr = cs))["week:armTreatment"])
邊際圖所用的母體平均機率,來自對已配適模型呼叫 predict;逆機率加權的分析則是把權重傳給同一個配適函式。完整的程式碼都在隨附的腳本 ch12_analysis_V01.R 裡,包括衰減與涵蓋率兩項模擬,以及帶累積退出權重的隨機遺漏脆弱性展示。圖形由中文版的 ch12_figures_zh_V01.R 繪出。
# --- 依組別與週次的母體平均預測機率 ---
newd <- expand.grid(week = 0:11, arm = factor(c("Control","Treatment")))
newd$p <- predict(fit, newdata = newd, type = "response")

# --- 逆機率加權:把 MCAR 放寬到 MAR ---
# 權重 w = 1 /(仍留在研究中的累積機率),由一個退出模型算出;
# 傳給 geeglm,並使用獨立的工作相關
gee_ipw <- geeglm(y ~ factor(t), id = id, data = observed, weights = w,
                  corstr = "independence")
軟體提示 • 該用哪一個 GEE 套件,以及與其他軟體對讀
R 裡有三個套件可以配適廣義估計方程,彼此的差異細微但真實。本章使用的 geepack (Halekoh et al., 2006) 提供乾淨的公式介面、數種工作相關,以及一個可對巢套平均數模型作 Wald 檢定的 anova 方法,建議當成預設。較老的 gee 套件把樸素與穩健標準誤並列報告,教學上很好用,介面則較舊。geeM 套件為大型資料的速度而寫。小樣本的三明治修正可經由 geesmv 與群集穩健的 clubSandwich 取得,後者提供偏誤縮減的 CR2 估計式,並附小樣本 \(t\) 參照分配。要與其他環境對讀的讀者,可以在 Stata 的 xtgee,以及 SAS 的 PROC GENMOD 加 REPEATED 敘述裡找到同樣的模型;估計標的與穩健標準誤在這些環境中都相同。
12.8 解讀與報告結果
廣義估計方程的結果,報告時要點名估計標的、描述三個模型部件,並在關心的量尺上解讀效果。這項治療試驗的示範段落可以這樣寫:「母體平均的緩解機率以一個羅吉斯廣義估計方程模型化,採可交換的工作相關與穩健標準誤,並以病人作為群集(\(N = 240\))。組別與週次的交互作用,也就是母體平均的治療效果,在對數勝算量尺上為正(\(\hat\beta = 0.13\),穩健 \(SE = 0.09\));模型所隱含的母體平均緩解機率在實驗組上升較快,到第 11 週時達到較高的比率(圖 12.6)。獨立、可交換與自我迴歸三種工作相關之下估計值幾乎沒有變動,這與係數的一致性相符。由於退出比較可能是隨機遺漏而不是完全隨機遺漏,主要的推論倚賴第 13 章的混合模型,廣義估計方程則作為母體平均的互補結果報告。」估計標的點名了,穩健標準誤與工作相關寫出來了,遺漏的但書也很誠實。
常見陷阱 • 廣義估計方程的三個錯誤
12.9 常見的迷思
關於廣義估計方程,有幾種說法會誤導讀者。第一種是廣義估計方程不過是用另一套軟體配適的混合模型:兩者回答的是不同的問題,一個邊際、一個條件,對非線性連結而言那是不同的量,兩者也在不同的遺漏假設之下才有效。第二種是穩健標準誤可以救所有的問題:三明治估計式保護的是工作相關被設錯(misspecified),不是平均數模型被設錯,而且它自己在群集少時也很脆弱。第三種是可交換相關對縱貫資料是安全的預設:縱貫的相關會隨時間衰退(decay),自我迴歸結構通常更說得通,儘管這個選擇只影響效率。第四種的後果最嚴重:這套方法不作分配假設,所以處理遺漏資料很好。實情剛好倒過來,未加權的方法需要完全隨機遺漏這個很強的條件,而在概似方法可以妥善處理的隨機遺漏退出之下,它是有偏誤的。還有一個反覆被問到的問題:審稿人為什麼會要求用某一種方法?答案要回到估計標的:把研究關心的那個量點名出來,方法自然就跟著定了。
本章摘要
一條迴歸式可以回答兩個不同的問題,母體平均的與個體特定的,而對非線性連結而言兩者分歧:邊際的羅吉斯斜率相對於條件(conditional)的斜率被衰減(attenuated),幅度隨個體間變異數增大(圖 12.1、12.2)。廣義估計方程以一個平均數模型、一個變異數函數與一個工作相關瞄準母體平均的估計標的,它最具定義性的性質是:工作相關即使設錯了,係數估計值仍然是一致的(圖 12.3),所以工作結構影響的是效率(efficiency),不是推論的有效性(validity)。推論使用穩健三明治標準誤(robust sandwich standard error),它在群集(cluster)數少時很脆弱,不作小樣本修正的話,低於大約四十個群集就涵蓋率不足(圖 12.4)。這套方法最主要的弱點是遺漏資料:未加權的估計方程需要完全隨機遺漏,而在概似方法能有效處理的隨機遺漏退出之下它有偏誤,這項脆弱性逆機率加權(inverse-probability weighting)也只能修補一部分(圖 12.5)。母體平均效果應在關心的量尺上以機率或平均數報告(圖 12.6)。在邊際取向與混合模型取向之間怎麼選,由估計標的與遺漏機制決定,不是由品味決定(圖 12.7);第 15 章的廣義線性混合模型就是本章所發展的方法的個體特定對應項。
接下來讀哪裡
邊際模型是走出古典方法的兩條路之一,另一條是混合模型,由第四部整個展開。第 13 章引進線性混合模型,它的隨機截距與隨機斜率(random slope)把邊際模型略去的個別差異還原回來,概似估計在隨機遺漏之下也有效;這裡學到的穩健標準誤會在那裡以群集推論的選項再次出現。第 15 章補齊本章開啟的那一對,把廣義線性混合模型發展成邊際模型的個體特定對應項,屆時第 12.1 節的衰減關係就成為兩組係數之間明確的翻譯。逆機率加權的邏輯會在第 29 章的存活模型中回來。「先點名估計標的」這項紀律,則會在任何需要把因果或描述目標講精確的地方反覆出現,其中最尖銳的是第 21 章的交叉延宕追蹤模型爭論。要帶走的教訓是:問題選定估計標的,估計標的選定模型,再多的穩健性都替代不了把問題問對。
習題
- 12.1 驗證衰減。模擬隨機截距變異數已知的個體特定羅吉斯資料,同時配適一個廣義線性混合模型與一個廣義估計方程,確認兩者斜率的比值符合衰減公式。
- 12.2 工作相關。在獨立、可交換與自我迴歸三種工作相關之下重配緩解的例子,報告係數與它的穩健標準誤各有什麼變化,並解釋係數為什麼那麼穩定。
- 12.3 把脆弱性造出來。在一個模擬資料集上建構一個隨機遺漏的退出機制,對照混合模型顯示未加權廣義估計方程的偏誤,再用逆機率加權把它修補回來。
- 12.4 小群集的涵蓋率。模擬一項有十五個群集的研究,估計樸素與偏誤修正三明治標準誤的實徵涵蓋率。
- 12.5 估計標的短論。針對三個研究情境,判斷要的是母體平均還是個體特定的估計標的,並以一小段文字為每一個選擇辯護。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 母體平均 | population-average (marginal) | 母體的平均結果如何改變;第 12.1 節 |
| 個體特定 | subject-specific (conditional) | 一個人的結果如何改變;第 12.1 節 |
| 衰減 | attenuation | 非線性連結下邊際斜率被壓低的現象;第 12.1 節 |
| 廣義估計方程 | generalized estimating equations (GEE) | 瞄準母體平均估計標的的邊際方法;第 12.2 節 |
| 平均數模型 | mean model | 把平均結果的函數連到預測變項;第 12.2 節 |
| 變異數函數 | variance function | 變異數如何隨平均數而變;第 12.2 節 |
| 工作相關 | working correlation | 假定的個體內依賴結構;設錯仍不影響一致性;第 12.2 節 |
| 可交換 | exchangeable | 任意兩個時點同一個相關;第 12.2 節 |
| 無結構 | unstructured | 每一對相關自由估計;第 12.2 節 |
| 一致性 | consistency | 樣本增大時估計值收斂到真值;第 12.2 節 |
| 三明治估計式 | sandwich (robust) estimator | 由實徵殘差建起來的穩健變異數;第 12.2 節 |
| 小樣本脆弱性 | small-sample fragility | 群集少時三明治標準誤向下偏誤;第 12.2 節 |
| 準概似訊息準則 | quasi-likelihood information criterion (QIC) | 挑選工作相關的粗略指引;第 12.3 節 |
| 逆機率加權 | inverse-probability weighting (IPW) | 以留存機率的倒數加權以放寬 MCAR;第 12.4 節 |
參考文獻
Fitzmaurice, G. M., Laird, N. M., & Ware, J. H. (2011). Applied longitudinal analysis (2nd ed.). Wiley.
Gardiner, J. C., Luo, Z., & Roman, L. A. (2009). Fixed effects, random effects and GEE: What are the differences?. Statistics in Medicine, 28(2), 221–239. https://doi.org/10.1002/sim.3478
Halekoh, U., Højsgaard, S., & Yan, J. (2006). The R package geepack for generalized estimating equations. Journal of Statistical Software, 15(2), 1–11. https://doi.org/10.18637/jss.v015.i02
Hardin, J. W., & Hilbe, J. M. (2013). Generalized estimating equations (2nd ed.). Chapman and Hall/CRC.
Hubbard, A. E., Ahern, J., Fleischer, N. L., Van der Laan, M., Lippman, S. A., Jewell, N., Bruckner, T., & Satariano, W. A. (2010). To GEE or not to GEE: Comparing population average and mixed models for estimating the associations between neighborhood risk factors and health. Epidemiology, 21(4), 467–474. https://doi.org/10.1097/EDE.0b013e3181caeb90
Kauermann, G., & Carroll, R. J. (2001). A note on the efficiency of sandwich covariance matrix estimation. Journal of the American Statistical Association, 96(456), 1387–1396. https://doi.org/10.1198/016214501753382309
Liang, K.-Y., & Zeger, S. L. (1986). Longitudinal data analysis using generalized linear models. Biometrika, 73(1), 13–22. https://doi.org/10.1093/biomet/73.1.13
Mancl, L. A., & DeRouen, T. A. (2001). A covariance estimator for GEE with improved small-sample properties. Biometrics, 57(1), 126–134. https://doi.org/10.1111/j.0006-341X.2001.00126.x
McNeish, D., Stapleton, L. M., & Silverman, R. D. (2017). On the unnecessary ubiquity of hierarchical linear modeling. Psychological Methods, 22(1), 114–140. https://doi.org/10.1037/met0000078
Pan, W. (2001). Akaike’s information criterion in generalized estimating equations. Biometrics, 57(1), 120–125. https://doi.org/10.1111/j.0006-341X.2001.00120.x
Robins, J. M., Rotnitzky, A., & Zhao, L. P. (1995). Analysis of semiparametric regression models for repeated outcomes in the presence of missing data. Journal of the American Statistical Association, 90(429), 106–121. https://doi.org/10.1080/01621459.1995.10476493
Zeger, S. L., & Liang, K.-Y. (1986). Longitudinal data analysis for discrete and continuous outcomes. Biometrics, 42(1), 121–130. https://doi.org/10.2307/2531248
Zeger, S. L., Liang, K.-Y., & Albert, P. S. (1988). Models for longitudinal data: A generalized estimating equation approach. Biometrics, 44(4), 1049–1060. https://doi.org/10.2307/2531734
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。