第 34 章
發展與教育心理學的應用
縱貫方法學誕生於發展研究,而整個領域最難的測量問題至今仍留在那裡。一個孩子三年級測一次、八年級再測一次,這中間的改變要讀在一把量尺(scale)上,而那把尺得先建構出來,任何變化才讀得出來。這個孩子同時在變老、在年級(grade)上往前走,也屬於某一個出生世代(birth cohort),那個世代碰上的世界與下一個世代不同;再加上一間間會在紀錄上留下自己印記的教室與學校。本章是應用篇的第二章,把三個發展與教育的問題從頭做到尾,主軸只有一句:在這個領域裡,測量的決定先於建模的決定,也限制住建模的決定,不是反過來跟在後面。第一個個案研究追蹤跨年級的學業成就(achievement),並做了一件正式論文裡罕見的事:把同一份資料從原始的多波合併(merge)一路帶到時間計量(time metric)的裁決、測量恆等性(measurement invariance)的示範、對廠商垂直量尺(vertical scale)的盤問、帶著機構巢套(institutional nesting)的成長模型(growth model),以及加速設計(accelerated design)所要求的世代收斂(cohort convergence)檢定,最後落到政策的轉譯。每一步都攤開同一件事:測驗出版商作的一個量尺化(scaling)選擇,就足以翻轉「差距是不是在擴大」的結論。第二個個案研究做發展連鎖(developmental cascade),守住已發表文獻常忘記的那份估計標的(estimand)紀律,把穩定的特質(trait)與個體內的交易(within-person transaction)分開,而傳統的交叉延宕追蹤模型(cross-lagged panel model)正是把這兩者默默混在一起。第三個轉向認知老化(cognitive aging),用的是以快時間尺度取樣一個慢歷程的測量叢發設計(measurement-burst design),檢驗老化文獻的招牌假設:個體內變異性(within-person variability)在平均數下降之前就先上升;檢驗時也帶著短序列與選擇性流失(selective attrition)所要求的那份清醒。貫串全章的教訓是 Wohlwill 的那一句:描述變化不等於解釋發展,而兩者之間的距離,正是本章要讓人看見的那片空間。
學習目標
讀完本章之後,你應該能夠:(1) 依估計標的來選一個發展的時間計量(time metric),也就是年齡、年級、波次或某個成熟歷程的時鐘,並為那個選擇辯護;(2) 分析一個加速的世代序列(cohort-sequential)設計,並檢定它的收斂假設,而不是預設;(3) 把機構巢套整合進成長模型,包括兒童轉學所造成的交叉分類(cross-classification);(4) 以消費者的深度盤問一把垂直量尺,認清一項成長結論取決於尺的程度,不亞於取決於孩子;(5) 先把個體間(between-person)與個體內(within-person)成分分開,再估計發展連鎖,不落進交叉延宕追蹤模型的積習;(6) 分析測量叢發資料裡變異性的改變與動態(dynamics)的改變,不只是水準(level)的改變;以及 (7) 報告發展與教育的發現時把假設說出來,包括「學習月數(months of learning)」這類轉譯背後的假設。
34.1 發展與教育的地形
發展與學校教育的問題落在少數幾個家族裡,而分析的第一個動作就是說出手上這一題屬於哪一個家族,因為那同時決定了估計標的,也決定了供應工具的是哪一章。一項能力平均而言會不會改變、循什麼形狀改變,是常態變化(normative change)的問題,由第 13 與 14 章的成長曲線模型(growth-curve model)回答。兒童在變化上會不會彼此不同、什麼預測了那份不同,是變化的個別差異(individual differences in change)的問題,答案讀在同一批模型的人層次隨機效果(random effect)上。一個發展中的系統會不會帶動另一個,例如閱讀拉起後來的數學、投入拉起後來的成就,是交易性(transactional)或連鎖的問題,由第 20 與 21 章的追蹤模型家族回答。教室、教師或學校會不會留下印記,是機構效果(institutional effect)的問題,由第 13 與 14 章的多層次模型(multilevel model)延伸到教育必然帶來的那份巢套來回答。波動本身會不會就是現象,例如預告認知衰退的表現不一致(performance inconsistency),是「變異性即構念(variability as construct)」的問題,由第 7、16 與 25 章的密集縱貫(intensive longitudinal)與動態工具回答。圖 34.1 畫出這份對應,表 34.1 則連同估計標的與代表文獻一起列出來。
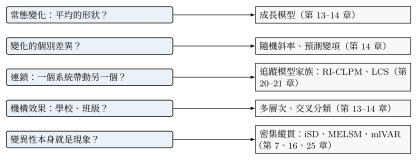
註:每一個問題家族都通往本書中回答它的那一部分,估計標的優先。一項發展研究往往同時問好幾個,而分析的手藝在於把對應的分析排序,讓每一步為下一步提供依據,那正是本章三個個案研究要示範的。
表 34.1 問題分類、估計標的、章次與領域代表文獻。
| 問題家族 | 估計標的 | 章次 | 代表文獻 |
|---|---|---|---|
| 常態變化 | 平均軌跡的形狀 | 13–14 | McArdle and Epstein (1987) |
| 個別差異 | 變化的變異數;預測變項 | 14 | Duncan and Duncan (2009) |
| 連鎖 | 個體內的交叉延宕 | 20–21 | Masten and Cicchetti (2010) |
| 機構效果 | 第二/三層的變異數 | 13–14 | Raudenbush and Bryk (2002) |
| 變異性即構念 | 個體內標準差的改變 | 7、16、25 | Ram and Gerstorf (2009) |
註:估計標的這一欄就是紀律。同一份發展資料常常同時支撐好幾個標的,分析者的工作是在選模型之前先說出當下在追哪一個,因為同一份資料換一套設定就回答不同的問題。
這一切背後坐著這個領域的招牌困難:被測量的東西不會在測量的過程中停著不動。一個構念(construct)可以還是同一個構念,行為表現卻跨發展改變,那就是第 3 章的異型連續性(heterotypic continuity):恐懼在學步兒身上是分離焦慮(separation distress),在青少年身上是社交迴避(social avoidance),單一組指標(indicator)服務不了兩者。就算表現穩定,分數所依附的那把量尺也得先證明在每個年齡上意義相同,年齡之間的差異才讀得成變化,而不是測量漂移(measurement drift);那是第 18 章的恆等性問題換到發展的範圍上。成就測驗尤其如此。學區(school district)(在美國是持有學生紀錄的地方教育主管機關,與臺灣的就學分發區不同)交到分析者手上的分數,抵達時已經轉換到一把垂直量尺上,而那把尺的建構裡嵌著分析者沒有作過、也往往看不見的假設。本章要花很多篇幅處理這件事,因為那是測量與建模相撞、後果最大的地方。三個時鐘讓困難疊加:一般的設計裡,一個孩子的年齡、年級與出生世代是一起往前走的,只有刻意打破它們共線性(collinearity)的設計才分得開,那是第 2 章的年齡/時期/世代(age-period-cohort)難題穿上發展的衣服。還多一層微妙:學校資料裡,入學的切分日期就是一條迴歸不連續(regression-discontinuity)的界線,細心的分析者用得上。
資料本身也帶著自己的現實。發展研究裡的同意(consent)是一條鏈,不是一次事件:家長同意要重新取得,兒童本人的允諾(assent)(與家長的同意有別)隨著孩子成熟再加上去。流失也絕不隨機,離開研究的家庭與留下來的家庭有系統性的差異。學校紀錄必須跨年串接,還要跨過那些本來就不是為了串接而建的行政系統,而孩子會轉學,於是「學生巢套在一所學校之內」那份整齊,讓位給「學生與前後就讀的幾所學校交叉分類」。大規模評量,例如全國性的縱貫研究,以稀疏的測量時點換來代表性(representativeness)與垂直量尺;實驗室的縱貫研究,則以小而選擇性的樣本換來密集、刻畫清楚的測量。這組設計取捨在抽象層次上解不開,只有對著一個具體的估計標的才解得開。圖 34.2 把三個時鐘的問題畫成具體的樣子,同一批模擬的成就紀錄分別放在波次、年級與年齡三個橫軸上,讓眼睛看見時鐘選得不同,世代的對齊會差多少。
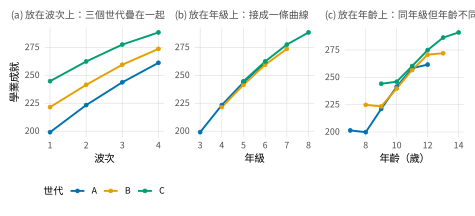
註:achieve_accel 加速設計(三個世代分別由三、四、五年級進入)的世代平均數。(a) 放在波次軸上:三個世代是三條平行的曲線,合起來涵蓋的年級跨距看不出來。(b) 放在年級軸上:重疊的段落接成一條橫跨三到八年級的加速成長曲線,那正是這個設計要換來的對齊。(c) 放在年齡軸上:同年級但不同年齡的孩子被攤開,各段不再重合,因為這份資料裡的成長由學校教育驅動,不由年齡驅動。這張圖就是「依估計標的選時鐘」的論證本身。
34.2 個案研究 A:跨年級的學業成就成長
第一個個案研究拿一份加速的、巢套在學校之下的成就資料,走完整條「測量到政策」的鏈條。這個領域的招牌決定都作在那條鏈上,而看著它們依序被作出,比孤立地處理其中任何一個都有價值。資料是模擬的 achieve_accel 紀錄:\(30\) 所學校裡的 \(1{,}200\) 名兒童,在四個年度波次上受測,分屬三個重疊的年級世代,合起來涵蓋三到八年級。這份資料帶著一個在潛在能力(latent ability)量尺上已知的減速成長歷程、植入的社經地位(socioeconomic status)對水準與成長率兩者的效果、讓年齡與年級脫鉤的入學年齡變異,以及一部分在波次之間轉學的兒童。真相由建構而已知,下面每一個估計值都對照得到它稽核(audit),這正是模擬範例的教學目的,也是這裡把數字報到真實資料不會允許的精度的理由。
34.2.1 裁決時間計量
第一個實質決定是要建模哪一個時鐘。這是估計標的的決定,不是模型配適(model fit)的決定。問題若關乎學校教育的效果,年級是自然的量尺,因為年級標示的是教學(instruction)的暴露(exposure);問題若關乎成熟(maturation),年齡才是自然的量尺。兩者分歧多少,恰恰等於同年級兒童在年齡上差多少,而那份年齡差來自延後入學(delayed entry)、為求年齡優勢而刻意延後一年入學(redshirting)與留級(retention)。把同一個減速成長模型配適到年級量尺上的成就分數,還原出三年級每年級 \(25.1\) 個分數點的增益,對照植入的真值 \(25\),而二次項(quadratic term)是 \(-1.53\),重現了那份減速。配適在年齡量尺上,線性增益衰減到每年 \(23.7\) 點,更能說明問題的是估計出來的兒童間成長率變異性被膨脹了:把一個由學校教育驅動的歷程對齊在年齡上,會把學校教育的訊號攤散到「孩子恰好坐在每個年級裡的那些年齡」上。這份資料裡的分歧是溫和的,因為年級之內的年齡分散溫和,年級內年齡標準差大約半年。誠實的結論不是「一個量尺對、另一個錯」,而是:對一個學校教育的估計標的來說,年級是比較銳利的那把尺,而兩把尺的分歧會隨著留級與延後入學所引進的年齡異質性而擴大。表 34.2 依審查者會想看到的方式記下這個決定,包含估計標的、選定的量尺、檢視過的替代方案,以及兩者的調和。
表 34.2 時間計量的裁決:個案 A 的決策日誌。
| 項目 | 年級量尺 | 年齡量尺 |
|---|---|---|
| 服務的估計標的 | 學校教育(教學暴露)的效果 | 成熟的效果 |
| 線性增益 | 每年級 \(25.1\) 點(真值 \(25\)) | 每年 \(23.7\) 點(被衰減) |
| 形狀 | 減速(二次項 \(-1.53\)) | 減速,但比較平 |
| 斜率異質性 | 較小(訊號對齊) | 較大(訊號沒對齊) |
| 判定 | 學校教育估計標的的首選 | 成熟估計標的的首選 |
註:兩把尺都配適過;選擇跟著估計標的走,不跟著配適統計量走。這裡的分歧溫和,因為年級內的年齡變異溫和,留級或延後入學一多,分歧就會變尖銳。兩者都報告並加以調和,是站得住腳的做法。
34.2.2 測量這一層:先恆等性,再談尺
跨年級的分數差異要讀成成長之前,有兩個截然不同的測量問題必須先回答,而把它們混為一談是常見的錯誤。第一個問題是這份測量在每個年級上運作的方式一不一樣,也就是縱貫恆等性(longitudinal invariance)。把一個縱貫因素模型(factor model)配適到最年輕世代四個波次上的六指標成就測量,依序加上恆等性限制,形貌(configural)、量尺(metric)與截距(scalar)三個恆等性模型都配適得幾乎完美,比較配適指標(comparative fit index)都是 \(1.000\),量尺與截距兩步的比較配適指標改變量也都是 \(0.000\)。這正是「由建構植入的恆等性」該有的樣子,也因此許可了下一句解讀:這個成就複合分數(composite)跨年級以同一把尺測同一個構念。第二個問題完全是另一回事,關乎所報告量尺本身的等距(interval)性質,而成就測驗文獻在這裡藏了一個多數消費者從不檢視的決定。
基礎概念 • 垂直連結的速寫
一把垂直量尺把不同年級的分數放到同一條連續線上,好讓三年級與八年級的分數可以比較,兩者的差也才叫得上成長。這個建構建立在跨相鄰年級施測的共同題目上:一道四年級與五年級都作答的題目,連結起這兩個年級的校準(calibration),一連串這樣的連結(linking)再經一個試題反應模型(item-response model)校準,就把單一把量尺傳播到整個範圍。這套程序有原則,卻不唯一。試題反應模型怎麼選、連結怎麼設計、拿哪個母體來定錨(anchor)量尺、接續各年級用什麼方法擺上去,全都在最後的等距間隔上留下指紋;不同而各自站得住腳的選擇,會產生一批「在兒童的排序上一致、在增益的大小上不一致」的量尺。消費者的義務不是去建那把尺,而是去問廠商作了哪些選擇,並檢驗研究結論撐不撐得過說得通的替代方案。Kolen and Brennan (2014) 是這方面的權威。對分析者來說重點只有一句:一把垂直量尺是一項建構,不是一項測量,而成長是透過它讀出來的。
後果就是本章的招牌片段,圖 34.3 把它畫成具體的樣子。同一個潛在成長歷程通過三種單調(monotone)的重新量尺化,每一種都是一把說得通的廠商量尺,在每個年級上都沒有讓任何一個孩子超越另一個孩子,平均成長的形狀卻起了質變:在等距忠實的線性量尺上,成長是減速的,標準化單位下的二次項為 \(-0.036\);在一把把上段拉開的凸型(convex)量尺上,同一份成長看起來在加速,二次項的正負號翻轉成 \(+0.034\);在一把把上段壓縮的凹型(concave)量尺上,成長看起來走上高原,減速加深到 \(-0.067\)。這個翻轉不是數值上的奇聞,是實質上的事:二次項的正負號恰恰是政策分析者拿來論證「學習在中間年級變慢還是變快」的那個量。對公平性(equity)研究更糟的是,「社經差距會不會隨年級擴大」的估計值在三把尺之間擺動了近七倍,凹型量尺上標準化的社經乘年級交互作用是 \(0.028\),線性量尺上是 \(0.088\),凸型量尺上是 \(0.192\)。同一批兒童於是生出兩種故事,一種說差距只是勉強在擴大,一種說差距在急速擴大,而分野只在測驗出版商(test publisher)作了哪一個量尺化選擇。表 34.3 列出這些假設、建構方式與敏感度發現。
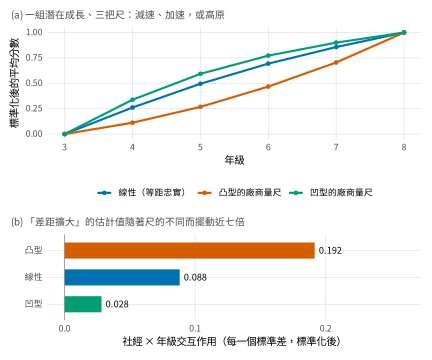
註:(a) 同一組模擬潛在成長經過三種單調重新量尺化之後的母體平均數,每一條各自對自己的全距標準化,因此只比形狀:凸型的廠商量尺把曲線壓到對角線之下(看起來像加速),凹型量尺把它推到對角線之上(看起來像高原),等距忠實的線性量尺居中。(b) 每一把尺之下的社經乘年級交互作用,也就是差距擴大的估計值;它由 \(0.028\) 擺動到 \(0.192\),而沒有任何一個孩子在任何一個年級上超越另一個孩子。嚴格說,凹型那一把量尺是弱單調而非嚴格單調:低分段有一道地板,\(4{,}800\) 個觀察值裡有 \(140\) 個被壓成同分,三年級 \(400\) 人中就佔了 \(71\) 個;因此保住的是沒有任何一對被顛倒,不是每個孩子各自的名次。驅動結論的是尺,不是孩子。英文版此圖的檔名是 ch34_fig04_ruler.pdf,與印出來的圖號 \(34.3\) 不合,圖形腳本的區塊標題也跟著錯;見 EN-34-01。
表 34.3 垂直量尺化:假設、建構與敏感度。
| 量尺化 | 它假設了什麼 | 對結論的影響 |
|---|---|---|
| 線性(等距忠實) | 保住等距的潛在量尺 | 成長減速;差距擴大 \(0.088\) |
| 凸型(上段拉開) | 後來的增益算得比較重 | 看起來在加速;差距擴大 \(0.192\) |
| 凹型(上段壓縮) | 後來的增益算得比較輕 | 看起來走上高原;差距擴大 \(0.028\) |
註:三把尺都是同一個潛在成長歷程的單調變換,在每個年級上都沒有讓任何一個孩子超越另一個孩子(凹型那一把是弱單調的,低分段有一部分被壓成同分)。等距層次的結論沒有被保住,也就是減速的正負號與差距擴大的大小。一項成長主張只要在性質上是等距的,就該報告它對量尺化的敏感度。
常見陷阱 • 年級當量分數與等距的主張
教育研究裡最常見的量尺化錯誤,是把年級當量(grade-equivalent)分數、或一個未經檢視的廠商量尺分數,當成帶著等距意義來用,接著計算並比較增益,彷彿全距底端的一分等於頂端的一分。年級當量分數尤其棘手:它由中位數表現定義,走勢非線性,同樣一個年級當量單位擺在不同位置就代表不同分量的學習。補救之道不是放棄這些分數,而是說明量尺的來歷,要作等距主張時優先選用等距理由站得住的量尺,並把成長結論放進替代量尺化裡跑一遍當作敏感度分析,正如圖 34.3 所做的。一項只在某一家廠商的量尺上成立的差距擴大發現,是關於那家廠商的發現,不是關於那些孩子的發現。
34.2.3 帶著機構巢套的成長
兒童巢套在學校之下,可是在縱貫設計裡這份巢套並不乾淨,因為兒童會轉學。這份資料裡,\(1{,}200\) 名兒童中有 \(180\) 名在某個波次換了學校。要模型化的是每個孩子的原就讀學校、忽略那次搬遷,還是每個時點上的當前學校?後者會讓兒童與前後就讀的幾所學校交叉分類。成長模型兩種都配適一次:忽略流動的單一隸屬(single-membership)設定,給出 \(123.4\) 的學校間變異數(variance)與 \(7.21\) 的殘差(residual)標準差(standard deviation);把每個時點記到它實際所屬學校的交叉分類設定,把學校間變異數降到 \(88.9\)、殘差降到 \(7.00\)。差別在於單一隸屬模型迫使轉學生搬遷之後的時點載到錯的學校上,再把那份錯配(misfit)吸收成膨脹的變異數。這個教訓推得開:流動不是一件用整列刪除(listwise deletion)丟掉轉學生就能處理的麻煩,那樣做恰恰是在流動所標示的那份劣勢上作選擇;流動是一項結構特徵,要以交叉分類來模型化。圖 34.4 把這個結構畫出來。
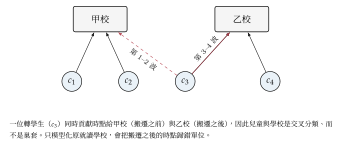
註:多數兒童只讀一所學校,但轉學生的各個時點在不同波次上屬於不同的學校,兒童與學校這兩個分組因此交叉。交叉分類的隨機效果模型(cross-classified random-effects model)把每個時點記到它實際所屬的學校;只用原就讀學校的單一隸屬模型,把搬遷之後的時點壓到錯的單位上,學校間變異數就被膨脹,這裡由 \(88.9\) 膨脹到 \(123.4\)。
34.2.4 加速設計的收斂檢定
加速設計把各自涵蓋一部分年級範圍的世代合併起來,對齊在年級上,重建一段任何單一世代都沒有被追蹤過的跨距。這項重建要成立,各世代必須在共有的年級上共享同一個成長歷程,那就是世代收斂的假設,而這個設計讓它可檢定,不只是被假定。把世代主效果與世代乘年級交互作用加進成長模型,以概似比檢定(likelihood-ratio test)比較,結果不顯著,\(p = .94\),這份資料裡的收斂假設成立,一如它被植入的樣子。方法上的重點是:那項假設該被檢視,不該憑信心預設。真實的教育資料裡,成就、課程(curriculum)或科技暴露上的世代間長期趨勢(secular trend)是常態,不是例外;一次失敗的收斂檢定也不是麻煩,而是一項關於世代效果的發現,而加速設計正好處在偵測得到它的獨特位置上。
34.2.5 預測變項、彈性與政策的轉譯
成長模型立好之後,軌跡的預測變項就讀得出來。社經地位每一個標準差把三年級的水準抬高 \(12.2\) 點,把成長率抬高每年級 \(3.74\) 點,後者就是上面那場量尺盤問中,在等距忠實的量尺上活下來的差距擴大效果。一項彈性檢查可以避免把減速的二次式硬加在資料想要別種形狀的地方:帶年級平滑項(smooth)的廣義加法模型(generalized additive model)回報有效自由度(effective degrees of freedom) \(3.8\),而訊息準則(information criterion)並不偏好平滑項勝過參數化(parametric)的二次式,Akaike 準則的差是 \(2.5\),偏向二次式。那條精簡(parsimonious)的減速曲線因此夠用,而那份非線性(nonlinearity)確實是二次的,不是多項式漏掉了什麼。圖 34.5 把整個個案組裝起來:接起來的減速成長、學校間的變異,以及正在擴大的社經差距。
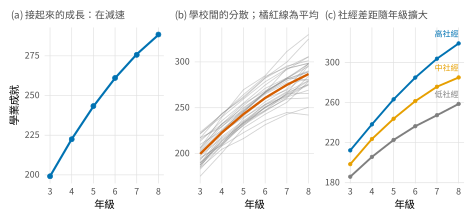
註:(a) 世代接起來的平均成就與配適的減速二次曲線。(b) \(30\) 條學校平均軌跡(灰)圍繞著總平均(橘紅),也就是多層次模型切分出來的那份機構變異。(c) 各社經三分位(tertile)在各年級的平均成就;差距在等距忠實的量尺上隨年級擴大,而讀者現在知道這個結論以那把尺為條件。英文版此圖的檔名是 ch34_fig03_caseA_master.pdf,與印出來的圖號 \(34.5\) 不合;見 EN-34-01。
最後一步是政策讀者會要的那項轉譯:把一個效果表達成學習月數,而且必須連同它的危害一起做。三年級的社經差距 \(12.2\) 點,除以大約 \(25\) 點的年平均增益,再乘上一個學年的九個月,差距就換算成大約 \(4.4\) 個學習月;每年 \(3.74\) 點的擴大則換算成每年大約多 \(1.3\) 個月。這項轉譯在溝通上很有力,在分析上很脆弱。它繼承了那把量尺的每一項假設,同一份差距換到凸型的廠商量尺上,就會換算出一個不同的月數,而且不同的方向隨年級而翻轉:三年級的差距在凸型量尺上換得比較少的月數,因為那把尺把分母抬高的速度快過分子;到了八年級,同一把尺換出來的月數則遠大於線性量尺上的月數。它拿來除的那個平均增益本身在減速,在被描述的範圍內並不是常數。一個學習月數的數字,因此絕不該在沒有交代所依據的量尺、也沒有加上但書的情況下報告出去,而那句但書是:它是一種溝通裝置(communicative device),不是一項測量。表 34.4 收攏那些報告義務,實務方塊則處理這類研究所仰賴的學區資料的現實。
表 34.4 教育與發展研究的報告檢核表。
| 項目 | 該報告什麼 |
|---|---|
| 時間計量 | 建模的那個時鐘、它服務的估計標的,以及與替代方案的調和 |
| 恆等性 | 建立起來的恆等性層次,以及支持它的配適改變量證據 |
| 垂直量尺 | 量尺的來歷,以及成長結論對替代量尺的敏感度 |
| 巢套與流動 | 巢套結構,包括為轉學生所作的交叉分類 |
| 世代收斂 | 那項收斂檢定,不是一項假設 |
| 學習月數 | 它所依據的量尺,以及它作為溝通裝置的身分 |
註:這份檢核表把本章的主張寫成條目:在這個領域裡,測量的決定是可以報告的結果,不是前置作業。一項沒有交代量尺、時間計量與巢套的成長發現,還不到解讀得了的程度。
實務要點 • 實務:使用學區資料與檔案資料
學區的成就資料是靠行政識別碼(administrative identifier)跨年串接起來的,而那些識別碼是為會計而建,不是為研究而建。分析者的第一項工作因此是一次有文件的合併(documented merge):依第 5 章的資料來歷(data provenance)紀律,在配適任何模型之前先調和重複紀錄、學年中途的轉出入,以及識別碼的變更。隱私規範限制了什麼可以串接、什麼可以釋出,例如美國《家庭教育權利與隱私法》(FERPA)對學生教育紀錄的保護;一項站得住腳的研究會說明自己的資料使用協定(data-use agreement)與去識別化(de-identification),不會把它們留在暗處。發展與教育領域有很多工作是對檔案性縱貫研究的次級分析(secondary analysis)。資料早於分析者存在,分析計畫卻不是:估計標的、模型、恆等性與量尺化的檢查,以及那些敏感度分析,即使資料已經蒐集完畢也可以、而且應該預先註冊(preregister),因為預先註冊約束的是分析者,不是資料。
34.3 個案研究 B:發展連鎖
第二個個案研究轉向交易,也就是「系統會隨時間彼此塑造」這個發展的想法:一個孩子的語文能力拉起後來的作業能力,或投入拉起後來的成就。它同時守住連鎖文獻太常忽略的那份估計標的紀律。資料是模擬的 wisc 紀錄,一個語文與作業能力的雙變量設計,在四個年度波次(annual wave)上測量 \(900\) 名兒童,以一個已知的交叉延宕歷程建成:穩定的個人特質在兩個領域之間相關,個體內的交易則有方向,語文帶動後來的作業遠多於反過來,而社經地位調節(moderate)那份交易的強度。這樣建構出來的資料讓分析稽核得了,更重要的是讓錯誤模型的後果攤得開。
34.3.1 把特質與交易分開
一項連鎖主張的估計標的是個體內效果:一個孩子的語文能力比自己平常高一些之後,作業能力會不會接著也比自己平常高一些。這是一句關於「偏離一個人自己軌跡的個體內離差」的陳述。傳統的交叉延宕追蹤模型估計不了它,因為它拿觀察分數對觀察分數作迴歸,沒有把穩定的個體間差異分出來,交叉延宕係數於是把個體內的交易與穩定特質的個體間相關混在一起;第 21 章的隨機截距交叉延宕追蹤模型(RI-CLPM)存在的目的,正是完成這道分離。兩者配適到同一份資料上,隨機截距模型還原出植入的有方向連鎖:語文到作業的個體內路徑是 \(0.202\),對照真值 \(0.25\),舒服地落在信賴區間(confidence interval)之內;作業到語文的路徑接近零,\(0.058\),對照真值 \(0.05\);相關的穩定特質則由 \(0.53\) 的個體間共變數(covariance)捕捉。沒有隨機截距的傳統模型把這份不對稱壓平了,語文到作業的路徑被拉低到 \(0.154\),作業到語文的路徑被膨脹到 \(0.093\),真值裡五比一的方向比(directional ratio)塌成不到二比一,連鎖的方向也跟著糊掉。圖 34.6 呈現這個對比與那份調節,表 34.5 則把估計值擺在真值旁邊。
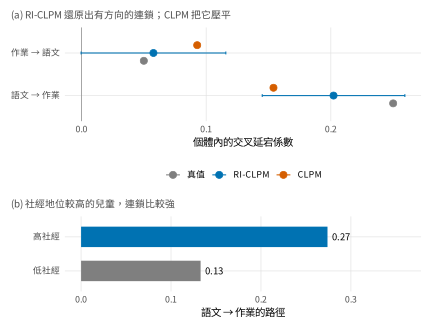
註:(a) 個體內的交叉延宕係數。隨機截距交叉延宕追蹤模型(藍)還原出植入的有方向連鎖,貼近真值(灰),語文到作業的路徑強,反向的路徑接近零;傳統的交叉延宕追蹤模型(橘紅)沒有隨機截距,把相關的穩定特質吸收進延宕係數,不對稱就被壓平了。(b) 分社經組估計的語文到作業路徑:社經地位較高的兒童連鎖比較強,那是植入的調節。
表 34.5 連鎖模型家族:估計值對照真值。
| 量 | 真值 | RI-CLPM | CLPM |
|---|---|---|---|
| 語文 \(\rightarrow\) 作業 | \(0.25\) | \(0.202\) | \(0.154\) |
| 作業 \(\rightarrow\) 語文 | \(0.05\) | \(0.058\) | \(0.093\) |
| 特質共變數/相關 | \(0.50\) | \(0.53\) | (被吸收) |
| 方向比 | \(5.0\) | \(3.5\) | \(1.7\) |
註:隨機截距模型(RI-CLPM)還原出個體內的有方向連鎖;傳統模型(CLPM)把相關的穩定特質與延宕動態混在一起,方向比也被壓縮。已發表文獻常把 CLPM 的交叉延宕係數當成連鎖的證據來報告,這個比較針對的正是那個習慣。
雙變量的潛在變化分數模型,也就是第 20 章那個耦合的雙變化分數設定,換一種參數化提供第二種視角:一個領域的變化由另一個領域的先前水準(prior level)預測。它在連鎖的方向上與隨機截距模型一致,語文到作業的耦合(coupling)是 \(0.099\),作業到語文是 \(0.078\),不過在這個度量上不對稱比較溫和,而模型的參數共變數矩陣在這裡接近奇異(near-singular),因此它只讀成方向的佐證,不當成大小的獨立估計。兩個模型家族的調和依循 Usami 及其同僚的架構,不把它們當成互相競爭的對手。那份調節則是在社經地位的中位數切分(median split)上釋放語文到作業的路徑估出來的:社經地位較高的兒童連鎖比較強,\(0.274\) 對社經地位較低兒童的 \(0.133\),正是植入的交互作用。放在一項實質研究裡,這個結果會招來一段討論,題目是什麼樣的資源讓一項發展中的能力槓桿得動另一項。
34.3.2 延宕背後的那個間隔
一個在年度波次上估出來的交叉延宕效果,對自己所依據的那個間隔是沉默的,而那份沉默是個陷阱。個體內的延宕效果不是一個固定的量,是測量間隔的函數:由零延宕時的零往上走,在某個歷程特有的間隔上達到高峰,然後衰減,那正是第 27 章連續時間(continuous-time)的邏輯。年度波次的連鎖估計值取樣的只是這條曲線上的一點,一項採半年或兩年波次的研究,對同一個歷程會報出不同的數字。圖 34.7 在概念上把這一點畫出來。這對發展連鎖研究的意涵不是「年度設計是錯的」,而是這些估計值都是間隔特定的;不同間距的研究互相比較,比的是曲線上不同的點,不是同一個效果。間隔結構一有變動,有原則的補救就是改用連續時間的表述。
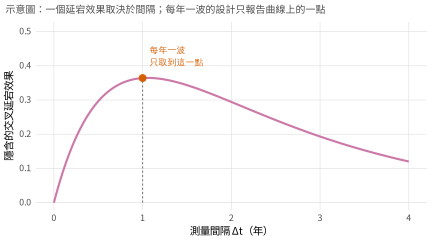
註:概念示意。個體內的交叉延宕效果隨測量間隔而變,這裡先上升,在一年左右的延宕附近達到高峰,然後衰減。年度波次的設計報告的是被標出來的那一點;間距不同的設計,對同一個底層歷程會報出不同的值。跨研究比較交叉延宕係數,隱含假定了一個很少被滿足的共同間隔,而第 27 章的連續時間模型直接處理這件事。
常見陷阱 • 只憑交叉延宕追蹤模型就談連鎖
已發表的發展連鎖文獻密布著建立在傳統交叉延宕追蹤模型上的主張,只要有一對顯著的交叉延宕係數,就被讀成「一個系統驅動另一個」的證據。問題在於這樣的交叉延宕係數把穩定的個體間差異與個體內的交易混在一起:兩個只在穩定水準上相關的構念,完全沒有任何交易也產生得出顯著的交叉延宕係數。一項連鎖主張需要一個把「人的穩定水準」與「人繞著它的波動」分開的模型,也就是隨機截距交叉延宕追蹤模型或潛在變化分數模型;只報告傳統交叉延宕係數的研究,還沒有為理論所指的那個個體內意義的連鎖提供證據。這項修正並不新,被採用的程度卻不完整,而審查者有權要求它。
34.4 個案研究 C:認知老化中的變異性與叢發
第三個個案研究轉向生命全程的另一端,也轉向一種以快時間尺度取樣慢歷程的設計,也就是測量叢發設計:一段段短期的密集每日測量,以長間隔重複進行,好讓快速的個體內動態在自己隨老化這條慢發展時間改變的過程中被追蹤到。資料是模擬的 burst_aging 紀錄:\(250\) 位長者在三年之內接受三次叢發的每日施測,每次叢發之內每日記錄訊息處理速度(processing speed)與記憶失誤(memory lapse),每次叢發另記錄一次認知複合分數。這個設計是為了承載老化文獻的招牌假設而建的,也就是個體內的表現不一致在平均數下降之前就先上升;它同時讓檢驗那項假設的兩個危害現形,一是讓動態產生偏誤的短序列,二是讓平均數產生偏誤的選擇性流失。
34.4.1 三個分析層
一個叢發設計在三個時間尺度上支撐三個不同的估計標的,表 34.6 把它們列出來。一次叢發之內,每日資料支撐一個個體內平均數、一個個體內變異性,以及一個個體內自我相關(autocorrelation);後兩者正是老化文獻當成構念本身在看的表現不一致與遲緩。叢發之間,這些「人乘叢發」的量橫跨老化這段慢時間怎麼改變,才是發展的估計標的,因此問題不只是平均數會不會下降,還包括變異性會不會增長、動態會不會變慢。波次層次上,認知複合分數提供一個定錨的結果(anchoring outcome),用來驗證那些快時間尺度的指標。圖 34.8 呈現一位受試者原始的多時間尺度結構:叢發平均數往上漂移,也就是反應變慢,而日與日之間的分散橫跨三次叢發越變越寬。
表 34.6 叢發的分析層:時間尺度、估計標的與模型。
| 層 | 估計標的 | 模型 |
|---|---|---|
| 叢發之內 | 平均數、個體內標準差(iSD)、自我相關 | 逐人逐叢發的描述;AR(1) |
| 叢發之間 | 平均數、iSD 與自我相關橫跨老化的改變 | 那些「人乘叢發」量的成長 |
| 波次層次 | 認知水準與它的下降 | 複合分數軌跡;流失模型 |
註:一份叢發資料在三個時間尺度上各給出估計標的。發展的問題住在叢發之間那一層:那裡關心的現象是變異性的改變與動態的改變,不只是水準的改變。
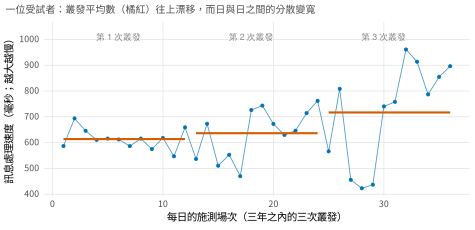
註:一位長者橫跨三年三次叢發的每日訊息處理速度測量,叢發平均數以橘紅標出。平均數往上漂移,也就是反應變慢,到第三次叢發時,日與日之間的分散明顯變寬。這張圖說明了叢發設計為什麼必要:變異性的改變住在叢發之內那個時間尺度上,「每波只測一次」的設計看不見它。
34.4.2 變異性會先於下降嗎?
老化文獻的招牌假設是:個體內的表現不一致是一個早期指標,在平均數本身下降之前就先上升。叢發結構讓這項假設直接檢驗得了。橫跨三次叢發,母體平均訊息處理速度由第一次到第二次基本上持平,\(650\) 然後 \(656\) 毫秒,到第三次才升到 \(687\);個體內變異性卻在第二次叢發就已經上升,三次的表現不一致中位數分別是 \(53\)、\(76\) 與 \(100\) 毫秒。變異性整整領先平均數一次叢發,圖 34.9 呈現那份領先。這項主張的個人層次版本,也就是某位長者第二次叢發的變異性預告得了隨後的下降,得到支持但幅度不大:在完成者(completer)之中,把平均速度由第二次到第三次叢發的改變,對第二次叢發的表現不一致作迴歸,正係數是 \(0.51\),標準誤 \(0.23\),\(p = .026\),相關大約 \(0.18\)。這是真實但小的效果,也恰恰是應該不加灌水、照實報告的那種量級。這份清醒是刻意的,呼應第 32 章那句「不要把早期預警指標讀得太多」的告誡:變異性作為領先標記是一個真實而且有用的現象,卻不是任何一條個體軌跡的決定性預測因子。
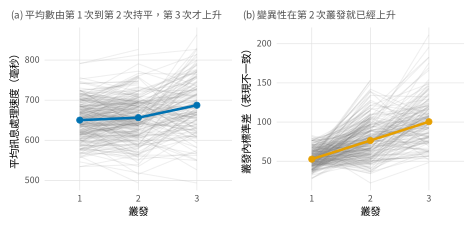
註:橫跨三次叢發的個人軌跡(灰)與母體摘要(彩色)。(a) 平均訊息處理速度由第一次到第二次叢發持平,第三次才上升。(b) 叢發之內的變異性在第二次叢發就已經上升,整整領先平均數一次叢發。變異性領先水準就是老化文獻的招牌假設,這裡從一份刻意含有它的資料中還原出來,而個人層次的版本幅度不大。
34.4.3 變化中的動態與選擇性流失
水準與變異性之外,動態本身也在改變:訊息處理速度在叢發之內的自我相關,也就是「一次慢反應之後跟著另一次慢反應」的那份遲緩,橫跨各次叢發往上走。在每次叢發之內以一個多層次自我迴歸(multilevel autoregression)估計它,那份增加還原了出來,三次叢發的自我相關分別是 \(0.12\)、\(0.20\) 與 \(0.28\)。這些估計值相對於植入的 \(0.25\)、\(0.36\) 與 \(0.47\) 向下偏誤,來源是十二天的短序列,也就是第 24 與 25 章熟悉的小樣本動態追蹤偏誤(dynamic-panel bias)。不過橫跨叢發的那份增加被清楚地還原出來,而那個「動態改變」的訊號才是這項研究在意的量,也才是它的發展估計標的。第二個危害是流失,而這裡的流失是訊息性(informative)的,不是良性的:在第三次叢發之前離開的長者,正是變異性比較大、下降比較快的那些人,第三次叢發的樣本因此是一個倖存者樣本,它天真(naive)的平均數低估了母體的下降幅度。第三次叢發完成者的天真平均數是 \(687\) 毫秒,母體真值是 \(705\)。以模型化的留下機率(probability of staying)的倒數為完成者加權,也就是把離去的高風險個案算回來的流失逆機率加權(inverse-probability-of-attrition weighting),估計值移到 \(696\),還原了大約一半的倖存者偏誤(survivor bias);而那個「大約一半」是上限,因為 \(696\) 的流失模型用的是生成流失的那兩個潛在傾向本身,真實的分析者拿不到,改以觀察得到的量重算得 \(694.48\),還原 \(40.1\%\)。剩下的落差提醒一件事:這種校正只調整得了已經測到的東西。結果與退出共享未測到的原因時,完整的補救是第 29 章介紹的「縱貫歷程與流失歷程的聯合模型」,而叢發設計裡的選擇性損耗,正是那個一般問題的發展版本。
實務要點 • 倫理:跨波的允諾與偶然發現
發展研究取得同意的那些年,正是兒童允諾能力逐年成長的那些年,而那份倫理義務是持續的,不是收案時一次履行完畢:允諾要隨著孩子成熟重新取得,而一個設計要說明自己怎麼向「在研究期間跨過發展門檻」的參與者重新徵得同意。縱貫的認知與教育測量可能浮現偶然發現(incidental finding),例如一位長者出乎意料的下降、一個孩子的學習困難;一項研究要事先講明什麼會回報給參與者、家庭或學校,以及透過什麼管道。測量叢發那種每日施測的親密程度,加上學校資料所在的機構脈絡,都提高了看到某件該處理的事的機會。原則是:照護的責任延伸到一段縱貫關係的整個跨距,不只是第一次接觸。
34.5 領域綜合
三個個案研究共用一個結構,圖 34.10 把它抽象成一道主張階梯(claims ladder),從縱貫資料最穩固地支撐得起的一階,爬到它最勉強地支撐得起的一階。最底下是描述,也就是記下「一個平均數以某種形狀改變」;只要測量站得住,成長模型就以高可信度交付得了它。上面一階是變化的個別差異及其相關因素的刻畫,穩固的程度取決於測量恆等、量尺等距忠實。再上面一階是個體內的交易,也就是連鎖,它需要個體間與個體內成分被分開,而年度設計只在一個固定的間隔上估得到它。最上面一階是發展的解釋,也就是「一件事引起另一件事在發展上浮現」這個主張;縱貫的描述限制得住它,卻建立不起它。正如 Wohlwill (1973) 所論證、Baltes and Nesselroade (1979) 所堅持的,描述變化與解釋發展是兩項不同的成就,而兩者之間的落差由理論與設計架起來,不是靠一段更長的追蹤。
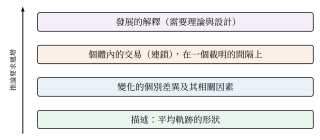
註:縱貫資料對各種主張的支撐並不均勻。平均變化的描述是最穩固的一階;個別差異及其相關因素要求測量站得住;個體內的交易要求特質與交易被分開,而且是間隔特定的;發展的解釋要求追蹤之外的理論與設計。把一項主張定位在階梯上,就是那份紀律:不讓一份縱貫描述被推銷成一項發展解釋。
發展或教育期刊的審查者會針對這個領域的特徵性弱點施壓,並預期分析者早就處理過。審查者會問:時間計量配不配得上估計標的、替代方案有沒有檢視過;測量有沒有證明在所比較的各年齡上恆等;成長結論撐不撐得過一把替代的垂直量尺;流動有沒有模型化,而不是刪掉;加速設計的收斂有沒有檢定,而不是假定;一項連鎖主張是不是建立在把特質與交易分開的模型上;一項「變異性即早期指標」的主張有沒有連同它不大的效果量與誠實處理過的流失一起報告;一個學習月數的轉譯有沒有帶著它的量尺與但書。這每一項都是三個個案研究公開作過決定的地方,而那些定錨文獻為想走得更深的讀者指路:成就成長與學校效果的經典在 Raudenbush and Bryk (2002) 與 Bryk and Raudenbush (1988),垂直量尺化的權威在 Kolen and Brennan (2014)、它的後果在 Briggs and Weeks (2009),連鎖的框架在 Masten and Cicchetti (2010) 與 Sameroff (2009)、估計標的的紀律在 Curran et al. (2014),老化變異性的研究方案在 Ram and Gerstorf (2009)、MacDonald et al. (2003) 與 Lövdén et al. (2007)。這個給了縱貫方法學第一批問題的領域,也持續拋出最難的測量問題,而它獎賞的手藝正是本章試著實踐的那一種:讓測量的決定被看見。在發展研究裡,那些決定不是科學的前置作業,它們就是科學的一部分。
軟體提示
這些分析只用了廣泛可得的套件。成長模型與交叉分類模型以 lme4 配適,它的交叉隨機效果語法在「學校識別碼在兒童之內變動」時原生就處理得了學生流動。縱貫恆等性、隨機截距交叉延宕追蹤模型與雙變量潛在變化分數模型以 lavaan 配適;恆等性序列以標記變項(marker-variable)法手工建起,並在截距恆等性那一步釋放因素平均數(factor mean),semTools 裡的自動恆等性輔助函式在這裡用不上。彈性檢查用 mgcv。垂直量尺化的敏感度、叢發層次的表現不一致與自我相關,以及流失逆機率加權,都以基礎 R 手寫。資料產生器(data generator)與分析腳本都設了種子(seed)並隨章附上,因此本章的每一張圖都可以對照植入的真值重新產生。
本章摘要
發展與教育是縱貫測量最難的地方,而本章的教訓是測量的決定先於建模的決定,也限制住建模的決定。個案 A 把一份加速的、巢套在學校之下的成就資料帶過測量到政策的鏈條,顯示:時間計量跟著估計標的走;恆等性許可了那個複合分數;一把垂直量尺是一項建構,換一把就可能翻轉一個成長結論,或讓一個差距擴大的估計值擺動近七倍;流動必須以交叉分類來模型化;加速設計的收斂是可檢定的;而一個學習月數的轉譯必須帶著它的量尺。個案 B 把穩定的特質與個體內的交易分開,以一個隨機截距模型還原出一份有方向的連鎖,而傳統的交叉延宕追蹤模型會把它壓平;它並指出一個延宕效果對所依據的間隔是特定的。個案 C 以一個測量叢發設計檢驗變異性是否先於下降,在母體層次上找到那份領先,在個人層次上找到一份不大的關聯,在短序列的向下偏誤之中還原出一份真實的動態變慢,並以對訊息性流失的加權校正一個倖存者偏誤的平均數。發展的主張階梯依每一項發現的推論要求把它定位,而貫串全章的那條線,是 Wohlwill 在「描述變化」與「解釋發展」之間所作的區分。
習題
- 34.1 盤問垂直量尺。在
achieve_accel上重現圖 34.3 的三種單調重新量尺化,確認二次項的正負號怎麼翻轉、社經差距擴大的估計值怎麼由 \(0.028\) 擺到 \(0.192\),並說明為什麼這一路上沒有任何一個孩子換過名次。 - 34.2 裁決時間計量。把同一個減速成長模型以 lme4 分別配適到
achieve_accel的年級量尺與年齡量尺上,依表 34.2 的欄位寫一份決策日誌;接著把世代主效果與世代乘年級交互作用加進去,以概似比檢定世代收斂,並寫出結果段落。 - 34.3 連鎖的方向比。在
wisc上以 lavaan 同時配適傳統的交叉延宕追蹤模型與隨機截距版本,依表 34.5 說明方向比為什麼由 \(3.5\) 塌成 \(1.7\),再依圖 34.7 補上一句,交代這些係數對年度間隔的依賴。 - 34.4 學習月數轉譯。用第 34.2 節的數字手算三年級社經差距的學習月數,再寫一段給政策讀者的備忘錄,說明這個數字繼承了哪一把量尺的假設,以及拿來除的年平均增益本身為什麼不是常數。
- 34.5 檢核表稽核。找一篇已發表的學業成就成長論文,依表 34.4 逐項稽核,特別追問它有沒有交代垂直量尺的來歷、有沒有把轉學生的流動模型化而不是整列刪除,並就疏漏寫出應有的審查意見。
- 34.6 叢發的三層。在
burst_aging上依表 34.6 的三個時間尺度各估一組量,重現圖 34.9 裡變異性領先平均數一次叢發的樣態,再以流失逆機率加權校正倖存者平均數,並說明剩下的落差為什麼要交給第 29 章。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 時間計量 | time metric | 建模時用的那個時鐘(年齡、年級、波次);由估計標的決定;第 34.2 節 |
| 加速設計 | accelerated design | 以重疊的世代拼接出單一世代未被追蹤過的跨距(承第 2、14 章);第 34.1 節 |
| 世代收斂 | cohort convergence | 各世代在共有年級上共享同一成長歷程的可檢定假設;第 34.2 節 |
| 垂直量尺化 | vertical scaling | 以跨年級的共同題目把不同年級的分數放到同一條連續線上;第 34.2 節 |
| 年級當量分數 | grade-equivalent score | 以中位數表現定義的分數;非線性,不可作等距用;第 34.2 節 |
| 交叉分類 | cross-classification | 兒童與他前後就讀的幾所學校交叉,不是巢套(承第 23 章);第 34.2 節 |
| 學習月數 | months of learning | 把一個效果除以年平均增益再乘九個月的溝通裝置;第 34.2 節 |
| 發展連鎖 | developmental cascade | 一個發展中的系統帶動另一個(承第 20 章的指路);第 34.3 節 |
| 個體內的交易 | within-person transaction | 一個人偏離自己軌跡之後帶動另一個領域的效果;第 34.3 節 |
| 測量叢發設計 | measurement-burst design | 短期密集測量以長間隔重複(承第 2 章);第 34.4 節 |
| 表現不一致 | performance inconsistency | 叢發之內的個體內標準差;老化文獻的構念;第 34.4 節 |
| 流失逆機率加權 | inverse-probability-of-attrition weighting | 以留下機率的倒數為完成者加權,校正倖存者偏誤;第 34.4 節 |
| 倖存者偏誤 | survivor bias | 完成者樣本的平均數低估母體的下降;第 34.4 節 |
| 發展主張階梯 | developmental claims ladder | 把結論的語言釘在推論要求上的四階;第 34.5 節 |
參考文獻
Baltes, P. B., & Nesselroade, J. R. (1979). History and rationale of longitudinal research. In J. R. Nesselroade & P. B. Baltes (Eds.), Longitudinal research in the study of behavior and development (pp. 1–39). Academic Press.
Briggs, D. C., & Weeks, J. P. (2009). The impact of vertical scaling decisions on growth interpretations. Educational Measurement: Issues and Practice, 28(4), 3–14. https://doi.org/10.1111/j.1745-3992.2009.00158.x
Bryk, A. S., & Raudenbush, S. W. (1988). Toward a more appropriate conceptualization of research on school effects: A three-level hierarchical linear model. American Journal of Education, 97(1), 65–108. https://doi.org/10.1086/443913
Curran, P. J., Howard, A. L., Bainter, S. A., Lane, S. T., & McGinley, J. S. (2014). The separation of between-person and within-person components of individual change over time: A latent curve model with structured residuals. Journal of Consulting and Clinical Psychology, 82(5), 879–894. https://doi.org/10.1037/a0035297
Duncan, T. E., & Duncan, S. C. (2009). The ABC’s of LGM: An introductory guide to latent variable growth curve modeling. Social and Personality Psychology Compass, 3(6), 979–991. https://doi.org/10.1111/j.1751-9004.2009.00224.x
Ferrer, E., Shaywitz, B. A., Holahan, J. M., Marchione, K., & Shaywitz, S. E. (2010). Uncoupling of reading and IQ over time: Empirical evidence for a definition of dyslexia. Psychological Science, 21(1), 93–101. https://doi.org/10.1177/0956797609354084
Grimm, K. J., An, Y., McArdle, J. J., Zonderman, A. B., & Resnick, S. M. (2012). Recent changes leading to subsequent changes: Extensions of multivariate latent difference score models. Structural Equation Modeling, 19(2), 268–292. https://doi.org/10.1080/10705511.2012.659627
Hertzog, C., Lindenberger, U., Ghisletta, P., & von Oertzen, T. (2006). On the power of multivariate latent growth curve models to detect correlated change. Psychological Methods, 11(3), 244–252. https://doi.org/10.1037/1082-989X.11.3.244
Hoffman, L., & Stawski, R. S. (2009). Persons as contexts: Evaluating between-person and within-person effects in longitudinal analysis. Research in Human Development, 6(2–3), 97–120. https://doi.org/10.1080/15427600902911189
Kolen, M. J., & Brennan, R. L. (2014). Test equating, scaling, and linking: Methods and practices (3rd ed.). Springer. https://doi.org/10.1007/978-1-4939-0317-7
Lövdén, M., Li, S.-C., Shing, Y. L., & Lindenberger, U. (2007). Within-person trial-to-trial variability precedes and predicts cognitive decline in old and very old age: Longitudinal data from the Berlin Aging Study. Neuropsychologia, 45(12), 2827–2838. https://doi.org/10.1016/j.neuropsychologia.2007.05.005
MacDonald, S. W. S., Hultsch, D. F., & Dixon, R. A. (2003). Performance variability is related to change in cognition: Evidence from the Victoria Longitudinal Study. Psychology and Aging, 18(3), 510–523. https://doi.org/10.1037/0882-7974.18.3.510
Masten, A. S., & Cicchetti, D. (2010). Developmental cascades. Development and Psychopathology, 22(3), 491–495. https://doi.org/10.1017/S0954579410000222
McArdle, J. J., & Epstein, D. (1987). Latent growth curves within developmental structural equation models. Child Development, 58(1), 110–133. https://doi.org/10.2307/1130295
Miyazaki, Y., & Raudenbush, S. W. (2000). Tests for linkage of multiple cohorts in an accelerated longitudinal design. Psychological Methods, 5(1), 44–63. https://doi.org/10.1037/1082-989X.5.1.44
Nesselroade, J. R. (1991). The warp and woof of the developmental fabric. In R. M. Downs, L. S. Liben, & D. S. Palermo (Eds.), Visions of aesthetics, the environment, and development: The legacy of Joachim F. Wohlwill (pp. 213–240). Lawrence Erlbaum Associates.
Ram, N., & Gerstorf, D. (2009). Time-structured and net intraindividual variability: Tools for examining the development of dynamic characteristics and processes. Psychology and Aging, 24(4), 778–791. https://doi.org/10.1037/a0017915
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage.
Salthouse, T. A. (2014). Why are there different age relations in cross-sectional and longitudinal comparisons of cognitive functioning?. Current Directions in Psychological Science, 23(4), 252–256. https://doi.org/10.1177/0963721414535212
Sameroff, A. (Ed.). (2009). The transactional model of development: How children and contexts shape each other. American Psychological Association. https://doi.org/10.1037/11877-000
Schaie, K. W. (1965). A general model for the study of developmental problems. Psychological Bulletin, 64(2), 92–107.
Sliwinski, M. J. (2008). Measurement-burst designs for social health research. Social and Personality Psychology Compass, 2(1), 245–261. https://doi.org/10.1111/j.1751-9004.2007.00043.x
Tong, Y., & Kolen, M. J. (2007). Comparisons of methodologies and results in vertical scaling for educational achievement tests. Applied Measurement in Education, 20(2), 227–253. https://doi.org/10.1080/08957340701301207
Wohlwill, J. F. (1973). The study of behavioral development. Academic Press.
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。