第 16 章
為個體內變異性建模:混合效果的位置尺度模型
到此為止的每一個模型都把變異性(variability)當成雜訊。殘差變異數是要估掉、要除掉的干擾項(nuisance),橫在資料與真正的研究對象也就是平均數結構之間。本章把這個立場翻轉過來,讓變異數當依變項。有一大類心理學問題,個體內變異性不是誤差,就是現象本身:邊緣型與雙相情況中的情緒不穩定(affective instability)、標誌著老化的認知表現不一致(performance inconsistency)、睡眠作息的不規律、一項治療想要撫平的症狀波動性(volatility)。這些情形要的量都是這個人擺盪得有多厲害,不是這個人平均落在哪裡。兩個平均數完全相同的人,預後可以差很多,因為一個穩定、另一個易變(labile)。第 7 章介紹了個體內變異性的各種指標,也清點了它們的毛病;本章提供以模型為基礎的修補。混合效果的位置尺度模型(mixed-effects location-scale model)在平均數上放一個次模型(submodel),在個體內變異數上再放第二個,兩者都帶隨機效果,並估計一個人的水準與這個人的波動性之間的相關。本書「先有指標、後有模型」這條邏輯,在這裡兌現得最清楚;貝氏估計也在這一章首度成為自然的引擎,而這個交棒由第 17 章完成。
學習目標
讀完本章之後,你應該能夠:(1) 說明個體內變異數為什麼是一個實質的量,以及兩階段的標準差指標當估計值用與當預測變項用時各有什麼缺陷;(2) 設定混合效果的位置尺度模型,包括位置次模型(location submodel)、帶隨機尺度效果(random scale effect)的對數線性(log-linear)尺度次模型(scale submodel),以及位置與尺度兩個隨機效果之間的相關;(3) 在乘性的變異數尺度上解讀尺度模型的係數;(4) 配適這個模型、讀它的輸出,並把參數還原出來;(5) 以恰當的不確定性檢定變異性的預測變項;(6) 把這個模型定位在分配模型(distributional model)這一族之中;(7) 以針對變異數的後驗預測檢查(posterior predictive check)驗證它,並報告到可供發表的水準。
16.1 變異性就是訊號
本章從一組人談起:他們的平均數完全相同,其他要緊的事情卻都不同。圖 16.1 裡有四個人,負向情緒(negative affect)的平均數一樣,個體內變異性卻天差地遠,從幾乎持平到劇烈擺盪。放進臨床情境,這是四個不同的病人:那個穩定的和那個高度易變的,可能拿到同一個診斷、平均症狀水準也一樣,面對的風險卻不同,對治療的反應不同,需要的監測也不同。研究這類差異的傳統由來已久,一路貫穿精神病理學裡情緒不穩定的工作 (Ebner-Priemer et al., 2009; Jahng et al., 2008)、把表現不一致當成認知衰退(cognitive decline)早期標記(early marker)的研究 (Hultsch et al., 2002),以及把短期個體內變異性當成穩定的個別差異構念(individual-differences construct)的更大方案 (Wang et al., 2012)。這些傳統的主張是同一個:變異數就是現象,只為平均數建模的方法把它丟掉了。
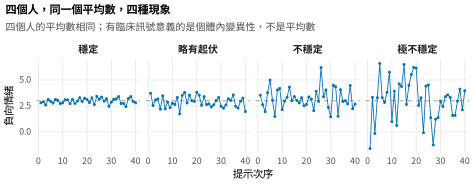
註:四個模擬出來的人,負向情緒的平均數相同,個體內變異性由穩定遞增到高度易變。平均數分辨不出他們,個體內標準差分辨得出來,而臨床上感興趣的往往正是後者。本圖延伸第 7 章的個體內變異性圖示,並補上明確的實質解讀。
第 7 章用個體內標準差(intraindividual standard deviation, iSD)測量這種變異性,一次算一個人,同時警告這個指標很脆弱。這項警告可以寫成四點缺陷。第一,兩階段的標準差本身帶著估計誤差,誤差大小取決於時點數:一個人只測了二十次提示(beep),估計值就遠比測了五十次的人不穩,圖 16.2 畫出由此產生的散布。第二,沒有收縮(shrinkage)。每個人的估計值各自為政,極端值照單全收,而極端值又不成比例地落在時點數最少的人身上,沒有任何力量把它們拉向團體。第三,水準與變異性只要有關聯,這個指標就把兩者混淆(confounding)在一起。圖 16.2 的右圖畫的正是這件事:量尺有界(bounded)或容易碰到地板(floor)時,平均數與標準差之間出現正向耦合(coupling),於是變異性上的差異可能只是水準差異的假象。第四,這個指標接著進入第二個分析當預測變項時,它的估計誤差就成了變項含誤差(error-in-variables),會讓下游的係數產生偏誤。這是代入謬誤(plug-in fallacy)的一個實例,也就是把帶雜訊的估計值當成已知量。以模型為基礎的做法必須把四項一起修好:跨人借力(borrow strength)、兩個層次都容許放共變項(covariate)、為水準與變異性聯合建模,並把屬於個人的變異性所帶的不確定性,傳到每一個用到它的地方。表 16.1 把兩種做法並排放在一起。
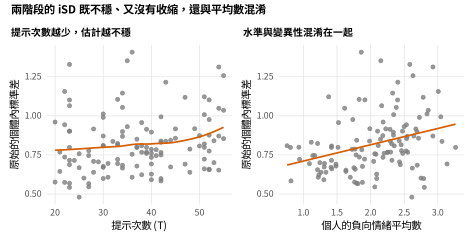
註:左:原始的個體內標準差對上提示次數。時點越少,估計越不穩、越極端,而且沒有任何收縮。右:原始的個體內標準差對上個人的平均數。結果變項有地板時,水準與變異性就混淆在一起。這兩項缺陷都由一個「帶收縮估計個人波動性、並把它與平均數分開」的模型來修補。
表 16.1 兩階段指標對上以模型為基礎的位置尺度做法。
| 能力 | 兩階段 iSD | 位置尺度模型 |
|---|---|---|
| 跨人借力(收縮) | 否 | 是 |
| 處理時點數不等 | 很差 | 是 |
| 變異性的共變項(誰、何時) | 否 | 是 |
| 為水準與變異性聯合建模 | 否 | 是 |
| 把不確定性傳到下游 | 否 | 是 |
註:兩階段的個體內標準差為每個人各算一個變異性估計值,再把它當成已知量往下帶。混合效果的位置尺度模型帶著收縮估計同一個量,兩個層次都容許放變異性的預測變項,並保留它的不確定性。
16.2 分三步組裝這個模型
混合效果的位置尺度模型分三步組裝最清楚,每一步都是前一步一眼認得出來的延伸。第一步是讓第一層變異數變成異質的(heterogeneous)。一般的混合模型假定每個人共用同一個殘差變異數(residual variance) \(\sigma^2\);第一次鬆綁讓這個變異數隨組別或隨共變項而不同,也就是第 14 章那塊熟悉的地盤:殘差的變異數函數(variance function)。第二步把變異數變成一個迴歸。對數線性的尺度次模型(log-linear scale submodel)不為每一組各給一個變異數,而是把個體內變異數的對數寫成預測變項的線性函數,\(\log \sigma^2_{it} = \alpha_0 + \alpha_1 x_{it}\),於是共變項可以抬高或壓低當下的變異性。對數連結(log link)不是偶然的:係數不論取什麼值,變異數都保持為正;係數也因此有乘性(multiplicative)的讀法,預測變項變動一個單位,變異數就乘以 \(e^{\alpha_1}\)。第三步在尺度次模型上加一個隨機效果。人與人在殘差波動性上的差異,超出共變項解釋得了的範圍,而隨機尺度效果(random scale effect) \(\omega_i\) 捕捉的正是這份差異,\(\log \sigma^2_{it} = \alpha_0 + \alpha_1 x_{it} + \omega_i\)。於是每個人都有屬於自己的基線波動性,正如位置次模型給每個人屬於自己的基線水準。
完整的模型把兩個次模型耦合起來,關鍵在於容許它們的隨機效果相關。位置次模型是 \(y_{it} = \gamma_{0} + \gamma_{1} x_{it} + u_{i} + \varepsilon_{it}\),其中 \(\varepsilon_{it} \sim N(0, \sigma^2_{it})\);尺度次模型是 \(\log \sigma^2_{it} = \alpha_0 + \alpha_1 x_{it} + \omega_i\);兩個屬於個人的效果則一起抽出來,\((u_i, \omega_i)' \sim N(\mathbf{0}, \mathbf{\Sigma})\),彼此之間有一個相關 \(\rho\)。圖 16.3 畫出這個架構。\(\rho\) 是最有實質分量的參數,它問的是:平均起來比較高的人,是不是也比較容易起伏?例如平均負向情緒較高的病人,情緒是不是也比較波動?兩階段分析問不出這個問題,因為它從來沒有把這兩個量放進同一個模型裡估計。表 16.2 列出這些參數以及各自的讀法。
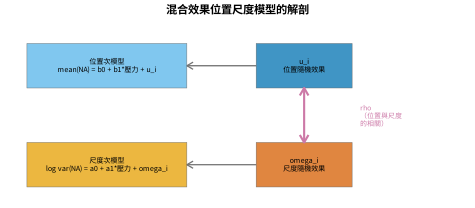
註:位置次模型在平均數上放一個屬於個人的隨機截距 \(u_i\);尺度次模型在個體內變異數的對數上放一個屬於個人的隨機截距 \(\omega_i\);個體內的預測變項可以進任一個次模型。兩個隨機效果由帶相關 \(\rho\) 的聯合分配一起抽出,這個位置尺度相關把一個人的水準與這個人的波動性連在一起。
表 16.2 位置尺度模型參數的詞彙表。
| 符號 | 次模型 | 解讀 |
|---|---|---|
| \(\gamma_1\) | 位置 | 預測變項對平均水準的效果 |
| \(\alpha_1\) | 尺度 | 預測變項對個體內變異數對數的效果;每一單位使變異數乘以 \(e^{\alpha_1}\) |
| \(u_i\) | 位置(隨機) | 個人在平均水準上的偏離;變異數 \(\tau_u^2\) |
| \(\omega_i\) | 尺度(隨機) | 個人在對數波動性上的偏離;變異數 \(\tau_\omega^2\) |
| \(\rho\) | 兩者 | 跨人的水準與波動性的相關 |
註:位置參數的讀法與一般混合模型相同。尺度參數要以乘性讀,因為那個次模型建在對數變異數上。相關 \(\rho\) 往往就是目標量,它把「誰高」與「誰起伏大」連起來。
這個模型比一般的混合模型難估計。概似(likelihood)要對兩個相關的隨機效果積分,其中一個還坐在變異數裡面,而這個積分沒有封閉解。有兩條路可走。一條是以適應性求積(adaptive quadrature)做最大概似(maximum likelihood),實作在 Hedeker 的專用程式裡 (Hedeker et al., 2008; Hedeker & Nordgren, 2013);這些程式為生態瞬時評估(ecological momentary assessment, EMA)資料開創了這個模型。另一條是以馬可夫鏈蒙地卡羅(Markov chain Monte Carlo)做貝氏估計,也就是本書採用的路線,它更容易推廣(generalize)到隨機尺度斜率(random scale slope)、兩層以上的結構,以及非高斯(non-Gaussian)的位置次模型 (Rast et al., 2012; Williams et al., 2019)。下面的實作分析走的是二維 Gauss-Hermite 求積(quadrature)的最大概似,這個實作(implementation)透明,還原的也是同一個估計標的(estimand);實務上建議的工具則是貝氏那一條,做法由第 17 章展開。這是刻意安排的交棒:位置尺度模型促成轉向貝氏的一步,下一章把它接過去。
基礎概念 • 為什麼對數變異數這個尺度要緊
尺度次模型在對數變異數上是線性的,這件事改變了「取平均」的意思。把一個人的離差平方(squared deviation)取平均,估計到的是變異數 \(\sigma_i^2\);再對這個估計值取對數,卻不會還原模型放常態隨機效果的那個量,因為 \(\mathbb{E}[\log s_i^2] \neq \log \mathbb{E}[s_i^2]\)。帶雜訊的變異數取對數之後會向下偏誤(biased downward),時點越少的人偏誤越大。兩階段地比較對數標準差,因此會把波動性上真實的差異,與抽樣精確度(sampling precision)造成的虛假(spurious)差異攪在一起。模型的做法不同:常態隨機效果 \(\omega_i\) 直接放在對數變異數這個尺度上,並以正確的不確定性估計。乘性的讀法也來自同一個連結。既然 \(\log \sigma^2_{it} = \alpha_0 + \alpha_1 x_{it} + \omega_i\),\(x\) 變動一個單位就讓變異數乘以 \(e^{\alpha_1}\)、標準差乘以 \(e^{\alpha_1/2}\),所以尺度效果要報告成倍數,不是差值。
16.3 配適這個模型
實作範例問的是:控制水準之後,當下的壓力能不能預測負向情緒的波動性?資料是模擬的日誌資料集 ema_lability,\(120\) 個人測到的提示次數不等,資料生成歷程(data-generating process)裡含有真正的隨機尺度效果,以及正向的位置尺度相關。個體內的壓力同時進入兩個次模型:進位置次模型,讓壓力抬高負向情緒的水準;進尺度次模型,讓壓力抬高波動性。壓力的位置效果(location effect)還原為 \(0.53\),接近真值,但有意思的發現在尺度次模型。壓力的尺度係數是 \(0.41\),標準誤(standard error) \(0.03\),在乘性的尺度上意思是:當下的壓力每上升一個單位,負向情緒的個體內變異數就乘以 \(e^{0.41} = 1.50\)。圖 16.4 把這件事畫成隨壓力上升的個體內標準差預測值,並附上不確定性帶(uncertainty band)。壓力不只抬高負向情緒的平均數,還讓負向情緒變得不穩定。第二個主張與第一個截然不同,而讓它變得可估計的正是尺度次模型。
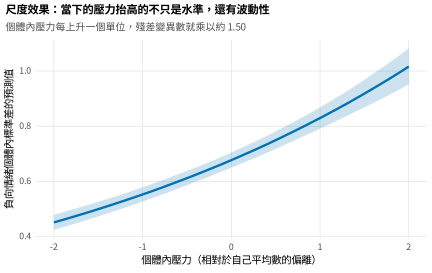
註:由尺度次模型算出的負向情緒個體內標準差預測值,隨個體內壓力變化,附 90% 的不確定性帶。當下的壓力每上升一個單位,殘差變異數就乘以約 \(1.5\)。尺度次模型把這個「使之不穩定」的效果,與壓力對平均水準的效果分開估計。
模型對兩階段指標的修補,在於把屬於個人的波動性估計值收縮起來。圖 16.5 把每個人原始的個體內對數標準差,與模型的經驗貝氏(empirical Bayes)估計值對照,橫軸是提示次數。原始估計值很極端,時點數最少的人尤其如此;模型則按它們的不可靠(unreliable)程度,成比例地把它們拉向團體。這正是第 13 章的收縮,如今施用在變異數上。收縮後的估計值不只比較平滑,而是真的比較好,這一點在這裡查得出來,因為真值已知:模型對個人波動性的估計值與真正的隨機尺度效果相關 \(0.90\),原始指標只有 \(0.81\)。位置尺度相關這個實質目標估計為 \(0.40\),標準誤 \(0.10\);圖 16.6 顯示背後那些屬於個人的效果的聯合分配,平均負向情緒較高的人,情緒上確實傾向比較波動。那個很寬的標準誤本身就是一課。位置尺度相關是二階(second-order)的量,取決於各人波動性的分散程度,估計精確度因此遠低於平均數效果;以它為估計目標的研究,需要比只瞄準平均數的研究更多的人、更多的時點。這是一項與第 4 章相接的檢定力(power)事實,誠實的報告必須承認。
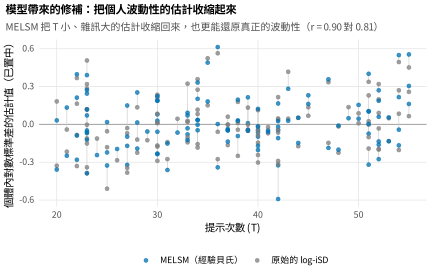
註:每個人原始的個體內對數標準差(灰)與模型的經驗貝氏估計值(藍),以線段相連,橫軸為提示次數。模型把時點少、雜訊大的估計值往團體平均數收縮。資料生成的真值已知,因此看得出收縮後的估計值比原始指標更能還原真正的個人波動性(相關 \(0.90\) 對 \(0.81\))。
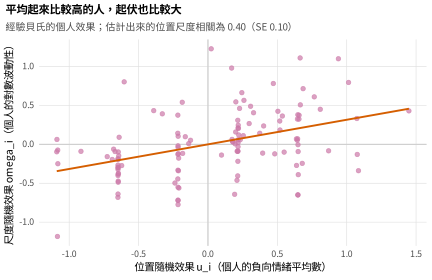
註:經驗貝氏的位置隨機效果(個人平均數)與尺度隨機效果(個人的對數波動性)的聯合分配。那條正斜率就是估計出來的位置尺度相關,這裡約為 \(0.40\),標準誤 \(0.10\)。兩階段分析取用不到這個相關,而它往往正是一項位置尺度研究的實質目標。
16.4 延伸與它的親戚
尺度次模型接受任何迴歸都接受的精緻化,其中兩項特別有用。第一,變異性的預測變項可以是時間本身,模型於是變成一項關於波動性在研究期間如何改變的陳述。圖 16.7 由一個時間變動的尺度模型還原出一條變異數軌跡,個體內波動性隨治療的週次遞減。變異性在這裡本身就是治療結果,是症狀的穩定化(stabilization),不是症狀水準的降低;一項治療即使在後者上進展緩慢,仍可能在前者上成功。第二項精緻化是分開個體間與個體內的變異數。隨機尺度效果為波動性上的個體間差異建模,尺度共變項則為它在個體內、時點與時點之間(occasion-to-occasion)的改變建模,而 Hedeker 的架構明確地把兩者分開 (Hedeker et al., 2012)。為個體內變異的個別差異而設的多層次做法早於這個完全耦合的模型,至今仍是有用的特例 (Hoffman, 2007)。
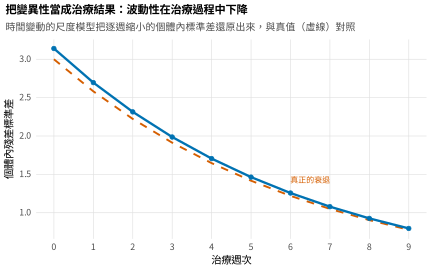
註:一個時間變動的尺度模型,個體內殘差標準差隨治療週次遞減。配適出來的衰退(藍)貼著真正的生成衰退(虛線)。變異性本身就是結果變項時,它在一項介入期間的軌跡就是研究發現,與平均水準上的任何改變截然不同。
位置尺度模型坐落在分配模型(distributional model)這一族之中,這族模型讓平均數以外的參數也隨共變項變化。表 16.3 畫出這一帶的地圖。雙重廣義線性模型(double generalized linear model)在廣義線性模型的離散度上放一個次模型。為位置、尺度與形狀而設的廣義加法模型(generalized additive models for location, scale and shape)讓一個有彈性的分配的每一個參數,包括偏態(skewness)與峰度(kurtosis),都能是共變項的平滑函數 (Rigby & Stasinopoulos, 2005)。變異數函數混合模型,以及現代軟體的離散度(dispersion)公式,能快速配適固定(fixed)的尺度次模型。多層次教育研究裡的變異數建模傳統,則從另一個領域處理同一個結構 (Leckie et al., 2014)。它們共享同一個前提:值得建模的不只是中心,還有分散程度(spread)。
表 16.3 位置尺度模型與它的分配模型親戚。
| 模型 | 除了平均數還為什麼建模 | R 工具 |
|---|---|---|
| 混合效果位置尺度 | 個體內變異數,並帶一個隨機尺度效果 | brms(分配模型) |
| 雙重廣義線性模型 | GLM 的離散度 | dglm |
| 變異數函數 GLMM | 殘差離散度,固定 | glmmTMB(dispformula) |
| GAMLSS | 位置、尺度、形狀皆為平滑函數 | gamlss |
註:分配模型讓平均數以外的參數也隨共變項變化。混合效果的位置尺度模型是這一族裡為縱貫資料加上隨機尺度效果的那一位;其餘幾位則以隨機尺度換取分配形式上的彈性,或換取固定尺度次模型的速度。
最後一項延伸關乎把估計出來的變異性拿到下游使用。一個人的尺度效果 \(\omega_i\) 若要在後續分析中當預測變項或結果變項,就不能縮成一個點估計值(point estimate)再代進去:那會丟掉它的不確定性,讓第二階段的結果產生偏誤,也就是把收縮後的估計值當成資料時一定會犯的代入謬誤。正確的做法是把 \(\omega_i\) 的完整後驗分配帶到下游,或者把兩個階段聯合配適,或者傳遞後驗抽樣(posterior draws),好讓波動性估得很不準的人按比例少貢獻一些。貝氏路線在這裡格外自然,理由也在這裡:它產生的後驗抽樣,讓誠實的傳遞變得直截了當。
16.5 驗證、陷阱與報告
位置尺度模型下主張的地方在變異數結構,檢查就要落在那裡,工具是瞄準變異數特徵(variance feature)而非平均數的後驗預測檢查(posterior predictive check)。圖 16.8 把觀察到的每個人的個體內標準差分配,與配適好的模型複製出來的分配對照。觀察到的分配穩穩落在複製出來的分散範圍之內,這就是模型重現了那個波動性型態的證據,而模型本來就是為了解釋這個型態而建的。這一類檢查瞄準的是 iSD 跨人的分散程度,或屬於個人的變異數校準(calibration)得好不好,是一般後驗預測檢查在位置尺度模型上的對應物,每一份報告都該放。表 16.4 是報告檢核表,它在第 13 章的混合模型檢核表之上,再加上貝氏配適所需要的估計品質診斷(diagnostics),那一部分由第 17 章完整說明。
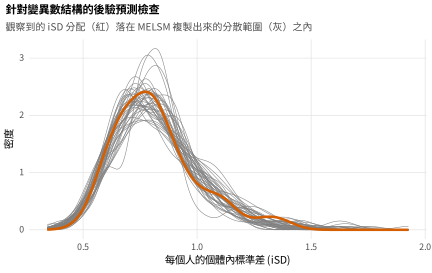
註:觀察到的每個人的個體內標準差分配(紅),對上配適好的位置尺度模型複製出來的四十條分配(灰)。觀察到的分配落在複製出來的分散範圍之內,表示模型重現了波動性的個體間型態。位置尺度模型的後驗預測檢查應該瞄準變異數特徵,不是平均數。
表 16.4 混合效果位置尺度模型的報告檢核表。
| 要素 | 要報告什麼 |
|---|---|
| 位置次模型 | 平均數結構的固定效果與隨機效果 |
| 尺度次模型 | 變異數的預測變項,以乘性讀,並附隨機尺度變異數 |
| 位置尺度相關 | 估計值與其不確定性,以及它的實質解讀 |
| 估計 | 使用的引擎;若為貝氏配適,附上收斂診斷(\(\hat{R}\)、有效樣本數、發散) |
| 設計是否足夠 | 人數與時點數相對於變異數目標是否足夠 |
| 驗證 | 瞄準變異數結構的後驗預測檢查 |
註:尺度次模型以乘性的變異數尺度報告;位置尺度相關要連同完整的不確定性一起報告,而那往往很寬。估計診斷屬於第 17 章展開的那套貝氏做法。
有三個陷阱一再出現。第一,把尺度係數當成原始標準差上的效果來讀,忽略了對數連結,會低估這個效果:尺度係數是變異數上的乘數(multiplier)。第二,從有界的量尺讀出「低變異性」可能是假象。靠近地板或天花板的人本來就沒什麼空間可以變動,表面上波動性的差異可能是喬裝過的水準差異,這與第 7 章討論相對變異性指數時的告誡相同。第三,把一個人波動性的點估計值當成結果變項使用,等於把它的不確定性洗掉(launder away),並使下游分析產生偏誤。三者都能靠這個模型本身提供的紀律避開。
16.6 在 R 中配適位置尺度模型
brms 的分配模型語法把兩個次模型寫在同一條式子裡:第一個給平均數,第二個冠上 sigma 前綴,給對數標準差,兩者各有自己的固定效果(fixed effects)與隨機效果。
library(brms)
# 位置:na ~ stress + (1 | person);尺度:log sigma ~ stress + (1 | person)
f <- bf(na    ~ stress_wc + (1 | p | person),
        sigma ~ stress_wc + (1 | p | person))   # 共用的 "p":讓兩個 RE 相關
m <- brm(f, data = ema, chains = 4, cores = 4)   # 先驗 + MCMC;見第 17 章
summary(m)                                        # 尺度效果在 log-SD 上
讓位置與尺度兩個隨機效果相關起來的,是共用的分組標籤 | p |,位置尺度相關就是這樣得到的。若只要固定效果、不要隨機尺度效果,尺度模型可以更快地由 nlme 的殘差變異數函數或 glmmTMB 的離散度公式取得,當踏腳石(stepping stone)用,或在不需要隨機尺度時直接用。
library(nlme)   # 固定的對數線性尺度:殘差 SD ~ exp(theta * stress)
m_fixed <- lme(na ~ stress_wc, random = ~1 | person, data = ema,
               weights = varExp(form = ~ stress_wc))
# glmmTMB 的替代做法:glmmTMB(na ~ stress_wc + (1|person),
#                              dispformula = ~ stress_wc, data = ema)
隨附的腳本 ch16_analysis_V01.R 收錄完整的分析:兩階段缺陷的示範、以二維 Gauss-Hermite 最大概似配適並取出經驗貝氏個人效果的完整位置尺度模型、尺度效果與位置尺度的圖示、變異數軌跡,以及瞄準變異數的後驗預測檢查。圖形由中文版的 ch16_figures_zh_V01.R 繪出,資料集由 gen_ema_lability_V01.R 產生。該腳本為了透明與可攜性而採最大概似;brms 用馬可夫鏈蒙地卡羅在一次呼叫裡配適同一個模型,是應用工作建議的工具,尺度次模型自己還帶隨機斜率時更是如此。
軟體提示 • 位置尺度模型的工具
有三族工具配適這個模型。Hedeker 的 MIXREGLS 程式與後繼者 MixWILD 以適應性求積的最大概似配適混合效果位置尺度模型,至今仍是參照實作(reference implementation),也多半具備一項少數工具才有的能力:讓位置隨機效果進入尺度模型。使用前請先確認它們目前是否仍可取得。brms 走的貝氏路線把這個模型表述成分配迴歸(distributional regression),能推廣到隨機尺度斜率、三層結構與非高斯的位置次模型,並產生下游傳遞所需要的後驗抽樣;它是本書的預設,也是第 17 章的主題。若只要固定效果的尺度模型,nlme 的變異數函數與 glmmTMB 的離散度公式又快又夠用。gamlss 套件則為橫斷資料配適更廣的位置、尺度與形狀那一族。
16.7 常見的迷思
關於個體內變異性,有幾個信念會誤導讀者。第一個是個體內標準差只要估得夠好,就跟模型一樣好。並不是。即使時點數很多,它仍然沒有收縮,承載不了共變項,而且水準與變異性只要有耦合,它就把兩者混淆。第二個是尺度次模型是一種異質變異數的修正。在這裡它就是假設本身,個體內變異數是感興趣的結果變項,不是要掃掉的干擾項。第三個是關於變異數的研究發現本質上比較難複製。真相是它們對設計的要求比較高,要更多的人與更多的時點;它們表面上的脆弱(fragility)多半是檢定力問題,交給第 4 章那套誠實的規劃處理。第四個是五波的追蹤資料就能支撐個體內變異數的建模。不能。每人寥寥幾個時點估不出那個人的波動性,這套方法屬於密集設計(intensive design)。
常見陷阱 • 位置尺度實作上的三個錯誤
第一,把尺度係數讀成原始標準差上的效果:尺度次模型建在對數變異數上,係數是變異數上的乘性倍數,報告成標準差上的差值會低估它。第二,把地板當成穩定:有界的量尺上,靠近邊界的人本來就變動不了多少,測到的低變異性可能是水準造成的假象,不是真正的穩定。第三,把個人波動性的點估計值代進去:把 \(\hat{\omega}_i\) 當成資料放進第二個分析,會丟掉它的不確定性並使結果產生偏誤,請改成把後驗帶到下游。
本章摘要
混合效果的位置尺度模型把個體內變異數變成依變項。它回答的是分散程度才是現象、平均數不是重點的那類問題:情緒不穩定、表現不一致、症狀波動性(圖 16.1)。兩階段個體內標準差有四項缺陷,也就是抽樣雜訊、缺少收縮、把水準與變異性混淆,以及拿到下游使用時的變項含誤差(圖 16.2、表 16.1);模型的修補是在個體內變異數上放一個對數線性次模型,給這個次模型一個隨機尺度效果,並讓尺度效果與位置效果相關(圖 16.3、表 16.2)。尺度係數要以乘性讀,因為那個次模型建在對數變異數上(圖 16.4)。屬於個人的波動性估計值被收縮,因而比原始指標更能還原真值(圖 16.5)。位置尺度相關這個實質目標把「誰高」與「誰起伏大」連起來,但估計出來的不確定性很寬(圖 16.6)。尺度次模型可以延伸成一條隨時間的變異數軌跡,讓穩定化成為一項治療結果(圖 16.7);這個模型也坐落在一整族分配模型親戚之中(表 16.3)。驗證要透過後驗預測檢查瞄準變異數結構(圖 16.8、表 16.4)。而這個模型的估計,正是貝氏方法變得必要的那個自然節點。
接下來要去哪裡
本章刻意停在貝氏估計的門檻上。位置尺度模型在這裡為了透明而以最大概似配適,但它自然的引擎是馬可夫鏈蒙地卡羅:隨機尺度斜率、多層次的延伸,以及最大概似很吃力才給得出來的後驗傳遞,它都處理得了。第 17 章完整提供這套做法。想先拿到食譜再回頭補理論的讀者,現在就可以用 brms 配適本章的模型,之後再回到第 17 章求理解。個體內變異數會在本書密集縱貫的部分一再出現:第 25 章為動態模型的創新變異數(innovation variance)裡的異質性建模,那是隨機尺度效果的動態版表親;第 33 章與第 35 章則把情緒不穩定部署成臨床與人格上的構念。「值得建模的不只是中心,還有分散程度」這一課,會出現在每一個測量得夠密、密到足以看出它擺盪多大的歷程上。
習題
- 16.1 缺陷示範。模擬一批時點數不等、真實波動性卻相同的人,顯示依原始個體內標準差排序有多不穩定,而位置尺度模型收縮後的估計值不會如此。
- 16.2 配適尺度次模型。挑一個日誌結果變項,配適一個位置尺度模型,兩個次模型都放進同一個個體內預測變項,再寫出尺度次模型的結果段落,以乘性的變異數尺度報告效果。
- 16.3 尺度隨機斜率。把模型延伸成允許預測變項對波動性的效果隨人而異,誠實評估收斂,並報告資料撐不撐得起這份額外的複雜度。
- 16.4 瞄準變異數的檢查。提出並實作兩項瞄準變異數結構的後驗預測檢查,解讀各自能揭露尺度次模型的哪一種設定錯誤。
- 16.5 位置、尺度,還是兩者。針對三個研究問題,判定各自關切的是水準、變異性,還是兩者的關係,並設定回答得了它的次模型。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 混合效果位置尺度模型 | mixed-effects location-scale model (MELSM) | 平均數與個體內變異數各有一個次模型,兩者的隨機效果相關;第 16.2 節 |
| 位置次模型 | location submodel | 為平均數建模的那個次模型;第 16.2 節 |
| 尺度次模型 | scale submodel | 為個體內變異數的對數建模的那個次模型;第 16.2 節 |
| 對數線性的尺度次模型 | log-linear scale submodel | 把對數變異數寫成預測變項的線性函數;第 16.2 節 |
| 隨機尺度效果 | random scale effect | 屬於個人的對數變異數偏離 \(\omega_i\);第 16.2 節 |
| 位置尺度相關 | location-scale correlation | 個人水準與個人波動性的相關 \(\rho\);第 16.2 節 |
| 個體內標準差 | intraindividual standard deviation (iSD) | 一次算一個人的原始變異性指標(承第 7 章);第 16.1 節 |
| 代入謬誤 | plug-in fallacy | 把帶雜訊的估計值當成已知量帶進下游分析;第 16.1 節 |
| 變項含誤差 | error-in-variables | 預測變項本身帶測量誤差所造成的偏誤;第 16.1 節 |
| 經驗貝氏 | empirical Bayes | 以估計出來的母體分配為先驗算出的個人效果;第 16.3 節 |
| 分配模型 | distributional model | 讓平均數以外的參數也隨共變項變化的模型族;第 16.4 節 |
| 後驗預測檢查 | posterior predictive check | 把觀察到的特徵與模型複製出來的特徵對照;第 16.5 節 |
參考文獻
Bürkner, P.-C. (2017). brms: An R package for Bayesian multilevel models using Stan. Journal of Statistical Software, 80(1), 1–28. https://doi.org/10.18637/jss.v080.i01
Ebner-Priemer, U. W., Eid, M., Kleindienst, N., Stabenow, S., & Trull, T. J. (2009). Analytic strategies for understanding affective (in)stability and other dynamic processes in psychopathology. Journal of Abnormal Psychology, 118(1), 195–202. https://doi.org/10.1037/a0014868
Hedeker, D., Mermelstein, R. J., & Demirtas, H. (2008). An application of a mixed-effects location scale model for analysis of ecological momentary assessment (EMA) data. Biometrics, 64(2), 627–634. https://doi.org/10.1111/j.1541-0420.2007.00924.x
Hedeker, D., Mermelstein, R. J., & Demirtas, H. (2012). Modeling between-subject and within-subject variances in ecological momentary assessment data using mixed-effects location scale models. Statistics in Medicine, 31(27), 3328–3336. https://doi.org/10.1002/sim.5338
Hedeker, D., & Nordgren, R. (2013). MIXREGLS: A program for mixed-effects location scale analysis. Journal of Statistical Software, 52(12), 1–38. https://doi.org/10.18637/jss.v052.i12
Hoffman, L. (2007). Multilevel models for examining individual differences in within-person variation and covariation over time. Multivariate Behavioral Research, 42(4), 609–629. https://doi.org/10.1080/00273170701710072
Hultsch, D. F., MacDonald, S. W. S., & Dixon, R. A. (2002). Variability in reaction time performance of younger and older adults. The Journals of Gerontology: Series B, Psychological Sciences and Social Sciences, 57(2), P101–P115. https://doi.org/10.1093/geronb/57.2.P101
Jahng, S., Wood, P. K., & Trull, T. J. (2008). Analysis of affective instability in ecological momentary assessment: Indices using successive difference and group comparison via multilevel modeling. Psychological Methods, 13(4), 354–375. https://doi.org/10.1037/a0014173
Leckie, G., French, R., Charlton, C., & Browne, W. (2014). Modeling heterogeneous variance-covariance components in two-level models. Journal of Educational and Behavioral Statistics, 39(5), 307–332. https://doi.org/10.3102/1076998614546494
Rast, P., Hofer, S. M., & Sparks, C. (2012). Modeling individual differences in within-person variation of negative and positive affect in a mixed effects location scale model using BUGS/JAGS. Multivariate Behavioral Research, 47(2), 177–200. https://doi.org/10.1080/00273171.2012.658328
Rigby, R. A., & Stasinopoulos, D. M. (2005). Generalized additive models for location, scale and shape. Journal of the Royal Statistical Society: Series C (Applied Statistics), 54(3), 507–554. https://doi.org/10.1111/j.1467-9876.2005.00510.x
Wang, L. P., Hamaker, E. L., & Bergeman, C. S. (2012). Investigating inter-individual differences in short-term intra-individual variability. Psychological Methods, 17(4), 567–581. https://doi.org/10.1037/a0029317
Williams, D. R., Zimprich, D. R., & Rast, P. (2019). A Bayesian nonlinear mixed-effects location scale model for learning. Behavior Research Methods, 51(5), 1968–1986. https://doi.org/10.3758/s13428-019-01255-9
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。