第 27 章
連續時間模型
前面每一個動態模型都藏著同一項依賴,本章要把它挑明。交叉延宕追蹤模型(cross-lagged panel model)的延宕係數、向量自我迴歸的自我迴歸(autoregression)、日記研究的延續效果(carryover),全都是觀察間隔的函數。兩份研究針對的是同一個歷程(process),一份隔一個月測、一份隔六個月測,估出來的數字就不一樣,甚至會在「兩個變項中哪一個領先」這件事上彼此矛盾。這不是加一個註腳就打發得掉的麻煩,而是對整片文獻可比較性(comparability)的威脅。連續時間(continuous-time)模型的解法,是不在製造出這個問題的離散步伐裡工作。它不用綁在單一間隔上的延宕係數,而是直接以漂移矩陣(drift matrix)為底層的歷程本身參數化(parameterize),由那個矩陣支配系統怎麼在時間中流動;觀察時點再怎麼不規則,都當成資料,而不是一格固定的網格。任何間隔上的離散效果,於是由漂移經一個關係還原出來,那就是矩陣指數(matrix exponential),本章的延宕翻譯器。本章先說服你:間隔依賴(interval dependence),也就是第 20 章所稱的區間依賴,是真的,也是有後果的;承擔這件事的是效果對間隔曲線,那張圖應該成為每一位讀者的反射。接著本章讓你有能力配適連續時間模型,並透過一次擾動(perturbation)的半衰期(half-life)解讀它。它值得那份概念上的額外成本,是因為它交出了一種通貨(currency):有了漂移矩陣,設計不同的研究終於可以互相比較。它的引擎就是第 26 章的狀態空間(state-space)形式,只是轉移改由微分方程(differential equation)支配,所以那套做法你早就有了。
學習目標
讀完本章之後,你應該能夠:(1) 用 \(\boldsymbol{\Phi}(\Delta t) = e^{\mathbf{A}\Delta t}\) 這個關係示範並解釋間隔依賴,說明一個交叉延宕的結論怎麼隨間隔而改變;(2) 解讀漂移矩陣 \(\mathbf{A}\):為負的對角線是回復速率(mean-reversion rate),半衰期為 \(\ln 2 / |a_{ii}|\),非對角線是連續時間的耦合(coupling),並一併解讀擴散(diffusion);(3) 把一個配適好的連續時間模型翻譯成任何間隔上隱含的離散效果,交出效果對間隔曲線;(4) 把 Ornstein-Uhlenbeck 歷程讀成帶著平衡點(equilibrium)與回復速率的連續時間 AR(1);(5) 對單一受試者、密集與不等間隔的追蹤資料配適連續時間模型,還原出逐人的半衰期;(6) 診斷識別(identification)與取樣率(sampling rate)的現實,包括振盪的漂移與疊頻(aliasing);(7) 判斷連續時間建模什麼時候值得付出相對於第 25 章離散化策略的額外成本。
27.1 間隔的醜聞
推動整章的那個事實令人不安:離散時間的動態係數,離開它的間隔就沒有意義。設想一個連續的歷程(process),壓力隨時間把負向情緒往上推。三支研究團隊研究它,一支每半個時間單位取樣一次,一支每兩個單位,一支每四個單位;每一支都配適一個交叉延宕(cross-lag)模型,並報告壓力對後來負向情緒的效果。圖 27.1 是他們的發現:交叉延宕效果分別是 \(0.10\)、\(0.19\) 與 \(0.14\)。三支團隊看起來彼此不合,比對這三篇論文的讀者可能會斷定這個效果很脆弱,或者這些研究互相牴觸。但三者都對,都是同一個底層系統在不同取樣率下的正確估計值。離散的交叉延宕不是這個歷程單獨的性質,而是歷程乘上間隔的性質;報告它卻不報告間隔,就像報告一個速度卻不給時間單位。
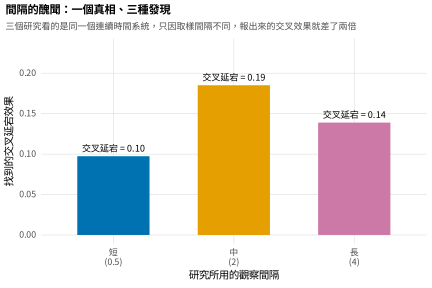
註:三份研究看的是同一個連續時間系統,取樣間隔分別為 \(0.5\)、\(2\) 與 \(4\) 個時間單位,報出來的交叉延宕效果卻差了將近兩倍。沒有一份是錯的;每一份都是在不同的間隔上讀同一個底層歷程。離散的交叉延宕離開它的間隔就沒有意義。
產生這種行為的關係就是本章的主方程式,先在數值上見一面,再談形式。底層的連續動態若由漂移矩陣(drift matrix) \(\mathbf{A}\) 支配,跨越間隔 \(\Delta t\) 的離散轉移矩陣(transition matrix)就是矩陣指數(matrix exponential) \(\boldsymbol{\Phi}(\Delta t) = e^{\mathbf{A}\Delta t}\);轉移矩陣裝的正是離散模型在那個間距上會估出來的自我迴歸與交叉延宕。把單一個漂移矩陣餵進這個關係,跑過一整排間隔,就得到圖 27.2 的效果對間隔曲線。那是本章的核心圖,也是要內化下來的那一張。自效果(auto-effect)是對角線上的元素,隨著間隔變長而由 \(1\) 單調衰減(decay)到零,因為一個變項對它自己遙遠過去的依賴會淡去。交叉效果(cross-effect)是非對角線上的元素,行為更有意思:極短的間隔上它從接近零開始,影響還沒有時間累積(accumulate);中等的間隔上升到高峰,這裡靠近 \(\Delta t = 2\);再長就隨著整個系統被沖淡而下降。在極短間隔上取樣的研究幾乎找不到交叉效果,可能斷定它不存在;落在高峰上的研究會發現它很強;長間隔的研究則會發現它又變弱了。存在一個讓效果最容易被偵測到的最適間隔(optimal interval),這一點由 Dormann and Griffin (2015) 發展出來;而一份離散研究報告的那個單一數字,只是這條曲線上的一個抽樣(draw)。帶有回饋(feedback)的系統裡,兩條交叉效果還會隨間隔改變大小順序,於是哪一個變項看起來領先竟取決於間距,這是 Kuiper and Ryan (2018) 分析過的一項危害。第 20 章為潛在變化分數提出的間隔告誡、第 21 章的跨研究可比較性問題、第 25 章離散化(discretization)帶來的粗化(coarsening),全都是同一個底層真相的不同側面。
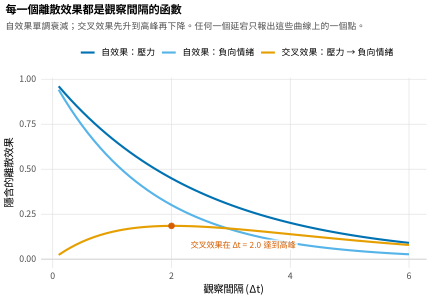
註:一個固定的漂移矩陣經由 \(\boldsymbol{\Phi}(\Delta t) = e^{\mathbf{A}\Delta t}\) 所隱含的離散自效果與交叉效果,畫成間隔 \(\Delta t\) 的函數。自效果單調衰減;交叉效果升到靠近 \(\Delta t = 2\) 的高峰之後下降。任何一份離散研究都只報出這些曲線上的一個點。這是本章的反射圖。
27.2 連續時間模型
這些曲線底下的模型是一個隨機微分方程(stochastic differential equation),它的符號帶著撐得過形式化的心理學意義。以 \(\boldsymbol{\eta}(t)\) 表示連續時間 \(t\) 上的潛在狀態(latent state)向量,方程式 \(d\boldsymbol{\eta}(t) = \big(\mathbf{A}\,\boldsymbol{\eta}(t) + \mathbf{b}\big)\,dt + \mathbf{G}\,d\mathbf{W}(t)\) 有三個部分。漂移項 \(\mathbf{A}\,\boldsymbol{\eta}(t)\,dt\) 是決定性(deterministic)的那份拉力:任何一個瞬間,系統都被拉往漂移矩陣作用在當下狀態上所設定的方向;歷程若會回復到平衡點,這份拉力就是往平衡點回去。截距 \(\mathbf{b}\) 決定那個平衡點的位置。擴散項 \(\mathbf{G}\,d\mathbf{W}(t)\) 是持續不斷的隨機輸入,是創新(innovation)在連續時間中的對應物。其中 \(\mathbf{W}(t)\) 是一個 Wiener 歷程(Wiener process),也就是連續時間中的隨機漫步(random walk),它的增量獨立且高斯,是那些讓系統一直活著、永不停歇的小衝擊(shock)的來源。要用這個模型並不需要測度論(measure theory):漂移是系統被拉往哪裡,擴散是它一路上被搖晃得多厲害。
漂移矩陣是要拿來解讀的那個物件,而它的對角線正是本章交得出來最可解讀的通貨。一個為負的對角元素 \(a_{ii}\) 就是一個回復速率:它越負,這個變項受擾動之後被拉回平衡點(equilibrium)的速度就越快。那個速率翻譯成一個半衰期(half-life),也就是一次擾動衰減到一半大小所需要的時間,由 \(\ln 2 / |a_{ii}|\) 給出。這正是第 24 章對自我迴歸做過的那個詮釋動作,只是改在連續時間裡進行,而且不依賴任何取樣間隔。一個 \(-0.40\) 的漂移自效果對應到 \(1.73\) 個時間單位的半衰期,一個 \(-0.60\) 的則對應到 \(1.16\)。非對角的元素是連續時間的交叉效果,是一個變項對另一個變項的瞬時耦合,它們帶著與第 25 章離散交叉延宕相同的詮釋紀律:它們是條件的(conditional)、嵌在系統裡的量,不是孤立的因果(causal)箭號,而且沒有標準化(standardization)就不可以跨「量尺不同的變項」比較。表 27.1 把連續與離散兩套詞彙並排,表 27.2 則連同半衰期一起解讀那些漂移參數。
表 27.1 離散時間與連續時間的對應。
| 離散時間的物件 | 連續時間的物件 | 兩者的關係 |
|---|---|---|
| 轉移矩陣 \(\boldsymbol{\Phi}(\Delta t)\) | 漂移矩陣 \(\mathbf{A}\) | \(\boldsymbol{\Phi}(\Delta t) = e^{\mathbf{A}\Delta t}\) |
| 自我迴歸 \(\phi_{ii}(\Delta t)\) | 回復速率 \(a_{ii}<0\) | 半衰期 \(\ln 2 / |a_{ii}|\) |
| 交叉延宕 \(\phi_{ij}(\Delta t)\) | 連續的交叉效果 \(a_{ij}\) | 對 \(\Delta t\) 非單調 |
| 創新共變數 \(\mathbf{Q}(\Delta t)\) | 擴散 \(\mathbf{G}\mathbf{G}^{\top}\) | Van Loan 積分 |
| 截距 | 平衡點 \(-\mathbf{A}^{-1}\mathbf{b}\) | 長期的平均數 |
註:漂移矩陣是與間隔無關的那個參數化方式;任何間距上的離散轉移都由矩陣指數還原出來。擴散是創新共變數在連續時間中的來源,而創新共變數本身仍然依賴間隔。
表 27.2 解讀漂移矩陣,連同半衰期。
| 漂移元素 | 數值 | 半衰期 | 讀法 |
|---|---|---|---|
| \(a_{\text{壓力}}\)(自效果) | \(-0.40\) | \(1.73\) | 壓力以 \(1.73\) 個單位的半衰期回復到平衡點 |
| \(a_{\text{負向情緒}}\)(自效果) | \(-0.60\) | \(1.16\) | 負向情緒回復得更快,半衰期 \(1.16\) |
| \(a_{\text{負向情緒,壓力}}\)(交叉) | \(+0.25\) | – | 壓力持續不斷地把負向情緒往上推 |
| \(a_{\text{壓力,負向情緒}}\)(交叉) | \(0.00\) | – | 在這個系統裡,情緒對壓力沒有回饋 |
註:自效果是回復速率,讀成半衰期,是那個與間隔無關、可解讀的通貨。交叉效果是連續的耦合,它在任何間隔上的離散大小都跟著效果對間隔曲線走。數值取自 ct_sim。表中「不適用」以短橫線標示。
連續時間能夠涵蓋任何間距,理由在那個精確的離散解。跨越一個間隔 \(\Delta t\),這個歷程精確地滿足 \(\boldsymbol{\eta}_{t} = e^{\mathbf{A}\Delta t}\,\boldsymbol{\eta}_{t-1} + \mathbf{w}_t\);\(\mathbf{w}_t\) 是高斯的,它的共變數是擴散在這個間隔上的一個積分,用基礎概念方塊記下的 Van Loan 方法算出來。同一個漂移矩陣因此在每一個間隔上都生成正確的離散動態。於是一份間距混雜的資料,日間空隙短、跨夜空隙長,處理起來不必假裝那些空隙相等。測量那一層就是第 26 章的狀態空間觀察方程式:連續的狀態透過一個負荷量矩陣(loading matrix)被觀察到,並帶著測量誤差(measurement error)。配適這個模型的引擎,就是那一章的卡爾曼濾波器(Kalman filter),只是轉移矩陣在每一個時點依它自己的間隔重算一次。Ornstein-Uhlenbeck 歷程是那個純量(scalar)的情形,也就是連續時間的一階自我迴歸(first-order autoregressive, AR(1)),是建立直覺最好的起點。圖 27.3 呈現它的樣本路徑:每一條都以自效果所設定的速率被拉回平衡點,永遠被擴散推開,也永遠被拉回來,而半衰期標示出一次偏離衰減得多快。它的定態(stationary)分配有一個變異數,基礎概念方塊會給出。整幅圖像把第 9 與第 20 章預告過的向量場(vector field)與吸引子(attractor)直覺形式化了。
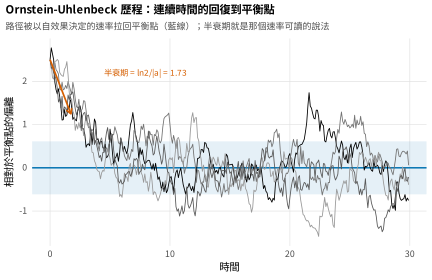
註:一個 Ornstein-Uhlenbeck 歷程的四條樣本路徑,那就是連續時間的 AR(1)。每一條都以自效果所設定的速率被拉向平衡點(藍線),並被擴散搖晃;陰影帶是一個定態標準差。半衰期,也就是那支紅色箭號,是回復速率可解讀的摘要。
基礎概念 • 矩陣指數、精確的離散解,與 OU 的變異數
矩陣指數由與純量情形相同的級數定義,\(e^{\mathbf{A}\Delta t} = \mathbf{I} + \mathbf{A}\Delta t + \tfrac{1}{2}(\mathbf{A}\Delta t)^2 + \tfrac{1}{6}(\mathbf{A}\Delta t)^3 + \cdots\);漂移 \(\mathbf{A}\) 若可對角化(diagonalizable)成 \(\mathbf{A} = \mathbf{V}\boldsymbol{\Lambda}\mathbf{V}^{-1}\),它就乾淨地算成 \(\mathbf{V}\,e^{\boldsymbol{\Lambda}\Delta t}\,\mathbf{V}^{-1}\),其中 \(e^{\boldsymbol{\Lambda}\Delta t}\) 只是把那些特徵值(eigenvalue)取指數。對純量漂移 \(a = -0.40\) 與 \(\Delta t = 2\),這給出 \(e^{-0.8} = 0.449\),也就是一份延宕兩個單位的研究會估出來的離散自我迴歸。精確的離散解隨之而來:把這個隨機微分方程在 \([t-\Delta t, t]\) 上積分,得到 \(\boldsymbol{\eta}_t = e^{\mathbf{A}\Delta t}\boldsymbol{\eta}_{t-1} + \mathbf{w}_t\),其中 \(\mathrm{Cov}(\mathbf{w}_t) = \int_0^{\Delta t} e^{\mathbf{A}s}\,\mathbf{G}\mathbf{G}^{\top}\,e^{\mathbf{A}^{\top}s}\,ds\),也就是被積分過的擴散。它不必作數值積分,用 Van Loan 的把戲即可取得:把區塊矩陣 \(\left[\begin{smallmatrix} -\mathbf{A} & \mathbf{G}\mathbf{G}^{\top} \\ \mathbf{0} & \mathbf{A}^{\top}\end{smallmatrix}\right]\Delta t\) 取指數,再把它的右上區塊乘上轉移矩陣,就讀出那個共變數。至於純量的 Ornstein-Uhlenbeck 歷程,它的定態變異數是 \(\sigma^2 = -g^2/(2a)\),於是回復越強(\(a\) 越負)或擴散越弱,平衡帶就越緊,那正是 \(\sigma^2_\varepsilon/(1-\phi^2)\) 在連續時間中的對應物。
整個系統的性格由漂移矩陣的特徵值(eigenvalue)決定,那正是連續時間與第 32 章振盪子(oscillator)接上頭的地方。圖 27.4 呈現兩個系統。特徵值若是實數且為負,系統在受擾動之後平滑地衰減回平衡點,那就是工作範例裡回復到平衡點的行為。特徵值若是複數、實部為負而虛部不為零,系統就一邊回去一邊振盪(oscillate),越過平衡點再以一種阻尼(damped)的節奏盪回來;那是第 24 章遇過的二階振盪在連續時間裡的面貌,也是通往第 32 章微分方程振盪子的橋。特徵值的實部(real part)支配系統安頓下來的速度,虛部(imaginary part)支配它振盪的速度。圖 27.5 把同樣的動態畫成一個向量場:每一支箭都是漂移矩陣在狀態空間中該一點上施加的瞬時拉力,全部朝平衡點流動,並被交叉效果扳彎。這就把本書自第 9 章起以預告方式呈現的那些吸引子圖像形式化了。
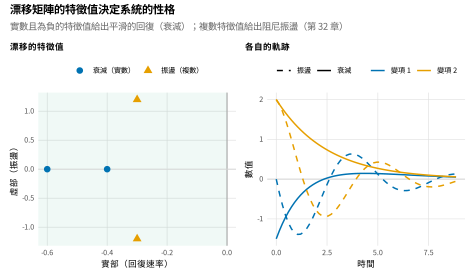
註:左:一個衰減系統(實數、為負)與一個振盪系統(複數)的特徵值在平面上的位置;陰影區標示穩定(實部為負)。右:兩者各自產生的軌跡,平滑的回復對照阻尼的振盪。特徵值的虛部是振盪的來源,也是通往第 32 章的橋。
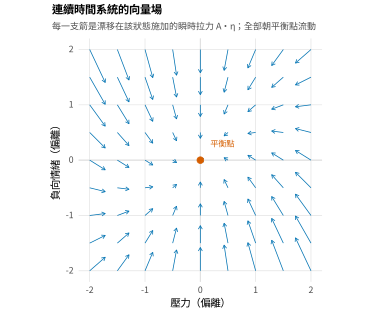
註:每一支箭都是漂移在該狀態上施加的瞬時拉力 \(\mathbf{A}\boldsymbol{\eta}\);全部朝平衡點(紅點)流動。那份不對稱,也就是流被扳彎的地方,正是壓力到情緒的交叉效果。這是第 9 與第 20 章那些吸引子預告的正式版本。
27.3 配適連續時間模型
這些模型的生產工具是 ctsem 套件。它設定一個連續時間模型,用頻率論(frequentist)的卡爾曼最大概似(maximum likelihood)配適,或用一個以 Stan 為底的階層貝氏(hierarchical Bayesian)模式配適,再回傳帶著不確定性的漂移矩陣。本章的分析自己寫了一具連續時間引擎:轉移用矩陣指數,歷程共變數用 Van Loan 積分,外加一個隨時間變動版本的第 26 章卡爾曼濾波器,在每一個時點依它自己的間隔把兩者重算一次。這樣做是為了讓整套做法能對照一個已知的真相逐項稽核;應用工作上該去拿的工具仍然是 ctsem,表 27.3 記下它的各種模式。工作階梯的第一階是還原。模擬一個帶著已知漂移矩陣的雙變項連續時間歷程,在不規則的間隔上取樣,再以最大概似配適連續時間模型,漂移就還原了出來:自效果回來成 \(-0.45\) 與 \(-0.56\),生成用的是 \(-0.40\) 與 \(-0.60\);壓力到情緒的交叉效果回來成 \(0.29\),生成用的是 \(0.25\);半衰期回來成 \(1.55\) 與 \(1.25\) 個單位,真值則是 \(1.73\) 與 \(1.16\),以單一條序列而言算是接近了。這個估計式從不等間隔的資料中還原出與間隔無關的動態,那正是整件事的重點。
# 延宕翻譯器與一次連續時間配適(手寫引擎)
library(Matrix)
A <- matrix(c(-0.40, 0.00,          # 漂移:為負的對角線就是回復速率
               0.25, -0.60), 2, 2, byrow = TRUE)
Phi <- function(dt) as.matrix(expm(A * dt))       # 間隔 dt 上的離散效果
Phi(0.5); Phi(2); Phi(4)            # 效果對間隔曲線,一次一個 dt
log(2) / abs(diag(A))               # 半衰期:1.73 與 1.16 個時間單位
# 以轉移的最大概似對不等間隔資料配適一個 CT-VAR(分析腳本中的 ct_fit_bivar):
# 先為每一個相異的間隔預先算好 Phi(dt) 與 Van Loan 的 Q*(dt),
# 再在 A 與擴散上最大化高斯的轉移概似。
fit <- ct_fit_bivar(Y = as.matrix(ct_sim[, c("stress","na")]), dtv = ct_sim$dt)
fit$A; fit$half_life                # 還原出來的漂移與半衰期
第二階是人。對每一個個體的序列配適一個連續時間 AR(1),就還原出一個逐人的回復速率,因而也還原出一個逐人的半衰期;而這些半衰期的分配(distribution),是一項以動態為通貨的個別差異(individual differences)發現。圖 27.6 同時呈現真實資料的分配與它的驗證。在 affect_ema 的 \(120\) 人中選了 \(80\) 人(執行時取的子集),用每個人實際的提示(beep)時戳(timestamp),也就是日間兩個半小時、跨夜十一個半小時的間隔,負向情緒的半衰期散得很開:中位數(median)靠近三小時,第十到第九十百分位數(percentile)的範圍由不到一小時到將近八小時。人與人在「情緒回到基線(baseline)有多快」上差別很大,這是一項逐人(person-specific)的參數。這樣的異質性(heterogeneity)還原得出來,由模擬確認:生成一批回復速率已知而各不相同的人,再逐一重新估計,還原出來的半衰期與真值相關 \(0.63\),在一份日記研究的序列長度下並不完美,但顯然帶著訊息。在 ctsem 的階層貝氏模式裡,這些逐人參數會連同它們的母體(population)分配一起估計,那正是第 25 章隨機效果那套跨人借力;而隨機自我迴歸在這裡再度以「來自一個漂移矩陣分配的抽樣」的身分登場。
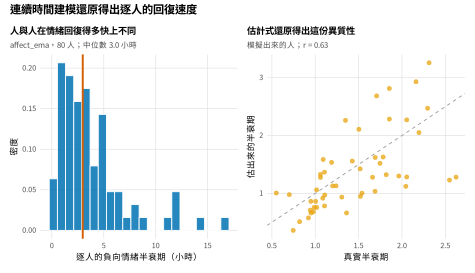
註:左:對 affect_ema 作連續時間 AR(1) 配適得到的逐人負向情緒半衰期分配,用的是每個人真實而不規則的時戳;中位數靠近三小時。右:一項模擬驗證,估出來的半衰期對照跨人的真實半衰期,以 \(0.63\) 的相關還原出這份異質性。
第三階是刻意的示範:連續時間不是只給密集資料用的,它也修補追蹤研究。設想一份只有少數幾波(wave)的追蹤(panel)研究,那幾波在不同的人身上落在真正不同的實際時間上,有些人隔一個月測、有些人隔三個月測。這正是離散模型會處理不好的情形,因為它把同一個延宕係數套在並不相等的間隔上。圖 27.7 呈現時點的柵狀圖(raster),每個人的施測各自落在自己的時間上,後果就放在旁邊。假裝間距相等的離散模型只報出單一個 \(0.14\) 的交叉延宕;真實的交叉效果卻隨著資料裡實際存在的那些間隔而變動,由最短間距上的大約 \(0.10\) 到最長間距上的 \(0.18\)。那份假裝把這一整段範圍壓成單一個數字,而這一次模擬報出的那個數字對應到大約 \(0.84\) 個時間單位的間距。\(0.84\) 只是一次抽樣的落點:同一份 \(200\) 人、\(5\) 波的模擬重複 \(300\) 次,合併估計值的平均是 \(0.1601\),圖上這一次的 \(0.14\) 落在第 \(22\) 百分位數。系統性的答案要看估計標的:定態之下,這個假裝等距的估計式的機率極限是轉移矩陣在間隔分配上的期望值,不是平均間隔上的轉移矩陣,而交叉效果在這份設計的間隔範圍上是凹的,由 Jensen 不等式得 \(0.1576\) 對照 \(0.1753\);把它放回效果對間隔曲線解出來的隱含間距是 \(1.08\),短於這份設計裡實際的平均間隔 \(1.42\)。連續時間模型還原出把上述全部正確生成出來的那個漂移矩陣。對照第 21 章的隨機截距(random intercept)交叉延宕追蹤模型,讀法是:連續時間加上去的,恰恰是跨人不等間距所要求的東西。所以任何一次連續時間配適,應用上的產出從來都不是那個原始的漂移本身,而是它的翻譯:讀者關心的那些間隔上隱含的(implied)離散矩陣、帶著不確定區間(interval)的半衰期,以及效果對間隔曲線,好讓這份結果與其他間距的研究比較得起來。
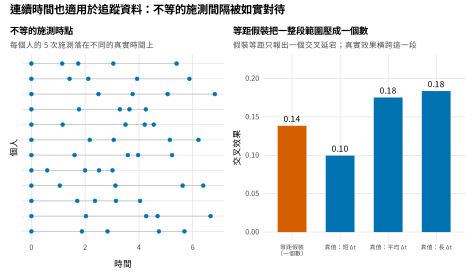
註:左:一份五波追蹤研究中逐人施測時點的柵狀圖;每個人的施測都落在不同的實際時間上。右:一個假裝間距相等的離散模型報出單一個交叉延宕(\(0.14\)),而真實的交叉效果在資料實際存在的那些間隔上橫跨 \(0.10\) 到 \(0.18\)。連續時間如實對待那份不相等的間距。
27.4 限制、誠實與選擇
連續時間很有力,但不是萬能,而它最重要的限制正是第 1 章以疊頻(aliasing)之名預告過的那一項,這裡改用矩陣指數這具透鏡重新看一次。歷程若運作得比取樣速度快得多,就還原不出來:兩次觀察之間,那些快的動態早已跑完,觀察值看起來幾乎彼此獨立,不帶任何關於回復速率的訊息。圖 27.8 把這件事量化。在一整排取樣間隔上估計一個快速歷程的回復速率,只要取樣間隔短於歷程的半衰期,半衰期就還原得不錯;間隔一旦超過半衰期,不確定性就炸開;等到間隔是半衰期的好幾倍,點估計本身也垮掉,漂移實際上就識別不出來了。這兩個位置量化得出來:不確定性在比值 \(3.9\) 附近炸開,點估計的中心則要到比值 \(7.8\) 才失效,中間那一段最危險,因為點估計看起來還好好的。圖上比值 \(5.19\) 那一格印的是一次抽樣;在同一個比值上重複估計,中位數只偏離真值 \(8\%\),垮掉的是離散程度,不是中心。實務上的讀法是:取樣率必須配上你希望研究的那個歷程的時間尺度,而那是一項事後任何分析都補救不了的設計決定。另外兩項限制界定了適用範圍。這裡呈現的模型是線性的;真正帶著非線性(nonlinear)動態、閾值(threshold)或依狀態而定之回復的歷程,要用第 32 章的非線性擴充。這裡也假設歷程在一個固定的平衡點附近是定態的;讓平衡點本身移動的連續時間成長模型是存在的,本章也引用了,但這套主力做法假設的是一個穩定的吸引子。
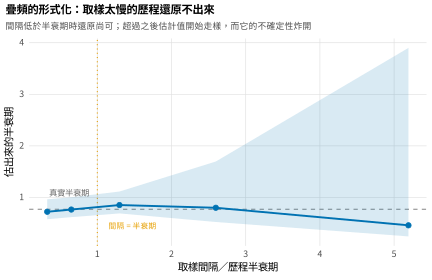
註:一個快速歷程估出來的半衰期,對照「取樣間隔比上真實半衰期」的比值。比值小於一(間隔在半衰期之下)時還原良好;越過之後不確定性,也就是那條陰影帶,先炸開,點估計要到比值數倍時才垮掉。圖上每一格印的都是一次抽樣;重複估計時,點估計的中心要到比值 \(7.8\) 附近才失效。取樣率必須配上歷程的時間尺度。
要不要付出連續時間那份概念成本,這個決定跟著資料的間隔結構走,圖 27.9 把它攤了出來。人之內或人之間的間隔變動很大時,連續時間值得,因為替代方案會誤述動態。間隔相等或幾乎相等時,一個離散模型就夠用,也比較簡單;而第 25 章動態結構方程模型的 TINTERVAL 離散化是一條中間路線,它把中度不等的間隔對齊到一格細網格上,不必動用完整的連續時間那一套做法。等距的假裝只有在間隔變異數小的時候才勉強可以接受,而本章的模擬把「什麼時候不可以」量化了出來:以追蹤範例那種很寬的間距變動來說,這份假裝顯著地錯過了那些依間隔而異的效果。更大的願景是可比較性,那也是這份額外成本值得學的理由。漂移矩陣與間隔無關,所以它是比較設計不同的研究、以及對動態作後設分析(meta-analysis)的天然共同通貨;後者是一個活躍的研究方向,目標是像一般後設分析彙整效果量(effect size)那樣,跨研究彙整漂移矩陣。表 27.4 以表格形式給出這個決定,表 27.5 則給出報告檢核表,而它不可讓步的那一項就是隱含間隔的翻譯。
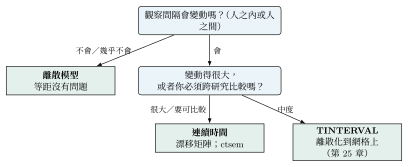
註:間隔相等或幾乎相等時,一個離散模型是可以的;中度不等的間隔可以用第 25 章的 TINTERVAL 離散化處理;顯著不等的間隔,或者跨研究比較的需要,就要用連續時間的漂移矩陣。代價是概念上的額外成本,回報是可比較性。
表 27.3 ctsem 的模式與設定。
| 模式/設定 | 它做什麼 | 使用指引 |
|---|---|---|
| 頻率論(卡爾曼 ML) | 最大概似的漂移,速度快 | 適合 \(N=1\) 與單一組的追蹤研究;用 delta 法(delta method)求區間 |
| 階層貝氏 | 經由 Stan 讓漂移在人與人之間隨機 | 帶彙整的逐人動態;需要先驗與執行時間 |
| 先驗(階層) | 在漂移/擴散上的弱訊息先驗 | 要報告出來;並探測其敏感度(第 17 章的素養) |
| 時間資料 | 提供實際的觀察時點 | 間隔結構是資料,不是一項假設 |
| 輸出的翻譯 | 在選定的 \(\Delta t\) 上隱含的離散矩陣 | 一律要報告;光有漂移還不是讀者讀得懂的東西 |
註:頻率論模式快速配適一個固定的漂移;階層貝氏模式估計逐人的漂移,並附上一個母體分配,承接第 17 章的貝氏工作流程。實際分析時請確認套件當時的介面。
表 27.4 連續時間什麼時候要緊。
| 情境 | 間隔結構 | 建議 |
|---|---|---|
| 等距的追蹤或密集縱貫資料 | \(\Delta t\) 為定值 | 離散模型就夠用;要把間隔報出來 |
| 輕度不等的間距 | 間隔變異數小 | 離散模型或 TINTERVAL(第 25 章);作敏感度檢查 |
| 嚴重不等的間距 | 間隔變異數大 | 用連續時間;假裝等距會誤導 |
| 跨研究比較 | 設計上就用了不同的間隔 | 用連續時間;漂移是共同的通貨 |
| 歷程快、取樣粗 | 間隔 \(\gg\) 半衰期 | 沒有任何模型還原得出來;請修正研究設計 |
註:等距的假裝只有在間隔變異數小的時候才勉強可以接受。間隔變動顯著,或者要跨研究比較,才是漂移矩陣賺回它額外成本的地方。沒有任何估計式克服得了「取樣對這個歷程而言太慢」。
常見陷阱 • 連續時間結果被誤讀的三種方式
第一,把漂移的交叉效果當成離散的交叉延宕來讀。瞬間上的連續交叉效果,不是一份離散研究在它自己的間隔上所報告的那個數字;兩者只透過效果對間隔曲線發生關係,所以一個 \(0.25\) 的漂移元素,在任何一個間距上都不是「一個 \(0.25\) 的交叉延宕」。第二,跨「量尺不同的變項」比較原始的漂移元素。這在連續時間裡,跟「在計量不同的預測變項(predictor)之間比較未標準化(unstandardized)迴歸係數」一樣沒有意義;要跨變項比較自效果或交叉效果,請先把漂移標準化。第三,相信連續時間解決得了混淆(confounding)。它解決的是間隔問題,還原出與間隔無關的動態,但對「一個被遺漏、卻同時驅動兩個被建模變項的變項」毫無辦法。第 25 與第 26 章那本告誡帳冊因此原封不動地轉移過來:連續時間的交叉效果是一個預測性的、嵌在系統裡的量,不是一張作因果主張的執照。
實務要點 • 起始值、先驗,以及「振盪還是雜訊」的問題
給最佳化器(optimizer)一組合理的漂移起始值(starting value):先在平均間隔上配適一個離散模型,取它轉移矩陣的矩陣對數(matrix logarithm)再除以那個間隔,當作初始的漂移。從任意值冷啟動經常收斂(converge)不了。在階層貝氏模式裡,把弱訊息先驗(weakly informative prior)放在漂移的對角線上,並讓它尊重那些元素的符號,回復到平衡點意味著為負;擴散上也要放先驗,而且都要報告出來、都要探測。在心理學的序列長度上,最難的識別問題是把真正的振盪,也就是複數的漂移特徵值,與雜訊區分開來。一條短而有雜訊的序列,可以顯示出取樣造成的假週期(cycle),所以一個振盪的漂移要通過敏感度檢查、最好還能跨人複製,才應該被接受。至於接近取樣率的振盪頻率(frequency)估計值,處理時要把疊頻的警告牢牢記在心裡。
軟體提示 • 連續時間軟體
主要的工具是 ctsem。它設定連續時間結構方程模型,並以兩種模式配適:一個快速的頻率論卡爾曼最大概似模式,以及一個以 Stan 為底、用一個母體分配估計逐人漂移矩陣的階層貝氏模式。這個套件把實際的觀察時點當成輸入,所以不等間距是原生地被處理的。第 26 章的 dynr 套件也具備連續時間能力,並加上了體制轉換(regime switching);OpenMx 則可以透過它那套狀態空間的做法表達連續時間模型。Mplus 目前並不配適真正的連續時間模型,它提供的最接近的近似是動態結構方程模型中的 TINTERVAL 離散化,那是把不等的間隔對齊到一格細網格,而不是為底層的微分方程作參數化。本章的分析一個也沒有用到這些工具,而是用矩陣指數、Van Loan 的被積分擴散,以及一個隨時間變動的卡爾曼濾波器,把連續時間引擎建了起來,好讓每一個關係都能對照一個已知的漂移矩陣被檢查。應用工作上的正確選擇仍然是那些套件,而它們的介面應該在實際分析時確認一次,因為這是一個正在積極發展的領域。
寫一份連續時間分析,有一項要求不可讓步,那也正是它有別於任何離散報告的地方:結果必須先以與間隔無關的形式給出,再翻譯成讀者用得上的那些間隔。報告要呈現帶著不確定性的漂移矩陣,把自效果轉成帶區間的半衰期,並在給出交叉效果時附上告誡,說明它們是連續的耦合,不是離散的交叉延宕。接著要翻譯:一到兩個具實質意義的間隔上隱含的離散轉移矩陣,最好還有效果對間隔曲線本身,好讓這項發現與其他間距的研究比較得起來。報告也要說明被建模的觀察時點(observation time)結構,註明用的是頻率論還是階層模式以及它的先驗,並誠實面對取樣率的限制,承認這份設計解析得了與解析不了哪些時間尺度(timescale)。示範的段落是這樣的:「本研究對不規則間隔的資料配適了一個雙變項連續時間模型,漂移矩陣以最大概似估計。負向情緒以 \(1.25\) 個時間單位的半衰期回復到平衡點(在這份日記資料中約為三小時),壓力的半衰期則為 \(1.55\);壓力對負向情緒有一個為正的連續時間效果,它隱含的離散交叉延宕在接近兩個單位的間隔上達到高峰。因為這個效果依賴間隔,我們一併報告在一個單位與四個單位間距上隱含的離散矩陣,好讓這些估計值能與使用那些延宕的研究比較。」
表 27.5 連續時間的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 漂移矩陣 | 估計值與不確定性;那個與間隔無關的參數化 |
| 半衰期 | 自效果化為 \(\ln 2 / |a_{ii}|\) 並附區間,用可解讀的時間單位 |
| 交叉效果 | 連續的耦合,並標明它們不是離散的交叉延宕 |
| 隱含的離散矩陣 | 在一到兩個實質間隔上的 \(\boldsymbol{\Phi}(\Delta t)\)(必要項) |
| 效果對間隔曲線 | 交叉效果跨間隔的樣子,最好畫出來 |
| 觀察時點 | 被建模的間隔結構;承認不規則的間距 |
| 估計 | 頻率論還是階層模式;若為貝氏則含先驗 |
| 取樣率的誠實 | 這份設計解析得了哪些歷程時間尺度 |
註:必要的那一項是隱含間隔的翻譯。漂移矩陣報告出來,卻沒有附上它在指名間隔上的離散意涵,讀者還是讀不懂;而可比較性,也就是使用連續時間的理由,正需要這一步。
本章摘要
離散時間的動態係數依賴觀察間隔,於是不同間距的研究會估出不同的數字,甚至會在「哪一個變項領先」上彼此矛盾;那是對一片文獻可比較性的威脅,不是一則腳註。連續時間模型以一個漂移矩陣為底層歷程參數化,並把觀察時點當成資料,藉此移除了這份依賴。任何間隔上的離散效果都由漂移經矩陣指數 \(\boldsymbol{\Phi}(\Delta t) = e^{\mathbf{A}\Delta t}\) 還原出來,而效果對間隔曲線顯示自效果單調衰減、交叉效果先升到高峰再下降,於是一個延宕只報出曲線上的一個點。漂移矩陣為負的對角線是回復速率,讀成半衰期,就是那個與間隔無關、可解讀的通貨;非對角線是連續的耦合;特徵值則決定這個系統是衰減還是振盪,那是通往第 32 章的橋。精確的離散解,也就是以矩陣指數得到的轉移與以 Van Loan 積分得到的歷程共變數,讓單一個漂移矩陣在每一個間距上都生成正確的動態,於是混雜而不等的間隔不必假裝相等就處理得了;配適的引擎就是第 26 章的卡爾曼濾波器,只是轉移逐間隔重算。這個估計式在 ct_sim 上從不規則的資料還原出一個已知的漂移,也還原出逐人的半衰期,而那些半衰期在 affect_ema 上的散布是一項真實的個別差異發現;它還修補了波次間距不等的追蹤研究,那種研究裡離散模型會把一整段真實效果壓成一個錯的數字。它的限制是誠實的:被取樣得比它半衰期慢得多的歷程會疊頻,還原不出來;線性而定態的模型有它的適用範圍;而連續時間解決的是間隔,不是被遺漏變項造成的混淆。用不用它,決定跟著間隔結構走;而它的回報,是把漂移矩陣當成跨研究比較與彙整動態的共同通貨,那正是每一份連續時間報告都必須把漂移翻譯成「指名間隔上隱含的離散效果」的理由。
習題
- 27.1 延宕翻譯器。用表 27.2 的漂移矩陣算出 \(\Delta t\) 為 \(0.5\)、\(2\) 與 \(4\) 上的轉移矩陣,重現圖 27.1 那三個看似互相牴觸的交叉延宕;再掃過一整排間隔畫出圖 27.2 的效果對間隔曲線,指出交叉效果的高峰落在哪個間距。
- 27.2 還原與翻譯。用 ctsem 對
ct_sim的不等間隔資料配適雙變項連續時間模型,把還原出來的自效果與半衰期對照生成的真值,再依表 27.5 寫出結果段落,一併交出一個單位與四個單位間距上隱含的離散矩陣。 - 27.3 逐人半衰期。用每個人真實的提示時戳,對
affect_ema逐人配適連續時間 AR(1),畫出負向情緒半衰期的分配並與圖 27.6 對照;說明只取 \(120\) 人中的 \(80\) 人這件事,會怎麼限制你對這份異質性所能作的陳述。 - 27.4 等距的假裝。對圖 27.7 那份波次間距不等的追蹤資料,分別配適一個假裝間隔相等的離散模型與一個連續時間模型,把兩者的估計標的對照清楚,並解釋那個單一的 \(0.14\) 為什麼只對應到 \(0.84\) 個時間單位,遠短於設計裡 \(1.42\) 的平均間隔。
- 27.5 手算與說明。以 \(a = -0.40\) 手算間隔為 \(2\) 時隱含的離散自我迴歸與 \(\ln 2 / |a|\) 的半衰期,再寫一份給非技術審查人的備忘錄,說明一個 \(0.25\) 的漂移交叉效果為什麼在任何間距上都不是「一個 \(0.25\) 的交叉延宕」。
- 27.6 取樣率的誠實。重現圖 27.8 的疊頻模擬,指出不確定性在哪個比值上先炸開、點估計又要到哪裡才垮掉;接著依表 27.4 判斷自己手上資料的間隔結構,並寫出第 27.4 節所要求的那段取樣率告白。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 連續時間模型 | continuous-time model | 以漂移矩陣為底層歷程參數化,把觀察時點當資料;第 27.2 節 |
| 間隔依賴 | interval dependence | 離散動態係數隨觀察間隔而變(第 20 章稱「區間依賴」);第 27.1 節 |
| 矩陣指數 | matrix exponential | \(\boldsymbol{\Phi}(\Delta t) = e^{\mathbf{A}\Delta t}\),本章的延宕翻譯器;第 27.1 節 |
| 效果對間隔曲線 | effect-versus-interval curve | 離散效果作為 \(\Delta t\) 的函數;本章的反射圖;第 27.1 節 |
| 漂移矩陣 | drift matrix | 支配瞬時拉力的矩陣 \(\mathbf{A}\);與間隔無關;第 27.2 節 |
| 回復速率 | mean-reversion rate | 為負的對角元素 \(a_{ii}\);越負回復越快;第 27.2 節 |
| 半衰期 | half-life | \(\ln 2 / |a_{ii}|\),擾動衰減到一半的時間(承第 24 章);第 27.2 節 |
| 擴散 | diffusion | \(\mathbf{G}\mathbf{G}^{\top}\),創新在連續時間中的來源;第 27.2 節 |
| Wiener 歷程 | Wiener process | 連續時間的隨機漫步,擴散的隨機輸入;第 27.2 節 |
| Ornstein-Uhlenbeck 歷程 | Ornstein-Uhlenbeck process | 連續時間的 AR(1),會回復到平衡點;第 27.2 節 |
| Van Loan 積分 | Van Loan integral | 以區塊矩陣指數求出被積分的擴散;第 27.2 節 |
| 疊頻 | aliasing | 取樣慢過歷程,動態就還原不出來(承第 1 章);第 27.4 節 |
參考文獻
Bergstrom, A. R. (1988). The history of continuous-time econometric models. Econometric Theory, 4(3), 365–383. https://doi.org/10.1017/S0266466600013359
Boker, S. M. (2001). Differential structural equation modeling of intraindividual variability. In L. M. Collins & A. G. Sayer (Eds.), New methods for the analysis of change (pp. 5–27). American Psychological Association. https://doi.org/10.1037/10409-001
Deboeck, P. R., & Preacher, K. J. (2016). No need to be discrete: A method for continuous time mediation analysis. Structural Equation Modeling: A Multidisciplinary Journal, 23(1), 61–75. https://doi.org/10.1080/10705511.2014.973960
Dormann, C., & Griffin, M. A. (2015). Optimal time lags in panel studies. Psychological Methods, 20(4), 489–505. https://doi.org/10.1037/met0000041
Driver, C. C., Oud, J. H. L., & Voelkle, M. C. (2017). Continuous time structural equation modeling with R package ctsem. Journal of Statistical Software, 77(5), 1–35. https://doi.org/10.18637/jss.v077.i05
Driver, C. C., & Voelkle, M. C. (2018). Hierarchical Bayesian continuous time dynamic modeling. Psychological Methods, 23(4), 774–799. https://doi.org/10.1037/met0000168
Hecht, M., & Zitzmann, S. (2021). Sample size recommendations for continuous-time models: Compensating shorter time series with larger numbers of persons and vice versa. Structural Equation Modeling: A Multidisciplinary Journal, 28(2), 229–236. https://doi.org/10.1080/10705511.2020.1779069
Kuiper, R. M., & Ryan, O. (2018). Drawing conclusions from cross-lagged relationships: Re-considering the role of the time-interval. Structural Equation Modeling: A Multidisciplinary Journal, 25(5), 809–823. https://doi.org/10.1080/10705511.2018.1431046
Oravecz, Z., Tuerlinckx, F., & Vandekerckhove, J. (2009). A hierarchical Ornstein–Uhlenbeck model for continuous repeated measurement data. Psychometrika, 74(3), 395–418. https://doi.org/10.1007/s11336-008-9106-8
Oravecz, Z., Tuerlinckx, F., & Vandekerckhove, J. (2011). A hierarchical latent stochastic differential equation model for affective dynamics. Psychological Methods, 16(4), 468–490. https://doi.org/10.1037/a0024375
Oud, J. H. L., & Jansen, R. A. R. G. (2000). Continuous time state space modeling of panel data by means of SEM. Psychometrika, 65(2), 199–215. https://doi.org/10.1007/BF02294374
Ryan, O., Kuiper, R. M., & Hamaker, E. L. (2018). A continuous-time approach to intensive longitudinal data: What, why, and how?. In K. van Montfort, J. H. L. Oud, & M. C. Voelkle (Eds.), Continuous time modeling in the behavioral and related sciences (pp. 27–54). Springer. https://doi.org/10.1007/978-3-319-77219-6_2
Uhlenbeck, G. E., & Ornstein, L. S. (1930). On the theory of the Brownian motion. Physical Review, 36(5), 823–841. https://doi.org/10.1103/PhysRev.36.823
van Montfort, K., Oud, J. H. L., & Voelkle, M. C. (Eds.). (2018). Continuous time modeling in the behavioral and related sciences. Springer. https://doi.org/10.1007/978-3-319-77219-6
Voelkle, M. C., & Oud, J. H. L. (2013). Continuous time modelling with individually varying time intervals for oscillating and non-oscillating processes. British Journal of Mathematical and Statistical Psychology, 66(1), 103–126. https://doi.org/10.1111/j.2044-8317.2012.02043.x
Voelkle, M. C., Oud, J. H. L., Davidov, E., & Schmidt, P. (2012). An SEM approach to continuous time modeling of panel data: Relating authoritarianism and anomia. Psychological Methods, 17(2), 176–192. https://doi.org/10.1037/a0027543
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。