第 25 章
向量自我迴歸、多層次 VAR 與動態 SEM
這是第六部分的旗艦,把貫穿全書的兩條線索,也就是多變量與多層次,綁成同一個結。第 24 章教的是一個人身上一個變項的動態;本章加進其他變項,問題就不再是一種情緒如何把自己帶向下一刻,而是一套由情緒與壓力構成的系統如何在這個人之內隨時間彼此驅動。再加進其他人,動態本身就成了隨機效果(random effect),在人與人之間有一個分配(distribution)。這套做法在同一份資料上刻意分三步往上爬。向量自我迴歸(vector autoregression)描述單一個人的系統,它的轉移矩陣(transition matrix)是一份關於「誰影響誰」的精簡陳述。多層次 VAR 讓那個矩陣在人與人之間變動,估出它的平均與散布,還原出時間的、同時的與個體間的結構,而後面一章會把這三者改以網絡(network)呈現。動態結構方程模型(dynamic structural equation modeling)補上最後一層:它把每一個觀察值分解(decompose)成一個潛在的個人平均數(person mean)與一個潛在的個體內歷程(process),遠在第 13 章就標出來的樣本平均數中心化(sample-mean centering)偏誤,到這一步才算解決;它並且讓自我迴歸、交叉延宕,甚至創新變異數(innovation variance)本身都成為隨機的,成為動態的分配而不是固定的數字。這些模型在實務上的生產標準是 Mplus,本章誠實地把它的輸入檔攤開來看;而書裡的估計是用手邊的工具與專門寫的模擬做出來的,樣本平均數中心化的偏誤、測量誤差(measurement error)造成的衰減、收縮(shrinkage)買到的準確度,每一項都對照一個已知的真相稽核過,不是空口斷言。
學習目標
讀完本章之後,你應該能夠:(1) 為一個人設定一個 VAR(1),把它的轉移矩陣讀成對角線上的自我迴歸慣性(inertia)與非對角線上的交叉延宕(cross-lag)影響,由特徵值(eigenvalue)判斷定態性(stationarity),追蹤一條脈衝反應(impulse response),並精確說出 Granger 預測許可與不許可什麼;(2) 設定以逐人轉移矩陣為隨機效果的多層次 VAR,分辨它的時間矩陣、同時矩陣與個體間矩陣,並權衡兩階段估計與聯合估計(joint estimation)之間的取捨;(3) 說清楚 DSEM 的架構:把觀察值潛在地分解成個體間的平均數與個體內的歷程,讓自我迴歸、交叉延宕與對數創新變異數都成為隨機參數,並說明它怎麼處理時間間隔與遺漏資料;(4) 解釋潛在中心化(latent centering)為什麼移除得掉樣本平均數(Nickell 與 Lüdtke)偏誤,並依序列長度把那份偏誤量化;(5) 用第 17 章的貝氏(Bayesian)底子讀懂一份 Mplus 的 DSEM 分析與它的收斂(convergence)診斷;(6) 走過整片偏誤地景,也就是樣本平均數中心化、測量誤差造成的衰減、隨機效果的收縮與時間間隔的粗化,並說得出每一項的補救;(7) 在 \(N=1\) 的 VAR、多層次 VAR、DSEM 與連續時間(continuous-time)模型之間作選擇,並帶著必要的告誡報告一份動態多層次分析。
25.1 一個人的系統:向量自我迴歸
向量自我迴歸把第 24 章的單一序列自我迴歸,推廣到一組隨時間同時測量的變項上。一個人在每個時點都測了數個變項,把他「相對於自己平均數」的個體內偏離收成一個向量 \(\mathbf{y}_t\),一階向量自我迴歸就是 \(\mathbf{y}_t = \boldsymbol{\Phi}\,\mathbf{y}_{t-1} + \boldsymbol{\varepsilon}_t\)。其中 \(\boldsymbol{\Phi}\) 是方陣(square matrix)形式的轉移矩陣(transition matrix),\(\boldsymbol{\varepsilon}_t\) 是創新(innovation)向量,帶著同時(contemporaneous)共變數矩陣 \(\boldsymbol{\Sigma}\)。要看的就是轉移矩陣,它的每一個元素都有清楚的心理學讀法。對角元素 \(\phi_{jj}\) 是變項 \(j\) 的延續效果(carryover),也就是前一章命名過的慣性:這個變項自己被抬高的狀態(state),延續到下一個時點(occasion)的程度。非對角元素 \(\phi_{jk}\) 是一條交叉延宕:變項 \(k\) 在某個時點被抬高,能多預測到下一個時點的變項 \(j\) 多少,而且是在 \(j\) 自己的延續效果之上再多出來的那一部分。兩個非對角元素都不為零,系統就含有一個回饋(feedback)迴路,兩個變項各自把對方往下一個時點推;整個矩陣就是這個人動態組織(dynamic organization)的一份精簡陳述。圖 25.1 為一個由壓力與負向情緒構成的雙變項系統標出這副解剖。
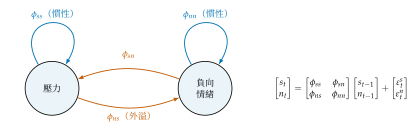
註:一個雙變項的一階向量自我迴歸。對角係數(藍色自我迴圈)是每個變項的慣性;非對角係數(橘色)是交叉延宕,也就是一個變項對另一個變項延宕一期的影響。兩條不為零的交叉延宕就構成一個回饋迴路。右邊的矩陣方程式是同一件事的代數寫法。
有兩項性質決定這樣一個系統行為好不好。第一項是定態性。這個從第 24 章繼承下來的前提現在取決於整個矩陣,不是單一個係數:\(\boldsymbol{\Phi}\) 的每一個特徵值都嚴格落在複數平面(complex plane)的單位圓(unit circle)之內,歷程才是定態的,衝擊(shock)才會衰減(decay)而不會累積(accumulate)。圖 25.2 在複數平面上畫出一個穩定系統與一個發散(explosive)系統的特徵值,旁邊各放上它們產生的序列:穩定的那條圍著平均數波動,發散的那條無界地散開。特徵值也承載著動態。實數特徵值給出平滑的衰減,複數特徵值給出前一章在二階自我迴歸裡遇過的阻尼振盪,而模數(modulus)最大的那一個決定系統整體的持續性(persistence)。第二項性質是創新怎麼讀。同時共變數矩陣 \(\boldsymbol{\Sigma}\) 捕捉延宕結構沒預測到的部分,也就是在同一個時點一起抵達的那些衝擊。同一時點的關聯究竟是一條快速的因果路徑,還是一個沒被建模的共同原因,留到第 28 章的同時網絡再談;在這裡它只是一個要估計的共變數,不是一項要提出的主張。
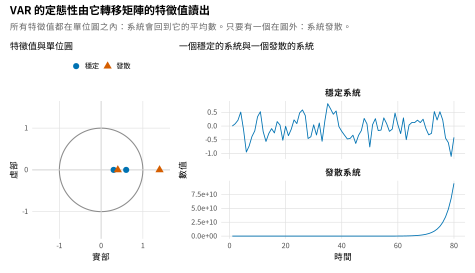
註:左:一個穩定的(藍)與一個發散的(橘)轉移矩陣,它們的特徵值相對於單位圓落在哪裡。右:兩個系統各自產生的序列。特徵值全都在圓內,衝擊就會衰減、系統就是定態的;只要有一個落在圓外,系統就發散。最大的特徵值模數概括了整體的持續性。
配適好一個 VAR 之後,脈衝反應函數(impulse-response function)會讓它的動態變得生動:這個函數追蹤的是,對其中一個變項的一單位衝擊如何在後續時點傳遍整個系統。歷程是線性的,所以期程(horizon) \(h\) 的反應就是把 \(\boldsymbol{\Phi}^{h}\) 作用在最初的衝擊上;畫出來的曲線同時顯示被衝擊變項的衰減,以及它對其他變項的外溢(spillover)。圖 25.3 呈現 affect_ema 資料裡一個人對壓力衝擊的反應:壓力從脈衝開始衰減,負向情緒則在一個時點之後升到延遲的高峰再消退,這正是外溢在時間上的指紋。脈衝反應讀起來很有力,但它立基於幾項必須交代的假設,也就是線性、定態,以及「哪一個衝擊是原生的」這件事的識別(identification)。在心理學實際收得到的序列長度下,它的抽樣不確定性(sampling uncertainty)很大,所以最好定性地讀成一種傳播的形狀,不要定量地讀成一項精確的預測。
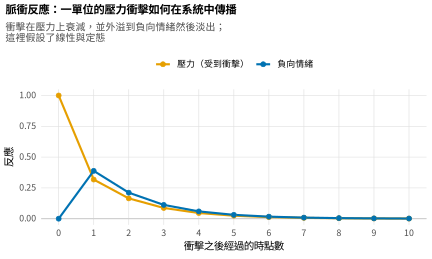
註:在 affect_ema 的一個人身上,壓力(橘)與負向情緒(藍)在一單位壓力衝擊之後十個時點內的反應。壓力衰減;負向情緒在一個時點之後升到高峰再淡出。這些曲線是把 \(\boldsymbol{\Phi}^{h}\) 作用在衝擊上得到的,並且假設了線性與定態。
Granger 預測值得精確地陳述,因為它太常被過度解讀。說一個變項 \(k\) 對一個變項 \(j\) 有 Granger 因果(Granger-cause),指的是 \(k\) 的過去能在 \(j\) 自己的過去之上改善對 \(j\) 的預測;這是一項關於預測內容的陳述,僅止於此。它不是機制(mechanism)的證據:一個被遺漏、又同時驅動兩者的個體內變項,就足以製造出那份預測上的改善。它也依賴測量的時間間隔(measurement interval),因為一個運作得比取樣速率更快或更慢的歷程,可以憑空出現、也可以憑空消失。配適到 affect_ema 的一個人身上,延宕的壓力在負向情緒自己的延續效果之上改善了預測,是一項顯著的 Granger 改善。誠實的注解是:這個人的壓力帶著關於下一刻情緒的預測訊息,不是壓力被證明造成了情緒。下面的 \(N=1\) 配適估出轉移矩陣、用特徵值檢查定態性,並跑了 Granger 檢定;表 25.1 把參數與它們的心理學語意收在一起。
# 對一個人配適 N=1 的 VAR(1):壓力與負向情緒
d1 <- subset(affect_ema, person == 59)
d1$cs <- d1$stress - mean(d1$stress, na.rm=TRUE)   # 個人平均數中心化
d1$cn <- d1$na     - mean(d1$na,     na.rm=TRUE)
d1$Lcs <- c(NA, head(d1$cs, -1)); d1$Lcn <- c(NA, head(d1$cn, -1))
fit_s <- lm(cs ~ 0 + Lcs + Lcn, d1)      # 壓力方程式
fit_n <- lm(cn ~ 0 + Lcs + Lcn, d1)      # 負向情緒方程式
Phi <- rbind(stress = coef(fit_s), na = coef(fit_n))   # 轉移矩陣
Mod(eigen(Phi)$values)                    # 都 < 1 即為定態(最大 0.53)
# Granger:延宕的壓力在 NA 自己的延宕之上還加得了預測力嗎?
anova(lm(cn ~ 0 + Lcn, d1), lm(cn ~ 0 + Lcn + Lcs, d1))   # p = 0.021
表 25.1 VAR 的參數與它們的心理學語意。
| 參數 | 統計上的意義 | 心理學上的語意 |
|---|---|---|
| \(\phi_{jj}\)(對角) | 一個變項對自己延宕一期的效果 | 變項 \(j\) 的慣性或延續效果,也就是它抗拒回到基線的程度 |
| \(\phi_{jk}\)(非對角) | \(k\) 對 \(j\) 延宕一期的效果 | 外溢或傳遞:此刻的 \(k\) 預測下一刻的 \(j\),在 \(j\) 自己的延續效果之上 |
| \(\boldsymbol{\Phi}\) 的特徵值 | 轉移矩陣的譜(spectrum) | 落在單位圓內:穩定的調節;複數:振盪;最大模數:整體的持續性 |
| \(\boldsymbol{\Sigma}\)(創新) | 衝擊的同時共變數 | 一起抵達又沒被預測到的部分;同一時點的耦合(網絡讀法在第 28 章) |
| 脈衝反應 \(\boldsymbol{\Phi}^{h}\) | 系統對一單位衝擊的反應 | 一次擾動在衰減之前如何傳播與外溢 |
| Granger 改善 | 由另一條序列的過去得到的預測增益 | 是預測,不是機制;依賴時間間隔;容易被遺漏的個體內混淆變項破壞 |
註:每一個係數都帶著一個個體內的讀法。對角線是慣性,非對角線是傳遞,特徵值支配穩定與振盪,而 Granger 的內容是預測,不是機制。
一個人的 VAR 只是起點,因為轉移矩陣並非人人相同。把同一個縮減式(reduced-form) VAR 配適到一批 affect_ema 的人身上,再讀出其中一個係數,也就是延宕的壓力對下一刻負向情緒的效果,得到的就是圖 25.4。估計值在人與人之間散得很開,有些人反應強烈,有些人幾乎沒有;而每個人的估計值都帶著很寬的信賴區間(confidence interval),因為一個人只提供得出幾十次可用的轉移。散布本身就是現象,與第 23 章的隨機斜率是同一個道理;區間太寬則是問題,與第 24 章短序列的限制也是同一個道理。兩者都指向同一步:把逐人的矩陣建模成隨機效果、跨人借力,也就是多層次 VAR。
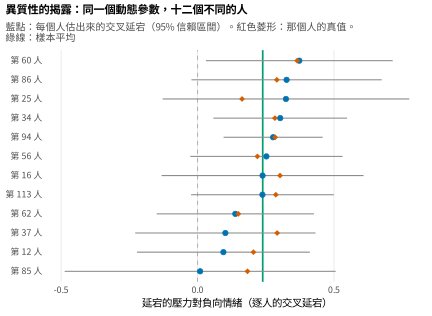
註:十二個 affect_ema 的人,每個人估出來的「延宕壓力對負向情緒」效果(藍點)與它的 95% 信賴區間、那個人的真值(紅色菱形),以及樣本平均數(綠線)。動態因人而異,而每一個單人估計值都不精確,這兩件事正是多層次彙整的動機。
基礎概念 • VAR 的定態分配與樣本平均數偏誤
一個定態的 VAR(1) 有一個定態分配,它的共變數 \(\boldsymbol{\Gamma}_0\) 滿足離散的 Lyapunov 方程式 \(\boldsymbol{\Gamma}_0 = \boldsymbol{\Phi}\,\boldsymbol{\Gamma}_0\,\boldsymbol{\Phi}^{\top} + \boldsymbol{\Sigma}\),也就是 AR(1) 變異數 \(\sigma^2_\varepsilon/(1-\phi^2)\) 的多變量推廣。解出它,就得到動態與創新共變數合起來所隱含的歷程變異數;它存在的條件,正是 \(\boldsymbol{\Phi}\) 的特徵值都落在單位圓內。延宕一期的自我共變數是 \(\boldsymbol{\Gamma}_1 = \boldsymbol{\Phi}\,\boldsymbol{\Gamma}_0\),所以轉移矩陣還原為 \(\boldsymbol{\Phi} = \boldsymbol{\Gamma}_1 \boldsymbol{\Gamma}_0^{-1}\),這是多變量的 Yule-Walker 關係。關鍵、也是本章核心的問題在後面:偏離 \(\mathbf{y}_t\) 靠減去每個人的平均數形成,而那個平均數不是已知的,是從同一條短序列估出來的。估出來的平均數會被稍後要減去它的那些觀察值拉過去,中心化之後的偏離按其構造就與自己的過去有輕微的負相關,自我迴歸因此向下偏誤。這個現象在動態追蹤資料的說法裡叫 Nickell (1981) 偏誤,在多層次的說法裡叫 Lüdtke et al. (2008) 的脈絡效果偏誤,一個現象兩個名字。這也正是「把個人平均數當成潛在變項處理」值得那一整套代價的理由,留到第 25.3 節再談。
25.2 多層次 VAR
多層次 VAR(multilevel VAR)把每個人的轉移矩陣,當成從「轉移矩陣的母體(population)」中得到的一次抽樣。個體內的模型就是上一節的向量自我迴歸;多層次那一層則讓每個人的自我迴歸(autoregression)與交叉延宕係數成為隨機效果。固定效果(fixed effect)估的是平均的動態,隨機效果變異數估的是它們的異質性(heterogeneity),這正是第 23 章隨機斜率的邏輯,只是現在用到延宕的預測變項上,而且同時用在好幾條方程式上。估計會產出三個矩陣,把它們分清楚至關重要。時間矩陣(temporal matrix)是固定效果的轉移矩陣,也就是平均的延宕動態。同時矩陣(contemporaneous matrix)是個體內創新的偏相關(partial correlation)結構,也就是移除延宕結構之後還留著的同一時點關聯。個體間矩陣(between-person matrix)是各人平均數的共變數,回答的是「在某一個變項上平均較高的人,在其他變項上傾向落在哪裡」。這三個就是第 28 章會解讀成圖(graph)的三個網絡層。在這裡它們只是要估計的統計物件;而 affect_ema 本來就由一個已知的多層次 VAR 生成,估出來還可以拿去對照真相。
那項對照是本章最令人滿意的展示。圖 25.5 把估出來的時間、同時與個體間三個矩陣,放在生成資料所用的數值旁邊,每一格上排是多層次估計值、下排是真值。時間矩陣把種下去的結構還原了出來:對角線的慣性接近生成值,壓力延宕外溢到負向情緒的那一格估成 \(0.24\),真值也是 \(0.24\),而真值為零的那些格子估出來也接近零。對角線的估計值略低於真值,那正是基礎概念方塊推導出來的樣本平均數偏誤看得見的指紋:平均的延續效果還原成 \(0.31\),真值是 \(0.35\)。同時矩陣還原了壓力與情緒之間為正的耦合,以及負向情緒與正向情緒之間為負的耦合;個體間矩陣則還原了各人平均數之間的相關。資料有雜訊(noisy)、有遺漏、又有界(bounded),估計式還能重現一個已知的轉移矩陣、一個已知的創新結構與一個已知的個體間結構,讀者在真相未知的資料上才信得過它。
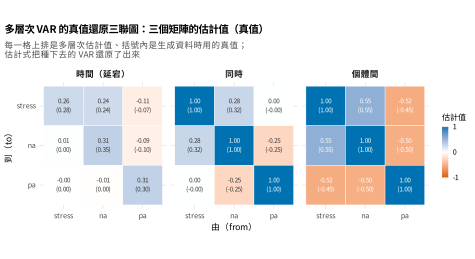
註:把一個多層次 VAR 配適到 affect_ema 之後,時間、同時與個體間三個矩陣估出來的(以及括號內生成資料所用的)元素;這份資料的生成歷程本身就是一個已知的多層次 VAR。填色編碼的是估計值。估計式把三個矩陣都還原了出來;時間矩陣對角線的元素略低,那是基礎概念方塊裡那個樣本平均數偏誤。
通往這些估計值有兩條路,兩者的對比正是通往 DSEM 的概念階梯。透明的那條是兩階段:先為每個人各配適一個 VAR,再用平均或後設分析(meta-analysis)把逐人的係數彙整起來。這條路好講解、也好計算,但序列一短就有偏誤,因為每個人的估計值都帶著上一節那個時點數少時的偏誤,而後設分析那一步又把有雜訊的估計值當成精確的來對待。比較好的那條是聯合估計:把所有人放進同一個多層次模型一起配適,每個人的動態都在「以母體為先驗(prior)」的情況下估出來,有雜訊的逐人估計值會往平均數收縮,準確度因此改善。圖 25.6 呈現這份回報。未經處理的逐人交叉延宕在真值周圍散得很開,收縮之後的多層次估計值則更緊地聚在真值線附近,均方根誤差(root-mean-square error, RMSE)由 \(0.142\) 降到 \(0.088\),完全靠跨人借力(borrowing strength)買到這一段可觀的改善。收縮後的估計值明顯比未收縮的平坦,這是刻意的:一個人自己的資料薄到釘不住自己的動態時,誠實的估計值就該被拉向「母體說什麼比較可能」的方向。多層次 VAR 的套件生態系是逐節點(nodewise)配適這個模型的,每個變項跑一條多層次迴歸,下面的程式碼就勾勒這套流程。
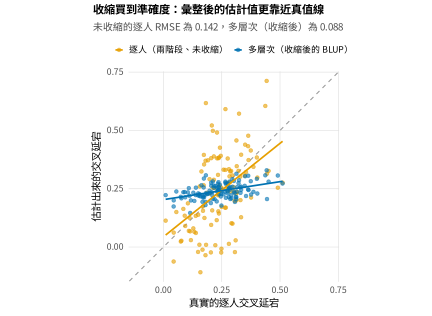
註:逐人的交叉延宕對照它們的真值:未經處理的逐人(兩階段)估計值為橘色,收縮後的多層次估計值為藍色,虛線標示完美還原。收縮把有雜訊的逐人估計值拉向母體,並把均方根誤差由 \(0.142\) 降到 \(0.088\)。
# 多層次 VAR,逐節點作(每個變項一條多層次迴歸)。
# 先把每個變項與它的延宕作個人平均數中心化(欄名 c_*、Lc_*)。
library(lme4)
m_na <- lmer(c_na ~ Lc_stress + Lc_na + Lc_pa +
                    (1 + Lc_na + Lc_stress | person), data = d)
fixef(m_na)                       # 時間矩陣的一列(平均動態)
coef(m_na)$person[, "Lc_stress"]  # 逐人的交叉延宕(收縮後的 BLUP)
# 同時矩陣:逐節點殘差的偏相關
# 個體間矩陣:各人平均數的相關
表 25.2 兩階段、多層次 VAR 與 DSEM 的比較。
| 特徵 | 兩階段逐人 | 多層次 VAR | DSEM |
|---|---|---|---|
| 中心化 | 樣本平均數 | 樣本平均數 | 潛在(不偏) |
| 逐人的動態 | 各自獨立配適 | 隨機效果,有收縮 | 隨機效果,有收縮 |
| 時點數少時的偏誤 | 完整的 Nickell 偏誤 | Nickell 偏誤仍在 | 由潛在平均數移除 |
| 測量誤差 | 使 \(\phi\) 衰減 | 使 \(\phi\) 衰減 | 可用潛在指標修補 |
| 創新變異數 | 逐人、權宜處理 | 通常固定或隨機 | 隨機(對數尺度) |
| 遺漏資料 | 成對的整列刪除 | 用得上的配對 | 模型本位(卡爾曼) |
| 估計 | 先 OLS 再彙整 | (RE)ML,逐節點 | 貝氏(MCMC) |
| 常用軟體 | 任意 | mlVAR | Mplus、dynr、Stan |
註:三種做法在「修正了什麼」上逐級往上。兩階段透明但有偏誤;多層次 VAR 加上了收縮,卻保留了樣本平均數偏誤;DSEM 再加上潛在中心化、潛在測量、模型本位的遺漏處理與隨機的創新變異數,代價是一整套貝氏做法。
25.3 動態結構方程模型
動態結構方程模型把多層次 VAR 重建在潛在變項(latent variable)的基礎上,而它的定義性動作是一次分解。每一個觀察分數(observed score)都寫成一個個體間部分與一個個體內部分之和,\(y_{it} = \mu_i + \tilde{y}_{it}\)。\(\mu_i\) 是這個人的潛在平均數,屬於個體間層次的隨機效果;\(\tilde{y}_{it}\) 則是承載序列動態(serial dynamics)的潛在個體內偏離(deviation)。自我迴歸與交叉延宕作用在潛在的 \(\tilde{y}\) 上,不是作用在「觀察分數減去一個樣本平均數」上,基礎概念方塊那份偏誤因此被移除:\(\mu_i\) 是借用跨人訊息估出來的參數,不是個體內的樣本平均數,偏離就不會機械性地與自己的過去相關,動態少了那股向下的拉力,還原得出來。圖 25.7 畫出這個架構:個體間層次供給每個人的潛在平均數與因人而異的動態參數,個體內層次則在潛在偏離上跑那個向量自我迴歸。
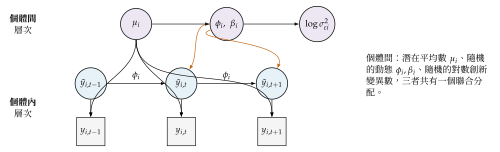
註:每一個觀察分數 \(y_{it}\) 都是一個潛在個人平均數 \(\mu_i\)(個體間層次)與一個承載自我迴歸與交叉延宕動態的潛在個體內偏離 \(\tilde{y}_{it}\)(個體內層次)之和。動態參數 \(\phi_i,\beta_i\) 與對數創新變異數本身也是隨機效果,共有一個個體間的聯合分配。以 \(\mu_i\) 而非以樣本平均數作中心化,正是移除小樣本偏誤的那一步。
圖 25.8 把潛在中心化(latent centering)的回報量化出來,那是本章方法學上的核心展示。一個已知係數為 \(0.40\) 的兩層次自我迴歸,在逐漸加長的序列上用三種方式估計:減去每個人觀察到的平均數;減去這個人真正的平均數,那是沒有任何分析者拿得到的神諭(oracle);以及把平均數當成階層貝氏模型裡的潛在參數,也就是 DSEM 的做法。樣本平均數中心化在短序列上向下偏誤得很嚴重,十個時點時還原成 \(0.23\)、二十個時點時 \(0.31\),要等序列加長才慢慢爬向真值。神諭中心化在每一種長度下都不偏。潛在中心化緊跟著神諭,連二十個時點都移除了幾乎全部的偏誤,只有在十個時點這個極端上往上擺動了一點,因為在那裡個體間與個體內兩部分幾乎分不開。教訓很直接:在心理學實際收得到的序列長度下,樣本平均數中心化低估了每一條自我迴歸與每一條交叉延宕,而潛在分解就是實用的修法。
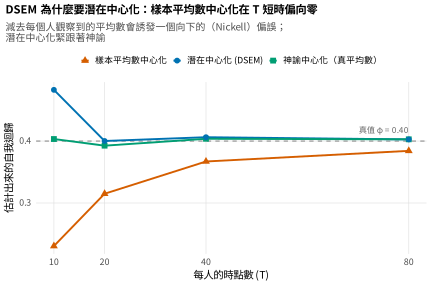
註:一個真值為 \(0.40\) 的自我迴歸,分別以樣本平均數中心化(橘)、神諭的真平均數中心化(綠)與潛在的階層中心化(藍)估計,對照序列長度。樣本平均數中心化在短序列上偏向零;潛在中心化緊跟著神諭。兩者的落差就是 DSEM 移除掉的那份偏誤。
這個架構還買到三項能力。第一,動態參數是隨機的,DSEM 估出來的不是單一個轉移矩陣,而是一整個轉移矩陣的分配;它也因此問得出動態會不會與平均水準共變,例如平均壓力較高的人,是不是也把壓力更強地傳遞到情緒上。圖 25.9 呈現逐人交叉延宕在樣本(sample)中的分配,以及它與平均壓力水準的關係;在這份資料上那個關係基本上是零,這本身就是一項發現:外溢的強度與平均水準是兩項分開的個別差異。第二,創新變異數也可以是隨機的,而且是在對數尺度上,於是人與人的差別不只在動態,還在時時刻刻的波動性(volatility),正是第 16 章位置尺度(location-scale)的想法在動態模型裡再生一次。圖 25.10 呈現逐人創新標準差的散布,而固定變異數的模型會錯誤地把這份波動性假設為常數。第三,測量那一層也可以做成潛在的。每個構念配上多個指標的 DSEM,估的是潛在因素(latent factor)的動態,不是單一個會犯錯的題目(item)的動態;這件事要緊,因為測量誤差會把自我迴歸的估計值往零的方向衰減。圖 25.11 示範那份衰減:一個 \(0.50\) 的自我迴歸,在信度(reliability) \(0.8\) 時還原成 \(0.38\),在信度 \(0.5\) 時還原成 \(0.23\)。多指標(multiple-indicator)的 DSEM 就是修補的辦法,等於讓第 24 章的 P 技術在更大的規模上翻身,而且配上了它當初缺的那套序列結構。
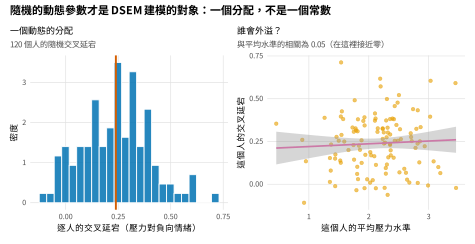
註:左:120 個人身上逐人交叉延宕(壓力到負向情緒)的分配,並標出平均數。右:那些交叉延宕對照每個人的平均壓力水準;接近零的相關說明在這份資料上,外溢強度與平均水準是兩項不同的個別差異。DSEM 直接把這個分配建模。
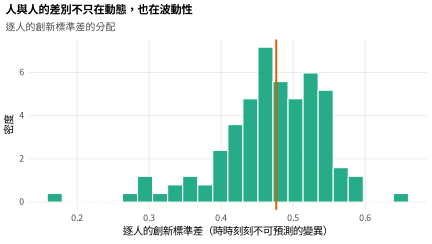
註:逐人創新標準差的分配,也就是時時刻刻那些不可預測的衝擊有多大。DSEM 讓它以一個隨機的對數創新變異數在人與人之間變動,那是把第 16 章的位置尺度模型帶進動態的場景。
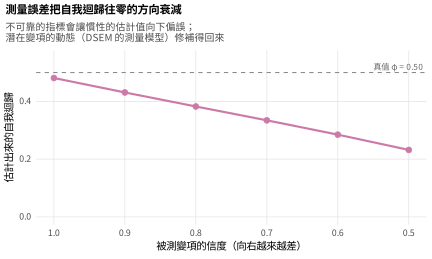
註:單一個會犯錯的指標,信度愈低,估出來的自我迴歸就愈低;真值 \(0.50\) 已標出。不可靠的測量會把慣性的估計值往零偏誤,而把構念建模成潛在變項的多指標 DSEM 修補得回這份衰減。
估計是貝氏的,理由充分:潛在分解、隨機的動態與隨機的變異數合起來,讓概似函數(likelihood function)對最大概似(maximum likelihood)方法變得棘手,而馬可夫鏈蒙地卡羅(Markov chain Monte Carlo, MCMC)自然地處理得了潛在平均數與隨機效果。實務上這個領域的標準是 Mplus。它的 DSEM 實作讀進密集縱貫(intensive longitudinal)資料,把資料分解成潛在的個體內與個體間兩部分,在參數上放先驗,再用第 17 章的貝氏語彙回傳後驗(posterior)摘要與收斂診斷(convergence diagnostics);那裡叫 \(\hat{R}\) 的量,在 Mplus 叫潛在尺度縮減因子(potential scale reduction factor),是同一個量。下面的輸入檔設定的是帶隨機交叉延宕的「壓力到情緒」外溢模型。&1 這個記法形成延宕,垂直線命名一個隨機斜率(random slope),而 TINTERVAL 選項把提示(beep)之間不等的間距離散化(discretize),那是通往第 27 章連續時間處理的橋。表 25.3 把這些設定翻譯成它們所編碼的決定。
! Mplus 兩層次 DSEM:隨機 AR 與隨機的壓力->NA 交叉延宕
VARIABLE:  NAMES = person day beep stress na pa;
           USEVARIABLES = stress na;
           CLUSTER = person;             ! 人就是群集
           LAGGED = stress(1) na(1);     ! 形成延宕一期的預測變項
           MISSING = ALL(-999);
ANALYSIS:  TYPE = TWOLEVEL RANDOM;
           ESTIMATOR = BAYES;            ! MCMC;ML 在這裡很吃力
           PROCESSORS = 2;
           BITERATIONS = (2000);         ! 下限;一直加到 PSR 穩定
MODEL:

    phi  | na     ON na&1;               ! 負向情緒的隨機 AR
    beta | na     ON stress&1;           ! 隨機交叉延宕:壓力 -> NA
    phis | stress ON stress&1;           ! 壓力的隨機 AR

    na WITH stress;                      ! 個體間平均數的共變
    phi beta phis WITH na stress;        ! 動態會與水準共變嗎?
OUTPUT:    TINTERVAL STANDARDIZED;
表 25.3 Mplus 中的 DSEM 設定與它們所編碼的決定。
| 設定 | 它控制什麼 | 指引 |
|---|---|---|
ESTIMATOR = BAYES | MCMC 估計 | 必要;ML 處理不了帶隨機動態的潛在分解 |
BITERATIONS | MCMC 疊代次數 | 設一個下限,再一直加到尺度縮減因子穩定為止;預設值不要照單全收 |
| 先驗 | 參數上的先驗分配 | 預設是弱訊息的;把先驗報告出來,並對有影響的先驗做敏感度檢查 |
| 尺度縮減因子 | 收斂診斷 | Mplus 對 \(\hat{R}\)(第 17 章)的稱呼;接近 \(1.0\) 表示收斂;並檢視軌跡圖 |
LAGGED、&1 | 延宕的建構 | 延宕在群集內形成;要確認它符合你想要的時間結構 |
TINTERVAL | 間隔的離散化 | 把不等的間距對到一個網格上;網格太粗會扭曲動態(第 25.4 節;第 27 章) |
註:DSEM 繼承了第 17 章的貝氏工作流程。收斂由尺度縮減因子與軌跡圖判斷,疊代次數一直加到它穩定為止,而先驗要報告、要探測,不是默默接受。
常見陷阱 • 動態多層次分析被過度解讀的四種方式
第一,把一條交叉延宕讀成個體內的因果效果。它是一項預測性的關聯(association),容易被遺漏的個體內混淆變項(confounder)破壞,也依賴測量的時間間隔;誠實的主張是預測,因果的語言只屬於當得起它的設計。第二,不帶恆等性(invariance)思維就跨人或跨組比較轉移矩陣。那些係數可能落在不同的個體內尺度上,要刻意作標準化(standardization),而且最好用一個把意義說清楚的個體內標準化,因為未標準化與標準化的交叉延宕回答的是不同的問題。第三,忽略不等間隔的離散化,把一個橫跨各次不同長度間隔估出來的係數,讀成單一個延宕效果。要把間隔說出來;間距差得太厲害時,就換到連續時間(第 27 章)。第四,把逐人的 DSEM 估計值當成那個人未經修飾的真相。它是一個往母體收縮過的後驗分配(posterior distribution);收縮是優點,但也意味著這個估計值有一部分在替樣本說話,關於個別極端案例的主張應該謹慎提出。
軟體提示 • 動態建模的軟體地景
這片地景移動得很快,誠實的對照如下。單一個人的 VAR,基礎工具與 vars 套件就夠了。多層次 VAR 交給 mlVAR,它逐節點估出時間、同時與個體間三個矩陣,與第 28 章的網絡呈現搭得很自然;graphicalVAR 估的則是帶正則化(regularized)的個體內(within-person)版本。完整的 DSEM,也就是帶潛在中心化、隨機動態、隨機創新變異數、潛在測量與模型本位遺漏處理的那一種,Mplus 是實務上的生產標準,可以透過 MplusAutomation 來回操作;Stan 裡的貝氏實作與處理狀態空間(state-space)動態的 dynr 套件,在 R 裡也涵蓋了其中大部分,只是要多組裝一些。本章的分析用的是基礎工具、用 lme4 作多層次 VAR,再用專門寫的模擬與一個手寫的小型 Gibbs 取樣器示範 DSEM 的機制;潛在中心化的偏誤、收縮的增益與測量誤差的衰減,每一項都對照一個已知的真相展示過,不必靠信任接受。有生產需求的讀者應該去用 Mplus 或一個 Stan 的實作;想弄懂那些引擎在做什麼的讀者,可以在隨書腳本裡看到這些機制被重現一遍。
25.4 偏誤的地景
把失敗模式聚在同一個地方,前面那套做法的價值最清楚,因為每一項都是一個特定的偏誤配上一個特定的補救。熟悉這片地景(landscape)的實務工作者,在收到第一筆資料之前就預期得到估計值會往哪個方向錯。本章出現過四項偏誤,每一項都以模擬對照一個已知的真相示範過。樣本平均數中心化在短序列上把自我迴歸往下偏誤,十個時點時將近一半、四十個時點時也還有十分之一,補救是潛在中心化。測量誤差按不可靠的程度把自我迴歸往零衰減,補救是一個潛在測量模型(latent measurement model)。兩階段估計把動態的表面異質性膨脹,因為它把有雜訊的逐人估計值當成精確的,補救是帶收縮的聯合估計(joint estimation)。間隔粗化,也就是把不等距的時點當成等距處理,會讓動態產生偏誤,因為實際長度不同的各次轉移被彙整進同一個係數裡。圖 25.12 示範最後這一項:一個真實的一步(one-step)自我迴歸為 \(0.67\) 的連續時間歷程,天真的等間隔配適估成 \(0.56\),向下偏誤了十分之一;一旦尊重了間隔就還原到 \(0.66\),那正是第 27 章的連續時間修正。表 25.4 陳述每一項偏誤、大小的驅動因素與補救;表 25.5 則為本章這些模型要回答的問題,給出誠實的序列長度與樣本數指引。
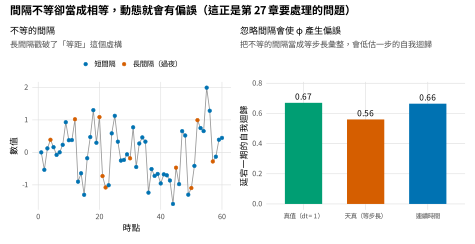
註:左:一個以不等間隔取樣的連續時間歷程,長的(過夜)間隔已標出。右:真實的一步自我迴歸(\(0.67\))、天真的等間隔估計值(\(0.56\)),以及連續時間還原出來的值(\(0.66\))。忽略間距會低估自我迴歸;第 27 章直接把它建模。
表 25.4 偏誤的地景:問題、大小的驅動因素與補救。
| 偏誤 | 方向 | 大小的驅動因素 | 補救 |
|---|---|---|---|
| 樣本平均數中心化 | 偏向零 | \(T\) 短;個體間變異數小 | 潛在中心化(DSEM) |
| 測量誤差 | 偏向零 | 指標的信度低 | 潛在測量模型(多指標 DSEM) |
| 兩階段的異質性 | 散布被膨脹 | \(T\) 短;逐人配適有雜訊 | 帶收縮的聯合估計 |
| 間隔粗化 | 通常偏向零 | 不等且很長的間隔被當成相等 | 連續時間模型(第 27 章);小心使用 TINTERVAL |
| 被遺漏的個體內混淆 | 兩個方向都可能 | 同時驅動兩條序列而未被測量的因素 | 靠設計與理論;事後補救不了 |
註:每一列都是一項有已知方向、也有已知補救的偏誤。熟悉這片地景,分析者就能在下結論之前、而不是之後,預測誤差的方向並選出移除它的估計式。
表 25.5 動態問題所需的序列長度與樣本數(以模擬為依據)。
| 問題 | 可行的設計 | 告誡 |
|---|---|---|
| 一個人的 AR 慣性 | \(T \approx 50\)–\(100\) | 區間很寬;在低端還有樣本平均數偏誤 |
| 一個人完整的 VAR(\(p\)) | \(T \gtrsim 150\)–\(200\) | 每多一個變項與一階延宕都要付出精確度 |
| 平均動態(多層次) | 中等的 \(N\),\(T \approx 30\)–\(50\) | 借力救得回短序列 |
| 動態的異質性(隨機效果變異數) | 更大的 \(N\) 與 \(T\)(例如 \(N \gtrsim 100\)、\(T \gtrsim 50\)) | 隨機效果變異數在兩個維度上都要有訊息 |
| 針對某一個個體的逐人動態 | 那個人要有很大的 \(T\) | DSEM 會收縮;關於個別極端案例的主張很脆弱 |
| 動態與水準或特質共變 | 很大的 \(N\) 與 \(T\) | 最稀缺的設計;要誠實報告不確定性 |
註:平均動態便宜,因為彙整救得回短序列;動態的變異數與逐人的估計值昂貴,因為它們在人的維度與時點的維度上都要有訊息。要讓設計配合問題,不是反過來。
實務要點 • 實務上跑 DSEM:收斂、敏感度與報告
DSEM 很慢,而且要求你留意收斂(convergence):疊代次數一直加到尺度縮減因子穩定在接近一、軌跡圖也混合良好為止,沒有收斂的模型不要去讀。審查者現在會期待幾項敏感度分析:以更長的延宕重新配適,確認延宕一期的結論站得住;去趨勢與不去趨勢各配適一次,說明動態不是趨勢造成的假象;有分量的先驗(prior)都要探測。報告要交代中心化的方式(潛在)、延宕結構、放進去的隨機效果、先驗與疊代次數、收斂診斷,以及間隔的處理,因為每一項都會改變估計標的。設計對這個問題而言太單薄時,例如一份四十個人、每人三十個時點的日記研究撐不起一個豐富的隨機動態 DSEM,就把這件事說出來,退回資料撐得住的那個模型:一個關於平均動態(average dynamics)的多層次 VAR,或一組報告得好的逐人 VAR,而不是硬配一個資料識別不了的模型。
25.5 選擇你的動態工具
本章的模型不是彼此的對手,而是一個分級的家族;在它們之間的選擇,由問題、資料,以及對這套做法的容忍度決定。圖 25.13 把這個決定畫成一張流程圖,它的邏輯值得用散文說一遍。關心的若是一個被密集研究、序列又長的個體,單人的 VAR 就是對的、也是足夠的工具,它按設計就是個殊取向(idiographic)的。關心的若是一個樣本,目標是平均的動態與它們的異質性,又要估得快、要以網絡(network)呈現,多層次 VAR 是那匹主力。問題若要的是只有潛在架構才給得起的東西,也就是短序列上不偏的中心化、與個人平均數共變的動態、隨機的創新變異數、構念的潛在測量,或有原則的遺漏處理,DSEM 就值得它的代價。觀察之間的間隔若變動到「當成相等」會扭曲動態,第 27 章的連續時間模型接手。動態的結構本身若就是異質的,也就是不同的人擁有性質不同(qualitatively different)的系統,而不是同一組係數的不同數值,那就是第 28 章群體搜尋(group search)方法處理的問題,這裡任何一個模型都處理不了。表 25.6 以一張動態多層次分析的報告檢核表為本章收尾。
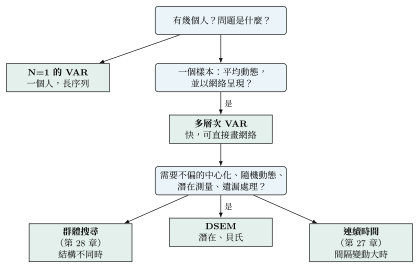
註:這些模型構成一個分級的家族。一個人加上長序列,用 VAR;一個樣本的平均動態,用多層次 VAR;潛在中心化、隨機動態、潛在測量或遺漏處理,用 DSEM;間隔嚴重不等,用連續時間(第 27 章);人與人的結構性質不同,用群體搜尋(第 28 章)。
寫一份動態多層次分析,是把前幾章的報告紀律延伸到這些模型特有的決定上。報告要說明配適的是哪一個模型,VAR、多層次 VAR 還是 DSEM,以及用了哪一種中心化,因為潛在中心化與樣本平均數中心化給出的偏誤不同。要給出估出來的動態與它們的心理學讀法:把平均的轉移矩陣讀成慣性與外溢,把異質性讀成隨機效果變異數(random-effect variance),並附上不確定性。DSEM 還要報告估計式(estimator)、先驗、疊代(iteration)次數、收斂診斷與間隔的處理,並描述跑過哪些敏感度分析。全篇的因果語言都要與設計相稱,把交叉延宕報告成個體內的預測性關聯(predictive association),不是因果效果(causal effect);也要承認逐人估計值有收縮,以及序列長度限制了什麼識別得出來。示範段落如下:「本研究以 Mplus 對負向情緒與當下壓力配適了一個兩層次的 DSEM(120 人,每人最多 84 個時點),使用貝氏估計式、潛在的個人平均數中心化,以及隨機的自我迴歸與交叉延宕係數。由壓力到下一刻負向情緒的平均個體內交叉延宕為 0.24(95% 可信區間(credible interval) [.., ..]);它在人與人之間變動(隨機效果標準差 ..),而且與平均壓力水準沒有明顯的共變。收斂情況良好(尺度縮減因子 \(<1.05\);軌跡圖混合良好),而延宕一期的結論在延宕二期的設定下仍然成立。交叉延宕被解讀為個體內的預測性關聯,不是因果效果。」
表 25.6 動態多層次模型的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 模型與中心化 | VAR/多層次 VAR/DSEM;樣本平均數中心化或潛在中心化 |
| 設計 | 人數、每人的時點數、間隔結構、遺漏情形 |
| 動態 | 平均的轉移矩陣(慣性、交叉延宕)與不確定性;心理學讀法 |
| 異質性 | 動態的隨機效果變異數;與個人平均數的共變 |
| 創新 | 同時結構;若有建模則含隨機的創新變異數 |
| 估計(DSEM) | 估計式、先驗、疊代次數、尺度縮減因子、軌跡圖檢查 |
| 間隔 | 間隔的處理(TINTERVAL 網格或連續時間模型) |
| 敏感度 | 延宕階數、去趨勢的各種版本、先驗的敏感度 |
| 解讀 | 交叉延宕是預測不是原因;逐人估計值有收縮 |
註:這張檢核表把第 23 章密集縱貫的報告要求,延伸到動態模型特有的中心化、隨機動態、估計與間隔決定上,而每一項都會改變「估的到底是什麼」。
本章摘要
向量自我迴歸以一個轉移矩陣描述一個人的多變量動態:對角線是慣性,非對角線是交叉延宕的傳遞,特徵值支配定態性與振盪,脈衝反應追蹤一次衝擊如何傳播。Granger 的內容是預測性的、依賴時間間隔的,不是因果的。轉移矩陣因人而異,一個人的序列又把它估得不精確,多層次 VAR 因此把逐人的矩陣當成隨機效果,並還原出三個不同的物件:時間矩陣、同時矩陣與個體間矩陣。在 affect_ema 上,這三者重現了一個已知的多層次 VAR 真相,而時間矩陣對角線的慣性略低,正是樣本平均數偏誤的指紋。帶收縮的聯合估計勝過兩階段彙整,它把有雜訊的配適往母體拉,逐人估計值的誤差因而下降。動態結構方程模型把每一個分數分解成一個潛在的個人平均數與一個潛在的個體內歷程,移除了折磨短序列的樣本平均數偏誤,整座架構到此完成;它並且讓自我迴歸、交叉延宕與對數創新變異數都成為隨機的,成為帶有共變數的動態分配,回答得了誰的外溢強、誰的波動性大;它還容許一個潛在的測量層,修補測量誤差加在自我迴歸上的衰減。它的估計是貝氏的,生產標準是 Mplus,收斂用第 17 章的診斷來讀。偏誤的地景,也就是樣本平均數中心化、測量誤差、兩階段把異質性膨脹,以及間隔粗化,是一組各有方向、也各有特定補救的錯誤。至於在 VAR、多層次 VAR、DSEM,以及接下來的連續時間與群體搜尋模型之間怎麼選,則跟著問題、資料,以及那套做法能不能被正當化而走。
習題
- 25.1 解剖一個人的系統。把一個 VAR(1) 配適到
affect_ema的單一個人身上,依表 25.1 把轉移矩陣讀成對角線的慣性與非對角線的外溢,並用特徵值的模數確認定態;接著追一次壓力衝擊的脈衝反應對照圖 25.3,並為那項 Granger 改善寫出一句只主張預測、不主張機制的注解。 - 25.2 異質性與收縮。先逐人把 VAR 配適到
affect_ema上,重現圖 25.4 那份散得很開又每個區間都很寬的異質性,再改成聯合估計的多層次 VAR,核對均方根誤差由 \(0.142\) 降到 \(0.088\)(圖 25.6),並依表 25.2 說清楚聯合估計修掉了什麼、又留下了什麼。 - 25.3 三聯圖的真值還原。在
affect_ema上配適一個多層次 VAR,把時間矩陣、同時矩陣與個體間矩陣分開報告並對照圖 25.5 的生成真值,說明時間矩陣的對角線為什麼落在 \(0.31\) 而不是 \(0.35\),再依第 25.5 節的示範寫出一段結果文字。 - 25.4 重現中心化的偏誤。重現圖 25.8 的模擬:一個真值 \(0.40\) 的自我迴歸,樣本平均數中心化在十個時點時只還原到 \(0.23\)、二十個時點時只還原到 \(0.31\),潛在中心化卻緊跟著神諭;再用圖 25.7 的分解說明這份落差是被哪一步移除的。
- 25.5 偏誤地景備忘錄。在看到資料之前先寫一份備忘錄,依表 25.4 逐項預測你的動態估計值會往哪個方向錯;引圖 25.11 的衰減(信度 \(0.8\) 時 \(0.50\) 掉到 \(0.38\))與圖 25.12 的間隔粗化(\(0.67\) 估成 \(0.56\))各給一個數字,並指名間隔差到什麼程度就該交棒給第 27 章。
- 25.6 檢核表稽核。取一篇已發表的動態多層次分析,依表 25.6 逐項稽核它的中心化、隨機效果、收斂診斷與間隔處理,用表 25.5 判斷它的人數與時點數撐不撐得起它宣稱的估計標的,再依圖 25.13 為你自己的資料選一個模型並說明理由。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 向量自我迴歸 | vector autoregression (VAR) | 把單一序列的自我迴歸推廣到一組同時測量的變項;第 25.1 節 |
| 轉移矩陣 | transition matrix | 對角線為慣性、非對角線為交叉延宕的方陣;第 25.1 節 |
| 外溢 | spillover | 一個變項延宕一期對另一個變項的影響;第 25.1 節 |
| 特徵值 | eigenvalue | 落在單位圓內即為定態;複數則振盪;第 25.1 節 |
| 脈衝反應函數 | impulse-response function | 一單位衝擊在系統中隨時點傳播的軌跡;第 25.1 節 |
| Granger 預測 | Granger prediction | 由另一條序列的過去得到的預測增益;不是機制;第 25.1 節 |
| 時間矩陣 | temporal matrix | 固定效果的轉移矩陣,也就是平均的延宕動態;第 25.2 節 |
| 同時矩陣 | contemporaneous matrix | 個體內創新的偏相關結構;第 25.2 節 |
| 個體間矩陣 | between-person matrix | 各人平均數之間的共變數;第 25.2 節 |
| 收縮 | shrinkage | 把有雜訊的逐人估計值往母體拉(承第 13 章);第 25.2 節 |
| 潛在中心化 | latent centering | 以潛在的個人平均數而非樣本平均數作中心化;第 25.3 節 |
| 對數創新變異數 | log-innovation-variance | 讓波動性因人而異的隨機參數;第 25.3 節 |
| 尺度縮減因子 | scale-reduction factor | Mplus 對 \(\hat{R}\) 的稱呼,收斂診斷(承第 17 章);第 25.3 節 |
參考文獻
Asparouhov, T., Hamaker, E. L., & Muthén, B. (2018). Dynamic structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 25(3), 359–388. https://doi.org/10.1080/10705511.2017.1406803
Bringmann, L. F., Vissers, N., Wichers, M., Geschwind, N., Kuppens, P., Peeters, F., Borsboom, D., & Tuerlinckx, F. (2013). A network approach to psychopathology: New insights into clinical longitudinal data. PLOS ONE, 8(4), e60188. https://doi.org/10.1371/journal.pone.0060188
Bulteel, K., Mestdagh, M., Tuerlinckx, F., & Ceulemans, E. (2018). VAR(1) based models do not always outpredict AR(1) models in typical psychological applications. Psychological Methods, 23(4), 740–756. https://doi.org/10.1037/met0000178
Bulteel, K., Tuerlinckx, F., Brose, A., & Ceulemans, E. (2016). Clustering vector autoregressive models: Capturing qualitative differences in within-person dynamics. Frontiers in Psychology, 7, 1540. https://doi.org/10.3389/fpsyg.2016.01540
Epskamp, S. (2020). Psychometric network models from time-series and panel data. Psychometrika, 85(1), 206–231. https://doi.org/10.1007/s11336-020-09697-3
Epskamp, S., Waldorp, L. J., Mõttus, R., & Borsboom, D. (2018). The Gaussian graphical model in cross-sectional and time-series data. Multivariate Behavioral Research, 53(4), 453–480. https://doi.org/10.1080/00273171.2018.1454823
Gates, K. M., & Molenaar, P. C. M. (2012). Group search algorithm recovers effective connectivity maps for individuals in homogeneous and heterogeneous samples. NeuroImage, 63(1), 310–319. https://doi.org/10.1016/j.neuroimage.2012.06.026
Hamaker, E. L. (2012). Why researchers should think “within-person”: A paradigmatic rationale. In M. R. Mehl & T. S. Conner (Eds.), Handbook of research methods for studying daily life (pp. 43–61). Guilford Press.
Hamaker, E. L., Asparouhov, T., Brose, A., Schmiedek, F., & Muthén, B. (2018). At the frontiers of modeling intensive longitudinal data: Dynamic structural equation models for the affective measurements from the COGITO study. Multivariate Behavioral Research, 53(6), 820–841. https://doi.org/10.1080/00273171.2018.1446819
Hamaker, E. L., Dolan, C. V., & Molenaar, P. C. M. (2005). Statistical modeling of the individual: Rationale and application of multivariate stationary time series analysis. Multivariate Behavioral Research, 40(2), 207–233. https://doi.org/10.1207/s15327906mbr4002_3
Hamaker, E. L., & Muthén, B. (2020). The fixed versus random effects debate and how it relates to centering in multilevel modeling. Psychological Methods, 25(3), 365–379. https://doi.org/10.1037/met0000239
Haslbeck, J. M. B., Bringmann, L. F., & Waldorp, L. J. (2021). A tutorial on estimating time-varying vector autoregressive models. Multivariate Behavioral Research, 56(1), 120–149. https://doi.org/10.1080/00273171.2020.1743630
Jongerling, J., Laurenceau, J.-P., & Hamaker, E. L. (2015). A multilevel AR(1) model: Allowing for inter-individual differences in trait-scores, inertia, and innovation variance. Multivariate Behavioral Research, 50(3), 334–349. https://doi.org/10.1080/00273171.2014.1003772
Krone, T., Albers, C. J., & Timmerman, M. E. (2017). A comparative simulation study of AR(1) estimators in short time series. Quality & Quantity, 51(1), 1–21. https://doi.org/10.1007/s11135-015-0290-1
Lüdtke, O., Marsh, H. W., Robitzsch, A., Trautwein, U., Asparouhov, T., & Muthén, B. (2008). The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies. Psychological Methods, 13(3), 203–229. https://doi.org/10.1037/a0012869
McNeish, D., & Hamaker, E. L. (2020). A primer on two-level dynamic structural equation models for intensive longitudinal data in Mplus. Psychological Methods, 25(5), 610–635. https://doi.org/10.1037/met0000250
Molenaar, P. C. M. (1985). A dynamic factor model for the analysis of multivariate time series. Psychometrika, 50(2), 181–202. https://doi.org/10.1007/BF02294246
Nickell, S. (1981). Biases in dynamic models with fixed effects. Econometrica, 49(6), 1417–1426. https://doi.org/10.2307/1911408
Schuurman, N. K., Ferrer, E., de Boer-Sonnenschein, M., & Hamaker, E. L. (2016). How to compare cross-lagged associations in a multilevel autoregressive model. Psychological Methods, 21(2), 206–221. https://doi.org/10.1037/met0000062
Schuurman, N. K., & Hamaker, E. L. (2019). Measurement error and person-specific reliability in multilevel autoregressive modeling. Psychological Methods, 24(1), 70–91. https://doi.org/10.1037/met0000188
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。