第 13 章
線性混合效果模型:基礎
這是全書的承重章。本章發展的混合模型(mixed model),是第四部到第六部其餘內容共同倚賴的那套做法,這裡引進的符號也綁住了後面所有章節。第 11 章已經說明,重複量數變異數分析只是某個更一般模型的受限特例;那個一般模型就在本章登場,把那些限制一一鬆開。它容得下每個人各自不同而且連續的時間,容得下以概似(likelihood)而不是刪除來處理的不平衡與不完整資料,容得下有彈性的共變數結構,而最要緊的是,透過隨機斜率(random slope)容得下改變上真正的個別差異。本章要完整交代四件事:模型怎麼設定、怎麼解讀;估計與推論如何把資料轉成參數與不確定性;中心化(centering)如何決定一個時間變動預測變項究竟在回答哪一個問題;以及從建模、診斷到報告的一整套實作流程。每一條式子後面都跟著一段白話說明,因為本章讀得流利,本書其餘部分就會輕鬆得多。
學習目標
讀完本章之後,你應該能夠:(1) 以階層形式(hierarchical form)與合併形式(combined form)兩種寫法寫出兩層線性混合模型,並在兩者之間互譯;(2) 在實質意義上解讀固定效果(fixed effects)、隨機效果(random effects)的變異數與共變數,以及殘差變異數;(3) 說明收縮(shrinkage)與個體效果的最佳線性不偏預測(best linear unbiased prediction, BLUP);(4) 區分最大概似(maximum likelihood, ML)與受限最大概似(restricted maximum likelihood, REML),並在恰當的時機分別採用;(5) 以自由度修正對固定效果作推論,並以邊界修正過的概似比檢定(likelihood-ratio test)對變異數成分作推論;(6) 以個人平均數中心化(person-mean centering)分解一個時間變動預測變項,並解讀它的個體內、個體間與脈絡效果(contextual effect);(7) 依一套有原則的順序建模、診斷與排除問題,量化解釋的變異數,並把結果報告到可供發表的水準。
13.1 從受限到有彈性:模型本身
線性混合模型有兩種等價的寫法,要用得流利就得兩種都握在手上。階層形式(hierarchical form)把資料的層次明白地分開。第一層是個體內的層次:每個人在每一個時點上的結果,是這個人自己的一條直線加上殘差噪音,\(y_{it} = \beta_{0i} + \beta_{1i}x_{it} + e_{it}\),其中 \(\beta_{0i}\) 與 \(\beta_{1i}\) 是第 \(i\) 個人自己的截距與斜率。第二層是個體間的層次:每個人的係數等於母體平均,加上屬於這個人的一個偏離,\(\beta_{0i} = \gamma_{00} + u_{0i}\),\(\beta_{1i} = \gamma_{10} + u_{1i}\)。把第二式代進第一式,就得到合併形式(combined form) \(y_{it} = \gamma_{00} + \gamma_{10}x_{it} + u_{0i} + u_{1i}x_{it} + e_{it}\),它把三樣東西分了開來:固定效果(fixed effects) \(\gamma\),也就是母體平均的截距與斜率;隨機效果(random effects) \(u\),也就是屬於個人的偏離;以及殘差 \(e\)。殘差假定為 \(e_{it} \sim N(0, \sigma^2)\),隨機效果則假定服從平均數為零的二元常態分配(bivariate normal distribution),其共變數矩陣稱為 T 矩陣(T matrix),\(\mathbf{T} = \left(\begin{smallmatrix} \tau_{00} & \tau_{01} \\ \tau_{01} & \tau_{11} \end{smallmatrix}\right)\):對角線上是截距的變異數(intercept variance)與斜率的變異數(slope variance),非對角線上是兩者的共變數(covariance)。圖 13.1 以 sleepstudy 資料把模型一步一步視覺地建起來,這筆資料記錄反應時間隨著連續多天的睡眠剝奪而變差:先是原始軌跡,再來是隨機截距模型,它容許人們在整體水準上不同、卻共用同一個斜率,最後是完整的隨機斜率模型,讓每個人都有自己的下降速率。
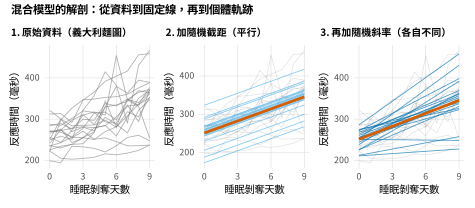
註:sleepstudy 資料(反應時間隨睡眠剝奪天數變化)。左:原始軌跡。中:隨機截距模型,個體直線(藍)與固定線(紅)平行,只在水準上不同。右:隨機斜率模型,個體直線連斜率也不同。隨機效果就是藍線相對於紅線的偏離。
T 矩陣裡的變異數與共變數不是干擾項,而是對個別差異的實質描述。截距變異數 \(\tau_{00}\) 說的是人們的起始水準差多少,斜率變異數 \(\tau_{11}\) 說的是人們的改變速率差多少,截距與斜率的共變數 \(\tau_{01}\)(通常讀成相關)說的則是起點高的人與起點低的人在改變上是否不同。圖 13.2 畫出兩種可能。相關為正時軌跡扇形展開(fan-spread):起點較高的人上升也較快,個別差異因此隨時間增大。相關為負時軌跡扇形收攏(fan-close),逐漸靠攏。這個相關往往就是實質上關心的量(substantive quantity),它說的是某個結果變項上的不平等(inequality)會隨時間拉大還是縮小;而且它由模型自由估計出來,不是先假定好的。
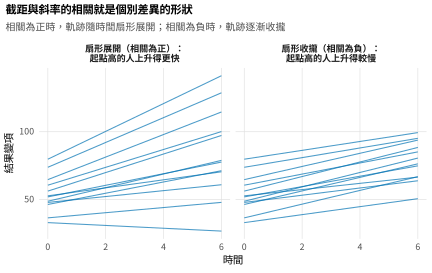
註:模擬軌跡。左:截距與斜率相關為正,起點高的人上升較快,軌跡向外扇形展開。右:相關為負,起點高的人上升較慢,軌跡逐漸收攏。T 矩陣裡估計出來的這個相關,描述的是個別差異隨時間增大還是縮小。
隨機效果還有一項後果,把本章與前兩章接了起來。這個模型是以條件的方式設定的,也就是設定屬於個人的直線;但它同時隱含了重複測量之間的一個邊際共變數(marginal covariance),把隨機效果積分掉就得到。對第 \(i\) 個人而言,若隨機效果的設計矩陣為 \(\mathbf{Z}_i\),觀察值的邊際共變數就是 \(\mathbf{Z}_i \mathbf{T} \mathbf{Z}_i' + \sigma^2 \mathbf{I}\)。這一個式子解釋了很多事。只有隨機截距時,\(\mathbf{Z}_i \mathbf{T} \mathbf{Z}_i' + \sigma^2 \mathbf{I}\) 的非對角線是常數,那正是第 11 章重複量數變異數分析所假定的複合對稱(compound symmetry):隨機截距模型就是那個分析,只是把它的球形假設攤在明處。有隨機斜率時,隱含的共變數則是變異數隨時間增大、相關隨間隔衰退,這個結構現實得多,任何固定的共變數菜單都給不出來。圖 13.3 把兩種隱含的共變數畫成熱圖。同一個式子,也就是第 12 章廣義估計方程用工作相關去近似的那個邊際共變數;第 19 章還會證明,潛在成長模型(latent growth model)重現的正是同一個共變數結構。一個條件模型,於是把變異數分析的球形、邊際模型的工作相關與成長模型的共變數結構全部包了進來。表 13.1 把同一個模型在幾個文獻傳統中的不同名字對了起來。
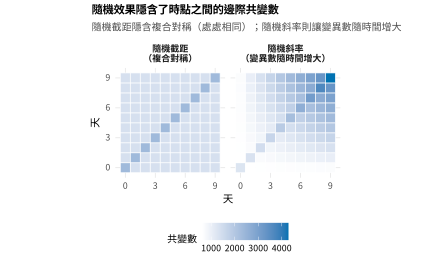
註:兩個模型所隱含的邊際共變數 \(\mathbf{Z}_i\mathbf{T}\mathbf{Z}_i' + \sigma^2\mathbf{I}\)。左:隨機截距隱含複合對稱,任意兩個時點之間的共變數都相同,正是重複量數變異數分析所假定的結構。右:隨機斜率隱含變異數隨時間增大、相關隨間隔衰退,這種結構任何固定的共變數菜單都給不出來。
表 13.1 同一個模型,五種文獻傳統。
| 名稱 | 起源領域 | 強調的重點 |
|---|---|---|
| 階層線性模型(hierarchical linear model) | 教育、社會學 | 巢套(nesting)的層次;脈絡效果 |
| 混合效果模型(mixed-effects model) | 統計、生物統計 | 固定效果加隨機效果 |
| 隨機係數模型(random-coefficients model) | 計量經濟 | 係數隨單位(unit)而變 |
| 變異數成分模型(variance-components model) | 動物育種、遺傳 | 變異數的分割(partition) |
| 多層次模型(multilevel model) | 跨學科 | 具巢套結構的資料 |
註:這些是同一個模型的不同名字。名詞會分歧,是因為這個模型在好幾個領域各自獨立發展出來,但底下的數學完全相同:在其中一個架構下得到的結果,可以精確地翻譯到另一個架構。
13.2 估計:軟體到底做了什麼
變異數參數由兩種概似方法之一估出來,而這項區分在實務上很有影響。最大概似(maximum likelihood, ML)最大化完整的概似來估計變異數成分,但它把固定效果當成已知,變異數估計值因而向下偏誤,就像把樣本變異數除以 \(n\) 而不是 \(n-1\) 一樣。受限最大概似(restricted maximum likelihood, REML)改從已經把固定效果投影掉的殘差來估變異數成分,這項偏誤就消失了,報告變異數估計值時它是恰當的預設(default)。兩者在模型比較上還有一項影響重大的差別。REML 改動了概似中屬於固定效果的那一部分,固定效果不同的兩個模型因此不能拿 REML 概似互相比較:固定效果的概似比檢定必須在最大概似之下進行,隨機效果的檢定則兩者皆可。表 13.2 把這些規則列了出來。
表 13.2 最大概似與受限最大概似。
| 工作 | 方法 | 理由 |
|---|---|---|
| 報告變異數估計值 | REML | 變異數成分不偏 |
| 比較固定效果的結構 | ML | 固定效果不同時 REML 概似不可比 |
| 比較隨機效果的結構 | 兩者皆可(偏好 REML) | 固定部分沒有改變 |
| 最終報告的模型 | REML | 變異數估計最好 |
註:實務上的做法(protocol)是:建模與比較各用恰當的方法,最終模型再以受限最大概似重配一次,以供報告。多數軟體的預設是 REML。
估計有時會走到邊界(boundary),回報為奇異配適(singular fit):某個變異數被估到零,或某個隨機效果相關被估到正負一。這不是錯誤,而是一則訊息,說的是資料撐不起所要求的隨機效果結構。最常見的原因是群集太少,或每個群集的時點太少而識別不出斜率變異數,也可能是兩個隨機效果幾乎共線(collinear)。正確的回應不是無視這個警告,而是有原則地把隨機結構簡化,做法在第 13.5 節發展。R 裡有兩套實作分工。lme4 快,又能處理交叉隨機效果(crossed random effects),是本書各個模型的主力;nlme 較慢,但可以直接配適殘差共變數結構與異質變異(heteroscedasticity),第 14 章的成長模型會用到這些能力。配適好的模型輸出應該逐行讀懂,第 13.6 節的實作範例會完整標註一份。
13.3 推論
混合模型的推論比一般迴歸細緻,而對這份細緻誠實,是把模型用好的一部分。就固定效果來說,困難在於檢定統計量的精確分配未知:資料不平衡、誤差又相關時,分母的自由度不是一個簡單的計數。lme4 套件刻意不報 \(p\) 值,原因正在這裡,不是因為混合模型有爭議,而是因為沒有唯一正確的自由度可報。實務上的解法是 Satterthwaite 與 Kenward-Roger 兩種近似,它們估計一個有效自由度(effective degrees of freedom),Kenward-Roger 還會一併調整標準誤。兩者在 R 中都有現成的實作,小樣本下的校準(calibration)也都遠比樸素的大樣本常態近似好。圖 13.4 說明這項修正為什麼要緊。在一項模擬中,建立在樸素常態近似上的信賴區間,群集數少時涵蓋率嚴重不足,六個群集時掉到百分之九十二以下;Satterthwaite 區間則全程守在名目的百分之九十五附近。教訓很清楚:群集少時,自由度修正不是可有可無的裝飾,而樣本最小時以 Kenward-Roger 為佳 (Luke, 2017; McNeish, 2017)。
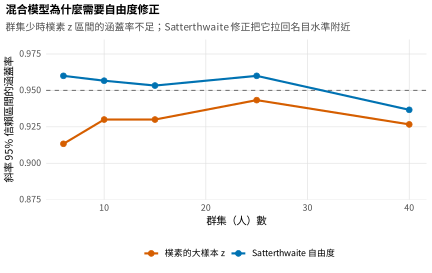
註:某個固定斜率的名目百分之九十五信賴區間,其實徵涵蓋率對群集數作圖,資料來自一項模擬。樸素的大樣本區間在群集少時涵蓋率不足,Satterthwaite 自由度修正把涵蓋率拉回名目水準附近。Kenward-Roger 的表現類似,樣本最小時以它為佳。
變異數成分(variance components)的推論面對的是另一個問題:變異數不可能是負的,虛無假設因此把參數放在參數空間的邊界上。要檢定一個隨機斜率是否必要,也就是它的變異數是否為零,就不能用配上尋常卡方參照的普通概似比檢定,因為標準理論假定虛無值落在參數空間的內部。在正確的邊界理論之下,概似比統計量服從的不是卡方分配,而是一個混合分配,在恰好等於零的地方有相當可觀的機率質量 (Self & Liang, 1987; Stram & Lee, 1994)。圖 13.5 由模擬畫出這個統計量的虛無分配。零點有一根很高的尖峰,因為變異數的無約束估計有一半的機會是負的,於是被設為零;其餘部分呈卡方的形狀,但落在樸素的卡方密度之下。樸素檢定因此是保守的(conservative),拒絕得太少。修正很簡單:把 \(p\) 值減半,或等價地拿混合分配去比。這件事的實務意涵與一般的擔憂正好相反,危險的不是誤判有隨機斜率,而是漏掉一個真實存在的隨機斜率。
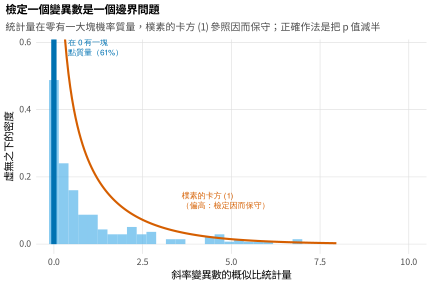
註:斜率變異數的概似比統計量在虛無之下的分配,由模擬得到:零點有一大塊點質量(point mass),正的部分則落在樸素卡方密度(紅)之下。樸素的卡方參照高於真正的虛無分配,樸素檢定因此是保守的;正確的檢定是把 \(p\) 值減半,或改用混合參照。
隨機效果也給出個體量的預測值,也就是最佳線性不偏預測(best linear unbiased predictions, BLUPs),又稱條件眾數(conditional modes),估計的是每個人自己的截距與斜率(person-specific intercept and slope)。它們不是那個人自己的最小平方(ordinary least squares)配適,而是這個配適與母體平均之間、以信度為權重的收縮(shrinkage)折衷,也就是第 7 章談個人平均數時預告過的部分合併(partial pooling)。觀察值多而可靠的人會被信任,預測值就停在自己的資料附近;觀察值少或很嘈雜的人則被收縮向群體,因為個體的估計不可靠時,群體是比較好的猜測。圖 13.6 顯示這件事在 sleepstudy 受試者身上的效果:逐人的最小平方估計被往內拉向合併估計,越不可靠的拉得越多,而收縮權重由基礎概念方塊明確給出。這些預測值對描述很有價值,可以畫毛毛蟲圖(caterpillar plot)與個體軌跡圖;但拿它們當第二階段分析的輸入必須謹慎,把收縮過的估計值當成觀察到的資料,會低估它們的不確定性(uncertainty),讓後續的結果產生偏誤(bias)。表 13.3 收齊了各種推論選項。
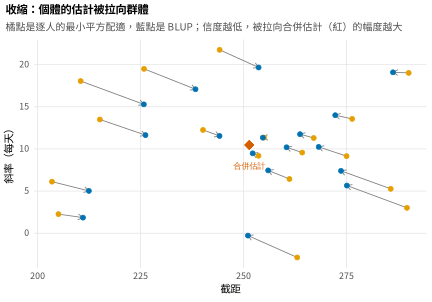
註:sleepstudy 受試者截距與斜率的逐人最小平方估計(橘)與模型的最佳線性不偏預測(藍),並以箭頭連接。預測值被拉向合併估計(紅),一個人自己的估計越不可靠就拉得越多,這就是基礎概念方塊所推導的部分合併折衷。
基礎概念 • 收縮就是以信度為權重的折衷
一個人的隨機截距,其最佳線性不偏預測是 \(\hat{u}_{0i} = \lambda_i (\bar{y}_i - \hat{\gamma}_{00})\),其中 \(\bar{y}_i - \hat{\gamma}_{00}\) 是這個人相對於總平均數的原始偏離,而 \(\lambda_i = \tau_{00} / (\tau_{00} + \sigma^2/n_i)\) 是一個介於零與一之間的信度(reliability)。一個人的觀察值很多時,\(\sigma^2/n_i\) 很小、\(\lambda_i\) 趨近一,預測值幾乎就是這個人自己的偏離。觀察值很少時,\(\sigma^2/n_i\) 很大、\(\lambda_i\) 趨近零,預測值被收縮向群體的平均數零。這個信度 \(\lambda_i\) 正是第 7 章的組內相關(intraclass correlation)邏輯套用在一個人的平均數上,那一章的個人平均數之所以被標記為嘈雜的,原因也在這裡:混合模型把它們換成收縮估計,依每個人的不可靠程度按比例向群體借力。同樣的邏輯用在變異數檢定上,就給出圖 13.5 的混合參照,因為變異數的受約束估計,就是無約束估計被向上收縮到零這個邊界。
表 13.3 混合模型中的推論選項。
| 對象 | 方法 | 註記 |
|---|---|---|
| 固定效果 | Satterthwaite 或 Kenward-Roger 自由度 | 修正小樣本涵蓋率不足;\(N\) 最小時偏好 KR |
| 固定效果 | 概似比檢定(在 ML 之下) | 比較巢套的固定結構 |
| 固定效果 | 參數拔靴法(parametric bootstrap);輪廓信賴區間(profile CI) | 最可靠但計算很重 |
| 變異數成分 | 邊界修正的概似比檢定 | \(p\) 值減半;用混合參照 |
| 個體效果 | BLUP 加上條件變異數(conditional variance) | 用於描述;不宜無批判地當成兩階段(two-stage)分析的輸入 |
註:最常見的單一錯誤,是報告未修正自由度(uncorrected degrees of freedom)的固定效果檢定,或未修正卡方的變異數檢定。兩種修正都有現成的工具,都應該用。
一個斜率該不該當成隨機的,一部分是統計問題,一部分是設計問題,這件事也真的引起過一場爭論。一種立場主張,驗證性的分析應該納入設計所能支持的最大隨機效果結構(maximal random-effects structure),凡是被檢定效果所在的群集內預測變項都給一個隨機斜率,因為省略它會膨脹偽陽性率(false-positive rate) (Barr et al., 2013)。相對的立場主張,最大結構往往是資料撐不起來的,會產生第 13.2 節的奇異配適並損失檢定力,隨機結構應該修剪到資料識別得出來的程度 (Matuschek et al., 2017)。這場爭論起源於實驗心理語言學(psycholinguistics),那裡設計平衡、群集也多,搬到縱貫的情境必須小心,因為每個人的時點往往很少。本書的立場居中:理論核心的個體內效果納入隨機斜率;資料撐不起完整結構時就簡化,而不是硬撐出一個奇異配適;並報告固定效果的結論對所選隨機結構的敏感度(sensitivity)。實務方塊把這場爭論消化過一遍。
實務要點 • 「保持最大」之爭,落到實務上的解法
最大立場 (Barr et al., 2013) 與精簡立場 (Matuschek et al., 2017) 各自說對了一件事。省略一個真的會變動的隨機斜率,確實會膨脹對應固定效果的偽陽性率,因為模型把相關的觀察值當成了獨立的證據。但硬要一個資料識別不出來的最大結構,會產生奇異配適、浪費檢定力,也可能讓原本想作的固定效果檢定變得不穩定。可行的解法分三段。第一,讓理論挑選候選的隨機斜率:唯有研究問題本身所在的那個個體內預測變項,才配得上一個隨機斜率。第二,讓資料裁決可行性:最大模型若是奇異的,先拿掉隨機效果之間的相關(也就是 (x || id) 的寫法),再拿掉理論上最不核心的那個斜率,直到配適不再奇異。第三,報告敏感度:把隨機結構寫出來,說明固定效果的結論在一個更簡單與一個更豐富的結構之下是否都成立,讓讀者看見結果並不繫於一個任意的選擇。
13.4 中心化:改變問題本身的那個抉擇
在縱貫混合模型中,後果最嚴重、也最常被處理錯的抉擇,是一個時間變動預測變項要怎麼中心化。中心化決定了這個預測變項的係數究竟在回答哪一個問題,而候選的問題有兩個。第 1 章預告過的完整處理就在這裡。時間變動預測變項 \(x_{it}\) 可以像第 7 章那樣分解成一個個人平均數 \(\bar{x}_{i\cdot}\) 與一個個體內偏離 \(x_{it} - \bar{x}_{i\cdot}\),兩個成分與結果變項的關係可以完全不同。個人平均數中心化(person-mean centering)又稱群集內中心化(centering within cluster),放進模型的是偏離 \(x_{it} - \bar{x}_{i\cdot}\),它的係數因此是純粹的個體內效果:一個人高於自己平常水準一個單位時,結果變項預期改變多少。再把個人平均數 \(\bar{x}_{i\cdot}\) 當成第二層的預測變項一起放進去,它的係數就捕捉到個體間效果:兩個平常水準相差一個單位的人,結果變項預期差多少。相對地,只放原始預測變項 \(x_{it}\) 而不放個人平均數,等於逼一個係數同時扮演兩個角色;那個係數是個體內與個體間效果以變異數為權重的混合(variance-weighted blend),除非兩者恰好相同,否則它哪一個都不是。總平均數中心化(grand-mean centering)只是移動截距,解不開這個混淆,因為它改的是原點,並沒有把層次分開。
個體內與個體間效果符號相反時,這個抉擇的後果最嚴重,而圖 13.7 正好在第 1 章引進的咖啡因與疲倦資料上顯示了這一點。在個體內,喝得比平常多與感覺比較不疲倦有關,個體內效果為負,\(-0.78\)。在個體間,習慣喝比較多咖啡因的人比較疲倦,個體間效果為正,\(+0.89\),推測是疲倦驅動了習慣性的攝取。原始係數 \(-0.78\) 只抓到個體內的那半個故事,把正向的個體間關聯完全遮住,這正是個人平均數中心化要防止的生態謬誤(ecological fallacy)。同一張圖也給了一個同號的例子:壓力與負向情緒的資料裡,個體內效果(\(0.35\))與個體間效果(\(0.46\))指向同一個方向,大小卻不同;原始係數即使不在符號上誤導,仍然混淆了兩個不同的量。脈絡效果(contextual effect)是個體間係數與個體內係數之差,往往就是實質上關心的量:一個人相對於其他人的位置,在這個人當下的狀態之外還額外有多少影響 (Curran & Bauer, 2011; Enders & Tofighi, 2007)。另一種等價的參數化是 Mundlak 設定,把原始預測變項與個人平均數一起放進去,個人平均數的係數就可以直接讀成脈絡效果。它會還原出同樣的個體內效果,也把混合模型接上計量經濟的固定效果估計式(fixed-effects estimator),第 21 章的交叉延宕模型會再走一次這座橋。表 13.4 是中心化的總表。
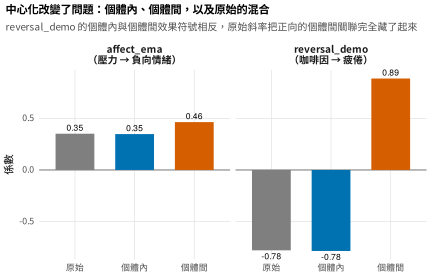
註:原始、個體內(個人平均數中心化)與個體間(個人平均數)三種設定所得的係數。左:壓力與負向情緒,兩個效果同號但大小不同。右:咖啡因與疲倦,個體內效果為負、個體間效果為正,原始係數把正向的個體間關聯完全藏了起來。只有個人平均數中心化能把兩者分開。
表 13.4 中心化的選擇與估計標的。
| 設定 | 放進去的預測變項 | 斜率估計的是 |
|---|---|---|
| 原始 | \(x_{it}\) | 個體內與個體間的混合;一般而言哪一個都不是 |
| 總平均數中心化 | \(x_{it} - \bar{x}\) | 同一個混合,只是截距移動了 |
| 個人平均數中心化 | \(x_{it} - \bar{x}_{i\cdot}\) | 純粹的個體內效果 |
| 中心化再加平均數 | \((x_{it} - \bar{x}_{i\cdot})\) 與 \(\bar{x}_{i\cdot}\) | 分開的個體內(偏離)與個體間(平均數) |
| Mundlak | \(x_{it}\) 與 \(\bar{x}_{i\cdot}\) | 個體內(原始)與脈絡(平均數) |
註:這個選擇不是裝飾:它決定了係數回答的是個體內還是個體間的問題。個體內的研究問題必須採個人平均數中心化,而且應該把個人平均數一起放進去,才不會把個體間效果丟掉。
13.5 實作流程
建一個混合模型是一連串有原則的決定,不是一道指令,而把這個順序記錄下來,本身就是分析的一部分。穩健的策略從無條件平均數模型開始,也就是只有隨機截距、沒有預測變項的模型,它給出組內相關(intraclass correlation, ICC),並確認多層次結構確有必要。接著加入時間的固定效果,以及任何由理論驅動的固定預測變項;再對核心的個體內效果加入隨機斜率。這一連串模型要用恰當的概似方法比較:改動固定效果時用最大概似,改動隨機效果時兩者皆可。每一步都記在一張建模表裡,範本見表 13.5,讀者才跟得上從虛無模型走到最終設定的推理。估計無法收斂或回報奇異配適時,依序套用圖 13.8 的排除流程:先把預測變項重新調整規模(rescale)並中心化,讓最佳化器(optimizer)面對可比的規模;再簡化隨機結構,先移除相關,再移除最不核心的斜率;接著換一個或合併多個最佳化器,並提高疊代上限。若那個結構是概似真的撐不起來的,最後一步是走向第 17 章的貝氏估計,它的先驗(prior)可以把弱識別(weakly identified)的變異數正則化(regularize)。
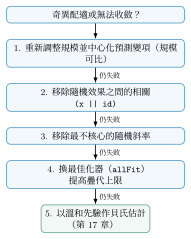
註:當混合模型無法收斂或回報奇異配適時,依序套用。每一步對付一個常見的原因:規模不佳的預測變項、過於野心的隨機結構,以及最佳化器的設定。最後一步是貝氏估計,它的先驗可以把概似識別不出來的變異數正則化。奇異配適是一則關於資料的訊息,不是一個該被壓下去的錯誤。
配適好的模型必須診斷,而混合模型在兩個層次上都有殘差與假設。圖 13.9 是 sleepstudy 模型的診斷圖組。第一層殘差應該同質變異(homoscedastic)且大致常態,用殘差對配適值的圖與分位數圖(quantile plot)檢查;隨機效果應該近似常態,用它自己的分位數圖檢查;隨機截距與隨機斜率的聯合分配(joint distribution)則顯示兩者的相關,以及有沒有離群(outlying)的人。可以放心的是,混合模型的固定效果估計對隨機效果的非常態相當穩健,隨機效果分位數圖上的輕微偏離並不致命;不過影響力(influence)極端的人值得細看 (Schielzeth et al., 2020)。最後,解釋的變異數以 Nakagawa and Schielzeth (2013) 的邊際與條件 \(R^2\) 摘要。邊際的那個此處為 \(0.30\),是單靠固定效果解釋的變異數比例;條件的那個此處為 \(0.79\),是固定效果與隨機效果一起解釋的比例,兩者之間的落差就是個別差異多添了多少。Rights and Sterba (2019) 的架構更完整,把解釋的變異數分解成可解讀的群集內(within-cluster)與群集間(between-cluster)來源,在來源本身要緊時它才是認真的答案;Nakagawa 那組指標則當作通用的貨幣。兩者都應該優先於樸素的擬 \(R^2\) (pseudo-\(R^2\))來報告,因為後者的行為可能反常,甚至在加入一個有用的預測變項時反而下降。
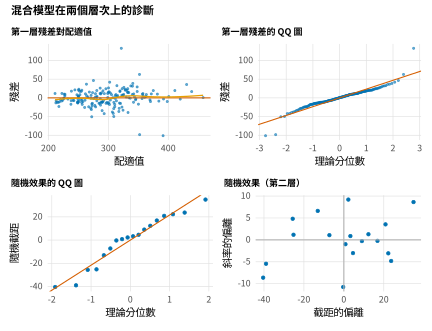
註:sleepstudy 模型的診斷。上:第一層殘差對配適值,以及它的分位數圖。下:隨機截距的分位數圖,以及隨機截距與隨機斜率的聯合分配。混合模型在兩個層次上都有假設;固定效果對隨機效果輕微的非常態相當穩健,但有影響力的個人值得細看。
表 13.5 建模過程的記錄範本。
| 模型 | 設定 | 估計 | 目的 |
|---|---|---|---|
| M0 | 截距、隨機截距 | REML | 組內相關;是否有巢套 |
| M1 | \(+\) 時間的固定效果 | ML | 平均軌跡 |
| M2 | \(+\) 固定共變項 | ML | 理論驅動的效果 |
| M3 | \(+\) 時間的隨機斜率 | REML | 改變上的個別差異 |
| M4 | \(+\) 跨層次交互作用(cross-level interaction) | ML | 改變的調節(moderation) |
| 最終 | 選定的模型 | REML | 報告的估計值 |
註:把順序記錄下來,讀者才跟得上從虛無模型(null model)走到最終設定的推理,也才看得出哪些效果通過了哪一次比較。固定效果的比較用最大概似;報告的模型以受限最大概似重配。
13.6 實作範例與報告
sleepstudy 資料把整段歷程完整走了一遍。無條件模型給出的組內相關是 \(0.39\),反應時間(reaction time)的變異數有三分之一以上穩定地落在個體之間,多層次模型因而有其必要。加入天數的固定效果就確立了平均軌跡:每多剝奪一天睡眠,反應時間大約增加十毫秒。再加入隨機斜率則顯示,人們在這個速率上差異相當大,斜率的標準差大約是每天六毫秒;截距與斜率的相關接近零,起始的反應時間因此預測不了惡化的速率。最終配適的模型畫在圖 13.10,一邊疊在資料上,一邊畫成個體斜率的毛毛蟲圖,這兩種「模型疊資料」(model-over-data)的呈現方式是第 8 章立為標準的。天數的固定效果估計為每天 \(10.47\) 毫秒,檢定配上 Satterthwaite 修正(\(SE = 1.55\),\(t = 6.77\),\(\mathit{df} = 17\),\(p < .001\)),邊際與條件 \(R^2\) 分別是 \(0.30\) 與 \(0.79\)。示範段落可以這樣寫:「反應時間以線性混合模型建模,包含天數的固定效果、一個隨機截距,以及天數在受試者之間的隨機斜率,以 lme4 的受限最大概似估計,自由度由 lmerTest 依 Satterthwaite 法提供。反應時間每天增加 \(10.47\) 毫秒(\(SE = 1.55\),\(\mathit{df} = 17\),\(p < .001\))。受試者在增加的速率上差異相當大(斜率 \(SD = 5.9\) 毫秒/天),截距與斜率的相關可以忽略。固定效果與隨機效果合起來解釋了 \(79\%\) 的變異數(邊際 \(R^2 = .30\))。」表 13.6 是這一段所滿足的報告檢核表,也是後續成長、廣義與密集資料各章沿用的標準。
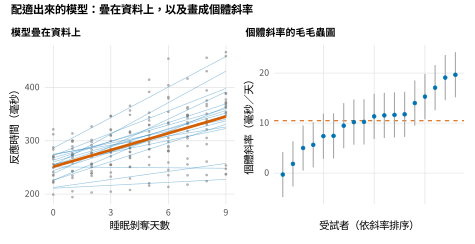
註:左:配適好的 sleepstudy 模型,個體預測軌跡(藍)與固定效果軌跡(紅)疊在觀察資料上。右:個體斜率與其區間的毛毛蟲圖,依大小排序;區間不含平均斜率(虛線)的受試者,惡化得比典型的人可靠地更快或更慢。這是第 8 章的兩種標準「模型疊資料」呈現方式。
表 13.6 線性混合模型的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 模型設定 | 固定效果、隨機效果,以及各自變動的層次,以階層或合併形式寫出 |
| 估計 | 方法(ML/REML)、軟體與版本,最佳化器(optimizer)若非標準設定也要寫 |
| 固定效果的推論 | 估計值、標準誤,以及自由度的方法(Satterthwaite/Kenward-Roger) |
| 隨機效果 | 各變異數、截距與斜率的相關、殘差變異數,並附上任何檢定所用的方法 |
| 中心化 | 時間變動預測變項如何中心化,以及每個係數估計的是什麼 |
| 建模過程 | 比較過的模型順序,以及最終選擇的判準 |
| 解釋的變異數 | 邊際與條件 \(R^2\);收斂(convergence)與奇異配適的說明 |
註:這份檢核表是本書的標準,第 14 到 16 章與第 23 章都會沿用。實務上最常漏掉的是自由度的方法、中心化的選擇,以及隨機結構的理由,而這三者每一項都會改變所報告數字的意義。
13.7 在 R 中執行混合模型
模型以 lme4 的 lmer 配適;載入 lmerTest 就得到 Satterthwaite 檢定,它會在摘要中補上自由度與 \(p\) 值。建模順序與中心化各只需要幾行。
library(lme4); library(lmerTest); library(dplyr)
data(sleepstudy)

m0 <- lmer(Reaction ~ 1 + (1 | Subject), sleepstudy)        # 虛無模型:ICC
m1 <- lmer(Reaction ~ Days + (1 | Subject), sleepstudy)     # 加固定斜率
m2 <- lmer(Reaction ~ Days + (Days | Subject), sleepstudy)  # 加隨機斜率
summary(m2)                                                 # Satterthwaite df
ranova(m2)                                                  # 隨機斜率的邊界檢定
VarCorr(m2); confint(m2)                                    # 變異數;輪廓 CI
個人平均數中心化把個體內與個體間效果分開,做法是先分組轉換,再把兩個成分一起放進模型;邊際與條件 \(R^2\) 則由預測值的變異數算出。
# --- 以個人平均數中心化作個體內/個體間分解 ---
ae <- readRDS("Examples/data/affect_ema.rds") |>
  filter(!is.na(na), !is.na(stress)) |>
  group_by(person) |> mutate(pm = mean(stress), cwc = stress - pm) |> ungroup()
lmer(na ~ cwc + pm + (1 | person), ae)     # cwc = 個體內效果;pm = 個體間效果

# --- Nakagawa 的邊際/條件 R^2 ---
vf <- var(predict(m2, re.form = NA)); vt <- var(predict(m2)); ve <- sigma(m2)^2
c(marginal = vf/(vf + (vt-vf) + ve), conditional = (vt)/(vt + ve))
完整的分析都在隨附的腳本 ch13_analysis_V01.R 裡,包括邊界概似比檢定與 Satterthwaite 涵蓋率兩項模擬,以及收縮的計算。中文版的圖形則由 ch13_figures_zh_V01.R 繪出。nlme 套件以不同的語法配適同樣的模型,並加上第 14 章會用到的殘差共變數結構;performance 與 r2mlm 兩個套件則可以自動算出解釋變異數的各種指標。
軟體提示 • 在不同軟體之間讀同一個模型
線性混合模型在 SPSS 中由 MIXED 配適,在 Stata 中是 mixed,在 SAS 中是 PROC MIXED,另外還有 HLM 程式。只要手上有表 13.1 的名詞對照,這些軟體的輸出就可以互相對應:lme4 印成隨機效果變異數的東西,SPSS 標為共變數參數,HLM 標為 tau。跨軟體有兩項要注意。第一,預設的自由度方法不同:SAS 與 Stata 提供 Kenward-Roger 或 Satterthwaite,有些軟體的預設卻是樸素的大樣本值,所以方法必須刻意設定,並且寫進報告。第二,多數套件的預設估計是 REML,但固定效果的比較需要 ML,各程式切換的方式不一樣。Mplus 的 TYPE = TWOLEVEL 架構以結構方程的參數化配適同一個模型,那正是第 19 章要發展的,屆時混合模型與潛在成長模型的等價性就會變得明白。
13.8 常見的迷思
關於混合模型,有幾種說法會誤導讀者。第一種是隨機效果只是為了處理非獨立性的干擾修正。它們往往就是現象本身,也就是驅動整項研究的、改變上的個別差異(individual differences in change);斜率變異數與截距斜率相關是實質的發現(substantive findings),不是統計上的記帳。第二種是 lme4 拒絕印 \(p\) 值代表混合模型有爭議。那只反映了分母自由度真正的困難,而這個困難已經由 Satterthwaite 與 Kenward-Roger 修正解決。第三種是關於隨機結構的一對相反錯誤:隨機效果越多越安全與奇異配適代表模型錯了。隨機結構應該與理論的要求、資料的支撐能力相稱,而奇異配適是一則要你簡化的訊息,不是失敗的判決。第四種是虛無模型算出來的組內相關在加入預測變項之後仍然有意義。預測變項一進場,變異數成分就是條件的(conditional),虛無模型的組內相關不再描述所配適的模型。還有一個反覆被問到的問題:需要多少群集、多少時點?誠實的答案是「看效果與設計而定」,最好由第 4 章以模擬為基礎的檢定力分析(power analysis)來決定。固定效果所需的群集數比變異數成分少,而變異數成分在群集數低於大約三十時就估得很差。
常見陷阱 • 混合模型實務上的四個錯誤
第一,跨固定結構比較 REML 離差:固定效果不同時 REML 概似不可比,固定效果的概似比檢定必須改在最大概似之下重配。第二,把奇異配適當成拔光所有隨機斜率的理由:正確的做法是依序簡化,先拿掉相關,而不是放棄理論所要求的隨機結構。第三,把原始分數的係數解讀成個體內效果:少了個人平均數中心化,那個係數是個體內與個體間效果的混合,甚至可能帶著錯的符號(圖 13.7)。第四,把下降的擬 \(R^2\) 讀成配適變差:有些擬 \(R^2\) 指標在加入一個有用的預測變項時反而會下降,那是它們建構方式造成的假象(artifact);請改用邊際與條件指標,或 Rights-Sterba 分解。
本章摘要
線性混合模型是本書的核心工具。它以階層形式寫出,屬於個人的那條直線,其係數環繞著母體平均變動;另有一個等價的合併形式,把固定效果、隨機效果與殘差分開(圖 13.1)。隨機效果的共變數,也就是 T 矩陣,描述水準上與改變上的個別差異以及兩者的相關,而這個相關的形狀就是軌跡的扇形展開或收攏(圖 13.2)。隨機效果隱含一個邊際共變數 \(\mathbf{Z}_i\mathbf{T}\mathbf{Z}_i' + \sigma^2\mathbf{I}\),把變異數分析的球形與邊際模型的工作相關都包了進去(圖 13.3)。估計以最大概似進行,或為了變異數不偏而改用受限最大概似,而奇異配適(singular fit)是一則「資料撐不起所要求的隨機結構」的訊息。固定效果的推論需要 Satterthwaite 或 Kenward-Roger 自由度修正,它在小樣本下把涵蓋率救了回來(圖 13.4);變異數的推論是一個邊界問題,樸素的卡方檢定偏保守(圖 13.5);個體效果則是依不可靠程度按比例向群體借力(borrowing strength)的收縮預測(圖 13.6)。個人平均數中心化把一個時間變動預測變項的個體內效果與個體間效果分開,兩者在大小甚至符號上都可能不同,原始係數因此哪一個問題都回答得不乾淨(圖 13.7)。模型以一套有記錄的順序建起來,以一份有次序的流程排除問題(圖 13.8),在兩個層次上診斷(圖 13.9),以邊際與條件解釋變異數摘要,並依一份檢核表報告(圖 13.10)。
接下來讀哪裡
第四部到第六部的一切都建立在本章上。第 14 章把模型專門化到成長,時間成為核心的預測變項,而軌跡的形狀,也就是線性、多項式或分段,本身成為研究的對象。第 15 章把它延伸到非常態的結果變項,也就是廣義線性混合模型,那是第 12 章邊際模型的個體特定對應項;第 16 章則把個體內變異數本身也模型化。第 17 章提供貝氏估計,用來拯救本章排除流程最後停在的那些弱識別隨機結構。第 19 章揭示潛在成長模型就是結構方程形式的同一個模型,第 13.1 節的隱含共變數會在那裡以因素結構的樣貌現身。第 21 章把固定效果與中心化這座橋帶進交叉延宕追蹤模型的爭論,第 23 章則把整套工具用在密集縱貫資料上。這裡建立的符號與流程是它們共同的語言,其中中心化那一節尤其會被反覆引用:只要有時間變動預測變項出現,個體內與個體間的區分就會跟著出現。
習題
- 13.1 在兩種形式之間互譯。就一個給定的兩層模型,寫出階層形式與合併形式,並以文字解讀每一個固定效果、變異數、共變數與殘差。
- 13.2 建一整套順序。在所提供的縱貫資料集上,把模型從虛無建到最終,每一步都記在一張建模表裡,並對照一個更簡單與一個更豐富的替代方案,為最終的隨機結構辯護。
- 13.3 用三種方式中心化。對一個時間變動預測變項配適原始、總平均數中心化與個人平均數中心化三種設定,寫出三種解讀,並指出哪一個係數回答的是個體內的問題。
- 13.4 涵蓋率模擬。以模擬估計固定斜率在十五個群集時 Satterthwaite 信賴區間的涵蓋率,並與樸素區間比較。
- 13.5 診斷並修復。給定一個植入了問題的不收斂模型(時間變項沒有調整規模,隨機結構又過度參數化),套用排除流程,並報告最後可用的模型。
- 13.6 邊界檢定。以模擬驗證斜率變異數的概似比統計量在虛無之下於零有一塊點質量,並顯示樸素的卡方檢定是保守的。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 階層形式 | hierarchical form | 把第一層與第二層分開寫的模型形式;第 13.1 節 |
| 合併形式 | combined form | 把兩層代入後合成一式的形式;第 13.1 節 |
| 固定效果 | fixed effects | 母體平均的截距與斜率;第 13.1 節 |
| 隨機效果 | random effects | 個人相對於母體平均的偏離;第 13.1 節 |
| T 矩陣 | T matrix | 隨機效果的共變數矩陣;第 13.1 節 |
| 扇形展開/收攏 | fan-spread / fan-close | 截距與斜率相關為正/為負時軌跡的形狀;第 13.1 節 |
| 邊際共變數 | marginal covariance | \(\mathbf{Z}_i\mathbf{T}\mathbf{Z}_i' + \sigma^2\mathbf{I}\);第 13.1 節 |
| 最大概似 | maximum likelihood (ML) | 變異數成分向下偏誤;用於比較固定結構;第 13.2 節 |
| 受限最大概似 | restricted maximum likelihood (REML) | 變異數成分不偏;報告時的預設;第 13.2 節 |
| 奇異配適 | singular fit | 變異數估到零或相關估到 \(\pm 1\);一則要你簡化的訊息;第 13.2 節 |
| Satterthwaite 修正 | Satterthwaite approximation | 固定效果的有效自由度;第 13.3 節 |
| Kenward-Roger 修正 | Kenward-Roger approximation | 同時調整自由度與標準誤;最小樣本時偏好;第 13.3 節 |
| 邊界問題 | boundary problem | 虛無值落在參數空間邊界,卡方參照因而保守;第 13.3 節 |
| 最佳線性不偏預測 | best linear unbiased prediction (BLUP) | 個體效果的收縮預測值;第 13.3 節 |
| 收縮 | shrinkage | 以信度為權重、向群體借力的折衷;第 13.3 節 |
| 個人平均數中心化 | person-mean centering | 放入個體內偏離以得到純粹的個體內效果;第 13.4 節 |
| 脈絡效果 | contextual effect | 個體間係數減個體內係數;第 13.4 節 |
| Mundlak 設定 | Mundlak specification | 原始預測變項加個人平均數;平均數的係數即脈絡效果;第 13.4 節 |
| 邊際與條件 \(R^2\) | marginal and conditional \(R^2\) | 單靠固定效果/固定加隨機效果解釋的變異數比例;第 13.5 節 |
參考文獻
Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001
Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62, 583–619. https://doi.org/10.1146/annurev.psych.093008.100356
Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989X.12.2.121
Hamaker, E. L., & Grasman, R. P. P. P. (2015). To center or not to center? Investigating inertia with a multilevel autoregressive model. Frontiers in Psychology, 5, Article 1492. https://doi.org/10.3389/fpsyg.2014.01492
Hox, J. J., Moerbeek, M., & van de Schoot, R. (2018). Multilevel analysis: Techniques and applications (3rd ed.). Routledge. https://doi.org/10.4324/9781315650982
Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
Laird, N. M., & Ware, J. H. (1982). Random-effects models for longitudinal data. Biometrics, 38(4), 963–974. https://doi.org/10.2307/2529876
Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y
Matuschek, H., Kliegl, R., Vasishth, S., Baayen, H., & Bates, D. (2017). Balancing Type I error and power in linear mixed models. Journal of Memory and Language, 94, 305–315. https://doi.org/10.1016/j.jml.2017.01.001
McNeish, D. (2017). Small sample methods for multilevel modeling: A colloquial elucidation of REML and the Kenward-Roger correction. Multivariate Behavioral Research, 52(5), 661–670. https://doi.org/10.1080/00273171.2017.1344538
Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining $R^2$ from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage.
Rights, J. D., & Sterba, S. K. (2019). Quantifying explained variance in multilevel models: An integrative framework for defining R-squared measures. Psychological Methods, 24(3), 309–338. https://doi.org/10.1037/met0000184
Schielzeth, H., Dingemanse, N. J., Nakagawa, S., Westneat, D. F., Allegue, H., Teplitsky, C., Réale, D., Dochtermann, N. A., Garamszegi, L. Z., & Araya-Ajoy, Y. G. (2020). Robustness of linear mixed-effects models to violations of distributional assumptions. Methods in Ecology and Evolution, 11(9), 1141–1152. https://doi.org/10.1111/2041-210X.13434
Self, S. G., & Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association, 82(398), 605–610. https://doi.org/10.1080/01621459.1987.10478472
Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel analysis: An introduction to basic and advanced multilevel modeling (2nd ed.). Sage.
Stram, D. O., & Lee, J. W. (1994). Variance components testing in the longitudinal mixed effects model. Biometrics, 50(4), 1171–1177. https://doi.org/10.2307/2533455
Verbeke, G., & Molenberghs, G. (2000). Linear mixed models for longitudinal data. Springer. https://doi.org/10.1007/978-1-4419-0300-6
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。