第 23 章
日記與密集縱貫資料的多層次模型
本章開啟第六部分,資料的型態與問題的型態同時換了一輪。第五部分的追蹤設計(panel design)只測量一個人幾次,密集縱貫(intensive longitudinal)設計則測量許多次:一天好幾個時刻,連續數天或數週,靠日記(diary)、經驗取樣(experience sampling)與生態瞬時評估(ecological momentary assessment)收資料。測量密度讓一種新的問題問得出口,那是個體內(within-person)的問題:不問「壓力較大的人和壓力較小的人有什麼不同」,而問「一個人在自己壓力比平常高的那些時刻,情緒怎麼動」。第 13 章的多層次模型(multilevel model)就是回答它的工具,在這裡重新派上用場,另外再補上密集個體內資料額外要求的幾項做法:中心化(centering)仍是推論的核心,而且現在還要延伸到延宕(lagged)的預測變項上;時刻巢套(nested)在天之內、天巢套在人之內;一天與一週的週期(cycle)要建構出來;趨勢(trend)要看問題處理,波動(fluctuation)的問題把它移除,變化的問題把它建模;相鄰時刻帶著序列依賴(serial dependence);歷程展開的過程中還有中介(mediation)與調節(moderation)。對社會、人格與臨床心理學的許多讀者來說,本章就是那個目的地,最像他們自己手上的資料,因此本章寫成可以獨立閱讀。本章同時也標出一條界線。多層次模型把動態(dynamics)當成要收拾乾淨的干擾項(nuisance);等到動態本身成為問題,估計標的(estimand)變成「一個系統如何把自己帶到下一刻」,就換第 24 到 28 章的工具接手,而本章最後會精確標出交棒的位置。
學習目標
讀完本章之後,你應該能夠:(1) 把一個個體內的歷程問題翻譯成多層次模型的設定,並把隨機斜率(random slope)讀成該歷程上的個別差異;(2) 對延宕的預測變項套用中心化準則,並以密集縱貫的語言解讀個體內效果、個體間(between-person)效果與脈絡效果(contextual effect);(3) 依設計與組內相關(intraclass correlation, ICC)的證據,在兩層次、三層次與交叉分類(cross-classified)結構之間作選擇;(4) 以正弦餘弦項建構日內與每週的節律,還原振幅(amplitude)與相位(phase),並讓節律因人而異;(5) 依估計標的決定要去趨勢(detrend)還是把趨勢建模,並認出趨勢滲漏(trend leakage);(6) 處理第一層的序列依賴,分辨 AR(1) 殘差結構與延宕依變項(lagged outcome)設定各自的估計標的與偏誤(bias);(7) 估計個體內的 1-1-1 中介,連同它的隨機效果共變數項與正確的不確定性;(8) 寫出一份完整、經得起審查的日記研究結果一節。
23.1 歷程問題與個體內迴歸
密集縱貫分析最關鍵的一步,是把問題問進個人的內部。以壓力與負向情緒(negative affect)為例。個體間的問題問的是:報告壓力較多的人,是不是也報告較多的負向情緒?這問的是人與人之間怎麼排序。個體內的問題問的是:同一個人在自己壓力比平常高的那些時刻,是不是覺得更糟?這問的是一個人自己的狀態如何隨時間一起移動。兩者在邏輯上截然不同,甚至可以正負相反,而第 13 章那一整套中心化做法存在的目的,就是把兩者分開。把當下的預測變項作個人平均數中心化(person-mean centering),也就是從每一筆當下的壓力報告中減去這個人自己的平均壓力,就分離出個體內的偏離(within-person deviation);以這個偏離為預測變項(predictor)去跑迴歸(regression),直接回答的就是個體內的問題。各人的平均數另外放進模型,承載個體間的訊息。這種拆解(disaggregation)由 Curran and Bauer (2011) 與 Wang and Maxwell (2015) 為追蹤資料發展出來,中心化的規範則由 Enders and Tofighi (2007)、Hoffman and Stawski (2009) 與 Hamaker and Muthén (2020) 定下。這與第 13.4 節是同一套準則,只是在本章每一步都要用到,因為這裡的每一個預測變項都在人之內測了很多次。分析這類資料有很長的方法學系譜,從 West and Hepworth (1991) 對日常經驗資料的早期處理,到 Hektner et al. (2007) 的經驗取樣手冊。
圖 23.1 把個體內的問題畫了出來。每一格是一個人自己的迴歸:把當下的負向情緒迴歸到個人平均數中心化之後的當下壓力上,取自 ema_stress 的十二個人。這份資料來自一項為期兩週的經驗取樣研究,120 人、每天六次提示(beep)。斜率明顯不同:有人的情緒隨壓力陡升,有人幾乎不動,還有一個人落在量尺(scale)的地板(floor)上,是平的。這些差異不是繞著一條共同斜率的雜訊,不該平均掉,它就是現象本身。人與人在「自己的情緒對自己的壓力有多敏感」這件事上並不相同,這是一項個別差異(individual differences)的發現,而只報告平均斜率的模型,會把資料裡最有意思的東西丟掉。這正是隨機斜率的實質讀法,出自 Bolger and Zuckerman (1995) 的人格歷程(personality process)傳統與 Bolger et al. (1989) 的日常壓力研究:隨機斜率的變異數是一項個別差異的發現,至於「用個人層次的共變項去解釋它」,那是下一個問題。
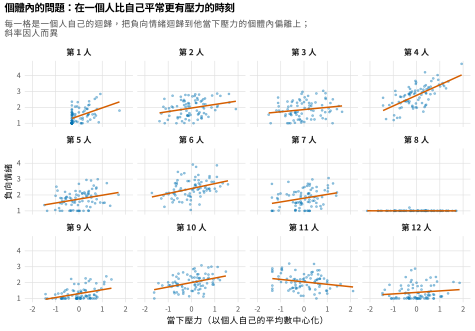
註:每一格把一個人當下的負向情緒迴歸到個人平均數中心化之後的當下壓力上,取自 ema_stress 的十二個人。斜率因人而異:有些人反應陡峭,有些人幾乎是平的。要研究的是這份異質性(heterogeneity),不是只有那條平均斜率。
多層次模型把這件事形式化。把第 \(i\) 個人在第 \(t\) 個時點的負向情緒寫作 \(\mathrm{na}_{it}\)、個人平均數中心化之後的壓力寫作 \(\mathrm{stress}^{wc}_{it}\),模型 \(\mathrm{na}_{it} = \beta_{0i} + \beta_{1i}\,\mathrm{stress}^{wc}_{it} + \gamma_2\,\overline{\mathrm{stress}}_i + e_{it}\) 讓截距 \(\beta_{0i}\) 與斜率 \(\beta_{1i}\) 在人與人之間隨機。固定效果(fixed effect)的斜率估計的是平均的個體內壓力反應性(reactivity),斜率的變異數(variance)估計的則是它的異質性。配適到 ema_stress 上,平均的個體內壓力反應性在情緒量尺上是 \(0.27\),隨機斜率的標準差不小:從幾乎不反應到強烈反應的人都有。圖 23.2 畫出各人反應性的分配,以及分配兩端的兩個人,一個的情緒緊跟著壓力走,另一個不跟。這份散開的程度就是發現。
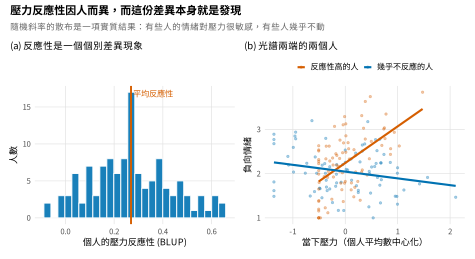
註:(a) 由 ema_stress 的隨機斜率模型算出來的各人壓力反應性(最佳線性不偏預測(best linear unbiased prediction, BLUP))的分配,直線標示平均數。(b) 反應性最高與最低的兩個人:一個人的負向情緒隨當下的壓力上升,另一個人幾乎是平的。人與人之間的這份差異是一項實質結果,不是統計上的保險。
反應性一旦確認會因人而異,下一個問題就是什麼在解釋它,而答案是跨層次交互作用(cross-level interaction):用一個個人層次的共變項去調節那條個體內斜率。在 ema_stress 中擔任這個角色的是神經質(neuroticism)。把個人平均數中心化的壓力與神經質的交互作用加進去,也就是 \(\beta_{1i} = \gamma_{10} + \gamma_{11}\,\mathrm{neuroticism}_i + u_{1i}\),估出 \(\gamma_{11}=0.13\)(\(SE=0.01\)):神經質較高的人,對自己的壓力反應較強。圖 23.3 把這個交互作用探測(probe)出來,畫的是預測的個體內斜率如何隨神經質的全距(range)而變,附上信賴帶(confidence band),各人的反應性散在它周圍。這個跨層次交互作用解釋掉一部分的斜率變異數,把描述出來的異質性變成建模出來的異質性。從問題到模型設定的這套文法,整理在表 23.1。
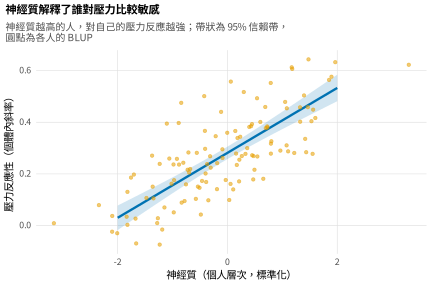
註:預測出來的個體內壓力反應性斜率隨神經質上升,線條附 95% 信賴帶,圓點是各人的反應性。這個跨層次交互作用解釋掉圖 23.2 所呈現的反應性異質性當中的一部分。
表 23.1 從歷程問題到多層次模型的設定。
| 問題(「在……的那些時刻」這個文法) | 模型設定 |
|---|---|
| 一個人在自己壓力比平常高的那些時刻,情緒是不是更糟? | 把壓力作個人平均數中心化;以個體內偏離為預測變項、加上隨機截距去迴歸情緒 |
| 反應性因人而異嗎? | 為那個個體內的預測變項加上隨機斜率 |
| 誰的反應性比較強? | 加上一個跨層次交互作用(interaction)(個人層次共變項 \(\times\) 個體內預測變項) |
| 個體間也存在關聯嗎? | 把該預測變項的個人平均數另外放進模型 |
| 昨天的狀態會不會延續到今天? | 加上一個延宕的預測變項或延宕依變項(第 23.5 節) |
註:個體內偏離回答歷程問題;個人平均數承載個體間的訊息;隨機斜率與它的調節變項承載個別差異。把這三者分開的,就是中心化。
23.2 結構:這個設計造出幾個層次?
密集設計把觀察值巢套進一個階層裡,分析者必須決定要建幾個層次。提示巢套在人之內,這是前面用的兩層次結構。提示同時也巢套在「天」之內,天再巢套在人之內,這給出三層次結構。同一批「一天中的時段」又在各天重複出現,所以提示還被個人與時段交叉分類。圖 23.4 把三者畫出來。這個決定不只是技術性的。「天」層次的隨機效果代表某件真實的東西:一個人的某一天整體上比較好或比較糟,凌駕於那一天之內的當下起伏。這一層確實存在卻被忽略時,聚集(clustering)的程度會被低估,推論也可能扭曲。要用幾個層次,證據來自第 7 章那套組內相關的邏輯,現在用到多出來的「天」這一層上。
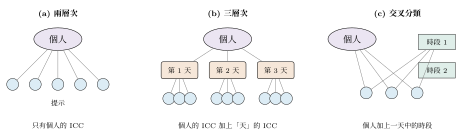
註:(a) 提示(藍色圓點)只當成巢套在人之內。(b) 提示巢套在人之內的「天」裡面,多出一個「天」層次的隨機效果,承載整天的高低。(c) 提示被個人與重複出現的時段交叉分類。虛無模型(null model)估出來的各層次組內相關,是選擇的依據。
在 ema_stress 上,三層次的虛無模型把負向情緒的變異數分解成三份:個人的、人之內各天的,以及提示層次的。個人的組內相關是 \(0.42\),可見有很大一部分變異數是穩定的個體間差異,這正是中心化要緊的理由。多出來的「天」層次那一份是 \(0.06\),不大但不為零:天確實把它裡面的提示聚在一起,三層次模型也就捕捉得到「一個人的星期二整體上可能比星期三糟」這件事。要不要帶第三層是一項判斷,得在這份證據、精簡原則(parsimony)與收斂(convergence)之間權衡,表 23.2 把這個決定攤開來。另一個相關的問題是預測變項住在哪一層:是「當下的一次壓力報告」,還是「一天彙總起來的壓力」。這屬於第 5 章提過的建構(construction)選擇。把當下的報告彙總(aggregate)成一天的平均數,會造出一個天層次的預測變項,它自己又分成天與天之間、天之內兩個部分,所以這道彙總要是刻意的,不能是不小心的。
表 23.2 層次結構的選擇。
| 設計特徵 | 證據 | 結構 |
|---|---|---|
| 提示只巢套在人之內,「天」的分組不是興趣所在 | 個人 ICC 不小;「天」的 ICC 接近零 | 兩層次(提示在人之內) |
| 整天的高低講得通 | 三層次虛無模型中「天」層次的 ICC 不為零 | 三層次(提示在天之內、天在人之內) |
| 重複出現的時段在人與人之間共享變異數 | 時段層次的聚集 | 交叉分類(個人 \(\times\) 時段) |
| 關心的是天層次的預測變項 | 該預測變項是逐天定義的 | 彙總到天的層次,再作分解 |
註:虛無模型算出來的組內相關是主要的證據。「天」層次的 ICC 接近零,支持較簡單的兩層次模型;不為零、又對整天效果有實質興趣,就支持三層次。收斂上的成本(見實務要點方塊)也與這個選擇有關。
23.3 一天之內與一週之內的時間:週期
情緒在一天之中不是平的,而是有節律(rhythm),隨著時辰上升或下降。那條日內節律(diurnal rhythm)要不是一個要移除的干擾項(nuisance),就是一個要研究的現象;無論哪一種,都得建模,否則它會汙染其他一切。標準的工具是三角函數迴歸(trigonometric regression):在一天這個週期上放一對正弦與餘弦,\(\beta_c\cos(2\pi\,h/24) + \beta_s\sin(2\pi\,h/24)\),其中 \(h\) 是時辰,用兩個係數就表示了一條平滑的週期。這一對係數比看起來好解讀,因為它們可以還原成振幅與相位:振幅 \(\sqrt{\beta_c^2+\beta_s^2}\) 是由當日平均數擺盪到高峰的幅度,相位 \(\arctan(\beta_s/\beta_c)\) 則把高峰定位在一天當中的哪個時刻。基礎概念方塊給出代數與 delta 法(delta method)的信賴區間。在 ema_stress 上,配適出來的餘弦與正弦係數是 \(0.23\) 與 \(0.12\),還原成 \(0.26\) 的振幅(\(SE=0.01\));負向情緒在中午前後最低,整個下午一路上升到傍晚的高峰。圖 23.5 畫出配適出來的節律與它的振幅,以及一組因人而異的節律。
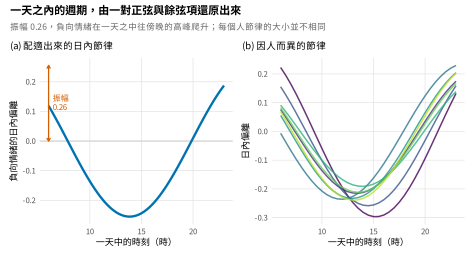
註:(a) 由一對正弦餘弦項得到的母體日內節律,振幅 \(0.26\):負向情緒在中午前後下探,往傍晚上升。(b) 由隨機的正弦與餘弦係數得到的個人節律,人與人在每日擺盪的大小與形狀上並不相同。振幅與相位都由那兩個三角函數係數還原而得。
基礎概念 • 由一對正弦餘弦項還原振幅與相位;中介的共變數項
一條寫成 \(\beta_c\cos\theta + \beta_s\sin\theta\)(其中 \(\theta = 2\pi h/24\))的日週期,等價於 \(A\cos(\theta-\phi)\),振幅 \(A=\sqrt{\beta_c^2+\beta_s^2}\)、相位 \(\phi=\arctan_2(\beta_s,\beta_c)\),所以那兩個迴歸係數編碼的就是「一天一個平滑高峰」的高度與時機。振幅的標準誤由 delta 法得到:梯度為 \((\beta_c/A,\ \beta_s/A)\),配上兩個係數的共變數矩陣 \(\mathbf{V}\),則 \(\widehat{SE}(A)=\sqrt{\mathbf{g}^\top\mathbf{V}\mathbf{g}}\)。讓正弦與餘弦係數隨人而異,就得到因人而異的振幅與相位。多層次中介則另有一套代數。\(a\) 路徑(預測變項到中介變項)與 \(b\) 路徑(中介變項到結果變項)都在人與人之間隨機時,平均的個體內間接效果(indirect effect)不是 \(a\,b\),而是 \(a\,b + \mathrm{cov}(a_i,b_i)\):兩個隨機斜率的共變數要加到它們平均數的乘積上 (Bauer et al., 2006)。省略這個共變數項會讓間接效果產生偏誤,而它正是多層次中介裡最常被忘記的一個量。
週期是干擾項還是現象,取決於問題。如果關心的是壓力反應性,日內節律只是一個變異數來源,那就把週期偏除(partial out)然後忘掉它:放著不管會把殘差膨脹,還會與同樣隨時辰變動的預測變項混淆(confound)。如果關心的是節律本身,是時型(chronotype),是「有些人的情緒在早晨到頂、有些人在夜裡到頂」這件事,那麼因人而異的振幅與相位就是估計標的。一週的週期值得同等的照料:負向情緒在週末可能較低,用一個平日與週末的對比(contrast)或一個星期幾的因子(factor)就捕捉得到。Liu and West (2016) 警告,沒有建模的每週週期是日記資料中常見的疏漏。在 ema_stress 中,週末對負向情緒的效果是 \(-0.06\)。表 23.3 是週期設定的菜單。
表 23.3 建構週期的一份菜單。
| 目的 | 模型設定 | 還原 |
|---|---|---|
| 固定的日內週期 | \(\beta_c\cos\theta + \beta_s\sin\theta\),\(\theta=2\pi h/24\) | \(A=\sqrt{\beta_c^2+\beta_s^2}\),\(\phi=\arctan_2(\beta_s,\beta_c)\) |
| 因人而異的節律 | 讓 \(\cos\theta\) 與 \(\sin\theta\) 的斜率隨機 | 每個人各自的振幅與相位 |
| 兩個諧波(harmonic)(一天兩次) | 再加上 \(\cos 2\theta\)、\(\sin 2\theta\) | 第二諧波的振幅 |
| 平日與週末 | 週末指標變項或星期幾的因子 | 每週的對比 |
| 週期隨共變項而變 | 讓三角函數項與共變項交互 | 隨共變項而變的節律 |
註:三角函數項用很少的參數給出一條平滑的週期,而且振幅與相位還原得出來;星期幾的因子則是一個較不平滑的替代方案。週期要當干擾項偏除,還是當現象估出來,由研究問題決定。
23.4 趨勢:波動與變化的分岔
兩週之內,一個人的情緒可能會漂移,而那條趨勢逼出一個完全取決於估計標的的決定。如果問題是關於波動,關於一個人在有壓力的那些時刻情緒如何繞著自己的水準移動,那麼趨勢就是汙染物:它會把個體內變異數膨脹;更糟的是,預測變項本身若也有趨勢,它還會滲漏進個體內效果。如果問題是關於變化,關於這個人的水準本身如何演變,那麼趨勢就是訊號,必須建模,通常是放進一個「成長加歷程」(growth-and-process)的合成模型,同時帶著一條軌跡(trajectory)與環繞著它的個體內波動。這個分岔的用語,是刻意與第 14.4 節的時間變動共變項(time-varying covariate)處理、以及第 25 章的動態模型協調過的,因為這是同一套準則在三個地方現身。
滲漏值得看清楚。圖 23.6 模擬一個隨時間有趨勢的個體內預測變項,以及一個既依賴該預測變項的波動、又帶著自己趨勢的結果變項。預測變項照慣例作個人平均數中心化時,中心化之後的偏離裡仍然含著趨勢,而結果變項裡的趨勢與它相關,於是估出來的個體內效果被膨脹到 \(0.38\),真值則是 \(0.30\)。改成逐人去趨勢,也就是在形成個體內偏離之前先把每個人的線性趨勢迴歸掉,就把真相還原到 \(0.30\)。教訓是:個人平均數中心化假設了定態性(stationarity),趨勢存在時,中心化之前必須先去趨勢,或者把趨勢當共變項放進去,否則個體內效果就會把它吸收進來。表 23.4 陳述這個分岔。
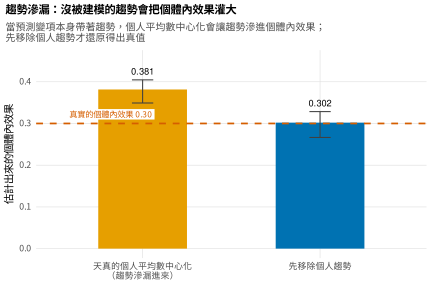
註:個體內的預測變項隨時間有趨勢時,天真的個人平均數中心化會讓趨勢滲漏進個體內效果,把它灌到真值 \(0.30\) 之上。中心化之前先逐人去趨勢,就還原得出真相。長條是模擬樣本上的平均數,鬍鬚是第 \(2.5\) 到第 \(97.5\) 百分位數。
表 23.4 趨勢的分岔:波動對變化。
| 估計標的 | 作法 | 選錯的後果 |
|---|---|---|
| 個體內的波動 | 逐人去趨勢(線性或樣條(spline))之後再中心化;或把時間當共變項放進去 | 把趨勢留著會把個體內效果膨脹或扭曲 |
| 個體內的變化 | 把趨勢建模(成長曲線加上個體內歷程) | 去趨勢會把真正關心的訊號移掉 |
| 兩者都要 | 成長加歷程的合成模型:軌跡加上中心化之後的波動 | 把兩者混為一談,水準的變化會與當下的反應性攪在一起 |
註:這個選擇由問題決定,不由資料決定。波動的問題要求一段定態的個體內序列,所以趨勢要移除;變化的問題需要那條趨勢,所以要把它建模。與第 14.4 節及第 25 章協調一致。
23.5 昨天有影響:延宕與序列依賴
相鄰的時刻並不獨立。一個人此刻覺得糟,過不久往往還是覺得糟,第一層的這份序列依賴一定要處理;但要怎麼處理,是一個真正的分岔,兩條路回答不同的問題,也帶著不同的偏誤。第一條路把相依當成殘差的性質:個體內的誤差是自我相關(autocorrelated)的,用一個一階自我迴歸(first-order autoregressive, AR(1))結構,其中 \(e_{it}=\rho\,e_{i,t-1}+\text{雜訊}\),把它建模可以校正個體內效果的標準誤,而不改變它們的意義。個體內反應性仍然是估計標的;AR(1) 只是承認歷程的雜訊不是白雜訊(white noise)。在 ema_stress 上,以一般化最小平方(generalized least squares)配適的 AR(1) 殘差結構把自我相關估在 \(0.30\)。圖 23.8 顯示,忽略它的模型裡明顯存在的殘差自我相關,一旦把 AR(1) 放進去就被漂白了。第二條路把先前的狀態放進平均數模型,作為延宕依變項,也就是把當下的情緒迴歸到它自己前一刻的值上。這改變了估計標的:各項係數現在都以先前的狀態為條件,而延宕依變項的係數本身就是一個實質的量,是情緒的延續效果(carryover),或稱慣性(inertia)。圖 23.7 把兩者畫出來,表 23.5 陳述各自何時較好。
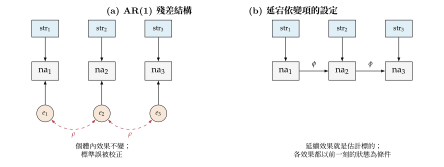
註:(a) AR(1) 殘差結構把個體內誤差當成自我相關的(\(\rho\)),個體內反應性不變,只有它的標準誤被校正。(b) 延宕依變項的設定把前一刻的情緒放進平均數模型(\(\phi\)),延續效果成為估計標的,所有效果也都變成以前一刻的狀態為條件。兩者回答不同的問題。
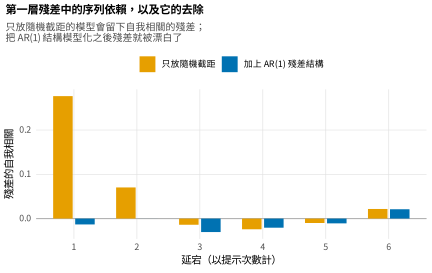
註:在 ema_stress 上,只放隨機截距的模型所留下的第一層殘差,其自我相關(橘色)呈現 AR(1) 的特徵:延宕一期的相關接近 \(0.28\),並隨延宕遞減。把 AR(1) 殘差結構建模之後,殘差就被漂白了(藍色)。這項診斷應該出現在每一份密集縱貫的報告裡。
延宕依變項這條路帶著一個必須明講的危險。放進個人的隨機截距(random intercept)的同時,又把當下的情緒迴歸到它自己前一刻的值上,每人的時點數少時會產出一個有偏誤的延續係數,因為隨機截距與延宕依變項相關,而從很少的觀察值(observation)裡估不好它。圖 23.9 用模擬把它量出來:真實的延續效果為 \(0.40\) 時,隨機截距的估計值在五個時點時被膨脹到 \(0.62\),要等到時點數增長到數十個才落回真值。這是第 21 章遇過的 Nickell 偏誤 (Nickell, 1981) 在多層次世界的對應物;在那裡,同一個估計式的固定效果版本是往相反方向、向下偏誤。兩者在 \(T\) 小的時候都不可信,而 McNeish and Stapleton (2016) 綜覽了各種小樣本的校正。誠實的結論是:延宕依變項模型需要每人有很多時點;當動態才是真正的興趣所在,第 25 章的動態結構方程模型(dynamic structural equation model)才是正確估計它們的地方。在延宕依變項模型還站得住腳的範圍內,它對真正動態的問題是有價值的:控制住今天的情緒之後,今天的衝突能不能預測明天的情緒?這種跨日的延續效果對比,正是 Bolger and Laurenceau (2013) 與 Laurenceau et al. (1998) 這個傳統的招牌分析。圖 23.10 在 ema_stress 上把同時效果與延宕效果並排:當下的壓力在當刻把情緒推得很強,情緒的延續效果不小,而延宕的壓力效果在以前一刻的狀態為條件之後實質為負(\(-0.09\),約為同時效果的三分之一),這是一種回彈的形態,只看同時關聯的分析看不見。
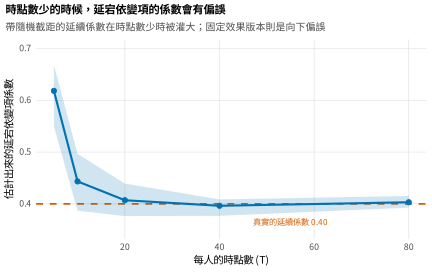
註:真實的延續係數為 \(0.40\) 時,帶隨機截距的延宕依變項估計值在每人時點數少的時候被膨脹,要等到時點數增加才落回真值。同一個估計式的固定效果版本則是向下偏誤(第 21 章)。兩者在 \(T\) 小的時候都會誤導人,這正是第 25 章那套工具存在的理由。
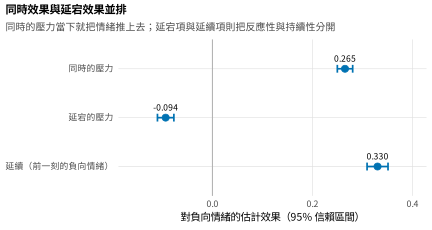
註:在 ema_stress 上:當下的壓力在同一個時刻把負向情緒推得很強;先前的情緒延續效果不小;而延宕的壓力效果在以前一刻的狀態為條件之後實質為負(\(-0.09\),約為同時效果的三分之一),是一種回彈。把同時效果與延宕效果分開,是密集縱貫研究的一項招牌分析。
表 23.5 序列依賴的分岔。
| 作法 | 估計標的 | 偏誤風險 | 何時較好 |
|---|---|---|---|
| AR(1) 殘差 | 個體內反應性,不變 | 不新增偏誤;標準誤被校正 | 相依是干擾項,反應性才是問題 |
| 延宕依變項 | 延續效果;各效果以前一刻的狀態為條件 | 時點數少時的偏誤(隨機截距往上,固定截距往下) | 延續效果就是實質問題,而且時點數夠多 |
| 完整的動態模型(第 25 章) | 因人而異的動態 | 處理得當 | 動態本身就是估計標的 |
註:這個選擇由估計標的決定,不由配適決定。相依是干擾項、反應性才是問題,就把它建成 AR(1) 殘差。延續效果才是問題,就用延宕依變項,但要有足夠的時點。動態本身就是目標時,交棒給第 25 章。
23.6 個體內的中介與調節
一個歷程問題往往帶著一套機制:壓力提高反芻(rumination),反芻又提高負向情緒。這條鏈上的三個變項都在人之內重複測量,是一個 1-1-1 中介。多層次那套做法估得出它,但其中有一個細微之處,正是這個領域裡最常見的錯誤。由壓力到反芻的 \(a\) 路徑與由反芻到情緒的 \(b\) 路徑都在人與人之間變動,而兩個隨機斜率相乘時,乘積的期望值不是兩個平均數的乘積,而是乘積再加上它們的共變數:平均的個體內間接效果是 \(a\,b + \mathrm{cov}(a_i,b_i)\)。把共變數項省略掉,像天真的兩模型作法那樣,會讓間接效果產生偏誤。Bauer et al. (2006) 的解法是把兩條方程式堆疊(stack)進單一個多層次模型一起估計,並讓 \(a\) 路徑與 \(b\) 路徑的隨機效果互相共變,共變數項就直接讀得出來。圖 23.11 畫出這個帶著隨機路徑的 1-1-1 模型。
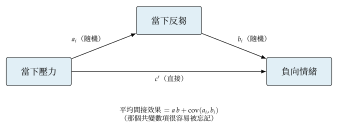
註:三個變項都在人之內重複測量。\(a\) 路徑(壓力到反芻)與 \(b\) 路徑(反芻到情緒)在人與人之間隨機變動,所以平均的個體內間接效果是 \(a\,b + \mathrm{cov}(a_i,b_i)\),也就是兩條平均路徑的乘積再加上它們的共變數。直接路徑 \(c'\) 是扣掉中介那條路之後剩下的反應性。
以堆疊模型配適到 ema_stress 上,\(a\) 路徑是 \(0.34\)、\(b\) 路徑是 \(0.23\)、直接路徑是 \(0.19\);固定的間接效果 \(a\,b\) 是 \(0.076\),蒙地卡羅(Monte Carlo) 95% 信賴區間為 \([0.062, 0.091]\),估出來的 \(a\) 與 \(b\) 的共變數再加上 \(0.006\),所以平均的總間接效果是 \(0.081\)。蒙地卡羅區間的作法,是從兩條路徑的聯合抽樣分配中抽樣,再取乘積的百分位數(percentile);間接效果的抽樣分配(sampling distribution)並不常態,這才是恰當的不確定性(uncertainty)。這與第 21 章的中介是同一套邏輯,只是搬進了人之內。Vuorre and Bolger (2018) 那種貝氏(Bayesian)實作在一個步驟裡同時處理隨機的共變數與區間,軟體可用時往往是最乾淨的路。Preacher et al. (2010) 的多層次結構方程架構是另一個有原則的選擇,它把中介的個體內部分與個體間部分明確分開。個體內的調節,也就是兩個個體內預測變項的交互作用,遵守同一套中心化紀律:兩個預測變項都要作個人平均數中心化,乘積也要由中心化之後的版本形成,否則交互作用會把個體內與個體間的效果混在一起。
23.7 完整的示範研究與報告
本章的各項做法合起來是一套工作流程,而 ema_stress 把它從頭走到尾。研究問題有三個:情緒對當下的壓力是否有反應、那份反應性如何變動又如何解釋(反應性與它的調節);情緒是否延續、壓力又如何跨時間運作(持續性與延宕效果);以及反芻是否在人之內中介了壓力與情緒的連結(機制)。結構的決定,由組內相關來看,是一個「天」層次佔比不大的三層次模型。週期建了模,一對日內的正弦餘弦(sine-cosine)項加一個週末對比,在這裡當成要偏除的干擾項。趨勢檢查過,而這是一項波動研究,所以有趨勢的地方就把它移除。序列依賴以 AR(1) 殘差處理,因為主要的估計標的是反應性而不是延續效果,殘差(residual)的自我相關也診斷過、漂白(whiten)過。反應性模型交出一個接近 \(0.27\) 的平均個體內效果,帶著可觀的異質性,其中一部分由神經質解釋掉;中介模型交出間接效果與它的共變數項;診斷確認殘差已經漂白。圖 23.12 是這項研究的一張總覽:間接效果的蒙地卡羅分配,以及主要效果對照它們的生成真值,每一項都還原到接近真值。
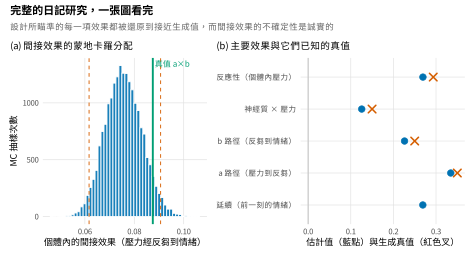
註:(a) 個體內間接效果(壓力經反芻到情緒)的蒙地卡羅分配,附 95% 區間與真實的 \(a\,b\)。(b) 本研究的主要效果,估計值(藍色)對照它們的生成真值(紅色叉);設計所瞄準的每一項效果都還原到接近真值。完整腳本以 ch23_analysis_V01.R 隨書提供。
報告這樣一項研究的結果一節,義務不只是一張係數表。表 23.6 把第 13 章的報告檢核表延伸到密集縱貫的細節上:中心化的陳述,說清楚哪些預測變項作了個人平均數中心化、個人平均數又怎麼放進模型;延宕的建構,說清楚延宕怎麼形成、有沒有跨過整夜的空檔;週期與趨勢的決定,說清楚建模了什麼、又把什麼當干擾項偏除;相依的處理,說清楚用的是 AR(1) 殘差還是延宕依變項、以及為什麼;還有軟體與版本,因為這些模型對估計式(estimator)與最佳化器(optimizer)很敏感。Gabriel et al. (2019) 與 Myin-Germeys and Kuppens (2021) 的開放手冊收集了這個領域正在成形的標準,Nezlek (2011) 與 Hoffman (2015) 則給了整本書篇幅的建模處理。常見陷阱、實務要點與軟體提示三個方塊,整理了反覆出現的危險、收斂上的成本,以及語法。
常見陷阱 • 密集縱貫分析出錯的四種方式
第一,時間變動的預測變項帶著趨勢,卻拿全樣本的個人平均數去中心化,趨勢就滲漏進個體內效果;波動問題碰上趨勢,要先去趨勢。第二,建構延宕時默默跨過了整夜的空檔,一天的第一次提示被迴歸到前一天最後一次提示上,好像中間沒有隔一個晚上;延宕要在天之內作,或者刻意決定那個夜間空檔怎麼處理。第三,把延宕依變項模型裡的共變項效果讀成總效果,但它們是以前一刻的狀態為條件的,回答的是另一個問題。第四,用兩個各自獨立的模型去估 1-1-1 中介,再把 \(a\,b\) 報告成間接效果,忘掉隨機路徑所貢獻的 \(\mathrm{cov}(a_i,b_i)\) 那一項。
實務要點 • 放幾條隨機斜率,以及要多少資料
一個密集縱貫模型能承載的隨機斜率數量有限,超過就不收斂,而第 13.5 節的流程在這裡適用:為那些「異質性本身值得關心」的效果加上隨機斜率、檢定它們,收斂困難時先簡化共變數結構,再考慮把斜率本身拿掉。這類設計的檢定力(power)有兩個樣本數,人數與每人的時點數,兩者做的工作不同:人數為個體間的問題與個體內斜率的調節變項提供檢定力,時點數則為個體內效果與它們的異質性提供檢定力。要偵測反應性的異質性,也就是一個變異數,代價很高,需要人多、每人的時點也多。第 4 章的檢定力工具可以把這個取捨量化出來,而誠實的結論是:隨機斜率的變異數比固定效果難偵測得多。
軟體提示 • 跨程式的密集縱貫模型
在 R 中,lme4 配適兩層次與三層次的隨機斜率模型,lmerTest 提供分母自由度(denominator degrees of freedom);nlme 透過 correlation = corAR1(form = ~ occ | person) 加上 AR(1) 殘差結構,本章的序列依賴走的就是這條路。堆疊起來的 1-1-1 中介在 lme4 中的作法,是用選擇指標(selection indicator)把中介變項(mediator)與結果變項(outcome)的兩條方程式堆起來,並讓 \(a\) 路徑與 \(b\) 路徑的隨機效果互相共變;brms 的貝氏版本則把隨機共變數與間接效果的區間一起處理,可用時往往更乾淨。Mplus 以 TYPE = TWOLEVEL 配適這些模型,而它的動態結構方程模型(DSEM)功能是通往第 25 章的門,在那裡延宕的動態由干擾項變成估計標的。完整的分析,也就是本章的每一個模型與模擬,是隨書的 ch23_analysis_V01.R,圖形在 ch23_figures_V01.R,資料集則由 gen_ema_stress_V01.R 建立。中文版的圖另由 ch23_figures_zh_V01.R 產生。
表 23.6 密集縱貫多層次研究的報告檢核表。
| 項目 | |
|---|---|
| 1 | 設計:人數、天數、每天幾次提示、取樣方案,以及配合度(compliance)或遺漏資料(missing data)的情形 |
| 2 | 中心化的陳述:哪些預測變項作了個人平均數中心化,個人平均數又怎麼放進模型 |
| 3 | 層次結構:兩層次、三層次或交叉分類,並附上支持這個選擇的組內相關 |
| 4 | 週期與趨勢的決定:建模了什麼(日內、每週、趨勢),又把什麼當干擾項偏除 |
| 5 | 序列依賴:用 AR(1) 殘差還是延宕依變項、各自瞄準的估計標的,以及一張殘差自我相關函數(autocorrelation function, ACF)診斷圖 |
| 6 | 隨機效果:哪些斜率是隨機的、共變數結構為何,以及收斂情形 |
| 7 | 中介:用的是堆疊估計式還是貝氏估計式、\(a\) 與 \(b\) 的共變數項,以及蒙地卡羅或後驗(posterior)區間 |
| 8 | 軟體、估計式、最佳化器與版本 |
註:把第 13 章的檢核表延伸到密集縱貫的細節上。中心化、延宕的建構、週期、趨勢與相依的處理都是會改變估計標的的分析選擇,所以每一項都必須寫出來,不能留在暗處。
本章摘要
密集縱貫設計讓個體內的問題問得出口,而多層次模型只要該講究的做法都照顧到,就回答得了它。個人平均數中心化把個體內偏離與個體間平均數分開;個體內效果、它的隨機斜率,以及調節那條斜率的共變項,就是反應性、它的異質性與它的解釋,這些個別差異的發現正是整件事的重點。時刻巢套在天之內、天巢套在人之內,這個結構由組內相關讀出來,並據以在兩層次、三層次與交叉分類之間作決定。週期,日內的與每週的,用正弦餘弦項建模,還原得出振幅與相位,也可以因人而異;要當干擾項偏除還是當現象估出來,由問題決定。趨勢逼出一個由估計標的決定的分岔:波動的問題要去趨勢,變化的問題要把趨勢建模,而只中心化卻不去趨勢,會讓趨勢滲漏進個體內效果。序列依賴也是一個分岔:AR(1) 殘差結構保住反應性這個估計標的並校正它的標準誤,延宕依變項則讓延續效果成為估計標的,代價是一個小樣本偏誤(隨機截距時往上、固定效果時往下),而動態本身成為目標時就交棒給第 25 章。個體內的 1-1-1 中介要在兩條平均路徑的乘積上加進隨機 \(a\) 路徑與 \(b\) 路徑的共變數,那是最常被忘記的一項,而它的不確定性是一個蒙地卡羅區間或後驗區間。報告則把多層次的檢核表延伸到中心化、延宕、週期、趨勢與相依這幾項決定上,因為每一項都會改變「估的到底是什麼」。
習題
- 23.1 設定的文法。針對五個「在……的那些時刻」的問題,寫出多層次模型的公式與中心化計畫,再以表 23.1 為對照,和同儕交換批評。
- 23.2 反應性與調節。在
ema_stress上配適隨機斜率的反應性模型,加上神經質的跨層次交互作用,把它探測出來,並寫出結果段落。 - 23.3 週期實作。由正弦餘弦項還原日內的振幅與相位,加上隨機的三角函數斜率,並解讀其中兩個人配適出來的節律。
- 23.4 趨勢滲漏。重現圖 23.6 的滲漏模擬,再寫一份決策備忘錄,說明何時該去趨勢、何時該把趨勢建模。
- 23.5 延宕的分岔。在
ema_stress上同時配適一個 AR(1) 殘差模型與一個延宕依變項模型,用文字把兩者的估計標的對照清楚,指名每一個係數的意義。 - 23.6 個體內中介。以蒙地卡羅區間估計 1-1-1 中介,報告 \(a\) 與 \(b\) 的共變數項,並陳述隨機效果上的告誡。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 密集縱貫 | intensive longitudinal | 一天多次、連續數天或數週的高密度重複測量(承第 1 章);第 23.1 節 |
| 個人平均數中心化 | person-mean centering | 減去個人自己的平均數,分離出個體內偏離;第 23.1 節 |
| 反應性 | reactivity | 個體內預測變項對結果變項的斜率,可因人而異;第 23.1 節 |
| 跨層次交互作用 | cross-level interaction | 個人層次共變項對個體內斜率的調節;第 23.1 節 |
| 組內相關 | intraclass correlation (ICC) | 各層次所佔的變異數比例(承第 7 章);第 23.2 節 |
| 交叉分類 | cross-classified | 觀察值同時屬於兩個非巢套的分組;第 23.2 節 |
| 日內節律 | diurnal rhythm | 一天之內的週期(承第 7 章);第 23.3 節 |
| 振幅與相位 | amplitude and phase | 由一對正弦餘弦係數還原的擺盪大小與高峰時刻;第 23.3 節 |
| 趨勢滲漏 | trend leakage | 未被建模的趨勢被個體內效果吸收;第 23.4 節 |
| 序列依賴 | serial dependence | 相鄰時刻的觀察值不獨立;第 23.5 節 |
| 延宕依變項 | lagged outcome | 把前一刻的結果變項放進平均數模型;第 23.5 節 |
| 延續效果 | carryover | 前一刻的狀態帶到此刻的程度,亦稱慣性(承第 21 章);第 23.5 節 |
| 1-1-1 中介 | 1-1-1 mediation | 三個變項都在個體內重複測量的中介;第 23.6 節 |
參考文獻
Bauer, D. J., Preacher, K. J., & Gil, K. M. (2006). Conceptualizing and testing random indirect effects and moderated mediation in multilevel models: New procedures and recommendations. Psychological Methods, 11(2), 142–163. https://doi.org/10.1037/1082-989X.11.2.142
Bolger, N., DeLongis, A., Kessler, R. C., & Schilling, E. A. (1989). Effects of daily stress on negative mood. Journal of Personality and Social Psychology, 57(5), 808–818. https://doi.org/10.1037/0022-3514.57.5.808
Bolger, N., & Laurenceau, J.-P. (2013). Intensive longitudinal methods: An introduction to diary and experience sampling research. Guilford Press.
Bolger, N., & Zuckerman, A. (1995). A framework for studying personality in the stress process. Journal of Personality and Social Psychology, 69(5), 890–902. https://doi.org/10.1037/0022-3514.69.5.890
Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62, 583–619. https://doi.org/10.1146/annurev.psych.093008.100356
Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989X.12.2.121
Gabriel, A. S., Podsakoff, N. P., Beal, D. J., Scott, B. A., Sonnentag, S., Trougakos, J. P., & Butts, M. M. (2019). Experience sampling methods: A discussion of critical trends and considerations for scholarly advancement. Organizational Research Methods, 22(4), 969–1006. https://doi.org/10.1177/1094428118802626
Hamaker, E. L., & Muthén, B. (2020). The fixed versus random effects debate and how it relates to centering in multilevel modeling. Psychological Methods, 25(3), 365–379. https://doi.org/10.1037/met0000239
Hektner, J. M., Schmidt, J. A., & Csikszentmihalyi, M. (2007). Experience sampling method: Measuring the quality of everyday life. SAGE Publications. https://doi.org/10.4135/9781412984201
Hoffman, L. (2015). Longitudinal analysis: Modeling within-person fluctuation and change. Routledge.
Hoffman, L., & Stawski, R. S. (2009). Persons as contexts: Evaluating between-person and within-person effects in longitudinal analysis. Research in Human Development, 6(2–3), 97–120. https://doi.org/10.1080/15427600902911189
Laurenceau, J.-P., Barrett, L. F., & Pietromonaco, P. R. (1998). Intimacy as an interpersonal process: The importance of self-disclosure, partner disclosure, and perceived partner responsiveness in interpersonal exchanges. Journal of Personality and Social Psychology, 74(5), 1238–1251. https://doi.org/10.1037/0022-3514.74.5.1238
Liu, Y., & West, S. G. (2016). Weekly cycles in daily report data: An overlooked issue. Journal of Personality, 84(5), 560–579. https://doi.org/10.1111/jopy.12182
McNeish, D., & Stapleton, L. M. (2016). Modeling clustered data with very few clusters. Multivariate Behavioral Research, 51(4), 495–518. https://doi.org/10.1080/00273171.2016.1167008
Myin-Germeys, I., & Kuppens, P. (Eds.). (2021). The open handbook of experience sampling methodology: A step-by-step guide to designing, conducting, and analyzing ESM studies (2nd ed.). Center for Research on Experience Sampling and Ambulatory Methods Leuven.
Nezlek, J. B. (2011). Multilevel modeling for social and personality psychology. SAGE Publications. https://doi.org/10.4135/9781446287996
Nickell, S. (1981). Biases in dynamic models with fixed effects. Econometrica, 49(6), 1417–1426. https://doi.org/10.2307/1911408
Preacher, K. J., Zyphur, M. J., & Zhang, Z. (2010). A general multilevel SEM framework for assessing multilevel mediation. Psychological Methods, 15(3), 209–233. https://doi.org/10.1037/a0020141
Vuorre, M., & Bolger, N. (2018). Within-subject mediation analysis for experimental data in cognitive psychology and neuroscience. Behavior Research Methods, 50(5), 2125–2143. https://doi.org/10.3758/s13428-017-0980-9
Wang, L. P., & Maxwell, S. E. (2015). On disaggregating between-person and within-person effects with longitudinal data using multilevel models. Psychological Methods, 20(1), 63–83. https://doi.org/10.1037/met0000030
West, S. G., & Hepworth, J. T. (1991). Statistical issues in the study of temporal data: Daily experiences. Journal of Personality, 59(3), 609–662. https://doi.org/10.1111/j.1467-6494.1991.tb00261.x
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。