第 20 章
潛在變化分數模型與進階成長模型
前面幾章的成長模型描述的是軌跡(trajectory):平均路徑長什麼樣子,人與人之間又如何在它周圍分散。本章要模型化的是另一件事:從這一個時點生出下一個時點的那條變化規則。潛在變化分數模型(latent change score model)把相鄰兩個真分數(true score)之間的變化本身當成一個變項,並為它寫下一條方程式,最常見的形式是「變化有一部分是固定的增量,另一部分是目前水準的一個比例」。從描述軌跡改成指明生成軌跡的規則,這一步是從運動學(kinematic)式的描述轉向動態(dynamic)式的解釋,也是第五部的軌跡模型與第六部的動態模型之間的概念樞紐。「變化是當下狀態的函數」就是一條差分方程(difference equation),是第 27 章那些連續時間微分方程(differential equation)的離散時間表親;把這件事挑明,等於把成長模型重新定位成研究一個系統的動態。本章先發展單變量的變化分數模型與它的軌跡分類,再擴充到兩個耦合(coupled)的歷程,那個著名而且常被濫用的「誰帶動誰」問題就在這裡出現;接著要求一套耦合文獻長期跳過的敏感度紀律;最後把第 18 章那張測量支票兌現在二階成長模型(second-order growth model)上,讓變化配適在恆等的潛在構念上,而不是配適在一個會出錯的複合分數上。
學習目標
讀完本章之後,你應該能夠:(1) 設定一個單變量潛在變化分數模型,包括真分數層、固定為一的路徑與潛在差異變項,並推導常數變化與比例變化如何生出一整族的軌跡形狀;(2) 解讀加法變化參數與比例變化參數,以及兩者對觀測區間(observation interval)的依賴;(3) 配適帶耦合參數(coupling parameter)的雙變量變化分數模型,並以應有的保留解讀一項領先延宕(lead-lag)的主張;(4) 跑完一整套耦合的敏感度檢驗(sensitivity battery);(5) 在恆等的測量之上建構二階成長模型,並說明它的好處;(6) 在 R 中以一個可重複使用的語法產生器(syntax generator)配適這些模型。
20.1 把變化當成一個潛在變項
潛在變化分數模型出自 McArdle 與同僚一項長期的研究計畫 (McArdle, 2009; McArdle & Hamagami, 2001)。它建在一套初學者會覺得陌生的鷹架(scaffolding)上,因為其中幾乎每一條路徑都固定為一,圖 20.1 把這套鷹架畫了出來。每一個觀察分數背後都有一個潛在真分數(latent true score),測量誤差(measurement error)已經去掉;真分數之間以自我迴歸(autoregression)跨時間相連,係數固定為恰好一,於是每一個真分數原封不動地把前一個真分數整個帶過來。流進每一個真分數的是一個潛在變化分數(latent change score),路徑同樣固定為一,所以每個時點的真分數字面上就是前一個真分數加上變化。這是一條恆等式(identity),不是一條迴歸式。模型化的工作全發生在變化分數上。常數變化(constant change)因素以固定為一的負荷量(loading)負荷在每一個變化分數上,每一步貢獻相同的增量(increment),它的平均數就是加法變化參數。比例變化(proportional change)路徑則從每一個真分數走到下一個變化分數,係數在每個區間都相同,使每一次變化裡有一部分是當下水準的一個比例。那些固定為一的路徑不是任意設的:它們強制執行「變化就是相鄰兩個真分數之差」這條恆等關係,好讓自由參數,也就是常數變化的平均數與變異數以及比例係數,成為真正要推論(inference)的對象。
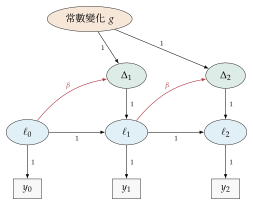
註:潛在真分數 \(\ell_t\) 以固定為一的負荷量撐起觀察分數 \(y_t\);真分數之間的自我迴歸固定為一;每一個潛在變化分數 \(\Delta_t\) 以固定為一的路徑進入它的真分數,強制執行 \(\ell_t = \ell_{t-1} + \Delta_t\) 這條恆等關係。自由參數都在變化上:常數變化因素 \(g\)(負荷量為一,平均數即加法變化)與從前一個水準過來的比例係數 \(\beta\)(紅)。正是這些固定為一的路徑,才使變化成為一個被模型化的潛在變項。
把變化規則寫成 \(\Delta_t = g + \beta\,\ell_{t-1}\) 再展開,就看得出這套裝置為什麼值得費這番工夫:少少幾個參數就生得出一整族的軌跡形狀。只有常數變化時,軌跡是線性的,每一步都是同樣的增量。只有比例變化時,軌跡是幾何式(geometric)的趨近,係數為負就朝零衰減(decay),為正就爆炸性成長。兩者並存時就是雙變化(dual change)模型,軌跡以逐漸減速的方式朝 \(-g/\beta\) 這個漸近值(asymptote)上升或下降,形狀正是第 14 章當作非線性混合模型(nonlinear mixed model)直接配適的那條負指數(negative exponential)。圖 20.2 畫出這套分類:同一條方程式依比例係數的正負與大小,生出常數、衰減、趨近漸近值與加速(acceleration)四種軌跡。表 20.1 則把變化分數的參數化對應到第 14 章的非線性曲線參數化。兩者描述的是同一批曲線,變化分數模型只是從生成它們的規則抵達,而不是從它們所描出的函數抵達。
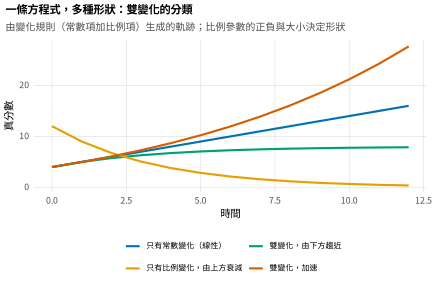
註:由變化規則 \(\Delta_t = g + \beta\,\ell_{t-1}\) 生成的軌跡。比例係數為零給出線性變化;係數為負而沒有常數項給出衰減;正的常數項配上負的係數給出朝漸近值的趨近;係數為正則給出加速。生出這一族形狀的是那條生成規則,不是一條被配適出來的函數。
基礎概念 • 從差分方程到軌跡,再到連續時間
雙變化規則 \(\Delta_t = \ell_t - \ell_{t-1} = g + \beta\,\ell_{t-1}\) 可以整理成線性遞迴關係式(linear recurrence) \(\ell_t = (1+\beta)\,\ell_{t-1} + g\),解為 \(\ell_t = (1+\beta)^t\left(\ell_0 + g/\beta\right) - g/\beta\)。當 \(-2 < \beta < 0\) 時,\((1+\beta)^t\) 這個因子會衰減,\(\ell_t\) 因此以幾何的速度趨近平衡值 \(-g/\beta\),這就是指數式趨近在離散時間中的影像。解出來的軌跡與第 14 章那條負指數曲線相同,對應關係列在表 20.1。這條離散的遞迴關係式是連續時間微分方程 \(d\ell/dt = a + b\,\ell\) 的一個近似,後者的解 \(\ell(t) = e^{bt}(\ell_0 + a/b) - a/b\) 把離散的 \((1+\beta)^t\) 換成連續的 \(e^{bt}\)。兩者只有在觀測區間縮得很小時才吻合。這正是離散的比例係數取決於取樣區間、連續時間的速率卻不取決於取樣區間的原因,也正是第 27 章要解決的問題。
表 20.1 同一批軌跡的變化分數參數化與非線性曲線參數化。
| 變化規則 | 隱含的軌跡 | 第 14 章的對應物 |
|---|---|---|
| 只有常數(\(\beta=0\)) | 線性 | 線性成長 |
| 只有比例 | 幾何式的衰減或成長 | 由零漸近值出發的指數 |
| 雙變化(\(g\) 與 \(\beta\)) | 朝漸近值 \(-g/\beta\) 趨近 | 負指數成長 |
註:潛在變化分數模型抵達的,是第 14 章那些非線性混合模型所描出的同一批曲線,只是它走的路是生成變化的規則,而不是變化所描出的函數。雙變化歷程的漸近值是 \(-g/\beta\)。
20.2 單變量變化分數模型的實作
把整座設定階梯(specification ladder)配適到一份已知為減速(decelerating)上升的資料上,選擇就變得具體。本章的示範資料是一個由雙變化規則生成的模擬歷程。只有常數變化的模型配適不良,因為它硬把一條直線穿過一條彎曲的軌跡;只有比例變化的模型配適得更差,少了固定的增量,它捕捉不住那段持續的上升;雙變化模型則配適良好,還原了生成參數,加法變化接近真值,比例係數也接近它為負的真值。圖 20.3 把三條隱含軌跡(implied trajectory)與觀察平均數放在一起,只有雙變化模型跟得上那段減速。比較的依據是訊息準則(information criteria),模型互相巢套(nested)時再加上卡方差異(chi-square difference),雙變化模型以很大的差距勝出。表 20.2 是參數的名詞表,表 20.3 則把參數的組合對應到它們所隱含的動態。有兩種估計上的病症會一再出現,該有的回應是冷靜處理而不是驚慌。資料接近線性時,比例係數可能漂到邊界(boundary)上;變化分數的變異數則可能落成略為負值,那又是第 13 章的邊界問題(boundary problem),做法是簡化模型,或如第 17 章所示改用貝氏估計(Bayesian estimation)。
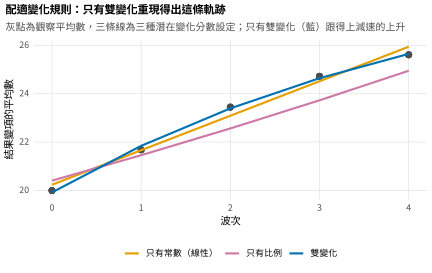
註:一個減速歷程的觀察平均數(灰),對照三種潛在變化分數設定的隱含軌跡。只有常數變化與只有比例變化的模型都抓不到那個形狀;雙變化模型把固定的增量與朝漸近值拉的比例項結合起來,跟得上它。訊息準則明確偏好雙變化模型。
表 20.2 潛在變化分數各參數的名詞表。
| 參數 | 解讀 |
|---|---|
| 常數變化的平均數 | 每個區間的平均加法增量,也就是變化的線性部分 |
| 常數變化的變異數 | 加法增量上的個別差異 |
| 比例係數 | 每一次變化中「當下水準的一個比例」的那一部分;它的正負決定趨近或加速 |
| 起始真分數的平均數與變異數 | 起始水準的平均與離散程度 |
| 起始值與變化的共變數 | 起點較高的人,變化是否有所不同 |
註:常數變化的兩個參數描述變化的線性部分,比例係數則描述取決於狀態的那一部分。比例係數承載了這個模型的動態內容,解讀時也最需要下文那份謹慎。
表 20.3 參數的組合與它們所隱含的動態。
| 組合 | 形狀 | 讀法 |
|---|---|---|
| 常數 \(> 0\),比例 \(= 0\) | 線性 | 穩定的變化,沒有自我回饋 |
| 常數 \(= 0\),比例 \(< 0\) | 衰減 | 朝零回歸(自我調節) |
| 常數 \(> 0\),比例 \(< 0\) | 趨近漸近值 | 朝一個非零的平衡點趨近 |
| 比例 \(> 0\) | 加速 | 自我放大的變化 |
註:比例係數的正負區分出兩種動態:自我調節的動態把歷程拉回平衡點,自我放大的動態則把它推離平衡點。這種動態式的讀法,正是變化分數模型獨有的貢獻。
比例係數帶著一項告誡,它在這裡首度登場,而後主宰整個連續時間的章節。這個係數是以觀測區間為單位(per observation interval)定義的:係數為 \(-0.2\) 的意思是,相鄰兩個被測量到的時點之間,與漸近值的差距縮小了五分之一。把這兩個時點的間隔拉成兩倍,係數就不一樣,因為區間拉長,縮小的幅度也跟著變大。圖 20.4 把同一個歷程分別以每一波與每隔一波重新配適,正是要展示這件事:比例係數由大約 \(-0.2\) 變成大約 \(-0.4\),變動相當可觀,不是因為歷程變了,而是因為區間變了。這種區間依賴(interval dependence)意味著,來自不同測量時程的研究,比例係數彼此不可比較。這也是支持第 27 章那套連續時間重新參數化最強的一項論據,因為在那裡,速率是歷程本身的性質,不是取樣方式的性質。
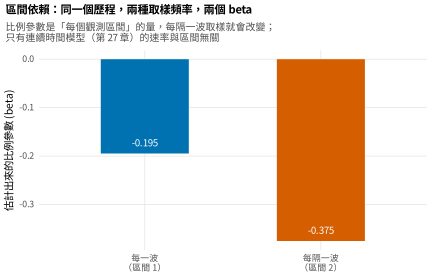
註:同一個歷程分別以每一個時點與每隔一個時點取樣時,估計出來的比例係數。係數的絕對值幾乎翻了一倍,不是因為動態變了,而是因為區間變了。離散的比例係數是每個區間的量,不能拿來跨測量時程比較,只有連續時間的速率可以。
20.3 雙變量變化分數模型與耦合
引起最多興趣、也惹出最多麻煩的那項擴充,是把兩套變化分數系統耦合起來,讓其中一個歷程的水準驅動另一個歷程的變化。圖 20.5 勾勒出這個架構:兩套雙變化系統並排,中間由耦合路徑(coupling paths)把每個歷程在某一個時點的真分數,帶進另一個歷程在下一個時點的變化。從第一個歷程通往第二個歷程之變化的那條耦合為正,意思是第一個歷程上分數較高,可以預測第二個歷程隨後的上升,這就是「第一個歷程領先第二個歷程」這項主張的結構性表達。本章的示範資料以一組不對稱的耦合生成,其中一個歷程驅動另一個,反向不成立;雙變量模型還原的正是這個結構,在生成的方向上有一條可觀的耦合,在另一個方向上則微不足道,正確辨識出領先延宕的結構。此時很容易把這樣的結果讀成因果問題已經解決,而這個念頭必須擋下來。
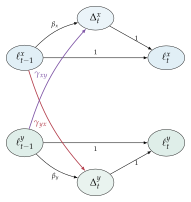
註:兩套雙變化系統,分別屬於歷程 \(x\)(上)與歷程 \(y\)(下),各自有自己的比例式自我回饋。耦合路徑把一個歷程在前一個時點的水準帶進另一個歷程的變化:\(\gamma_{yx}\)(紅)是 \(x\) 的水準對 \(y\) 之變化的效果,\(\gamma_{xy}\)(紫)則是反方向。兩條耦合之間的不對稱,就是一項領先延宕主張的結構性表達。
解讀一個耦合參數需要一套逐條列舉的紀律,因為耦合文獻一再過度宣稱。第一,耦合是以整個系統為條件的,加進或拿掉另一條路徑時,它的數值甚至正負都可能改變,所以「逐一拿掉一條路徑」的敏感度分析(sensitivity analysis)是必要的。第二,它有區間依賴,繼承了比例係數的問題。第三,模型若沒有把真分數與誤差分開,耦合就會把測量誤差吸收(absorb)進去,這是採用二階版本的一項論據。第四,一個耦合的意義取決於與它並排的自我回饋(self-feedback)係數:同一個水準效果,放在自我調節(self-regulating)的歷程旁邊,與放在自我放大(self-amplifying)的歷程旁邊,讀起來並不一樣。第五,某些雙變量變化分數模型在統計上等價於加了限制的交叉延宕追蹤模型(cross-lagged panel model),一項耦合結果因此可能有一個等價模型(equivalent model)的影子:另一套不同、卻配適得一樣好的設定,會用另一套說法描述同一批資料,這正是第 21 章要處理的統整工作。本書的標準是一整套敏感度檢驗(sensitivity battery):在一系列站得住腳的設定之下重新配適那個耦合,報告估計值有多穩定,而不是報告單一個點估計(point estimate)。圖 20.6 對本章的耦合跑了這套檢驗,估計值穩定得令人放心;表 20.4 是那份檢核表。通過檢驗的耦合,才配得上一個謹慎的領先延宕讀法;沒有通過的,就只是某個特定設定造出來的假象。
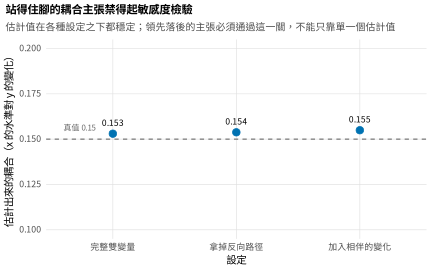
註:在幾種替代設定之下估計出來的耦合,對照它的真值。估計值是穩定的,一個謹慎的領先延宕讀法靠的就是這份穩定。耦合若在這些設定之間大幅移動,那是所選模型造出來的假象而不是一項發現,而只報告單一個點估計會把這個風險藏起來。
表 20.4 一項耦合主張的敏感度檢驗。
| 檢驗 | 防的是什麼 |
|---|---|
| 輪流拿掉其他每一條路徑 | 耦合是以整個系統為條件的 |
| 變動區間,或至少把區間交代清楚 | 估計值的區間依賴 |
| 配適一個二階(無誤差)的版本 | 測量誤差被吸收進耦合裡 |
| 與交叉延宕的設定相比 | 等價模型的影子 |
| 把上述每一種設定的估計值都報出來 | 單一個點估計把不穩定藏了起來 |
註:一項來自雙變量變化分數模型的領先延宕主張,只有在這整套檢驗之下都穩定才可信。本書的立場是:耦合文獻只報告單一設定的點估計,因而過度宣稱;補救之道是把證據門檻提高到已經示範出來的穩定性。
耦合系統是一組差分方程,這樣讀它就預告了第六部。那一對變化規則在兩個水準的每一種組合上,都定義出各自預期的一步變化量,把它們畫成箭頭就得到一個向量場(vector field),也就是一個動力系統(dynamical system)的流(flow)在離散時間中的影像。圖 20.7 為配適出來的耦合系統畫出這個場:箭頭顯示這個歷程不論從哪裡出發,都朝一個平衡點(equilibrium)流動;而流的形狀是螺旋、直接收斂還是發散,就是那些參數所編碼的定性動態(qualitative dynamics)。第六部的向量自我迴歸模型(vector autoregressive model)與連續時間模型要形式化的正是這幅圖,在此處把它畫出來,也就坐實了變化分數模型的橋樑地位。
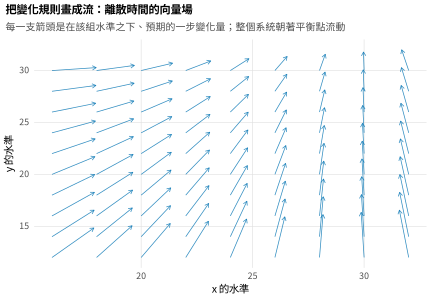
註:每一支箭頭都是配適出來的耦合模型在該組水準之下所預期的一步變化量。這個場顯示系統朝它的平衡點流動。把變化分數模型做這樣的動力系統式解讀,就是通往第六部那些向量自我迴歸模型與連續時間模型的橋樑。
20.4 二階成長模型
第 18 章確立測量恆等性(measurement invariance),就是為了讓那張支票在這裡兌現。二階成長模型(second-order growth model)不把成長結構放在觀察分數上,也不放在複合分數(composite score)上,而是放在由多個指標所測量的潛在構念上:一個帶恆等負荷量與恆等截距的一階測量模型(first-order measurement model)在每個時點定義出一個因素,二階的成長模型再把截距(intercept)與斜率(slope)配適到那些因素上。這樣的建構需要整條恆等性鏈條,其中截距恆等性(scalar invariance)是因素平均數可比較的必要條件,因此也是因素平均數的成長講得通的必要條件;表 20.5 說明每一級各自許可了什麼。回報有兩重:成長配適在一個無誤差的構念上,測量誤差不再把它衰減(attenuate);而且恆等性可以檢定,不是假定。圖 20.8 在第 18 章那份投入程度資料上呈現這份回報,該資料的第二個指標(indicator)有漂移(drift)。二階模型把成長配適在部分恆等的潛在構念上,還原了真實的斜率;複合分數則默默假定了嚴格恆等性(strict invariance),於是高估了它,這正是第 18 章那個後果模擬在多題項投入程度資料上的回聲。把成長配適到複合分數上,就是把它配適到一份意義可能已經位移的測量上;把成長配適到一個恆等的因素上,才是把它配適到那個構念上。二階模型有兩種多變量的形式,回答的是不同的問題:因素曲線模型(curve-of-factors model)把一個成長歷程配適到每一波都測量到的同一個因素上,曲線因素模型(factor-of-curves model)則把一個高階因素(higher-order factor)配適到好幾個各自獨立的成長歷程上。兩者之間怎麼選,取決於那些構念在實質上的結構。
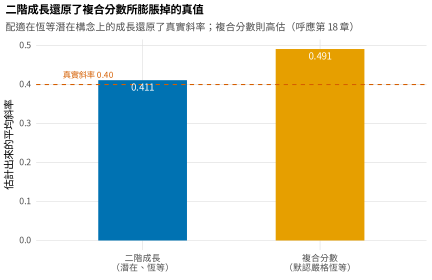
註:投入程度構念的平均斜率,分別由一個建在恆等潛在因素上的二階成長模型與一個建在複合分數上的成長模型估計出來,並與真實斜率對照。二階模型還原了真值;複合分數默默假定了那個會漂移的題目所違反的嚴格恆等性,因而高估了成長。第 18 章那道測量檢查,對改變速率的估計有實實在在的後果。
表 20.5 二階成長模型所要求的恆等性層級。
| 所需的恆等性層級 | 它在成長模型中許可了什麼 |
|---|---|
| 形貌(configural) | 每一波測量到的是同一個構念 |
| 量尺(負荷量)(metric) | 各波之間的因素變異數與共變數可以比較 |
| 截距(scalar) | 各波之間的因素平均數可以比較,平均數的成長才有意義 |
| 部分截距(partial scalar) | 有些題目漂移時,以一組站得住腳的定錨題目(anchor item)談平均數的成長 |
註:潛在平均數的成長至少需要部分截距恆等性,否則因素平均數的改變會把構念的變化與測量的漂移混在一起。二階成長模型把恆等性變成可以檢定的東西,不像複合分數那樣默默假定它。
20.5 結構化的非線性成長
在變化分數模型與二階模型之外,還有一族結構化潛在曲線(structured latent curve)模型。它們以「由某個函數形式推導出來的受限負荷量」強加一條特定的非線性目標函數,可以是指數(exponential)、羅吉斯(logistic)或樣條(spline) (Blozis, 2004)。這一族兼有具名函數形式的解讀精確度與潛在變項架構的彈性,位置就落在兩者之間:一邊是第 19 章那個不強加任何形狀的放開負荷量(freed-loading)潛在基底(latent basis),另一邊是第 14 章那個強加一個僵硬形狀的完全參數化非線性混合模型。本章把它們當地圖看,不當住所。理論指明了一條參數可解讀的特定曲線時,用結構化潛在曲線或非線性混合模型去配適它;形狀未知時,用潛在基底去估計它;個別不同的測量時點(individually varying times)、或結構方程架構處理起來不順手的多層次巢套一旦佔了主導,第 14 章與第 30 章的混合模型與加法模型(additive model)才是更好的歸宿。重點在於,這些架構構成一條關於「改變的形狀」的假設連續體,從什麼都不假設一路到完全指定一個函數,而分析者要挑的是理論與資料擔保得起的那個位置。
20.6 在 R 中執行變化分數模型
波次一多,手寫潛在變化分數的語法(syntax)就容易出錯,所以隨書的分析附了一個產生器,由變項名稱與波次數目生出 lavaan 語法,讀者可以重複使用,也可以自行擴充。
library(lavaan)
# lcs_syntax(v, W, dual, prop) 產生單變量模型(見 ch20_analysis_V01.R)
# dual = 雙變化;const = 只有常數
dual  <- sem(lcs_syntax("x", W = 5, dual = TRUE,  prop = TRUE),  data = d)
const <- sem(lcs_syntax("x", W = 5, dual = TRUE,  prop = FALSE), data = d)
anova(const, dual)                      # 比較兩種設定
雙變量的產生器把兩套單變量系統合起來,再加上耦合路徑;二階成長模型則把截距因素與斜率因素放到第 18 章那些恆等的波次因素上。
# 雙變量耦合:一個歷程的水準預測另一個歷程的變化
biv <- sem(lcs_bivariate(W = 5, coupling = "both"), data = d)
# 二階成長:成長因素建在潛在構念上(測量恆等)
# I =~ 1*f1 + 1*f2 + 1*f3 + 1*f4 ; S =~ 0*f1 + 1*f2 + 2*f3 + 3*f4
完整的分析都在隨書腳本 ch20_analysis_V01.R 裡,包括設定階梯、區間依賴的示範、帶敏感度檢驗的雙變量耦合、隱含的向量場,以及二階成長與複合分數的比較。本章各張圖形由中文版的 ch20_figures_zh_V01.R 繪製,所用的資料則由 gen_lcs_V01.R 產生。
軟體提示 • 變化分數模型在各套軟體中的做法
潛在變化分數模型可以在 lavaan 中配適,在 Mplus 中以 MODEL 語法把變化分數用固定路徑定義出來,也可以在 OpenMx 中配適。這類模型需要大量的等式限制(equality constraint),個別不同的區間又需要定義變項(definition variable),而 OpenMx 在這兩件事上的彈性最大。這些模型例行產生的「潛在共變數矩陣非正定(non-positive-definite)」警告通常是良性的,來源是變化分數本身就是真分數的確定性函數,不是設定錯誤的徵兆,該做的是檢查它而不是怕它。至於間隔不等的正式動態模型,第 27 章那些連續時間工具,尤其是 ctsem 套件,以估計一個與區間無關的速率取代了離散的變化分數模型,兩種參數化之間的關係是精確的 (Voelkle & Oud, 2015)。
20.7 常見的誤解
關於變化分數模型,有幾種信念會把人帶偏。第一種是變化分數模型不過是多繞幾道手續的成長模型。它提出的是一項不同的科學主張,講的是生成變化的規則而不是軌跡的形狀,而且用「規則配得上、形狀配不上」的資料就能把兩者分開。第二種是負的比例係數是迴歸趨中(regression to the mean)造成的假象。它可以是測量誤差造成的假象,二階版本正好把那個誤差移除;但它同樣可以是貨真價實的自我調節,兩者要靠模型化分辨,不能靠假定。第三種是雙變量變化分數模型解決了因果方向。敏感度檢驗之所以存在,正是因為它沒有解決,而一個耦合只有在各種設定之下都穩定才可信。第四種是二階模型是心理計量純粹主義者的玩意。關於偏誤(bias)與檢定力(power)的證據顯示,凡是要估計一個潛在構念之變化的人都該在意它。第五種是比例係數可以跨研究比較。它有區間依賴,所以不能,除非先做連續時間的重新參數化。
常見陷阱 • 變化分數實作上的四個錯誤
第一,手寫語法:波次一多,那套固定路徑的鷹架就容易在謄寫(transcription)時出錯,請改用產生器。第二,把耦合讀成 Granger 式的因果:一條由水準到變化的路徑不等於一個已經確定的因果方向,敏感度檢驗是必做的。第三,跨測量時程比較比例係數:它們是每個區間的量,彼此不可比較,請移到連續時間。第四,沒有截距恆等性就配適二階成長:潛在平均數的成長至少需要部分截距恆等性,否則就會把構念的變化與測量的漂移混在一起。
本章摘要
潛在變化分數模型把相鄰真分數之間的變化當成一個被模型化的潛在變項,建在一套固定為一的路徑鷹架上;那些固定路徑強制執行「變化就是差」這條恆等關係,自由參數則都在變化上,也就是一個固定的增量與一個比例係數(圖 20.1)。這條變化規則生出一整族的軌跡形狀,線性、衰減、趨近漸近值與加速,正是第 14 章那些非線性混合模型直接描出的同一批曲線(圖 20.2、表 20.1);把整座設定階梯配適一遍,就還原得出生成規則(圖 20.3、表 20.2 與表 20.3)。比例係數以觀測區間為單位,不能跨測量時程比較,這是支持連續時間最強的一項論據(圖 20.4)。把兩套系統耦合起來,就以「由水準到變化」的路徑表達了領先延宕的結構(圖 20.5);但一項耦合主張需要一整套敏感度檢驗,因為這個參數是有條件的、有區間依賴的、會吸收誤差的,而且被等價模型的影子籠罩著(圖 20.6、表 20.4)。把耦合系統讀成差分方程,它就是一個離散時間的向量場,也就是通往第六部的橋樑(圖 20.7)。二階成長模型把成長配適到一個無誤差的潛在構念上,兌現了第 18 章那道恆等性檢查,還原了複合分數所膨脹掉的真值(圖 20.8、表 20.5);結構化潛在曲線模型則補完了那條關於「改變的形狀」的假設連續體。
接下來要去哪裡
本章把描述變化轉了個彎,走向模型化變化的動態,而這個彎道通往本書其餘的部分。第 21 章證明潛在變化分數模型、交叉延宕追蹤模型與帶隨機截距(random intercept)的追蹤模型同屬一個統整(unified)家族,解決了耦合那一節提出的等價模型影子問題;對在此處初次遇到耦合的讀者,那是最自然的下一步。第 27 章解決區間依賴,估計一個屬於歷程本身、不屬於取樣時程的連續時間速率,把本章那套差分方程的讀法落到實處。耦合系統的向量場圖,是第 24 章與第 25 章那些向量自我迴歸模型與動態結構方程模型(dynamic structural equation model, DSEM)的離散預告,那些模型在密集測量之中模型化的是個體之內的同一種流。二階成長模型完成了第 18 章開始的那條測量優先的鏈條;第 34 章的發展連鎖(developmental cascade)應用,則把雙變量耦合這套做法投到「一個發展領域如何把另一個領域拉著走」這種實質問題上。
習題
- 20.1 推導那條軌跡。給定常數變化參數與比例參數,就一個四波次的雙變化模型把遞迴關係式展開,算出隱含的平均數,再拿一個
lavaan配適結果來驗證。 - 20.2 把整座階梯配一遍。在所提供的資料上配適只有常數、只有比例與雙變化三種模型,互相比較,並就變化規則寫出一段站得住腳的結論。
- 20.3 區間依賴實作。模擬一個雙變化歷程,分別在每一個時點與每隔一個時點上重新配適,示範比例係數會改變而軌跡不會。
- 20.4 耦合的敏感度。在雙變量資料上估計那個耦合,跑完整套敏感度檢驗,再寫出這套檢驗支持得起的、帶保留條件的領先延宕結論。
- 20.5 二階成長。由一個恆等的測量模型建出二階成長模型,把它的斜率推論拿去與建在複合分數上的成長模型相比,並解讀兩者的差異。
- 20.6 使用產生器。讀懂隨書的語法產生器,用它配適一個五波次的模型,並為它加上一個新的選項。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 潛在真分數 | latent true score | 觀察分數背後、已去掉測量誤差的分數;第 20.1 節 |
| 潛在變化分數 | latent change score | 相鄰兩個真分數之差,被當成一個被模型化的變項;第 20.1 節 |
| 常數變化 | constant change | 每一步貢獻相同增量的因素;第 20.1 節 |
| 比例變化 | proportional change | 每一次變化中「當下水準的一個比例」的那一部分;第 20.1 節 |
| 雙變化 | dual change | 常數項與比例項並存,軌跡朝 \(-g/\beta\) 趨近;第 20.1 節 |
| 以觀測區間為單位 | per observation interval | 比例係數的定義單位,因此隨取樣時程而變;第 20.2 節 |
| 區間依賴 | interval dependence | 同一歷程在不同取樣區間下得到不同的比例係數;第 20.2 節 |
| 耦合路徑 | coupling paths | 把一個歷程的水準帶進另一個歷程之變化的路徑;第 20.3 節 |
| 敏感度檢驗 | sensitivity battery | 在多種站得住腳的設定下重估耦合,報告其穩定程度;第 20.3 節 |
| 向量場 | vector field | 每一組水準上的預期一步變化量所構成的流;第 20.3 節 |
| 二階成長模型 | second-order growth model | 把成長配適到多指標所測量的潛在構念上;第 20.4 節 |
| 因素曲線模型 | curve-of-factors model | 一個成長歷程配適到每波都測到的一個因素上;第 20.4 節 |
| 曲線因素模型 | factor-of-curves model | 一個高階因素配適到數個各自獨立的成長歷程上;第 20.4 節 |
| 結構化潛在曲線 | structured latent curve | 以受限負荷量強加一個具名非線性函數的模型;第 20.5 節 |
參考文獻
Blozis, S. A. (2004). Structured latent curve models for the study of change in multivariate repeated measures. Psychological Methods, 9(3), 334–353. https://doi.org/10.1037/1082-989X.9.3.334
Ferrer, E., Balluerka, N., & Widaman, K. F. (2008). Factorial invariance and the specification of second-order latent growth models. Methodology, 4(1), 22–36. https://doi.org/10.1027/1614-2241.4.1.22
Ferrer, E., & McArdle, J. J. (2003). Alternative structural models for multivariate longitudinal data analysis. Structural Equation Modeling, 10(4), 493–524. https://doi.org/10.1207/S15328007SEM1004_1
Ferrer, E., & McArdle, J. J. (2010). Longitudinal modeling of developmental changes in psychological research. Current Directions in Psychological Science, 19(3), 149–154. https://doi.org/10.1177/0963721410370300
Grimm, K. J., An, Y., McArdle, J. J., Zonderman, A. B., & Resnick, S. M. (2012). Recent changes leading to subsequent changes: Extensions of multivariate latent difference score models. Structural Equation Modeling, 19(2), 268–292. https://doi.org/10.1080/10705511.2012.659627
Grimm, K. J., Ram, N., & Estabrook, R. (2017). Growth modeling: Structural equation and multilevel modeling approaches. Guilford Press.
Hamagami, F., & McArdle, J. J. (2007). Dynamic extensions of latent difference score models. In S. M. Boker & M. J. Wenger (Eds.), Data analytic techniques for dynamical systems (pp. 47–85). Lawrence Erlbaum Associates.
Hancock, G. R., Kuo, W.-L., & Lawrence, F. R. (2001). An illustration of second-order latent growth models. Structural Equation Modeling, 8(3), 470–489. https://doi.org/10.1207/S15328007SEM0803_7
Kievit, R. A., Brandmaier, A. M., Ziegler, G., van Harmelen, A.-L., de Mooij, S. M. M., Moutoussis, M., Goodyer, I. M., Bullmore, E., Jones, P. B., Fonagy, P., Lindenberger, U., & Dolan, R. J. (2018). Developmental cognitive neuroscience using latent change score models: A tutorial and applications. Developmental Cognitive Neuroscience, 33, 99–117. https://doi.org/10.1016/j.dcn.2017.11.007
McArdle, J. J. (2009). Latent variable modeling of differences and changes with longitudinal data. Annual Review of Psychology, 60(1), 577–605. https://doi.org/10.1146/annurev.psych.60.110707.163612
McArdle, J. J., & Hamagami, F. (2001). Latent difference score structural models for linear dynamic analyses with incomplete longitudinal data. In L. M. Collins & A. G. Sayer (Eds.), New methods for the analysis of change (pp. 139–175). American Psychological Association. https://doi.org/10.1037/10409-005
McArdle, J. J., & Nesselroade, J. R. (2014). Longitudinal data analysis using structural equation models. American Psychological Association. https://doi.org/10.1037/14440-000
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
Usami, S., Murayama, K., & Hamaker, E. L. (2019). A unified framework of longitudinal models to examine reciprocal relations. Psychological Methods, 24(5), 637–657. https://doi.org/10.1037/met0000210
Voelkle, M. C., & Oud, J. H. L. (2015). Relating latent change score and continuous time models. Structural Equation Modeling, 22(3), 366–381. https://doi.org/10.1080/10705511.2014.935918
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。