第 17 章
縱貫模型的貝氏估計
前面幾章一再走到同一扇門前。第 13 章的混合模型(mixed model)碰上邊界估計值(boundary estimate)與奇異配適(singular fit),那裡有一個變異數塌成了零。第 15 章的廣義線性混合模型得把隨機效果從一個沒有封閉解的概似裡積分掉。第 16 章的位置尺度模型把一個隨機效果放進變異數裡,還讓它與平均數相關,最大概似(maximum likelihood)在那裡已經很吃力。這些困難有一個共同的解法,本章就把它交出來。貝氏估計(Bayesian estimation)把參數當成帶著機率分配的不確定量,把先驗(prior)與概似(likelihood)結合成後驗(posterior),再以模擬去探索那個後驗,而不是去最大化一個函數。本章不談貝氏哲學,也不在老爭論裡選邊站,而是把貝氏方法當成三件實務上的事:一套把最大概似救不回來的模型救回來的估計法、一條樣本小時仍然站得住腳的推論路徑,以及一種把不確定性傳遞到衍生量(derived quantity)與預測(prediction)上的自然語言。讀完本章,你應該是雙語的:在貝氏幫得上忙的地方用它,也能按各自的優點為任何一具引擎辯護。
學習目標
讀完本章之後,你應該能夠:(1) 說明後驗如何由先驗與概似形成,並解讀後驗、可信區間(credible interval)與後驗預測分配(posterior predictive distribution);(2) 為縱貫模型的參數選擇先驗,尤其是變異數成分(variance component)與相關的先驗,並以先驗預測模擬(prior predictive simulation)檢查它們;(3) 執行馬可夫鏈蒙地卡羅(Markov chain Monte Carlo, MCMC),以分裂 \(\hat{R}\)、有效樣本數(effective sample size)與發散(divergence)診斷它,並認出漏斗(funnel)病態與它的非中心化解法;(4) 以後驗預測檢查批判一個模型,並以交叉驗證(cross-validation)比較模型;(5) 在貝氏估計之下重配本書前面的模型,並說出答案什麼時候應該、什麼時候不應該與最大概似不同;(6) 善用貝氏獨有的三項好處:不受邊界所困的變異數估計、樣本小時仍然誠實的推論,以及衍生量上完整的不確定性。
17.1 推論架構,最精簡的版本
貝氏推論建立在一條恆等式上。給定資料之後,參數的後驗分配正比於給定參數之後資料的概似,乘上參數的先驗分配,\(p(\bm{\theta}\mid \mathbf{y}) \propto p(\mathbf{y}\mid \bm{\theta})\,p(\bm{\theta})\)。概似就是最大概似要最大化的那個東西;先驗編碼的是看到資料之前對參數已經知道的事;後驗則是看過資料之後更新的知識狀態。圖 17.1 為單一個參數畫出這三樣東西,這個參數是 sleepstudy 反應時間資料的平均斜率。弱訊息先驗(weakly informative prior)相對於合理範圍而言很寬,貢獻很少;概似承載資料裡的訊息;後驗幾乎疊在概似上,只被朝先驗輕輕推了一點。資料有訊息而先驗又弱時,情形都是這樣:後驗由資料主導,先驗主要拿來正則化(regularize),不是拿來導向。資料稀疏或參數弱識別(weakly identified)時,先驗做的事就多了,先驗的選擇因此要自成一節。
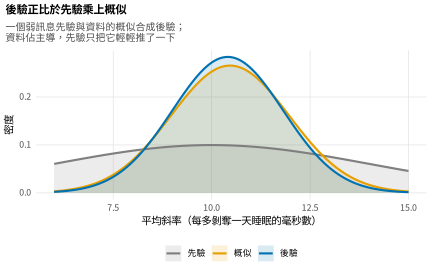
註:sleepstudy 資料平均斜率的弱訊息先驗(灰)、資料的概似(橘),以及由此得到的後驗(藍)。後驗是以精確度加權(precision-weighted)的折衷,這裡幾乎與概似重合,因為資料有訊息而先驗很弱。資料稀疏時先驗貢獻較多,先驗要慎選也要檢查,道理就在這裡。
這套做法的產物是每一個參數的完整分配,推論就直接從那個分配上讀出想要的量。可信區間是一個以指定的後驗機率包含參數的區間,它的意思正好就是新手誤以為信賴區間(confidence interval)在說的那件事:給定資料、模型與先驗,參數落在百分之九十五可信區間內的機率就是百分之九十五。信賴區間下的是另一個比較細緻的頻率論(frequentist)陳述,講的是程序的長期涵蓋率(coverage),不是講手上這一個區間。先驗弱而資料充足時,兩者數值相近;先驗有訊息或樣本小時就會分歧。差別在於什麼被當成隨機的:貝氏當成隨機的是參數,頻率論者當成隨機的是區間。本書用貝氏方法的取向是估計與預測,為參數報告後驗與可信區間、為新觀察報告預測分配;至於用來做假設檢定的貝氏因子(Bayes factor),留到本章後面簡短處理,並附上告誡。
縱貫模型為什麼一再走到貝氏估計,值得畫成一張地圖。第 13 章碰上落在參數空間邊界上的變異數參數,最大概似在那裡給出的是一個退化(degenerate)的點,不確定性無從定義。第 15 章碰上對隨機效果的難解積分。第 16 章碰上一個坐在變異數裡面的隨機效果。接下來幾部把這些困難疊在一起:第六部的潛在變項動態、連續時間(continuous-time)與狀態空間(state-space)模型,以及動態結構方程模型(dynamic structural equation model),實務上都以馬可夫鏈蒙地卡羅估計,因為它們那種弱識別、高維度的後驗,沒有別的方法處理得漂亮。本章擺在這個位置,就是要當全書的估計引擎:建造一次,反覆使用。
17.2 縱貫模型參數的先驗
先驗是一項建模抉擇,而任何建模抉擇都必須是刻意的,也都要接受檢查。就固定效果來說,標準建議是在標準化尺度(standardized scale)上給一個弱訊息的常態分配:寬到不對效果的正負號(sign)與大致量級(magnitude)提供訊息,又窄到能排除荒謬(absurd)的值。這樣既穩住(stabilize)估計,資料足夠時又不會實質影響後驗。縱貫模型裡真正有意思的先驗放在變異數成分與相關上,而近年的實務在這裡已經果斷離開了舊的預設值(default)。
變異數的歷史預設值是逆伽瑪(inverse-gamma)分配,選它是為了共軛性(conjugacy);但它偏偏在縱貫模型所在的那一帶、也就是零附近表現很差,因為一個真的很小的變異數會被逆伽瑪先驗推離零,推的方式又很難做到無訊息 (Gelman, 2006)。現代的建議把先驗放在標準差上,不放在變異數上,並改用半常態(half-normal)或半 \(t\) 分配(half-\(t\));這些密度在零處最大,然後平滑衰減(decay),於是很小或為零的變異數是被允許的,不是被禁止的。這就是第 13 章的邊界故事以先驗的形式重講一遍:最大概似把小變異數壓成恰好為零的地方,半常態先驗讓後驗集中在零附近,同時保住它的不確定性。一個先驗弱不弱訊息,不看口號,看的是一項可以查核的隱含結果,而查核的方式就是先驗預測模擬:從先驗抽參數,再檢視它們隱含的資料或衍生量。圖 17.2 就三個變異數先驗所隱含的組內相關(intraclass correlation, ICC)做了這項檢查。一個尺度很大的半常態本意是無訊息,實際上卻把先驗質量堆在零與一附近,這等於相信變異數不是幾乎全落在群集內,就是幾乎全落在群集間。
把半常態收窄完全沒有幫助:兩個獨立的半常態不論共用什麼尺度,隱含的組內相關都是 \(\mathrm{Beta}(1/2, 1/2)\),尺度會約掉,要換的是分配族,不是寬度;半 Cauchy 更糟,在兩個極端上壓了更重的質量。補救之道只有兩條:換一個分配族,或者直接把先驗放在組內相關上。教訓是,放在變異數上的先驗,就是放在這個變異數所隱含的一切之上的先驗,而只有先驗預測模擬能揭露(reveal)實際上假設了什麼。
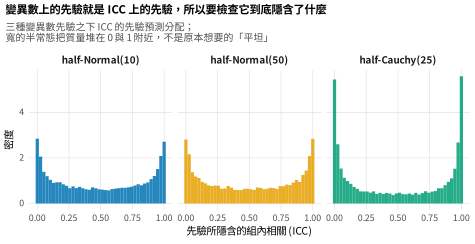
註:三個放在隨機效果標準差與殘差標準差上的先驗,各自隱含的組內相關之先驗預測分配。一個很寬的半常態本意是無訊息,卻隱含了「組內相關接近零或一」這個先驗信念;把半常態收窄改不了這個形狀,因為尺度會約掉,要換成 Gamma 這一類在零處密度為零的分配族,質量才被拉回中間;半 Cauchy 則更偏好極端值。使一個變異數先驗成為弱訊息的,是它隱含的分配族,不是它名目上的寬度。
隨機效果之間的相關,也就是第 13 章 T 矩陣的非對角線(off-diagonal),有自己的先驗。標準選擇是放在相關矩陣上的 LKJ 先驗 (Lewandowski et al., 2009),由單一個形狀參數(shape parameter) \(\eta\) 掌管;圖 17.3 顯示它在單一個相關上的行為。\(\eta=1\) 時先驗在合法範圍上是平坦的;\(\eta\) 大於一時先驗朝零集中,把相關往獨立的方向正則化;\(\eta\) 小於一時偏好極端值。\(\eta=2\) 這種溫和的值是合理的預設,表達的是「隨機效果並非完全相關」這個弱信念(weak belief),同時讓資料說話。先驗敏感度(prior sensitivity)因此是工作流程的例行動作,不是事後才補的:模型在兩三組站得住腳的先驗之下各配適一次,後驗結論全都撐得過,才報告為穩健(robust)。從先前研究取得的有訊息先驗,在早先的證據可靠時既正當又有價值,但有一個標準的告誡要記得:被發表偏誤(publication bias)扭曲過的文獻,提供的先驗會過度自信,也離零太遠。表 17.1 收齊了預設建議。
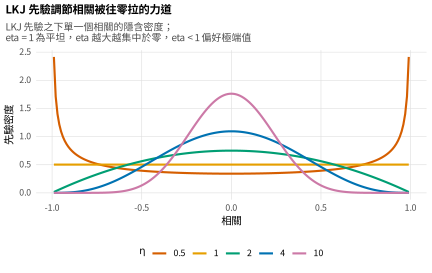
註:在幾個形狀參數 \(\eta\) 之下,單一個隨機效果相關在 LKJ 先驗下的先驗密度。\(\eta=1\) 時先驗是平坦的;\(\eta\) 越大,相關就越集中在零附近,往獨立的方向正則化;\(\eta\) 低於一時偏好強相關。\(\eta=2\) 附近是常見的弱訊息預設值。
表 17.1 依參數類別給的預設弱訊息先驗。
| 參數 | 建議的先驗 | 先驗預測檢查 |
|---|---|---|
| 固定效果 | 標準化尺度上的常態 | 隱含的效果量級 |
| 隨機效果 SD | 標準差上的半常態或半 \(t\) | 隱含的組內相關 |
| 殘差 SD | 標準差上的半常態或半 \(t\) | 隱含的結果變項分散程度 |
| 相關矩陣 | LKJ,\(\eta \approx 2\) | 隱含的相關密度 |
註:先驗放在標準差上,不放在變異數上,以避開逆伽瑪的邊界病態。每一個先驗都要用「從它模擬、再檢視隱含的資料或衍生量」的方式檢查,不能只相信它名目上的寬度。
17.3 實務上的馬可夫鏈蒙地卡羅
後驗只知道到一個常數為止,一般也無法解析地摘要,所以要用模擬去探索。馬可夫鏈蒙地卡羅建構一條參數抽樣的鏈,它的平穩分配(stationary distribution)就是後驗;經過一段起始的暖身(warmup)之後,那些抽樣就是後驗的樣本,任何感興趣的量都以對它們取平均來估計。現在的預設演算法是 Hamiltonian 蒙地卡羅(Hamiltonian Monte Carlo),以及它會自我調校的變體「不掉頭取樣器」(no-U-turn sampler):它用對數後驗的梯度(gradient)提出遠距離、有訊息的移動(move),探索相關的高維度後驗,效率遠高於早期實務中的隨機漫步(random walk)與 Gibbs 取樣器 (Betancourt, 2017)。實務上的預設是跑好幾條鏈(chain),各自從不同的起點(starting point)出發,丟掉暖身期,再跑足夠多的暖身後疊代(iteration),把感興趣的量估到可接受的精確度;下面的診斷有要求時,就把次數拉高。
基礎概念 • 梯度為什麼有用,以及交叉驗證怎麼近似
Hamiltonian 蒙地卡羅為參數擴充一組輔助的動量(momentum)變項,模擬一個粒子沿著對數後驗曲面滑動的物理過程。單一次提議(proposal)因此會沿著分配的等高線(contour)走一段長長的軌跡(trajectory),而不是盲目地走一小步(local step)。軌跡尊重幾何,取樣器就能快速穿過會困住隨機漫步的相關後驗;代價是它需要對數後驗的梯度,而機率程式語言(probabilistic programming language)會自動算出來。同一批後驗抽樣也撐得起留一交叉驗證(leave-one-out cross-validation)的模型比較,那個做法問的是:把某一筆觀察拿掉(held out)之後,模型對它預測得多好。為每一筆觀察各重配一次模型太貴,所以那個被留出的預測密度是由單一次完整配適以重要性抽樣(importance sampling)近似出來的:把後驗抽樣重新加權,讓它們代表留一之後的後驗,再附上一項診斷,也就是 Pareto 形狀參數,標示出近似不可靠的觀察,而那些通常正是有影響力的觀察 (Vehtari et al., 2017)。
一條配適好的鏈要先診斷過才能信任,而四項診斷做掉大部分的工作。潛在尺度縮減因子(potential scale reduction factor) \(\hat{R}\) 比較鏈內的變異數與鏈間的變異數;各鏈都收斂到同一個分配時兩者一致,\(\hat{R}\) 接近一,大約高於 \(1.01\) 就是各鏈尚未混合(mix)的訊號 (Vehtari et al., 2021)。圖 17.4 給出它的視覺對應物:健康的鏈互相重疊,像白雜訊(white noise)一樣圍著一個共同的水準交錯;病態的鏈從不同起點出發,跑了同樣的量之後仍未相遇,它們的分離就是一個大 \(\hat{R}\) 背後的幾何,這裡是 \(6.63\) 對上健康的 \(1.08\)。有效樣本數衡量一條自我相關的鏈相當於多少個獨立抽樣,在分配中央算「主體」的,在兩端算「尾部」的;有效樣本數小,就表示後驗摘要本身也帶著雜訊。發散轉移(divergent transition)是 Hamiltonian 模擬失敗,標示出取樣器穿不過去的區域。四項之中它最專屬(specific)於縱貫模型,因為它源自階層模型造出來的漏斗幾何。表 17.2 列出每一項診斷、它的門檻、它偵測的病態,以及它的解法。
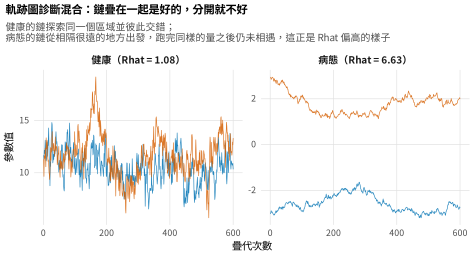
註:左:一個識別良好的參數的健康鏈,互相重疊、圍著一個共同水準交錯,\(\hat{R}\) 接近一。右:從不同起點出發、跑了同樣的量之後仍未收斂到共同分配的病態鏈,這是一個大 \(\hat{R}\) 的視覺特徵。軌跡圖是最先也最快的收斂診斷。
表 17.2 馬可夫鏈蒙地卡羅的四項診斷。
| 診斷 | 門檻 | 病態 | 解法 |
|---|---|---|---|
| \(\hat{R}\) | 低於約 \(1.01\) | 各鏈未混合 | 增加疊代;換更好的參數化 |
| 有效樣本數 | 主體與尾部都要數百 | 摘要帶雜訊 | 增加疊代;重新參數化 |
| 發散轉移 | 一個都不能有 | 到不了的幾何(漏斗) | 非中心化參數化;提高適應目標 |
| 最大樹深度 | 未達上限 | 軌跡沒效率 | 重新參數化;提高上限 |
註:四項診斷要一起看,因為每一項偵測的失敗方式不同。對階層式的縱貫模型而言,發散是後果最嚴重的一項,絕不可以忽略:它標示的是偏誤,不只是沒效率。
漏斗值得配一張自己的圖,因為它是階層模型的招牌病態,也是一個設定良好的模型仍然可能配適失敗的原因。組層次的標準差本身也是一個參數時,這個標準差的對數與它所掌管的那些組效果,聯合後驗會呈漏斗形狀:標準差小的地方,組效果被擠進一段狹窄的頸部;標準差大的地方,組效果散開成一個寬闊的口。圖 17.5 把它畫了出來。頸部裡組效果的條件分散程度整個塌下去,這個例子由口部的約 \(4.5\) 掉到頸部的約 \(0.2\),尺度變化(change in scale)超過二十倍,沒有任何單一個步長(step size)應付得了,於是一個調校(tune)到口部的梯度取樣器會衝過頭(overshoot)而發散。解法不是某個調校旋鈕,而是一次變數變換。非中心化參數化(non-centered parameterization)把每一個組效果改寫成組標準差乘上一個標準常態的輔助變項,兩者就此解耦(uncouple),漏斗也變成圖右側那團無害的雲(blob)。模型沒有變,變的只是它的座標(coordinates);現代軟體預設就會做這項重新參數化,發散仍然出現時也會報出來。這一類重新參數化的直覺,也就是認出問題出在模型的幾何而不是它的設定,是以馬可夫鏈蒙地卡羅配適階層模型時最有用的單一技能。
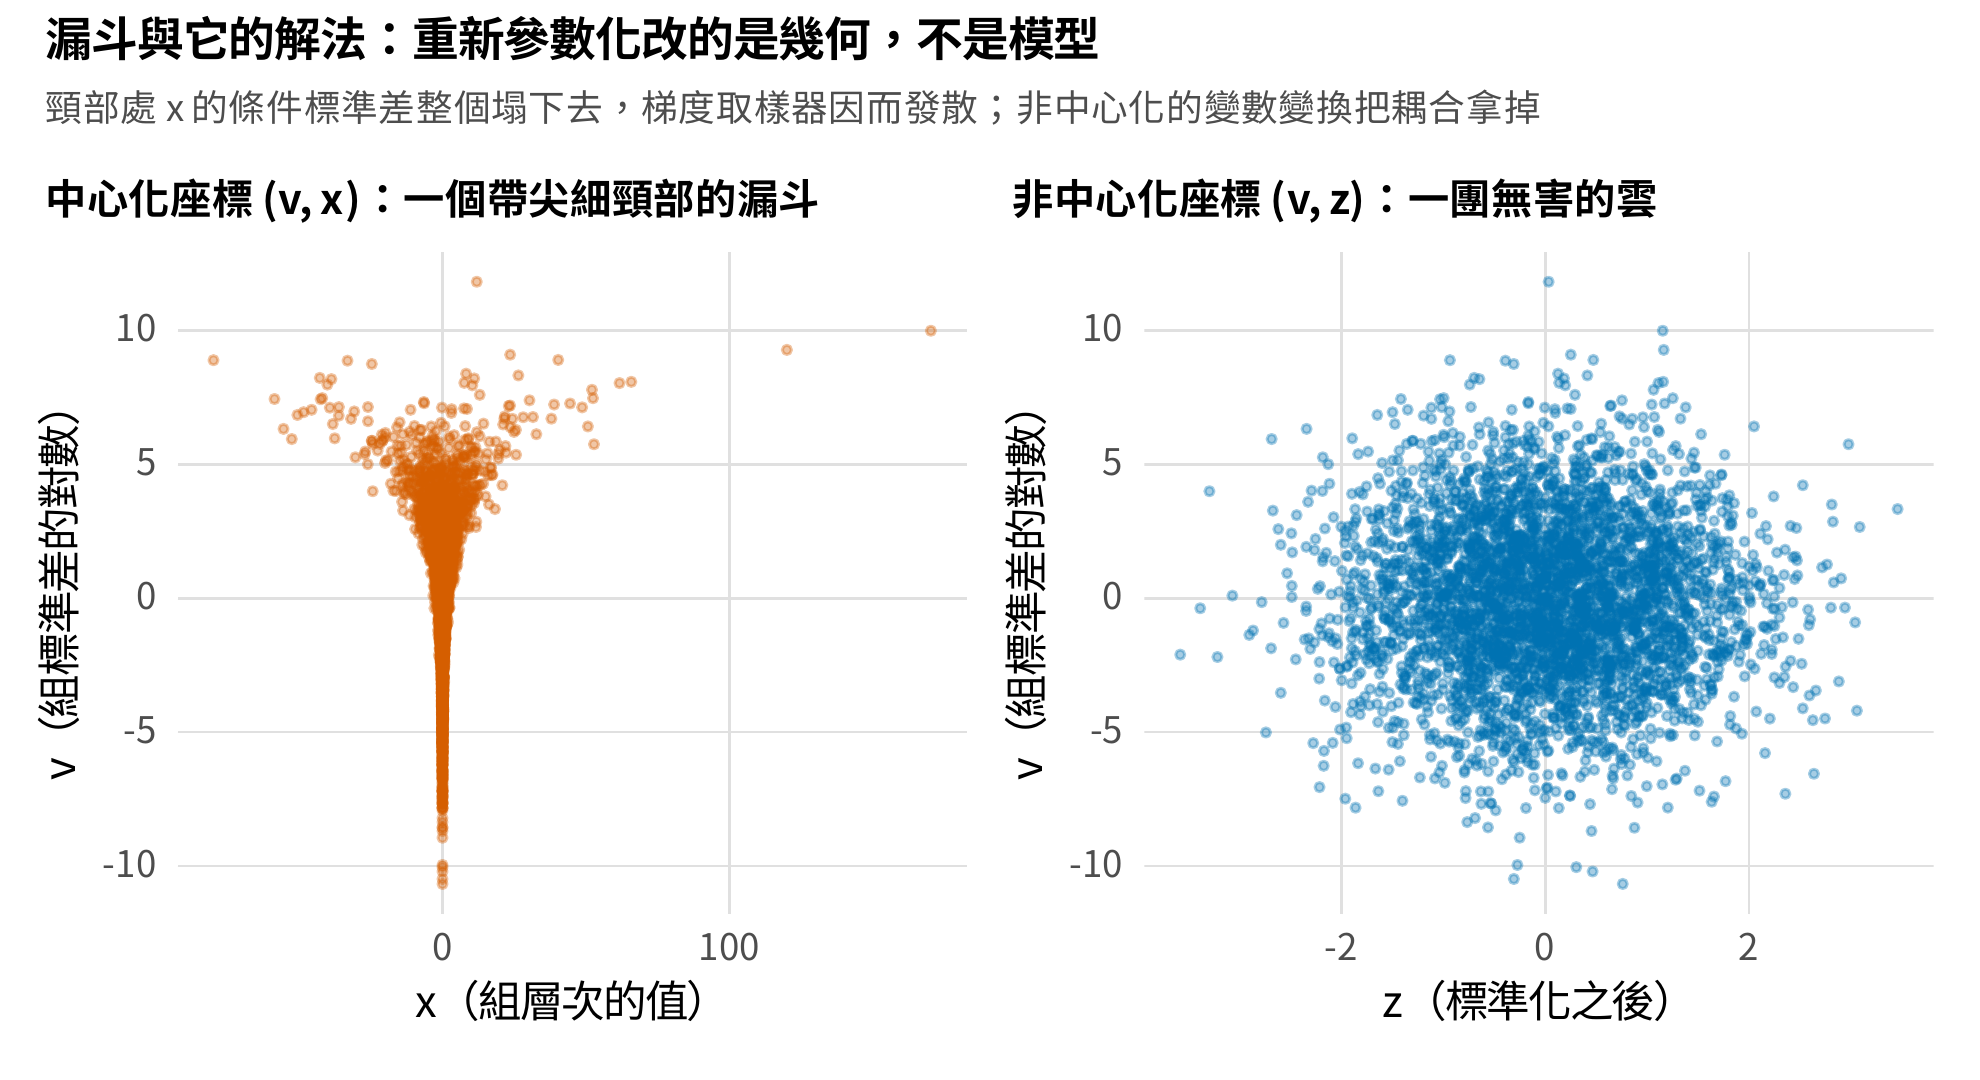
註:左:在「組標準差的對數」與「組效果」這組中心化座標中,後驗是一個漏斗,取樣器穿不過它的頸部,因為組效果的條件分散程度在那裡塌掉了。右:非中心化座標,其中組效果被寫成標準差乘上一個標準常態變項,兩軸因而解耦成一團無害的雲。兩者描述的是同一個模型。
17.4 模型批判與比較
貝氏模型以後驗預測檢查來批判:從配適好的模型模擬資料,再把模擬資料的某些特徵與觀察資料的同一些特徵對照。模型夠好,觀察資料看起來就像是從它抽出來的一個合理樣本;某個特徵系統性地偏掉,那個落差就把設定錯誤(misspecification)定位(localize)出來。技藝在於挑選要檢查的特徵,該挑的是「模型為了它預期的用途必須算對」的那些量:隨時間變化的平均軌跡、個體軌跡的分散程度,或者第 16 章明確建模的那個變異數結構。圖 17.6 檢查 sleepstudy 模型的平均軌跡:觀察到的每日平均數都落在後驗預測帶內,模型重現了平均結構。瞄準變異數或瞄準個人層次軌跡的檢查,盤問的是模型的其他承諾(commitment);一份周全的報告會集合一小組這樣的檢查,不會只靠其中一個。
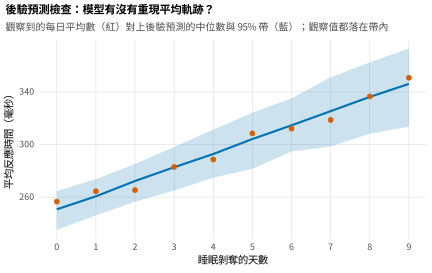
註:觀察到的每日平均反應時間(紅),對上由配適好的模型算出的後驗預測中位數與百分之九十五帶(藍)。觀察值落在帶內,是模型重現了平均軌跡的證據。後驗預測檢查要挑哪些特徵來看,取決於模型為了它的目的必須算對什麼。
模型之間的比較,看的是它們對新資料的期望預測準確度,估計方式是留一交叉驗證,或與它關係很近的廣泛適用訊息準則(widely applicable information criterion, WAIC),兩者都由後驗抽樣算出。這些工具估計的是樣本外(out-of-sample)的預測表現,不是真理:它們偏好的模型,是期望能把一筆新觀察預測得最好的那一個,未必是描述機制的那一個。預測與解釋分歧的地方,這個區分都要緊,第 31 章會展開。它們的診斷是每一筆觀察的 Pareto 形狀參數,標示出近似不可靠的點,而那些點通常正是有影響力(influential)、實質上也有意思的點,例如某位受試者的軌跡讓模型難以容納。表 17.3 把這些比較工具並排放好。貝氏因子比較兩個模型的邊際概似(marginal likelihood),回答的是另一個問題:一個模型相對於另一個的證據強度。但貝氏因子對參數先驗敏感得出名,連那些對估計無害的先驗都會左右它,而且需要專門的計算。它有它的用處,本書比較模型的預設仍然是預測導向的,走交叉驗證,再補上任何自動準則都取代不了的實質判斷。
表 17.3 比較貝氏模型的工具。
| 工具 | 回答的問題 | 告誡 |
|---|---|---|
| 留一交叉驗證 | 樣本外的預測準確度 | Pareto-\(k\) 標示有影響力的點 |
| 廣泛適用訊息準則 | 樣本外的預測準確度 | 沒有留一交叉驗證穩健 |
| 貝氏因子 | 一個模型相對於另一個的證據 | 對參數先驗高度敏感 |
| 後驗預測檢查 | 模型有沒有重現關鍵特徵 | 是一項檢查,不是一個分數 |
註:交叉驗證與訊息準則估計的是預測,不是真理,它們偏好的模型未必就是有解釋力的那一個。貝氏因子回答的是一個證據性的問題,但強烈依賴先驗。預測導向的比較加上後驗預測檢查,是本書的預設。
17.5 三項好處的示範
三項示範顯示貝氏估計買到了什麼,每一項也都以一句誠實的話收尾,說明哪裡仍然是最大概似比較好。第一項是邊界搶救。
在一份只有八個人的小資料集上,一個隨機斜率模型以受限最大概似配適會回傳奇異配適:截距與斜率的相關被推到 \(+1\),斜率標準差停在 \(0.11\),兩者都不附任何不確定性,這就是第 13 章那個秩不足的 T 矩陣。同一個模型改用貝氏配適,在斜率標準差上放一個半常態先驗,回傳的後驗集中(concentrate)在零附近卻不貼著零,還帶著一個很寬的可信區間,這個例子大約由 \(0.03\) 到 \(2.42\)。圖 17.7 把兩者對照起來。貝氏的答案不是「斜率變異數很大」,而是「資料解析不出這個變異數」;後驗誠實地這麼說,不塌成一個假的確定性(false certainty)。往下游走,任何依賴斜率變異數的量都繼承這份誠實的不確定性,不是繼承一個退化的點。
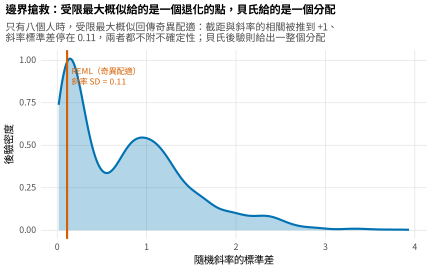
註:一個建在八個人身上的隨機斜率模型。受限最大概似回傳奇異配適:截距與斜率的相關被推到 \(+1\),斜率標準差停在 \(0.11\)(紅線),完全不附不確定性。貝氏後驗(藍)讓這個標準差離零有段距離,並帶著一個很寬的可信區間,誠實地表達「資料解析不出這個變異數」,而不是把它壓掉。
第二項好處是小樣本推論。群集數很少時,固定效果建立在天真常態近似上的頻率論區間會涵蓋不足(under-cover),因為它忽略了估計出來的變異數成分本身帶著的不確定性(uncertainty),正是第 13 章 Satterthwaite 與 Kenward-Roger 修正處理的同一個問題。圖 17.8 摘要一個只有五個群集的模擬:天真區間在大約百分之八十九的樣本中涵蓋到真值,名目(nominal)上卻是百分之九十五;貝氏可信區間把變異數中的不確定性積分進來,因而比較寬,涵蓋率約為百分之九十三。貝氏區間在小樣本下校準(calibrate)得比較好,靠的不是魔法,是對「什麼是不知道的」誠實。這裡也要接上後面會展開的告誡:這份誠實依賴合理的先驗,草率的先驗會讓小樣本的貝氏推論更差,不是更好 (McNeish, 2016; Smid et al., 2020)。
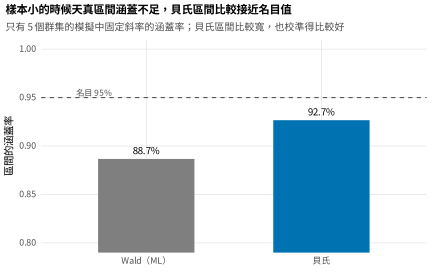
註:一個只有五個群集的模擬中,固定斜率名目百分之九十五區間的涵蓋率。天真的最大概似區間忽略變異數成分中的不確定性,因而涵蓋不足;比較寬的貝氏可信區間接近名目值。這項改善靠的是合理的先驗,不是「貝氏」這個標籤。
第三項好處是不確定性傳遞。貝氏估計回傳的是聯合後驗的抽樣,參數的任何一個函數因此免費繼承一個完整的後驗分配,包括那些最大概似的點估計做法只能笨拙近似的量。圖 17.9 給出其中一個衍生量:sleepstudy 資料中每一個人真正的斜率為負的後驗機率,也就是這個人在睡眠剝奪之下反應時間變好而不是變差的機率。幾乎沒有人有值得一提的變好機率,估計最曖昧的那一位所帶的機率接近二分之一,而這一切不確定性都被恰當地量化了。這一類問題都直接從後驗抽樣回答:某個人屬於某一類的機率、母體中軌跡在下降的比例、一位尚未被觀察到的個體的預測路徑。最大概似則必須訴諸 delta 法(delta method)或拔靴法(bootstrap),而且仍然難以把變異數成分中的不確定性傳遞出去。圖 17.10 接著說出每一項示範結尾都該說的那句平衡的話:重新配適的 sleepstudy 模型,各參數的最大概似估計值與貝氏後驗平均數相當一致,變異數成分在貝氏配適下只稍大一些,因為它不帶最大概似那個向下的偏誤。兩具引擎通常回傳同樣的數字,差別在於把什麼當成不確定的,以及資料很薄時能誠實地說什麼。表 17.4 就本書的幾個模型家族,列出各自什麼時候比較好。
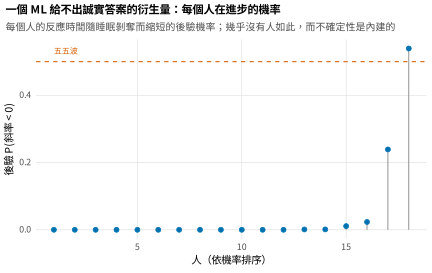
註:sleepstudy 資料中每一個人真正的斜率為負的後驗機率,也就是反應時間在睡眠剝奪之下變好的機率。幾乎沒有人如此,最曖昧的那一位落在五五波的位置。這一類屬於個人的衍生量連同它們的不確定性,直接由後驗抽樣得出;要從最大概似的點估計值誠實地取得,就相當彆扭。
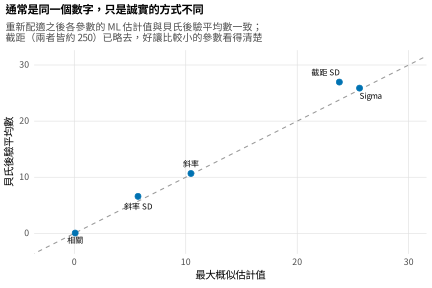
註:sleepstudy 模型各參數的最大概似估計值對上貝氏後驗平均數(截距在兩者之下都接近 \(250\),已略去,好讓比較小的參數看得清楚)。估計值落在單位線(identity line)上;隨機效果的標準差在貝氏配適下稍大,因為它沒有最大概似那個向下的變異數偏誤。數字一致,對待不確定性的方式不同。
表 17.4 什麼時候該偏好貝氏估計、什麼時候該偏好最大概似。
| 偏好貝氏估計的時機 | 偏好最大概似的時機 |
|---|---|
| 變異數撞到邊界或出現奇異配適 | 樣本大而配適穩定 |
| 樣本小而推論必須誠實 | 速度或慣例最重要 |
| 衍生量需要完整的不確定性 | 一個快速的點估計就夠了 |
| 模型弱識別(尺度、動態、潛在) | 模型標準而且識別良好 |
註:本書是雙語的。貝氏估計在最大概似吃力的地方值回它的成本:在邊界上、在小樣本上、在衍生量與弱識別模型上;而對大型、穩定、標準的問題,最大概似仍然是有效率的預設。
17.6 報告一項貝氏縱貫分析
一項貝氏分析要報告到一個標準:讓抱持懷疑(skeptical)的讀者能重建它,也能信任它;學界已經為此收斂出一份檢核表 (Depaoli & van de Schoot, 2017)。先驗要連同理由一起陳述,並報告一項先驗敏感度分析,因為沒有陳述出來的先驗就是無法稽核(audit)的假設。軟體與版本要指名,因為預設值會變。收斂診斷,也就是 \(\hat{R}\)、有效樣本數與發散轉移的次數,要一一報出來,不能只斷言一句「都沒問題」;任何發散都必須解釋或解決。後驗以集中趨勢(central tendency)加一個可信區間摘要,絕不只給一個點估計值,衍生量也要連同區間一起報告。後驗預測檢查要秀出來。表 17.5 就是那份檢核表。最後還有一件實務上的事:怎麼面對抱持懷疑的審查者或口試委員。最有效的回應是證據,也就是圖 17.10 那張一致性圖,顯示兩者都有效的地方貝氏與頻率論的估計值重合,再加上一份把先驗與診斷交代完整的報告,消除「是不是有藏起來的選擇」這層疑慮。
表 17.5 一項貝氏縱貫分析的報告檢核表。
| 要素 | 要報告什麼 |
|---|---|
| 先驗 | 每一個先驗連同它的理由,以及一項敏感度分析 |
| 軟體 | 套件與版本,以及取樣器的設定 |
| 收斂 | \(\hat{R}\)、主體與尾部的有效樣本數,以及發散轉移次數 |
| 後驗摘要 | 集中趨勢配上可信區間,絕不只給一個點 |
| 衍生量 | 連同它們完整的後驗不確定性一起報告 |
| 模型檢查 | 後驗預測檢查與任何預測導向的比較 |
註:這份檢核表改編自「何時該擔心貝氏方法」那套指引,存在的目的是讓讀者能稽核每一項選擇。一再出現的失誤,是報告了後驗平均數與可信區間,卻略掉那些使它們值得信任的先驗與診斷。
17.7 在 R 中執行貝氏模型
brms 套件用與 lme4 相同的式子語法設定貝氏多層次模型,交給 Stan 配適,並提供可以檢視(inspect)也可以覆寫(override)的弱訊息預設先驗。
library(brms)
# sleepstudy 的隨機斜率模型,貝氏版
m <- brm(Reaction ~ Days + (Days | Subject), data = sleepstudy,
         prior = c(prior(normal(0, 50), class = b),          # 固定效果
                   prior(normal(0, 50), class = sd),          # 隨機效果 SD(半常態)
                   prior(lkj(2),        class = cor)),        # 相關上的 LKJ
         chains = 4, cores = 4, seed = 1)
summary(m)                                                    # 後驗摘要 + Rhat、ESS
診斷、先驗與後驗預測檢查,以及預測導向的比較,各只要一次呼叫,而衍生量則由後驗抽樣得出。
pp_check(m)                                    # 後驗預測檢查
loo(m)                                         # 留一交叉驗證
# 先驗預測:以 sample_prior = "only" 重配一次,再 pp_check
# 衍生量:由後驗抽樣算 P(某人的斜率 < 0)
post <- as_draws_df(m)                          # 後驗抽樣,含隨機效果
# 先驗敏感度:在 2-3 組先驗之下重配並比較後驗
隨附的腳本 ch17_analysis_V01.R 收錄本章完整的分析:先驗預測與 LKJ 的示範、一個從第一原理寫出分裂 \(\hat{R}\) 與有效樣本數函式的透明馬可夫鏈蒙地卡羅取樣器、漏斗幾何、邊界搶救、小樣本涵蓋率模擬,以及衍生量與一致性的圖示;圖形由中文版的 ch17_figures_zh_V01.R 繪出。該腳本為了透明與可攜性,用自己寫的取樣器配適模型;實務生產建議用配上 Stan 後端的 brms,後面幾章建立在本章之上時,預設的引擎也是它。
軟體提示 • 貝氏工具鏈
工具分好幾層。最底下是 Stan 本身,透過 cmdstanr 或 rstan 呼叫,控制權完整,任何寫得進它那個語言的模型都配適得了 (Carpenter et al., 2017)。brms 套件由一條式子自動寫出 Stan 程式,是本書這些模型建議的入口;rstanarm 預先編譯一組固定的模型,換來較快的啟動,代價是彈性(flexibility)。診斷與視覺化用 bayesplot,後驗的操作用 posterior 與 tidybayes,交叉驗證在 loo。第五部的結構方程模型有 blavaan,把同一個 Stan 後端(backend)帶進潛在變項架構。跨程式工作有一項告誡:Mplus 的貝氏估計式,預設值與診斷都和 Stan 生態系不同,它報的潛在尺度縮減因子建立在另一種構造(construction)上;第 25 章的動態結構方程模型若在該程式中配適,這個差別就會要緊。
17.8 常見的迷思
關於貝氏方法,有幾個信念會誤導讀者。第一個是貝氏估計讓人在小樣本下想說什麼都行。資料稀少時先驗確實在做事,敏感度分析因此是必要的,而草率的先驗會傷害,不會幫助 (McNeish, 2016)。第二個是可信區間不過是哲學比較好的信賴區間。先驗弱、資料充足時兩者數值接近,但它們下的是不同的陳述,差別正好在於什麼被當成隨機的。第三個是發散轉移是可以容忍的警告。發散標示的是取樣器穿不過後驗的某一塊,那些抽樣因此帶偏誤,不只是沒效率,必須解決。第四個是交叉驗證會選出真的模型。它估計的是預測準確度,而預測最好的模型未必是有解釋力的那一個。第五個是平坦先驗是客觀、無假設的選擇。放在變異數上的平坦先驗是一項很強、通常也不合理的陳述,圖 17.2 的先驗預測檢查已經顯示過了。
常見陷阱 • 貝氏實作上的四個錯誤
第一,以客觀之名在變異數上放平坦先驗:放在變異數上的平坦或極寬先驗,會在組內相關與其他衍生量上隱含一個極端的先驗;請以先驗預測模擬檢查它到底隱含了什麼。第二,因為 \(\hat{R}\) 看起來沒問題就忽略發散:各鏈收斂並不排除取樣器從未到達的區域,發散必須自己處理,通常是靠非中心化參數化。第三,用交叉驗證選出一個模型,然後把它解讀成因果真相:預測上的排序(ranking)不構成解釋上的憑據(warrant)。第四,報告一個有界參數的後驗平均數卻不給區間:變異數或相關靠近邊界時,光看平均數會誤導,訊息在區間裡。
本章摘要
貝氏估計把後驗形成為先驗乘上概似,再以模擬探索它;縱貫建模中的邊界、積分與潛在動態一再要求的,正是這一具估計引擎。後驗給出可信區間,陳述的是參數落在某個範圍內的機率,而先驗弱時它通常由資料主導(圖 17.1)。先驗放在標準差上而不是變異數上,用容許小變異數的半常態或半 \(t\) 密度,相關則透過 LKJ 先驗;每一個先驗都要以先驗預測模擬檢查,因為放在變異數上的先驗,就是放在組內相關以及它所隱含的一切之上的先驗(圖 17.2 與圖 17.3、表 17.1)。帶 Hamiltonian 動力學的馬可夫鏈蒙地卡羅,以 \(\hat{R}\)、有效樣本數與發散轉移診斷(圖 17.4、表 17.2);階層模型的招牌病態是漏斗,治它靠的不是調校,是非中心化的重新參數化(圖 17.5)。模型以瞄準要緊特徵的後驗預測檢查來批判(圖 17.6),以交叉驗證來比較,而交叉驗證估計的是預測,不是真理(表 17.3)。好處很具體:最大概似只給一個退化的點,貝氏給出一個後驗(圖 17.7);小樣本的區間校準得比較好(圖 17.8);衍生量帶著完整的不確定性(圖 17.9);而兩者都有效的地方,它與最大概似在數字上仍然一致(圖 17.10、表 17.4)。這項分析要報告到一份由先驗、診斷與檢查構成、可供稽核的檢核表(表 17.5)。
接下來要去哪裡
後面大部分的內容都要用到本章。第五部的結構方程模型,也就是潛在成長與變化分數模型以及交叉延宕追蹤模型,越來越多透過 blavaan 與商業程式的貝氏選項以貝氏估計配適,第 18 章的恆等性檢定也得到一個近似的貝氏形式。第六部的密集縱貫模型幾乎完全靠它:第 25 章的動態結構方程模型原封不動繼承本章的診斷表,第 26 章與第 27 章的連續時間與狀態空間模型實務上就是貝氏的。交叉驗證那一節的預測取向會在第 31 章回來,報告檢核表則餵給第 36 章的工作流程。第 16 章的位置尺度模型把你送到這裡來取它的估計方法,現在可以帶著理解重配一次,而不是拿著借來的工具。本章養成的三個習慣,以隱含結果檢查先驗、在看估計值之前先看診斷、把不確定性傳遞到每一個衍生量,就是貝氏縱貫分析的工作紀律。
習題
- 17.1 先驗預測的設計。對一個結果變項介於零到一百之間的成長模型,為固定效果與變異數成分選擇先驗,從它們模擬,並在碰資料之前就證明所隱含的軌跡與組內相關是合理的。
- 17.2 診斷與修復。給定三個植入了不同病態的配適模型:一條未混合的鏈、一個尾部有效樣本數過低的情形,以及來自漏斗的發散,請由各自的診斷把它們一一辨認出來,並說出修復方式。
- 17.3 重配與一致。把前面某一章的一個混合模型在貝氏估計之下重新配適,產出最大概似對貝氏的一致性圖,並為兩者不同的任何一個參數提出說明。
- 17.4 衍生量。由後驗抽樣算出某個人的斜率為負的機率,以及一位新受試者軌跡的預測區間,並各寫出它所支持的那一句實質陳述。
- 17.5 預測導向的比較。以留一交叉驗證比較一個線性與一個分段成長模型,把 Pareto 形狀參數的標示實質地解讀成有影響力的個人,並陳述這項比較確立了什麼、又沒有確立什麼。
- 17.6 先驗敏感度。在三組站得住腳的先驗之下重新配適一個模型,報告某個關鍵參數在各組之下的後驗,並判斷這項結論是否穩健。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 後驗 | posterior | 給定資料之後參數的分配;正比於先驗乘上概似;第 17.1 節 |
| 先驗 | prior | 看到資料之前對參數的分配;第 17.1 節 |
| 可信區間 | credible interval | 以陳述好的後驗機率包含參數的區間;第 17.1 節 |
| 弱訊息先驗 | weakly informative prior | 寬到不指向結論、窄到能排除荒謬值的先驗;第 17.2 節 |
| 先驗預測模擬 | prior predictive simulation | 從先驗抽樣並檢視它隱含的資料或衍生量;第 17.2 節 |
| LKJ 先驗 | LKJ prior | 相關矩陣上由形狀參數 \(\eta\) 掌管的先驗;第 17.2 節 |
| 馬可夫鏈蒙地卡羅 | Markov chain Monte Carlo (MCMC) | 以平穩分配為後驗的抽樣鏈;第 17.3 節 |
| Hamiltonian 蒙地卡羅 | Hamiltonian Monte Carlo | 以對數後驗梯度提出遠距移動的取樣器;第 17.3 節 |
| 潛在尺度縮減因子 | potential scale reduction factor (\(\hat{R}\)) | 比較鏈內與鏈間變異數的收斂診斷;第 17.3 節 |
| 有效樣本數 | effective sample size | 自我相關的鏈相當於多少個獨立抽樣;第 17.3 節 |
| 發散轉移 | divergent transition | Hamiltonian 模擬穿不過某區域的失敗;標示偏誤;第 17.3 節 |
| 漏斗 | funnel | 階層模型中組標準差與組效果的聯合後驗形狀;第 17.3 節 |
| 非中心化參數化 | non-centered parameterization | 把組效果寫成標準差乘上標準常態變項;第 17.3 節 |
| 後驗預測檢查 | posterior predictive checking | 把模型模擬出的特徵與觀察資料對照(承第 16 章);第 17.4 節 |
| 留一交叉驗證 | leave-one-out cross-validation | 以樣本外預測準確度比較模型;第 17.4 節 |
| 貝氏因子 | Bayes factor | 兩個模型邊際概似的比值;對先驗高度敏感;第 17.4 節 |
參考文獻
Betancourt, M. (2017). A conceptual introduction to Hamiltonian Monte Carlo. arXiv. https://arxiv.org/abs/1701.02434
Bürkner, P.-C. (2017). brms: An R package for Bayesian multilevel models using Stan. Journal of Statistical Software, 80(1), 1–28. https://doi.org/10.18637/jss.v080.i01
Carpenter, B., Gelman, A., Hoffman, M. D., Lee, D., Goodrich, B., Betancourt, M., Brubaker, M., Guo, J., Li, P., & Riddell, A. (2017). Stan: A probabilistic programming language. Journal of Statistical Software, 76(1), 1–32. https://doi.org/10.18637/jss.v076.i01
Depaoli, S., & van de Schoot, R. (2017). Improving transparency and replication in Bayesian statistics: The WAMBS-checklist. Psychological Methods, 22(2), 240–261. https://doi.org/10.1037/met0000065
Gabry, J., Simpson, D., Vehtari, A., Betancourt, M., & Gelman, A. (2019). Visualization in Bayesian workflow. Journal of the Royal Statistical Society: Series A (Statistics in Society), 182(2), 389–402. https://doi.org/10.1111/rssa.12378
Gelman, A. (2006). Prior distributions for variance parameters in hierarchical models. Bayesian Analysis, 1(3), 515–534. https://doi.org/10.1214/06-BA117A
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). CRC Press. https://doi.org/10.1201/b16018
Kruschke, J. K. (2015). Doing Bayesian data analysis: A tutorial with R, JAGS, and Stan (2nd ed.). Academic Press. https://doi.org/10.1016/C2012-0-00477-2
Lewandowski, D., Kurowicka, D., & Joe, H. (2009). Generating random correlation matrices based on vines and extended onion method. Journal of Multivariate Analysis, 100(9), 1989–2001. https://doi.org/10.1016/j.jmva.2009.04.008
McElreath, R. (2020). Statistical rethinking: A Bayesian course with examples in R and Stan (2nd ed.). CRC Press. https://doi.org/10.1201/9780429029608
McNeish, D. (2016). On using Bayesian methods to address small sample problems. Structural Equation Modeling: A Multidisciplinary Journal, 23(5), 750–773. https://doi.org/10.1080/10705511.2016.1186549
Smid, S. C., McNeish, D., Miočević, M., & van de Schoot, R. (2020). Bayesian versus frequentist estimation for structural equation models in small sample contexts: A systematic review. Structural Equation Modeling: A Multidisciplinary Journal, 27(1), 131–161. https://doi.org/10.1080/10705511.2019.1577140
van de Schoot, R., Depaoli, S., King, R., Kramer, B., Märtens, K., Tadesse, M. G., Vannucci, M., Gelman, A., Veen, D., Willemsen, J., & Yau, C. (2021). Bayesian statistics and modelling. Nature Reviews Methods Primers, 1, Article 1. https://doi.org/10.1038/s43586-020-00001-2
Vehtari, A., Gelman, A., & Gabry, J. (2017). Practical Bayesian model evaluation using leave-one-out cross-validation and WAIC. Statistics and Computing, 27(5), 1413–1432. https://doi.org/10.1007/s11222-016-9696-4
Vehtari, A., Gelman, A., Simpson, D., Carpenter, B., & Bürkner, P.-C. (2021). Rank-normalization, folding, and localization: An improved $R$ for assessing convergence of MCMC. Bayesian Analysis, 16(2), 667–718. https://doi.org/10.1214/20-BA1221
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。