第 11 章
重複量數變異數分析與多變量變異數分析
重複量數的變異數分析(analysis of variance, ANOVA)是變異數分析傳統對「改變」給出的答案,到今天仍是實驗心理學的預設作法,也是多數審稿人期待聽到的語言。本章給這個仍然管用的工具應有的敬意,也用它的假設所要求的精確度要求它。目的有兩層。一是把這套方法教到位:變異數分解(decomposition of variance)、承重的球形假設(sphericity assumption)與救它一命的幾種修正、對比(contrast)、混合設計(mixed design),以及它的多變量替代方案。二是把它的邊界劃清楚,好讓第四部走向混合模型(mixed model)這一步出於理解,不是趕流行。重複量數變異數分析不是混合模型的過時對手,是它的一個受限特例(constrained special case):在平衡、完整、時間為類別的這個狹窄範圍內,它相當有力。本章最後會把促成一般模型的五項限制示範出來,不只是宣稱一遍。
學習目標
讀完本章之後,你應該能夠:(1) 分解重複測量的平方和(sum of squares),並說明受試者內設計(within-subject design)如何把個別差異移出誤差項;(2) 精確陳述球形假設(sphericity assumption)、檢定它,並把 Greenhouse-Geisser 與 Huynh-Feldt 兩種修正當成預設程序來套用;(3) 分析受試者間與受試者內交叉的混合因子設計(mixed factorial design),並以正確的誤差項透過對比(contrast)與單純主要效果(simple effects)解讀其交互作用(interaction);(4) 以正交多項式對比(orthogonal polynomial contrasts)進行趨勢分析(trend analysis),並把它接上成長曲線(growth curve);(5) 在修正後的單變量取向(corrected univariate approach)與多變量取向(multivariate approach)之間作選擇並為選擇辯護;(6) 計算並解讀淨 \(\eta^2\)(partial eta-squared)與廣義 \(\eta^2\)(generalized eta-squared);(7) 逐項列出並示範促成混合模型的五項結構限制。
11.1 受試者內優勢的形式化
重複測量設計的力量,來自一種受試者間設計(between-subjects design)做不到的變異數分割。每個人在每個時點都測過,總變異數就可以先切出個體間(between-persons)的部分,也就是整體水準上穩定的個別差異,再切出個體內(within-persons)的部分。個體間的變異數在受試者間設計裡會膨脹誤差項,在這裡則被移出誤差項。圖 11.1把治療試驗實驗組的這個分割畫了出來:總平方和分成一大塊擱在一旁的個體間成分,以及一塊個體內成分;個體內成分再分成時點(occasion)效果這個訊號,以及用來檢定該訊號的個體內殘差(residual)。誤差項不再扛著個體間的變異數,對時點效果的檢定就遠比對等的受試者間比較敏感。這正是配對 \(t\) 檢定在第 10 章享有的優勢,如今由兩個時點推廣到 \(k\) 個。表 11.1列出證成這個 \(F\) 比值的期望均方(expected mean squares),關鍵在最後一列:時點效果是拿個體內殘差來檢定的,而這一項在虛無假設(null hypothesis)之下的期望均方就只等於誤差變異數本身。
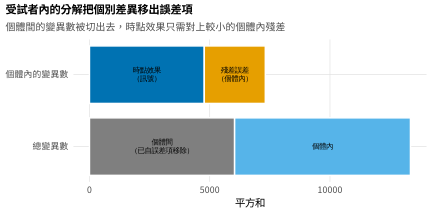
註:實驗組的總平方和(total sum of squares)分割成個體間(between-persons)的部分(擱在一旁)與個體內(within-persons)的部分;個體內的部分再分成時點(occasion)效果與殘差誤差(residual error)。個體間的變異數已經移除,時點效果面對的是很小的個體內誤差,這就是重複測量設計檢定力(power)的來源。
表 11.1 單因子重複測量設計的期望均方。
| 變異來源 | \(df\) | 期望均方 | \(F\) |
|---|---|---|---|
| 個體間 (\(S\)) | \(n-1\) | \(\sigma^2_e + k\,\sigma^2_S\) | |
| 時點 (\(A\)) | \(k-1\) | \(\sigma^2_e + n\,\theta^2_A\) | \(\mathrm{MS}_A/\mathrm{MS}_{SA}\) |
| 誤差 (\(S \times A\)) | \((n-1)(k-1)\) | \(\sigma^2_e\) |
註:\(\sigma^2_S\) 是個體間的變異數(between-persons variance),\(\theta^2_A\) 是時點效果(occasion effect),\(\sigma^2_e\) 是殘差(residual)。時點效果拿人與時點的交互作用來檢定,這一項的期望均方就只是誤差變異數。把設計寫成一個隨機的人效果(random person effect)加上一個固定的時點效果(fixed occasion effect),等於已經把它表述成一個受限的混合模型(mixed model),這正是第四部要推廣的一點。
表 11.1的期望均方結構值得讀兩遍,它揭示了重複量數變異數分析是一個換了裝的混合模型。一個貢獻出個體間變異數 \(\sigma^2_S\) 的隨機人效果,加上一個固定的時點效果,就是第 13 章的隨機截距模型(random-intercept model);這個設計所執行的 \(F\) 檢定,也就是該模型在一個特定共變數假設(covariance assumption)之下會執行的檢定。現在就認清這一點,可以免去「第四部取代了本章」的錯覺。第四部是把本章推廣,鬆開的正是下一節要檢視的那個假設。
11.2 球形:那個承重的假設
重複測量 \(F\) 檢定能否成立,靠的不是大家熟悉的變異數同質性(homogeneity of variance),而是一個更強也更脆弱的假設:球形(sphericity),也就是所有時點兩兩相減之後,這些差異的變異數彼此相等。換個等價的說法:扣掉時點平均數與個人平均數之後,時點之間的共變數具有複合對稱(compound symmetry)的形式,變異數相等且共變數相等。縱貫資料幾乎從來不滿足這個條件。時間上靠得近的時點相關較強、離得遠的相關較弱,這是一種自我迴歸(autoregressive)結構;相隔遠的時點之間的差異,會比相鄰時點之間的差異變動得更厲害。圖 11.2直接在實驗組資料上顯示了這項違反:成對差異的變異數隨兩個時點的間隔穩定增大,而球形要求每一個點都落在虛線上。偏離球形的程度由epsilon(\(\varepsilon\))量化,完全球形時等於一,違反越嚴重就越往 \(1/(k-1)\) 掉 (Box, 1954)。就這批資料而言,Greenhouse-Geisser 的估計值是 \(\varepsilon = 0.87\),Mauchly 球形檢定(Mauchly’s test of sphericity)也達到顯著(\(W = 0.79\),\(p = .004\))。
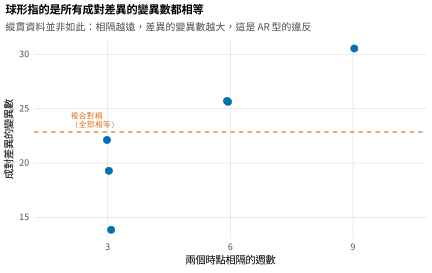
註:實驗組中兩個時點之差的變異數,對兩者相隔多遠作圖。球形(sphericity)要求這些值相等(虛線),但它們隨間隔增大,正是縱貫資料典型的自我迴歸式(autoregressive)違反。偏離的程度以 \(\varepsilon < 1\) 摘要。
無視球形被違反,代價是第一類型錯誤率(Type I error rate)嚴重膨脹:那些差異彼此相關時,未修正的 \(F\) 用的自由度(degrees of freedom)太大了。圖 11.3以一項虛無為真的模擬示範這件事。時點之間的自我迴歸相關越高、\(\varepsilon\) 越低,未修正的檢定拒絕一個為真的虛無假設的比例就遠高於 \(5\%\),在強相關處達到 \(7\%\);兩種標準修正則以 \(\varepsilon\) 這個乘數縮小自由度,把錯誤率拉回控制之中。Greenhouse-Geisser 修正 (Greenhouse & Geisser, 1959) 把兩個自由度都乘上估計出來的 \(\varepsilon\),略偏保守;Huynh-Feldt 修正 (Huynh & Feldt, 1976) 改用一個偏誤(bias)較小的估計式,更貼近名目水準。很自然會想到的作法,是先用 Mauchly 的程序檢定球形,只在它顯著時才修正,但這種兩階段策略本身就是膨脹的來源:Mauchly 檢定的檢定力很低,經常偵測不到真實的違反,於是放行了一個接著過度拒絕的未修正檢定。站得住腳的作法是預設就修正,不管 Mauchly 的判決如何,一律對每一個受試者內的 \(F\) 套用 Greenhouse-Geisser 或 Huynh-Feldt。球形真的成立時 \(\varepsilon\) 會接近一,修正幾乎不花代價。
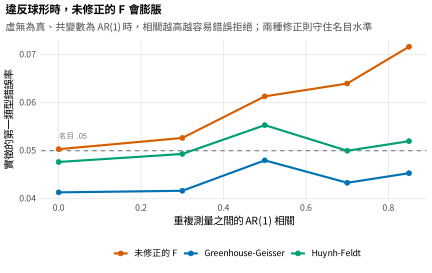
註:一項模擬中,四個時點具有自我迴歸共變數、虛無為真時的實徵第一類型錯誤率(empirical Type I error rate),對相關作圖。相關越大、球形越糟,未修正的 \(F\) 就越過度拒絕;Greenhouse-Geisser(略偏保守)與 Huynh-Feldt 兩種修正把錯誤率守在名目的 \(5\%\) 附近。這就是「預設就修正」的理由。
11.3 對比、趨勢與計畫性比較
整體的時點效果只回答了「平均數在某處有差別」,可解讀的問題多半落在改變的形狀上,這正是正交多項式對比(orthogonal polynomial contrasts)要處理的:把時點效果分割成線性趨勢、二次趨勢與更高階的成分。圖 11.4顯示這些對比的權重。線性對比檢定的是穩定的上升或下降,二次對比檢定的是單一個彎折,每一個都是自由度為一的比較。這些對比還有一項決定性的實務優點:每一個對比對每個人而言都只是一個導出分數(derived score),以單樣本比較的方式檢定,各自帶著自己的誤差項,因此不受球形假設牽制,整體檢定則深受其擾。用在實驗組上,趨勢分析的結果毫不含糊:線性對比很大且高度顯著(\(t = -16.7\),\(p < .001\)),二次對比幾乎沒有增益(\(t = -1.59\),\(p = .12\)),三次對比則完全沒有,症狀的下降基本上是一條直線。圖 11.5把線性配適與線性加二次配適疊在觀察平均數上,確認直線已經抓住了時點效果。通往第四部的橋在這裡是明說的:一組多項式趨勢對比就是一條沒有隨機斜率(random slope)的固定效果成長曲線(fixed-effects growth curve),描述的是平均軌跡,而第 19 章的潛在成長模型(latent growth model)會賦予它個體間的變異數。
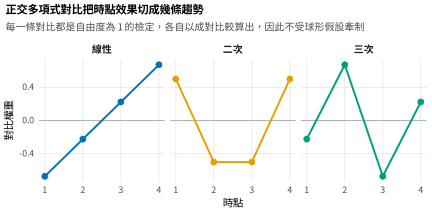
註:四個時點上線性、二次與三次對比的權重(contrast weight)。每一條對比都是自由度為一的檢定,以它自己的成對比較算出,不受球形假設牽制。線性對比檢定穩定的趨勢,二次對比檢定單一個彎折。
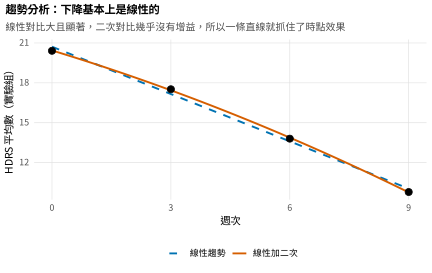
註:實驗組四個週次的觀察 HDRS 平均數(點),配上配適出來的線性趨勢(虛線)與線性加二次的配適(實線)。線性對比顯著、二次對比不顯著,一條直線就抓住了平均軌跡。多項式趨勢對比就是沒有隨機斜率的固定效果成長曲線。
11.4 混合因子設計
典型的成效評估設計,會把一個受試者間因子(between-subjects factor)與受試者內的時點因子交叉起來,招牌檢定就是交互作用。圖 11.6顯示治療試驗兩組跨四個波次的情形:一邊是疊在一起的剖面線,一邊是這項試驗真正的估計標的(estimand),也就是差異軌跡。組別與時間的交互作用(group-by-time interaction)檢定兩組是否隨時間有不同的改變,這就是治療效果的正式檢定。它在這裡很大且高度顯著,\(F(3, 444) = 17.7\),\(p < .001\),對應的多變量平行性檢定(multivariate parallelism test)也同意(Wilks \(\Lambda = 0.79\),\(p < .001\))。交互作用顯著並不表示治療在每一個波次都有效,誠實的後續作法是把它分解成單純主要效果(simple effects),在每一個時點之內檢定組別差異。圖 11.7顯示兩組在基線相當,一如隨機化(randomization)所保證的,之後才逐步拉開;這個交互作用反映的是隨時間浮現的治療效益,不是基線的不平衡。後續分析的誤差項必須小心挑選:某一個時點上的組間單純主要效果,用的誤差層(error stratum)和組內的趨勢並不相同,拿整體檢定的合併誤差(pooled error)去套每一個比較是很常見的錯誤。混合因子設計還帶進一項來自實驗心理學的區分,縱貫研究者必須想清楚。真正的重複測量實驗裡,時點是一個被操弄的條件,順序效果(order effects)必須以對抗平衡(counterbalancing)控制;縱貫觀察裡,時點就是時間本身,無從對抗平衡,延續效果(carryover)是一項實質的特徵,不是該用設計消掉的干擾。
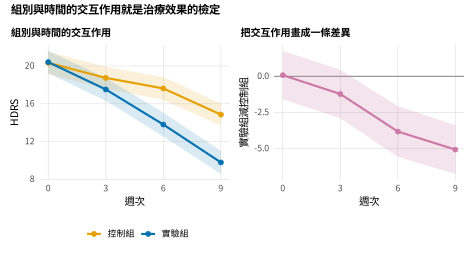
註:左:兩組跨四個波次的 HDRS 平均數,附信賴帶(confidence ribbon)。右:實驗組減控制組的差異軌跡。交互作用檢定兩組是否有不同的改變,這就是治療效果的正式檢定,最直接的呈現方式就是這條差異軌跡(如第 8 章所述)。
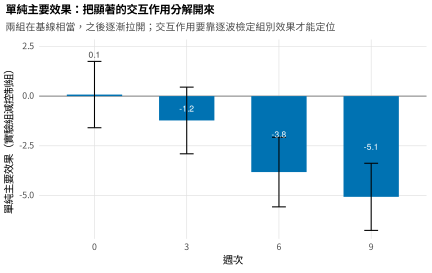
註:在每一個波次之內檢定的組別差異(實驗組減控制組),附信賴區間(confidence interval)。兩組在基線相當,之後隨時間拉開,交互作用反映的是逐漸浮現的治療效益,不是基線的不平衡。單純主要效果的作用是把交互作用定位,每一個都用它該用的誤差項。
11.5 多變量取向
除了修正單變量的 \(F\),另一條路是乾脆放棄球形假設,把 \(k\) 個時點當成一個 \(k\) 維的多變量結果變項來處理,這就是多變量變異數分析(multivariate analysis of variance, MANOVA)取向 (O’Brien & Kaiser, 1985)。它的受試者內檢定以 Wilks 的 lambda、Pillai 的跡(Pillai’s trace)或相關的統計量報告,對時點之間的共變數結構不作任何假設,改為要求多變量常態性(multivariate normality),以及最關鍵的完整資料。這份自由不是沒有代價。樣本相對於時點數偏小時,多變量檢定可能比修正後的單變量檢定更沒有檢定力,所以經典的建議是:小樣本偏好修正後的單變量取向,樣本充裕而球形被嚴重違反時偏好多變量取向 (Algina & Keselman, 1997; Davidson, 1972)。多變量的框架在剖面分析(profile analysis)裡有一種特別好解讀的形式,它對各組的剖面線提出三個問題,如圖 11.8所示。平行性(parallelism)問各組改變的形狀是否相同,也就是交互作用;水準(levels)問各組的平均高度是否有別,也就是組間主要效果(between-groups main effect);平坦性(flatness)問各組到底有沒有改變,也就是受試者內主要效果(within-subjects main effect)。這批治療資料對三個問題都給了決定性的答案:剖面線不平行、水準有別、也不平坦,合起來說的是兩組起點相近、都有改善,實驗組改善得更多。表 11.2提供兩種取向之間的選擇指引。
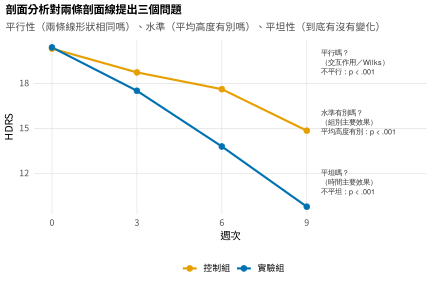
註:兩組跨週次的剖面線,標註了剖面分析(profile analysis)的三個問題:平行性(交互作用,兩條線形狀是否相同)、水準(組間主要效果,高度是否有別),以及平坦性(受試者內主要效果,到底有沒有改變)。剖面分析是多變量取向中最好解讀的一面。
表 11.2 修正後的單變量對多變量:一份選擇指引。
| 情境 | 建議的取向 |
|---|---|
| 相對於時點數,\(n\) 偏小 | 修正後的單變量(Greenhouse-Geisser/Huynh-Feldt) |
| \(n\) 充裕、球形被嚴重違反 | 多變量(Wilks、Pillai) |
| 關心的是趨勢的形狀 | 多項式對比(兩種取向下都不受球形牽制) |
| 有時點遺漏 | 兩者皆不適用;改用混合模型(第四部) |
| 想問可解讀的組別剖面問題 | 剖面分析(平行性、水準、平坦性) |
註:兩種取向都假定資料完整且平衡(balanced)。時點有遺漏、每個人的測量時間各自不同,或時間是連續的,兩者都不適用,必須改用混合模型(mixed model)。假設被違反時,Pillai 的跡(Pillai’s trace)是最穩健(robust)的多變量統計量。
11.6 效果量與報告
重複測量的結果報告時要附上效果量(effect size),而兩個常見選項怎麼選,對累積性科學(cumulative science)是有影響的。淨 \(\eta^2\)(partial eta-squared)表達的是一個效果相對於它自己加上它自己的誤差;這個分母排除了其他因子的變異數與個體間的差異,淨 \(\eta^2\) 在受試者內設計中因此被膨脹,更糟的是它在因子結構不同的設計之間並不可比。廣義 \(\eta^2\)(generalized eta-squared) (Bakeman, 2005; Olejnik & Algina, 2003) 用的分母則納入任何設計中都存在的個體間變異數與誤差變異數,在受試者間、受試者內與混合設計之間都可比,這就是它被推薦為重複測量預設效果量的理由。兩者可以差很多:治療與時間的交互作用,淨 \(\eta^2\) 是 \(.11\),廣義 \(\eta^2\) 卻是 \(.04\);把淨值當成可以和受試者間效果相比的數字來報告,會誇大這個交互作用。針對特定對比的效果量,例如標準化的線性趨勢效果,往往比整體值更有訊息量。表 11.3界定各個選項,表 11.4是報告檢核表,其中不可退讓的元素是修正後的自由度、\(\varepsilon\) 的數值,以及一個廣義的效果量。
表 11.3 重複測量設計的效果量。
| 效果量 | 分母 | 用途 |
|---|---|---|
| 淨 \(\eta^2\) | 效果 \(+\) 它自己的誤差 | 研究內部;跨設計不可比 |
| 廣義 \(\eta^2\) | 效果 \(+\) 個體間的變異數與誤差變異數 | 推薦使用;跨設計可比 |
| \(\omega^2\)(廣義) | 偏誤較小的版本 | 在意偏誤校正時 |
| 對比的 \(d\) | 該對比的 SD | 針對趨勢,往往最有訊息量 |
註:本書推薦廣義 \(\eta^2\)(generalized eta-squared):它的分母把淨 \(\eta^2\) 拿掉的那些變異數成分放了回去,效果因此能在一份文獻所包含的受試者間、受試者內與混合設計之間相互比較。
表 11.4 重複測量設計的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 修正後的檢定 | 附 Greenhouse-Geisser 或 Huynh-Feldt 自由度的 \(F\),以及 \(\varepsilon\) 的數值 |
| 效果量 | 每一個效果的廣義 \(\eta^2\) |
| 球形 | 說明修正是預設套用的(不是取決於 Mauchly 檢定) |
| 交互作用的後續分析 | 單純主要效果或對比,附上恰當的誤差項,並控制多重性(multiplicity) |
| 趨勢 | 當關心形狀時,報告多項式對比 |
| 遺漏資料 | 不完整的個案如何處理,以及由此得到的 \(n\) |
註:報告未修正的自由度、略去 \(\varepsilon\),或只給淨 \(\eta^2\),是常見的疏漏。這份檢核表與 APA 對重複測量設計的期待一致。
11.7 重複量數變異數分析做不到的事
本章對這套方法的敬意,反而讓它的限制更具教育意義。以下五項限制(示範於圖 11.9的圖庫中)合起來,使第四部的混合模型成為必要,而不只是流行。第一,這個設計要求完整而平衡的資料,只要少了一個時點,整列刪除(listwise deletion)就把那個人整個剔掉;治療資料中若要求十二週都完整,收案的病人只剩下 \(134\) 位,個案與統計檢定力一併丟掉,而第 6 章已經說明這是可以避免的。第二,時點必須是類別的,每個人測量時間各自不同的設計在觀察性研究與密集研究中很常見,這裡卻根本無法表述。第三,這個模型不容許改變上的個別差異,只估一條平均軌跡;個體間斜率的變異數往往正是實質上關心的量,對整體 \(F\) 而言卻是隱形的。第四,它的共變數假設是一份僵硬的菜單:不是複合對稱,就是多變量那個無結構(unstructured)的極端,中間那些自我迴歸的與異質的結構一概沒有,混合模型則可以配適並比較它們。第五,它容納不了時間變動共變項(time-varying covariate),也就是本身會隨時點改變的預測變項,因為它的設計矩陣(design matrix)裡沒有位置放。表 11.5是讀者的羅塞塔石碑,把每一個重複測量的概念翻譯成它的混合模型對應項,也正是接下來幾章要走過的那座橋;同一張表會在第 13 章再次出現。
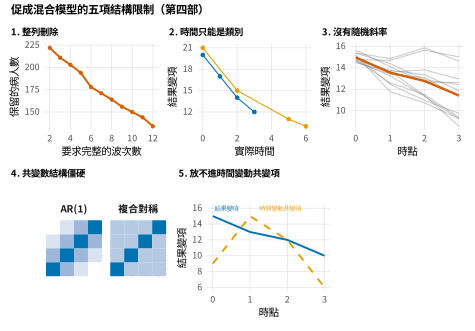
註:(1) 整列刪除(listwise deletion)會因為任何一個時點的遺漏而丟掉一位病人,要求的完整波次越多,個案就掉得越多。(2) 只能表述類別的、等間距的時間,表述不了每個人各自不同的測量時間。(3) 只估一條平均軌跡;斜率上的個別差異是隱形的。(4) 共變數的菜單很僵硬。(5) 放不進時間變動共變項(time-varying covariate)。每一項都被第四部的混合模型解除。
表 11.5 把重複量數變異數分析翻譯成混合模型。
| 重複量數變異數分析 | 混合模型的對應項 |
|---|---|
| 個體間的平方和 | 隨機截距,(1 | person) |
| 複合對稱假設 | 只有隨機截距的共變數 |
| 球形修正(\(\varepsilon\)) | 一個配適出來的共變數結構(AR、無結構) |
| 時點作為一個因子 | 時間的固定效果 |
| 多項式趨勢對比 | 固定的多項式時間(沒有隨機斜率) |
| 組別與時間的交互作用 | 固定的組別與時間交互作用 |
| (沒有)個體斜率的變異數 | 隨機斜率,(time | person) |
| 不完整個案的整列刪除 | 對觀察到的資料直接作概似(FIML) |
| 只能是類別的、平衡的時間 | 連續的、每個人各自不同的時間 |
| (沒有)時間變動共變項 | 一個第一層的時間變動預測變項 |
註:左欄的每一列,都是右欄那個一般模型的一個特例或一項限制。重複量數變異數分析就是被限制成只有隨機截距、時間為類別且平衡、資料完整的混合模型。
11.8 在 R 中執行這些分析
base R 以 aov 加上一個 Error 層執行重複量數變異數分析,這一層把個體間與個體內的誤差項分開;球形的那套做法,不過是對重複測量的共變數矩陣作一小段計算。
library(dplyr); library(tidyr)
rct <- readRDS("Examples/data/therapy_rct.rds")
w <- rct |> filter(week
  pivot_wider(names_from = week, values_from = hdrs, names_prefix = "w",
              id_cols = c(patient_id, arm)) |> filter(complete.cases(across(everything())))
long <- w |> pivot_longer(starts_with("w"), names_to = "occ", values_to = "y") |>
  mutate(occ = factor(occ), pid = factor(patient_id), arm = factor(arm))

# --- 混合因子:受試者間 (arm) x 受試者內 (occ),誤差層要分對 ---
fit <- aov(y ~ arm * occ + Error(pid / occ), data = long)
summary(fit)                                        # arm 在 pid 層;occ、arm:occ 在個體內層
Greenhouse-Geisser 的 epsilon 由受試者內正交規範對比(orthonormal contrasts)的共變數算出,Mauchly 檢定則可對一個多變量線性模型取得;多項式趨勢與多變量的剖面檢定走的是同一套對比邏輯。
Y <- as.matrix(dplyr::filter(w, arm == "Treatment")[, c("w0","w3","w6","w9")])
k <- ncol(Y); n <- nrow(Y); C <- t(contr.poly(k))   # (k-1) x k 的正交規範對比
lam <- eigen(C
eps_gg <- sum(lam)^2 / ((k - 1) * sum(lam^2))        # Greenhouse-Geisser epsilon
mauchly.test(lm(Y ~ 1), X = ~1)                      # 球形檢定

# --- 多項式趨勢對比:每一條都是自己的單一自由度、不受球形牽制的檢定 ---
apply(contr.poly(k), 2, function(w) t.test(Y

# --- 多變量/剖面分析(平行性 = arm x time 交互作用)---
D <- Y <- as.matrix(w[, c("w0","w3","w6","w9")])
summary(manova(D ~ w$arm), test = "Wilks")           # 不作球形假設
完整的分析都在隨附的腳本 ch11_analysis_V01.R 之中,包括一個小資料集的手算分解、第一類型錯誤模擬,以及廣義 \(\eta^2\) 的計算;圖形由中文版的 ch11_figures_zh_V01.R 繪出。使用 afex 套件的讀者一次呼叫就能得到同樣的修正檢定與效果量,emmeans 則能處理對比與單純主要效果並控制多重性。此處展示 base R 的路徑,是為了讓機制看得見。
軟體提示 • 誤差層的陷阱,以及 afex 的便利
重複測量分析中,base R 最常見的單一錯誤是漏掉或寫錯 Error 項。這會使 aov 把個體內與個體間的變異數合併成一個錯誤的誤差層,報出一個嚴重過度寬鬆(anticonservative)的 \(F\)。正確的寫法 Error(pid / occ) 告訴 R 時點巢套(nested)在個體內,受試者間因子於是拿人那一層來檢定,受試者內因子拿人與時點那一層來檢定。afex 套件消除了這個風險:它接受一個明確標示受試者內與受試者間因子的單一公式,預設套用 Greenhouse-Geisser,回傳廣義 \(\eta^2\),並強制使用第三類型平方和(Type III sums of squares),與多因子設計保持一致。由選單式軟體轉過來的讀者會發現,它的輸出直接對應得上自己熟悉的一般線性模型重複測量表格,包括球形與修正那幾列。
11.9 解讀與報告結果
重複測量的結果報告時要有修正後的自由度、一個廣義的效果量,以及把交互作用定位的後續分析。這項試驗的示範段落可以這樣寫:「以組別為受試者間因子、週次為受試者內因子的 \(2 \times 4\) 混合變異數分析,在第 0、3、6、9 週資料完整的 \(150\) 位病人上進行。所有受試者內檢定均套用 Greenhouse-Geisser 修正(\(\varepsilon = .93\))。週次的主要效果顯著,\(F(2.8, 414) = 152.0\),\(p < .001\),廣義 \(\eta^2 = .24\);組別與週次的交互作用亦顯著,\(F(2.8, 414) = 17.7\),\(p < .001\),廣義 \(\eta^2 = .04\)。趨勢分析顯示組內的改變以線性為主。單純主要效果檢定指出兩組在基線並無差異,之後逐步拉開,實驗組改善較多。」修正後的自由度、報告出來的 \(\varepsilon\)、廣義效果量,以及交互作用的分解,四者俱在;下面的陷阱方塊收錄了這樣的報告所避開的錯誤。
常見陷阱 • 重複測量分析的四個錯誤
第一,先檢定再修正:跑 Mauchly 檢定、只在它顯著時才修正,會膨脹第一類型錯誤,因為那個檢定的檢定力不足;請預設就修正。第二,跨設計比較淨 \(\eta^2\):拿受試者內的淨 \(\eta^2\) 去和受試者間的比並不成立,兩者的分母不同;為了可比性,請報告廣義 \(\eta^2\)。第三,交叉型交互作用下的主要效果:剖面線交叉時,主要效果是在把方向相反的單純主要效果平均掉,可能毫無意義甚至誤導;請先解讀交互作用。第四,無視對抗平衡:實驗性的重複測量設計裡把順序當成無關緊要,會使延續效果與時點效果混淆;請作對抗平衡,最好還檢定順序效果。
11.10 常見的迷思
關於重複量數變異數分析,有幾種說法會誤導讀者。第一種是Greenhouse-Geisser 修正偏保守,所以 Mauchly 檢定不顯著時可以跳過;球形成立時這個修正幾乎不花代價,球形不成立時它不可或缺,憑一個檢定力不足的檢定跳過它,正是本章要避開的那種膨脹。第二種是 MANOVA 是單變量取向的現代替代品;兩者各有所長,在心理學常見的小樣本下,修正後的單變量檢定往往更有檢定力。第三種是組別與時間的交互作用顯著,就表示治療在每一個波次都有效;交互作用只說了兩組的改變不同,要定位在哪裡有效得靠單純主要效果。第四種是重複量數變異數分析與混合模型是互相對立的哲學;前者是後者的一個受限特例,兩者之間的取捨是實務問題,不是意識形態問題。還有一個反覆被問到的問題:各組人數不等會不會有問題。對受試者間因子而言,答案讓人放心,它容得下不平衡;對受試者內因子而言,答案很尖銳,真正的難處不是各組人數不等,而是時點的遺漏,那是這個設計根本容納不了的。
本章摘要
重複量數變異數分析把變異數分割開來,讓穩定的個別差異移出誤差項(圖 11.1),這是它檢定力的來源;期望均方同時揭示,它是一個受限的混合模型。它能否成立取決於球形,也就是所有成對差異的變異數相等,而縱貫資料以自我迴歸結構違反了這一點(圖 11.2)。無視這項違反會膨脹第一類型錯誤(圖 11.3),所以 Greenhouse-Geisser 或 Huynh-Feldt 修正是預設套用的,不取決於 Mauchly 那個檢定力不足的檢定。正交多項式對比把時點效果分割成可解讀、又不受球形牽制的趨勢(圖 11.4、11.5),它們就是固定效果成長曲線的雛形。混合因子設計裡,組別與時間的交互作用是治療效果的檢定(圖 11.6),再由單純主要效果分解、定位兩組在何處分開(圖 11.7)。多變量取向與它的剖面分析形式避開了球形假設,代價是損失一些檢定力(圖 11.8);為了跨設計的可比性,要報告的是廣義 \(\eta^2\) 而不是淨 \(\eta^2\)。五項結構限制,即整列刪除、類別化的時間、沒有隨機斜率、僵硬的共變數菜單,以及放不進時間變動共變項,是被示範出來而不是被宣稱的(圖 11.9),每一項都對應到混合模型的一項能力(表 11.5),那正是下一部所要開展的。
接下來讀哪裡
那張翻譯表就是通往第四部的門。第 12 章提供另一條繞過共變數假設的路線,也就是廣義估計方程(generalized estimating equations, GEE):它為平均軌跡建模,把個體內的相關當成一項干擾項(nuisance)來處理。第 13 章與第 14 章開展表 11.5所預告的混合模型,把變異數分析表現不出來的隨機斜率、彈性的共變數結構、每個人各自不同的時間與時間變動共變項一一還原,並以概似(likelihood)而不是刪除來處理不完整的資料。本章的趨勢分析會在第 19 章成為潛在成長模型,屆時此處用來描述平均軌跡的那條多項式,會變成一條帶有估計出來的個體間變異數的曲線。要帶走的教訓是:重複量數變異數分析不是錯,而是窄,在它的假設之內精確,在假設之外沉默;一般模型就是同一個想法,只是解開了本章所點明的那些束縛。
習題
- 11.1 手算分解。就所提供的八人、三時點資料集,用手算出個體間、時點與誤差的平方和,組成 \(F\) 比值,再拿
aov驗證。 - 11.2 延伸模擬。在圖 11.3的第一類型錯誤模擬中再加入一個自我迴歸強度,報告未修正、Greenhouse-Geisser 與 Huynh-Feldt 三種檢定的實徵拒絕率。
- 11.3 一次完整的混合分析。就所提供的兩組、四時點資料集,作帶修正的混合分析,把交互作用分解成單純主要效果與趨勢,報告廣義 \(\eta^2\),並寫出結果段落。
- 11.4 調和兩種取向。用修正後的單變量取向與多變量剖面取向分析同一批資料,再以樣本大小與球形為線索,解釋兩者結論上的任何差異。
- 11.5 診斷並重新設定。找一篇已發表的重複測量分析,判斷五項限制中哪幾項真的咬住了它,並寫出能解除這些限制的混合模型設定,作為通往第 13 章的橋。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 球形 | sphericity | 所有成對差異的變異數相等;第 11.2 節 |
| 複合對稱 | compound symmetry | 變異數相等且共變數相等的共變數形式;第 11.2 節 |
| epsilon | epsilon (\(\varepsilon\)) | 偏離球形的程度,介於 \(1/(k-1)\) 與 \(1\) 之間;第 11.2 節 |
| Greenhouse-Geisser 修正 | Greenhouse-Geisser correction | 把兩個自由度都乘上 \(\varepsilon\);略偏保守;第 11.2 節 |
| Huynh-Feldt 修正 | Huynh-Feldt correction | 偏誤較小的 \(\varepsilon\) 估計式;第 11.2 節 |
| Mauchly 球形檢定 | Mauchly’s test of sphericity | 檢定力不足,不宜用來決定要不要修正;第 11.2 節 |
| 期望均方 | expected mean squares | 證成 \(F\) 比值該拿哪一項當分母;第 11.1 節 |
| 正交多項式對比 | orthogonal polynomial contrasts | 把時點效果分割成線性、二次等趨勢;第 11.3 節 |
| 趨勢分析 | trend analysis | 以多項式對比描述改變的形狀;第 11.3 節 |
| 混合因子設計 | mixed factorial design | 受試者間因子與受試者內因子交叉;第 11.4 節 |
| 組別與時間的交互作用 | group-by-time interaction | 兩組是否有不同的改變;治療效果的正式檢定;第 11.4 節 |
| 單純主要效果 | simple effects | 在某一個時點之內檢定組別差異,用以定位交互作用;第 11.4 節 |
| 誤差層 | error stratum | 每一個效果各自該用的誤差項;第 11.4 節 |
| 順序效果 | order effects | 實驗設計中因施測次序造成的效果,須以對抗平衡控制;第 11.4 節 |
| 多變量變異數分析 | multivariate analysis of variance (MANOVA) | 把 \(k\) 個時點當成 \(k\) 維結果變項,不假設球形;第 11.5 節 |
| 剖面分析 | profile analysis | 對組別剖面線問平行性、水準與平坦性;第 11.5 節 |
| 淨 \(\eta^2\) | partial eta-squared | 分母只含該效果與它自己的誤差;跨設計不可比;第 11.6 節 |
| 廣義 \(\eta^2\) | generalized eta-squared | 分母含個體間與誤差的變異數;跨設計可比;第 11.6 節 |
| 時間變動共變項 | time-varying covariate | 本身隨時點改變的預測變項;重複測量設計放不進去;第 11.7 節 |
參考文獻
Algina, J., & Keselman, H. J. (1997). Detecting repeated measures effects with univariate and multivariate statistics. Psychological Methods, 2(2), 208–218. https://doi.org/10.1037/1082-989X.2.2.208
Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707
Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786
Davidson, M. L. (1972). Univariate versus multivariate tests in repeated-measures experiments. Psychological Bulletin, 77(6), 446–452. https://doi.org/10.1037/h0032674
Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731915
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
O’Brien, R. G., & Kaiser, M. K. (1985). MANOVA method for analyzing repeated measures designs: An extensive primer. Psychological Bulletin, 97(2), 316–333. https://doi.org/10.1037/0033-2909.97.2.316
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。