第 5 章
重複測量資料的整備與管理
這一章最能替你省下時間,也最不容易替你換到引用次數。從原始資料匯出檔到一個配適完成的模型,中間橫著一段不起眼的工作:重整形狀、對齊時間、合併、篩檢、衍生新變項。已發表的論文很少寫這一段,它卻經常實質改變結果。這裡做的決定不是科學開始之前的雜務,而是分析上的選擇,值得與模型設定一樣被記錄、被辯護。
學習目標
讀完本章之後,你應該能夠:(1) 在寬格式(wide)與長格式(long)之間轉換,並說明哪一類模型要用哪一種格式;(2) 建立有原則的時間變項,包括波次、研究天數、日曆時間、事件時間與年齡,並針對研究問題說明為什麼這樣選;(3) 用有紀律的鍵值衛生(key hygiene)與合併驗證,把多波、多來源的資料合起來;(4) 計算配合度(compliance)指標,並產出一份配合度報告;(5) 由作答時間與同答串(invariant response strings)偵測密集資料中的隨意或無效作答;(6) 正確建構個體內的延宕變項,包括要不要跨過夜間間隔;(7) 把資料集與資料編碼簿(codebook)打包封存。
5.1 重複測量資料的形狀
重複測量資料有兩種標準形狀,另有一種非正式的形狀。寬格式(wide)是每個人佔一列,重複測量橫向展開成多欄,一個時點一欄。長格式(long)是每個人在每個時點各貢獻一列,結果變項只佔一個欄位,由個體識別碼與時間變項共同索引。第三種是非正式的資料流清單(list of streams),出現在密集與多來源研究裡:自陳、生理與被動感測各以不同的時鐘取樣、各存成一個檔案,日後才對齊。圖 5.1把同樣三個人分別以寬格式與長格式呈現。本書可直接分析的標準結構是長格式,一列一個「人乘時點」,因為多層次模型(multilevel model)與大多數現代軟體都預期這種形狀。表 5.1列出哪一族模型要用哪一種形狀。
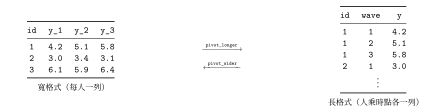
註:寬格式每人一列,時點分放各欄;長格式則是一列一個「人乘時點」。兩者之間的轉換由 tidyverse 的動詞 pivot_longer 與 pivot_wider 負責。
兩個方向的轉換各只要一行。下面這組慣用寫法涵蓋了縱貫資料重整的大部分情形:明確替時點變項命名,並去掉欄位名稱的前綴,讓時間索引保持乾淨。
library(tidyverse)
# 寬轉長:一列一個「人乘時點」(供多層次模型、GEE、繪圖使用)
long <- wide
  pivot_longer(cols = starts_with("y_"), names_to = "wave",
               names_prefix = "y_", values_to = "y")
  mutate(wave = as.integer(wave))

# 長轉寬:供重複量數變異數分析,以及部分 SEM 設定慣用的寬格式
wide <- long
pivot_wider(names_from = wave, values_from = y, names_prefix = "y_")每個時點測了好幾份量表時,寬格式的欄位名稱同時編碼兩件事:變項與波次。pivot_longer 的 names_pattern 可以把兩者分開,例如把 na_w1, pa_w1, na_w2, ... 轉成一張長表,na 與 pa 各自成欄,並以波次索引。全書的內部慣例是:變項名稱用 snake_case;個體識別碼用穩定的整數或字串,命名為 id 或 person;寬格式欄位以 var_wave 為後綴。慣例定下來,重整就成了機械化的動作,不必每次臨場發揮。
表 5.1 各族模型分別預期哪一種資料形狀。
| 模型家族 | 形狀 | 說明 |
|---|---|---|
| 重複量數變異數分析(ANOVA)/ 多變量變異數分析(MANOVA) | 寬格式 | 每人一列;時點放在各欄 |
| 多層次/混合模型(第 13、23 章) | 長格式 | 一列一個「人乘時點」 |
| 廣義估計方程(generalized estimating equations, GEE)(第 12 章) | 長格式 | 長格式,並帶有個體的群集識別碼 |
| 結構方程(structural equation modeling, SEM)/潛在成長(第 19 章) | 寬格式\(^{a}\) | 古典 SEM 用寬格式;部分軟體現已接受長格式 |
| 繪圖(ggplot2) | 長格式 | 圖形文法(grammar of graphics)把長格式的欄位對應到視覺屬性(aesthetics) |
註:\(^{a}\)lavaan 的潛在成長模型慣例上讀寬格式(每個時點一欄)。請保留一份長格式的主檔,需要時再轉成寬格式,不要反過來。
5.2 時間是一個你建構出來的變項
時間索引不是資料給你的,是你建構出來的;而這個建構,是一個偽裝成資料清理的模型決定。同一批觀察至少可以用五種時鐘索引,每一種回答的問題都不一樣。波次(wave)把各次評量當成等距的整數來數,方便,卻對真實的間距完全不置一詞。時鐘時間(clock time)記的是日曆上的日期與一天中的時刻。研究時間(study time)數的是自收案以來的天數。事件時間(event time)數的是相對於某個有意義事件的時間,例如一次戒菸嘗試、一次診斷、一次喪親。發展時間(developmental time)就是年齡。圖 5.2把一位參與者在戒菸研究中的渴求評分,分別放在五種時鐘上作圖。對著波次看,那個急遽的下降顯得平緩;對著時鐘時間看,它只是毫無意義的雜訊;對著研究天數、尤其是對著「距戒菸日的天數」看,這個下降就與造成它的那個事件對齊了。時鐘選得與歷程相配,你才看得見這個現象,否則等於把它藏起來;同樣的選擇會在第 14 章的成長模型中再度成為核心決定。表 5.2是一份建構指南。
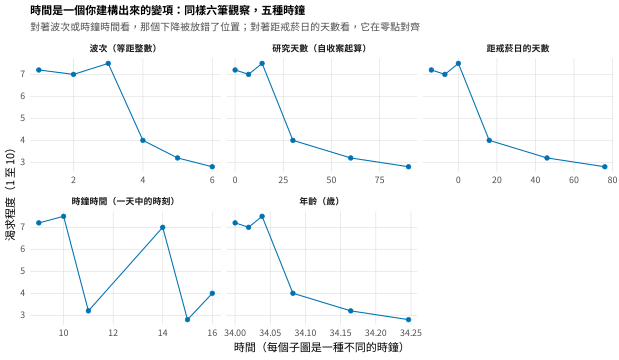
註:一位參與者在戒菸研究中的渴求評分,分別對波次、研究天數、距戒菸日的天數、時鐘時間與年齡作圖。時鐘選了哪一種,決定變化會不會與它的成因對齊。請把每一種時鐘都留在資料裡;清理時一種都不要丟掉。
密集設計另有自己的計時風險。提示編號(beep number),也就是一天中的第幾次訊號提示,並不是時戳(timestamp):兩個人的「當天第三次提示」落在不同的時刻。作答也可能在提示送出好幾分鐘之後才抵達,所以預定時間與實際作答時間都要記錄下來,兩者之間的延遲,也就是作答延遲(response latency),同樣要當成資料保留(下文用它篩檢隨意作答,第 27 章用它餵給連續時間模型)。碰上作息會到午夜之後的受試族群,「一天」怎麼定義是一個必須做的決定:以凌晨三點為切點,多半能把深夜的作答歸到正確的那一天。時區(time zone)與日光節約時間(daylight saving time)不是吹毛求疵,是真正的錯誤來源:研究橫跨時制變更,或某一台裝置以不同時區匯出,只要時戳沒有以具時區意識的方式解析,觀察的順序就會被默默弄錯。紀律是:用 lubridate 明確指定時區解析每一個時戳,排序之前先把一切轉換到單一的研究時鐘上。下面的程式碼是這條紀律的範本:原始匯出檔 affect_ema_raw 的 tz 欄實際記載的是 Asia/Seoul(\(7{,}340\) 列)與 UTC(\(34\) 列),而那 \(34\) 列的 response_ts 減 scheduled_ts 已經等於 latency_sec,時戳字串本身並未偏移,照著 tz 欄的標籤逕行換算,製造出來的才是八小時的錯置。
library(lubridate)
# 具時區意識的解析;那位換過手機的參與者,其資料是以 UTC 匯出的。
tz_study <- "Asia/Taipei"
resp <- ymd_hms(raw$response_ts, tz = tz_study)
utc  <- raw$tz == "UTC"
# 轉到研究時鐘
resp[utc] <- with_tz(force_tz(resp[utc], "UTC"), tz_study)
raw$latency_sec <- as.numeric(
resp - ymd_hms(raw$scheduled_ts, tz = tz_study))譯註:英文版此處的研究時區是 Asia/Seoul(UTC\(+\)9),下文因此說時戳會「錯置九小時」。中文版改為 Asia/Taipei(UTC\(+\)8),讓程式碼對台灣讀者可以直接套用,錯置的時數隨之改為八小時。affect_ema 是模擬資料,並不是台灣資料。
表 5.2 建構時間變項:五種時鐘,以及它們各自服務的問題。
| 時鐘 | 定義 | 它服務的問題 |
|---|---|---|
| 波次 | 評量的次序編號(1、2、3……) | 間距相等或間距無關緊要時的時點效果 |
| 研究時間 | 自收案起算的天數 | 以研究方案為索引的變化 |
| 時鐘/日曆時間 | 日期與一天中的時刻 | 日內節律與星期效果;排序 |
| 事件時間 | 距某個事件之前或之後的時間 | 由某個成因所組織的變化(戒菸日、發病) |
| 發展時間 | 年齡 | 橫跨生命全程的成長與老化 |
註:請在分析檔中同時建立並保留好幾種時鐘。即使分析用的是波次,也要記錄確切的作答時戳(time_actual),因為後續的連續時間模型(第 27 章)需要真實的間距。
5.3 合併與驗證
縱貫資料的合併是無聲錯誤進場的地方:鍵值對不上不會報錯,只會安靜地把列丟掉或複製出來。紀律是合併之前先稽核。anti_join 傳回的是「在第一張表裡有、在第二張表裡找不到對應」的那些列,先跑它,就能趕在 left_join 之前把孤立記錄(orphaned records)揪出來;這些列會被補成遺漏值還是整列丟掉,要看合併的方向。對鍵值做一次計數,則能在重複鍵值把資料列變多之前先發現它們。圖 5.3呈現這個迴圈。多波研究更難處理,因為變項名稱會跨波漂移:第一波叫 ach 的成就欄位,到第四波變成 score。漂移的不只是成就欄位:識別碼欄位跨波寫成 ID、id、Child、id,後果嚴重得多,因為天真的 left_join 只接得上欄名恰好相同的第二與第四波,整個三年級的 \(400\) 列會就此無聲消失,而不只是讓某一欄變成遺漏值。更名的對應關係應該以資料的形式保存,也就是一張新舊名稱的小表,而不是散落在程式碼各處、無從檢查。
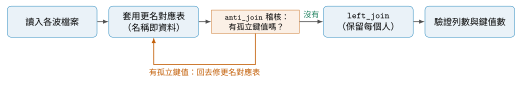
註:在 left_join 之前先跑一次 anti_join,可以把原本會被默默丟掉的鍵值浮現出來。合併時要保留每一位參與者(流失留到分析階段處理,見第 6 章),因此 left_join 要以名冊為左表,才會保住所有記錄。
# 更名對應表以資料形式保存,逐波套用,合併前先稽核。
orphans <- anti_join(waves, roster, by = "child_id")   # 合併「之前」先稽核
stopifnot(nrow(orphans) == 0)                          # 要大聲失敗
dup_keys <- waves
stopifnot(nrow(dup_keys) == 0)
long <- left_join(roster, waves, by = "child_id") # 保留每一個孩子多來源的對齊,也就是把自陳資料接上活動記錄儀(actigraphy)資料或生理訊號,另有一個問題:各條資料流以不同的時鐘取樣,幾乎不會落在同一個瞬間。可用的工具有兩類:帶明確容許時窗(tolerance window)的最近時戳合併(nearest-timestamp join)(例如把每一筆自陳配到五分鐘以內的感測器讀值),以及重新取樣或聚合。每一項都要當成一個決定記錄下來,不要默默執行。一貫的規則是:任何可能丟掉或複製資料列的操作,前面都要有一道會大聲失敗的稽核。
5.4 密集資料的篩檢
密集資料要針對兩個不同的問題篩檢:提示有沒有被回答,以及回答能不能被信任。配合度(compliance)是已完成提示對預定提示的比例,首要規則是「先看它,再摘要它」,因為一個百分比會把真正要緊的型態藏起來。圖 5.4是本書經驗取樣研究的配合度熱圖:每一格是一個「人乘日」,以有效作答次數上色,各人依總配合度排序。這張圖讓平均數藏起來的東西現形:低配合度集中在特定幾個人身上,而且隨著研究進行逐步下滑。這個型態對遺漏資料的建模有直接後果(第 6 章)。圖中這項研究的整體配合度為 \(72.8\%\),每人配合度的中位數為 \(73\%\),範圍由 \(58\%\) 到 \(85\%\)。
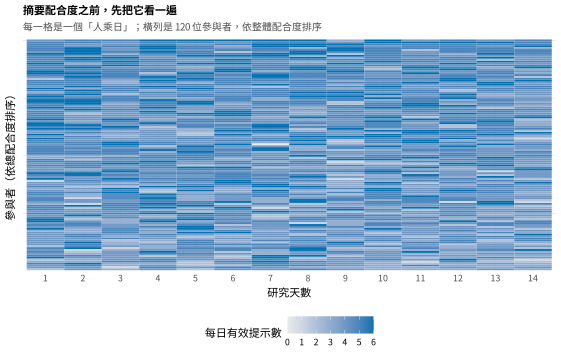
註:每一格是 affect_ema 研究中的一個「人乘日」,以有效作答次數上色(每日預定六次)。橫列是 120 位參與者,依總配合度排序。威脅推論的是型態,不是整體百分比。
回答能不能被信任,就是隨意作答(careless responding)的問題。密集設計提示很多、每一次的份量又輕,特別容易出現。有三種特徵不必靠特殊套件就偵測得到。第一是極速完成:幾秒之內就送出的作答,不可能反映真正的思索。第二是同答串(invariant response string),也就是一次提示中所有題目都選同一個值,即直線作答(straight-lining);捕捉它的指標是最長同答串(longstring),也就是同一次提示中連續各題作答相同的最長串長,而一段橫跨相反效價(valence)題目的同答串(負向情緒題與正向情緒題都選了同一個值),是很強的訊號。第三是不可能的順序與超出量尺範圍的數值。圖 5.5是同一項研究的篩檢儀表板:左邊是作答時間的分配圖,標出過快與超出時限的區域;右邊是最長同答串的分配圖,把直線作答的個案標示出來。套用這些篩檢之後,\(7{,}342\) 筆作答中標記出 \(45\) 筆超出時限的作答與 \(26\) 筆隨意作答。
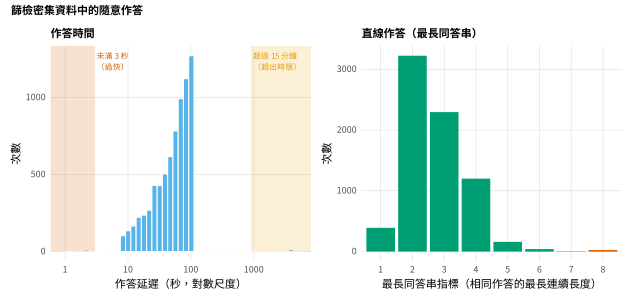
註:左:作答延遲的分配(對數尺度),標出未滿三秒(過快)與超過十五分鐘(超出時限)的區域。右:最長同答串指標的分配,直線作答(連續八題以上相同)者以紅色標示。
篩檢的首要原則是標記,而不是刪除(flag, not drop)。每一道篩檢都在資料上加一個布林欄位,不刪掉任何一列;決定排除什麼的因此是分析腳本,不是清理腳本,而「納入與排除被標記個案各做一次」的敏感度分析也就只是改一行的事。排除規則應該盡可能預先註冊,並報告它的後果。表 5.3是篩檢檢核表。
表 5.3 密集縱貫資料的篩檢檢核表。
| 問題 | 偵測方式 | 處置(標記,不要默默刪除) |
|---|---|---|
| 未作答 | 已完成對預定的提示數 | 計算配合度;把型態畫出來;預先註冊排除規則 |
| 極速完成 | 作答延遲低於門檻(例如 \(<3\) 秒) | 標記;報告納入與排除各一次的敏感度 |
| 直線作答 | 最長同答串指標(longstring),即相同作答的連續長度 | 標記;橫跨相反效價題目的同答串具決定性 |
| 超出時限的作答 | 延遲超過作答時限 | 標記;考慮改用以時戳為基礎的分析 |
| 超出範圍/不可能值 | 數值落在量尺之外;順序不可能 | 標記;追查匯出或裝置錯誤 |
| 工具漂移 | 題目措辭或編碼跨波改變 | 記錄下來;合併前先調和(harmonize)(第 3 章) |
註:每一道篩檢都寫出一個旗標欄位;由分析腳本決定排除。請報告被標記的筆數,以及排除對主要估計值的影響。
實務要點 • 換過手機的那位參與者
研究進行到一半,有一位參與者換了手機,新裝置匯出資料的方式不同:識別碼寫成純數字 7,不是補零的 P007;時戳標成 UTC,不是研究所在的當地時區;還有五筆記錄的時戳掉了「秒」。每一項差異都是一次無聲的資料損壞。純數字識別碼會在任何 group_by 裡把這個人拆成兩個人;時區標示與時戳實際所用的時鐘一旦對不上,這個人的作答就會錯置八小時,日期歸屬全盤打亂;格式不完整的時戳會解析成遺漏值而消失。這條處理流程把三者都攔了下來:識別碼標準化(as.integer(gsub("[0-9]", "", id)))把這個人重新併回一起;具時區意識的解析加上逐列核對時戳究竟落在哪一個時鐘上,把時戳留在正確的位置;一道備援的解析器救回了沒有秒數的那幾筆。這些修補在最終的資料集裡完全看不出來,正因如此,它們必須在流程腳本裡看得出來。
5.5 做對衍生變項
後續各章拿來建模的變項,多半是衍生出來的。其中兩種衍生既常見又極容易做錯,值得明講:中心化(centering)與延宕(lagging)。個人平均數(person mean),以及個人平均數中心化(person-mean centering)後的偏離值,是個體間與個體內分解(between-within decomposition)的主力(第 1、7、13、23 章),應該算一次就存起來,不要每次在行內重算。慣用寫法是分組的 mutate,它最常見的錯誤是事後忘了 ungroup:資料會一直維持分組狀態,後續每一個操作都默默以人為單位執行。
d <- d
  group_by(person)
  mutate(stress_pm = mean(stress, na.rm = TRUE),   # 個體間的部分
         stress_wd = stress - stress_pm)
  ungroup()                                        # <- 千萬別忘了這一行
延宕更細緻。密集資料裡,正確的延宕必須尊重「人」的邊界,往往還要尊重「日」的邊界。沒有明確排序、或跨越了不同人的延宕,會默默把某個人的第一筆觀察配上另一個人的最後一筆。即使在同一個人之內,做日誌分析的人也得決定:一天中的第一次提示,要延宕到前一晚的最後一次提示,還是重新開始?圖 5.6所示的夜間間隔(night gap)是實質選擇,不是技術細節:跨夜的延宕等於主張某個狀態能持續穿過睡眠。安全的慣用寫法是先明確排序,再依人分組(要日內延宕就再依日分組),最後才套用 lag。
d <- d
  arrange(person, day, beep)
  group_by(person, day)
  mutate(na_lag1 = lag(na))
  ungroup()
# 若要「會」跨夜的延宕,只依 person 分組,並記錄間距讓那道間隔看得見:
# mutate(interval = as.numeric(t - lag(t)))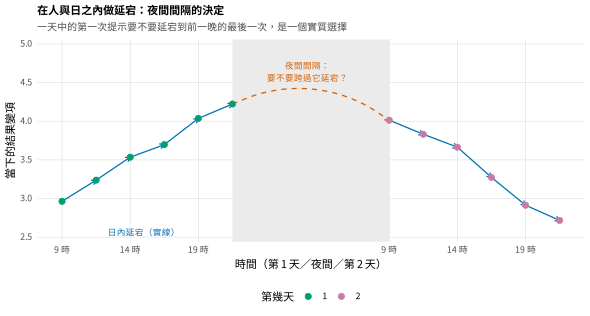
註:跨越兩天的當下觀察。實線箭頭是日內延宕;跨過灰底夜間區域的虛線箭頭,則是分析者必須明確做出的決定:某個狀態要不要延宕跨過整夜的間隔。記錄確切的間距,可以讓這道間隔一直看得見。
常見陷阱 • 三種會無聲失敗的衍生
第一,分組殘留(grouped-mutate leakage):分組的 mutate 之後忘了 ungroup(),資料就一直維持分組狀態,後面的 mutate(z = scale(x)) 會在每個人之內標準化,而不是整體標準化,而且不會有任何警告。分組操作做完就要 ungroup。第二,跨人延宕(lagging across persons):對沒有依人分組、也沒有明確排序的資料套用 lag(),會把相鄰兩個人邊界上的觀察配成一對;延宕之前一律先 arrange 再 group_by(person)。第三,在遺漏程度不同時默默平均(silent averaging over differing missingness):用 rowMeans(..., na.rm = TRUE) 算量表平均數,等於對某位受訪者平均三題、對另一位平均八題,「同一份」量表在不同列上的意義因此不同;請改為訂出並記錄一條最少題數規則。
5.6 可重現的處理流程
本章的工作應該單向流動:從一份永不修改的原始資料出發,經過清理階段,到衍生變項,再到分析。每個階段各是一支獨立的腳本,原始檔一律視為唯讀。圖 5.7呈現這條流程。原始匯出檔原封不動地封存起來,日後對某個清理決定有疑問,重跑一次流程就能回答,不必在一個已被覆寫的檔案上做考古。清理腳本產出一份中介的乾淨檔,衍生腳本再加上中心化與延宕變項,分析腳本只讀衍生檔。這樣的分離,加上一份套件版本鎖定檔(lockfile)(renv),以及在較大的專案裡改用只重跑受影響階段的流程管理器(targets),能讓「從原始資料到結果」的整條路徑被另一個人重現,也被十年後的你自己重現(第 36 章發展整套可重現性工具)。表 5.4列出資料編碼簿隨封存資料集一併提供時,至少要包含哪些內容。
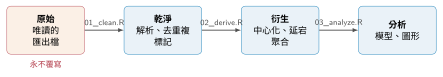
註:每一支箭頭都是一支獨立、納入版本控制(version control)的腳本。每一個階段都寫出一個新檔案,不覆寫自己的輸入。原始匯出檔原封不動地封存,下游的每一個決定才都能由它重現。
表 5.4 資料編碼簿的最低欄位,以及封存檢核表。
| 編碼簿欄位 | 封存檢核表(OSF 或其他資料庫) |
|---|---|
| 變項名稱與標籤 | 原始資料以唯讀方式封存,並註明匯出日期 |
| 型別與單位 | 每一支清理與衍生腳本,均納入版本控制 |
| 有效範圍/類別 | 資料編碼簿與資料字典(data dictionary) |
| 時間度量與原點 | 套件版本鎖定檔(renv 的 renv.lock) |
| 遺漏值代碼 | 一份說明腳本執行順序的 README |
| 衍生方式(如何算出) | 授權條款;敏感資料另附去識別化(de-identification)說明 |
註:遵循 FAIR 原則,也就是可尋(findable)、可取(accessible)、可互通(interoperable)、可再用(reusable) (Wilkinson et al., 2016),一份資料集才能被別人使用,也才能被那個已經忘光所有決定的、未來的你使用。
軟體提示 • 輔助套件與純 tidyverse 的取捨
有好幾個套件專門處理經驗取樣資料的清理,提供現成的配合度摘要、隨意作答指標與延宕建構函式。使用之前要先確認它們取得得到、也還有人維護,因為這類套件來來去去。不過本章沒有一件事非它們不可:配合度是一次 count 加一個比值,最長同答串指標是對題目欄位做一次簡短的 apply,延宕是 dplyr::lag 加上明確的排序,全都是純 tidyverse。偏好透明、相依性少的慣用寫法,一條流程多年之後才跑得動,即使某個便利套件屆時已被封存。若某個仍在維護的輔助套件確實能減少錯誤(隨意作答的偵測就有經過充分測試的實作),就用它,但要弄懂並記錄它到底算了什麼。
5.7 報告資料處理流程
資料整備寫在「方法」一節(Method section)裡。審稿人越來越期待那些會移動效果量的決定被明白寫出來,不要被埋起來。一段站得住腳的資料整備文字要交代四件事:達成的配合度以及它怎麼算的、篩檢規則以及各自標記了多少筆記錄、實際採用的排除規則及其敏感度,以及產出分析變項的那些衍生方式。針對本章這項研究的示範文字可以這樣寫:「在 \(10{,}080\) 次預定提示中,有 \(7{,}342\) 次被回答(整體配合度 \(72.8\%\);每人配合度中位數 \(73\%\),範圍 \(58\)–\(85\%\)),係由作答時戳計算而得。作答在三秒之內完成、或全部題目都選同一個值者,標記為隨意作答(\(26\) 筆,\(0.4\%\));在提示發出超過十五分鐘之後才送出的作答,標記為超出時限(\(45\) 筆,\(0.6\%\))。被標記的作答在主要分析中予以保留,並在敏感度分析中排除,結論未因此改變。個體內的偏離值以個人平均數中心化計算;延宕預測變項在『人乘日』之內建構,不跨越夜間間隔延續。」每一個子句都對應本章談過的一個決定,數字則直接來自處理流程。
5.8 常見的迷思
有四種看法會造成本來可以避免的損害。第一,認為清理是科學開始之前的事,不必記錄:排除哪些個案、用哪一種時鐘、要不要跨夜延宕,這些決定經常改變效果量;沒有記錄,它們既無法重現,也無法辯護。第二,認為長格式只是給多層次模型用的:長格式同時是現代繪圖與許多結構方程工具所預期的形狀,而一份長格式的主檔,是任何寬格式視圖的正確來源。第三,認為配合度百分比本身就是一個資料品質指標:遺漏的型態比它的比率更重要(第 6 章),這正是配合度要先被看見、再被摘要的理由。第四,針對那個常被問到的問題「清理的時候要不要順便插補?」:不要。插補是分析決定,取決於模型與遺漏機制(第 6 章);在清理階段就做,等於把一個未經檢驗的假設寫死在下游的每一次分析裡。
本章摘要
在原始匯出檔與一個配適完成的模型之間,橫著一段後果重大、也能夠被記錄下來的工作。重複測量資料有寬格式與長格式兩種形狀,本書可直接分析的形式是長格式,一列一個「人乘時點」(圖 5.1)。時間是建構出來的變項,不是直接讀出來的;在波次、研究、時鐘、事件與發展這幾種時鐘之間怎麼選,決定變化會不會與它的成因對齊(圖 5.2)。合併要在執行之前先稽核,用 anti_join 檢查、把更名對應表當成資料保存,對不上的鍵值才會大聲失敗,而不是無聲地丟掉資料列。密集資料要針對配合度篩檢(先看見、再摘要),也要針對隨意作答篩檢(標記,而不是刪除)。衍生變項,包括中心化分數與延宕,要以明確的分組與排序計算,而夜間間隔的延宕是一個實質選擇。整條路徑單向流動,從唯讀的原始資料經過乾淨與衍生階段到分析,並連同資料編碼簿一起封存,使每一個決定都能被重現。
接下來讀哪裡
本章建立的結構,下游到處要用:配合度所揭露的遺漏在第 6 章建模;第 7 至 9 章的描述性與圖形呈現讀的是長格式;中心化與延宕變項餵給第 13 章與第 23 章的多層次與動態模型;此處保留下來的確切間距,讓第 27 章的連續時間模型成為可能;封存的紀律則在第 36 章完成。本章唯一的要求是:從原始資料到結果之間的每一次轉換,都是一個要記錄、也要辯護的決定。
習題
- 5.1 建立一條處理流程。就
Examples資料中那份雜亂的三波匯出檔,產出一個可直接分析的長格式檔案與一份資料編碼簿(codebook)。請用所附的檢查項目(列數、鍵值唯一性、數值範圍)驗證你的結果。 - 5.2 三種時鐘。對你自己選定的一份資料集,建構波次、研究天數與事件時間三個變項。說明每一種時鐘各自服務什麼研究問題,並把同一個結果變項分別對三者作圖。
- 5.3 夜間間隔的延宕。在
affect_ema上實作一個日內延宕與一個跨夜延宕。在兩種規則之下各配適一個「負向情緒對自身延宕」的簡單模型,並報告自我迴歸係數有何不同。 - 5.4 寫出那一段文字。使用處理流程的輸出,依第 5.7 節為
affect_ema撰寫資料整備與配合度的段落。 - 5.5 把合併弄壞。所附的各波檔案中埋了合併錯誤(一個漂移的名稱、一個重複的鍵值、一個孤立的識別碼)。請用稽核把每一個找出來,並說明一次天真的
left_join會造成什麼後果。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 寬格式 | wide format | 每人一列、時點分列各欄;第 5.1 節 |
| 長格式 | long format | 每個「人乘時點」一列;第 5.1 節 |
| 資料流清單 | list of streams | 多來源研究中各自成檔、各有時鐘的資料流;第 5.1 節 |
| 波次 | wave | 評量的次序編號;第 5.2 節 |
| 時鐘時間 | clock time | 日期與一天中的時刻;第 5.2 節 |
| 研究時間 | study time | 自收案起算的天數;第 5.2 節 |
| 事件時間 | event time | 距某個事件的時間;第 5.2 節 |
| 發展時間 | developmental time | 以年齡為索引的時間;第 5.2 節 |
| 時戳 | timestamp | 記錄事件發生時刻的資料欄位;第 5.2 節 |
| 作答延遲 | response latency | 提示送出到作答送出之間的時間;第 5.2 節 |
| 時區 | time zone | 時戳所屬的地理時制;第 5.2 節 |
| 孤立鍵值 | orphaned key | 在另一張表中找不到對應的鍵值;第 5.3 節 |
| 更名對應表 | rename map | 以資料形式保存的新舊欄名對照;第 5.3 節 |
| 容許時窗 | tolerance window | 最近時戳合併所允許的最大時間差;第 5.3 節 |
| 配合度 | compliance | 已完成提示對預定提示的比例;第 5.4 節 |
| 配合度熱圖 | compliance heatmap | 以人乘日呈現作答次數的圖;第 5.4 節 |
| 隨意作答 | careless responding | 不加注意、無效的作答;第 5.4 節 |
| 直線作答 | straight-lining | 所有題目都選同一個值;第 5.4 節 |
| 最長同答串 | longstring | 連續相同作答的最長長度;第 5.4 節 |
| 效價 | valence | 題目的正負向性質;第 5.4 節 |
| 提示編號 | beep number | 一天中的第幾次訊號提示,不是時戳;第 5.2 節 |
| 標記,而不是刪除 | flag, not drop | 篩檢只加旗標欄位,由分析決定排除;第 5.4 節 |
| 旗標欄位 | flag column | 記錄某筆資料是否符合某條件的布林欄位;第 5.4 節 |
| 分組殘留 | grouped-mutate leakage | 忘了 ungroup 導致後續操作仍分組執行;第 5.5 節 |
| 跨人延宕 | lagging across persons | 未依人分組即延宕,把相鄰兩人邊界上的觀察配成一對;第 5.5 節 |
| 默默平均 | silent averaging | 對遺漏題數不同的受訪者取平均數,使量表分數意義不一;第 5.5 節 |
| 夜間間隔 | night gap | 前一天最後一次與次日第一次提示之間的間隔;第 5.5 節 |
| 最少題數規則 | minimum-items rule | 計算量表平均數所要求的最少作答題數;第 5.5 節 |
| 唯讀 | read-only | 原始資料一律不得修改;第 5.6 節 |
| 版本鎖定檔 | lockfile | 記錄套件版本以利重現的檔案;第 5.6 節 |
| 資料字典 | data dictionary | 逐變項說明其定義與編碼的文件;第 5.6 節 |
| 去識別化 | de-identification | 移除可辨識個人身分的資訊;第 5.6 節 |
| FAIR 原則 | FAIR principles | 可尋、可取、可互通、可再用;第 5.6 節 |
參考文獻
Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989
Curran, P. G. (2016). Methods for the detection of carelessly invalid responses in survey data. Journal of Experimental Social Psychology, 66, 4–19. https://doi.org/10.1016/j.jesp.2015.07.006
Curran, P. J., & Hussong, A. M. (2009). Integrative data analysis: The simultaneous analysis of multiple data sets. Psychological Methods, 14(2), 81–100. https://doi.org/10.1037/a0015914
Meade, A. W., & Craig, S. B. (2012). Identifying careless responses in survey data. Psychological Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science: Import, tidy, transform, visualize, and model data (2nd ed.). O’Reilly Media.
Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., & Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3, Article 160018. https://doi.org/10.1038/sdata.2016.18
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。