第 15 章
類別與計數結果變項的廣義線性混合模型
第 13 章與第 14 章的線性混合模型(linear mixed model)假定結果變項(outcome)是連續的,在給定條件下也服從常態分配。心理學反覆測量的東西,有很大一部分不長這樣。一個症狀要嘛緩解(remission)要嘛沒有;臨床人員在一條有次序的量尺上評定嚴重度;日誌記錄某一天喝了幾杯、抽了幾根、吵了幾次架。這些結果變項是二元(binary)、次序(ordinal)與計數(count)。廣義線性混合模型(generalized linear mixed model)把第 13 章那套做法延伸到這類結果變項:在線性預測式與平均數之間插進一個連結函數(link function),就像廣義線性模型(generalized linear model)延伸一般迴歸那樣,同時保留使資料成為縱貫資料的隨機效果(random effects)。延伸在做法上是一小步,在解讀上不是。分析者要多扛三項連續結果變項不會出現的負擔。第一,係數活在非線性的尺度上,個體特定(subject-specific)效果與母體平均(population-averaged)效果在那裡並不相等,解讀要靠第 12 章從另一側發展出來的條件與邊際紀律。第二,概似(likelihood)不再有封閉解(closed form),估計只能仰賴積分近似,而近似準不準還得檢查。第三,計數結果變項帶著分配上的問題:過度離散(overdispersion)與零過多(excess zeros)。這兩者不是待補的瑕疵,是關於資料如何產生的理論。本章以縱貫實作範例逐一發展這三項負擔,並且從頭到尾堅持一件事:結果要報告成讀者感受得到的量,也就是預測機率(predicted probability)與比率(rate),不是光禿禿的勝算比(odds ratio)。
學習目標
讀完本章之後,你應該能夠:(1) 針對二元、次序與計數結果變項,以分配族(family)、連結函數與隨機效果結構設定廣義線性混合模型;(2) 在係數自身的尺度上把它讀成個體特定效果,與母體平均效果區分開來,並把兩者都換算成預測機率與比率;(3) 說明概似為什麼需要積分近似,區辨懲罰擬概似(penalized quasi-likelihood)、Laplace 近似與適應性 Gauss-Hermite 求積(adaptive Gauss-Hermite quadrature),並認出這個選擇何時會改變答案;(4) 以負二項(negative binomial)或觀察層次隨機效果(observation-level random effect)診斷並建模過度離散,以零膨脹(zero-inflation)或門檻(hurdle)建模零過多,並依實質理由在兩者之間抉擇;(5) 配適次序的累積 logit 混合模型(cumulative-logit mixed model),並檢查它的比例勝算假設(proportional-odds assumption);(6) 以模擬為基礎的殘差(simulation-based residual)驗證配適好的模型;(7) 把廣義線性混合模型報告到可供發表的水準,並附上可解讀的預測量。
15.1 從線性混合模型到廣義線性混合模型
廣義線性混合模型(generalized linear mixed model, GLMM)由三個部分組成,就是界定任何一個廣義線性模型的那三個部分,只是第三個部分多了隨機效果。第一個是結果變項的分配(distribution),取自指數族(exponential family):二元結果變項用 Bernoulli,次序結果變項用多項式(multinomial),計數用 Poisson 或負二項。第二個是連結函數 \(g\),把結果變項的平均數映到整條實數線上;機率用 logit、比率用對數(log),這是兩個典型(canonical)的選擇。第三個是線性預測式(linear predictor),現在同時含有固定效果與隨機效果,\(g(\mu_{it}) = \eta_{it} = \mathbf{x}_{it}'\bm{\gamma} + \mathbf{z}_{it}'\mathbf{u}_i\),其中隨機效果 \(\mathbf{u}_i \sim N(\mathbf{0}, \mathbf{T})\),與第 13 章完全相同。每週測量的二元緩解結果變項,模型就是 \(\text{logit}\,\Pr(y_{it}=1) = \gamma_{00} + \gamma_{10}\,\text{week}_{it} + u_{0i}\):在緩解的對數勝算(log-odds)上做羅吉斯成長(logistic growth),並帶著個體特定的截距。就做法而言,這離線性混合模型只有一小步;解讀上不是。表 15.1 把常見的結果變項型態與它們的分配族、連結函數以及 R 的實作對應起來。
表 15.1 依結果變項型態選擇分配族與連結函數。
| 結果變項 | 分配族 | 連結函數 | R 的實作 |
|---|---|---|---|
| 二元 | 二項(binomial) | logit | glmer(..., binomial) |
| 次序 | 累積(cumulative) | logit | clmm(ordinal 套件) |
| 計數 | Poisson | 對數 | glmer(..., poisson) |
| 過度離散的計數 | 負二項 | 對數 | glmer.nb;glmmTMB |
| 零過多的計數 | 門檻或零膨脹 | 對數 | glmmTMB |
註:分配族編碼結果變項的分配,連結函數把它的平均數映到整條實數線上。對機率與比率而言,logit 與對數是典型連結。機率單位(probit)連結把潛在殘差設為常態而非羅吉斯,是二元與次序結果變項的另一個選擇,並與第 18 章的類別測量模型相接。
二元與次序結果變項還有一個很有啟發性的等價形式:建在潛在連續變項上的閾值模型(threshold model)。設想一個觀察不到的連續傾向(propensity) \(y^{\ast}_{it} = \eta_{it} + \varepsilon_{it}\),觀察到的類別則看這個潛在變項落在一個或多個閾值(threshold)的哪一側。二元結果變項只有一個閾值:潛在傾向超過它,事件就發生。有 \(K\) 個類別的次序結果變項有 \(K-1\) 個閾值,把潛在軸切成有次序的幾段。圖 15.1 把兩者都畫了出來。這個構作不是硬套上去的虛構,它正是 logit 與機率單位連結長成那個樣子的原因:潛在殘差 \(\varepsilon\) 設為標準羅吉斯分配,得到的就是 logit 連結;設為標準常態,得到的就是機率單位連結。它同時點出一件後果很大的事實,下面會展開:潛在殘差變異數不是估計出來的,是連結函數的選擇把它固定住的,logit 連結固定在 \(\pi^2/3\)。
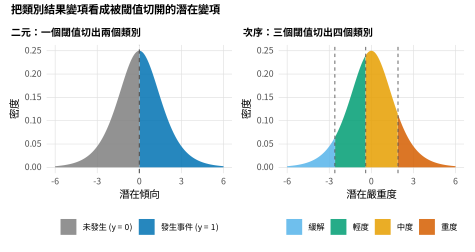
註:左:潛在傾向跨過單一閾值,二元結果變項就發生;該閾值把潛在密度分成未發生與發生兩區。右:四個類別的次序結果變項來自三個閾值,把同一條潛在密度切成有次序的幾段。logit 連結對應標準羅吉斯的潛在殘差,其變異數固定在 \(\pi^2/3\),並非估計而得。
15.1.1 條件與邊際:連結函數逼出來的解讀
連結函數是非線性的,GLMM 裡的係數因此是個體特定效果,也叫條件效果:固定住某個人的隨機效果,這個係數描述那個人的對數勝算或對數比率改變了多少。它是第 12 章廣義估計方程(generalized estimating equations, GEE)所估計的母體平均效果、也就是邊際效果的鏡像,兩者並不相等。把一群人的羅吉斯曲線平均起來,得到的不是一條斜率相同的羅吉斯曲線,而是一條比較平緩的曲線:非線性的連結函數與對隨機效果取期望值,這兩個運算的次序不能對調(do not commute)。母體平均效果相對於個體特定效果朝零衰減(attenuation),衰減的倍率隨隨機效果變異數而增大,這就是第 12 章的衰減關係從模型導向(model-based)那一側看過去的樣子。圖 15.2 在緩解資料上展示了這件事:一位典型病人的個體特定曲線與母體平均曲線並不相同,也不是誰把誰等比例縮放。配適出來的模型截距變異數很大,個人在對數勝算尺度上的標準差接近 \(2.7\),落差就相當可觀:第八週的實驗組,模型隱含的中位數病人緩解機率是 \(.05\),跨病人的母體平均機率則是 \(.18\)。
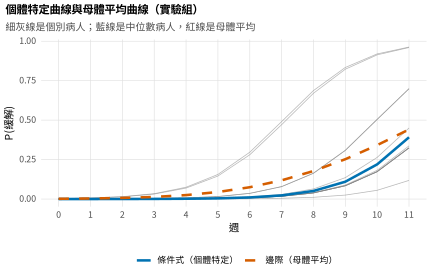
註:實驗組跨週的緩解機率預測值。細灰線是配適出來的隨機效果所隱含的個別病人,藍線是中位數病人(隨機效果為零)的個體特定軌跡,紅色虛線是跨病人的母體平均。logit 連結是非線性的,個別曲線的平均因此不是平均病人的曲線,週的母體平均效果相對於個體特定效果也是衰減的。這就是第 12 章的衰減從混合模型這一側看過去的樣子。
兩個量沒有誰才是對的,它們回答不同的問題。個體特定效果回答的是一項介入如何改變某一個人的勝算,這是理論與臨床上最感興趣的估計標的(estimand);邊際效果回答的是母體盛行率(prevalence)如何位移,這是公共衛生上最感興趣的估計標的。要求只有一個:分析者要知道手上這個數字是哪一個,並照著報告。GLMM 出來的係數是個體特定的。審查者若要母體平均效果,做法是把模型的預測機率對隨機效果的分配、以及對共變項的分配取平均,現代工具會自動處理這項計算;把係數就地改個說法並不算數。
15.1.2 為什麼羅吉斯 (logistic) 係數不能跨模型比較
潛在殘差變異數被固定住,帶來一項一再誤導人的後果。一般線性迴歸裡加入一個與既有預測變項不相關的新預測變項,既有係數不會實質改變,因為殘差變異數會自己縮小,吸收掉新解釋的那部分變異數。羅吉斯迴歸的殘差變異數縮不了,連結函數把它固定在 \(\pi^2/3\)。新的預測變項一旦解釋掉結果變項的一部分,整條潛在尺度等於被重新縮放(rescale),其他預測變項的係數也跟著改變,即使那些預測變項與新來者毫不相關 (Mood, 2010)。圖 15.3 用一個真值已知的模擬示範這件事:兩個預測變項依建構彼此獨立,第一個的真係數是 \(1.0\);只用第一個預測變項配適結果變項得到 \(0.72\),把與它正交(orthogonal)的第二個加進去之後,第一個係數回到真正的 \(1.0\)。教訓是,羅吉斯與其他 GLMM 的係數不能像線性係數那樣跨巢套(nested)模型比較,也不能跨殘差組成不同的群體比較;一個係數在加入共變項之後改變了,並不足以構成混淆(confounding)或中介(mediation)的證據。因應的做法是比較預測機率或平均邊際效果(average marginal effect),不是比較係數,或者改用專為這個問題發展、對重新縮放穩健的方法。
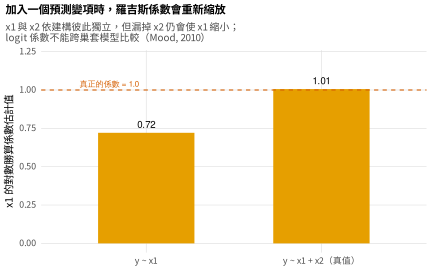
註:一個真值已知的模擬,兩個預測變項彼此獨立,第一個的真係數是 \(1.0\)。只用第一個預測變項迴歸二元結果變項會低估為 \(0.72\);把正交的第二個加進去之後,係數回到真值。潛在殘差變異數固定在 \(\pi^2/3\),羅吉斯係數因此不像一般迴歸係數那樣可以跨巢套模型比較 (Mood, 2010)。
15.2 估計:沒有封閉解的積分
GLMM 的概似要把隨機效果從聯合密度中積分掉,而非線性連結之下這個積分沒有封閉解。每一個群集貢獻一個因子 \(\int \prod_t f(y_{it}\mid \mathbf{u}_i)\,\phi(\mathbf{u}_i)\,d\mathbf{u}_i\):一堆非常態密度的乘積,乘上常態的隨機效果密度,沒有反導函數(antiderivative)。估計只能建立在近似這個積分之上,而決定一項分析成不成功的,往往是那個近似,不是模型本身。實務上有三種方法。懲罰擬概似(penalized quasi-likelihood, PQL)在當前估計值附近把模型線性化,速度快,但對二元與低計數的結果變項偏誤嚴重,固定效果與變異數成分都會低估,該當成歷史遺留的方法看待,不是預設值 (Breslow & Clayton, 1993)。Laplace 近似(Laplace approximation)把被積函數換成在其眾數(mode)處吻合的高斯函數,是現代軟體的主力預設值,對多數設計準確度足夠。適應性 Gauss-Hermite 求積(adaptive Gauss-Hermite quadrature, AGQ)在眾數附近適應性地布下若干節點來計算積分,節點數增加會收斂到確切的概似,代價是速度,以及常見實作把它限制在單一個純量(scalar)隨機效果。表 15.2 摘要了這些選擇。
表 15.2 廣義線性混合模型的積分近似方法。
| 方法 | 何時夠用 | 軟體 |
|---|---|---|
| 懲罰擬概似 | 計數大、群集大;二元結果變項應避免 | MASS::glmmPQL |
| Laplace | 多數設計;實務上的預設值 | glmer、glmmTMB |
| 適應性 Gauss-Hermite | 二元或稀疏結果變項、群集小、變異數大 | glmer(nAGQ)、GLMMadaptive |
| 貝氏(MCMC) | 複雜隨機結構、完全分離、小樣本 | brms、MCMCglmm(第 17 章) |
註:這些方法以速度換準確度。懲罰擬概似最快也最不準;適應性求積對困難的情形最準,但多數實作把它限制在單一個純量隨機效果。設計很棘手時,貝氏配適(第 17 章)是穩健的退路。
這個選擇最要緊的地方,正是縱貫心理學常常在操作的地帶:二元結果變項、時點不多、個體間變異數可觀。圖 15.4 顯示兩者在緩解模型上的分歧,這個模型的截距變異數很大。Laplace 近似把截距放在對數勝算尺度上的 \(-5.22\)、截距標準差放在 \(2.67\),十五點的適應性求積則把它們移到 \(-4.88\) 與 \(2.34\)。主要感興趣的固定效果,也就是週的斜率、以及治療和週的交互作用,比較穩定;但截距與變異數成分位移的幅度,對任何關於基線機率或個體間異質性(heterogeneity)的陳述都已經夠大。實務上的守則是:先用 Laplace 配適,結果變項為二元而且變異數可觀時,再用幾個等級的適應性求積確認。估計值有實質改變就是訊號,表示該採用求積的估計值;最棘手的情形則該轉向第 17 章的貝氏估計。
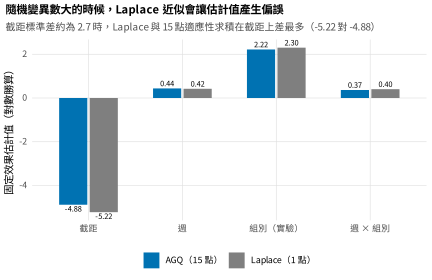
註:二元緩解模型的固定效果估計值,分別出自 Laplace 近似(一個求積節點)與十五點適應性 Gauss-Hermite 求積。截距標準差在對數勝算尺度上接近 \(2.7\) 時,兩種方法在截距上差最多,Laplace 近似把它放得離零更遠;斜率與交互作用比較穩定。個體間變異數大的二元結果變項,適應性求積是比較準確的方法。
基礎概念 • 衰減倍率與適應性求積
母體平均與個體特定的羅吉斯斜率之間,有一個相當好的近似關係 \(\bm{\gamma}_{\text{邊際}} \approx \bm{\gamma}_{\text{個體特定}} / \sqrt{1 + c^2\,\tau^2}\),其中 \(c = 16\sqrt{3}/(15\pi)\),\(\tau^2\) 是隨機截距變異數;第 12 章導出的是同一個式子。\(\tau^2\) 越大,邊際效果就越往零縮,個體特定效果不變。圖 15.2 的兩條曲線在結果變項越異質時分歧越大,原因就在這裡。適應性 Gauss-Hermite 求積把群集的概似近似成 \(\int f(\mathbf{y}_i\mid u)\phi(u)\,du \approx \sum_{q=1}^{Q} w_q\, f(\mathbf{y}_i\mid a_q)\),在 \(Q\) 個節點 \(a_q\) 上計算被積函數。這些節點適應性地落在被積函數的眾數附近,不是落在固定位置,所以少數幾個放對地方的節點,就能解析固定節點求積要用多得多節點才處理得了的積分。Laplace 近似是 \(Q=1\) 的特例。
15.3 二元與次序結果變項
15.3.1 二元結果變項
二元緩解模型以緩解對數勝算上的羅吉斯成長來配適,結果則要一路從係數的尺度走到讀者感受得到的尺度。時間中心化在第八週。選這個位置,是因為沒有病人在基線就緩解,截距放在那裡會不可識別(unidentified),正是第 14 章關於原點的那一課。治療與週的交互作用在對數勝算尺度上是 \(0.40\),取指數之後,是實驗組在緩解勝算成長上每週約 \(1.5\) 的勝算比優勢。但勝算比是很差的溝通載體,交付品是預測機率軌跡。圖 15.5 畫出兩組在整個研究期間模型隱含的緩解機率,並疊上觀察到的每週緩解率;傳達研究發現的是這張圖,不是係數表。緩解在前幾週稀少,兩組也相近,之後在實驗組陡升,到第十一週逼近二分之一,控制組則遠遠跟不上。個體間異質性由潛在尺度的組內相關(latent-scale intraclass correlation)摘要,算法是 \(\tau_{00}/(\tau_{00}+\pi^2/3)\),因為第一層變異數就是被固定住的 \(\pi^2/3\)。這裡它是 \(.68\),表示緩解傾向的變異數大部分穩定地落在病人之間。
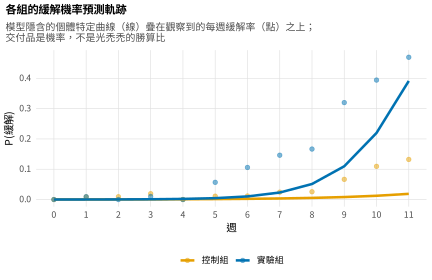
註:各組模型隱含的個體特定緩解機率(線),疊在觀察到的每週緩解率(點)之上。緩解在早期稀少,兩組也相當,之後在實驗組陡升。二元縱貫分析的交付品是這樣一條機率軌跡,不是一個勝算比。
15.3.2 次序結果變項
次序結果變項,例如臨床人員四個等級的嚴重度評定,以累積 logit 混合模型(cumulative-logit mixed model)建模,把 logit 連結套用在「落在某類別或更低類別」的累積機率上。模型有一組斜率與 \(K-1\) 個閾值,定義性的限制是比例勝算假設(proportional-odds assumption):一個預測變項在每一個閾值上,位移「落在更高類別」勝算的量都相同,單一個斜率就足以應付所有的類別邊界。嚴重度資料配上一個屬於個人的隨機截距,週的斜率在累積 logit 尺度上是 \(-0.47\),也就是每過一週,落在更嚴重類別的勝算乘以大約 \(0.63\),治療的斜率再加上一份減幅。圖 15.6 把配適好的模型畫成隨時間變化的類別機率預測值,讀起來就清楚了:療程推進,機率質量從重度與中度流出,累積到輕度與緩解。比例勝算假設要檢查,不能逕自假定,做法是檢定「在每個閾值各給一個斜率」會不會改善配適。違反時的補救不是放棄這個模型,而是放鬆它:讓那個違規的預測變項享有部分或完全不成比例的效果,或者誠實地把稀疏的相鄰類別合併。沒有次序的名義(nominal)結果變項要改用多項式混合模型,專門的套件都有提供;但次序確實存在時,丟掉次序會賠上檢定力與可解讀性。
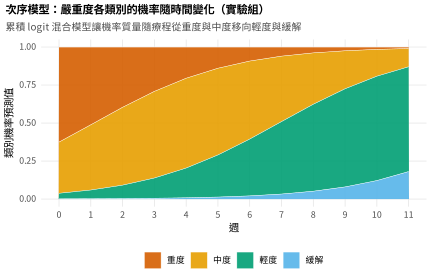
註:由累積 logit 混合模型算出的實驗組四個嚴重度類別跨週的機率預測值。堆疊的面積顯示機率質量在整個研究期間由重度與中度移向輕度與緩解。這個模型假定比例勝算:每個預測變項在每一個類別邊界上位移勝算的量都相同。這項假定必須檢定。
15.4 計數結果變項
計數,也就是隨身研究(ambulatory study)蒐集到的行為日計次,以對數連結配上計數分配來建模。它們帶來兩個連續結果變項不會有的問題:變異數會不會超過基準分配所容許的範圍,以及零出現的頻率會不會高於基準分配所預測的。貫串本節的例子是一份模擬的每日日誌資料 ema_drinks,資料生成歷程(data-generating process)已知,測量橫跨十四天,每天清醒的時數不等。
基準模型是 Poisson 混合模型,\(\log \mathbb{E}(y_{it}) = \eta_{it} + \log(\text{曝險}_{it})\),其中 \(\log(\text{曝險})\) 那一項是偏移項(offset):一個係數固定為一的預測變項,把模型從計數轉換成比率,長度不等的觀察窗因此也算了進去。只要觀察窗會變動,為「每清醒小時喝幾杯」建模、而不是為原始杯數建模,就很要緊;真實的日誌裡,日與日之間的長度與完整程度本來就不一樣。Poisson 帶著很強的假設,變異數等於平均數,對行為計數而言多半是錯的。喝酒資料的 Pearson 離散度(dispersion)是 \(2.4\),是 Poisson 所期望的一的兩倍多,這是過度離散的特徵。補救有兩種,各自編碼不同的故事。負二項加進一個離散參數,以乘性的方式把變異數抬到平均數之上,適用於額外的變異是比率上瀰漫而未被解釋的異質性。觀察層次隨機效果為每一筆觀察各給一個隨機截距,透過一個明確的潛在項把過度離散引進來,適用於把額外的變異看成屬於個別時點的擾動。兩者都能解掉眼前的症狀,選哪一個是一項建模判斷:多餘的變異究竟從哪裡來。
零過多與過度離散是兩個不同的問題,而且是比較有意思的那一個,因為那些零帶著實質意義。圖 15.7 把觀察到的每日杯數分配,對上配適出來的 Poisson 與負二項機率。Poisson 錯了兩次:零預測得太少,\(35\)% 對上觀察到的 \(52\)%;尾部的質量也太薄。負二項把整個分配變胖,觀察到的零比例倒是配得不錯,\(51\)%。這說明過度離散與零過多糾纏在一起:離散度更大的分配同時也帶著更多的零。但把零的個數配對,不等於為產生零的歷程建模,而有兩個模型以不同的方式把這個歷程講明白。圖 15.8 把區別畫成一對歷程樹。
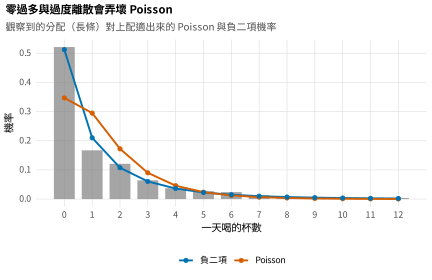
註:觀察到的每日杯數分配(長條),配上 Poisson 與負二項混合模型配適出來的邊際機率。Poisson 預測的零日太少(\(35\)% 對上觀察到的 \(52\)%),尾部也太薄;負二項加進離散度之後,零比例與尾部都配得好得多。過度離散與零過多是糾纏在一起的兩個症狀。
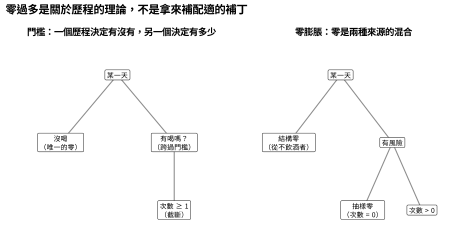
註:關於零的兩套說法。門檻模型(左)主張一個歷程決定有沒有,另一個被截斷(truncated)的歷程在跨過門檻的那些單位上決定數量,每一個零因此都是結構零。零膨脹模型(右)主張這是一個混合分配(mixture):一部分單位是結構零,從來不處於風險中,其餘的服從一個計數分配,而該分配本身也會產生抽樣零。在兩者之間抉擇,是一項關於零如何產生的實質主張。
門檻模型(hurdle model)是一個兩部分模型。一個歷程是羅吉斯模型,決定計數有沒有跨過位於零的那道門檻;另一個歷程是零截斷(zero-truncated)的計數模型,在跨過去的那些單位上決定數量。每一個零都屬於同一種,就是沒能跨過門檻,而這兩個部分回答兩個研究問題:這個行為到底有沒有發生,以及在它發生的前提下發生了多少。零膨脹模型(zero-inflation model)講的是另一個故事,一個由兩種潛在單位組成的混合分配:一部分單位以某個機率抽成結構零(structural zero),從來不處於風險中;其餘的服從一般計數分配,而該分配本身也會產生抽樣零(sampling zero)。這個區別是實質的,不是統計的。從不喝酒的人是適合用混合分配處理的結構零;會喝酒、某一天剛好沒喝的人,是抽樣零。母體裡究竟含不含真正的「從不飲酒者」,還是只有「沒喝酒的日子」,是一項關於現象的理論;選擇模型該由它決定,不是由訊息準則決定 (Atkins et al., 2013; Atkins & Gallop, 2007)。喝酒資料上,門檻模型的兩個部分把生成的真值還原得不錯,「有沒有喝」的週末對數勝算是 \(1.2\),真值為 \(1.1\),配適好的門檻模型也幾乎精準地重現了觀察到的零比例。表 15.3 把診斷與補救整理成一張表。
表 15.3 診斷過度離散與零過多並為之建模。
| 症狀 | 候選模型 | 實質意義 |
|---|---|---|
| 變異數超過平均數 | 負二項 | 比率上瀰漫而未被解釋的異質性 |
| 變異數超過平均數 | 觀察層次隨機效果 | 屬於個別時點的比率擾動 |
| 零比計數模型所容許的還多 | 門檻(兩部分) | 一個歷程管有沒有,另一個管有多少 |
| 零更多,且有一個次母體從不處於風險中 | 零膨脹(混合分配) | 來自從不處於風險單位的結構零,加上抽樣零 |
註:過度離散與零過多相關但不相同。門檻與零膨脹之間的抉擇是一項關於零如何產生的主張,也就是「從不喝酒的人」對上「沒喝酒的日子」;應該依理論決定,再以配適檢查,不能單靠配適來挑。
15.5 驗證與報告
配適好的 GLMM 必須檢查,而線性模型那套殘差圖對離散結果變項沒有訊息量:來自二元或低計數觀察的殘差連近似常態都談不上。現代的標準是以模擬為基礎的殘差。對每一筆觀察,用配適好的模型模擬出許多份複製的結果,殘差就是觀察值在它自己那組模擬分配中的位置。模型正確時,不論結果變項的分配是什麼,這個量都在單位區間上服從均勻分配(Hartig 的 DHARMa 實作了這個做法;同一個量也可以從任何配適好的模型的 simulate 方法透明地算出來)。圖 15.9 把它用在計數模型上。Poisson 縮放後的殘差明顯偏離均勻的對角線,最大偏差為 \(0.26\),正是它不配適的指紋;負二項的殘差貼合對角線得多。這類圖還配有專門檢定過度離散、零過多與群集內殘差結構的工具,是任何 GLMM 都建議先跑的診斷。
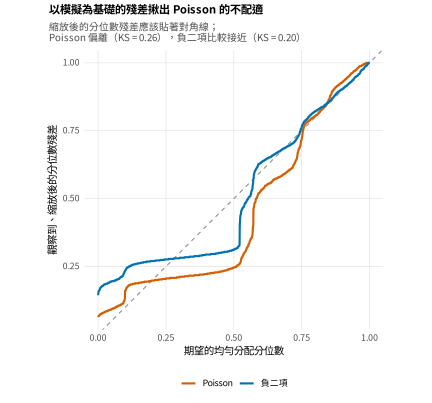
註:Poisson 與負二項計數模型以模擬為基礎、縮放後的分位數殘差(scaled quantile residual),對上它們期望的均勻分位數。模型正確時殘差會貼著對角線。Poisson 偏離(最大偏差 \(0.26\)),反映它未建模的過度離散與零過多;負二項比較接近。這項診斷對任何離散結果變項都適用,一般的殘差圖不然。
把 GLMM 報告好,很大一部分是解讀上的紀律問題。一再出現的失誤是報告光禿禿的係數或勝算比,而讀者少有人能把它翻譯成後果。表 15.4 列出各項要素。分配族與連結函數要指名並說明理由;估計方法與它的設定要陳述,包括使用適應性求積時的節點數;解讀的尺度每一步都要保持明確,因為係數是個體特定的,而勝算比不是風險比(risk ratio)。最重要的是,結果應該一路帶到預測機率、比率或類別機率,畫成軌跡或剖面(profile),那些才是讀者評估得了的量。表 15.5 列出從係數尺度到可報告量的解讀流程。
表 15.4 廣義線性混合模型的報告檢核表。
| 要素 | 要報告什麼 |
|---|---|
| 分配族與連結函數 | 結果變項的分配與連結函數,附上理由 |
| 估計 | 近似方法及其設定,包括適應性求積的節點數 |
| 解讀的尺度 | 係數要指明是個體特定;勝算比要與風險比區分開 |
| 預測量 | 機率、比率或類別剖面,畫成軌跡 |
| 隨機效果 | 變異數成分與潛在尺度的組內相關 |
| 離散度與零 | 對計數而言,離散度的處理以及零模型與其理由 |
| 診斷 | 以模擬為基礎的殘差檢查 |
註:廣義線性混合模型的書面報告在線性模型之外還必須包含的要素,延伸自第 13 章的檢核表。一再出現的失誤是停在係數的尺度;每一項結果都應該走到一個可解讀的預測量。
表 15.5 廣義線性混合模型的解讀流程。
| 結果變項 | 係數的尺度 | 可報告的量 |
|---|---|---|
| 二元 | 對數勝算(個體特定) | 預測機率軌跡;勝算比並附上條件式的但書 |
| 次序 | 累積對數勝算 | 類別機率隨時間的剖面 |
| 計數 | 對數比率 | 每曝險單位的預測比率;發生率比 |
| 任一種 | 固定效果係數 | 對隨機效果與共變項分配取平均的平均邊際效果 |
註:係數是估計結束的地方,不是報告結束的地方。每一種結果變項都有一個自然的可解讀量,把模型翻譯到讀者評估得了的尺度上:把預測值通過反連結函數映回去,母體平均的量再對隨機效果取平均。
15.6 在 R 中執行廣義線性混合模型
二元與計數模型以 lme4 的 glmer 配適,次序模型以 ordinal 的 clmm 配適,計數的延伸則用 glmer.nb 或更有彈性的 glmmTMB。適應性求積由 nAGQ 引數要求,只適用於純量隨機效果。
library(lme4); library(ordinal)
rct <- transform(rct, week_c = week - 8,               # 原點放在可估計的位置
                 remit = as.integer(hdrs <= 7))

# --- 二元:羅吉斯成長,先 Laplace 再適應性求積 ---
mB  <- glmer(remit ~ week_c*arm + (1 | patient_id), data = rct,
             family = binomial, nAGQ = 1)              # Laplace
mB2 <- update(mB, nAGQ = 15)                           # 15 點 AGQ
tau <- VarCorr(mB)$patient_id[1]; tau/(tau + pi^2/3)   # 潛在尺度的 ICC

# --- 次序:比例勝算的累積 logit 混合模型 ---
mO <- clmm(severity ~ week + arm + (1 | patient_id), data = rct)
計數使用對數曝險偏移項;過度離散以負二項處理,門檻模型則寫成兩個部分,或以 glmmTMB 在單一次呼叫中完成。
# --- 計數:帶偏移項的 Poisson,再換負二項 ---
mP  <- glmer(drinks ~ weekend + (1|person), offset = log(awake_hours/16),
             data = ema, family = poisson)
mNB <- glmer.nb(drinks ~ weekend + (1|person) + offset(log(awake_hours/16)), data = ema)

# --- 門檻模型一次呼叫(glmmTMB):數量模型 + 零門檻模型 ---
# glmmTMB(drinks ~ weekend + (1|person), ziformula = ~., family = truncated_nbinom2, data = ema)

# --- 任何配適好的模型都能算以模擬為基礎的殘差 ---
# DHARMa::simulateResiduals(mNB) |> plot()
隨書附上的腳本 ch15_analysis_V01.R 收錄完整的分析,包括 Laplace 與求積的比較、條件與邊際的計算、係數重新縮放的示範,以及配上模擬殘差的計數模型展示;圖形由中文版的 ch15_figures_zh_V01.R 繪出,計數資料集由 gen_ema_drinks_V01.R 產生。glmmTMB 套件能在單一次呼叫中配適零膨脹與門檻模型,是計數結果變項建議的工具;GLMMadaptive 在模型帶有隨機斜率時提供適應性求積;DHARMa 把以模擬為基礎的診斷自動化。
軟體提示 • glmer、glmmTMB 與類別資料的傳統
二元與次序結果變項用 glmer 與 clmm 就夠了。計數,尤其是過度離散與零過多,glmmTMB 能力更強:它以 family 與 ziformula 兩個引數,在單一次呼叫中配適帶隨機效果的負二項、零膨脹與門檻模型。隨機斜率讓 glmer 的 nAGQ 不能用時,GLMMadaptive 補上適應性求積。同一個模型跨程式有不同的名字:SAS 用 PROC GLIMMIX 配適,Stata 用 meglm 與各分配族專屬的指令,SPSS 用 GENLINMIXED。第 18 章要處理的結構方程傳統,是透過機率單位連結配上加權最小平方(Mplus 與 lavaan 中的 WLSMV 估計式)來配適類別結果變項,直接估計圖 15.1 的那些閾值,並與試題反應理論(item response theory)相接。本章以概似為基礎的 logit 模型,與該章有限訊息(limited-information)的機率單位模型,是以不同的估計途徑回答同樣的實質問題。
15.7 常見的迷思
關於廣義線性混合模型,有幾個信念會誤導讀者。第一個是羅吉斯係數可以像線性係數那樣跨模型比較。潛在殘差變異數被固定住,加入任何一個預測變項都會把其他係數重新縮放,跨模型比較係數因此無效,要改為比較預測機率或平均邊際效果(圖 15.3)。第二個是GLMM 的係數與邊際模型的係數估計的是同一個東西。GLMM 的係數是個體特定的,廣義估計方程的係數是母體平均的,兩者差了第 12 章的那個衰減。第三個是過度離散是 Poisson 的一項瑕疵,用負二項補起來就好。過度離散往往是實質的,觀察層次隨機效果或混合分配可能更能呈現它的來源。第四個是零膨脹是配適的問題。門檻與混合分配之間的抉擇是一項關於零如何產生的理論,應該論證,不是用訊息準則挑出來。第五個是比例勝算假設一旦被違反,次序模型就不能用了。部分或完全不成比例的放鬆,可以在鬆綁違規預測變項的同時保留這個模型。
常見陷阱 • GLMM 實作上的五個錯誤
第一,把光禿禿的勝算比當成風險比報告:結果變項常見時,勝算比會高估風險比,兩者也都不是機率;請把結果帶到預測機率。第二,跨巢套模型比較 logit 係數:被固定住的殘差變異數會把它們重新縮放,一個係數在加入共變項之後改變了,不是中介的證據。第三,對個體間變異數大的二元結果變項相信 Laplace:請以適應性求積確認,估計值可能實質移動(圖 15.4)。第四,不檢查離散度就假定 Poisson:Pearson 離散度遠高於一就是過度離散的訊號,以模擬為基礎的殘差會把它顯示出來。第五,單憑 AIC 就選零膨脹而不選門檻:要由「從不處於風險中的結構零在實質上是否真的存在」來決定。
實務要點 • 二元與稀疏 GLMM 中的完全分離
二元的縱貫結果變項容易發生完全分離(separation):預測變項的某一個水準完美預測了結果,一個係數或截距因此衝向無限大,配適陷入不收斂。事件在早期不可能發生時,分離自然就會出現,緩解在基線就是如此。它看起來像是一個大得離譜的係數配上一個大得離譜的標準誤,或者乾脆就是估計失敗。補救依序有三項。先把時間重新中心化、或把預測變項重新縮放,讓截距落在可估計的區域,這正是第 14 章關於原點的那項決定。再誠實地把結構上為空的細格合併或排除。分離若是資料本身固有的性質,就透過懲罰概似(penalized likelihood)或貝氏先驗(第 17 章)加進弱訊息的正則化(regularization),把估計值維持在有限的範圍內。本章的緩解模型正是把時間原點從沒有任何病人緩解的基線,移到截距可識別的第八週。
本章摘要
廣義線性混合模型插進一個連結函數,把線性混合模型延伸到二元、次序與計數結果變項,隨機效果原封不動。二元與次序結果變項還有一個等價形式:建在潛在變項上的閾值模型,而該潛在變項的殘差變異數由連結函數固定住(圖 15.1)。這件事帶來兩項後果。一是係數為個體特定,與第 12 章的母體平均效果之間差了一個衰減,衰減隨隨機變異數增大(圖 15.2)。二是羅吉斯係數不能跨模型比較,因為被固定住的殘差變異數會把它們重新縮放(圖 15.3)。概似需要積分近似,而懲罰擬概似、Laplace 與適應性求積之間的選擇,對群集小、變異數大的二元結果變項最要緊,Laplace 在那裡會讓截距與變異數成分產生偏誤(圖 15.4)。二元結果變項報告成預測機率軌跡(圖 15.5),並以潛在尺度的組內相關摘要;次序結果變項以累積 logit 模型報告,比例勝算假設可以檢查,結果畫成類別機率剖面(圖 15.6)。計數用對數連結配上曝險偏移項,帶來兩個問題:過度離散,以負二項或觀察層次隨機效果處理;零過多,以門檻或零膨脹混合分配建模。兩者之別是關於零的理論,不是一個配適統計量(圖 15.7 與圖 15.8)。以模擬為基礎的殘差是離散結果變項的診斷標準(圖 15.9),而報告要把每一項結果都帶到一個可解讀的預測量。
接下來要去哪裡
廣義線性混合模型是第 12 章邊際模型的個體特定對應物,兩章應該當成一對來讀,主題是非線性連結的縱貫模型該怎麼解讀。第 16 章轉向為個體內變異數本身建模,也就是混合效果的位置尺度模型(mixed-effects location-scale model),把變異性當成結果變項,不當成干擾。第 17 章提供貝氏估計,用來搶救本章較困難的情形所產生的模型,那些模型容易完全分離、識別也弱;它也用來配適適應性求積處理不了的複雜隨機結構。第 18 章從測量那一側逼近類別結果變項,潛在變項表述中的那些閾值在那裡成為類別測量模型的試題參數,以加權最小平方估計。第 23 章把二元與計數結果變項部署到密集日誌資料上。第 29 章則揭示離散時間存活分析(discrete-time survival analysis)就是喬裝過的二元廣義線性混合模型:事件在每一個時點的危險率(hazard),建模方式與本章處理緩解的方式一模一樣。
習題
- 15.1 Laplace 對求積。在隨機截距變異數小與大的兩種情形下模擬二元混合模型資料,各以 Laplace 與高階適應性求積配適,並以已知真值列表比較固定效果與變異數成分的偏誤。
- 15.2 從係數走到機率。在二元的縱貫結果變項上配適羅吉斯成長模型,把係數換算成勝算比、再換算成預測機率軌跡,並把結果段落寫成「沒有任何一個光禿禿的勝算比是單獨出現的,一定伴隨一個機率」。
- 15.3 比例勝算。對植入了比例勝算違反的次序結果變項配適累積 logit 混合模型,以比例與部分比例兩種設定的比較把它偵測出來,並報告與估計標的相稱的補救做法。
- 15.4 從計數走到門檻。在計數日誌結果變項上配適帶曝險偏移項的 Poisson,診斷過度離散,改用負二項,再改用門檻模型,並以一段短文為門檻而非零膨脹混合分配辯護,論據要建立在歷程上,不是配適上。
- 15.5 殘差鑑識。給定四個配適好的模型,各自植入了不同的設定錯誤:未建模的過度離散、未建模的零過多、漏掉的非線性,以及一個正確的模型;請由各自以模擬為基礎的殘差圖把它們一一辨認出來。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 廣義線性混合模型 | generalized linear mixed model (GLMM) | 以連結函數延伸到非常態結果變項的混合模型;第 15.1 節 |
| 連結函數 | link function | 把結果變項的平均數映到整條實數線上的函數;第 15.1 節 |
| 閾值模型 | threshold model | 把類別結果變項看成被閾值切開的潛在連續變項;第 15.1 節 |
| 個體特定 | subject-specific | 固定住某人的隨機效果之下的效果;與母體平均對舉;第 15.1.1 節 |
| 母體平均 | population-averaged | 對隨機效果分配取平均之後的效果;第 15.1.1 節 |
| 懲罰擬概似 | penalized quasi-likelihood (PQL) | 線性化的快速近似;二元結果變項偏誤大;第 15.2 節 |
| Laplace 近似 | Laplace approximation | 以眾數處吻合的高斯近似被積函數;第 15.2 節 |
| 適應性 Gauss-Hermite 求積 | adaptive Gauss-Hermite quadrature (AGQ) | 在眾數附近適應性布點計算積分;第 15.2 節 |
| 潛在尺度的組內相關 | latent-scale intraclass correlation | \(\tau_{00}/(\tau_{00}+\pi^2/3)\);第 15.3.1 節 |
| 累積 logit 混合模型 | cumulative-logit mixed model | 次序結果變項的比例勝算混合模型;第 15.3.2 節 |
| 比例勝算假設 | proportional-odds assumption | 預測變項在每個閾值上位移勝算的量相同;第 15.3.2 節 |
| 偏移項 | offset | 係數固定為一的預測變項,把計數轉成比率;第 15.4 節 |
| 過度離散 | overdispersion | 變異數超過基準計數分配所容許的範圍;第 15.4 節 |
| 門檻模型 | hurdle model | 有沒有與有多少分成兩個歷程;每個零都是結構零;第 15.4 節 |
| 零膨脹模型 | zero-inflation model | 結構零與抽樣零的混合分配;第 15.4 節 |
| 以模擬為基礎的殘差 | simulation-based residual | 觀察值在自身模擬分配中的位置;正確時為均勻分配;第 15.5 節 |
| 完全分離 | separation | 預測變項完美預測結果,係數衝向無限大;第 15.7 節 |
參考文獻
Agresti, A. (2013). Categorical data analysis (3rd ed.). Wiley.
Atkins, D. C., Baldwin, S. A., Zheng, C., Gallop, R. J., & Neighbors, C. (2013). A tutorial on count regression and zero-altered count models for longitudinal substance use data. Psychology of Addictive Behaviors, 27(1), 166–177. https://doi.org/10.1037/a0029508
Atkins, D. C., & Gallop, R. J. (2007). Rethinking how family researchers model infrequent outcomes: A tutorial on count regression and zero-inflated models. Journal of Family Psychology, 21(4), 726–735. https://doi.org/10.1037/0893-3200.21.4.726
Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008
Breslow, N. E., & Clayton, D. G. (1993). Approximate inference in generalized linear mixed models. Journal of the American Statistical Association, 88(421), 9–25. https://doi.org/10.1080/01621459.1993.10594284
Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
Bürkner, P.-C. (2017). brms: An R package for Bayesian multilevel models using Stan. Journal of Statistical Software, 80(1), 1–28. https://doi.org/10.18637/jss.v080.i01
Christensen, R. H. B. (2019). ordinal: Regression models for ordinal data (R package version 2019.12-10) [Computer software]. https://CRAN.R-project.org/package=ordinal
Hedeker, D., & Gibbons, R. D. (1994). A random-effects ordinal regression model for multilevel analysis. Biometrics, 50(4), 933–944. https://doi.org/10.2307/2533433
Hedeker, D., & Gibbons, R. D. (2006). Longitudinal data analysis. Wiley. https://doi.org/10.1002/0470036486
Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006
Mullahy, J. (1986). Specification and testing of some modified count data models. Journal of Econometrics, 33(3), 341–365. https://doi.org/10.1016/0304-4076(86)90002-3
Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining $R^2$ from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
Zeger, S. L., Liang, K.-Y., & Albert, P. S. (1988). Models for longitudinal data: A generalized estimating equation approach. Biometrics, 44(4), 1049–1060. https://doi.org/10.2307/2531734
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。