第 8 章
視覺化改變 I:軌跡、子圖與比較性圖示
一張縱貫資料的圖不是分析做完之後才貼上去的裝飾,它本身就是分析。對的圖示回答每一項變化研究都躲不掉的兩個問題:典型的型態長什麼樣,人在它周圍變異多大。這兩個問題要回答兩次,一次在估計任何參數之前,一次在配適完模型之後,後者是把配適好的模型疊回它自稱能解釋的那份資料上。本章是視覺化兩章的第一章,處理時點數從少到中等的追蹤型資料(panel-type data):成長軌跡、組間比較,以及能讓「改變上的個體差異」現形的圖示。全書的圖形樣式也在此一次定案,後續每一張圖都繼承它,美學問題於是不必逐章重吵。座右銘很簡單:配模型之前先畫圖,配完模型之後把模型畫出來。
學習目標
讀完本章之後,你應該能夠:(1) 從「這張圖要回答什麼問題」來選圖示,不論問題是平均變化、改變上的個體差異、組間對比還是調節效果;(2) 做出分層次的軌跡圖(layered trajectory plot),讓它從數十人一路撐到數千人都還讀得出來;(3) 用小型多重圖(small multiples)與千層麵圖(lasagna plot)呈現單一疊圖藏住的異質性(heterogeneity);(4) 比較組別時畫出帶有自身不確定性的差異軌跡(difference trajectory),而不是兩條疊在一起的平均線;(5) 畫整個分配而不是長條,並說得出炸藥圖(dynamite plot)與截斷座標軸(truncated axis)為什麼誤導;(6) 把模型隱含(model-implied)與個體專屬(person-specific)的配適軌跡疊回觀察資料,當成例行的診斷;(7) 產出色覺友善、耐印刷的圖形,以及符合 APA 期待、以比較為導向的表格。
8.1 畫改變的原則
有效的圖形順著人類視覺解碼數量的方式來設計,而這個排序早有定論:沿著共同尺度的位置(position along a common scale)讀得最準,其次是長度(length),再來是角度(angle)與斜率(slope),顏色(color)與面積(area)最不準 (Cleveland & McGill, 1984)。改變的圖示因此要盡量把關注的量編碼成位置,顏色留給分組,不要拿來編碼大小。第二個與時間有關的知覺事實是:連接線意謂連續性,它主張狀態從一個測量點平滑地滑到下一個,而這個主張在兩種常見情況下會誤導。時點間距不等卻畫成等距,眼睛讀到的就是一個資料並不支持的固定變化率;圖 8.1 把同樣五個測量值分別對波次編號與對實際經過的時間畫出來,第一個子圖那種平穩的下降,到第二個子圖就正確地變成集中在單一區間內的一次陡降。線若畫過遺漏的波次,則會內插出一個從未觀察到的值,等於在整份研究訊息最少的那一點上製造資料。兩種情況的補救相同:橫軸放真實的時間,真正有缺口的地方把線斷開,不要拿線糊過去。
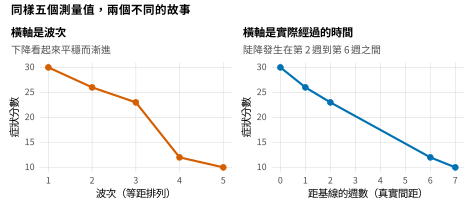
註:左:五個時點以等距的波次排列,看起來像漸進而固定的下降。右:同樣的數值對實際經過的時間畫出,幾乎所有改變都發生在第二週到第六週之間。把不等的間距畫成相等,是改變圖形中最常見、後果也最嚴重的扭曲之一。
每一張畫改變的圖都要同時回答兩個問題:典型的軌跡長什麼樣子,個體偏離它多少。只給平均數、或只給個體的圖示都不完整。表 8.1 把常見的研究問題對應到能回答它的圖示,是本章實用的索引。本章其餘各節依這些問題編排,但有一件事要先交代:全書的圖形樣式在此定義一次,之後全書重複使用。這套樣式是一個格線淡雅的乾淨主題、色覺友善的 Okabe-Ito 定性色盤 (Okabe & Ito, 2008)、置底的圖例,以及以目標欄寬的實體寬度輸出,讓圖形不必縮放就清楚可讀。隨書附的 theme_book_zh_V01.R 提供主題、色盤與尺寸輔助函式,後續各章用 source() 載入,不各自重新定義美學。
表 8.1 從問題選擇圖示。
| 問題是關於…… | 能回答它的圖示 |
|---|---|
| 平均軌跡與它的不確定性 | 附信賴帶(confidence band)的平均軌跡;\(N\) 小時直接疊在資料上 |
| 改變上的個體差異 | \(N\) 小時用義大利麵圖(spaghetti plot);依斜率排序的小型多重圖(small multiples);隨機斜率的毛毛蟲圖(caterpillar plot) |
| \(N\) 大時的異質性 | 列的排序有訊息量的千層麵圖(lasagna plot);透明度混色(alpha blending)或抽樣後的義大利麵圖 |
| 組別或條件之間的對比 | 各組的平均軌跡,以及附有自身信賴區間的差異軌跡 |
| 整個分配的改變 | 跨時點的山脊圖(ridgeline)或雨雲圖(raincloud)序列 |
| 共變項對改變的調節 | 分面(faceting)或以顏色編碼的軌跡;在共變項各水準上由模型預測的子圖 |
| 模型配適得好不好 | 配適軌跡疊在資料上;觀察到的與模型隱含的平均數對照 |
註:圖示要跟著問題走,不是跟著習慣走。許多已發表的變化圖形都把錯的問題回答得很好:研究關心的是個體差異,畫出來的卻是一個精確的組平均數;估計標的(estimand)是兩組之差,畫出來的卻是兩組疊在一起。
8.2 軌跡圖這匹主力與它的規模問題
義大利麵圖(spaghetti plot)就是一人一條連接線。它是縱貫資料的主力圖示,因為一張圖同時回答兩個問題:線條聚成的雲給出典型型態,散開的程度給出變異。它的弱點在規模。人數一多,線條就重疊糊成一團認不出來的墨團,圖示必須跟著換。圖 8.2 用學業成就資料呈現這個推移:三十個孩子時個別線條還讀得出來;三百個時,透明度混色(alpha blending)讓每條線半透明,密度以顏色深淺現形,個別路徑則消失;到了全樣本,唯一誠實的摘要是一條附帶區間的平均軌跡,此處取第十到第九十百分位的範圍,因為一千兩百條疊在一起的線怎麼畫都只是墨水。表 8.2 列出各個樣本規模下的策略。一般原則是:化簡不是不誠實,而是設計。結果既然認不出來,把所有資料都畫出來對讀者毫無幫助;一個有原則、能揭露型態的摘要,比一團藏住型態的亂線更真實。
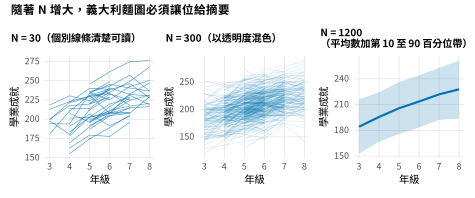
註:同一批成就資料在三個樣本數之下。\(N = 30\) 時個體軌跡清楚可讀;\(N = 300\) 時透明度混色(alpha blending)顯示密度,代價是個別路徑;\(N = 1200\) 時,只剩一條附第 10 到第 90 百分位帶的平均軌跡讀得出來。對的圖示由樣本數決定,不由「要把所有資料都畫出來」這條固定規則決定。
表 8.2 依樣本規模而定的義大利麵圖擴充策略。
| 樣本數 | 主要策略 | 說明 |
|---|---|---|
| 約 50 以下 | 完整的義大利麵圖,線條不透明 | 個別路徑可讀;再加一條平均線疊上去 |
| 約 50 到約 500 | 透明度混色(alpha blending);可再隨機挑幾條線標示出來 | 密度看得見;標註或以顏色點出幾個範例 |
| 約 500 到數千 | 千層麵圖(lasagna plot),或平均數加分配帶 | 疊在一起的線純粹是墨水;千層麵圖的列要有意義地排序 |
| 數萬以上 | 分箱摘要;斜率的六角形分箱圖(hexbin);依分層的小型多重圖(small multiples) | 逐一畫出個體已不可行;改以設計層次來摘要 |
註:這些策略可以疊加,不是互斥的:一張大 \(N\) 的圖常常在醒目的平均線與分配帶後面襯一層淡淡的抽樣義大利麵,把密度與摘要收進同一個圖示。
平均軌跡本身也帶著一項危害:許多個體歷程平均起來,可能得到一個沒有任何個體展現過的形狀。圖 8.3 重現那個經典的演示 (Estes, 1956):二十個人各自在自己特有的時刻從低值一步跨到高值,組平均數卻平滑而漸進地上升,這個形狀誤現了樣本裡的每一個人。這一課不是說平均數沒有用,而是說平均軌跡必須連同個體資料一起讀:聚合可以從一堆突然的改變中造出漸進性,而這個假象牽動的是「變化理論要怎麼檢驗」(這個主題會在第 1 章的遍歷性(ergodicity)討論與第六部的動態模型裡再度出現)。
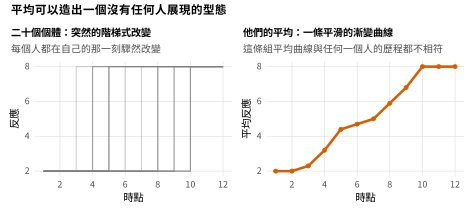
註:左:二十個個體,各自在不同的時刻驟然改變。右:他們的平均數是一條平滑漸進的曲線,與任何一個個體的階梯式歷程都不相符。平均軌跡是集中趨勢(central tendency)的有效摘要,卻可能誤現歷程;請連同個體資料一起讀。
重點若是個體差異,小型多重圖(small multiples)把每一個人畫進各自的子圖,而讓這些子圖有訊息量的關鍵設計,是排序。圖 8.4 把二十個孩子各放進自己的子圖,依對其資料配適的直線斜率排序,格狀圖於是變成一道由陡降到陡升、讀得下去的梯度,而不是一堆雜亂;依基線水準排序或依某個共變項排序回答的是別的問題,一樣正當,但依編號排序等於浪費整張圖。樣本更大時,千層麵圖(lasagna plot)改用熱圖(heatmap)取代那團亂線,一人一列、一個時點一欄,格子的深淺代表數值,而排序同樣是關鍵抉擇,只是這次排的是列。圖 8.5 把同樣八十個孩子分別依基線成就與依成長斜率排序,浮現的結構並不相同:前者是一道基線梯度,後者是軌跡的扇形展開 (Swihart et al., 2010)。空白格子反映加速世代設計(accelerated cohort design):每個孩子在六個年級中只測到四個年級。這張圖把那個結構顯示出來,不是藏起來。
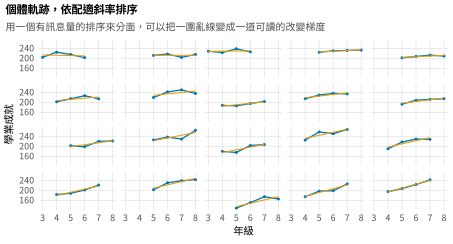
註:二十個孩子各佔一個子圖,子圖依該孩子資料所配適的最小平方(ordinary least squares, OLS)直線(橘色)斜率排序。有訊息量的排序把小型多重圖從一團雜亂變成一道可讀的改變梯度,由降得最陡的排到升得最陡的。
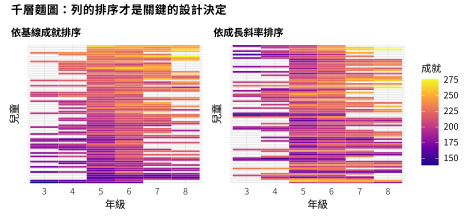
註:八十個孩子的「人 \(\times\) 年級」熱圖,深淺代表成就。依基線成就排序(左)浮現起始水準的梯度;依成長斜率排序(右)浮現變化速率的差異。空白格子反映加速世代設計(accelerated cohort design),每個孩子只跨四個年級。樣本大時,千層麵圖是取代重疊過度的義大利麵圖的可讀選擇。
8.3 跨時間比較組別與條件
研究要對比組別時,直覺是把各組的平均軌跡疊在一起。這個圖示有用,卻很少就是估計標的(estimand)。兩組(two-arm)試驗設計要估的量,是兩組之間隨時間變化的差異(difference),而這個差異值得有自己的子圖與自己的不確定性。圖 8.6 把治療試驗畫成兩種樣子:左子圖把兩組連同信賴帶疊在一起;右子圖畫「實驗組減控制組」的差異,附一個隨流失累積而變寬的信賴區間,隨治療優勢擴大而往零以下走得更遠,到最後一週約達六個憂鬱量表分。差異子圖直接把結果講出來;看疊圖子圖的讀者得自己用眼睛做減法,還完全看不到這個對比的不確定性。畫對比,就是「報告交互作用而不是報告兩條簡單斜率(simple slopes)」的視覺版。
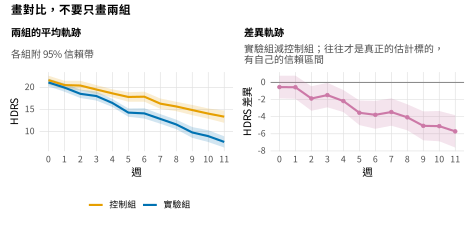
註:左:兩組的 HDRS 平均軌跡,附 \(95\%\) 信賴帶。右:「實驗組減控制組」的差異軌跡,附自身的信賴區間,這才是該試驗真正的估計標的。差異子圖把效果與它逐漸擴大的不確定性一次顯示出來;疊圖只能讓讀者用眼睛去減。
兩時點的對比也一樣,同一個原則讓一種流傳甚廣的圖示站不住腳。炸藥圖(dynamite plot)是一根長到組平均數高度、頂上加一條誤差鬚的長條,它丟掉整個分配,只留兩個摘要統計量;對改變尤其誤導,因為它把「個體是一起移動還是往相反方向移動」藏了起來。圖 8.7 拿它跟同一批資料的配對連線圖(paired-line chart)對照。配對連線圖把每位病人的基線與終點連起來,反應的異質性於是連同平均數一起看得見:有些病人大幅改善,有些幾乎沒動 (Weissgerber et al., 2015)。長條圖那兩個矩形可以由許多種個體改變型態產生,其中多數在臨床上意義不同,而配對圖示分得出來。建議也就呼之欲出:把分配畫出來,重複測量還要把個體內的改變畫出來;長條留給次數,那是它唯一能誠實編碼的量。
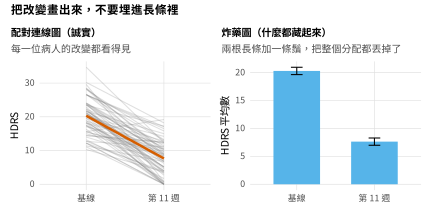
註:左:配對連線圖把每一位接受治療的病人的基線與終點連起來,粗線是平均改變,個體的異質性看得見。右:同一批資料的炸藥圖把它化約成兩根長條與兩條鬚,分配與個體內的改變都丟掉了。這兩個圖示出自完全相同的數字。
組別之間的比較也可以放在整個分配的演變上,不必只比平均數,這在地板或天花板效應、或改變的偏態本身就是故事的一部分時特別要緊。圖 8.8 用山脊圖(ridgeline)序列呈現各年級的成就分配:分配整體向上移動,分散程度變化很小。山脊圖顯示的正是平均軌跡顯示不了的事,這裡的成長是一次位置移動,不是個體差異的擴大。這一類分配式的圖示,山脊圖與它的近親雨雲圖(raincloud plot),在分配的形狀而不只是中心帶有實質意義時,已經越來越是讀者的期待 (Allen et al., 2019; Rousselet et al., 2017)。
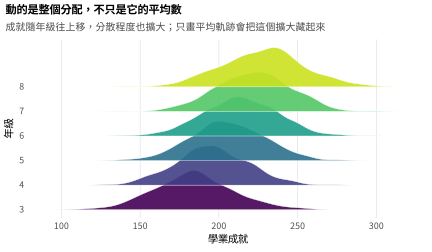
註:各年級的成就分配,以山脊圖序列呈現,各條密度採同一個帶寬,彼此才比得起來。成就跨年級向上移動,分散程度變化很小:這裡的成長是一次位置移動,不是個體差異的擴大,而這正是一條平均數軌跡顯示不了的事。當關注的是形狀而不只是中心時,分配式的圖示才是正確的選擇。
8.4 共變項與改變
要呈現共變項與改變的關係,兩匹主力是分面(faceting)與以模型為基礎的預測。依調節變項(moderator)的水準分面、或用顏色編碼軌跡,顯示的是各層內部的原始型態;在選定的共變項數值上由模型預測的軌跡,則乾淨地顯示配適出來的調節效果,不帶原始資料的雜訊。圖 8.9 以病人年齡為候選調節變項,兩種做法都畫:左子圖依年齡三分位(tertile)對原始的組平均數分面,右子圖畫各組在平均年齡上下一個標準差處由模型預測的軌跡。在這批資料中,年齡對治療斜率的調節很輕微,而圖示誠實地把它畫成輕微,沒有把一個微弱的效果誇大。這正是模型預測子圖的美德:估計出來的調節效果多大就畫多大。這種預測軌跡的做法預告了第 13 與 14 章以模型為基礎的視覺化,那裡配適出來的效果會用專為此設計的工具畫出。第 7 章的個體間與個體內散布圖是另一種標準的共變項圖示;任何「某個關聯運作在某個特定層次上」的主張,都應該附上它們。
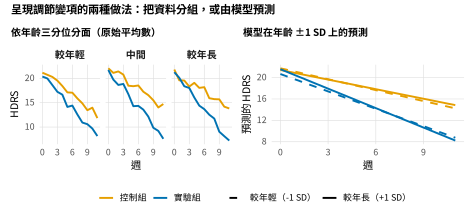
註:左:依年齡三分位分面的原始 HDRS 軌跡。右:各組在年齡低於與高於平均一個標準差處由模型預測的軌跡。在這批資料中,年齡對治療斜率的調節很輕微,模型預測子圖就照這個真實而輕微的大小畫,沒有誇大。
8.5 畫模型,不只是畫資料
「配適完就把模型畫出來」這條座右銘,產生了縱貫工作中最重要的幾張診斷圖,第一張就是把配適軌跡疊在觀察資料上。圖 8.10 給出標準形式:灰色是觀察資料,細藍線是已配適的成長模型所給的個體專屬配適軌跡,粗線是固定效果的平均軌跡。這些個體專屬的配適值就是模型的最佳線性不偏預測(best linear unbiased predictions, BLUP),也就是每個個體軌跡的收縮估計(shrinkage estimate);看著它們在平均線周圍展成扇形,隨機斜率變異數(random-slope variance)便一目了然,而這是任何一張變異數成分表都做不到的。後續每一個配適模型的章節都少不了這張圖,它的標準形式在此定義。它的搭檔是圖 8.11 的毛毛蟲圖(caterpillar plot),把個別的隨機效果連同不確定性區間排序,讓讀者同時看見個體成長速率的分散程度,以及哪些個體可靠地偏離平均數:區間不涵蓋零的孩子,成長得可靠地比典型的孩子快或慢。
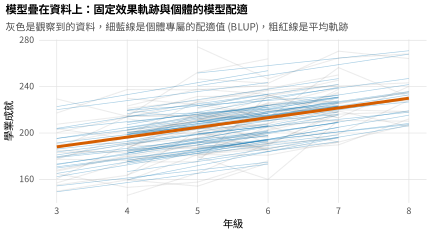
註:觀察到的成就資料(灰)、線性成長模型給的個體專屬配適軌跡(細藍,即經驗貝氏預測值(empirical Bayes prediction)),以及固定效果的平均軌跡(粗紅)。個體配適值展開的扇形直接把隨機斜率變異數顯示出來。把模型疊在資料上,是全書通用的標準配適檢查。
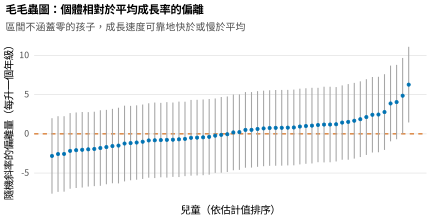
註:六十個孩子估計出來的隨機斜率偏離量,已排序,附 \(95\%\) 區間。區間未涵蓋零(虛線)的孩子,成長得可靠地比平均的孩子快或慢。毛毛蟲圖(caterpillar plot)同時傳達個體成長速率的分散程度,以及每個個體偏離平均數的確定程度。
第三種模型圖示直接檢查平均數結構:把觀察到的組平均數疊在各時點模型隱含的平均數上,如圖 8.12。吻合良好就支持這個函數形式,此處是一條線性軌跡,把觀察到的各年級平均數追得很好。系統性的落差,也就是模型隱含的平均數在特定時點上向外彎離觀察值,則是誤設(misspecification)的可見特徵,例如拿一條直線去配適一個彎曲的歷程。這個「觀察對模型隱含」的比較,是第四部與第五部的成長模型與結構方程模型的主力診斷;標準形式在此定義,後續各章可以直接引用,不必重新解釋。
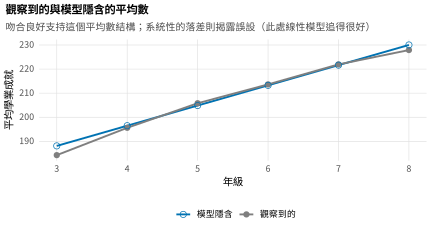
註:各年級觀察到的平均成就(灰)對照已配適的線性成長模型所隱含的平均數(藍)。吻合緊密就支持這個線性的平均數結構;特定時點上系統性的偏離則揭露配適不良。這是本書評估模型平均數結構的標準診斷。
8.6 表格、輸出與可重製性
圖形承載型態,表格承載讀者可能要拿去再用的精確數值;一張好的縱貫結果表是為了比較而設計,不只是為了完整。它的數字四捨五入到帶有訊息的那兩、三位有效數字 (Ehrenberg, 1977),它的列與欄安排成讓讀者要做的比較沿著欄往下走,因為眼睛在那個方向比得最準,而它的結構把固定效果估計值、隨機效果變異數與配適統計量分成有標籤的區塊。第 7 章的描述性「表 1」是入口,模型比較表與參數表守同樣的紀律。表 8.3 收錄本書遵循的 APA 圖表要求。最後兩件事是輸出與可重製性:圖形以向量格式、以目標欄寬的實體寬度存檔,文字才保持可讀;在色覺模擬下檢查過,選 Okabe-Ito 色盤正是為了通過這一關;附上描述性的替代文字(alt text);而最要緊的是由腳本產生,書中每一張圖才能完全重製,這也是隨書儲存庫執行的政策,每一章一個腳本。
表 8.3 APA 圖表合規檢核表。
| 元素 | 要求 |
|---|---|
| 圖的標題 | 依本書樣式,簡短的標題置於圖上方;註置於下方,定義符號、顏色與線型,只描述視覺機制,不描述結果 |
| 表的標題 | 簡短、斜體的標題置於表上方;註置於下方,靠左對齊 |
| 框線 | 只用橫線(頂線、中線、底線);不用直線 |
| 顏色 | 色覺友善的色盤;再以形狀或線型做冗餘編碼(redundant coding),讓各組在灰階(grayscale)下仍然分得出來 |
| 座標軸 | 談改變的主張不得截斷座標軸;橫軸放真實的時間;不用雙縱軸 |
| 不確定性 | 誤差帶要標明它代表什麼(SD、SE、CI);重複測量的誤差帶要用尊重非獨立性的算法 |
| 可重製性 | 每一張圖都由存檔的腳本產生;以最終印刷寬度輸出向量檔 |
註:本檢核表與 APA 格式及本書的 LaTeX 標準一致,目的是讓一張圖或一張表不論彩色或灰階、在最終尺寸下都讀得正確,而且能由程式碼重新產生。
常見陷阱 • 要拒絕的三種扭曲
第一,跨過遺漏波次的連接線:畫過未觀察時點的線會內插出不存在的資料,請在缺口處把線斷開。第二,談改變卻截斷座標軸:縱軸不從零起算、或縮得很緊,會把微不足道的改變放大成戲劇性的改變;凡是關於改變幅度的主張,座標軸就不得為了誇大而截斷。第三,對重複測量套用天真的信賴帶:由各時點的原始標準誤算出來的信賴帶,忽略了同一批人反覆測量這件事,會誤述個體內比較的不確定性;請改算受試者內(within-subject)區間 (Cousineau, 2005; Morey, 2008),或把那條帶標示為描述性的分散範圍,不要當成推論性的區間。
8.7 在 R 中建立這些圖示
本章的程式碼比多數章節多,因為畫圖這門手藝是做出來的,不是說出來的。全書樣式載入一次、設為全域,此後每一張圖都繼承它。
library(ggplot2); library(dplyr); library(tidyr); library(patchwork); library(lme4)
source("Examples/R/theme_book_zh_V01.R")  # theme_book_zh(), ok_palette, save_fig()
theme_set(theme_book_zh())

sg <- readRDS("Examples/data/school_growth.rds") |> mutate(grade_c = grade - 3)
第 8.2 節那張分層次的軌跡圖,就是個體的義大利麵圖加上一條平均線,要撐到多少人,由個體線條的透明度控制。
# --- 分層次的義大利麵圖,疊一條平均線 ---
ggplot(sg, aes(grade, achievement)) +
  geom_line(aes(group = child_id), alpha = 0.08, color = ok_palette["blue"]) +
  stat_summary(fun = mean, geom = "line", color = ok_palette["vermillion"],
               linewidth = 1.3) +
  labs(x = "Grade", y = "Achievement")
第 8.3 節的差異軌跡這樣算:先把各組摘要起來,轉成寬格式,再相減,差異的標準誤由兩組的標準誤合併得到。第 8.5 節「模型疊資料」的圖示則是把成長模型配適一次,再同時預測個體專屬軌跡與固定效果軌跡。
# --- 差異軌跡與它自己的 CI (therapy_rct) ---
rct <- readRDS("Examples/data/therapy_rct.rds")
gm <- rct |> group_by(arm, week) |>
  summarise(m = mean(hdrs, na.rm = TRUE),
            se = sd(hdrs, na.rm = TRUE) / sqrt(sum(!is.na(hdrs))), .groups = "drop")
dif <- gm |> pivot_wider(names_from = arm, values_from = c(m, se)) |>
  mutate(d = m_Treatment - m_Control, sed = sqrt(se_Treatment^2 + se_Control^2))
ggplot(dif, aes(week, d)) +
  geom_hline(yintercept = 0, color = "grey55") +
  geom_ribbon(aes(ymin = d - 1.96 * sed, ymax = d + 1.96 * sed), alpha = 0.2) +
  geom_line(linewidth = 1)

# --- 模型疊資料:固定效果與 BLUP 軌跡 ---
m_sg <- lmer(achievement ~ grade_c + (1 + grade_c | child_id), data = sg)
sg$blup <- predict(m_sg)                                   # 個體專屬的配適值
fixed  <- data.frame(grade = 3:8, grade_c = (3:8) - 3)
fixed$fit <- predict(m_sg, newdata = fixed, re.form = NA)  # 平均軌跡
十二張圖完整且可重製的程式碼都在隨附的 ch08_figures_zh_V01.R,包括千層麵圖的兩種排序、毛毛蟲圖中連同條件變異數一起取出隨機效果,以及觀察對模型隱含的比較;全書樣式的定義則在 theme_book_zh_V01.R。
軟體提示 • 組版與表格工具
本書由多個子圖組成的圖形都用 patchwork 組版:+ 運算子把圖並排,/ 把圖上下疊,plot_layout(guides = "collect") 把共用的圖例合併,plot_annotation() 加上總標題。發表用的表格若由 R 產生,gt 以「表格文法」的語法產出精緻的 HTML 與 LaTeX 輸出;flextable 透過 officer 針對 Word 文件,交付物是 Word 稿件時比較合用。兩者都強制套用 APA 格式「只用橫線、註在下方」的慣例,選哪一個由輸出格式決定,不由表格內容決定。
實務要點 • 熬得過製作流程的輸出設定
線條圖一律存成向量的 PDF 或 SVG,不要存點陣的 PNG,放大到任何倍率才都還銳利;點陣輸出只留給有數千個重疊點的圖,那時向量檔會大到難以處理,這種情況要用高解析度輸出。圖的尺寸要設成目的地的實體寬度,期刊單欄大約 \(3.4\) 吋、整個文字寬度大約 \(7\) 吋,基礎字級也要設成在那個尺寸下座標軸標籤還讀得出來:照螢幕尺寸設計、再縮到一欄寬的圖,文字就毀了。請在色覺缺陷(color-vision deficiency)模擬下檢查結果,輸出時嵌入字型,並把產生它的腳本納入版本控制,資料或樣式一改就能重新產生。
8.8 常見的迷思
關於畫改變,有幾個信念會造成傷害。第一個是圖形是裝飾,結果由表格承載。在變化的研究裡,圖形往往就是結果:一張軌跡圖揭露的函數形式、異質性與配適不良,任何表格都傳達不了,而「觀察對模型隱含」的圖示是正式的診斷,不是裝飾。第二個是永遠都應該把所有資料畫出來。一萬條重疊到認不出來的線什麼也沒顯示,有原則地化簡成一個能揭露型態的摘要,比一團藏住型態的亂線更誠實。第三個是誤差線就是誤差線。標準差、標準誤、信賴區間與預測區間回答的是不同的問題;對重複測量而言,天真的受試者間區間會誤述受試者內的不確定性,所以一條帶代表的是哪一個量,必須寫明。還有一個反覆出現的問題:該用顏色還是形狀區分組別。最好的答案是兩者都用,冗餘編碼能讓有色覺缺陷的讀者、以及灰階複印的情況下,各組仍然分得出來。
本章摘要
一張改變的圖就是分析,而對的圖回答兩個問題:典型的型態是什麼,人在它周圍變異多大。圖示要從問題來選(表 8.1)。義大利麵圖在 \(N\) 小時同時回答這兩個問題,樣本一大就得讓位給透明度混色、千層麵圖與摘要(圖 8.2);而它摘要出來的平均軌跡,可能把一堆突然的個體改變誤現成平滑的漸變(圖 8.3)。個體差異靠排序得有訊息量的小型多重圖(圖 8.4)與列排得對的千層麵圖(圖 8.5)呈現。組間對比要畫帶有自身不確定性的差異軌跡,不要畫兩條疊在一起的平均線(圖 8.6);改變要透過整個分配呈現,不要用把分配丟掉的炸藥圖(圖 8.7、8.8)。調節效果靠分面與在共變項數值上由模型預測的子圖呈現(圖 8.9)。配適之後要把模型疊在資料上畫出來:固定效果與個體專屬的軌跡(圖 8.10)、隨機效果的毛毛蟲圖(圖 8.11),以及觀察對模型隱含的平均數(圖 8.12),這三張是全書重複使用的標準診斷。把不等的間距畫成相等、截斷座標軸、跨過遺漏波次內插,以及對重複測量套用天真的誤差帶,都要拒絕。全書樣式在此定義一次、之後處處繼承,每一張圖都由腳本產生。
接下來讀哪裡
下一章把這些原則帶進密集縱貫資料。那裡每個人有數百個時點,需要的圖示遠超出本章這套為少數時點設計的方法;時間本身也透過週期、事件與連續取樣,變成一個更豐富的對象。本章定義的全書樣式、分層次軌跡的邏輯,以及三項「模型疊資料」的診斷,會在後續每一個建模章節重現:第 13 與 14 章的成長模型倚賴「固定效果加 BLUP」的疊圖與「觀察對模型隱含」的比較,第 23 章的多層次日誌模型延伸調節變項的圖示,第 36 章的報告綜論則回到此處收錄的表格與可及性標準。唯一的承諾是:報告任何模型都要附上一張圖,讓模型立在它自稱能解釋的資料之上。
習題
- 8.1 重建一張壞圖。給定一張畫在截斷座標軸上的炸藥圖,重建它底層的資料,做出兩個站得住腳的替代方案:一張配對連線圖與一張分配式圖示,再各用一段話說明它為什麼比原圖誠實。
- 8.2 替千層麵排序。以
school_growth建立千層麵圖,列分別依編號、依基線成就、依成長斜率排序,說明每一種排序各揭露或遮蔽了什麼結構。 - 8.3 畫出對比。就
therapy_rct產出差異軌跡圖,為「實驗組減控制組」的差異算出正確的信賴區間,再寫出這張子圖支持的一句話解讀。 - 8.4 模型疊資料。把第 8.5 節的線性成長模型配適到
school_growth,重現「固定效果加 BLUP」的疊圖與「觀察對模型隱含」的平均數圖示,並說明每一張各告訴你配適的哪一件事。 - 8.5 一張結果表。由配適好的成長模型產出一張符合 APA 規範的結果表,固定效果、變異數成分與配適統計量分成不同區塊,數字為比較而四捨五入,並寫出它的註。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 義大利麵圖 | spaghetti plot | 一人一條連接線的軌跡圖;第 8.2 節 |
| 透明度混色 | alpha blending | 讓線條半透明,使密度以顏色深淺現形;第 8.2 節 |
| 小型多重圖 | small multiples | 每個個體各佔一個子圖的格狀圖;第 8.2 節 |
| 千層麵圖 | lasagna plot | 一人一列、一時點一欄的熱圖;第 8.2 節 |
| 差異軌跡 | difference trajectory | 兩組之差隨時間的變化,附自身信賴區間;第 8.3 節 |
| 估計標的 | estimand | 研究設計上真正要估計的那個量;第 8.3 節 |
| 炸藥圖 | dynamite plot | 長條加誤差鬚,丟掉整個分配;第 8.3 節 |
| 配對連線圖 | paired-line chart | 把同一個人的前後兩個時點連起來;第 8.3 節 |
| 山脊圖 | ridgeline plot | 各時點的分配依序堆疊呈現;第 8.3 節 |
| 雨雲圖 | raincloud plot | 密度、盒鬚與原始點的合成圖;第 8.3 節 |
| 調節變項 | moderator | 改變某個關聯強度或方向的變項;第 8.4 節 |
| 最佳線性不偏預測 | best linear unbiased prediction (BLUP) | 個體軌跡的收縮估計;第 8.5 節 |
| 毛毛蟲圖 | caterpillar plot | 把隨機效果連同區間排序畫出;第 8.5 節 |
| 模型隱含的平均數 | model-implied means | 由已配適模型算出的各時點平均數;第 8.5 節 |
| 分面 | faceting | 依某個變項的水準把資料拆到多個子圖;第 8.4 節 |
| 截斷座標軸 | truncated axis | 縱軸不由零起算,會誇大改變幅度;第 8.6 節 |
| 加速世代設計 | accelerated cohort design | 不同世代各觀察部分年齡段再拼接;第 8.2 節 |
參考文獻
Allen, M., Poggiali, D., Whitaker, K., Marshall, T. R., & Kievit, R. A. (2019). Raincloud plots: A multi-platform tool for robust data visualization. Wellcome Open Research, 4, 63. https://doi.org/10.12688/wellcomeopenres.15191.1
Cleveland, W. S. (1993). Visualizing data. Hobart Press.
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
Cousineau, D. (2005). Confidence intervals in within-subject designs: A simpler solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042
Ehrenberg, A. S. C. (1977). Rudiments of numeracy. Journal of the Royal Statistical Society: Series A (General), 140(3), 277–297. https://doi.org/10.2307/2344922
Estes, W. K. (1956). The problem of inference from curves based on group data. Psychological Bulletin, 53(2), 134–140. https://doi.org/10.1037/h0045156
Gelman, A., Pasarica, C., & Dodhia, R. (2002). Let’s practice what we preach: Turning tables into graphs. The American Statistician, 56(2), 121–130. https://doi.org/10.1198/000313002317572790
Matejka, J., & Fitzmaurice, G. (2017). Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing. In Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems (pp. 1290–1294). Association for Computing Machinery. https://doi.org/10.1145/3025453.3025912
Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061
Okabe, M., & Ito, K. (2008). Color universal design (CUD): How to make figures and presentations that are friendly to colorblind people. J*FLY Data Depository for Drosophila Researchers. https://jfly.uni-koeln.de/color/
Rousselet, G. A., Pernet, C. R., & Wilcox, R. R. (2017). Beyond differences in means: Robust graphical methods to compare two groups in neuroscience. European Journal of Neuroscience, 46(2), 1738–1748. https://doi.org/10.1111/ejn.13610
Swihart, B. J., Caffo, B., James, B. D., Strand, M., Schwartz, B. S., & Punjabi, N. M. (2010). Lasagna plots: A saucy alternative to spaghetti plots. Epidemiology, 21(5), 621–625. https://doi.org/10.1097/EDE.0b013e3181e5b06a
Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), e1002128. https://doi.org/10.1371/journal.pbio.1002128
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-24277-4
Wilke, C. O. (2019). Fundamentals of data visualization. O’Reilly Media.
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。