第 3 章
跨時間與跨時間尺度的測量
變化分數會承接它所依據的每一項測量缺陷,再添上幾項自己的。問一個人有沒有改變之前,得先守住一個容易被假定、卻難以真正取得的前提:這份工具在兩個時點上意謂同一件事。本章談的就是這個前提,以及測量一旦重複,信度究竟是什麼意思。
學習目標
讀完本章之後,你應該能夠:(1) 說明水準(level)、變化(change)與變異性(variability)三種問題,對測量品質的要求為何並不相同;(2) 為一份密集縱貫量表分別計算並解讀個體間信度(between-person reliability)與個體內信度(within-person reliability);(3) 說明把重複測量資料堆疊起來所算出的 alpha 係數為何無法解讀;(4) 寫出尊重既定參照期間(reference period)與時間尺度的當下題目;(5) 從概念上定義形貌恆等性(configural invariance)、量尺恆等性(metric invariance)與截距恆等性(scalar invariance),並預測違反各層次的後果;(6) 區分構念連續性(construct continuity)與分數可比較性(score comparability),包括異型連續性(heterotypic continuity)這種情形;(7) 評估變化分數的信度,以及個體內時間序列衍生指標的信度。
3.1 變化要能被解讀,什麼必須保持不變
想像每天早晨站上家裡的體重計,把數字記下來。體重計若值得信任,這一串數字就能告訴你體重的變化。但假設它在你不知情之下慢慢失準,到了月底每次都多讀兩公斤。那條上升的數列反映的是儀器,不是身體,你推論出來的變化只是假象。或者假設它變得不穩定:體重沒有改變,讀數卻一天比一天跳動得更厲害。數字仍然圍繞著真值,但每一個讀數都比前一個更不可靠,任兩個讀數之間的差異可能大半只是雜訊。心理學的構念,正是用會漂移、也會退化的工具測量的,漂移的方式恰恰就是這兩種,只是很少像一台沒校準的體重計那樣顯眼。
重複測量要能產出可解讀的變化,有三件事必須同時成立。圖 3.1分別示範這三件事,圖中那個人在某項特質上的真實水準從頭到尾都沒有改變。第一,工具在每個時點測到的是同一個構念(same construct),那些數字才指向同一件事。第二,工具使用同一套量尺(same metric),同一個分數在每個時點才代表構念的同樣份量;圖 3.1的子圖 B 是量尺逐步往上漂移,一個完全沒有改變的人於是看起來像在成長。第三,工具維持同樣的精確度(same precision),各時點的分數才同樣值得信任;子圖 C 是精確度逐步退化,後期的分數在真值周圍散得更開。這三項要求非正式地對應到測量恆等性(measurement invariance)的各個形式層次,本章第 3.5 節先引入,第 18 章再完整發展:同一個構念對應形貌恆等性,同一套量尺對應量尺恆等性與截距恆等性,同樣的精確度對應測量誤差在各時點相等。
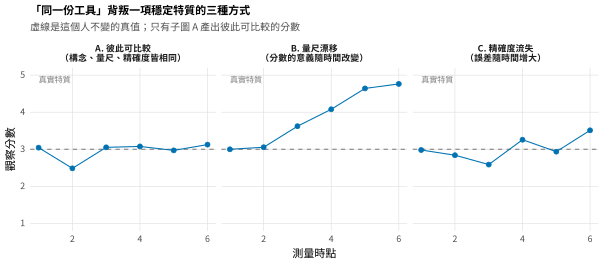
註:模擬資料。圖中這個人的真實特質值(虛線)在六個時點上固定不變。子圖 A 的工具穩定,觀察分數彼此可比較。子圖 B 的量尺往上漂移,在沒有變化的地方製造出變化的假象。子圖 C 的精確度流失,後期的分數比早期的分數更不可靠。
還有一層更細的複雜性:構念要保持不變,有時必須改變題目。以攻擊行為跨越發展階段為例。五歲兒童的攻擊行為表現為打人、咬人與發脾氣;十五歲青少年身上,同一個底層傾向表現為言語敵意、打架與違規犯紀。一份在兩個年齡都問「咬人」的工具,五歲時測得很好,十五歲時測得很糟。這就是異型連續性(heterotypic continuity):構念本身連續,行為指標卻隨發展改變,因此要測到同一個構念,反而必須換上符合各年齡的題目(圖 3.2)。異型連續性逼出兩項設計決定。第一,它支持納入定錨題目(anchor item),也就是在整個年齡範圍內都有效的指標,用來把各年齡專屬的測量連結到同一條量尺上。第二,原始分數的可比較性不能假定,只能靠分析建立,也就是第 18 章的縱貫連結(linking)與部分恆等性(partial invariance)方法。一個構念表面上的穩定或變化,可能是「題目該換卻沒換」的假象,也可能是「換了題目卻沒有連結」的假象 (Widaman et al., 2010)。
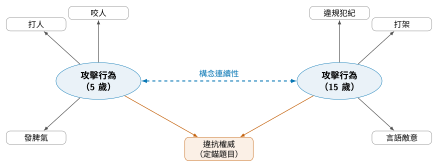
註:潛在構念跨年齡持續存在,行為指標卻會改變。一道在兩個年齡都有效的定錨題目(橘色)提供共同參照點,兩套年齡專屬的測量才能放到同一條量尺上。
3.2 測量重複之後的信度
古典測驗理論(classical test theory)把信度(reliability)定義為觀察分數變異數中屬於真分數(true score)而非誤差(error)的比例;單一次橫斷測量用這個定義就夠了。測量一旦重複,單一個係數就不夠用,因為信度相對於某個母體,也相對於某個分析層次。同一份量表可以在「把人依平均水準排序」上信度極高,在「偵測某個人此刻的起伏」上卻信度很差;第 3.3 節的實作範例會具體展示。從某一個樣本、某一個時點報告出來的「\(\alpha = .85\)」,若沒有進一步的證據,並不授權任何一種重複測量的用法。
在變化的測量上,流傳最頑強的一則坊間說法關於差異分數(difference score)的信度;第 10 章需要這件事先有定論,這裡就正面處理。這個古典結果與 Cronbach and Furby (1970) 相連:差異分數往往不可靠。這句話沒錯,只是說得不夠完整。
基礎概念 • 差異分數的信度
令 \(Y_1\) 與 \(Y_2\) 為前測與後測分數,兩者的變異數同為 \(\sigma^2\)、信度同為 \(\rho\),\(\rho_{12}\) 為兩者的觀察相關。差異 \(D = Y_2 - Y_1\) 的觀察變異數為
\(D\) 之中的誤差變異數則是兩個誤差變異數之和,即 \(2(1-\rho)\sigma^2\)。差異分數的信度就是一減去「誤差對觀察」的比值:
式 (3.2) 給出的結論常令人不安:前後測相關 \(\rho_{12}\) 逼近信度 \(\rho\) 時,差異的信度趨近於零。兩個時點的相關是 \(.80\)、每個時點的信度也是 \(.80\),差異的信度就是 \(0\)。但請把公式連同它的意義再讀一次。\(\rho_{12}\) 很高,意味著人們從前測到後測維持原本的排序,也就是每個人改變的量大致相同,於是根本沒有多少變化上的個體間變異可供信度係數去偵測。差異分數信度低,發出的訊號是「變化很同質」,不是「測量無效」。差異分數依然是每個人個體內變化的不偏估計值;信度低所陳述的是偵測變化上的個體差異的精確度,不是「變化究竟有沒有發生」(Rogosa et al., 1982)。這項區分,也就是「偵測個體差異的精確度」與「個體內量本身的效度」之分,會在全書反覆出現。
比任何單一係數都更誠實的框架來自概化理論(generalizability theory):它把觀察分數看成從一個「可容許觀察的全域」(universe of admissible observations)中抽出的樣本,再追問這個分數的變異數有多少可以歸給測量的每一個側面(facet) (Cronbach et al., 1972)。重複測量資料相關的側面是個體、時點與題目,三者交叉如圖 3.3所示。概化理論把題目反應的總變異數分解為穩定的個體差異成分、個體之內的時點成分(真正的當下狀態)、題目成分,以及這些成分的交互作用與殘差。這個框架的價值在於它拒絕抽象地回答「這份量表的信度是多少?」,而是逼出另一個問題:「對什麼而言可靠、要概化到什麼範圍?」把人排序的信度概化到時點與題目,落在個體成分上;偵測當下狀態的信度只概化到題目,落在「個體乘時點」成分上。兩者取用同一份變異數分解裡的不同片段,這正是兩者可以差距如此懸殊的原因。
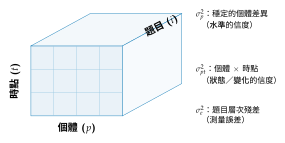
註:每一個格子是一位個體在一個時點對一道題目的作答。概化理論把總變異數分解為個體、個體之內的時點、題目,以及這些來源交互作用的成分。不同的信度問題取用不同的成分:個體間成分主導個人平均水準的信度,「個體乘時點」成分主導當下狀態的信度。
3.3 密集資料的多層次信度
密集縱貫資料讓信度的「層次專屬性」無法迴避:每個人都貢獻許多時點,題目結構在個體層次與時點層次上又可能不同。Cranford et al. (2006) 以及 Geldhof et al. (2014) 發展的框架,把每一份密集縱貫量表同時擁有的兩種信度形式化。個體間信度(between-person reliability)問的是:這份量表把人依平均水準排序時有多可靠,也就是把每個人的許多時點聚合之後的排序品質;穩定的個體差異相對於誤差越大,它就越高。個體內信度(within-person reliability)問的是:在單一時點上,這份量表偵測某個人「相對於自己平均數的當下偏離」時有多可靠;當下的狀態變異數相對於題目層次的誤差越大,它就越高。這是兩個不同的量,一份量表完全可能在其中一項表現出色,在另一項不堪使用。
實作範例使用配套資料集 affect_ema_items 裡的四道負向情緒題目,也就是 affect_ema 當下負向情緒複合分數背後的題目層次作答。以交叉隨機效果模型(crossed random-effects model)分解這些題目的變異數,得到個體間(穩定)變異數約 \(0.17\)、個體乘時點(當下狀態)變異數約 \(0.15\)、題目層次殘差約 \(0.53\)。由這些成分算出來,在平均六十一個時點、四道題目的條件下,個人平均水準的個體間信度約為 \(.97\):有六十一次當下回報,一個人的平均負向情緒就估計得相當精確。單一次四題複合分數的個體內信度卻只有約 \(.53\):一次四題的回報,是「此人此刻相對於自己常態位在何處」的一個雜訊很大的指標。多層次因素分析用 omega 的語言講出同一個故事:這份負向情緒量表的個體間 omega 約為 \(.88\),個體內 omega 約為 \(.61\)。兩條路線的數值不會相等:交叉隨機效果模型隱含負荷量相等,多層次因素分析則允許負荷量不等,個體內 omega 因此比個體內信度高出約 \(.077\),這個差距來自模型設定,不是取樣波動。比較不同人的平均數時,這些題目凝聚成一份良好的量表;追蹤同一個人的起伏時,它們凝聚得差得多。這個落差不是這份特定量表的缺陷,而是常態;對只報告單一個信度係數的人來說,它完全隱形。
常見陷阱 • 在堆疊的長格式資料上算 alpha 係數
密集縱貫資料以長格式存放、每一列是一個「人乘時點」時,有一條很誘人的捷徑:忽略個體結構,直接在堆疊起來的題目欄位上跑 alpha 係數。對上面那些負向情緒題目,這個合併後的 alpha 約為 \(.71\),看起來體面,卻幾乎沒有意義。它是個體間信度(約 \(.88\))與個體內信度(約 \(.61\))的混合,權重取決於樣本中個體間與個體內變異數的比例,因此不對應研究者真正想要的任何一個量。報告它,會誘使讀者以為這份量表在水準與變化上一樣好用,而事實並非如此。正確的做法是把信度分層估計、兩個層次都報告,用多層次驗證性因素分析(multilevel confirmatory factor analysis, CFA)或概化理論的係數;合併後的 alpha 根本不該出現。另一個相關的錯誤是只報告個體內 omega,卻把它說成「這份量表的信度」,彷彿那是一個全域屬性;它專指當下偏離的信度,對個體平均數的信度一句話也沒說。
接著有兩個實務問題。第一,一份當下量表需要幾道題目?每一次提示能動用的題量十分有限(第 2 章),當下量表都很短,而個體內信度的公式正說明了短為何有害:題目數量減半,題目層次誤差在每一個當下分數裡所佔的份量就提高。這裡沒有普世的下限,但主導這個決定的應該是個體內信度,不是個體間信度,因為時點數量本身就會把聚合值的個體間信度撐高,幾乎在任何情況下都看起來足夠。第二,單一題目能不能勝任?構念狹窄而具體、負擔確實是約束條件、而且有個體內層次的效度證據時,單題的當下測量站得住腳;但單一題目的個體內信度完全無法從內部一致性(internal consistency)推得,必須另行建立,例如安排偶爾一次的多題探測,或在很短的間隔內做重測(test–retest) (Schuurman & Hamaker, 2019)。表 3.1整理本節引入的各個係數。
表 3.1 重複測量資料的信度係數。
| 係數 | 它回答的問題 | 如何取得 |
|---|---|---|
| 個體間信度(個體間 omega;\(R_{kF}\)) | 這份量表把人依平均水準排序時有多可靠? | 兩層次 CFA(個體間 omega);變異數成分 |
| 個體內信度(個體內 omega;\(R_{kR}\)) | 單一次回報偵測當下偏離時有多可靠? | 兩層次 CFA(個體內 omega);變異數成分 |
| 個人平均數的信度 | 在 \(T\) 個時點下,一個人的估計平均數有多穩定? | \(\sigma^2_p / (\sigma^2_p + \sigma^2_{w}/T)\) |
| 差異分數的信度 | 變化上的個體差異偵測得多精確? | 由重測資料計算 \((\rho - \rho_{12})/(1 - \rho_{12})\) |
| iSD 或慣性的信度 | 個體內變異性或動態估計得多可靠? | 以模擬或折半法(split-half);隨 \(T\) 緩慢提升 |
註:個體間與個體內係數依循 Cranford et al. (2006) 與 Geldhof et al. (2014) 的多層次框架;\(\sigma^2_w\) 表示複合分數在時點層次的變異數。R 的實作見第 3.8 節。
3.4 當下評估的題目與量表設計
測量品質在估計之前就設計好了,而當下評估(momentary assessment)多了一些特質測量沒有的設計限制。其中最重要的一項是參照期間(reference period)。一道當下題目必須問現在,或問一段最近而有明確邊界的區間,也就是「現在這一刻」或「自上一次提示以來」,因為密集取樣的全部理由就是趕在記憶重建之前捕捉經驗(第 2 章)。把一道問「過去一週以來,你有多緊繃?」的題目嵌進當下評估方案,等於放進一份偽裝過的回溯摘要:它把設計原本要擊敗的回憶偏誤又請了回來,也混淆了時間尺度,因為以週為單位的摘要不可能在一天之內隨提示而變動。圖 3.4把一道良好的當下題目,與一道把回溯窗口偷渡進當下研究的題目並列對照。
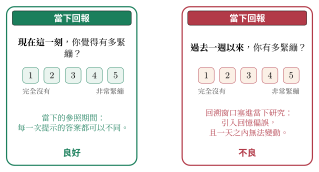
註:示意稿。參照期間是決定性的設計選擇:一道當下題目必須問現在,或問自上一次提示以來的區間,作答才能在一天之內變動,而不是由記憶重建而來。
參照期間之外,還有幾項選擇會塑造當下資料的品質。反應量尺在各次提示之間應該保持一致:視覺類比量尺(visual analog scale)能捕捉細緻的等級,但對受訪者要求較高;少數幾個李克特(Likert)選項在高頻施測下較快也較穩健;兩種格式混用則會破壞可比較性。題目也可以在各次提示之間輪替,保留一組每次都測的固定核心,再搭配偶爾才測的輪替周邊,這是一種計畫性遺漏(planned missingness),以分析複雜度換取負擔的降低(第 6 章)。標準工具的當下版本已廣泛使用,表 3.2列出常見的改編方式;此處最重要的紀律是從一份已驗證的特質工具出發,改寫參照期間與措辭,並明確引用所使用的那一個當下版本,不要假定特質量表的心理計量性質可以直接移轉。表 3.3把這些設計規則收攏成一份檢核表。
表 3.2 常見自陳構念的當下版本改編(示例)。
| 特質構念 | 當下版本的改編 | 參照期間 |
|---|---|---|
| 正向/負向情緒(PANAS 傳統) | 當下情緒形容詞(例如:緊繃、心煩、滿足、愉快) | 「現在這一刻」 |
| 知覺壓力 | 一道或數道當下壓力評估題 | 「現在這一刻」或「自上一次提示以來」 |
| 自尊 | 狀態自尊(例如「現在這一刻,我對自己感覺良好」) | 「現在這一刻」 |
| 反芻思考(rumination) | 當下的重複性思考(momentary repetitive thought) | 「自上一次提示以來」 |
註:表中的措辭僅為示例,不是經認可的工具。請從一份已驗證的特質量表改編,並引用所使用的那一個當下版本;不要假定特質量表的信度與效度會移轉到當下層次。
表 3.3 撰寫當下題目的檢核表。
| 要這樣做 | 要避免 |
|---|---|
| 明確寫出當下的參照期間(「現在這一刻」) | 在當下評估方案中使用回溯窗口(「過去一週以來」) |
| 一道題目只測一個構念 | 一題兩問(double-barreled),例如「緊繃而且擔憂」 |
| 各次提示的反應量尺完全相同 | 在各次提示之間混用視覺類比與李克特格式 |
| 固定一組簡短的核心題,其餘輪替 | 冗長不變的題組,使受訪者疲乏 |
| 在順序效果可能存在時隨機化題目順序 | 固定順序,讓前面的題目促發後面的題目 |
| 引用所使用的當下版本及其證據 | 假定特質量表的心理計量性質可以移轉 |
註:這份檢核表把第 2 章的設計原則落實到單一題目的層次。
3.5 測量恆等性:概念
測量恆等性把第 3.1 節「同一套量尺」那項要求形式化。完整裝置留到第 18 章,但它的邏輯可以用一座梯子掌握,如圖 3.5所示:每往上一階,就多把測量模型的一項特徵限制為跨時點相等,也就多授權一種比較。最底層的形貌恆等性(configural invariance)只要求相同的題目在每個時點都以相同型態負荷到相同的因素上;它確立「測到的是同一個構念」,不授權任何量化比較。往上一階是量尺恆等性(metric invariance),也稱弱恆等性,加上因素負荷量(factor loading)跨時點相等(此處的「量尺」指潛在變項的計量單位,不是第 3.4 節所說的題目反應量尺);潛在變項的量尺此時已跨時點一致,於是授權比較這個構念與其他變項的關聯如何隨時間變化,也授權比較變化的斜率。第三階是截距恆等性(scalar invariance),也稱強恆等性,加上題目截距(item intercept)相等;到了這一階,潛在平均數才可以跨時點比較,「構念水準有所成長」的主張也才站得住腳。最上面一階是嚴格恆等性(strict invariance),也稱殘差恆等性,加上殘差變異數相等,連觀察分數的信度都跨時點相等;實質結論多半不必走到這一階。表 3.4陳述每一階授權什麼、又還不授權什麼。
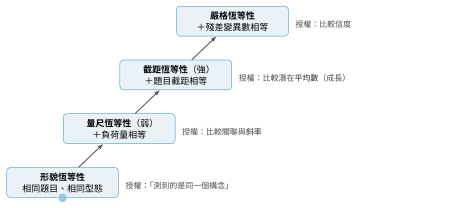
註:概念圖;對應的方程式與檢定出現在第 18 章。較高的階層涵蓋較低的階層。一項研究達到哪一階,決定了哪些跨時點的比較站得住腳。
表 3.4 恆等性層次以及各層次所授權的比較。
| 層次 | 跨時點限制相等 | 授權 | 仍不安全 |
|---|---|---|---|
| 形貌恆等性 | 題目與因素的型態 | 「測到的是同一個構念」 | 任何量化比較 |
| 量尺恆等性(弱) | +因素負荷量 | 比較關聯與變化的斜率 | 比較潛在平均數 |
| 截距恆等性(強) | +題目截距 | 比較潛在平均數(水準的成長) | 比較觀察分數的信度 |
| 嚴格恆等性 | +殘差變異數 | 直接比較觀察分數信度 | – |
註:每一層次都涵蓋表中位於它上方的層次。截距恆等性是解讀「構念平均水準的變化」時的實務門檻。表中短橫線表示該處未列出項目。
縱貫非恆等性(noninvariance)有一些成因是重複測量所特有的。受訪者可能隨著自身發展重新解讀(reinterpret)題目,同樣一段文字在兒童與青少年眼中並不相同。追蹤制約(panel conditioning)(第 2 章)可能改變資深受訪者使用量尺的方式。測量模式改變,例如從紙本改為智慧型手機應用程式,可能改變題目功能(item functioning)。評量情境改變,例如基線在實驗室、追蹤在日常生活中,也可能改變一道題目捕捉到的東西。忽略非恆等性的後果不只是不夠優雅:負荷量或截距實際上漂移了,分析卻假定它們相等,成長的估計值就會有偏誤,一項研究於是把「工具的變化」報告成「構念的變化」。關鍵在於這種偏誤並不限於結構方程模型。研究者若改用多層次成長模型去配適總分,藉此迴避恆等性檢定,並沒有逃離問題;總分只是在未經檢定的情況下假定了嚴格恆等性,也默默繼承了同樣的偏誤。換一個分析框架換不到豁免,第 18 章會用模擬展示這一點。
3.6 衍生個體內指標的信度與效度
密集縱貫研究越來越常把一個人時間序列的某些特徵本身當成分數:以個體內標準差(within-person standard deviation, iSD)測情緒變異性,以連續差異均方根(root mean square of successive differences, RMSSD)測不穩定性,以延宕一期自我相關(lag-1 autocorrelation)(也就是慣性(inertia))測情緒的持續性(這些指標在第 7 章發展)。這些指標從一個人的序列估計而來,信度因此極度依賴時點的數量,依賴的程度遠高於一個簡單平均數。圖 3.6以模擬顯示三個量的信度如何隨每人時點數成長。個人平均數只要四個時點就達到約 \(.70\),到六十個時點超過 \(.95\)。個體內標準差慢得多,大約要十四個時點才越過 \(.70\)。慣性,也就是自我相關,要求最高:十四個時點時信度只有約 \(.34\),要接近 \(.80\) 得等到將近六十個時點。一份為期兩週、每天一次提示的日誌研究,能給出個人平均數的可靠估計,卻只能給出情緒慣性的一個勉強可用的估計。從短序列報告慣性而不承認它的不可靠,是常見而且後果嚴重的錯誤。
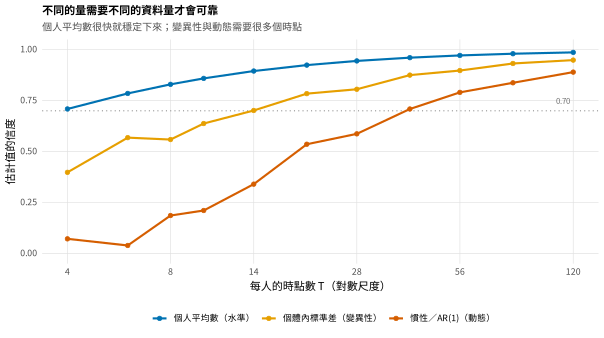
註:模擬。個人平均數(藍色)只要少數時點就變得可靠;個體內標準差(金黃色)需要更多;延宕一期自我相關,也就是慣性(橘紅色),需要很多。點線標示 \(.70\) 的信度。橫軸是每人時點數,不是樣本大小。
變異性指標還有第二個特有的危險:它與平均數糾纏。任何有上下界的反應量尺,可能的變動範圍都受水準限制:當下負向情緒貼近量尺地板的人,不可能表現出和位在量尺中段的人一樣大的標準差,因此觀察到的「平均數與變異性有關聯」可能只是界限造成的數學假象,不是實質發現 (Mestdagh et al., 2018)。這件事很重要,因為情緒變異性經常被當成心理病理的相關變項來研究;症狀水準較高的人若平均數也較高,變異性與症狀之間表面上的連結,就可能是平均數假扮成變異性。補救方式有三:用經平均數校正的變異性指標,例如相對變異性指數(relative variability index);明確控制平均數;或者更好的做法,改採第 16 章那種以模型為基礎的取徑,直接把個體內變異數當成參數估計,同時調整平均數。Dejonckheere et al. (2019) 提出更廣的警告:複雜的動態指標往往在平均數與變異數之外只增添很少的預測訊息,而它們在現實序列長度下的不可靠正是原因之一。圖 3.7比較當下情緒題目在個體間與個體內的相關結構,從另一個角度讓「結構具有層次專屬性」變得鮮明。
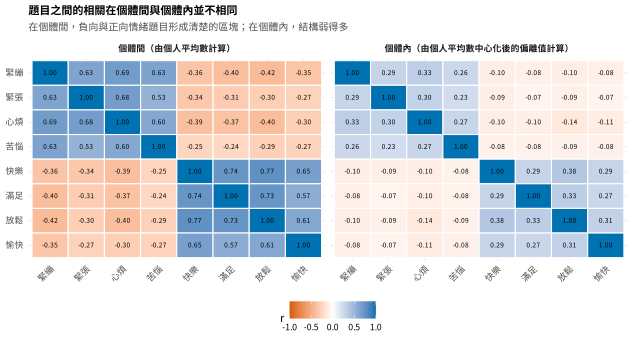
註:affect_ema_items 中八道當下情緒題目之間的相關,分別以個體間(左,由個人平均數計算)與個體內(右,由個人平均數中心化後的偏離值計算)方式求得。在個體間,負向與正向情緒題目形成清楚且相關強烈的區塊;在個體內,同樣的區塊弱得多,這正是個體間與個體內信度會分歧的原因。
3.7 超越自陳
並非所有跨時間的測量都是自陳。活動記錄儀記錄動作並推估睡眠;隨身生理測量記錄心率與心率變異性;智慧型手機與穿戴式感測器記錄位置、活動與通訊(第 2 章)。這些管道避開了自陳的某些問題,特別是反應性與回憶,卻沒有避開測量理論,只是把它搬到別的地方。被動測量與生理測量的關鍵測量決定往前移到同步化與前處理:把不同頻率取樣的資料流對齊到同一個時鐘、決定聚合所依據的時段長度(epoch)、界定什麼算是假訊號(artifact)以及如何處理,還有從原始訊號中選擇抽取哪些特徵。每一項都是測量選擇,對信度與效度的後果和題目措辭一樣真實,因此每一項都要報告,最好還接受穩健性檢驗。被動測量的效度證據也有特定的形式:像「在家時間」這樣的感測器衍生指標,是「退縮」這類心理構念的替代指標(proxy),效度取決於這層替代關係有多強,而這件事必須建立,不能假定 (Fried et al., 2022)。本章的測量原則,也就是同一個構念、同一套量尺、同樣的精確度,以及層次專屬的信度,套用在一串加速度計計數上與套用在一道心情題目上完全一樣,只是建立它們的技術不同。
3.8 以 R 估計信度
上面討論的各種信度都可以用幾行 R 算出來,而看到計算過程能讓它們的意義變得具體。實作範例使用 affect_ema_items 中的四道負向情緒題目。第一項任務是概化理論信度背後的變異數分解:把題目堆疊成長格式,再配適一個對個體、對個體之內的時點、對題目都設隨機效果的交叉隨機效果模型。
library(lme4)
d <- readRDS("Examples/data/affect_ema_items.rds")
na_items <- c("na_tense", "na_nervous", "na_upset", "na_distressed")

# 堆疊成長格式:一列 = 一人 × 一時點 × 一題
long <- reshape(d[, c("person","day","beep", na_items)], varying = na_items,
                v.names = "resp", timevar = "item", times = na_items,
                direction = "long")
long <- long[!is.na(long$resp), ]
long$occ <- interaction(long$person, long$day, long$beep, drop = TRUE)

vc <- as.data.frame(VarCorr(lmer(resp ~ 1 + (1|person) + (1|occ) + (1|item),
                                 data = long)))
s2_p  <- vc$vcov[vc$grp == "person"]     # 個體間,約 0.17
s2_pt <- vc$vcov[vc$grp == "occ"]        # 個體內(狀態),約 0.15
s2_e  <- vc$vcov[vc$grp == "Residual"]   # 題目層次誤差,約 0.53

k <- 4; Tbar <- mean(tapply(!is.na(d$na_tense), d$person, sum))  # 約 61
RkR <- s2_pt / (s2_pt + s2_e / k)                          # 個體內,約 0.53
RkF <- s2_p  / (s2_p + s2_pt/Tbar + s2_e/(Tbar*k))         # 個體間,約 0.97
第二項任務直接由兩層次驗證性因素分析計算個體間與個體內的 omega,許多讀者會覺得這個做法更熟悉。lavaan 的語法在個體內層次指定一個因素、在個體間層次指定一個因素,omega 由各層次的負荷量與殘差變異數算出。
library(lavaan)
model <- "
  level: 1
    fw =~ na_tense + na_nervous + na_upset + na_distressed
  level: 2
    fb =~ na_tense + na_nervous + na_upset + na_distressed
"
fit <- sem(model, data = d, cluster = "person", missing = "listwise")

# 某一層的 omega = (負荷量總和)^2 × 因素變異數 ÷
#                  [ (負荷量總和)^2 × 因素變異數 + 殘差變異數總和 ]
# 以 parameterEstimates(fit) 取出;omega_within 約 .61、omega_between 約 .88
跑完這些程式會確認第 3.3 節報告的數值:個人平均數的個體間信度接近 \(.97\),單一當下分數的個體內信度接近 \(.53\);換成 omega 的語言則是個體間 \(.88\)、個體內 \(.61\)。作為對照,誘人但錯誤的合併 alpha(也就是 psych::alpha(d[na_items]))會回報約 \(.71\),正是上面警告過的無法解讀的混合值。這段程式強制的紀律是:計算任何信度之前必須先選定一個層次,因為沒有任何單一數字描述得了這份量表。
3.9 重複測量的信度報告
如今審查密集縱貫研究的審稿人,會期待信度報告在與每一項主張相配的層次上,只報告單一個 alpha 的方法段會招來詢問。前面各章引入的報告紀律,在信度上有四個對應要素。第一,報告與估計標的相配的信度:分析關心平均水準上的個體間差異,就報告個體間信度;關心個體內的起伏或耦合,就報告個體內信度;兩者都關心,就兩者都報告。第二,指明方法與模型:說明這些係數來自多層次驗證性因素分析還是概化理論的變異數成分,並給出軟體與版本。第三,iSD 或慣性這類衍生指標,要在已達成的時點數之下報告、至少承認它們的信度,不要把它們呈現得和平均數一樣可靠。第四,使用單題的當下測量時,要說明信任它的依據何在,因為單一題目沒有內部一致性信度可言。
把這些要素合起來,針對實作範例中那份負向情緒量表的示範文字可以這樣寫:「四題當下負向情緒量表的信度以兩層次驗證性因素分析估計(lavaan 0.6-x)。個體間信度(個體間 omega)為 \(.88\),表示各參與者的平均水準區分得可靠;個體內信度(個體內 omega)為 \(.61\),表示單一次當下回報區分同一個人不同時點的程度僅屬中等。主要分析關心的是個體內的耦合,相關的係數因此是個體內那一個,而它中等的數值也反映在第 25 章所採用的衰減校正(attenuation correction)之中。」每一個子句都指明了一個層次;凡是提出信度係數的地方,都交代了那是「什麼的信度」。
軟體提示 • 計算多層次信度
有好幾種工具可以計算本章的各個係數,指定方式等價時結果一致。在 R 中,lavaan 配適兩層次 CFA,個體間與個體內 omega 由此算出;semTools 計算組合信度的函式直接支援多層次模型;psych 的 multilevel.reliability(mlr)實作 Cranford 與 Shrout-Lane 的概化係數(\(R_{kF}\)、\(R_{kR}\) 及其相關量),不過時點數很多時它內部的模型可能無法收斂,此時退回用 lme4 的變異數成分自行計算(如第 3.8 節所示)是穩健的備案。misty 套件提供便利的包裝函式。在 Mplus 中,同樣的兩層次 CFA 以 TYPE = TWOLEVEL 指定,各層次的 omega 由模型限制功能算出。無論用哪一種工具,都要報告是哪一個係數、在哪一個層次、來自哪一個模型。
3.10 常見的迷思
有四種看法反覆出現。第一,認為只要有一次 alpha 超過 \(.70\),這份量表就永遠、在每一個層次上都被證成了:信度相對於某個母體、某個時點、某個分析層次,一個個體間的 alpha 對個體內信度什麼也沒說(第 3.3 節)。第二,認為差異分數本質上不可靠,所以變化分數永遠不該使用:差異分數信度低,發出的訊號是變化很同質,不是測量無效,而變化分數依然是不偏的個體內量(見基礎概念方塊;Rogosa et al., 1982)。第三,認為恆等性檢定是結構方程模型的講究,做多層次模型的人可以略過:以成長模型配適總分,等於在未經檢定的情況下假定嚴格恆等性,也繼承同樣的偏誤,換框架換不到豁免。第四,針對那個常被問起的問題「密集評估裡每個構念可以只用一道題目嗎?」:有時可以,條件是構念狹窄、負擔確實是約束,而且有個體內層次的效度證據;但單一題目的個體內信度無法從內部一致性讀出來,必須另行建立。
本章摘要
變化分數要能解讀,前提是工具跨時點維持了同一個構念、同一套量尺與同樣的精確度(圖 3.1);而要維持同一個構念,有時反而必須改變題目,異型連續性就是這種情形。測量一旦重複,信度就不是一個數字:同一份量表有一個把各人平均數排序的個體間信度,也有一個偵測當下狀態的個體內信度,兩者經常分歧,實作範例中的 \(.88\) 對 \(.61\) 就是例子。在堆疊的長格式資料上算 alpha 係數,混合了兩者,因此哪一個都不是。長期被詬病的差異分數信度,反映的是變化的同質程度,不是測量的無效。測量恆等性把「同一套量尺」這項要求形式化為一座階梯,每往上一階就授權更強的比較;違反它會使成長估計值產生偏誤,在多層次與結構方程兩種框架下都一樣。變異性與慣性這類衍生的個體內指標本身也是分數,信度陡峭地依賴時點數,還可能與平均數混淆。請把信度報告在與主張相配的那個層次上。
接下來讀哪裡
本章的線索貫串全書。這裡預告的各種衍生指標在第 7 章發展;差異分數的平反為第 10 章的兩時點方法鋪路;個體內變異數的模型化取徑在第 16 章;測量恆等性的形式機制,連同方程式與一個偏誤模擬,在第 18 章;測量誤差對動態估計值的後果在第 25 章;異型連續性之下連結各年齡專屬測量這件事,則在第 34 章的發展研究應用中再度出現。本章唯一的命令是:每一個信度、每一個比較,都要說出它成立於哪一個層次、哪一個時間尺度。
習題
- 3.1 兩種信度。使用
affect_ema_items,依第 3.8 節的做法計算四道正向情緒題目的個體間信度與個體內信度。解讀兩者的落差,並說明要研究當下正向情緒的動態時,你會報告哪一個係數。 - 3.2 改寫題目。從任何一份已發表的特質量表中取三道回溯式問卷題目,把每一道改寫成帶有明確參照期間的當下題目。請依表 3.3為每一個參照期間的選擇提出理由。
- 3.3 差異分數的代數。由定義推導式 (3.2)。接著計算 \(\rho = .85\)、\(\rho_{12} = .80\) 時的差異分數信度,並寫兩句話向持懷疑態度的審稿人說明,使用這個變化分數的研究為什麼仍然有訊息價值。
- 3.4 恆等性的威脅。你拿到一份為期二十年的自尊追蹤研究,從青少年期到中年期都使用同一份問卷測量。請指出三個可能造成縱貫非恆等性的來源,並針對每一個說明它會危及哪一項比較。
- 3.5 信度與 \(T\)(模擬)。改寫
ch03_figures_zh_V01.R中的模擬,估計延宕一期自我相關的信度如何隨時點數變化。序列要多長才達到 \(.70\)?你的答案對一份為期兩週的每日日誌研究意味著什麼?
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 信度 | reliability | 觀察分數變異數中屬於真分數而非誤差的比例;第 3.2 節 |
| 古典測驗理論 | classical test theory | 觀察分數=真分數+誤差的測量理論;第 3.2 節 |
| 真分數 | true score | 無誤差時應得的分數;第 3.2 節 |
| 同一個構念 | same construct | 各時點測到的是同一件事;第 3.1 節 |
| 同一套量尺 | same metric | 相同分數在各時點代表相同份量;第 3.1 節 |
| 同樣的精確度 | same precision | 各時點分數同樣值得信任;第 3.1 節 |
| 異型連續性 | heterotypic continuity | 構念連續但行為指標隨發展改變;第 3.1 節 |
| 構念連續性 | construct continuity | 潛在構念跨時間持續為同一者;第 3.1 節 |
| 分數可比較性 | score comparability | 原始分數能否跨時點直接相比;第 3.1 節 |
| 定錨題目 | anchor item | 跨年齡皆有效、用於連結量尺的指標;第 3.1 節 |
| 連結 | linking | 把不同題組放到同一條量尺上;第 3.1 節 |
| 差異分數 | difference score | 後測減前測;第 3.2 節 |
| 變化分數 | change score | 差異分數的一般說法;全書 |
| 概化理論 | generalizability theory | 依測量側面分解變異數的理論;第 3.2 節 |
| 可容許觀察的全域 | universe of admissible observations | 觀察分數被視為由此抽出的樣本;第 3.2 節 |
| 側面 | facet | 測量的一個來源維度(個體、時點、題目);第 3.2 節 |
| 變異數成分 | variance component | 歸屬於某一側面的變異數;第 3.2 節 |
| 個體間信度 | between-person reliability | 把人依平均水準排序的可靠程度;第 3.3 節 |
| 個體內信度 | within-person reliability | 偵測當下偏離的可靠程度;第 3.3 節 |
| 交叉隨機效果模型 | crossed random-effects model | 同時對個體、時點與題目設隨機效果;第 3.3 節 |
| 多層次驗證性因素分析 | multilevel CFA | 分層估計因素結構的模型;第 3.3 節 |
| omega 係數 | omega | 由負荷量與殘差算出的組合信度;第 3.3 節 |
| alpha 係數 | coefficient alpha | 內部一致性信度;堆疊資料上不可解讀;第 3.3 節 |
| 內部一致性 | internal consistency | 同一份量表各題目之間的一致程度;第 3.3 節 |
| 當下評估 | momentary assessment | 詢問「此刻」狀態的測量;第 3.4 節 |
| 參照期間 | reference period | 題目所詢問的時間範圍;第 3.4 節 |
| 視覺類比量尺 | visual analog scale | 連續滑桿式反應量尺;第 3.4 節 |
| 一題兩問 | double-barreled item | 一道題目同時問兩件事;第 3.4 節 |
| 計畫性遺漏 | planned missingness | 刻意讓部分題目在部分時點不施測;第 3.4 節 |
| 測量恆等性 | measurement invariance | 測量模型的參數跨時點是否相等;第 3.5 節 |
| 形貌恆等性 | configural invariance | 題目與因素的型態相同;第 3.5 節 |
| 量尺恆等性(弱) | metric / weak invariance | 加上因素負荷量相等;第 3.5 節 |
| 截距恆等性(強) | scalar / strong invariance | 加上題目截距相等;第 3.5 節 |
| 嚴格恆等性 | strict / residual invariance | 加上殘差變異數相等;第 3.5 節 |
| 部分恆等性 | partial invariance | 只有部分參數跨時點相等;第 3.1 節 |
| 非恆等性 | noninvariance | 恆等性不成立的狀態;第 3.5 節 |
| 因素負荷量 | factor loading | 題目與潛在因素的關聯強度;第 3.5 節 |
| 題目截距 | item intercept | 潛在分數為零時的題目期望值;第 3.5 節 |
| 殘差變異數 | residual variance | 未被因素解釋的題目變異數;第 3.5 節 |
| 潛在平均數 | latent mean | 潛在變項的平均數;第 3.5 節 |
| 重新解讀 | reinterpret / reinterpretation | 受訪者對同一題目的理解隨時間改變;第 3.5 節 |
| 個體內標準差 | within-person standard deviation (iSD) | 個人序列的標準差;第 3.6 節 |
| 連續差異均方根 | root mean square of successive differences (RMSSD) | 相鄰時點變動幅度的指標;第 3.6 節 |
| 慣性 | inertia | 延宕一期自我相關;情緒的持續性;第 3.6 節 |
| 相對變異性指數 | relative variability index | 經平均數校正的變異性指標;第 3.6 節 |
| 時段長度 | epoch | 被動訊號聚合所依據的時間單位;第 3.7 節 |
| 假訊號 | artifact | 非目標來源造成的訊號;第 3.7 節 |
| 替代指標 | proxy | 以可測量的量代表目標構念;第 3.7 節 |
| 衰減校正 | attenuation correction | 針對測量誤差造成的低估加以校正;第 3.9 節 |
參考文獻
Cranford, J. A., Shrout, P. E., Iida, M., Rafaeli, E., Yip, T., & Bolger, N. (2006). A procedure for evaluating sensitivity to within-person change: Can mood measures in diary studies detect change reliably?. Personality and Social Psychology Bulletin, 32(7), 917–929. https://doi.org/10.1177/0146167206287721
Cronbach, L. J., & Furby, L. (1970). How we should measure “change”: Or should we?. Psychological Bulletin, 74(1), 68–80. https://doi.org/10.1037/h0029382
Cronbach, L. J., Gleser, G. C., Nanda, H., & Rajaratnam, N. (1972). The dependability of behavioral measurements: Theory of generalizability for scores and profiles. Wiley.
Dejonckheere, E., Mestdagh, M., Houben, M., Rutten, I., Sels, L., Kuppens, P., & Tuerlinckx, F. (2019). Complex affect dynamics add limited information to the prediction of psychological well-being. Nature Human Behaviour, 3(5), 478–491. https://doi.org/10.1038/s41562-019-0555-0
Fried, E. I., Flake, J. K., & Robinaugh, D. J. (2022). Revisiting the theoretical and methodological foundations of depression measurement. Nature Reviews Psychology, 1(6), 358–368. https://doi.org/10.1038/s44159-022-00050-2
Geldhof, G. J., Preacher, K. J., & Zyphur, M. J. (2014). Reliability estimation in a multilevel confirmatory factor analysis framework. Psychological Methods, 19(1), 72–91. https://doi.org/10.1037/a0032138
Horn, J. L., & McArdle, J. J. (1992). A practical and theoretical guide to measurement invariance in aging research. Experimental Aging Research, 18(3), 117–144. https://doi.org/10.1080/03610739208253916
Meredith, W. (1993). Measurement invariance, factor analysis and factorial invariance. Psychometrika, 58(4), 525–543. https://doi.org/10.1007/BF02294825
Mestdagh, M., Pe, M. L., Pestman, W., Verdonck, S., Kuppens, P., & Tuerlinckx, F. (2018). Sidelining the mean: The relative variability index as a generic mean-corrected variability measure for bounded variables. Psychological Methods, 23(4), 690–707. https://doi.org/10.1037/met0000153
Nezlek, J. B. (2017). A practical guide to understanding reliability in studies of within-person variability. Journal of Research in Personality, 69, 149–155. https://doi.org/10.1016/j.jrp.2016.06.020
Rogosa, D. R., Brandt, D., & Zimowski, M. (1982). A growth curve approach to the measurement of change. Psychological Bulletin, 92(3), 726–748. https://doi.org/10.1037/0033-2909.92.3.726
Schuurman, N. K., & Hamaker, E. L. (2019). Measurement error and person-specific reliability in multilevel autoregressive modeling. Psychological Methods, 24(1), 70–91. https://doi.org/10.1037/met0000188
Widaman, K. F., Ferrer, E., & Conger, R. D. (2010). Factorial invariance within longitudinal structural equation models: Measuring the same construct across time. Child Development Perspectives, 4(1), 10–18. https://doi.org/10.1111/j.1750-8606.2009.00110.x
Willett, J. B. (1988). Questions and answers in the measurement of change. Review of Research in Education, 15, 345–422. https://doi.org/10.3102/0091732X015001345
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。