第 24 章
單一受試者的時間序列分析
前一章用了許多人身上的許多次測量,問的說到底仍是一個以「跨人彙整」來回答的個體內問題。本章把鏡頭收到一個人身上,而且拒絕彙整。密集地測量一個人:一位每天接受監測的臨床病人、一位人格研究者手上的單一個案、一位連續數週每天取樣多次的參與者,所得到的那條序列本身就是正當的分析對象。分析它的工具,是物理科學與經濟科學的古典時間序列(time series)方法,引進心理學之後再彎折來配合心理學的資料。這道引進正是本章的主題。計量經濟學(econometrics)的序列長,心理學的短;它們乾淨,心理學的有雜訊(noise);它們完整,心理學的有遺漏;它們不受限,心理學的有界。每一項古典假設(assumption)都在這些事實面前繃到極限。本章誠實地教這套核心做法:弱定態性(weak stationarity)是承重的前提,自我相關函數(autocorrelation function)與偏自我相關函數(partial autocorrelation function)是歷程的指紋,自我迴歸(autoregression)係數是心理上的延續而不是要掃掉的干擾項(nuisance),中斷時間序列(interrupted time series)是讓一個人成為自己控制組的設計,而 P 技術因素分析(P-technique factor analysis)是個殊取向(idiographic)綱領的歷史根源,那個綱領由第 25 到 28 章接力往前推。本章最後落在一個問題上,每一位手上有密集資料的讀者都必須面對它,卻很少有人把它問出聲:序列要多長,上面這一切才可信?
學習目標
讀完本章之後,你應該能夠:(1) 定義弱定態性,並診斷趨勢(trend)、週期(cycle)與變異數移位(variance shift)這三種違反,既用滾動統計量(rolling statistics)作目視(visual)診斷,也用 ADF 與 KPSS 檢定,同時認清這兩個檢定在心理學的序列長度下檢定力(power)很低;(2) 把自我相關函數與偏自我相關函數讀成指紋,用來指認候選的自我迴歸移動平均(autoregressive-moving-average)結構;(3) 配適並檢查 AR、MA 與 ARMA 模型,以正確的自由度(degrees of freedom)用 Ljung-Box 檢定判斷殘差(residual)漂白了沒有,並在心理學上把參數讀成慣性(inertia),以及透過複數根(complex roots)讀成振盪(oscillation);(4) 分辨差分(differencing)與去趨勢(detrending),並說出各自回答哪一個心理學問題;(5) 為單一個案的介入評估分析一條中斷時間序列,在誤差自我相關的情況下估計水準變化與斜率變化,並誠實面對小樣本推論的問題;(6) 執行一次 P 技術因素分析,說清楚它對「因人而異的結構」的洞見,以及它在序列依賴(serial dependence)上的瑕疵,並指出修補它的是第 26 章的動態因素模型(dynamic factor model);(7) 說出這些方法需要多長的序列,並可信地報告一份單一受試者的分析。
24.1 為什麼要認真研究一個人
個殊取向的主張在第 1 章引入,現在要讓它站得住腳:一個重複測量過的人不是檢定力不足的「\(n=1\) 樣本」,而是一個在時間中的母體(population);這個人的歷程結構是科學標的,任何數量的個體間資料都構不到它。有三個研究綱領把這項主張變得具體。臨床監測跨數天或數週追蹤一位病人的症狀,用來偵測惡化、評估治療、調整照護,這種用法在單一個案實驗設計(single-case experimental design)裡有很長的歷史,如今在數位表現型分析(digital phenotyping)中正在成長 (Borckardt et al., 2008)。人格與情緒研究把人當成一個動態系統(dynamic system),這個系統的調節傾向,也就是情緒多快回到基線(baseline)、會不會衝過頭再擺盪回來,是只有在人之內跨時間才量得到的個別差異(individual differences)構念 (Kuppens et al., 2010; Suls et al., 1998)。個殊取向傳統裡的理論檢驗,則把類推(generalization)看成跨人的系統性複製(systematic replication),不是跨人的彙整:一項發現先在一個人身上成立、又在另一個人身上重現,才取得地位。這正是第 25 章要改寫成多層次模型隨機效果的那套邏輯,也就是在單一個配適好的物件裡跑一場關於人的後設分析(meta-analysis)。
這件事要緊的地方,也是個殊取向綱領不只是一種方法學偏好的地方,在於個體間的結構與個體內的結構不必然一致。跨人估計的因素模型(factor model)描述的是個體彼此之間如何不同;在一個人身上跨時點估計的因素模型,描述的是這個人的狀態如何隨時間一起移動。遍歷性(ergodicity)定理精確地指出,兩者只有在特定條件之下才會重合,那些條件是定態性與母體內的同質性(homogeneity),而心理歷程(process)經常違反它們 (Molenaar, 2004; Molenaar & Campbell, 2009)。條件不成立時,群體層次的結構就不是個體的摘要,而是另一個物件,跨層次的推論並不合法。兩個層次確實不同、由群體到個體的可推論性(group-to-individual generalizability)不能假定,這樣的實徵示範正是那份宣言(manifesto)兌現出來的價值 (Beltz et al., 2016; Fisher et al., 2018),也是「就這個人自己的樣態去分析這個人」的思想憲章。
把古典的那套做法引進來之前,它的假設得先拿去和心理學實際產出的資料掂量。圖 24.1 把一條心理學序列擺在一條計量經濟學序列旁邊。計量經濟學的序列很長,經常是數百到數千個等距(equally spaced)的觀察值,以高信度(reliability)的儀器測得,缺口很少。心理學的序列很短,一項典型的密集研究是五十到數百個時點;雜訊大,被錯過的提示(beep)與跳過的日子打斷;量在有界的量尺上,於是出現地板(floor)與天花板(ceiling);而且具反應性(reactive),因為測量這個動作本身就可能改變被測的東西。古典工具搬得過來,但它們的大樣本(large-sample)依據在心理學的長度下站不太住,定態性假設在發展性的漂移(drift)面前繃得很緊,完整資料的推導在遺漏面前撐不起來。本章反覆的紀律是:每一件工具都用,每一次都把這道引進在哪裡變弱講明白。
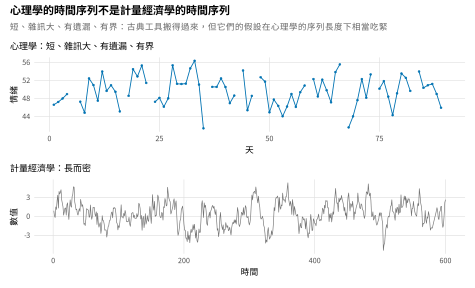
註:上:一個人九十天的負向情緒,短、雜訊大、有界,錯過的日子以缺口呈現。下:一條長、乾淨、密集取樣的序列,古典時間序列方法正是為這種序列建起來的。本章的方法為下面那條推導出來,卻用在上面那條身上;它們的假設只有小心才搬得過來。
本章的示範序列是 mood_ts,一個人在零到一百的量尺上一百八十天的每日負向情緒報告。這條序列是模擬出來的,資料生成歷程(data-generating process)因此已知,而且刻意攜帶本章要教的每一個現象:基線是一個帶複數根的定態二階自我迴歸,於是這個人的情緒會把自己帶向下一刻,並且輕輕地振盪;第九十一天種下一次介入(intervention),形式是立即的水準(level)下降加上其後斜率(slope)的改變;第一百五十一天再種下創新(innovation)變異數的一次後期移位,那種不定態留給第 32 章處理,在這裡只用來當作定態性診斷必須抓得到的東西。知道真相,就能拿每一個估計值去對照產生它的那個數值,這正是本書自始至終要求自己的標準。
24.2 定態性:那個承重的概念
接下來幾乎每一件事都預設了弱定態性,用它之前值得把這個概念說精確。一條序列滿足三個條件就是弱定態的,或說共變數定態(covariance stationary):平均數不隨時間而變、變異數不隨時間而變、兩個時點之間的自我共變數(autocovariance)只取決於兩者相隔的延宕(lag),不取決於它們落在序列的哪個位置。定態性是承重的,不是一項技術細節,因為整套關於動態的詞彙,自我迴歸係數、自我相關函數、衝擊(shock)逐漸消退這個概念,都由「假定在整條序列上恆定」的量所定義。平均數若在游移,把序列迴歸到它自己的過去上,會把那份游移和延續混在一起,報出一個其實是趨勢的慣性;變異數若移位了,單一個自我迴歸係數會把兩個本該分開描述的體制(regime)平均起來。在一條不定態的序列上估計動態,不只是損失效率(efficiency),而是估了一個並不存在的參數。
診斷從眼睛開始,不從檢定開始。滾動平均數(rolling mean)與滾動標準差在一個移動的窗(window)裡算出來,這正是第 9 章的移動窗統計量(rolling-window statistics);把它們疊在序列上,在心理學的長度下比任何正式程序都更可靠地揭露游移的水準或改變中的散布。圖 24.2 是一組畫廊(gallery),收了分析者必須學會用眼睛分辨的四種情況:滾動平均數與散布都平坦的,是定態序列;滾動平均數往上爬的,是有趨勢序列;滾動平均數守得住、滾動散布卻變寬的,是變異數移位;水準在中途跳一級的,是體制轉換(regime switching)。每一種要求不同的回應,而回應取決於估計標的(estimand),下文會展開。
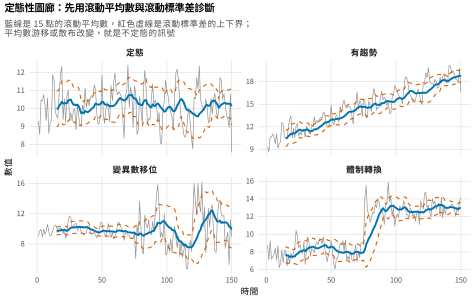
註:每一格畫出一條序列(灰)與它十五點的滾動平均數(藍)與滾動散布(紅色虛線帶)。滾動平均數與散布都平坦表示定態;平均數往上爬表示有趨勢;帶寬變寬表示變異數移位;平均數出現階梯表示體制轉換。目視診斷先於正式檢定。
正式檢定排在第二位,而且最好成對使用,因為兩個標準檢定的虛無假設(null hypothesis)剛好相反。增廣 Dickey-Fuller 檢定(augmented Dickey-Fuller test, ADF)以不定態、也就是單根(unit root)為虛無,拒絕之後倒向定態;KPSS 檢定以定態為虛無,拒絕之後倒向不定態。兩個一起跑,可以互相佐證:ADF 拒絕而 KPSS 不拒絕,兩者都指向定態。也可以互相衝突:兩個都不拒絕,這在短序列上很常見,而它只說明資料對這個問題沒有提供訊息。在 mood_ts 的基線區段上,ADF 統計量(statistic)是 \(-7.02\),對照百分之五的臨界值(critical value) \(-2.88\),果斷地拒絕了單根;KPSS 統計量是 \(0.050\),對照百分之五的臨界值 \(0.463\),離拒絕定態還很遠。兩個檢定一致,而這裡的一致可信,因為基線本來就以定態歷程生成。同樣長度的真實資料上,不該期待它們這麼乾淨地一致。
本節欠讀者一句誠實話,關乎檢定力。單根檢定是為數百到數千個觀察值的經濟序列設計的,在心理學的長度下檢定力嚴重不足:序列即使真的是定態的,檢定也經常無法拒絕單根。一項小型模擬(simulation)把這項失敗變成數字。生成帶中等自我迴歸係數的定態一階自我迴歸(first-order autoregressive, AR(1))序列再施以 ADF 檢定,在 \(T=30\) 時正確拒絕單根的機率只有 \(0.47\),在 \(T=50\) 升到 \(0.88\),要到 \(T=100\) 才接近確定。因此在許多日記研究的長度下,ADF 檢定不拒絕幾乎不帶訊息,證據的重量大部分由目視診斷承擔。這是本章數個「以模擬產出、而非以斷言給出」的數字中的第一個;它們告訴讀者的,是教科書只用定性語言說過的事。
心理學資料中不定態的來源可以對應到補救方式,而補救方式由估計標的決定,不是為了統計上的方便而選,表 24.1 把它們列出來。線性或曲線趨勢,例如情緒在一個學期之中變好,來自一個緩慢的發展歷程騎在波動(fluctuation)底下。波動若是標的,就以去趨勢移除趨勢,也就是把序列迴歸到時間上再分析殘差,這保住了原尺度上的波動動態;變化本身若是標的,就要把趨勢建模,不是把它移除。一個緩慢的週期,例如每日序列中的一週節律(rhythm),在短窗之內是不定態的,但處理它的方式是用第 23 章的正弦與餘弦項把週期建模,不是差分。變異數移位或體制改變的訊號,是這條序列由不只一個歷程生成,恰當的回應是把變化點(change point)明白地建模,那是第 32 章的主題,而不是硬把單一個定態模型套過斷點。差分,也就是把每一個值換成它相對於前一時點的變化,是計量經濟學面對趨勢的反射動作,但它索取的心理學代價下一節會說清楚:應該少用,而且要說出理由。
表 24.1 不定態:違反、診斷、補救,以及對估計標的的後果。
| 違反 | 診斷 | 補救 | 對估計標的的後果 |
|---|---|---|---|
| 線性或曲線趨勢 | 滾動平均數往上爬或彎曲;ACF 衰減得非常慢 | 若波動是標的就去趨勢;若變化是標的就把趨勢建模 | 去趨勢保住波動這個估計標的;差分把它換成變化分數的動態 |
| 緩慢週期(每週、日內) | 滾動平均數呈週期;ACF 在週期處出現高峰 | 以正弦餘弦項建模(第 23 章) | 週期成為被建模的成分,不再是 AR 估計值的汙染物 |
| 變異數移位 | 滾動散布變寬或變窄;水準大致不變 | 把變化點建模(第 32 章);把序列切段 | 單一個 AR 變異數會把兩個體制平均掉,哪一個都描述不了 |
| 體制轉換(水準跳階) | 滾動平均數出現階梯;兩個平台 | 變化點模型或介入模型(第 24.4 節;第 32 章) | 一個定態模型橫跨斷點,估的是一個不存在的共同歷程 |
| 單根(隨機趨勢) | ADF 不拒絕;KPSS 拒絕;ACF 在所有延宕都接近 1 | 在排除上述其他可能之後差分一次 | 差分回答的是變化的動態,不是水準的動態 |
註:補救由估計標的決定,不由檢定決定。去趨勢與差分都移除趨勢,但留下的序列不同,回答的問題也不同。ADF 與 KPSS 的虛無假設相反,要一起讀。
基礎概念 • AR(1) 的半衰期與 AR(2) 的定態三角形
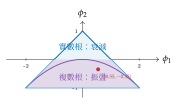
對一個定態的一階自我迴歸 \(x_t = \phi\, x_{t-1} + \varepsilon_t\)(\(|\phi|<1\))而言,這個歷程的平均數為零、變異數為 \(\sigma^2_\varepsilon/(1-\phi^2)\),延宕 \(k\) 的自我相關為 \(\rho_k = \phi^{k}\),所以自我相關以幾何級數衰減。時點 \(t\) 的一單位衝擊,對 \(k\) 步之後的序列貢獻 \(\phi^{k}\);那份貢獻降到一半所需的步數,也就是一次擾動(perturbation)的半衰期(half-life),是 \(h = \ln(0.5)/\ln|\phi|\)。半衰期把一個抽象的係數變成一句臨床工作者用得上的話:\(\phi=0.5\) 時一次衝擊一步就消掉一半,\(\phi=0.8\) 時大約三步,\(\phi=0.95\) 時大約十四步。對二階歷程 \(x_t = \phi_1 x_{t-1} + \phi_2 x_{t-2} + \varepsilon_t\) 而言,定態要求這對係數落在一個三角形之內:\(\phi_1+\phi_2<1\)、\(\phi_2-\phi_1<1\)、\(\phi_2>-1\)。三角形之內,拋物線(parabola) \(\phi_2 = -\phi_1^2/4\) 以下的區域產生複數根,因而給出一段阻尼(damped)振盪而不是平滑的衰減,這就是「衝過頭再回來」在代數上的來源,而情緒動態的研究者把它讀成調節(regulation)。下圖中的那個點標出的是示範序列的真值,落在振盪區。
24.3 ARMA 工具箱
一階自我迴歸是本章在心理學上的主力,它的係數是本章的核心量,值得在代數堆積起來之前先把解讀釘住。在 \(x_t = \phi\, x_{t-1} + \varepsilon_t\) 裡,係數 \(\phi\) 就是慣性,也就是這個人此刻的狀態有多少從緊接著的前一刻延續下來;情緒動態文獻把它讀成情緒調節的遲滯,一種情緒傾向於持續、而不是快速回到基線的性質 (Kuppens et al., 2010; Suls et al., 1998)。基礎概念方塊推導出來的半衰期,把這個係數變成一句關於「一次擾動會留多久」的臨床陳述。圖 24.3 畫出 \(\phi\) 為零、十分之四與十分之八的三條模擬序列,並標上半衰期,視覺上的教訓立刻成立:零時序列是白雜訊(white noise),沒有記憶;十分之四時一次衝擊一步之內就消掉一半;十分之八時擾動堆疊成緩慢而持久的擺盪。較舊的方法學文獻把自我相關當成要修正掉的干擾項,在這裡它就是發現。
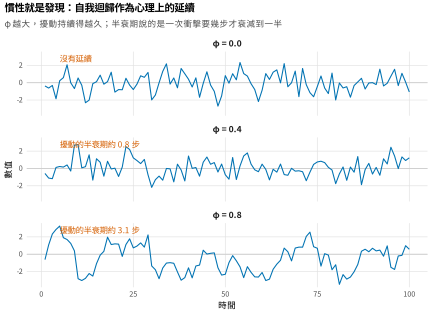
註:三條 AR(1) 序列,\(\phi=0\)、\(0.4\) 與 \(0.8\)。\(\phi\) 越大,擾動持續得越久,看得見的是更慢、更持續的擺盪;標註的半衰期給出一次衝擊衰減到一半所需的步數。自我迴歸係數是一項實質的個別差異,不是統計上的干擾項。
擴充到二階,就容許了一種性質上全新的行為。在 \(x_t = \phi_1 x_{t-1} + \phi_2 x_{t-2} + \varepsilon_t\) 裡,一個夠大的負二階係數會讓特徵多項式(characteristic polynomial)有複數根,而複數根使自我共變數振盪:序列衝過它的平均數、擺盪回來、往另一邊再衝過頭,然後安定下來,是一段阻尼的節律,不是平滑的回歸。示範序列以 \(\phi_1=0.55\) 與 \(\phi_2=-0.35\) 建起來,這一對落在定態三角形之內、複數根拋物線之下,給出週期接近 \(5.8\) 天的阻尼振盪。圖 24.4 畫出一條實現(realization),而心理學上的讀法就是情緒動態的那一套:一個人的情緒不只往前延續,還傾向於矯正過頭,那正是一個會衝過頭的調節系統的招牌。第 32 章會把這段振盪寫成明白的微分方程(differential equation)形式,也就是一個阻尼線性振盪子(damped linear oscillator);在這裡它是二階自我迴歸在心理學上最有意思的一張臉。
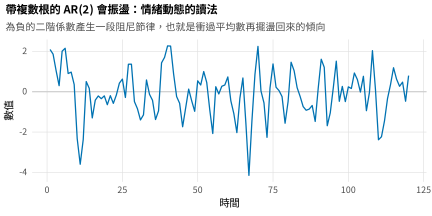
註:一個二階自我迴歸,\(\phi_1=0.55\)、\(\phi_2=-0.35\)。為負的二階係數給出複數根與一段週期接近六個時點的阻尼振盪,也就是一種衝過平均數再擺盪回來的傾向,情緒研究者把它解讀為一項調節上的動態。
移動平均(moving average)歷程描述的是另一種互補形式的記憶。在 \(x_t = \varepsilon_t + \theta\, \varepsilon_{t-1}\) 裡,此刻依賴的不是過去的狀態而是過去的衝擊,於是一次擾動只持續固定個數的時點然後乾淨地消失,與自我迴歸的幾何式淡出形成對比。混合的 ARMA 歷程把兩者結合起來,而對大多數心理學的用途而言,一個低階的 AR 或 ARMA 就夠了。挑選階數的古典策略,也就是 Box-Jenkins 法,是把自我相關函數與偏自我相關函數讀成指紋 (Box et al., 2015)。階數為 \(p\) 的自我迴歸,偏自我相關在延宕 \(p\) 之後乾脆地截斷,自我相關則遞減;階數為 \(q\) 的移動平均,自我相關在延宕 \(q\) 之後截斷,偏自我相關則遞減;混合歷程兩個函數都拖尾(tail off)。圖 24.5 展示四種標準指紋,表 24.2 陳述產生它們的辨識規則。
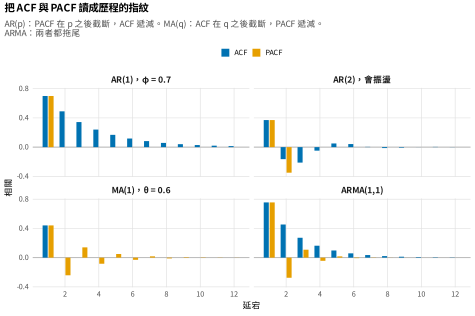
註:四個歷程理論上的自我相關(藍)與偏自我相關(橘)。AR(\(p\)):偏自我相關在延宕 \(p\) 之後截斷,自我相關遞減。MA(\(q\)):自我相關在延宕 \(q\) 之後截斷,偏自我相關遞減。ARMA:兩者都拖尾。這些指紋就是 Box-Jenkins 辨識捷思(heuristic)的視覺形式。
表 24.2 ACF 與 PACF 的辨識指紋。
| 歷程 | 自我相關(ACF) | 偏自我相關(PACF) | 讀法 |
|---|---|---|---|
| AR(\(p\)) | 遞減(幾何式或阻尼正弦式) | 在延宕 \(p\) 之後截斷 | 由 PACF 的截斷點讀出階數 \(p\) |
| MA(\(q\)) | 在延宕 \(q\) 之後截斷 | 遞減 | 由 ACF 的截斷點讀出階數 \(q\) |
| ARMA(\(p,q\)) | 在延宕 \(q\) 之後拖尾 | 在延宕 \(p\) 之後拖尾 | 兩者都不截斷;改用訊息準則 |
| 白雜訊 | 所有延宕都接近零 | 所有延宕都接近零 | 沒有序列結構 |
| 不定態 | 衰減得非常慢,接近 1 | 在延宕 1 有一根大突起 | 先差分或去趨勢 |
註:「截斷對遞減」這組對比是 Box-Jenkins 辨識的捷思核心。在短序列上這兩個函數的抽樣變異很大,視覺上的指紋應該再以訊息準則的比較佐證,不能單獨信賴。
用眼睛辨識是一項捷思,不是一項證明,而在心理學的長度下它很脆弱,因為樣本(sample)自我相關的抽樣變異(sampling variability)大到足以把「截斷(cut off)對遞減」這個區分抹糊。現代的補充是以訊息準則(information criteria)選模,配適一小組候選階數再以 AIC 或 BIC 比較,但要留意短序列上這些準則會很樂意過度配適(overfit),選出複製不出來的假移動平均項。示範的配適同時說明了它的潛力與那項告誡。在 mood_ts 九十天的基線區段上,樣本偏自我相關在延宕 1 有一根 \(0.31\) 的突起(spike)、在延宕 2 有第二根 \(-0.24\);延宕 12 還有一次 \(-0.26\) 的偏離跨出雜訊帶(noise band),但十五個延宕一起看,這種大小靠機遇就會出現。這正是 AR(2) 的指紋,而訊息準則也同意:AR(2) 模型取得最低的 AIC(\(458.2\))與最低的 BIC(\(468.2\)),勝過 AR(1)(\(461.7\)、\(469.2\))與 ARMA(1,1)(\(460.1\)、\(470.1\))。配適出來的係數是 \(0.38\) 與 \(-0.24\),相對於生成的 \(0.55\) 與 \(-0.35\) 有衰減,但正負號與大小級數都對;衰減是「只用九十個觀察值去估一個二階結構」該付的預期代價,而它隱含的 \(5.4\) 天振盪週期,還原了種下去的 \(5.8\)。這份衰減不是程式錯誤,而是估計式在心理學的長度下誠實的行為,它預告了第 24.6 節。
估計與檢查完成整段弧線。參數可以用條件或完全最大概似(maximum likelihood)配適,兩者在這種長度下差別可以忽略;配適好的模型要靠「它有沒有把序列漂白(whiten)」來判斷,也就是殘差有沒有留下任何序列結構。Ljung-Box 綜合(portmanteau)檢定把殘差的各個自我相關匯總成一個統計量,而那個關鍵的細微之處,也是應用工作中最常被搞砸的一處,是它的自由度必須扣掉估計出來的自我迴歸與移動平均參數個數,因為那些參數已經吸收掉一部分自我相關。對這個 AR(2) 配適而言,殘差的 Ljung-Box 檢定在校正過的自由度下回傳 \(p=0.93\),沒有殘餘結構的證據,模型予以保留。自由度若沒有校正,這個檢定就會過於寬鬆(anticonservative),太容易宣告殘差是白的。下面這段程式在基線區段上走完整段弧線,從定態性檢查到辨識、到配適、到殘差診斷。
# 在一個人的基線情緒序列上走完 Box-Jenkins 這一段
d <- readRDS("Examples/data/mood_ts.rds")
base <- d$y[d$phase == "baseline"]        # T = 90 天

# 1. 定態性:先用眼睛,再用成對的檢定
plot.ts(base)                              # 目視滾動平均數與散布
adf_test(base); kpss_test(base)            # ADF 拒絕單根;KPSS 不拒絕

# 2. 辨識:把 ACF 與 PACF 當指紋
acf(base, lag.max = 15); pacf(base, lag.max = 15)   # PACF 在延宕 2 截斷

# 3. 選模:以訊息準則比較候選階數
fit1 <- arima(base, order = c(1,0,0))      # AR(1)
fit2 <- arima(base, order = c(2,0,0))      # AR(2):AIC 與 BIC 最低
fitm <- arima(base, order = c(1,0,1))      # ARMA(1,1)
AIC(fit1, fit2, fitm); BIC(fit1, fit2, fitm)

# 4. 解讀:phi 是慣性,複數根是振盪
coef(fit2)                                 # ar1 約 0.38,ar2 約 -0.24
# 阻尼振盪的週期,單位為天:
2*pi / acos( coef(fit2)[1] / (2*sqrt(-coef(fit2)[2])) )   # 約 5.4

# 5. 檢查:以校正過的自由度看殘差是否為白
Box.test(residuals(fit2), lag = 10, type = "Ljung-Box", fitdf = 2)   # p = 0.93
還有兩件事使工具箱完整:差分與去趨勢之間的選擇,以及遺漏時點的處理。趨勢存在時,分析者可以用差分把它移掉,分析時點到時點的變化,也可以用去趨勢把它移掉,迴歸到時間上再分析殘餘的波動。兩者不可互換,因為它們回答不同的問題,也留下不同的序列。圖 24.6 把同一條有趨勢的序列走過兩條路,並畫出它們的自我相關函數。原始序列在延宕 1 的自我相關接近 \(0.95\),那是趨勢造成的假象(artifact);去趨勢之後回到 \(0.31\),那是真正的波動動態;差分之後是 \(-0.37\),一個負的自我相關,正是過度差分(overdifferencing)的指紋,也就是把一個水準歷程換成了變化歷程,於是問題也由「這個人的情緒如何波動」換成了「這個人的日與日之間的變化如何彼此相關」。對一個心理學上的波動問題而言,去趨勢幾乎總是正確的路;差分應該保留給真有隨機趨勢的序列,而且要說出理由。
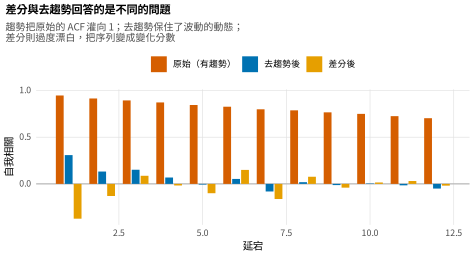
註:同一條有趨勢的序列在保持原樣(紅)、去趨勢(藍)與差分(橘)三種處理下逐延宕的自我相關。趨勢把原始的自我相關灌向 1;去趨勢還原了波動動態;差分則過度漂白,落到延宕 1 為負的自我相關,那是一條變化分數序列在回答另一個問題的印記。
遺漏的時點在心理學序列中無所不在,天真的做法在這裡造成的損害也最不容易察覺。那個誘人的補救,也就是以相鄰兩點之間的線性內插(interpolation)填掉每一個缺口,會製造出自我相關,因為一個內插出來的值按其構造就是周圍的平滑混合,比一個真實的觀察值更像它的鄰居。圖 24.7 在示範序列上呈現這份膨脹:完整序列在延宕 1 的自我相關是 \(0.42\),刪掉一部分時點再以內插填補之後升到 \(0.57\),表面上的慣性虛增了三分之一。方法上正確、又不會扭曲動態的處理,是保留缺口,讓一個狀態空間模型(state-space model)透過卡爾曼濾波器(Kalman filter)去處理它們,那是第 26 章的主題;退一步的最低要求,是在觀察到的時點上以一個尊重遺漏機制(missingness mechanism)的概似函數(likelihood function)去配適模型,而不是憑空造資料把缺口填起來。
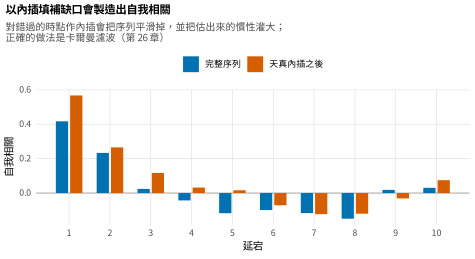
註:完整序列(藍)與同一條序列在刪除若干時點並以線性內插填補之後(紅)逐延宕的自我相關。內插把序列平滑掉,並把估出來的慣性膨脹,這裡讓延宕 1 的自我相關由 \(0.42\) 升到 \(0.57\)。卡爾曼式的處理(第 26 章)才是正確的替代方案。
表 24.3 把 ARMA 家族的參數與本章堅持每個參數都必須攜帶的心理學語意收在一起:一個沒有附上意義就報出來的係數,審查者評估不了,臨床工作者也用不上。
表 24.3 ARMA 參數的解讀對照表。
| 參數 | 統計上的意義 | 心理學上的語意 |
|---|---|---|
| \(\phi_1\)(AR1) | 延宕 1 的自我迴歸 | 慣性或延續:此刻的狀態有多少從上一個時點持續下來;半衰期 \(\ln(0.5)/\ln|\phi_1|\) |
| \(\phi_2\)(AR2) | 延宕 2 的自我迴歸 | 與 \(\phi_1\) 一起決定歷程是平滑衰減還是振盪;落在拋物線以下、為負的 \(\phi_2\) 給出調節上的衝過頭 |
| \(\theta\)(MA1) | 延宕 1 的移動平均 | 衝擊的持續:一次性的擾動在消散之前被感受多久,與狀態自己的記憶無關 |
| \(\sigma^2_\varepsilon\) | 創新變異數 | 時時刻刻的易變性:進入系統的不可預測擾動有多大 |
| 複數根 | AR 多項式的根落在實數線之外 | 阻尼振盪:衝過頭再回來;週期為 \(2\pi/\arccos(\phi_1/2\sqrt{-\phi_2})\) |
| 半衰期 | \(\ln(0.5)/\ln|\phi|\) | 一次擾動衰減到一半所需的時點數;把慣性翻譯給臨床工作者的說法 |
註:每一個參數都要連同它的心理學讀法一起報告。自我迴歸係數是個別差異構念,不是干擾項的修正;創新變異數是易變性;複數根是調節上的振盪。
軟體提示 • R 的時間序列生態系,以及 arima() 的一個命名陷阱
基礎的 stats 套件提供 arima()、acf()、pacf()、ar() 與 Box.test(),本章需要的一切都在裡面。有兩個生態系把它們擴充出去。較舊的 forecast 套件(Hyndman)提供 auto.arima() 作自動階數選擇,並帶著一套成熟的預測做法;較新的 fable 套件屬於 tidyverts,以 tidy 的、以 tibble 為基礎的介面重新實作同一套建模,是生態系正在移動的方向,不過 forecast 仍被廣泛使用而且完整支援。對單一條短序列而言,兩者都比任務所需的做法更繁;用基礎的 arima() 手動比較幾個階數,既透明又足夠。有一個命名陷阱值得標出來:arima() 報出來的 intercept 不是迴歸的截距,而是估計出來的歷程平均數,只是印在係數向量裡 intercept 這個標籤底下。把它讀成自我迴歸方程式的常數項(constant)(那應該是平均數乘以 \((1-\sum\phi)\))是一個常見而且後果嚴重的錯誤。使用自動選擇時,要確認選出來的階數在一個合理的樣本上是穩定的,不是短序列上過度配適的產物。
24.4 單一個案研究的中斷時間序列
中斷時間序列是把一個人的序列變成受控比較的那個設計。它的邏輯是這個人擔任自己的控制組(control):一段基線期確立這個人本來會沿著走下去的軌跡(trajectory),一次介入在一個已知的時點引入,而那個時點之後軌跡的改變,對照「沒有介入」這個反事實(counterfactual),就是處理效果(treatment effect)。這個設計有真實的威脅,其中最主要的是歷史(history),也就是另有事件與介入同時發生,以及成熟(maturation),也就是一條本來就會出現的趨勢。基線期因此必須長到足以可信地確立那條反事實軌跡;多重基線設計(multiple-baseline design)能強化推論也是同一個道理,因為把介入錯開跨行為或跨情境施行,會讓「剛好同時發生的歷史事件」變得不可信 (Kratochwill et al., 2010; McCleary et al., 2017)。
統計模型是一個分段迴歸(segmented regression)。把結果變項寫作 \(y_t\)、時間寫作 \(t\)、在介入時點由零轉為一的指標變項(indicator variable)寫作 \(D_t\),模型 \(y_t = \beta_0 + \beta_1 t + \beta_2 D_t + \beta_3 (t - t^\ast) D_t + e_t\) 估計基線水準 \(\beta_0\)、基線斜率 \(\beta_1\)、介入當下立即的水準變化(level change) \(\beta_2\),以及其後的斜率變化(slope change) \(\beta_3\)。水準變化是介入那一刻不連續的跳躍,斜率變化是其後累積起來的軌跡差異;兩者合起來把介入的效果分解成一次立即的位移與一次趨勢的改變。圖 24.8 在 mood_ts 上呈現這個解剖,它的介入種在第九十一天,是六分的水準下降加上每天 \(0.05\) 分的斜率變化。
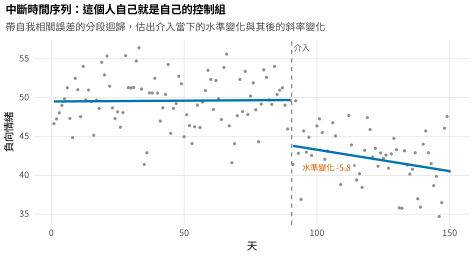
註:一個人每天的負向情緒(灰)與介入前後的分段迴歸配適(藍),介入在第九十一天(虛線)。這個配適估出基線的水準與斜率、介入當下的水準變化,以及其後的斜率變化。誤差以一階自我迴歸建模。
把單一個案時間序列與一般迴歸區分開來的那個麻煩之處,是誤差有序列相關:連續兩天的情緒並不獨立。忽略這份依賴有一個明確而且可預期的後果,標準誤(standard error)被低估,於是介入看起來估得比資料所允許的更精確、也更顯著。補救是把誤差的自我相關建模,最簡單的做法是用帶一階自我迴歸誤差結構的一般化最小平方(generalized least squares),它把殘差自我相關與迴歸一起估,並把標準誤膨脹到它們誠實的大小。把分段模型以一般化最小平方配適到 mood_ts 上,還原出的水準變化是 \(-5.85\)(對照種下去的 \(-6\)),斜率變化是 \(-0.057\)(對照種下去的 \(-0.05\)),估出來的殘差自我相關是 \(0.30\),點估計值都接近真值。自我相關的後果要靠比較兩種誤差處理才看得見:忽略依賴的最小平方(ordinary least squares),回傳的水準變化標準誤只有一般化最小平方那個值的四分之三,把不確定性低估了整整四分之一,也相應地把顯著性高估了。天真的分析會報出一個假性精確的效果。
小樣本問題比點估計值所顯示的更嚴重,誠實要求把它說出來。基線九十、介入後區段六十,這條序列已在單一個案研究所能達到的上緣,然而誤差自我相關的估計值本身是不確定的;在應用的單一個案工作典型的、更短的長度下,把自我相關當成已知的一般化最小平方標準誤,本身也是樂觀的。補救辦法是一個重抽殘差結構的拔靴法(bootstrap),或是專為這個設計發展出來的小樣本校正,而報告的標準是承認這份脆弱(fragility),不是把漸近(asymptotic)區間當成定案 (Borckardt et al., 2008)。表 24.4 列出效果量數與推論選項,包括單一個案設計文獻中與迴歸參數互補、並連向目視分析(visual analysis)傳統的非重疊效果量(nonoverlap effect sizes) (Parker et al., 2011)。
表 24.4 中斷時間序列:效果量數與小樣本推論選項。
| 量數或選項 | 它估的是什麼 | 用於單一個案時的註記 |
|---|---|---|
| 水準變化(\(\beta_2\)) | 介入當下立即的跳躍 | 那道不連續;要附上自我相關校正過的區間 |
| 斜率變化(\(\beta_3\)) | 其後軌跡的改變 | 累積起來的效果;介入後區段要夠長才估得出來 |
| AR(1) 誤差(\(\rho\)) | 殘差的序列依賴 | 必須建模;忽略它會低估所有的標準誤 |
| GLS 區間 | 把 \(\rho\) 當成已知的標準誤 | 在 \(T\) 短時偏樂觀;漸近的預設做法 |
| 殘差拔靴法 | 重抽出來的不確定性 | 在 \(T\) 短時較佳;尊重依賴結構 |
| 非重疊效果量(Tau-U、NAP) | 兩期分配的分離程度 | 補足迴歸;連向目視分析 |
註:報告迴歸參數時要附上自我相關校正過的不確定性,在短序列上寧取拔靴法而不取漸近區間,並把目視分析與統計建模當成互補而非對立。
常見陷阱 • 單一受試者時間序列誤導人的四種方式
第一,在一條不定態的序列上估計動態,於是把游移的平均數讀成慣性、把趨勢讀成自我相關;解讀任何一個自我迴歸係數之前,先檢查定態性。第二,在短序列上把 ARMA 模型過度辨識,選進一個配適得了這個樣本、卻複製不出來的第二個移動平均項;把階數壓低,並以訊息準則佐證那個指紋。第三,套用 Ljung-Box 檢定卻沒有把自由度扣掉已配適的 AR 與 MA 參數個數,這使漂白檢查過於寬鬆,放過一個配適不良的模型。第四,把一個有界量尺的地板或天花板誤認成一項動態:一條被壓在量程底部的序列會呈現壓縮的變異數與扭曲的自我相關,那反映的是工具,不是這個人;考慮作轉換或改用能處理設限(censoring)的模型,而且絕不要把地板效應(floor effect)讀成調節。
24.5 P 技術與因人而異的結構
對結構而非對動態的個殊取向分析,有一個名字與一段歷史:P 技術因素分析,由 Cattell 在一九四〇年代引入,是他那個資料方塊(data box)的一個面向,也就是人乘變項乘時點的三向陣列 (Cattell et al., 1947)。讀者熟悉的那種因素分析(factor analysis),也就是 R 技術(R-technique),在單一個時點上橫切這個方塊,問的是變項如何在人與人之間共變;P 技術則對單一個人跨時點縱切它,問的是這個人的變項如何隨時間共變。輸出的是一個屬於這個個體的因素結構,回答「這個人的情緒狀態如何自我組織」,而它不必然與「人與人之間如何不同」的那個結構相符。Nesselroade and Ford (1985) 與 Jones and Nesselroade (1990) 之所以為生命全程與人格研究發展這項技術,正是因為個體內的組織是一個不同的、而且往往更切題的對象。
圖 24.9 把 P 技術用在 affect_ema_items 的兩個人身上,對每個人的八個情緒題目跨各自的時點作因素分析,並把負荷量(loading)以熱圖(heatmap)呈現。兩個結構不同。對其中一個人而言,負向情緒的題目在一個因素上都取正的負荷量,正向情緒的題目落在另一個因素上,看起來像教科書上那個二維的情緒結構;不過只有一個題目負荷得強(\(0.99\),已逼近 Heywood 邊界),其餘都只是中等。對另一個人而言,型態位移了,題目以不同的方式交叉負荷(cross-loading),於是同樣的八個題目組織成一個明顯不同的個人結構樣態。兩個人配對因素之間的因素同構係數(factor congruence coefficient)是 \(0.76\) 與 \(0.92\),第二個因素高,第一個因素只算中等,把一份真實的結構異質性(heterogeneity)量化了出來。兩個人可以有不同的情緒結構,這不是測量誤差,而就是發現,也是第 24.1 節所主張的非遍歷性(nonergodicity)的實徵面貌。跨人估計的個體間 R 技術結構會報出一個平均的結構,而它對兩個人都不精確地相符,這就是遍歷性議題兌現出來的具體樣子 (Fisher et al., 2018; Molenaar, 2004)。
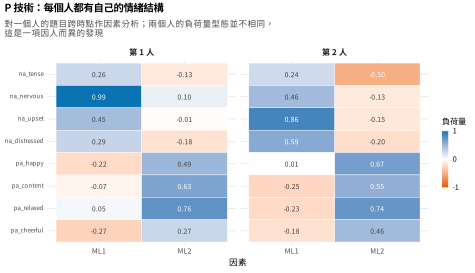
註:對 affect_ema_items 中兩個人的八個情緒題目分別作 P 技術因素分析所得的負荷量熱圖。縱軸的題目代號是資料集的欄名,保留原文以便讀者對照。兩個負荷量型態並不相同,這是一項因人而異的發現:同樣的題目組織成明顯不同的個人結構,而一項個體間的分析會報出一個對誰都不精確相符的平均。
P 技術的洞見是真的,它的瑕疵也很明確,而把那個瑕疵說精確正是接下來幾章的動機。這項技術把各個時點當成獨立的觀察值去作因素分析,就像 R 技術對待人那樣,因而忽略了序列依賴,而序列依賴正是一條時間序列的全部重點。後果不是負荷量沒有價值,它們往往大致還原得出來,而是標準誤錯了,因為有效的獨立觀察值個數比時點數少;還有,這項技術對動態什麼也沒說,也就是因素自己如何隨時間演化、又如何彼此預測。修補它的是動態因素模型,它把一個因素結構與一個時間序列結構放進同一個模型,估計因人而異、會把自己與彼此帶向下一刻的因素,那是第 26 章的主題 (Hamaker et al., 2005; Molenaar, 2004)。因此 P 技術最好理解成「因人而異的結構」這個問題在歷史上第一次、也是概念上最清楚的一次陳述,而它的答案由後面幾章的狀態空間與動態因素那套做法提供,並且沒有它那個序列依賴上的錯誤。
24.6 序列要多長?
每一位手上有密集資料的讀者都必須回答、應用文獻又太常迴避的問題是:本章的方法究竟需要幾個時點?誠實的答案不是單一個數字,而是所問問題的函數,而給出它最好的方式是模擬,不是斷言,因為這些估計式在短序列上的抽樣行為,恰恰是大樣本理論沒有描述的東西。因此本節配上一次真正的模擬:以已知的係數生成長度為三十、五十、一百與兩百的定態 AR(1) 序列,在每一次複製(replication)中重估那個係數,再把偏誤(bias)、均方根誤差(root-mean-square error, RMSE)與信賴區間(confidence interval)的寬度對序列長度列成表。
結果列在表 24.5 與圖 24.10,既令人清醒,也把事情說清楚了。\(T=30\) 時,自我迴歸係數帶著將近十分之一的向下偏誤、\(0.19\) 的均方根誤差,以及 \(0.65\) 寬的信賴區間,寬到跨過容許範圍的大半,分辨不出一個弱持續的歷程與一個強持續的歷程。精確度隨長度穩定改善:均方根誤差在 \(T=50\) 降到 \(0.13\)、\(T=100\) 降到 \(0.09\)、\(T=200\) 降到 \(0.07\),區間則由 \(0.65\) 收窄到 \(0.49\)、到 \(0.34\)、到 \(0.24\)。那份向下偏誤是自我迴歸估計式已知的小樣本性質,由 \(T=30\) 時的將近十分之一縮到 \(T=200\) 時的百分之一上下。結論是:一個 AR(1) 等級的問題,也就是把單一個慣性係數估到堪用的精確度,在 \(T\) 大約五十到一百時可行,那是一項兩週到一個月、每天數次提示的日記(diary)研究所及的範圍。但一個更細緻的問題,例如一段二階振盪、一個移動平均項,或一次完整的 ARMA 辨識,需要的長得多,因為每多一個參數都是從同樣有限的訊息裡估出來的,而辨識本身在短序列上就變得不穩定。第 24.3 節那個 AR(2) 配適的衰減,也就是在 \(T=90\) 時由生成值 \(0.55\) 與 \(-0.35\) 還原出 \(0.38\) 與 \(-0.24\),就是這張表的教訓在單一次配適上的模樣。
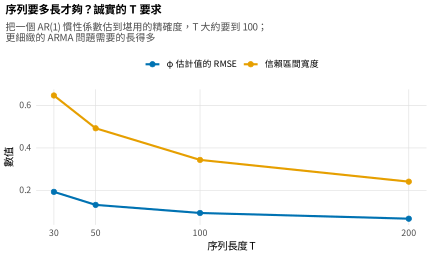
註:一階自我迴歸係數的均方根誤差(藍)與信賴區間寬度(橘),對序列長度模擬而得。精確度隨長度穩定改善;一個慣性係數在 \(T\) 接近 100 時達到堪用的精確度,而更細緻的 ARMA 問題需要長得多的序列。
表 24.5 序列長度的要求:由問題類型到誠實的最低長度。
| \(T\) | AR(1) 偏誤 | AR(1) RMSE | 區間寬度 | 對問題類型的判定 |
|---|---|---|---|---|
| 30 | \(-0.092\) | \(0.193\) | \(0.647\) | 太短,估不出可信的慣性;區間跨過大半個範圍 |
| 50 | \(-0.047\) | \(0.132\) | \(0.492\) | 對 AR(1) 而言勉強;只夠應付一個又強又明顯的效果 |
| 100 | \(-0.027\) | \(0.093\) | \(0.343\) | 足以估 AR(1) 慣性;日記研究的實務目標 |
| 200 | \(-0.011\) | \(0.067\) | \(0.241\) | 對 AR(1) 很好;也是一個可信的 AR(2) 或 ARMA 問題的下限 |
註:一階自我迴歸係數模擬出來的偏誤、均方根誤差與百分之九十五區間寬度。一個慣性問題在 \(T\) 接近 100 時可行;二階與移動平均的問題需要更多。這個估計式在短序列上向下偏誤,而偏誤隨 \(T\) 縮小。
這份對 \(T\) 的誠實不是勸人絕望,而正是後面幾章的動機。這個領域面對短序列問題的答案不是放棄個體,而是跨個體借力:一邊估計每個人的動態,一邊彙整關於「動態在樣本中的分配」的訊息,那就是第 25 章的多層次與動態結構方程那套做法。一個只有五十個時點、少到釘不住自己那段振盪的人,會貢獻給、也受益於一個把「人的動態所構成的母體」一起估出來的模型,而彙整所提供的收縮(shrinkage)會把這個人自己的估計值穩定下來。跨整個 ema_stress 樣本逐人估出來的那些 AR(1) 慣性,由幾乎為零一路到超過二分之一、平均數接近 \(0.29\),到了第 25 章就成為單一個模型的隨機效果;而本章只能逐人描述的那份異質性,在那裡成為一個要估計、也要解釋的變異數成分(variance component)。
24.7 寫出一份單一受試者的時間序列分析
可信地報告一份 \(N=1\) 的分析,意思是讓每一項分析決定都看得見,因為在單一個案研究中,那些決定所承載的分量比在大樣本中更重,讀者也沒有大數法則可以回頭倚靠來原諒它們。寫作時應該陳述序列長度以及遺漏時點的數目與型態,因為它們主宰了什麼估得出來;也應該報告遺漏是怎麼處理的,是用一個尊重它的概似函數,還是用了內插,若是後者則要承認它所誘發的自我相關。定態性的評估要記錄下來,把目視診斷與 ADF、KPSS 的結果一起放上,以及任何施行過的去趨勢或轉換,並附上支持它的估計標的。在動態這一邊,應該報告辨識出來的階數與支持它的證據,也就是自我相關與偏自我相關的指紋加上訊息準則的比較;報告配適出來的係數與它們的心理學讀法,一個慣性要附上它的半衰期,一段振盪要附上它的週期;以及那項證明模型已把序列漂白的殘差診斷,也就是在正確自由度下的 Ljung-Box 結果。對一條中斷時間序列而言,應該報告水準與斜率的變化並附上自我相關校正過的不確定性,指名誤差結構,並且正面面對小樣本的脆弱,不要把漸近區間當成定案。全篇的用語都應該讓心理學意義黏在每一個數字上,因為一個沒有附上意義就報出來的係數無法解讀;而類推的邏輯也應該誠實陳述:一個人的結果是一次複製,它的外部效度(external validity)建立在它在其他人身上的重現,不建立在它自己那個估計值的顯著性上。
一段示範的段落是這樣的:「本研究分析了一百八十天的每日負向情緒報告,沒有遺漏的時點。基線區段(第 1 至 90 天)以滾動平均數與散布的目視檢視、以及 ADF 與 KPSS 檢定判定為定態(ADF \(=-7.02\),\(p<.01\);KPSS \(=0.05\),\(p>.10\))。偏自我相關在延宕 2 之後截斷,而在所考慮的候選模型中,AR(2) 模型取得最低的 AIC 與 BIC。配適出來的係數 \(\phi_1=0.38\) 與 \(\phi_2=-0.24\) 隱含一段週期約 5.4 天的阻尼振盪,與一個會衝過頭再回來的調節動態一致;殘差為白(Ljung-Box \(p=.93\),自由度已就兩個估計出來的參數校正)。考慮到序列長度,這些二階估計值應該讀成經過衰減的,而本分析僅作為一次複製提出,有待跨人的系統性複製。」下面的實務要點方塊把這套報告標準濃縮成一張檢核表。
實務要點 • 處理錯過的提示,以及一份單一受試者的報告檢核表
今天處理錯過的時點,是在觀察到的資料上以一個尊重遺漏的概似函數去配適,不是憑空造值:基礎的 arima() 透過它的狀態空間概似函數就容納得了序列內部的遺漏值,而第 26 章的卡爾曼式處理是有原則的通用解。避免平均數插補(mean imputation)與線性內插,兩者都會扭曲自我相關(autocorrelation)。一份單一受試者的報告應該陳述:(1) 序列長度、遺漏時點的數目與型態,以及遺漏的處理方式;(2) 定態性評估,目視的與檢定的,以及任何去趨勢或轉換(transformation)及其估計標的;(3) 辨識出來的階數,以及支持它的 ACF/PACF 與訊息準則證據;(4) 配適出來的參數與其心理學解讀,慣性附半衰期、振盪附週期;(5) 在校正過的自由度下的殘差漂白診斷;(6) 若是中斷時間序列,水準與斜率的變化並附上自我相關校正過的、最好是拔靴出來的不確定性;(7) 類推的複製邏輯,一個人是一次系統性複製,不是一個 \(n=1\) 的樣本。
本章摘要
密集測量下的單一個人是一個正當的分析對象,這個人的個體內結構不必然與跨人估出來的個體間結構相符,而兩個層次的不等價正是個殊取向綱領的思想憲章。弱定態性是每一項動態估計的承重前提,先以滾動平均數與散布作目視診斷(diagnosis),再以 ADF 與 KPSS 檢定,兩者相反的虛無假設要一起讀;它們在心理學的長度下檢定力低到需要一次小型模擬才說得清楚:在三十個時點時,ADF 檢定只有大約一半的機會拒絕那個並不成立的單根。自我迴歸係數就是慣性,是一項帶著半衰期的心理延續,不是一個要被修正掉的干擾項,而帶複數根的二階自我迴歸產生那段阻尼振盪,情緒研究者把它讀成調節上的衝過頭。自我相關函數與偏自我相關函數以指紋的方式辨識階數,在短序列上要再以訊息準則佐證,否則它們會過度配適;配適好的模型則由一個自由度必須扣掉已估參數的 Ljung-Box 檢定來認證。去趨勢與差分都移除趨勢,回答的問題卻不同;對錯過的時點作天真內插會製造出自我相關,而狀態空間的處理避得開它。中斷時間序列讓這個人成為自己的控制組,在誤差自我相關的情況下,對照基線的反事實估計一次水準變化與一次斜率變化,而忽略那份自我相關會低估每一個標準誤,在這裡低估了四分之一。P 技術因素分析是「因人而異的結構」這個問題在歷史上的陳述,它的負荷量有洞見,它的標準誤卻是錯的,因為它忽略序列依賴,而這項瑕疵由第 26 章的動態因素模型修補。至於誠實的序列長度要求,一個 AR(1) 慣性在接近一百個時點時可行、更細緻的問題需要遠多於此,正是第 25 章那套多層次借力的確切動機,在那裡,單一個人的短序列由周圍那整群人穩定下來。
習題
- 24.1 檢定力模擬。重現本章的 ADF 檢定力模擬,以中等的自我迴歸係數生成長度為三十、五十與一百的定態序列,核對 \(T=30\) 時 \(0.47\)、\(T=50\) 時 \(0.88\) 的拒絕率;再說明在日記研究常見的長度下,為什麼圖 24.2 那種目視診斷承擔了大部分的證據重量。
- 24.2 走完辨識弧線。在
mood_ts九十天的基線區段上,依表 24.2 的指紋辨識階數、以 AIC 與 BIC 比較候選階數,並在扣掉已估參數的自由度下檢查殘差漂白了沒有;接著照第 24.7 節的示範寫出一段結果,慣性附上半衰期、振盪附上週期,並說明配適值相對於生成值為什麼衰減。 - 24.3 兩種誤差處理。在
mood_ts上以普通最小平方與帶一階自我迴歸誤差的一般化最小平方各配適一次分段迴歸,把兩者的水準變化標準誤並排,說明那四分之一的低估是怎麼來的,再依表 24.4 補上一個在短序列上比漸近區間更誠實的不確定性量數。 - 24.4 去趨勢或差分。用表 24.1 向一位合作者解釋去趨勢與差分留下的是不同的序列、回答的是不同的問題,講清楚延宕 1 的自我相關為什麼由 \(0.95\) 分別變成 \(0.31\) 與 \(-0.37\);再以圖 24.7 說明線性內插為什麼把慣性由 \(0.42\) 膨脹到 \(0.57\)。
- 24.5 報告稽核。依第 24.7 節那份七項的報告檢核表,稽核一篇已發表的單一個案時間序列研究,逐項指出它交代了什麼、又漏了什麼;接著在
ema_stress中任選一個人的序列作同一份稽核,並以表 24.5 判斷那個長度撐不撐得起你打算報的模型。 - 24.6 P 技術實作。對
affect_ema_items中的兩個人各作一次 P 技術因素分析,算出配對因素的同構係數,並說明那個逼近 Heywood 邊界的 \(0.99\) 負荷量該怎麼讀;接著寫出第 26 章的動態因素模型修補了 P 技術的哪一項瑕疵。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 個殊取向 | idiographic | 以個人自身為單位分析其歷程(承第 1 章);第 24.1 節 |
| 遍歷性 | ergodicity | 個體內與個體間結構重合所需的條件;第 24.1 節 |
| 弱定態性 | weak stationarity | 平均數、變異數不隨時間變,自我共變數只依延宕;第 24.2 節 |
| 滾動平均數 | rolling mean | 移動窗內的平均數,定態性的目視診斷工具;第 24.2 節 |
| 單根 | unit root | 隨機趨勢;ADF 檢定的虛無假設;第 24.2 節 |
| 慣性 | inertia | 自我迴歸係數的心理讀法:狀態的延續程度(承第 23 章);第 24.3 節 |
| 半衰期 | half-life | 一次擾動衰減到一半所需的時點數;第 24.3 節 |
| 移動平均 | moving average (MA) | 此刻依賴過去的衝擊而非過去的狀態;第 24.3 節 |
| 複數根 | complex roots | AR 多項式的根落在實數線外,給出阻尼振盪;第 24.3 節 |
| 去趨勢 | detrending | 迴歸到時間上再分析殘差,保住波動的估計標的;第 24.3 節 |
| 差分 | differencing | 以相鄰時點之差取代原值,改問變化的動態;第 24.3 節 |
| 中斷時間序列 | interrupted time series | 以介入前後的分段迴歸讓個人成為自己的控制組;第 24.4 節 |
| P 技術因素分析 | P-technique factor analysis | 對一個人跨時點作因素分析,得出因人而異的結構;第 24.5 節 |
參考文獻
Beltz, A. M., Wright, A. G. C., Sprague, B. N., & Molenaar, P. C. M. (2016). Bridging the nomothetic and idiographic approaches to the analysis of clinical data. Assessment, 23(4), 447–458. https://doi.org/10.1177/1073191116648209
Borckardt, J. J., Nash, M. R., Murphy, M. D., Moore, M., Shaw, D., & O’Neil, P. (2008). Clinical practice as natural laboratory for psychotherapy research: A guide to case-based time-series analysis. American Psychologist, 63(2), 77–95. https://doi.org/10.1037/0003-066X.63.2.77
Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons.
Cattell, R. B., Cattell, A. K. S., & Rhymer, R. M. (1947). P-technique demonstrated in determining psycho-physiological source traits in a normal individual. Psychometrika, 12(4), 267–288. https://doi.org/10.1007/BF02288941
Chatfield, C., & Xing, H. (2019). The analysis of time series: An introduction with R (7th ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351259446
Fisher, A. J., Medaglia, J. D., & Jeronimus, B. F. (2018). Lack of group-to-individual generalizability is a threat to human subjects research. Proceedings of the National Academy of Sciences, 115(27), E6106–E6115. https://doi.org/10.1073/pnas.1711978115
Hamaker, E. L., Dolan, C. V., & Molenaar, P. C. M. (2005). Statistical modeling of the individual: Rationale and application of multivariate stationary time series analysis. Multivariate Behavioral Research, 40(2), 207–233. https://doi.org/10.1207/s15327906mbr4002_3
Hamilton, J. D. (1994). Time series analysis. Princeton University Press.
Jones, C. J., & Nesselroade, J. R. (1990). Multivariate, replicated, single-subject, repeated measures designs and P-technique factor analysis: A review of intraindividual change studies. Experimental Aging Research, 16(4), 171–183. https://doi.org/10.1080/03610739008253874
Kratochwill, T. R., Hitchcock, J., Horner, R. H., Levin, J. R., Odom, S. L., Rindskopf, D. M., & Shadish, W. R. (2010). Single-case designs technical documentation. What Works Clearinghouse. https://ies.ed.gov/ncee/wwc/Docs/ReferenceResources/wwc_scd.pdf
Kuppens, P., Allen, N. B., & Sheeber, L. B. (2010). Emotional inertia and psychological maladjustment. Psychological Science, 21(7), 984–991. https://doi.org/10.1177/0956797610372634
McCleary, R., McDowall, D., & Bartos, B. J. (2017). Design and analysis of time series experiments. Oxford University Press. https://doi.org/10.1093/oso/9780190661557.001.0001
Molenaar, P. C. M. (2004). A manifesto on psychology as idiographic science: Bringing the person back into scientific psychology, this time forever. Measurement: Interdisciplinary Research and Perspectives, 2(4), 201–218. https://doi.org/10.1207/s15366359mea0204_1
Molenaar, P. C. M., & Campbell, C. G. (2009). The new person-specific paradigm in psychology. Current Directions in Psychological Science, 18(2), 112–117. https://doi.org/10.1111/j.1467-8721.2009.01619.x
Nesselroade, J. R., & Ford, D. H. (1985). P-technique comes of age: Multivariate, replicated, single-subject designs for research on older adults. Research on Aging, 7(1), 46–80. https://doi.org/10.1177/0164027585007001003
Parker, R. I., Vannest, K. J., & Davis, J. L. (2011). Effect size in single-case research: A review of nine nonoverlap techniques. Behavior Modification, 35(4), 303–322. https://doi.org/10.1177/0145445511399147
Shumway, R. H., & Stoffer, D. S. (2017). Time series analysis and its applications: With R examples (4th ed.). Springer. https://doi.org/10.1007/978-3-319-52452-8
Suls, J., Green, P., & Hillis, S. (1998). Emotional reactivity to everyday problems, affective inertia, and neuroticism. Personality and Social Psychology Bulletin, 24(2), 127–136. https://doi.org/10.1177/0146167298242002
Velicer, W. F., & Fava, J. L. (2003). Time series analysis. In J. A. Schinka & W. F. Velicer (Eds.), Handbook of psychology: Research methods in psychology (Vol. 2, pp. 581–606). Wiley. https://doi.org/10.1002/0471264385.wei0223
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。