第 35 章
社會、人格、組織與健康心理學的應用
日誌(diary)法與經驗取樣(experience sampling)法就是在這些領域發明出來的,本書那條個體內(within-person)的主線也在這裡回報得最豐厚:這裡要問的現象是一天之內、以及人與人之間的歷程,不是個體間的差異。本章是應用篇的第三章,也是最後一章,處理三個常因為缺了對的個體內工具而做錯的問題。第一個把人格(personality)本身重新框定:一個特質(trait)不是一個數字,而是一整組狀態(state)的分配;一個人的平均數、一個人的變異性(variability)、一個人依情境而定的反應性(reactivity),全都是人格的參數,由密集資料估出來,再帶進法則網絡(nomological network),不像兩階段分析那樣把不確定性洗掉。第二個是本章著墨最多的一段,也就是雙人(dyadic)的每日歷程。兩條互相依賴的資料流必須一起模型化,而多數研究者順手拿來的設定在幾處微妙的地方是錯的,錯的方式恰好汙染了他們所報告的效果本身;多層次形式的行動者與伴侶互倚模型(actor-partner interdependence model),連同雙重分解(double decomposition)所要求的中心化(centering)紀律,在這裡發展得比零散的文獻深。第三個轉向工作與復原(recovery)的節律。每週的週期不是一個要被控制掉的麻煩,它就是要檢驗的理論,而傍晚的心理抽離(psychological detachment)預報得了隔天早上的活力(vigor)。三個個案共享一份承諾與一份警戒:承諾是個體內結構才是動作發生的地方;警戒是伴侶效果不自動就是影響、變異性指標不自動就是特質、星期幾的係數也不自動就是控制變項。三個個案都寫成一篇實徵論文的樣子,把一篇完稿論文所藏起來的推理攤開來。
學習目標
讀完本章之後,你應該能夠:(1) 把人格當成狀態的密度分配(density distribution)來處理,把平均數、個體內變異性與依情境而定的反應性估計成特質參數,並在帶進「特質對結果」的分析時一併傳遞它們的不確定性;(2) 用多層次的行動者與伴侶互倚模型來模型化雙人的每日資料,分開個體內與伴侶間(between-couple)的效果、分開行動者(actor)與伴侶(partner)的效果,並以能讓它們保持分開的中心化方式估計;(3) 估計雙人的成長與跨伴侶的領先延宕(lead-lag)結構,並以它的混淆所要求的謹慎解讀伴侶效果;(4) 把週期性的組織現象當成理論來檢驗,不當成裝飾,並估計跨越夜晚界線的個體內復原;(5) 處理這些領域的設計現實,從事件取樣記錄(event-contingent recording)到伴侶隱私,再到組織同意的層級;(6) 把個體內的發現翻譯給受個體間構念訓練的讀者,而不過度主張。
35.1 地形:歷程住在人生活的地方
本書服務得了的社會、人格與組織心理學問題,全都是關於個體內歷程的問題,而且落在少數幾個家族裡,每一個家族都通往前面章節的工具。狀態的表現與它的偶連性(contingency),也就是一個人當下的外向性(extraversion)或情緒起伏有多大、又是什麼情境在推動它,屬於分配的問題,由第 7 與 16 章的變異性與位置尺度(location-scale)工具回答。狀態在人與人之間的傳遞,也就是一位伴侶的支持(support)會不會抬起另一位的親密感(intimacy)、每天又是誰帶誰,屬於雙人的問題,由第 23 章的多層次模型延伸到兩位互相依賴的成員來回答,再由第 25 章的耦合(coupling)方法補上。工作與復原的節律,也就是每週的週期與週末的修復,屬於週期性的問題,由第 23 與 30 章的三角函數(trigonometric)與循環平滑(cyclic smooth)工具回答。行為與健康在一天之內的耦合則屬於動態的問題,由同一套個體內機制回答。圖 35.1 畫出這份對應;表 35.1 把這些家族連同估計標的(estimand)與代表性文獻一起列出。
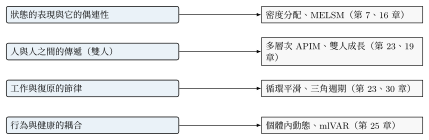
註:每一個個體內問題的家族,都通往回答它的那些工具。設計的譜系從羅徹斯特互動紀錄(Rochester Interaction Record)與 Wheeler and Reis (1991)、Reis and Wheeler (1991) 的事件取樣傳統,一路走到今天的智慧型手機經驗取樣;分析的家族卻是穩定的,而說出眼前是哪一個家族,仍然是第一個分析動作。
表 35.1 問題分類、估計標的、章次與代表文獻。
| 問題家族 | 估計標的 | 章次 | 代表文獻 |
|---|---|---|---|
| 狀態的分配 | 個人平均數、標準差、反應性 | 7、16 | Fleeson (2001) |
| 雙人的傳遞 | 行動者/伴侶的個體內效果 | 23、25 | Laurenceau et al. (1998) |
| 工作的節律 | 週期的形狀;復原延宕 | 23、30 | Sonnentag (2003) |
| 行為與健康 | 個體內的耦合 | 25 | Butler (2011) |
註:估計標的就是紀律。這些領域共有一個長期的溝通問題:它們的讀者受的是個體間構念的訓練。最後一節會回到這件事。
35.2 個案研究 A:把人格看成狀態的分配
Fleeson (2001) 提出的「狀態與特質的調解」,靠著換掉討論的對象化解了一場老爭論:人格特質不是一個人單一的特徵值,而是這個人當下狀態的密度分配(density distribution);這個分配的參數,也就是平均數、分散程度(spread),以及狀態隨情境而變的方式,就是特質。這個重新框定把密集縱貫資料變成一件人格測量的工具。個案 A 就做這件事,用的是重新框成人格研究的 affect_ema 紀錄:\(120\) 個人,每天大約取樣六次,為期兩週;他們當下的正向情緒(positive affect)、負向情緒(negative affect)與壓力(stress),就是用來估計分配參數的狀態。
35.2.1 分配參數即人格
圖 35.2 呈現研究的原始對象,也就是一批人當下正向情緒的分配,並用視覺說出關鍵的那一點:人與人的差別不只在分配坐落的位置,也在它有多寬。兩個平均情緒相同的人,變異性可以差很多,而兩件事都是人格。要把參數估對,就得抵抗「算一個原始的個體內標準差、再把它當成特質」的誘惑:這種指標把真實的變異性、測量誤差(measurement error)與那個人的平均數混在一起,那正是 Baird et al. (2006) 記錄過的干擾。第 16 章的位置尺度模型是那份修補,它把一個人的平均數與這個人殘差變異性的對數一起模型化,並把依情境而定的反應性(reactivity)當成一個隨機斜率(random slope)。配適到這份資料上,三個參數都很可觀,而且因人而異:負向情緒的個人平均數平均為 \(2.02\),個體間標準差 \(0.44\);個體內變異性平均為 \(0.56\),個體間標準差 \(0.10\);壓力反應性,也就是一個人的負向情緒隨當下壓力上升的程度,平均為 \(0.35\),個體間標準差 \(0.08\)。表 35.2 列出哪一個分配參數操作化了哪一個人格構念。
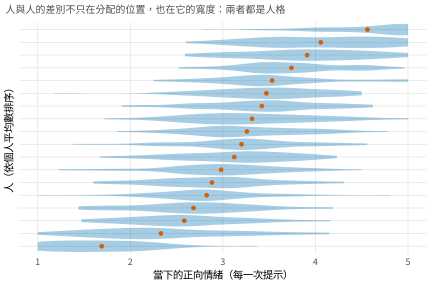
註:每一列是一個人兩週取樣期間當下正向情緒的分配,依個人平均數(紅點)排序。人與人的差別在分配的位置上,也獨立地在它的分散程度上;在密度分配的觀點裡,兩者都是穩定的人格參數。直接從這些分配讀出來的原始標準差,會把真實的分散、測量誤差與平均數混在一起,那正是第 16 章的位置尺度模型要修正的。請注意,這張圖畫的是正向情緒,正文所報的三個分配參數(\(2.02\)、\(0.56\)、\(0.35\))則都是負向情緒的,兩者不能互相對照;英文版亦然,見 EN-35-02。
35.2.2 穩定性與反代入的紀律
一個分配參數要算得上特質,就必須穩定。把研究切成前後兩週,再把每個參數在兩半之間求相關,也就是做一次折半(split-half)檢核,經驗上的判定就出來了:個人平均數高度穩定,兩半之間相關 \(0.90\);個體內變異性中等穩定,\(0.56\);反應性最有雜訊,\(0.37\)。這正是密度分配文獻收斂到的型態:平均水準穩健得像特質,更高階的參數是真的,卻比較難在兩週的資料裡釘住。這些穩定性的數字對下一步很要緊。下一步要把這些參數帶進「特質對結果」的分析,而一個帶著誤差估出來的參數,就是一個帶著測量誤差的預測變項;把它當成已知量來用,就是第 16 章警告過的代入謬誤(plug-in fallacy)。圖 35.3 用一次受控的示範呈現後果。一個人層次的結果若真的取決於那個人的變異性,把結果對變異性的代入估計值作迴歸(regress)會衰減(attenuate)那個效果,這裡從真值 \(0.50\) 掉到天真的 \(0.45\);不確定性也報得太小,因為估計出來的變異性裡的雜訊被忽略了。把那份估計的不確定性傳遞下去,用一個利用「標準差的取樣變異數為已知」的變項含誤差校正(errors-in-variables correction),效果被推回到 \(0.55\),區間也誠實地拉寬。這裡的 \(0.55\) 越過了真值 \(0.50\),而那不是抽樣的抖動:這次示範是把估計出來的變異性先標準化再作迴歸,而用來標準化的那個標準差本身已被估計誤差膨脹,衰減因此是信度(reliability)的平方根而不是信度本身,同除以信度就系統性地過了頭,期望值是 \(0.552\);直接用未標準化的估計值作迴歸,衰減恰好是信度,校正之後還原為 \(0.5013\)。校正要對準實際進入迴歸的那一個預測變項。這條紀律說起來簡單,卻經常被忽略:進入個體間模型的分配參數帶著自己的不確定性,而那份不確定性屬於第二階段的推論。
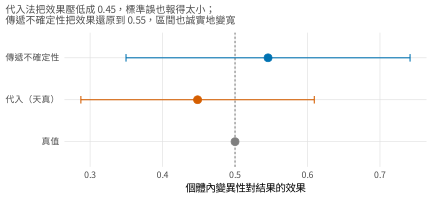
註:一個人層次的結果取決於那個人真實的個體內變異性,而這裡的變異性由大約二十五個可用時點估出來。代入的分析把結果對點估計作迴歸,衰減了效果,也報出過窄的區間。把估計的不確定性傳遞下去,用一個利用「標準差的取樣變異數為已知」的變項含誤差校正,效果就被推了回去,區間也拉到它誠實的寬度。這裡的校正施加在標準化之後的預測變項上,因此會系統性地過頭,正文有說明。參數所依據的時點越少,衰減就越大。
常見陷阱 • 把原始的變異性指標當成特質
這片文獻裡最常見的單一錯誤,是算出一個人原始的個體內標準差、或一個平均連續差異(mean successive difference),再把它當成乾淨的特質丟進個體間的分析。三個問題疊在一起。第一,這種指標把真實的變異性與測量誤差混在一起,不可靠的測量因此製造得出虛假的變異性。第二,它與平均數糾纏在一起:有界量尺(bounded scale)會在天花板(ceiling)與地板(floor)附近壓縮變異性,一個人的變異性與水準因此無法從原始指標獨立讀出。第三,它是帶著取樣誤差(sampling error)估出來的,第二階段(second-stage)的分析接著忽略那份誤差,任何效果都因此被衰減,還報得過度精確。第 16 章的位置尺度模型把平均數與變異性的對數一起模型化,處理前兩個問題;圖 35.3 的不確定性傳遞處理第三個。只建立在原始指標上的變異性發現,還算不上一項關於那個人的發現。
35.3 個案研究 B:雙人的每日歷程
一段關係裡的兩個人產生兩條互相依賴的每日資料流。核心的方法學事實是:這兩條流不能分開分析,因為每一位伴侶的結果同時取決於兩位伴侶的預測變項,也因為一對伴侶的兩位成員比兩個隨機的個人更相似。個案 B 把分析發展在 couples_diary 紀錄上。那是一份可區辨雙人(distinguishable dyad)的研究,\(130\) 對伴侶在三週之內每天報告支持與親密感,資料裡植入了已知的行動者與伴侶結構、一個滿意度(satisfaction)的調節變項(moderator)、一個伴侶間的混淆(confound)、一段共同命運(common fate)的成長歷程,以及一個不對稱(asymmetric)的跨伴侶延宕,因此每一項主張都可以對照真值檢核。圖 35.4 呈現這份資料的解剖,也就是兩條共用同一批伴侶日的對齊資料流;本節就建起尊重那份結構的模型。
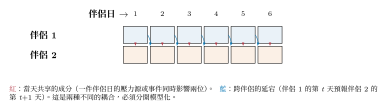
註:兩位伴侶產生共用同一批伴侶日的對齊資料流。耦合有兩種不同的形式:一種是當天共享的成分,一件事同時推動兩位伴侶;另一種是延宕的跨伴侶成分,一位伴侶的狀態預報另一位隔天的狀態。把兩者混為一談,或乾脆忽略那份非獨立性(nonindependence),都會把互倚(interdependence)這個研究對象說錯。
35.3.1 非獨立性與行動者及伴侶的模型
那份非獨立性是真的,也量得出來:親密感的雙人組內相關(dyadic intraclass correlation),也就是落在伴侶之間的變異數(variance)比例,是 \(0.34\),離「把人當成個人來分析」所假定的零很遠。這正是伴侶層次的隨機效果不可省的原因。尊重雙人結構的模型是多層次形式的行動者與伴侶互倚模型(actor-partner interdependence model, APIM):每位伴侶每天的親密感,迴歸到這位伴侶自己的支持(行動者效果)與另一位伴侶的支持(伴侶效果)上,兩位成員的日子則共用一個伴侶層次的隨機截距。圖 35.5 畫出這個設定。零散的應用文獻慣常弄錯的微妙之處是中心化。行動者效果是個體內效果,說的是一位伴侶在自己支持高於平常的那些天,親密感上升多少;只有把支持作個人平均數中心化(within-person centering),它才估得乾淨,因為這樣才把一天一天的個體內關聯,與「比較常給支持的人」那種個體間關聯分開。表 35.3 是這個設定的決策表,交叉了可區辨性、誤差結構與中心化。
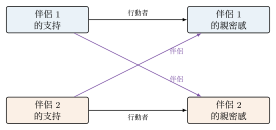
註:每位伴侶的親密感取決於這位伴侶自己的支持(行動者效果)與另一位伴侶的支持(伴侶效果,紫色)。在一個把支持作個人平均數中心化、並加上伴侶層次隨機截距的多層次模型裡估計,行動者與伴侶效果就是每天的個體內效果,與伴侶之間的關聯分開。圖上畫的是個體內那一層;伴侶之間那一層是一組平行的效果,預測變項換成伴侶平均數。
表 35.3 雙人模型設定的決策表。
| 決策 | 選項 | 建議 |
|---|---|---|
| 可區辨性 | 可區辨(例如依角色)對不可區辨 | 可區辨:把成員放進模型;不可區辨:用配對/雙重輸入(pairwise/double-entry)法,搭配成員不變(member-invariant)的效果 |
| 誤差結構 | 殘差變異數要一個還是兩個;當天之內要不要相關 | 允許伴侶日之內的殘差相關;可區辨的雙人可能需要兩個殘差變異數 |
| 中心化 | 個人平均數中心化(within-person)、總平均數中心化(grand-mean)或伴侶平均數中心化(couple-mean) | 行動者效果用個人平均數中心化;伴侶平均數承載個體間的效果 |
註:多數應用論文弄錯的組合是「總平均數中心化加上單一殘差變異數」,它把行動者效果和個體間關聯汙染在一起。最後一列的個人平均數中心化就是解方。
配適中心化正確的模型,就還原出植入的結構:行動者效果 \(0.45\),對照真值 \(0.40\);伴侶效果 \(0.19\),對照真值 \(0.20\);「平均支持對親密感」的伴侶間效果 \(0.59\),對照真值 \(0.60\)。個體間的關聯確實大於個體內的,那正是中心化設計出來要揭露的雙重分離(double dissociation)。圖 35.6 把這些估計值擺在真值旁邊,也呈現了那個常見錯誤的代價:只把支持作總平均數中心化的分析者,會把行動者效果估成 \(0.51\),被比較大的個體間關聯向上汙染,而這個誤差和許多已發表的效果一樣大。被汙染的不只行動者效果:同一個錯誤讓伴侶效果由 \(0.186\) 掉到 \(0.105\),幾乎腰斬,方向與行動者效果相反,因為對方支持的個體間關聯在這份資料上比個體內關聯小。中心化不是把某一個係數往上推,而是把每一個係數都換成一個沒人要的混合體。關係滿意度也如植入的那樣調節(moderate)了行動者效果,個體內「支持對親密感」的耦合在比較滿意的伴侶身上比較強,還原出來的交互作用是 \(0.13\),對照真值 \(0.15\)。表 35.4 這份詞彙表讓四個效果保持分明。
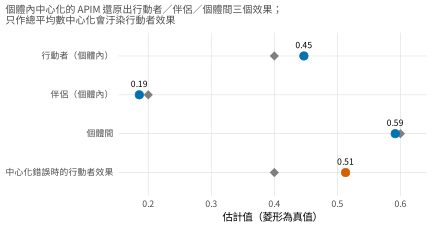
註:個體內中心化的模型,把行動者(\(0.45\))、伴侶(\(0.19\))與個體間(\(0.59\))三個效果還原到接近植入的真值(菱形)。最下面一列是支持只作總平均數中心化時的行動者效果:它被拉到 \(0.51\),受比較大的個體間關聯汙染,而這個誤差會膨脹所報告的個體內耦合。中心化在這裡不是枝微末節,它是「你要的那個效果」與「你沒有要的那個效果」之間的差別。
表 35.4 APIM 的效果詞彙表。
| 效果 | 意義 | 估計值(真值) |
|---|---|---|
| 行動者,個體內 | 自己的支持對自己的親密感,一天一天 | \(0.45\)(\(0.40\)) |
| 伴侶,個體內 | 對方的支持對自己的親密感,一天一天 | \(0.19\)(\(0.20\)) |
| 個體間 | 平均支持對平均親密感 | \(0.59\)(\(0.60\)) |
| 行動者,中心化錯誤 | 被汙染的行動者效果 | \(0.51\)(應為 \(0.40\)) |
註:這四個量回答不同的問題。個體內的行動者與伴侶效果是每天的互倚;個體間的效果是一項人的差異上的關聯;中心化錯誤的行動者效果則哪一個都不是,它是一個沒有任何理論打算要的混合體。最後一列只列出行動者效果,並不表示只有它受汙染:同一個中心化錯誤讓伴侶效果由 \(0.186\) 掉到 \(0.105\),方向相反而幅度更大。
35.3.2 雙人的成長,以及誰帶誰
除了每天的耦合,一對伴侶的親密感還有一條軌跡,而雙人成長模型問的是兩位伴侶的軌跡會不會一起動。配適一個帶伴侶層次隨機斜率的成長模型,還原出每天 \(0.015\) 個單位的共享上升;伴侶層次的斜率捕捉的就是共同命運,也就是伴侶在研究期間傾向一起起伏,不是各自起伏。圖 35.7 用一批兩條軌跡互相跟隨的伴侶呈現這件事。共同命運的表徵是一條伴侶層次的軌跡同時驅動兩位伴侶。因果故事若是共享處境而不是互相影響,它在理論上就比平行歷程(parallel-process)模型那種「兩條各自但相關的斜率」更貼切;在兩者之間選擇,選的是「這對伴侶是什麼」,不是一場配適的比賽。最後一層是動態那一層,也就是誰帶誰。在親密感的殘差(residual)上估計跨伴侶的延宕,還原出植入的不對稱:伴侶 1 某一天的親密感以 \(0.18\) 的係數預報伴侶 2 隔天的親密感,反向的路徑只有 \(0.07\),因此伴侶 1 領先、伴侶 2 跟隨,那就是圖 35.8 呈現的領先延宕結構。這裡的警戒就是第 25 章壓過的那一條:跨伴侶的延宕是一項時間上的預測事實,不是一項影響的示範。一個共享而未測到的驅動因子、一件共同的每日壓力源,或一個第三變項,都製造得出那份不對稱;第 32 章以遞迴為本的協調(coordination)方法提供一個互補的視角,卻解決不了那個因果問題。
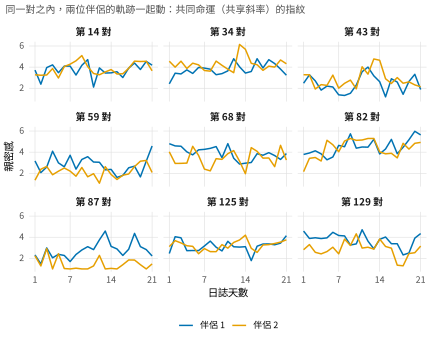
註:九對伴侶的親密感軌跡,每位伴侶各一條線。同一對之內,兩位伴侶的軌跡一起動,那就是伴侶層次隨機斜率所捕捉的共同命運指紋。伴侶因為共享處境而一起起伏時,共同命運模型是貼切的表徵;故事若是互相影響,替代方案才是帶跨伴侶斜率耦合的平行歷程模型。
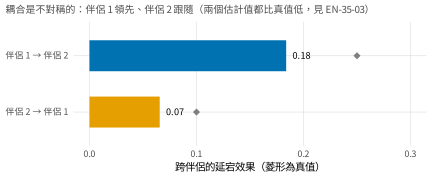
註:控制每位伴侶自己的慣性(inertia)之後,親密感殘差上的跨伴侶延宕效果。耦合是不對稱的,伴侶 1 領先(\(0.18\))、伴侶 2 跟隨(\(0.07\)),還原出植入的不對稱(菱形)。領先延宕是一項預測的事實,不是影響的證明:一個共享的每日驅動因子就製造得出同樣的不對稱,第 25 章那份警戒帳也因此適用於此。兩個估計值都低於各自的真值(\(0.25\) 與 \(0.10\)),正文與英文版都沒有點出來,見 EN-35-03。衰減的大小取決於殘差裡還留著什麼,不取決於「在殘差上估計」這個動作本身:在殘差模型裡再加一個成員層次的隨機截距,兩條路徑就回到 \(0.237\) 與 \(0.102\),前者只低了約 \(5\%\),後者幾乎沒有衰減。
實務要點 • 實務:跑一份伴侶日誌
雙人日誌研究多了單人研究不必面對的後勤負擔。招募必須為每一個單位找到兩位有承諾的參與者,而配合度(compliance)的差異,也就是一位伴侶填得比另一位多,會製造出一種遺漏型態:配合度若跟著研究中的歷程走,這種遺漏就不可忽略。伴侶之間的隱私是設計限制,不是事後才想到的事:填答必須蒐集得讓一位伴侶讀不到另一位的答案,這件事形塑了遞送平台與知情同意。讓雙人資料有意思的那些共享事件,也就是兩位伴侶都會報告的爭執與和好,必須在兩條資料流之間對得起來,而那需要一套共同的時戳(timestamp)紀律。這些就是那張乾淨資料矩陣背後的現實;忽略它們的方法一節,會招來審查者的懷疑。
實務要點 • 倫理:互倚與揭露
雙人資料帶著個人資料所沒有的揭露(disclosure)風險:一位伴侶的填答可能透露另一位的處境,而一份把每個個人都去識別化(de-identify)的釋出,仍然可能曝光一對伴侶。報告建立在少數或特殊子樣本上的彙總量,可能讓某一段關係被它自己的成員認出來;把個體層次的結果回饋給一位伴侶,則可能違背另一位的信任。照護的責任延伸到兩位成員,也延伸到這對伴侶作為一個單位:知情同意要兩位伴侶都理解,分析輸出不能追溯到某一對可辨識的伴侶,資料分享計畫也要把伴侶、而不只是個人,當成要保護的單位。
軟體提示
這裡的雙人模型用 lme4 配適,帶一個伴侶層次的隨機截距,支持則作個人平均數中心化;可區辨雙人有時需要伴侶日之內的殘差相關,那可以用 nlme 的相關結構取得。Gistelinck and Loeys (2019) 發展了結構方程(structural-equation)架構下的行動者與伴侶模型,容許相關殘差與潛在變項(latent variable)。brms 的貝氏實作容納得了兩成員的誤差結構,也自然地傳遞不確定性,代價是計算時間比較長。個案 A 的密度分配參數以位置尺度模型估計,可以用 brms,這裡則以分階段的方式近似;跨伴侶的領先延宕用的是第 25 章的殘差向量自我迴歸(residual vector-autoregression)。所有腳本都設了種子,隨章附上。
35.4 個案研究 C:工作週的節律與復原
組織領域關於壓力與復原的文獻,把「一週」當成一個有意義的結構:緊張橫跨工作日累積,復原發生在傍晚與週末,而那份節律本身就是現象,不是要被排除掉的麻煩。個案 C 把這些想法做在 work_week 紀錄上。那是一份 \(200\) 位工作者的兩週日誌(diary),有工作日、傍晚與早晨的架構;活力上植入了一個每週的週期、一段不連續的週末修復、一個把傍晚的抽離(detachment)連到隔天早上活力的個體內復原效果,以及一個工作要求(job demands)的調節變項,理論的檢驗因此可以對照一個已知的歷程來稽核(audit)。
35.4.1 每週的週期即理論
每週的週期以兩種方式估計,而這個對比很有教育意義。單一的三角諧波(harmonic)在七天的週期上放一組正弦(sine)與餘弦(cosine),強加一條平滑的正弦曲線,還原出植入的週期,與真值的相關是 \(0.95\)。循環樣條(cyclic spline)讓資料自己選形狀,同時強制週期閉合(period closure),讓星期日接回星期一,還原出來的相關是 \(0.91\),理論中立(theory-agnostic),效率(efficiency)也幾乎一樣好。圖 35.9 把兩者連同真值一起畫出來,週中一個活力低谷、週末一個高峰;表 35.5 是那份決策指引。方法上的重點是:在兩者之間選擇是理論上的選擇,不只是統計上的選擇。理論若預測一段平滑的單峰節律,三角函數模型就把那個預測編碼進去,並有效率地檢驗它;形狀若未知、或可能是多峰的,循環平滑就是誠實的預設。第三個選項是把星期幾當成一組自由的虛擬變項(dummy variable),那等於完全丟掉週期結構,只有在完全不預期有節律時才適當。當裝飾配適的每週週期,也就是因為軟體有這個功能才加上去的一條平滑,跟當理論配適的每週週期不是同一回事。
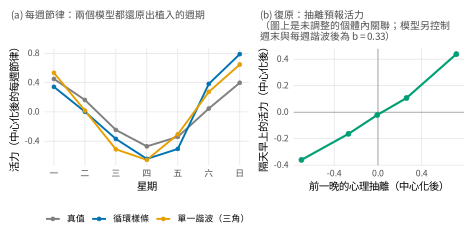
註:(a) 單一三角諧波與循環樣條各自還原出來的每週活力週期,兩者都追得上植入的真值(週中低谷、週末高峰)。形狀是已知的正弦時,三角函數模型有效率;循環平滑則是理論中立的預設。(b) 個體內的復原效果:隔天早上的活力隨前一晚的心理抽離而上升,那正是壓力復原文獻的核心歷程。英文版這一格畫的是未中心化的原始邊際關聯(斜率約 \(0.45\)),副標印的卻是個體內的模型係數 \(0.33\);中文版把兩個變項都先作個人平均數中心化再分箱,畫出來的就是個體內的關聯,並在副標中註明模型另有調整。見 EN-35-01。
表 35.5 檢驗週期的決策指引。
| 做法 | 什麼時候適用 | 它假設了什麼 |
|---|---|---|
| 三角諧波 | 理論預測一段平滑的單峰節律 | 在指定週期上呈正弦形狀 |
| 循環樣條 | 形狀未知或可能多峰 | 只假設平滑與週期閉合 |
| 星期幾虛擬變項 | 完全不預期有週期結構 | 什麼都不假設,但丟掉了節律 |
註:這個選擇把一項關於節律形狀的理論承諾編碼進去。理論預測正弦時卻配一條有彈性的平滑,浪費檢定力;形狀未知時強加正弦,冒配適不良的風險;改用自由的虛擬變項,則丟掉了那個本身就是現象的結構。
35.4.2 復原、週末與工作要求
復原的假設是傍晚從工作抽離會補回隔天要動用的資源。這是一項個體內的延宕(lagged)主張,也正是這份日誌建來檢驗的東西:把隔天早上的活力對前一晚的心理抽離作迴歸,作個人平均數中心化,並以第 5 章壓過的那份小心跨越夜晚的界線(night boundary),還原出 \(0.33\) 的係數,對照植入的 \(0.35\);一位工作者自己比平常更好的抽離,因此預報得了這位工作者自己比較高的活力。週末加上一段不連續。那不只是一條平滑週期上的低點,而是一次真正的跳躍;把它模型化成一次分段(piecewise)的位移,還原出 \(0.51\) 的週末活力提升,對照真值 \(0.50\)。圖 35.10 把它呈現成它本來的樣子,也就是一段週內的修復。工作要求也如植入的那樣調節整個系統:報告較高要求的工作者抽離得比較少,「要求對抽離」的係數是 \(-0.36\),對照真值 \(-0.30\),而且報告較低的基線(baseline)活力。保護活力的那個復原歷程,對最需要它的工作者最不可得,這是模型浮現出來的一項實質發現。最後,一天的中斷(interruption)次數是一個計數(count),而一個卜瓦松(Poisson)混合模型還原出它的結構:中斷隨工作要求而上升,對數率(log rate)的係數是 \(0.51\),對照真值 \(0.50\),並在週中達到高峰。這個計數結果由第 15 章的廣義線性混合模型處理,不硬塞進線性的模子裡。
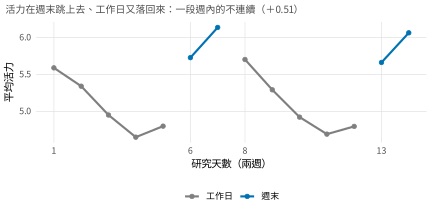
註:兩週日誌期間的平均活力,工作日與週末分開標示。活力在週末跳上去,在工作週重新開始時落回來,那是一段大約半個量尺點的週內不連續。分段模型抓得住它,平滑的每週週期則會把它糊掉。週末不只是一道梯度上低緊張的那一端,它是一個性質不同的狀態。
實務要點 • 實務:組織的取得管道與知情同意
組織的日誌研究靠層級式授予、而且收得回去的取得管道在跑,它的同意鏈有一個個人研究所沒有的結構。雇主允許研究一群員工,不等於那些員工同意參與,兩者必須分得清清楚楚:參與必須自願,不參與必須對主管不可見,否則資料是被強迫來的,估計也會被「誰敢拒絕」偏誤掉。組織資料還帶著另一種風險,個體內的發現會被讀成個別績效評估,因此研究要事前說明結果不會用來考核特定員工,並加以彙總,以保護個人不受可能對單一個案很好奇的管理階層打擾。陳述這些保障的方法一節不是樣板文字,它正是讓那個樣本值得信任的東西。
35.5 領域綜合
三個個案共享一份紀律,也共享一組會被這些領域的審查者反覆提出的異議。那份紀律是:個體內的結構才是研究對象。分配參數、行動者效果、復原延宕,全都是個體內的量,必須以它們的本性所要求的中心化、不確定性傳遞與因果謹慎來估計;把它們摘述成一個個體間或特質的網絡時,也不能把它們的不確定性洗掉,那正是代入謬誤過不了的那道標準。反覆出現的異議有三個。第一個是要求一次實驗,也就是那位把任何個體內關聯都讀成因果主張、然後問「操弄在哪裡」的審查者。誠實的回答是:這些設計估計的是個體內的關聯(association)與時間上的預測(prediction),它們限制因果(causal)假設,並不建立因果假設;從一個伴侶效果或一段領先延宕過度主張影響,正是那份警戒帳存在要防的錯誤。第二個是對樣本數的誤讀,也就是那位把八十對伴侶或兩百位工作者稱作小樣本的審查者。回答是層次特定(level-specific)的檢定力(power)素養:對個體內效果而言,相關的樣本是時點數乘以人數;個體間的樣本只管個體間的效果;一項設計的檢定力必須在估計標的所在的層次上評估,如第 4 章所述。第三個是把節律或星期幾當成麻煩的控制變項打發掉,那是把理論誤認成雜訊。表 35.6 收攏這些領域的報告義務,包括把個體內的發現翻譯成應用讀者所使用的語言。想走得更深的讀者可以從這些錨定文獻起步:密度分配的研究方案在 Fleeson (2001) 與 Fleeson and Jayawickreme (2015),雙人分析的經典在 Kenny et al. (2006)、日誌的手藝在 Laurenceau and Bolger (2005),復原與組織取樣的文獻在 Sonnentag (2003)、Sonnentag and Fritz (2007)、Beal (2015) 與 Gabriel et al. (2019)。這些正是個體內革命開始的地方,而它們獎賞的手藝就是本章一路實踐的那一種:把歷程模型化在它所住的地方,並且不說得比個體內資料所支持的更多。
表 35.6 領域的報告檢核表與個體內的翻譯。
| 項目 | 該報告什麼(以及怎麼翻譯) |
|---|---|
| 分配參數 | 位置尺度的估計值、它們的穩定性,以及拿它們當預測變項時的不確定性 |
| 中心化 | 用了哪一種中心化;個體內與個體間的效果有沒有保持分開 |
| 雙人結構 | 可區辨性、誤差結構,以及行動者/伴侶/個體間的分解 |
| 因果語言 | 關聯與預測,不是影響,除非有設計撐得起更強的說法 |
| 層次特定的樣本數 | 時點數與人數分開報告;檢定力在估計標的所在的層次上評估 |
| 翻譯 | 個體內的效果要說成「在某些天」或「對這個人而言」,不要說成特質上的差異 |
註:最後一列是這些領域長期的溝通任務。個體內效果描述的是一個人隨時間在自己身上的變異;把它翻譯成應用讀者所預期的個體間特質語言時,不能順手斷言一項個體內資料建立不了的個體間差異。
本章摘要
社會、人格與組織心理學正是個體內方法誕生的地方,而本章的教訓是:它們的現象就是個體內的結構,要用紀律去模型化。個案 A 把人格當成狀態的密度分配,把個人的平均數、變異性與反應性估計成特質參數,發現平均數高度穩定,更高階的參數是真的、只是比較有雜訊,並堅持一件事:分配參數帶進特質分析時,要一併帶進它的不確定性,否則就得付出代入謬誤造成的衰減。個案 B 建起多層次的行動者與伴侶模型,用中心化把個體內的行動者與伴侶效果和比較大的個體間關聯分開,還原出植入的結構,並顯示總平均數中心化會汙染行動者效果;接著估計共同命運的成長與不對稱的領先延宕,帶著「預測不是影響(influence)」的警戒。個案 C 把每週的週期當成理論來檢驗,不當成裝飾,還原出由傍晚抽離到隔天早上活力的個體內復原延宕,把週末模型化成一次真正的不連續,並用一個卜瓦松混合模型處理中斷的計數。綜合那一節是這些領域的審查者攻略,也是它的翻譯紀律:把歷程模型化在它所住的地方,在估計標的所在的層次上評估檢定力,並且不說得比個體內資料所支持的更多。
習題
- 35.1 反代入的展示。重現圖 35.3 的模擬,先把人層次的結果對個體內變異性的點估計作迴歸,再做一次變項含誤差校正,報出兩種做法的效果與區間寬度;接著把每人可用的時點數減半,說明衰減為什麼變得更嚴重。
- 35.2 分配參數即特質。在
affect_ema上配適第 16 章的位置尺度模型,估出個人平均數、個體內變異性與壓力反應性,依表 35.2 指名每一個參數操作化了哪一個人格構念,再做前後兩週的折半檢核,並寫出一段結果,說明三個參數的穩定性為什麼依序遞減。 - 35.3 中心化的陷阱。在
couples_diary上用 lme4 配適多層次的行動者與伴侶互倚模型,依表 35.3 定下可區辨性與誤差結構,支持一次作個人平均數中心化、一次作總平均數中心化;再依表 35.4 說明被汙染的那個行動者效果究竟回答了哪一個問題。 - 35.4 誰帶誰的警戒。依圖 35.8 的不對稱估計值,寫一份給關係治療師看的一頁備忘錄,說明伴侶 1 領先為什麼只是時間上的預測事實;至少提出兩個製造得出同樣不對稱的共享驅動因子,再說明在圖 35.7 的共同命運與平行歷程之間,選的為什麼是理論而不是配適。
- 35.5 節律與復原。在
work_week上以三角諧波與循環樣條各估一次每週的活力週期,依表 35.5 說出這個選擇編碼了什麼理論承諾;再把隔天早上的活力對前一晚的抽離作個人平均數中心化的迴歸,小心跨過夜晚的界線,並解讀圖 35.9 的兩格。 - 35.6 報告與翻譯。取一篇已發表的日誌或雙人論文,依表 35.6 逐列稽核,尤其看中心化與層次特定樣本數這兩列;再挑它一項個體內發現,依第 35.5 節的紀律翻譯給應用讀者,並指出原文哪裡說得比個體內資料所支持的更多。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 密度分配 | density distribution | 特質即一個人狀態的整組分配(承第 7 章);第 35.2 節 |
| 位置尺度模型 | location-scale model | 把個人的平均數與殘差變異性的對數一起模型化(承第 16 章);第 35.2 節 |
| 反應性 | reactivity | 狀態隨情境變動的斜率;一個隨機斜率;第 35.2 節 |
| 代入謬誤 | plug-in fallacy | 把一個估出來的參數當成已知量帶進第二階段(承第 16 章);第 35.2 節 |
| 變項含誤差校正 | errors-in-variables correction | 以已知的取樣變異數還原被衰減的效果;第 35.2 節 |
| 雙人組內相關 | dyadic intraclass correlation | 落在伴侶之間的變異數比例;第 35.3 節 |
| 行動者效果 | actor effect | 自己的預測變項對自己結果的個體內效果;第 35.3 節 |
| 伴侶效果 | partner effect | 對方的預測變項對自己結果的個體內效果;第 35.3 節 |
| 個人平均數中心化 | within-person centering | 把行動者效果與個體間關聯分開的關鍵;第 35.3 節 |
| 可區辨雙人 | distinguishable dyad | 兩位成員可依角色區分;決定模型的設定;第 35.3 節 |
| 共同命運 | common fate | 一條伴侶層次的軌跡同時驅動兩位伴侶;第 35.3 節 |
| 心理抽離 | psychological detachment | 傍晚從工作抽離;復原歷程的核心;第 35.4 節 |
| 三角諧波 | trigonometric harmonic | 在指定週期上放一組正弦與餘弦(承第 23 章);第 35.4 節 |
| 循環樣條 | cyclic spline | 讓資料選形狀、但強制週期閉合(承第 30 章);第 35.4 節 |
參考文獻
Baird, B. M., Le, K., & Lucas, R. E. (2006). On the nature of intraindividual personality variability: Reliability, validity, and associations with well-being. Journal of Personality and Social Psychology, 90(3), 512–527. https://doi.org/10.1037/0022-3514.90.3.512
Beal, D. J. (2015). ESM 2.0: State of the art and future potential of experience sampling methods in organizational research. Annual Review of Organizational Psychology and Organizational Behavior, 2, 383–407. https://doi.org/10.1146/annurev-orgpsych-032414-111335
Bolger, N., Davis, A., & Rafaeli, E. (2003). Diary methods: Capturing life as it is lived. Annual Review of Psychology, 54, 579–616. https://doi.org/10.1146/annurev.psych.54.101601.145030
Bolger, N., DeLongis, A., Kessler, R. C., & Wethington, E. (1989). The contagion of stress across multiple roles. Journal of Marriage and the Family, 51(1), 175–183. https://doi.org/10.2307/352378
Butler, E. A. (2011). Temporal interpersonal emotion systems: The “TIES” that form relationships. Personality and Social Psychology Review, 15(4), 367–393. https://doi.org/10.1177/1088868311411164
Fleeson, W. (2001). Toward a structure- and process-integrated view of personality: Traits as density distributions of states. Journal of Personality and Social Psychology, 80(6), 1011–1027. https://doi.org/10.1037/0022-3514.80.6.1011
Fleeson, W., & Jayawickreme, E. (2015). Whole trait theory. Journal of Research in Personality, 56, 82–92. https://doi.org/10.1016/j.jrp.2014.10.009
Gabriel, A. S., Podsakoff, N. P., Beal, D. J., Scott, B. A., Sonnentag, S., Trougakos, J. P., & Butts, M. M. (2019). Experience sampling methods: A discussion of critical trends and considerations for scholarly advancement. Organizational Research Methods, 22(4), 969–1006. https://doi.org/10.1177/1094428118802626
Gistelinck, F., & Loeys, T. (2019). The actor-partner interdependence model for longitudinal dyadic data: An implementation in the SEM framework. Structural Equation Modeling: A Multidisciplinary Journal, 26(3), 329–347. https://doi.org/10.1080/10705511.2018.1527223
Ilies, R., Scott, B. A., & Judge, T. A. (2006). The interactive effects of personal traits and experienced states on intraindividual patterns of citizenship behavior. Academy of Management Journal, 49(3), 561–575. https://doi.org/10.5465/amj.2006.21794672
Kenny, D. A., Kashy, D. A., & Cook, W. L. (2006). Dyadic data analysis. Guilford Press.
Laurenceau, J.-P., Barrett, L. F., & Pietromonaco, P. R. (1998). Intimacy as an interpersonal process: The importance of self-disclosure, partner disclosure, and perceived partner responsiveness in interpersonal exchanges. Journal of Personality and Social Psychology, 74(5), 1238–1251. https://doi.org/10.1037/0022-3514.74.5.1238
Laurenceau, J.-P., & Bolger, N. (2005). Using diary methods to study marital and family processes. Journal of Family Psychology, 19(1), 86–97. https://doi.org/10.1037/0893-3200.19.1.86
Ledermann, T., & Kenny, D. A. (2012). The common fate model for dyadic data: Variations of a theoretically important but underutilized model. Journal of Family Psychology, 26(1), 140–148. https://doi.org/10.1037/a0026624
Reis, H. T., & Wheeler, L. (1991). Studying social interaction with the Rochester Interaction Record. Advances in Experimental Social Psychology, 24, 269–318. https://doi.org/10.1016/S0065-2601(08)60332-9
Sels, L., Ceulemans, E., & Kuppens, P. (2019). All’s well that ends well? A test of the peak-end rule in couples’ conflict discussions. European Journal of Social Psychology, 49(4), 794–806. https://doi.org/10.1002/ejsp.2547
Sonnentag, S. (2003). Recovery, work engagement, and proactive behavior: A new look at the interface between nonwork and work. Journal of Applied Psychology, 88(3), 518–528. https://doi.org/10.1037/0021-9010.88.3.518
Sonnentag, S., & Fritz, C. (2007). The Recovery Experience Questionnaire: Development and validation of a measure for assessing recuperation and unwinding from work. Journal of Occupational Health Psychology, 12(3), 204–221. https://doi.org/10.1037/1076-8998.12.3.204
Wheeler, L., & Reis, H. T. (1991). Self-recording of everyday life events: Origins, types, and uses. Journal of Personality, 59(3), 339–354. https://doi.org/10.1111/j.1467-6494.1991.tb00252.x
Wright, A. G. C., & Zimmermann, J. (2019). Applied ambulatory assessment: Integrating idiographic and nomothetic principles of measurement. Psychological Assessment, 31(12), 1467–1480. https://doi.org/10.1037/pas0000685
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。