第 22 章
成長混合分配模型、潛在類別成長與潛在轉移模型
第五部分到目前為止的每一個模型,都假設一組參數(parameter)就描述得了所有人:一條成長曲線(growth curve),個別差異環繞在它周圍;一組適用於每一個人的交叉延宕(cross-lagged)動態。本章要考慮另一種可能:母體(population)其實由若干個性質截然不同的次群體(subgroup)混合而成,各有各的軌跡(trajectory),或各有各的狀態序列。這個想法很直覺,從發展精神病理學(developmental psychopathology)到物質使用研究(substance-use research)都極受歡迎:變化也許不是一條連續體(continuum),而是幾種類型,像是早期反應者與無反應者、有韌性(resilience)的與易感的、持續型與中止型。把這個直覺形式化的工具是潛在類別成長分析(latent class growth analysis)、成長混合分配模型(growth mixture model)與潛在轉移分析(latent transition analysis),它們是整套縱貫工具箱裡最強大、也最常被誤用的幾件。資料裡根本沒有類別,它們照樣樂意交出幾個類別來;十年的方法學研究已經說明,光是一個偏態(skewed)的母體就足以騙倒它們。本章因此背負著前面幾章沒有的雙重任務:既要把這套做法教到你能稱職使用,也要把那份懷疑(skepticism)養成永久的反射動作,免得交出來的次群體是統計假象(artifact),不是真實的種類。能力與懷疑要一起養成,因為在混合分配模型裡,這兩件事是同一項本事。
學習目標
讀完本章之後,你應該能夠:(1) 分辨把類別內變異數(within-class variance)固定為零的潛在類別成長分析,與把它釋放出來的成長混合分配模型,並預測這個選擇如何改變類別的數目與意義;(2) 執行一套多重準則(multi-criteria)的類別數決定流程,同時用上訊息準則(information criteria)、拔靴法概似比檢定(bootstrap likelihood ratio test)、熵(entropy)、類別大小、可解讀性與複製(replication),絕不只看單一指標;(3) 診斷過度抽取(overextraction),尤其是 Bauer 與 Curran 指出的那一種,也就是非常態(nonnormal)的單一母體會產出虛假的類別,並做相應的抗脆弱(anti-fragility)檢查;(4) 以三步驟法(three-step methods)把類別連到共變項(covariate)與遠端結果變項(distal outcome),並說明先分類再迴歸(classify-then-regress)與一步驟法(one-step)為什麼都不行;(5) 設定一個測量恆等(invariant)的潛在轉移模型,並解讀它的轉移矩陣(transition matrix);(6) 把潛在轉移分析接到隱藏馬可夫(hidden Markov)模型的傳統上;(7) 依逐漸成形的 GRoLTS 標準報告一份混合分配分析。
22.1 異質性:程度的差別,還是種類的差別?
在任何軟體跑起來之前,有一個實質問題必須先面對:一組軌跡裡的異質性(heterogeneity),是程度的差別還是種類的差別?向度觀(dimensional view)主張人與人之間連續地不同,有些人在一個共同的歷程(process)周圍下降得比別人快,任何分組都只是為了敘述方便,對連續體所作的摘要。類別觀(categorical view)主張母體裡確實有性質不同的次類型(subtype),各由自己的歷程支配,一個人屬於其中一型,而這些型是真的。這個區分要緊,是因為兩種觀點許可的主張不同。向度式的發現支撐的是「什麼變項可以預測改變速率」這類陳述;類別式的發現若為真,支撐的是「有哪幾種人」這類陳述,是誰屬於持續型、誰屬於中止型,而且它會招來針對類別的介入(intervention)。混合分配模型(mixture model)配合的是類別觀,而它們的誘惑力恰恰在於:不管類別是不是真的,它們都會交出類別來。
一個值得警惕的範例是 Moffitt (1993) 的反社會行為發展分類體系(developmental taxonomy)。它提出兩種性質不同的犯罪者:一小群生命歷程持續型(life-course-persistent),一大群青少年期限定型(adolescence-limited),兩者的病因(etiology)不同。這個分類體系影響極大,組織了數十年的研究,而且是理論驅動的,不是配適演算法(fitting algorithm)的產物。但它也變成另一種實徵工作的樣板:配適一個成長混合分配模型,跑出幾個類別,這幾個類別隨即被實體化(reify)成「被發現的類型」,冠上名字與臨床意義,憑藉的常常只是一個訊息準則(information criterion)。從 Moffitt 那種理論先行的分類體系,到軟體先行的軌跡類別抽取(trajectory class extraction),這段距離正是本章要你從頭盯到尾的。類別可以是世界的真實特徵,可以是對連續體的一個好用近似,也可以是海市蜃樓;模型分辨不出這三者,只有實質理論、複製,以及下文要發展的各項診斷(diagnostics)才分辨得出來 (Bauer, 2007)。
圖 22.1 把這個知識論(epistemic)上的重點具體化。它畫了三組看起來很像的軌跡,就是無數混合分配論文開頭都會出現的那種義大利麵圖(spaghetti plot)。第一組是單一個異質的母體,一個歷程配上很大的個別變異。第二組是三個潛在類別成長的類別,界線俐落的次群體,類別內除了測量誤差(measurement error)之外沒有變異數。第三組是三個成長混合分配的類別,次群體各自帶著自己的內部散布(spread)。用眼睛看,這三組幾乎分不出來;盯著原始軌跡看再久,也不會知道是哪一個生成故事(generative story)產出了它們。這就是本章其餘篇幅要處理的問題,也是本章堅持「答案不可能只從資料裡來」的理由。
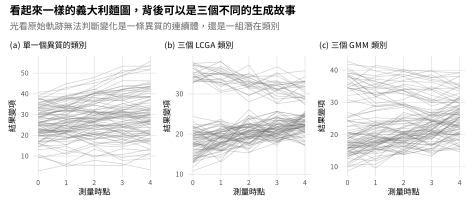
註:同一種樣式的義大利麵圖,可以來自一個異質的母體 (a),可以來自類別內沒有變異數、界線俐落的潛在類別成長類別 (b),也可以來自類別內有散布的成長混合分配類別 (c)。原始軌跡分不出這三種說法,所以撐起論證的必須是類別數的決定流程與本章的各項診斷,不是目視檢查。
把類別式異質性形式化的這一族模型,是第 19 章的單一類別潛在成長模型(latent growth model)經過兩次擴充而來。第一次擴充讓成長平均數(growth means)在一組潛在類別(latent class)之間不同,同時強迫同一類別內的每個人都落在同一條曲線上(只差測量誤差),得到的是 Nagin 傳統的潛在類別成長分析(latent class growth analysis, LCGA)模型 (Nagin, 1999)。第二次擴充再把成長因素(growth factors)在每個類別之內釋放,讓每個類別自己就是一個小型的潛在成長模型,得到的是 Muthén 與 Shedden 傳統的成長混合分配模型(growth mixture model, GMM) (Muthén & Shedden, 1999)。單一類別的成長模型則是兩者在類別數為一時的特例。Jung and Wickrama (2008) 與 Ram and Grimm (2009) 為這個區分提供了好讀的入門,Masyn (2013) 與 Grimm et al. (2017) 給了完整的處理。表 22.1 把三者並排攤開:它們在假設上的差異會產生結論上的大差異,最看得見的一項就是抽出幾個類別。
表 22.1 潛在成長、潛在類別成長與成長混合分配模型的比較。
| 特徵 | 潛在成長(第 19 章) | LCGA(Nagin) | GMM(Muthén) |
|---|---|---|---|
| 類別數 | 一個 | 數個 | 數個 |
| 類別內成長變異數 | 自由估計 | 固定為零 | 自由估計 |
| 類別捕捉的是 | 無(單一母體) | 一條有別於其他類別的平均軌跡 | 一條有別於其他類別、且帶散布的軌跡 |
| 典型的類別數 | – | 較多(以類別吸收變異數) | 較少 |
| 主要風險 | 若次群體真的存在則會漏掉 | 限制過嚴造成的過度抽取 | 不收斂;非常態造成的過度抽取 |
| 把異質性讀成 | 連續的 | 類別的,界線俐落 | 類別的,界線模糊 |
註:LCGA 與 GMM 對「類別問題」的回答方式不同。LCGA 禁止類別內變異,往往需要更多類別才配適得了同一批資料,所以 LCGA 與 GMM 的類別數不可互相比較,這一點常見陷阱方塊還會再談。表中「不適用」以短橫線標示。
22.2 模型設定與估計
兩個模型只差一項共變數(covariance)上的限制,後果卻很大。把類別 \(k\) 之內的成長模型寫成 \(\mathbf{y}_i = \mathbf{Z}\bm{\beta}_k + \mathbf{Z}\mathbf{b}_i + \bm{\varepsilon}_i\),其中 \(\mathbf{Z}\) 裝的是時間編碼(time codes),\(\bm{\beta}_k\) 是該類別的成長平均數,\(\mathbf{b}_i\) 是這個人的隨機偏離(random deviations),\(\bm{\varepsilon}_i\) 是殘差雜訊。LCGA 把隨機效果(random effect)的共變數矩陣設為零,\(\mathrm{Var}(\mathbf{b}_i)=\mathbf{0}\),同一類別的每個成員於是精確地共用該類別的曲線,只差殘差誤差:類別是一條條俐落的線,類別內所有的散布都算成雜訊。GMM 把這個共變數釋放出來,每個類別就成了環繞自己平均曲線的一團雲。圖 22.2 在成長因素構成的空間裡畫出這個差別:LCGA 把一個類別看成一個點,GMM 把它看成一個橢圓。這項限制後果嚴重,是因為真實的母體幾乎一定有類別內的散布,而禁止類別內散布的模型只能改用別的方式把它表示出來,方式就是增加類別。這就是 LCGA 在同一批資料上比 GMM 抽出更多類別的機制,也是兩者的類別數絕不可以當成同一件事來比較的理由。
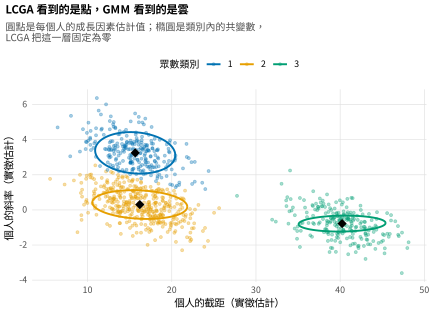
註:每個圓點是某個人由 classes_sim 算出來的成長因素估計值,顏色是成長混合分配的眾數類別(modal class)。橢圓是成長混合分配的類別內共變數,也就是 LCGA 固定為零的那份散布;固定為零之後,每個類別就塌縮成中心那個黑色的點。母體若真的有類別內變異數,LCGA 只能靠多加幾個類別來表示它。
類別數選定之後,兩個模型都以最大概似(maximum likelihood)透過期望最大化(expectation-maximization, EM)演算法估計。演算法在兩件事之間交替:先在當前參數之下算出每個人屬於各類別的後驗機率(posterior probability),再把參數更新成以後驗機率加權的量。混合分配的概似函數要對未知的類別歸屬求和,曲面上佈滿局部極大值(local maxima),「從單一起始值跑一次」因此不可信。這個領域最後定下來的紀律是大量的隨機起始值(random starts),數十到數百個,保留對數概似(log-likelihood)最好的那個解;關鍵在於確認這個最佳值被好幾個起始值重複達到,而不是只出現過一次就再也不見。一個只出現一次的最佳對數概似,是虛假解的警訊。基礎概念方塊給出概似函數與演算法,實務要點方塊整理可重製性(reproducibility)所要求的起始值與種子(seed)衛生習慣。
基礎概念 • 混合分配的概似、EM,以及熵為什麼不是配適指標
對一個 \(K\) 類的混合分配而言,第 \(i\) 個人資料的邊際密度(marginal density)是 \(f(\mathbf{y}_i)=\sum_{k=1}^{K}\pi_k\, f_k(\mathbf{y}_i\mid\bm{\theta}_k)\),也就是各類別內密度以混合權重(mixing weights) \(\pi_k\) 加權之後的和,權重加總為一。對數概似 \(\sum_i \log f(\mathbf{y}_i)\) 沒有封閉解(closed form),因為類別標籤是遺漏的。EM 於是在期望步驟(expectation step)引進後驗機率 \(\hat p_{ik}=\pi_k f_k(\mathbf{y}_i)/\sum_j \pi_j f_j(\mathbf{y}_i)\),再於最大化步驟(maximization step)最大化完整資料對數概似的期望值,把 \(\pi_k\) 更新為後驗機率的平均數,把 \(\bm{\theta}_k\) 更新為後驗機率加權的估計值。反覆迭代會讓觀測資料的對數概似單調上升到一個局部極大值。常被一併報告的熵(entropy)是 \(E_K = 1 - \sum_i\sum_k(-\hat p_{ik}\ln \hat p_{ik})/(N\ln K)\),衡量的是人被分得多乾淨,後驗機率都接近零或一時它會趨近一。它完全沒有說 \(K\) 對不對:一個兩類模型可以把人俐落地分進兩個錯的類別裡。熵是分類品質(classification quality)的性質,報告它是為了解讀,永遠不是選類別數的準則。
實務要點 • 隨機起始值、種子,以及把解的路徑寫下來
把隨機起始值的個數當成一項要報告的分析決定,不要當成預設值。簡單的模型也許數十個起始值就夠;釋放了類別內共變數的 GMM 要用多得多的起始值,一直加到最佳對數概似在好幾個獨立起始值上重複出現為止。設定並報告種子,讓解可以重製,並把完整路徑寫下來:起始值幾個、收斂(convergence)了幾個、最佳值有沒有重複出現,以及在每一個 \(K\) 上遇到的邊界解(boundary solutions)或不收斂問題。邊界解、負變異數與不收斂都是模型與資料不合的診斷訊息,不是可以默默丟掉的麻煩。本章的分析用的是從頭寫起、設好種子並多重起始的期望最大化演算法,好讓每一步都看得見;實際研究會改用專門套件(軟體提示方塊列了幾個),但估計上的現實完全一樣,尤其是局部極大值與多重起始值的要求。
22.3 類別數的決定:多重準則的流程
選幾個類別是其他一切所依賴的那個決定,而它真的很難,因為沒有任何單一統計量能為它作出定論。主力指標是訊息準則,它們在配適與複雜度之間權衡:貝氏訊息準則(Bayesian information criterion, BIC)、它的樣本數校正版本(sample-size-adjusted BIC, aBIC),以及一致 AIC(consistent AIC, CAIC),三者都是越小越好。在至今仍是參照點的 Nylund et al. (2007) 模擬中,BIC 與 aBIC 表現良好,一般的 Akaike 訊息準則(Akaike information criterion, AIC)則會過度抽取;最可靠的單一指標是拔靴法概似比檢定(bootstrap likelihood ratio test, BLRT),它以模擬概似比(likelihood ratio)的虛無分配(null distribution)來比較 \(K\) 類與 \(K-1\) 類模型。與這些並列的還有幾項:報告分類品質而非用來選模的熵;最小類別的大小,因為一個只佔樣本百分之二的類別很少是站得住腳的類型;實質上的可解讀性;以及在對半分割(split halves)或獨立樣本上的複製。流程是把它們全部當成一組證據來看,絕不把單一指標讀成判決 (Nylund-Gibson & Choi, 2018)。
圖 22.3 展示這組證據在真有三個類別的 classes_sim 資料上組起來的樣子。訊息準則出現明顯的手肘(elbow),在三個類別處達到最小值,BIC 到第四類又回升。拔靴法概似比檢定由一類到兩類、由兩類到三類都顯著,由三類到四類則不顯著,這個型態說的是第四個類別沒有加進任何東西。熵很高,最小類別到三類為止都維持在相當大的比例;第四、第五個虛假類別一出現,就從樣本上削下薄薄幾條,最小類別隨之崩掉。每一項準則合起來讀,指向的都是三,而三就是真相。表 22.2 整理這些指標、它們已知的行為,以及它們該扮演的角色;表 22.3 把本書逐步的類別數決定流程寫成一個可以預先註冊(preregister)的形式。
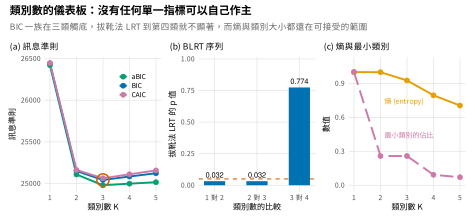
註:訊息準則 (a) 出現手肘並在三個類別處達到最小值;拔靴法概似比檢定 (b) 到三個類別為止都顯著,對第四個類別則不顯著;熵與最小類別的佔比 (c) 到三類為止都可接受,接著虛假類別出現,最小類別隨之崩掉。沒有任何單一子圖能作決定,是它們的一致才可以。
表 22.2 類別數決定的各項指標與其角色。
| 指標 | 行為 | 在流程中的角色 |
|---|---|---|
| BIC | 對複雜度的懲罰重;可靠,略偏保守 | 主要指標;找最小值或手肘 |
| aBIC | 樣本數校正較輕;比 BIC 稍不保守 | 佐證 BIC;樣本數小時有用 |
| CAIC | 一致 AIC;與 BIC 一樣保守 | 佐證用的訊息準則 |
| AIC | 在模擬中會過度抽取 | 不建議用來選模 |
| BLRT | 以拔靴法建立概似比的虛無分配;檢定力高 | 逐一以 \(K\) 對 \(K-1\) 檢定;不顯著就停 |
| 熵 | 分類品質,不是配適 | 為解讀而報告;絕不用來選模 |
| 最小類別 | 最稀有那個類別的人數或比例 | 合理性篩檢;不要相信只有薄薄幾條的類別 |
| 可解讀性、複製 | 實質意義;跨樣本的穩定性 | 與其他準則同等,不是事後補充 |
註:在模擬文獻裡,拔靴法概似比檢定與 BIC 是最值得信賴的兩個單一指標,但這個決定是多重準則的:訊息準則、BLRT、類別大小、可解讀性與複製要一起看。
22.3.1 Bauer 與 Curran 的警告
這一片文獻裡最重要的單一結果是個否定的結果。Bauer and Curran (2003) 與 Bauer and Curran (2004) 說明,成長混合分配模型只要配適到單一母體的資料上,而該母體是非常態的,就會抽出多個類別。原因在於常態的混合分配可以近似一個偏態或厚尾(heavy-tailed)的分配,而配適演算法拿多出來的類別去做的正是這件事。這種情況下的類別不是次群體,是用來逼近一個形狀的基底函數(basis functions)。這個結果不是無關緊要的邊緣現象,而是對每一份混合分配分析持續存在的威脅,因為真實的心理變項本來就經常偏態。圖 22.4 是本章的招牌展示。資料來自單一個偏態母體,就一群人,以右偏(right-skewed)的截距與共同的斜率生成。用常態的成長混合分配去配適,訊息準則會偏好好幾個類別,模型也很樂意把這條偏態的連續體切成一個低分類別與一個高分類別,切點落在尾巴上某個隨便的位置。這裡沒有次群體,只有一個偏態的母體,那些類別是「把常態成分硬套到非常態形狀上」所產生的假象。
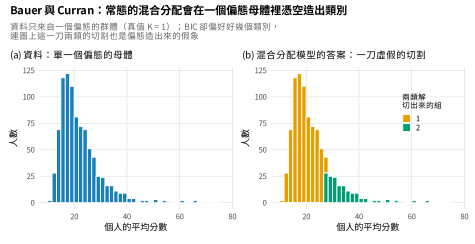
註:左:資料是一個右偏的母體(真正的類別數是一)。右:常態的成長混合分配(BIC 認為它比單一類別更好)把這條連續體切成幾個虛假的類別,切點落在尾巴上某個隨便的位置。這些類別逼近的是那份偏態,不是次群體。光是偏態就足以製造出類別。
對付這種失敗的防線很具體,而且應該成為例行工作。第一道是問「這些類別會不會只是分配形狀的假象」,做法是配適允許類別內分配非常態的模型,也就是在軟體支援時改用偏態常態(skew-normal)或偏態 \(t\)(skew-\(t\))的混合分配,看看成分被允許偏態之後,多出來的類別還在不在。第二道是納入共變項的穩定性檢查:加入共變項之後大幅改變的類別解,或只在沒有共變項的模型裡才出現的類別解,都很可疑,因為真實的次群體不該因為引進一個預測變項就瓦解。第三道是比較的紀律:問一個連續的模型,也就是帶非常態分配的單一類別成長模型或一個因素模型(factor model),是不是把資料配適得一樣好;如果是,精簡原則(parsimony)加上 Bauer 與 Curran 的結果,兩者一起勸阻你把這些類別實體化。這幾道防線沒有一道算是保證。Bauer 與 Curran 這一系文獻誠實的結論是知識論上的謙遜:配適良好的混合分配與潛在類別的存在相容,卻不能確立潛在類別存在,而一份報告的用語就該這麼寫。
表 22.3 本書的類別數決定流程。
| 步驟 | 作法 |
|---|---|
| 1 | 從 \(K=1\) 配適到一個寬裕的上限,隨機起始值的個數要寫下來;確認每一個 \(K\) 的最佳對數概似都重複出現 |
| 2 | 把訊息準則(BIC、aBIC、CAIC)排在一起,讀最小值或手肘,不要只讀一個指標 |
| 3 | 對相鄰的 \(K\) 逐一跑拔靴法概似比檢定;在它變得不顯著的地方停下來 |
| 4 | 篩檢熵(為了解讀)與最小類別的人數(不要相信薄薄幾條的類別) |
| 5 | 探測 Bauer 與 Curran 的風險:非常態成分的模型、納入共變項的穩定性,以及與連續模型的比較 |
| 6 | 檢查在對半分割或獨立世代(cohort)上的複製 |
| 7 | 以實質可解讀性作最後裁決,可能的話把準則預先註冊;報告完整的解路徑 |
註:這個流程刻意寫成多個步驟,而且可以預先註冊。它的用意是讓「幾個類別」這個決定成為一份有紀錄的論證,不是讀一個統計量。
第六步的穩定性檢查值得自己一張圖,因為它最常被忽略。圖 22.5 在資料的兩個獨立半樣本上重跑類別數的決定。三類解複製出來了:BIC 在兩個半樣本都在三類觸底。一個在全樣本出現、卻在任一半樣本都不出現的解,或是一半給三類、另一半給四類的解,都在警告你這些類別不穩定,多半不是真的。複製不是選完模型之後補上的形式,它是選模的一部分。
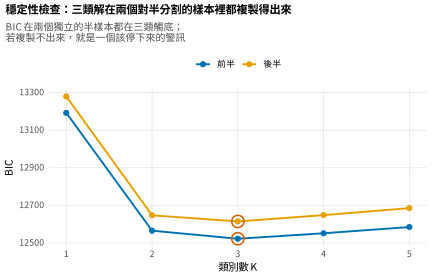
註:BIC 在 classes_sim 的兩個獨立半樣本都在三個類別處觸底,三類解因此複製得出來。在保留的半樣本裡沒有再度出現的解,或在兩半給出不同類別數的解,就是不穩定的證據,也是懷疑的理由。
22.4 把類別放進脈絡:輔助變項
一個類別解很少就是分析的終點;這些類別本來就是要拿去和別的變項建立關聯,可能是預測歸屬的變項,也可能是一個遠端結果變項。天真而錯誤的做法是把每個人指派到最可能的那個類別,再把這項指派當成觀測變項放進迴歸,用共變項預測眾數類別,或用眾數類別預測結果。問題出在分類誤差(classification error)。眾數指派丟掉了後驗機率裡的不確定性,把以 \(0.6\) 的機率分好類的人和以 \(0.99\) 分好類的人當成一樣;由此產生的誤分類(misclassification)會讓類別進入的每一個關係都被衰減,把共變項效果與遠端結果的差異都推向零。另一種做法是把共變項直接建進混合分配模型,也就是一步驟法。它避開了衰減,卻製造出另一個問題:共變項於是參與定義了類別,加入或移除一個預測變項就會重塑潛在類別,測量模型(measurement model)也不再與結構問題分得開。圖 22.6 畫出這兩條天真路線為什麼都失敗,以及三步驟的邏輯改做了什麼。
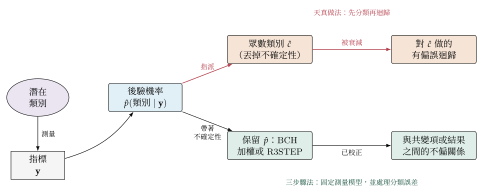
註:混合分配交出來的是後驗類別機率。天真路線(上方,紅色)把它們塌縮成一個眾數類別,丟掉分類的不確定性,於是任何以眾數類別為自變項或依變項的迴歸都會被誤分類衰減。三步驟路線(下方)先把測量模型固定住,再把分類的不確定性帶進共變項的分析(R3STEP)或遠端結果的分析(BCH),藉此校正誤差。圖上沒有畫出來的一步驟法,則讓共變項回頭重塑了類別。
三步驟法把這兩件事分開。它先把測量模型固定住,單靠指標估出類別;接著把類別連到共變項與結果上,而連的方式會把分類誤差算進去,不是忽略它。預測類別歸屬的共變項,現在的工具是 R3STEP 法;遠端結果的工具則是 Vermunt (2010) 與 Bakk and Vermunt (2016) 的 BCH 法,它源自 Bolck et al. (2004) 的洞見:分類誤差矩陣是可以估計並反轉的,反轉之後就能把衰減撤銷。這幾個步驟在 Mplus 中的實作見 Asparouhov and Muthén (2014),Nylund-Gibson et al. (2019) 則直接比較了幾種處理遠端結果的做法。表 22.4 把這些方法對應到它們回答的問題上。圖 22.7 在 resp_classes 資料上示範這項校正;這是一份治療反應的混合分配資料,植入了三個類別,早期反應者、漸進反應者與無反應者,歸屬由基線症狀嚴重度(baseline symptom severity)驅動,復發(relapse)風險則依類別而異。前兩個類別把生成的斜率還原了出來,\(-3.17\) 與 \(-1.41\) 對上真值 \(-3.0\) 與 \(-1.5\);第三個類別最小、也最不分離,還原得很差,斜率是 \(+0.21\),真值卻是 \(-0.2\),眾數成員只有 56 人,真正的成員有 127 人。在遠端結果這一邊,真實的復發機率 \(0.15\)、\(0.30\) 與 \(0.65\) 被眾數指派往樣本平均拉,變成 \(0.18\)、\(0.34\) 與 \(0.52\),而 BCH 校正把它們拉回真值附近的 \(0.15\)、\(0.35\) 與 \(0.57\)。在預測變項這一邊,嚴重度對無反應者歸屬的真實效果是 \(1.20\) 的對數勝算(log-odds),眾數指派把它衰減成 \(1.03\);本章用的後驗加權近似同樣沒有把它還原出來,只到 \(0.95\),因為單靠加權並不能像 BCH 的反轉那樣撤銷誤分類,要還原得靠完整的 R3STEP 實作。對兩個分得開的類別而言,衰減幅度不大;至於無反應者這一類,真正的成員只有百分之四十三進得來,衰減就不小了,而這正是校正發揮價值的情境。
表 22.4 混合分配模型的輔助變項方法。
| 方法 | 回答的問題 | 誤差的處理 | 註記 |
|---|---|---|---|
| 先分類再迴歸 | 兩者皆可 | 沒有處理;眾數類別被當成觀測變項 | 會被衰減;不建議 |
| 一步驟法 | 兩者皆可 | 處理正確,但共變項會重塑類別 | 測量與結構分不開 |
| R3STEP | 共變項預測類別 | 固定測量模型;把誤差模型化 | 用於歸屬的預測變項 |
| BCH | 類別預測遠端結果 | 反轉分類誤差矩陣;穩健 | 用於遠端結果;加權有可能出現負權重 |
| Lanza 法(DCAT) | 類別預測遠端結果 | 以模型描述遠端變項的密度 | BCH 的替代方案 |
註:R3STEP 與 BCH 分別是預測變項與遠端結果目前的標準;Lanza et al. (2013) 的 DCAT 則是遠端結果的另一個選擇。R 這一側的涵蓋仍不齊全,許多應用研究在 Mplus 裡跑這些方法。
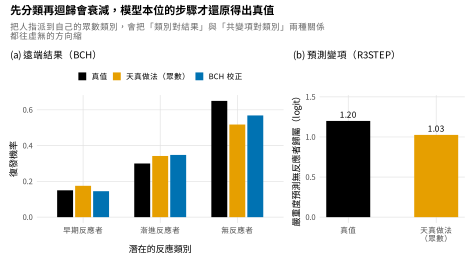
註:在 resp_classes 上:(a) 各類別真實的復發機率(黑色)被眾數指派往平均拉(橘色),再被 BCH 校正拉回來(藍色)。(b) 嚴重度預測無反應者歸屬的真實對數勝算(黑色)在眾數指派之下被衰減(橘色)。熵高時偏誤不大,隨著分類變得不確定而增大。
22.5 潛在轉移分析
到目前為止的模型分類的是整條軌跡:一個人在整個研究期間都屬於同一個軌跡類別。另一種類別式的問題問的不是一個人屬於哪一種軌跡型,而是這個人在每個時點佔據哪一個狀態(status),以及隨時間如何在狀態之間移動。一個學生可能在某一波是投入的,下一波是矛盾的,第三波是疏離的;關心的對象是狀態的序列,以及狀態之間的轉移機率(transition probability)。潛在轉移分析(latent transition analysis, LTA)把這件事形式化,Collins and Lanza (2010) 給了它一本專書的處理。它由每一波的一個潛在類別測量模型組起來:狀態在每一波由一組類別指標推論出來,再由一個轉移結構把各波接起來。圖 22.8 畫出這個架構,每一波有一個潛在狀態由它的指標測量,狀態之間由「這一波到下一波」的轉移機率連起來。
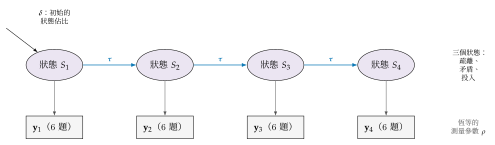
註:每一波的潛在狀態 \(S_w\)(疏離、矛盾、投入三者之一)由六個二元指標測量,題目反應機率 \(\bm{\rho}\) 是狀態特定的,且跨時間恆等。初始狀態佔比 \(\bm{\delta}\) 啟動這條鏈,轉移矩陣 \(\bm{\tau}\) 把相鄰的狀態接起來。這個結構就是一個隱藏馬可夫模型,只是配上類別式的測量模型與很少的時點。
這個模型有三組參數。測量參數給的是在某狀態之下對每一個指標作肯定反應的機率,它們應該跨波維持恆等(invariant),這是第 18 章縱貫測量恆等性(longitudinal measurement invariance)在類別世界的回聲:一個狀態必須在每個時點都指同一件事,狀態的改變才是可解讀的改變,不是「狀態本身的意思變了」。初始狀態參數給的是第一波各狀態在母體中的佔比。轉移參數構成一個矩陣,第 \(a\) 列第 \(b\) 行的元素是「現在在狀態 \(a\)、下一波移到狀態 \(b\)」的機率,對角線就是留在原狀態的機率。估計同樣以期望最大化進行,用的是隱藏馬可夫模型(hidden Markov model)裡熟悉的前向後向遞迴(forward-backward recursion),而它把結構還原得不錯。在 engage_status 資料上(六個二元投入指標、測了四波、植入三個狀態),配適出來的模型還原了恆等的題目機率、接近真值 \(0.30\)、\(0.35\)、\(0.35\) 的初始佔比,以及一個對角線接近 \(0.71\)、\(0.65\)、\(0.73\) 的轉移矩陣,正確反映出「多數人停留」的移動者與停留者(mover-stayer)結構:大多數學生一波到下一波都維持原狀態。表 22.5 是這些參數與恆等要求的對照表。
表 22.5 潛在轉移分析:參數與要求。
| 參數 | 意義 | 要求或註記 |
|---|---|---|
| 題目反應機率 \(\bm{\rho}\) | 在某狀態之下對各指標作肯定反應的機率 | 跨波維持恆等,狀態的意義才穩定 |
| 初始佔比 \(\bm{\delta}\) | 第一波各狀態的比例 | 加總為一 |
| 轉移矩陣 \(\bm{\tau}\) | \(P(\text{第 } w{+}1 \text{ 波的狀態} \mid \text{第 } w \text{ 波的狀態})\) | 每一列加總為一;對角線是留在原狀態的機率 |
| 移動者與停留者變體 | 有些人從不移動,其他人會轉移 | 一種加了限制的轉移結構 |
| 狀態數 | 每一波的潛在類別數 | 由類別數決定流程逐波選定 |
註:測量參數的恆等性,是縱貫測量恆等性(第 18 章)在類別世界的對應物:沒有它,一項看起來的轉移可能只是「狀態的意思變了」,而不是這個人變了。
圖 22.9 以熱圖(heatmap)呈現估計出來的轉移矩陣,並畫出四波之間狀態盛行率(prevalence)隨之而來的演變。熱圖由對角線主導,這是以停留者為主的母體的招牌特徵,非對角的流動不大。把初始佔比透過轉移矩陣一波一波推下去,可以看到母體組成在小額轉移的累積之下緩緩漂移,這裡是往矛盾這個中間狀態靠。這就是這個模型在解讀上的收穫:它給的不是一張靜態的分類表,而是一段關於移動的描述,關於一個母體如何隨時間在各狀態之間重新分配。
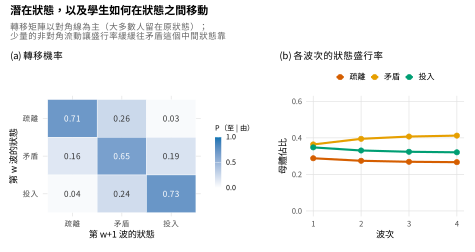
註:左:由 engage_status 估計出來的轉移矩陣,由對角線主導,是一個以停留者為主的母體的印記。右:各狀態在各波的母體佔比,由初始佔比透過轉移矩陣推算而得;少量的非對角流動讓盛行率隨時間緩緩位移。
就結構而言,潛在轉移分析是一個隱藏馬可夫模型,只是配上類別式的測量模型與很少的時點。這層關聯值得點明,因為它把潛在轉移分析放進了一個更大的家族。時點數不多時,像大多數追蹤研究那樣,潛在轉移分析的框架與它那種「一波一波」的解讀最自然。序列很長時,第 24 與 26 章的動態系統框架就成了更有用的鏡頭,同一套前向後向的做法在那裡用來估計密集單一受試者或多受試者序列的隱藏狀態。模型是同一個,框架跟著設計走。軟體提示方塊列出實務上估計這些模型的 R 工具,其中包括 depmixS4 與 LMest。
軟體提示 • R 與 Mplus 中的混合分配與轉移模型
R 在這一塊的生態系有能力,但不齊整。成長混合分配與潛在類別成長模型可以用 lcmm (Proust-Lima et al., 2017) 配適,有限混合分配(finite mixture)的示範可用 mclust;潛在類別與潛在剖面(latent profile)模型可用 poLCA 與 tidyLPA;潛在轉移與隱藏馬可夫模型可用 depmixS4 (Visser & Speekenbrink, 2010) 與 LMest (Bartolucci et al., 2017)。輔助變項方法 R3STEP 與 BCH 在 R 這一側只有部分涵蓋,目前仍以 Mplus 的實作最完整,而 Mplus 的流程可以透過 MplusAutomation 從 R 端以可重製的方式腳本化。本章的計算用從頭寫起的期望最大化演算法完成,一來建置環境裡沒有那些混合分配套件,二來從頭寫的程式碼讓估計過程完全透明;演算法、多重起始值的原則、類別數決定的各項指標,以及轉移用的前向後向遞迴,都與套件所實作的完全相同。隨書腳本為 ch22_analysis_V01.R(完整工具箱)、ch22_figures_V01.R,以及三個生成腳本 gen_classes_sim_V01.R、gen_resp_classes_V01.R 與 gen_engage_status_V01.R。中文版的圖另由 ch22_figures_zh_V01.R 產生。
常見陷阱 • 混合分配分析出錯的五種方式
第一,只憑一個指標(通常是 BIC)決定類別數,可是這個決定是多重準則的,BLRT、類別大小、可解讀性與複製都算數。第二,把眾數類別的指派當成沒有誤差的組別歸屬,帶進會被誤分類衰減的下游分析。第三,在沒有共變項的情況下決定類別數,之後才把類別連到那個共變項上,卻沒有檢查納入共變項之後解還穩不穩。第四,把一個只佔樣本百分之二或三的極小類別實體化成具有實質意義的類型。第五,把 LCGA 與 GMM 的類別數當成同一把尺上的數字來比較,而 LCGA「類別內變異數為零」的限制會系統性地拉高它所需要的類別數。
22.6 報告與複製的要求
混合分配結果很脆弱,透明報告因此承擔了不尋常的分量。這個領域的回應是 van de Schoot et al. (2017) 的 GRoLTS 檢核表,一組報告潛在軌跡研究的指引;本章認可這套指引,表 22.6 加以改寫。反覆出現的主題有三。第一,報告完整的解路徑,不只是選中的那個模型:隨機起始值幾個、最佳對數概似有沒有重複出現、所有考慮過的 \(K\) 的配適指標,以及最後這樣選的理由。第二,把類別畫得誠實。最常見的混合分配圖形是一個類別一條乾淨的平均曲線,它也最容易誤導人,因為它藏起了類別內的散布與分類的不確定性,讓類別看起來比實際上更俐落、更真實。圖 22.10 示範本書的標準:把成員軌跡疊在平均曲線上,依分類的確定程度為每個成員上色深淺,讓讀者看見類別之間模糊的重疊,也看見模型拿不準的那些成員,而不是一張整齊的分割圖。第三,管好用語。一份混合分配分析許可的陳述是「在所述假設之下,資料與若干個潛在類別相容」,不許可「發現了若干種人」這樣的主張。這兩句話之間的差別,就是本章從頭到尾在講的那個差別。
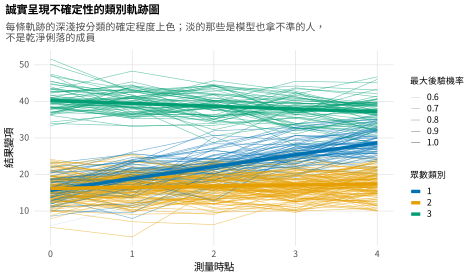
註:每一條成員軌跡都以它眾數類別的顏色畫出,並依最大後驗機率決定深淺,所以淡的線是模型分類信心低的成員,不是這個類別乾淨的成員。粗線是各類別的平均曲線。這張圖呈現的重疊與不確定性,正是只畫平均曲線的圖所掩蓋掉的,而它是本書要求的報告標準。
關於韌性類別的那一片文獻,是讓報告標準變得具體的警世案例。Infurna and Luthar (2016) 重新檢視了一項被廣泛引用的發現:絕大多數人對重大生活壓力源具有韌性。這項發現建立在軌跡類別分析之上,而他們說明,那個有韌性的類別對分析選擇很脆弱,模型配適一旦做得謹慎,它就比原先宣稱的小得多。這段插曲不是反對混合分配模型的論據,而是支持本章所發展的紀律的論據:「一項穩健的發現」與「一個假象」之間的差別,恰恰就是「謹慎的多重準則類別數決定加上誠實報告」與「單一指標抽取加上把類別實體化」之間的差別。表 22.6 就是把這份紀律操作化的檢核表。
表 22.6 針對混合分配模型、與 GRoLTS 對齊的報告檢核表。
| 項目 | |
|---|---|
| 1 | 明確說出模型類型(LCGA 或 GMM)以及類別內變異數的設定 |
| 2 | 每一個 \(K\) 的隨機起始值個數,以及最佳對數概似有沒有重複出現 |
| 3 | 以表格列出所有考慮過的 \(K\) 的配適指標(BIC、aBIC、CAIC)、BLRT 與熵 |
| 4 | 最小類別的人數,以及選定這個 \(K\) 的實質可解讀性論證 |
| 5 | Bauer 與 Curran 的探測:非常態成分的檢查、納入共變項的穩定性、與連續模型的比較 |
| 6 | 複製的證據:對半分割或獨立樣本的穩定性 |
| 7 | 指名所用的輔助變項方法(R3STEP、BCH),而不是先分類再迴歸 |
| 8 | 一張誠實呈現不確定性的類別軌跡圖,而不是只有平均曲線 |
| 9 | 把類別報告成「與資料相容」,而不是報告成「被發現的人的種類」的用語 |
註:改寫自 GRoLTS 檢核表 (van de Schoot et al., 2017)。這些項目把本章的雙重任務操作化:既要稱職地配適混合分配,也要以其脆弱性所要求的懷疑來報告它。
本章摘要
混合分配模型把「母體裡含有性質截然不同的變化次群體」這個想法形式化:潛在類別成長分析把類別內變異數固定為零,成長混合分配模型把它釋放。這項限制使 LCGA 抽出比 GMM 更多的類別,所以兩者的類別數不可比較。估計以期望最大化演算法從大量隨機起始值出發,而一個不會重複出現的最佳對數概似是警訊。選幾個類別是一個多重準則的決定,要看訊息準則、拔靴法概似比檢定、只用於分類品質的熵、類別大小、可解讀性與複製,絕不是單一指標。統攝全局的告誡是 Bauer 與 Curran 的結果:單一個非常態母體會產出虛假的類別,因為常態的混合分配可以近似一個偏態的形狀;所以配適良好的混合分配與潛在類別相容,卻不能確立潛在類別。把類別連到共變項與結果上需要三步驟法,預測變項用 R3STEP、遠端結果用 BCH,因為把人指派到眾數類別會丟掉分類的不確定性,並衰減每一項下游關係。潛在轉移分析建模的是隨時間在狀態之間的移動,是一條被測量到的馬可夫鏈,帶有恆等的類別式測量、一個轉移矩陣,以及一套把它接到後面幾章動態模型的隱藏馬可夫估計。報告必須遵守 GRoLTS 的紀律:完整的解路徑、誠實呈現不確定性而非乾淨平均曲線的軌跡圖,以及把類別報告成「與資料相容」而非「被發現的人的種類」的用語。能力與懷疑是同一項本事。
習題
- 22.1 類別數決定流程。在真正類別數為三的
classes_sim上跑完表 22.3 的整套流程,把訊息準則、拔靴法概似比檢定、熵與對半檢查都組起來,並把每一步記錄下來。 - 22.2 Bauer 與 Curran 實作。用常態的成長混合分配分析
classes_sim_skew,也就是單一個偏態母體的資料;說明訊息準則為什麼會偏好多於一個類別,並寫一份「誘惑與抵抗」的備忘錄,解釋這些類別為什麼是假象。 - 22.3 LCGA 對 GMM。對同一批資料同時配適一個 LCGA 與一個 GMM,並以類別內變異數的限制解釋兩者偏好的類別數為什麼有落差。
- 22.4 輔助變項工作流程。在
resp_classes上,先以先分類再迴歸、再以模型本位的三步驟邏輯,把基線嚴重度連到類別歸屬、把類別連到復發結果上,並量化天真做法帶進來的衰減。 - 22.5 潛在轉移。在
engage_status上配適一個三狀態的潛在轉移模型,還原轉移矩陣;接著在某一波植入一項測量恆等性的違反再配適一次,說明它如何扭曲看起來的轉移。 - 22.6 GRoLTS 稽核。給定一段已發表的成長混合分配論文節錄,依表 22.6 的檢核表加以稽核,並就它的疏漏寫出應有的審查意見。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 潛在類別成長分析 | latent class growth analysis (LCGA) | 把類別內成長變異數固定為零的軌跡混合分配模型;第 22.1 節 |
| 成長混合分配模型 | growth mixture model (GMM) | 讓每個類別自己是一個潛在成長模型的軌跡混合分配模型;第 22.1 節 |
| 類別內變異數 | within-class variance | 同一類別成員在成長因素上的散布;LCGA 固定為零;第 22.2 節 |
| 期望最大化 | expectation-maximization (EM) | 在後驗機率與參數更新之間交替的估計演算法;第 22.2 節 |
| 熵 | entropy | 分類乾淨程度的量數;報告用,不作選模準則;第 22.2 節 |
| 貝氏訊息準則 | Bayesian information criterion (BIC) | 對複雜度懲罰較重的訊息準則;越小越好;第 22.3 節 |
| 拔靴法概似比檢定 | bootstrap likelihood ratio test (BLRT) | 以模擬的虛無分配比較 \(K\) 類與 \(K-1\) 類模型;第 22.3 節 |
| 過度抽取 | overextraction | 抽出比生成歷程實際存在者更多的類別;第 22.3.1 節 |
| 眾數類別 | modal class | 後驗機率最高的那個類別;第 22.4 節 |
| 三步驟法 | three-step methods | 先固定測量模型,再把分類誤差算進輔助變項分析;第 22.4 節 |
| 遠端結果變項 | distal outcome | 在類別之後、由類別預測的結果變項;第 22.4 節 |
| 潛在轉移分析 | latent transition analysis (LTA) | 建模潛在狀態隨時間移動的模型;第 22.5 節 |
| 轉移矩陣 | transition matrix | 由這一波狀態到下一波狀態的條件機率;第 22.5 節 |
| 移動者與停留者 | mover-stayer | 一部分人從不改變狀態、其餘人會轉移的結構;第 22.5 節 |
參考文獻
Asparouhov, T., & Muthén, B. (2014). Auxiliary variables in mixture modeling: Three-step approaches using Mplus. Structural Equation Modeling: A Multidisciplinary Journal, 21(3), 329–341. https://doi.org/10.1080/10705511.2014.915181
Bakk, Z., & Vermunt, J. K. (2016). Robustness of stepwise latent class modeling with continuous distal outcomes. Structural Equation Modeling: A Multidisciplinary Journal, 23(1), 20–31. https://doi.org/10.1080/10705511.2014.955104
Bartolucci, F., Pandolfi, S., & Pennoni, F. (2017). LMest: An R package for latent Markov models for longitudinal categorical data. Journal of Statistical Software, 81(4), 1–38. https://doi.org/10.18637/jss.v081.i04
Bauer, D. J. (2007). Observations on the use of growth mixture models in psychological research. Multivariate Behavioral Research, 42(4), 757–786. https://doi.org/10.1080/00273170701710338
Bauer, D. J., & Curran, P. J. (2003). Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes. Psychological Methods, 8(3), 338–363. https://doi.org/10.1037/1082-989X.8.3.338
Bauer, D. J., & Curran, P. J. (2004). The integration of continuous and discrete latent variable models: Potential problems and promising opportunities. Psychological Methods, 9(1), 3–29. https://doi.org/10.1037/1082-989X.9.1.3
Bolck, A., Croon, M., & Hagenaars, J. (2004). Estimating latent structure models with categorical variables: One-step versus three-step estimators. Political Analysis, 12(1), 3–27. https://doi.org/10.1093/pan/mph001
Collins, L. M., & Lanza, S. T. (2010). Latent class and latent transition analysis: With applications in the social, behavioral, and health sciences. Wiley. https://doi.org/10.1002/9780470567333
Grimm, K. J., Ram, N., & Estabrook, R. (2017). Growth modeling: Structural equation and multilevel modeling approaches. Guilford Press.
Infurna, F. J., & Luthar, S. S. (2016). Resilience to major life stressors is not as common as thought. Perspectives on Psychological Science, 11(2), 175–194. https://doi.org/10.1177/1745691615621271
Jung, T., & Wickrama, K. A. S. (2008). An introduction to latent class growth analysis and growth mixture modeling. Social and Personality Psychology Compass, 2(1), 302–317. https://doi.org/10.1111/j.1751-9004.2007.00054.x
Lanza, S. T., Tan, X., & Bray, B. C. (2013). Latent class analysis with distal outcomes: A flexible model-based approach. Structural Equation Modeling: A Multidisciplinary Journal, 20(1), 1–26. https://doi.org/10.1080/10705511.2013.742377
Masyn, K. E. (2013). Latent class analysis and finite mixture modeling. In T. D. Little (Ed.), The Oxford handbook of quantitative methods (Vol. 2, pp. 551–611). Oxford University Press. https://doi.org/10.1093/oxfordhb/9780199934898.013.0025
Moffitt, T. E. (1993). Adolescence-limited and life-course-persistent antisocial behavior: A developmental taxonomy. Psychological Review, 100(4), 674–701. https://doi.org/10.1037/0033-295X.100.4.674
Muthén, B., & Shedden, K. (1999). Finite mixture modeling with mixture outcomes using the EM algorithm. Biometrics, 55(2), 463–469. https://doi.org/10.1111/j.0006-341X.1999.00463.x
Nagin, D. S. (1999). Analyzing developmental trajectories: A semiparametric, group-based approach. Psychological Methods, 4(2), 139–157. https://doi.org/10.1037/1082-989X.4.2.139
Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
Nylund-Gibson, K., & Choi, A. Y. (2018). Ten frequently asked questions about latent class analysis. Translational Issues in Psychological Science, 4(4), 440–461. https://doi.org/10.1037/tps0000176
Nylund-Gibson, K., Grimm, R. P., & Masyn, K. E. (2019). Prediction from latent classes: A demonstration of different approaches to include distal outcomes in mixture models. Structural Equation Modeling: A Multidisciplinary Journal, 26(6), 967–985. https://doi.org/10.1080/10705511.2019.1590146
Proust-Lima, C., Philipps, V., & Liquet, B. (2017). Estimation of extended mixed models using latent classes and latent processes: The R package lcmm. Journal of Statistical Software, 78(2), 1–56. https://doi.org/10.18637/jss.v078.i02
Ram, N., & Grimm, K. J. (2009). Growth mixture modeling: A method for identifying differences in longitudinal change among unobserved groups. International Journal of Behavioral Development, 33(6), 565–576. https://doi.org/10.1177/0165025409343765
van de Schoot, R., Sijbrandij, M., Winter, S. D., Depaoli, S., & Vermunt, J. K. (2017). The GRoLTS-checklist: Guidelines for reporting on latent trajectory studies. Structural Equation Modeling: A Multidisciplinary Journal, 24(3), 451–467. https://doi.org/10.1080/10705511.2016.1247646
Vermunt, J. K. (2010). Latent class modeling with covariates: Two improved three-step approaches. Political Analysis, 18(4), 450–469. https://doi.org/10.1093/pan/mpq025
Visser, I., & Speekenbrink, M. (2010). depmixS4: An R package for hidden Markov models. Journal of Statistical Software, 36(7), 1–21. https://doi.org/10.18637/jss.v036.i07
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。