第 7 章
變異數分解與重複測量的描述統計
配適任何變化模型之前,先用配得上資料結構的描述工具,把一份重複測量的資料徹底盤問一遍。其中後果最重大的問題是變異數落在哪裡:變異數幾乎全在個體之間的構念,能問的問題與撐得起的分析,都和一個在同一個人身上一刻一刻擺盪的構念不同。第 1 章在概念上區分了個體間與個體內,本章給出它的量化對應物:測量各層次各佔多少變異數的組內相關、把預測變項分解成個體間與個體內兩部分的做法,以及摘要每個人動態的那一族個體層次指標,涵蓋變異性、不穩定與慣性。本章同時是一堂關於保持懷疑的課,因為每一個指標都帶著自己的失效模式,而負責任的分析者介紹一個測量,就同時把它的限制交代清楚。
學習目標
讀完本章之後,你應該能夠:(1) 由無條件多層次模型估計並解讀組內相關(intraclass correlation, ICC),包括個體層次與日層次,並說出高值與低值各自對設計與分析有什麼意涵;(2) 把一個隨時間變動的預測變項分解成個體間與個體內兩個成分,並說明各自代表什麼;(3) 計算標準的個體內變異性與動態指標,包括個體內平均數(iMean)、個體內標準差(iSD)、相對標準差(relative standard deviation)、連續差異均方根(RMSSD)、急遽變化機率(PAC) 與延宕一期慣性(lag-1 inertia),並說出每一個各針對歷程的哪一個特徵;(4) 認出有界量尺上的平均數與變異數混淆(mean-variance confound)並加以校正;(5) 評估個體層次指標的信度如何隨時點數而變;(6) 認出這些指標在實徵上的冗餘(redundancy),並抗拒過度解讀;(7) 產出一份可供發表的縱貫資料描述表。
7.1 變異數落在哪裡:組內相關
重複測量資料最基礎的描述量是組內相關(intraclass correlation, ICC),它回答的問題是:某個變項的總變異數,有多少比例落在個體之間,而不是落在個體之內。估計它要靠一個無條件模型(unconditional model),或稱虛無模型(null model),也就是只含截距的兩層模型 \(y_{it} = \gamma_{00} + u_{0i} + e_{it}\),其中 \(u_{0i} \sim N(0, \tau_{00})\) 是這個人相對於總平均數的穩定偏離,\(e_{it} \sim N(0, \sigma^2)\) 是當下的起伏。虛無模型是一台變異數分解機器:它把總變異數切成個體間的 \(\tau_{00}\) 與個體內的 \(\sigma^2\) 兩份,ICC 就是兩者的比值 \(\mathrm{ICC} = \tau_{00} / (\tau_{00} + \sigma^2)\)。這個量有兩種等價的讀法,兩種都值得記住。它是變異數落在個體之間的比例,也是同一個人身上任取兩筆觀察的期望相關;後一種讀法說明了它為什麼可以當成非獨立性的指標,而非獨立性正是後續模型必須設法容納的東西。圖 7.1 提供一次視覺校準:ICC 為 \(0.1\) 時,各個體的軌跡徹底交纏,因為變異數幾乎都是當下的;到 \(0.5\) 時軌跡開始分離;到 \(0.9\) 時每個人各佔一條穩定、幾乎不重疊的帶狀區域,此時主導的是個體間的差異。
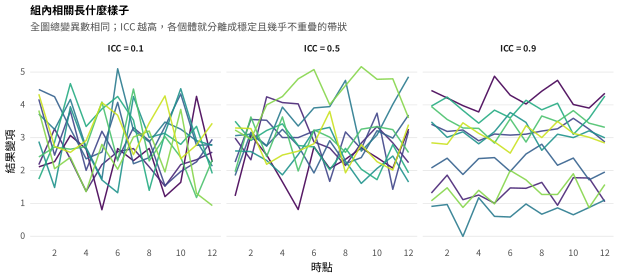
註:十位模擬的個體,各測十二個時點,各子圖的總變異數相同。ICC 由 \(0.1\) 升到 \(0.9\),穩定的個體間變異數所佔的比例隨之增加,軌跡也就從一團糾結的帶狀,分離成各自持續而彼此有別的水準。ICC 既是個體間變異數的比例,也是同一個人兩筆觀察之間的期望相關。
以本書的經驗取樣資料而言,虛無模型把當下負向情緒的 ICC 定在 \(0.36\)、正向情緒 \(0.44\)、當下壓力 \(0.47\),都落在密集測量的情緒與行為構念常見的 \(0.3\) 到 \(0.6\) 之間 (Bolger & Laurenceau, 2013)。讀法直接,後果卻很大:這三個變項都有略多於一半的變異數是當下的,而那正是經驗取樣設計要捕捉的個體內變異。拿一個幾近特質式的變項來對照更清楚:這批資料裡「當下是否獨處」這個情境指標的 ICC 與零無異,某個人在某次提示(beep)時是不是獨處,幾乎完全是個體內的、隨情境而定的事,穩定的個體間成分很小;這個變項的變異數,就落在個體間問卷永遠觸及不到的地方。ICC 接近一的構念則呈現相反的問題:個體內的問題沒有變異數可用,再怎麼密集取樣,也造不出這個構念本來就不展現的起伏。
密集設計還邀請進一步的分解,因為時點本身也是巢套的:一次次的提示巢套在日之內,日巢套在個體之內。三層虛無模型(three-level null model)於是把變異數切成個體、日與當下三份。負向情緒的三份是個體之間 \(0.35\)、個體之內的日之間 \(0.14\)、日之內 \(0.51\),屬於日層次的大約是總變異數的七分之一。這個份額不小,它描述的是這個構念有多「以日為結構」:一刻一刻的雜訊之上,還有沒有好日子與壞日子之分。壓力的日層次份額則小得多(\(0.06\)),它的起伏比較純粹是當下的,並不以日為單位組織起來。最後一項警告也最重要:ICC 不是構念的固定性質,而是隨時間尺度(timescale)與取樣方案而變。同一個構念改以每小時、每天、每年取樣,會得到不同的分解,因為個體內與個體間的界線會隨那個時間窗移動。一個 ICC 講的是「某個變項在某個設計中」,不是抽離設計之後的那個變項本身。
7.2 分解預測變項:中心化是一種描述行為
描述結果變項的那同一套分解也適用於預測變項,而做這件事就是後續每一個個體內模型的描述性基礎。任何隨時間變動的變項都可以寫成「個體特定的平均數」加上「當下的偏離」,\(x_{it} = \bar{x}_{i\cdot} + (x_{it} - \bar{x}_{i\cdot})\)。個人平均數 \(\bar{x}_{i\cdot}\) 是個體間的量,是這個人特質(trait)水準的替代指標;偏離 \(x_{it} - \bar{x}_{i\cdot}\) 是個體內的量,是相對於這個人自己基準線的當下偏離。這不只是計算上的方便,而是實質的分離:兩個成分與同一個結果變項的關係可以不同,甚至可以相反。第 1 章在概念上引入的就是這個現象,第 13 與 23 章的多層次模型再把它形式化。圖 7.2 用經驗取樣資料中壓力與負向情緒的關聯,把這個分離具體演示出來。個體間的子圖畫的是個人平均壓力對個人平均負向情緒,一個人一點:平均而言壓力較大的人,平均而言也較負向,個體間相關為 \(0.55\)。個體內的子圖畫的是每個人當下的壓力偏離對自己當下的負向情緒偏離,合併後的斜率也就是個體內相關 \(0.33\),回答的是另一個問題:某個人比自己平常更有壓力時,是不是也比平常更負向?這裡兩個關聯都是正的,但它們不是同一個數字,也不必然同號。把兩者混為一談,就是生態謬誤(ecological fallacy),而個體內方法存在的目的正是防止它。
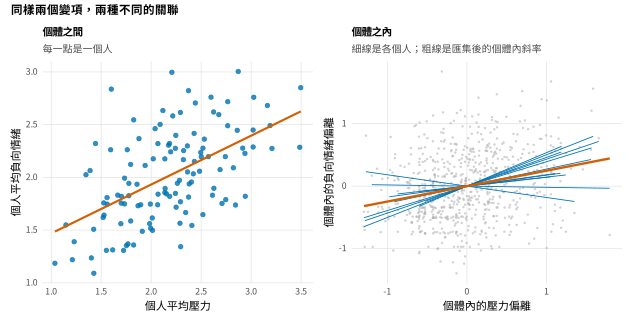
註:左:個人平均壓力對個人平均負向情緒,一個人一點,畫的是個體間的關聯(\(r = 0.55\))。右:個體內的壓力偏離對個體內的負向情緒偏離;細線是各個人,粗線是合併後的個體內斜率(\(r = 0.33\))。兩個關聯回答不同的問題,也由不同的變異數估計而來。
這個「觀察值版」的分解要附上一項警告,時點數少的時候尤其要緊。個人平均數 \(\bar{x}_{i\cdot}\) 不是這個人真正的特質水準,只是它的一個估計,帶著變異數為 \(\sigma^2/T_i\) 的抽樣誤差。時點數少時,觀察到的個人平均數會比真正的特質平均數更分散,觀察到的個體間變異數也跟著被膨脹。後果是:由原始個人平均數建立起來的分解,等於把每個人的估計平均數當成精確已知的量,而它並不是。以模型為基礎的補救之道是用收縮(shrinkage)估計取代原始的個人平均數,依各自的不確定性把不可靠的個別平均數往總平均數拉(第 13 章詳述);動態結構方程模型(dynamic structural equation model, DSEM)(第 25 章)的完全潛在分解更徹底,在估計時就把真分數(true score)變異數與誤差變異數分開,這份污染因此完全移除。就描述層次而言,要點成立:中心化是一種分解,這個分解有訊息量,而它的原始形式帶著一個已知的偏誤,後續各章會加以校正。
基礎概念 • 個體內與個體間的分解,以及 \(T\) 小為什麼會咬人
把個人平均數寫成 \(\bar{x}_{i\cdot} = \frac{1}{T_i}\sum_t x_{it}\),並把 \(x_{it}\) 分解為 \(x_{it} = \bar{x}_{i\cdot} + \tilde{x}_{it}\),其中 \(\tilde{x}_{it} = x_{it} - \bar{x}_{i\cdot}\)。依建構,每個人之內都有 \(\sum_t \tilde{x}_{it} = 0\),個體內成分與個體間成分因此正交,總變異數也就可加地分解為 \(\mathrm{Var}(x_{it}) \approx \mathrm{Var}(\bar{x}_{i\cdot}) + \mathrm{Var}(\tilde{x}_{it})\)。若每個人有一個真正的特質水準 \(\mu_i\),且 \(x_{it} = \mu_i + \varepsilon_{it}\)、\(\mathrm{Var}(\varepsilon_{it}) = \sigma^2\),則 \(E[\bar{x}_{i\cdot}] = \mu_i\),但 \(\mathrm{Var}(\bar{x}_{i\cdot} \mid \mu_i) = \sigma^2 / T_i\)。觀察到的個人平均數,分散程度因此比真正的特質變異數多出 \(\sigma^2 / T_i\),而這一項只在 \(T_i\) 增大時才消失。短序列算出來的個人平均數之所以是雜訊很大的特質估計,觀察到的個體間變異數之所以在 \(T\) 小時向上偏誤,收縮(第 13 章)與潛在分解(第 25 章)之所以優於原始計算,原因都在這裡。
7.3 個體內動態指標一覽
從個體之內來看資料,每個人的序列都可以用一組指標摘要,每個指標各針對歷程的不同特徵。這些指標有雙重角色:此刻是描述性的摘要,在後續各章則自己成為結果變項或預測變項。指導的教學原則是「先算指標,後配模型」,因為每一個描述性指標都有一個以模型為基礎的對應物,用適當的不確定性估計同一個量:個體內變異性對應第 16 章的混合效果位置尺度模型(mixed-effects location-scale model),慣性對應第 25 章的多層次自我迴歸模型(multilevel autoregressive model)。圖 7.3 是本章的招牌教學圖,也是這整件事最好的理由:四個人平均數完全相同,動態卻明顯有別。穩定的人變異很小;波動大的人擺盪得又寬又快;緩慢漂移的人也變異得很寬,但變得慢,因此漂移者的個體內標準差(\(0.78\))雖然大於波動者(\(0.67\)),連續差異卻小得多,因為改變是漸進而不是突然的;陣發的人多半平靜,只是不時被幾次急遽的跳動打斷。單獨一個平均數對這一切完全盲目;即使只用單獨一個變異性指標,也會把波動者與漂移者搞混。要捕捉這個差別得靠好幾個指標,以下逐一定義,每一個都連同它所針對的特徵與它要求的警告,並收在表 7.1。
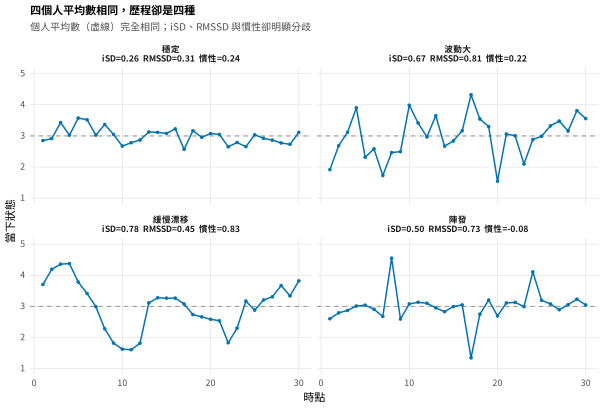
註:每一個子圖是一位模擬的個體,各測三十個時點;虛線標出共同的個人平均數,在四個子圖中位置完全相同。iSD、RMSSD 與延宕一期慣性卻明顯分歧。漂移者的 iSD 大於波動者,RMSSD 反而小得多,因為緩慢的改變只造成很小的連續差異。
位置由個體內平均數(intraindividual mean, iMean)摘要,也就是這個人的平均水準;就許多目的而言它是最具預測力的單一指標,每一個變異性測量都得拿它來對照檢查。變異性由個體內標準差(intraindividual standard deviation, iSD)摘要,也就是一個人自己那些觀察的標準差,它量化狀態擺盪的範圍有多寬;但在有界量尺(bounded scale)上,它會機械性地與平均數纏在一起,下一節會處理這一點,並由相對標準差(relative standard deviation)加以校正 (Mestdagh et al., 2018)。不穩定指的是從一刻到下一刻突然改變的傾向,由連續差異均方根(root mean square of successive differences, RMSSD)摘要,\(\sqrt{\frac{1}{T-1}\sum_{t=2}^{T}(x_t - x_{t-1})^2}\);它與 iSD 不同,對觀察的時間順序敏感,因此分得出快速振盪與緩慢漂移 (Jahng et al., 2008)。與它相關的另一個不穩定指標是急遽變化機率(probability of acute change, PAC),也就是連續轉換中超過某個選定門檻的比例,單獨抓出大幅跳動的頻率。慣性指的是狀態持續下去的傾向,由個體層次的延宕一期自我相關(lag-1 autocorrelation)摘要,也就是每一筆觀察與前一筆的相關;文獻把它連結到情緒調節(emotion regulation),偏高時則連結到適應不良(maladjustment) (Kuppens et al., 2010)。它是第 24 章自我迴歸參數(autoregressive parameter)的描述性前身,也帶著一項嚴重的小樣本警告,下文會詳細說明。跨構念的動態由兩個狀態之間的個體內相關(within-person correlations)摘要;一組情緒題目則由情緒區辨(emotion differentiation)摘要,操作化為同效價(valence)題目之間平均的個體內相關:平均相關低,表示這個人把自己的負向狀態分得很細;平均相關高,表示對這個人來說所有負向感受都一起變動 (Erbas et al., 2014)。在題目層次的經驗取樣資料中,四個負向情緒題目之間平均的個體內相關是 \(0.27\),區辨程度平均而言中等。
表 7.1 個體內動態指標一覽。
| 指標 | 所針對的特徵 | 計算方式 | 主要警告 |
|---|---|---|---|
| iMean | 平均水準 | 這個人所有觀察的平均數 | 常是最強的預測變項;把功勞歸給其他指標之前先控制它 |
| iSD | 整體變異性 | 這個人所有觀察的標準差 | 在有界量尺上與平均數混淆 |
| 相對 SD | 已對平均數校正的變異性 | iSD 除以該平均數與該上下界所允許的最大值 | 在量尺極限上未定義,接近極限時不穩定 |
| RMSSD | 不穩定/突然性 | 連續差異平方的平均數再開根號 | 對順序敏感;會被趨勢與週期膨脹 |
| PAC | 大幅跳動的頻率 | \(|\)連續差異\(|\) 超過某切點的比例 | 切點是任意選定的,必須報告出來 |
| 慣性 | 持續性/ 延續效果 | 個體層次的延宕一期自我相關 | 在 \(T\) 小時嚴重向下偏誤 |
| 個體內 \(r\) | 兩個狀態的耦合 | 當下偏離之間的相關 | 需要每個人有足夠的時點 |
| 區辨 | 狀態的細緻程度 | 同效價題目之間平均的個體內相關 | 與變異性及平均數混淆 |
註:每一個指標都有一個以模型為基礎的對應物,能以收縮與適當的不確定性估計同一個特徵:變異性對應第 16 章的混合效果位置尺度模型,慣性對應第 25 章的多層次自我迴歸模型。要描述就算指標,要推論就配模型。
還有一種互補的框架來自 Fleeson (2001)。它拒絕把個體內的序列化約成任何單一指標,而是把整個個體內分配當成關注的對象,也就是密度分配(density-distribution)觀點:特質就是一個人隨時間所造訪過的那些狀態的密度。圖 7.4 為十二個人實現了這個觀點,並依當下負向情緒的平均水準排序,用肉眼就還原了那些指標所量化的東西:平均負向情緒低的人,分配右偏並擠在量尺的地板上;水準較高的人分配較寬、較對稱。平均數、離散程度與形狀是連動的,這是單獨一個數字傳達不了的。密度觀點也是「指標氾濫」的一劑解毒劑,提醒讀者這些指標只是一個更豐富對象的有損摘要。
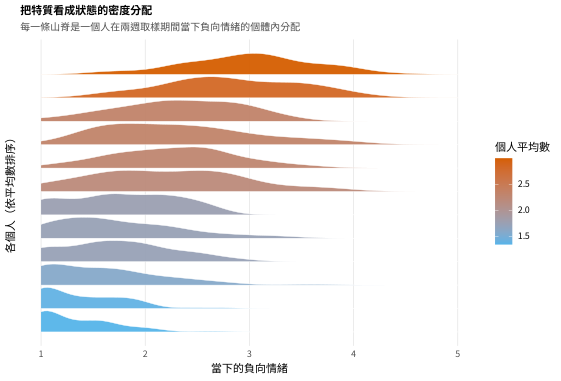
註:每一條山脊是一個人在兩週取樣期間,當下負向情緒的個體內分配;各個人依平均水準排序,並以顏色(藍至橘紅)標示平均水準。平均數低的人分配右偏,壓在量尺的地板上;平均數較高的人則較寬、較對稱。在 Fleeson 的框架裡,描述的對象是整個分配,不只是它的平均數或標準差。
7.4 這些指標可信嗎?
上面那份一覽表如果沒有配上相對的節制就會很危險。個體層次的指標由有限長度的序列估計而來,因此承接了小樣本的一切脆弱之處,其中有三個問題特別容易把一個指標變成假象(artifact)。第一個是平均數與變異數的混淆(mean-variance confound)。在有界量尺上,一個人能展現多少變異數,受限於平均數離量尺的地板或天花板有多近:平均數靠近最低值的人幾乎沒有空間可以變動,落在量尺中點附近的人則可以擺盪得很寬。即使底層歷程完全相同,iSD 仍然機械性地與 iMean 綁在一起。圖 7.5 在經驗取樣資料上演示這個問題與它的校正。左子圖畫的是每個人的 iSD 對 iMean,拋物線的包絡線標出在一到五的量尺上,每一個平均數之下可達到的最大標準差;觀察到的點緊貼在地板那一帶,與平均數的相關是 \(0.61\)。一項天真地把變異性連上某個結果變項的分析,因此有一部分等於是在把平均數連上那個結果變項。Mestdagh et al. (2018) 的相對標準差移除了這個假象,做法是把每個人的 iSD 表達成「在自己的平均數之下本來可以取到的最大值」的一個比例。右子圖顯示,經過這道校正之後,與平均數的關聯已不再是正的。實務上的規則直接跟著出來:在有界量尺上,沒有控制平均數、也沒有換成已對平均數校正的指標之前,絕不要解讀原始的 iSD,否則一項關於變異性的發現,可能只是一項關於水準的發現換了裝。
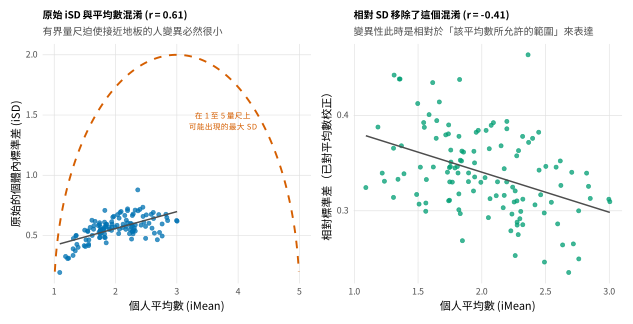
註:左:原始的個體內標準差對個人平均數;虛線拋物線是在一到五的有界量尺上,每一個平均數之下可達到的最大標準差,觀察到的相關為 \(0.61\)。右:相對標準差把觀察到的標準差除以那個最大值,於是不再與平均數正向混淆(\(r = -0.41\))。任何由原始 iSD 得到的變異性結論,都必須拿這個混淆檢查一遍。
第二個問題是信度(reliability),也就是一個指標需要多少時點,才會估計到一個穩定的個體特徵,而不是雜訊。指標既然算自一個人的序列,它的信度就隨那個序列的長度增長,而不同指標增長的速度差別很大。圖 7.6 報告一項複本信度(parallel-forms reliability)模擬:把一個人的資料切成兩段獨立、等長的平行序列,各算一次指標,再跨個體求相關,看它如何隨時點數(number of occasions)變化。變異性指標的表現相對良好:iSD 與 RMSSD 在大約三十個時點時信度就接近 \(0.80\),到一百個時點時超過 \(0.94\)。慣性的要求高得多:延宕一期自我相關在十個時點時信度只有 \(0.11\)、三十個時點時 \(0.36\),要到序列很長時才接近可接受的水準,因為估計一個跨時間的相關需要很多次轉換(transitions)。這一課是:在每日日誌研究常見的短序列裡,慣性應該當成一個不可靠的個體層次指標;而第 25 章那種以模型為基礎、帶收縮的估計能在個體之間互相借力,並不是一項精緻化,而是一項必要。
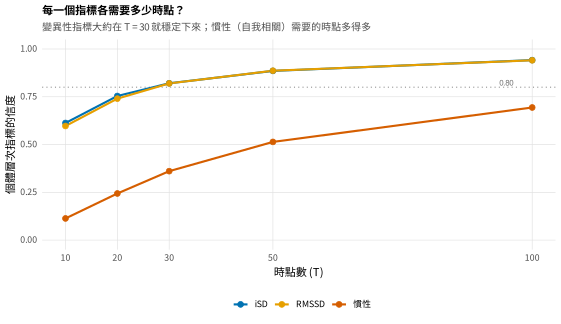
註:三個指標的複本信度對時點數 \(T\),來自一項在平均數、變異性與慣性上都有個體間變異的模擬。變異性指標(iSD、RMSSD)在 \(T = 30\) 附近跨過慣用的 \(0.80\) 門檻;慣性,也就是延宕一期自我相關,在那之後很久仍然不可靠,需要長得多的序列,或以模型為基礎的估計。
慣性的困難除了信度低之外還有第二張臉,也就是一項系統性的小樣本偏誤(small-sample bias):樣本自我相關在短序列中向下偏誤,連它的平均數都低報了真正的持續性。在一項真實延宕一期自我相關為 \(0.40\) 的模擬中,樣本估計在十個時點時平均只有 \(0.17\)、三十個時點時 \(0.33\),即使到一百個時點,仍有大約 \(0.02\) 的偏誤。這個偏誤的階數是 \(1/T\),是自我迴歸模型(autoregressive model)的一個古典結果,最低階的校正項約為 \(-(1 + 3\varphi)/T\)。它在實務上的含意很嚴重:跨個體或跨組別比較慣性時,若各自的序列長度不同,比較就會被差別性的偏誤所混淆,而記錄較短的那一組看起來會比實際上更不具慣性。上面那些樣本估計取的是皮爾森形式的延宕一期自我相關,也就是把 \((x_{t-1}, x_t)\) 當成 \(T - 1\) 對資料算的積差相關(第 7.6 節的 compute_dynamics_indices());acf() 所用的自我相關函數形式讓兩個邊際共用同一個總平均數,在 \(T\) 小時與前者並不相等,\(T = 10\) 時低了 \(0.024\),與許多實質效果同一個量級。換一個同名的估計式就換一組數字,報告慣性時因此必須指名估的是哪一個,否則讀者改用 acf() 會得到不同的數字。下方的基礎概念方塊把兩種偏誤一起陳述。
第三個問題是系統性趨勢的污染(contamination by systematic trends)。變異性與不穩定這兩類指標都假定個體內的起伏就是訊號,但其中一部分可能是可預測的趨勢或週期。圖 7.7 用一個日內節律(diurnal rhythm)把這一點演示出來:一個隨一天中的時刻起落的序列,RMSSD 是 \(0.65\);一旦把日週期模型化並移除,殘差的 RMSSD 就掉到 \(0.28\)。表面上的不穩定,有一半以上來自一個被當成雜訊來計算的可預測節律。要不要移除這種結構是一項決定,不是預設的做法,而表 7.2 提供一份去趨勢(detrending)的決策指南。最關鍵的問題是:這個趨勢或週期是研究者想描述的那個歷程的一部分,還是描述殘餘動態之前應該先排除的干擾?
基礎概念 • 延宕一期自我相關的兩種偏誤
樣本延宕一期自我相關 \(r_1 = \sum_{t=2}^{T}(x_t - \bar{x})(x_{t-1} - \bar{x}) / \sum_{t=1}^{T}(x_t - \bar{x})^2\) 有兩個彼此不同的「\(T\) 小」問題。第一,它是負向偏誤的:對參數為 \(\varphi\) 的 AR(1) 歷程,期望值約為 \(E[r_1] \approx \varphi - (1 + 3\varphi)/T\),短序列因此系統性地低報持續性,而且長度不同的序列偏誤幅度也不同。第二,它不可靠:抽樣變異數在 \(T\) 小時很大,同一個人的兩段資料會得到相關很弱的估計(圖 7.6)。兩個問題還會相互加成。由日誌長度的序列算出來的個體層次慣性要謹慎對待,理由在此;第 25 章的多層次自我迴歸模型既能在個體之間合併訊息,又把測量誤差與動態分開,才是恰當的估計工具,理由也在此。
表 7.2 變異性與不穩定指標的去趨勢決策指南。
| 若研究問題關心的是…… | 那麼就這樣處理系統性結構…… |
|---|---|
| 含週期在內的整體個體內變異性 | 直接在原始序列上計算指標,並報告趨勢已被保留 |
| 扣掉可預測節律之後的動態 | 先移除線性趨勢(linear trend)與日內週期,再在殘差上計算指標 |
| 日內週期本身 | 明確把週期模型化(第 23、30 章);此時週期就是訊號 |
| 比較趨勢不同的個體 | 逐人去趨勢,或把趨勢與動態聯合模型化,以避免混淆 |
註:去趨勢是一項實質選擇,不是技術上的預設做法。移除一個週期所回答的問題,與保留它所回答的問題並不相同,兩者可能對「誰最不穩定」給出相反的結論。請把這個選擇與它的理由寫出來。
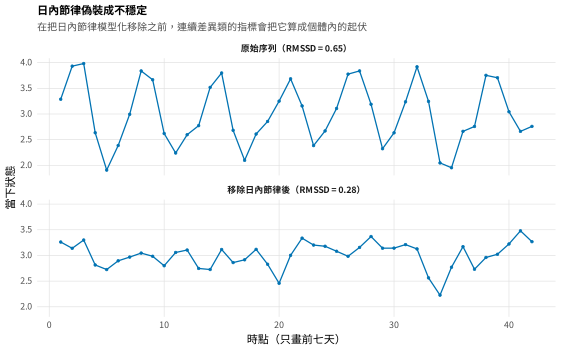
註:上:一段帶有日內週期的模擬當下序列,RMSSD 為 \(0.65\)。下:把日週期模型化並移除之後,殘差的 RMSSD 掉到 \(0.28\)。表面上一刻一刻的不穩定,有一半以上是一個可預測的節律。要不要移除它取決於研究問題(表 7.2)。
最後,即使個別而言可信的指標,合起來也可能冗餘(redundant):它們測到的東西太過接近,把好幾個一起放進模型,除了多元共線性(multicollinearity)之外一無所獲,而且在預測結果變項時,相對於平均數所增加的也很少 (Dejonckheere et al., 2019)。圖 7.8 呈現經驗取樣資料中各個體層次指標之間的實徵相關,型態令人清醒:RMSSD 與 PAC 相關 \(0.88\),是同一個不穩定的兩種看法;iMean 滲進 iSD 達 \(0.61\),就是上面記錄的那個混淆;只有相對 SD 與慣性,明顯和變異性那一群拉開距離。這並不是說這些指標沒有用,而是說必須刻意挑選:一個特徵挑一個代表,而不是累積。任何增量的主張,也就是「某個動態指標在平均數之上還能預測某個結果」,都必須拿平均數與其他指標檢定過,不能逕行斷言。
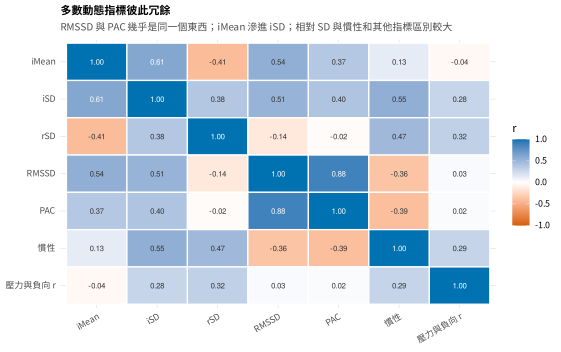
註:經驗取樣資料中各個體層次指標之間的實徵相關。RMSSD 與 PAC(\(0.88\))幾乎是重複的;平均數滲進 iSD(\(0.61\))。只有相對 SD 與慣性,和變異性那一群有實質的區別。把好幾個冗餘的指標一起放進模型,產生的是多元共線性,不是洞見。
常見陷阱 • 指標誤導人的三種方式
7.5 重複測量的描述表
本章這一整套描述工具,在縱貫版的「表 1」上達到頂點,也就是那張區分層次(level-aware)的描述表。每一項密集或追蹤研究都應該報告它,讀者也需要它才能判斷後續的分析。它與橫斷版的「表 1」差別在於報告層次專屬的訊息:不是每個變項一個平均數與一個標準差,而是變異數跨層次的分解;也不是一個相關矩陣,而是兩個,因為個體間與個體內的關聯並不相同。表 7.3 是一份經驗取樣資料的示範描述表。每一個變項都帶著總平均數、總標準差,以及個體層次與日層次的組內相關;相關矩陣則在對角線上方報告個體間相關,下方報告個體內相關。兩個三角形講的是不同的故事,正如第 7.2 節的分解所預測:負向情緒與正向情緒在個體之間相關 \(-0.50\),在個體之內只有 \(-0.32\);壓力與正向情緒在個體之間相關 \(-0.52\),在個體之內卻只有微不足道的 \(-0.11\)。壓力與正向心情在特質層次上的對立,遠強於它們一刻一刻的耦合,而單獨一個不加區分的相關會把這件事整個遮掉。軟體提示記錄了幾個能把這張表的一部分自動化的套件,並附上一項警告:它們的組內相關定義並不總是一致。
表 7.3 經驗取樣資料的示範描述表。
| 變項 | \(M\) | \(SD\) | \(\mathrm{ICC}_{p}\) | \(\mathrm{ICC}_{d}\) | 1 | 2 | 3 |
|---|---|---|---|---|---|---|---|
| 1. 負向情緒 | 2.01 | 0.71 | .35 | .14 | – | \(-.50\) | \(.55\) |
| 2. 正向情緒 | 3.22 | 0.82 | .43 | .10 | \(-.32\) | – | \(-.52\) |
| 3. 壓力 | 2.16 | 0.74 | .47 | .06 | \(.33\) | \(-.11\) | – |
註:\(M\) 與 \(SD\) 在所有「人乘時點」上計算。\(\mathrm{ICC}_{p}\) 與 \(\mathrm{ICC}_{d}\) 是三層虛無模型所得的個體層次與日層次組內相關。對角線上方是個體間相關,以個人平均數計算;下方是個體內相關,以個人平均數中心化後的偏離計算。\(N = 120\) 人,每人最多 \(84\) 個時點。對角線上的短橫線表示不適用。
7.6 在 R 中執行描述統計
這個實作範例把本章的每一個量都在經驗取樣資料上算一遍。組內相關來自虛無多層次模型:讀出變異數成分(variance component)再組合起來,兩層的版本給出個體 ICC,三層的版本再加上日層次的份額。
library(lme4); library(dplyr); library(tidyr)
ae <- readRDS("Examples/data/affect_ema.rds")

# 由兩層虛無模型得到 ICC
m2  <- lmer(na ~ 1 + (1 | person), data = ae)
vc  <- as.data.frame(VarCorr(m2))
tau <- vc$vcov[vc$grp == "person"]; sig <- vc$vcov[vc$grp == "Residual"]
icc_person <- tau / (tau + sig)                 # 負向情緒為 0.36

# 三層的變異數份額:提示在日之內、日在個體之內
m3  <- lmer(na ~ 1 + (1 | person/day), data = ae)   # person 與 day:person
vc3 <- as.data.frame(VarCorr(m3))
shares <- vc3$vcov / sum(vc3$vcov)              # 個體、日、當下三份
個體層次的指標由一個附完整說明的函式計算,逐人套用在排好序的序列上。隨書附的腳本定義了 compute_dynamics_indices(),逐人套用之後,再算冗餘矩陣、信度模擬,以及上文報告的小樣本自我相關偏誤。
# compute_dynamics_indices(): iMean、iSD、相對 SD、RMSSD、PAC、慣性
compute_dynamics_indices <- function(x, lo = 1, hi = 5, pac_cut = 1) {
  xo <- x[!is.na(x)]; if (length(xo) < 3) return(rep(NA, 6))
  m <- mean(xo); s <- sd(xo)
  maxsd <- sqrt((hi - m) * (m - lo))            # 此平均數在 [lo,hi] 上的最大 SD
  rSD <- if (maxsd > 0) s / maxsd else NA       # Mestdagh et al. (2018)
  d <- diff(x); d <- d[!is.na(d)]
  RMSSD <- sqrt(mean(d^2)); PAC <- mean(abs(d) > pac_cut)
  x1 <- x[-length(x)]; x2 <- x[-1]; ok <- !is.na(x1) & !is.na(x2)
  inertia <- if (sum(ok) >= 3) cor(x1[ok], x2[ok]) else NA
  c(iMean = m, iSD = s, rSD = rSD, RMSSD = RMSSD, PAC = PAC, inertia = inertia)
}

person_idx <- ae
  summarise(as.data.frame(t(compute_dynamics_indices(na))), .groups = "drop")

cor(person_idx[, -1], use = "pairwise.complete.obs")   # 冗餘矩陣
描述性的「表 1」把層次專屬的統計量與兩個相關矩陣組裝起來。個體間相關由個人平均數計算,個體內相關由個人平均數中心化後的偏離計算,等於把第 7.2 節的分解套用到每一對變項上。
pm  <- ae
  summarise(across(c(na, pa, stress), ~mean(.x, na.rm = TRUE)))
between_cor <- cor(pm[, -1], use = "complete.obs")     # 對角線上方
aew <- ae
  mutate(across(c(na, pa, stress), ~ .x - mean(.x, na.rm = TRUE), .names = "wd_{.col}"))
within_cor <- cor(aew[, c("wd_na","wd_pa","wd_stress")], use = "pairwise.complete.obs")
軟體提示 • 描述統計的輔助工具,以及一項關於 ICC 定義的警告
有幾個套件能把縱貫版「表 1」的一部分自動化:psych::statsBy 一次呼叫就傳回個體間與個體內的相關與信度;misty::multilevel.descript 報告層次專屬的描述統計與組內相關;performance::icc 則從一個已配適的模型中取出 ICC。最關鍵的一項警告是:「ICC」指的是一個家族,不是單一個量。各套件在報告未調整或已調整的 ICC、採單向或雙向的形式(one-way or two-way),以及三層資料要報告哪一層的份額上都有差異,因此報告一個 ICC 時,一律要附上產生它的模型與定義。像上面那樣由一個明確的虛無模型算出 ICC,定義才毫無歧義。
7.7 描述結果的解讀與報告
一份密集研究的描述段落,應該報告變異數落在哪裡、指標的表現如何,以及層次專屬的關聯,措辭還要讓各層次保持分明。針對經驗取樣資料的示範文字可以這樣寫:「當下負向情緒、正向情緒與壓力的個體層次組內相關分別為 \(.35\)、\(.43\) 與 \(.47\)(三層虛無模型),表示每一個變項都有大約一半的變異數是當下的,可供個體內分析使用,另有 \(6\) 至 \(14\%\) 組織在日層次上。各變項都計算了個人平均數與個人平均數中心化後的偏離。壓力與負向情緒的個體間關聯與個體內關聯在大小上有別(\(r = .55\) 與 \(r = .33\)),與特質層次與狀態層次為不同歷程的看法一致。個體內變異性以相對標準差摘要,而非原始的個體內標準差,因為在有界的反應量尺上,後者與個人平均數的相關為 \(.61\)。延宕一期慣性亦已計算,但報告時附上保留,因為在實際達成的時點數之下它的信度偏低。」每一個子句都報告一個層次專屬的量,並標記出唯一那個資料撐不起其可信度的指標,也就是慣性。這正是本章所要培養的誠實。
7.8 常見的迷思
關於這些描述統計,有幾個信念會誤導人。第一個把組內相關等同於信度:兩者都由類似的變異數比值算出來,也確實相關,但一個結果變項的 ICC 描述的是它有多少變異數在個體之間,一個測量的信度描述的是它有多少變異數是真分數,而一個變項完全可以 ICC 很低、卻測量得非常精確。第二個主張高慣性總是適應不良的:實徵文獻平均而言把偏高的慣性連結到較差的適應,但持續性算適應還是適應不良,取決於持續的是什麼,以及在什麼脈絡裡,而把一個指標道德化是一種概念錯誤。第三個把個人平均數當成這個人的真實水準:它們是帶著抽樣誤差的估計,時點數少時那份誤差相當可觀,後續各章的收縮與潛在分解方法之所以存在,正是因為原始平均數高估了個體間的分散程度。還有一個反覆被問到的問題:該用哪一個變異性指標?答案是表 7.1 的邏輯,也就是把指標對上研究者關心的那個歷程特徵,同時受冗餘警告的節制:一個特徵挑一個代表,不要報告一整批彼此相關的指標;在有界量尺上,則優先採用已對平均數校正的形式。
實務要點 • 每一個指標最少需要幾個時點
一個指標需要多少時點,不是單一個數字,而取決於是哪一個指標,以及研究者願意接受多高的信度。在圖 7.6 的模擬中,個體內標準差(iSD)與連續差異均方根(RMSSD)大約在三十個時點時,複本信度(parallel-forms reliability)就接近 \(.80\)。延宕一期慣性要求高得多,在三十個時點時仍低於 \(.40\),需要長得多的序列,或是能在個體之間互相借力的模型式估計,個體層次的值才值得信任。這些數字是那個模擬歷程所特有的,應該讀成數量級的指引,而不是門檻:誠實的做法是報告實際達成的時點數,並把由短序列算出來的個體層次指標,尤其是以自我相關為基礎的那些,一律當成暫定的。
本章摘要
重複測量的描述分析,從追問變異數落在哪裡開始。由虛無模型得到的組內相關把總變異數切成個體間與個體內兩份,同時兼任同一個人兩筆觀察的期望相關(圖 7.1);就本書的情緒資料而言,每一個當下構念都約有一半的變異數在個體之內,另有十分之一左右在日層次。任何隨時間變動的預測變項都可以分解成一個個體間的平均數與一個個體內的偏離,兩者與結果變項的關聯可以不同(圖 7.2),而原始的個人平均數在 \(T\) 小時是一個雜訊很大的特質估計。一族個體層次指標摘要每個人的動態,包括平均數、標準差及其對平均數校正後的相對形式、代表不穩定的 RMSSD 與急遽變化機率,以及代表慣性的延宕一期自我相關;四個平均數完全相同的人,在這些指標上可以差得很多(圖 7.3)。每一個指標都帶著一種失效模式:原始的 iSD 在有界量尺上與平均數混淆,必須加以校正(圖 7.5);慣性在短序列中既不可靠又向下偏誤(圖 7.6);趨勢與日內週期若不先模型化移除就會膨脹不穩定(圖 7.7);而這些指標彼此冗餘,相對於平均數所增加的很少(圖 7.8)。本章以縱貫版的「表 1」收尾,它報告層次專屬的統計量,以及分開的個體間與個體內相關矩陣。貫穿全章的紀律是:要描述就算指標,要推論就配模型。
接下來讀哪裡
本章的描述統計是進入建模各部的入口。變異數分解就是每一個多層次成長與日誌模型(第 13、14、23 章)所要在其上擴充的那個虛無模型,而它所產生的 ICC 決定了那些模型有多少個體內訊號(within-person signal)可用。預測變項的個體間與個體內分解,會變成個體內建模核心的那個中心化(centering)決定。變異性指標會在第 16 章的混合效果位置尺度模型中變成模型參數,慣性則會變成第 24 與 25 章單一受試者(single-subject)與多層次時間序列模型中的自我迴歸參數,並在那裡以描述性指標所缺乏的收縮與誤差分離估計出來。到了第 33 與 35 章的應用,這些指標會再度以臨床與人格結果變項的預測變項身分出現,而此處反覆提醒過的那些警告,也就是平均數的混淆、信度的下限、彼此的冗餘,就是一項穩健發現與一項假象之間的差別。
習題
- 7.1 分解變異數。就
affect_ema中的四個當下變項,計算個體層次與日層次的兩層與三層組內相關(其中alone只計算兩層的版本)。解讀每一個值對於「這個構念比較適合在個體之內還是在個體之間研究」各意味著什麼。 - 7.2 兩種關聯。為壓力與負向情緒建立個體間與個體內兩張分解散布圖,估計兩個斜率,並寫一段約 \(225\) 字的解讀,讓兩個層次保持分明,並指名把兩者混為一談會犯下的那個謬誤。
- 7.3 把混淆暴露出來。重製「平均數對 iSD」的散布圖及其有界量尺包絡線,接著套用相對標準差,並報告一個假設性的「變異性與某結果變項之間的相關」,在平均數的混淆被移除之後會如何改變。
- 7.4 慣性的偏誤。以模擬估計延宕一期自我相關在 \(T = 10\)、\(30\) 與 \(100\) 時的偏誤,真值由你自己選定,並說出這對「跨序列長度不同的研究比較慣性」有什麼後果。
- 7.5 建一張表 1。使用所提供的一份日誌資料與表 7.3 的範本,產出一份可供發表的描述表,含層次專屬的統計量以及分開的個體間與個體內相關矩陣,並寫出隨附的描述段落。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 組內相關 | intraclass correlation (ICC) | 落在個體之間的變異數比例,同時是同一人兩筆觀察的期望相關;第 7.1 節 |
| 無條件模型 | unconditional model | 只含截距的模型,用來分解變異數;第 7.1 節 |
| 虛無模型 | null model | 同無條件模型;第 7.1 節 |
| 個體內平均數 | intraindividual mean (iMean) | 一個人自己觀察的平均數;第 7.3 節 |
| 個體內標準差 | intraindividual standard deviation (iSD) | 一個人自己觀察的標準差;第 7.3 節 |
| 相對標準差 | relative standard deviation | iSD 除以該平均數所允許的最大 SD;第 7.3 節 |
| 連續差異均方根 | root mean square of successive differences (RMSSD) | 對時間順序敏感的不穩定指標;第 7.3 節 |
| 急遽變化機率 | probability of acute change (PAC) | 連續差異超過切點的比例;第 7.3 節 |
| 慣性 | inertia | 狀態持續的傾向,以延宕一期自我相關摘要;第 7.3 節 |
| 個體內相關 | within-person correlation | 兩個狀態當下偏離之間的相關;第 7.3 節 |
| 情緒區辨 | emotion differentiation | 同效價題目之間平均的個體內相關,低者區辨細;第 7.3 節 |
| 密度分配 | density distribution | 把特質看成一個人所造訪狀態的分配(Fleeson);第 7.3 節 |
| 平均數與變異數的混淆 | mean-variance confound | 有界量尺上 iSD 機械性地與 iMean 綁在一起;第 7.4 節 |
| 小樣本偏誤 | small-sample bias | 樣本自我相關在短序列中向下偏誤;第 7.4 節 |
| 去趨勢 | detrending | 計算指標前先移除趨勢或週期;第 7.4 節 |
| 冗餘 | redundancy | 多個指標測到幾乎相同的東西;第 7.4 節 |
| 收縮 | shrinkage | 依不確定性把不可靠的個別估計往總平均數拉;第 7.2 節 |
| 混合效果位置尺度模型 | mixed-effects location-scale model | 同時建模平均數與個體內離散度(第 16 章);第 7.3 節 |
| 縱貫版「表 1」 | longitudinal Table 1 | 區分層次的描述表,含兩個相關矩陣;第 7.5 節 |
參考文獻
Baird, B. M., Le, K., & Lucas, R. E. (2006). On the nature of intraindividual personality variability: Reliability, validity, and associations with well-being. Journal of Personality and Social Psychology, 90(3), 512–527. https://doi.org/10.1037/0022-3514.90.3.512
Bliese, P. D. (2000). Within-group agreement, non-independence, and reliability: Implications for data aggregation and analysis. In K. J. Klein & S. W. J. Kozlowski (Eds.), Multilevel theory, research, and methods in organizations: Foundations, extensions, and new directions (pp. 349–381). Jossey-Bass.
Bolger, N., & Laurenceau, J.-P. (2013). Intensive longitudinal methods: An introduction to diary and experience sampling research. Guilford Press.
Dejonckheere, E., Mestdagh, M., Houben, M., Rutten, I., Sels, L., Kuppens, P., & Tuerlinckx, F. (2019). Complex affect dynamics add limited information to the prediction of psychological well-being. Nature Human Behaviour, 3(5), 478–491. https://doi.org/10.1038/s41562-019-0555-0
Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989X.12.2.121
Erbas, Y., Ceulemans, E., Pe, M. L., Koval, P., & Kuppens, P. (2014). Negative emotion differentiation: Its personality and well-being correlates and a comparison of different assessment methods. Cognition and Emotion, 28(7), 1196–1213. https://doi.org/10.1080/02699931.2013.875890
Fleeson, W. (2001). Toward a structure- and process-integrated view of personality: Traits as density distributions of states. Journal of Personality and Social Psychology, 80(6), 1011–1027. https://doi.org/10.1037/0022-3514.80.6.1011
Hamaker, E. L. (2012). Why researchers should think “within-person”: A paradigmatic rationale. In M. R. Mehl & T. S. Conner (Eds.), Handbook of research methods for studying daily life (pp. 43–61). Guilford Press.
Houben, M., Van Den Noortgate, W., & Kuppens, P. (2015). The relation between short-term emotion dynamics and psychological well-being: A meta-analysis. Psychological Bulletin, 141(4), 901–930. https://doi.org/10.1037/a0038822
Jahng, S., Wood, P. K., & Trull, T. J. (2008). Analysis of affective instability in ecological momentary assessment: Indices using successive difference and group comparison via multilevel modeling. Psychological Methods, 13(4), 354–375. https://doi.org/10.1037/a0014173
Kuppens, P., Allen, N. B., & Sheeber, L. B. (2010). Emotional inertia and psychological maladjustment. Psychological Science, 21(7), 984–991. https://doi.org/10.1177/0956797610372634
Mestdagh, M., Pe, M. L., Pestman, W., Verdonck, S., Kuppens, P., & Tuerlinckx, F. (2018). Sidelining the mean: The relative variability index as a generic mean-corrected variability measure for bounded variables. Psychological Methods, 23(4), 690–707. https://doi.org/10.1037/met0000153
Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
Trull, T. J., Solhan, M. B., Tragesser, S. L., Jahng, S., Wood, P. K., Piasecki, T. M., & Watson, D. (2008). Affective instability: Measuring a core feature of borderline personality disorder with ecological momentary assessment. Journal of Abnormal Psychology, 117(3), 647–661. https://doi.org/10.1037/a0012532
Wang, L. P., Hamaker, E. L., & Bergeman, C. S. (2012). Investigating inter-individual differences in short-term intra-individual variability. Psychological Methods, 17(4), 567–581. https://doi.org/10.1037/a0029317
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。