第 14 章
多層次架構下的成長曲線模型
上一章的混合模型(mixed model)把時間當成眾多預測變項中的一個,本章讓時間當主角。斜率隨人而異的那個預測變項若就是時間本身,屬於個人的直線就成了屬於個人的軌跡(trajectory):截距(intercept)是起始水準,斜率(slope)是改變速率;而第 13 章還顯得抽象的隨機效果共變數(random-effect covariance),到這裡就是科學問題的實質內容,也就是人們的起點差多少、改變的速度差多少,這兩種差異又是否連動。成長曲線模型(growth curve model)不過就是把時間放在第一層當預測變項的線性混合模型;第 13 章確立的一切,概似(likelihood)估計、變異數檢定的邊界問題(boundary problem)、中心化(centering)的邏輯,全部原封不動沿用過來。新增的是一組只有在時間當預測變項時才會出現的決定:時間軸的原點放在哪裡、軌跡取什麼函數形式、每個人的受測年齡或時程各不相同時怎麼辦、個人層次的共變項如何重塑整條軌跡,以及隨機效果沒吸收完的殘差依賴怎麼建模。每一項都是帶著實質後果的建模抉擇,本章會逐項配上式子、白話解讀,以及在真實軌跡上的實作示範。
學習目標
讀完本章之後,你應該能夠:(1) 把無條件線性成長模型(unconditional linear growth model)寫成混合模型,並把它的固定效果、隨機效果變異數與截距斜率共變數,讀成個體軌跡的特徵;(2) 為時間計量(time metric)的原點作選擇並提出理由,說明重新編碼時間如何牽動截距、截距的變異數以及截距與斜率的相關,斜率本身則不變;(3) 以多項式(polynomial)、分段線性(piecewise-linear)與樣條(spline)基底設定非線性的改變,並比較配適;(4) 以加速縱貫設計(accelerated longitudinal design)把測量年齡範圍互相重疊的幾個世代配適成單一個成長模型,並說清楚它的連結假設;(5) 加入個人層次共變項當截距與斜率的預測變項,把由此產生的跨層次交互作用(cross-level interaction)讀成被調節的改變;(6) 在成長模型中納入時間變動共變項(time-varying covariate),並分開它的個體內效果與個體間效果;(7) 隨機效果沒有完全吸收依賴時,以 nlme 為殘差共變數結構建模;(8) 建立、診斷成長模型,並把它報告到可供發表的水準。
14.1 成長就是混合模型:時間當預測變項
無條件線性成長模型(unconditional linear growth model)就是第 13 章的兩層混合模型,只是把時間放進去當第一層唯一的預測變項。在第一層,每個人在每一個時點上的結果,是一條屬於自己、隨時間變化的直線加上殘差,\(y_{it} = \pi_{0i} + \pi_{1i}\,a_{it} + e_{it}\),其中 \(a_{it}\) 是第 \(i\) 個人在第 \(t\) 個時點上時間計量的值,\(\pi_{0i}\) 是第 \(i\) 個人的截距,也就是 \(a_{it}=0\) 時結果變項(outcome)的期望值(expected value),\(\pi_{1i}\) 則是這個人的斜率,也就是每單位時間結果變項預期的改變。以希臘字母 \(\pi\) 標示屬於個人的係數,是 Raudenbush and Bryk (2002) 與 Singer and Willett (2003) 的成長模型慣例,它就是第 13 章寫成 \(\beta_i\) 的那個東西。在第二層,每個人的截距與斜率是母體平均數加上屬於自己的偏離,\(\pi_{0i} = \gamma_{00} + u_{0i}\),\(\pi_{1i} = \gamma_{10} + u_{1i}\),而這些偏離(departure)服從二元常態分配,\((u_{0i}, u_{1i})' \sim N(\mathbf{0}, \mathbf{T})\):共變數矩陣 \(\mathbf{T}\) 的對角線上是截距變異數 \(\tau_{00}\) 與斜率變異數 \(\tau_{11}\),非對角線上是兩者的共變數 \(\tau_{01}\)。合併形式 \(y_{it} = \gamma_{00} + \gamma_{10}a_{it} + u_{0i} + u_{1i}a_{it} + e_{it}\) 正是第 13 章的隨機斜率模型;要把它讀成成長(growth),只需認出那個隨人而變的預測變項(predictor)是時間。
這三個變異數參數(variance parameters)就是一項成長研究的實徵(empirical)內容。截距變異數 \(\tau_{00}\) 衡量的是在定為時間零的那一刻,人們之間差得有多開。斜率變異數 \(\tau_{11}\) 衡量的是改變速率差得有多開;斜率變異數若與零無法區辨,發現就是「不論平均改變多大,每個人的改變速率基本上都一樣」。截距與斜率的共變數 \(\tau_{01}\) 通常以相關報告,說的是起點較高的人改變得比起點較低的人快還是慢。最後這個量回答的是結果變項上的個別差異隨時間拉大還是縮小,也就是第 13 章的扇形展開(fan-spread)或收攏(fan-close)。在發展與教育的應用中,它經常就是首要問題,因為它區分了兩種歷程:一種是早期優勢(early advantage)會複利累積,一種是起點較低的人會迎頭趕上。只報告平均軌跡、也就是只報告固定效果 \(\gamma_{00}\) 與 \(\gamma_{10}\) 的成長模型,等於丟掉了當初之所以要測量改變的那些個別差異(individual differences)。
本章一路使用的資料是 school_growth,一個模擬的世代,共 \(1{,}200\) 位兒童,每人測量四次,並巢套(nested)於學校之中,記錄三年級到八年級之間的學業成就(academic achievement)。把時間計量中心化在三年級,也就是令 \(a_{it} = \text{年級} - 3\),再配適無條件線性模型,得到三年級的平均起始水準 \(\gamma_{00} = 188.1\) 分,每升一個年級平均增加 \(\gamma_{10} = 8.39\) 分。兒童層次的標準差估計為截距 \(20.1\) 分、斜率每年級 \(3.09\) 分,截距與斜率的相關為 \(-0.25\);學校層次另外貢獻 \(8.7\) 分的截距標準差,殘差標準差為 \(9.1\)。這個負的截距斜率相關說的是:在這個原點之下,三年級起點較高的兒童增加得略慢,屬於輕微的收斂(convergence)。這句描述站不站得住腳,完全取決於原點放在哪裡,那正是下一節的主題。
一個成長模型能估計什麼形狀,受限於時點(occasion)的數目,而這是收資料之前就得定下來的設計限制(design constraint)。表 14.1 陳述了這個對應。兩個時點只能支持一個差異分數,沒有軌跡可言,因為單一個間隔無法把斜率與殘差噪音(residual noise)分開。三個時點是線性斜率(linear slope)的最低要求,但在這個下限上,斜率變異數的檢定力(power)低得出名,第 4 章的檢定力分析已就此展開。曲率、樣條與非線性形式要可識別(identifiable)又有足夠檢定力,則需要四個以上的時點。因此,想刻畫改變形狀的設計,取得的時點數應該比該形狀的固定部分嚴格要求的還多:形狀上的隨機變異才是真正的科學目標,而它需要的訊息比平均數多。
表 14.1 各種候選成長形狀所需的時點數。
| 波次 | 可估計的形狀 | 註記 |
|---|---|---|
| 兩波 | 只有差異(difference)或水準(level) | 沒有軌跡;斜率無法與殘差分開,改變就是單一個差異分數(第 10 章) |
| 三波 | 線性成長 | 斜率的最低要求;斜率變異數可估,但檢定力很差(第 4 章) |
| 四波 | 線性配適綽綽有餘;二次(quadratic)可識別 | 曲率項變得可估,但它的變異數仍然弱 |
| 五波以上 | 二次估得好;三次(cubic)可行 | 高階與分段形狀開始獲得支持 |
| 六波以上 | 樣條(spline)與非線性(nonlinear)形式 | 有彈性的、以及本質上非線性的軌跡變得可行 |
註:可估計的形狀受時點數所限:\(p\) 次多項式(polynomial)的固定趨勢(fixed trend)至少需要 \(p+1\) 個時點,該趨勢的變異數則需要更多。斜率與曲率的變異數,估計時的檢定力遠低於它們的平均數,所以三波時斜率變異數不顯著,只是「每個人改變得一樣」的很弱證據。
14.1.1 時間從哪裡開始:原點是一項建模抉擇
成長模型中後果最嚴重、也最被低估的一項決定,是時間計量的編碼(coding)。原點(origin),也就是 \(a_{it}\) 等於零的那個值,界定了截距的意義,並透過模型的幾何結構一併決定截距變異數與截距斜率相關 (Biesanz et al., 2004; Mehta & West, 2000)。斜率對原點不變,因為把時間軸左右平移(shift)不會改變一條直線的陡度(steepness);截距則是直線在 \(a=0\) 處的高度,這個高度、它的個體間變異性,以及它與斜率的關聯,都會隨原點一起移動。圖 14.1 在學校成長的線性模型上示範了這件事。把時間中心化(centering)在觀察窗(observation window)起點的三年級,截距就是起始水準 \(188.1\) 分,截距斜率相關為 \(-0.25\)。中心化在中點五年級,截距成為窗中段的水準 \(204.9\) 分,相關升到接近零的 \(0.06\)。中心化在終點八年級,截距成為最終水準 \(230.0\) 分,相關變成可觀的 \(+0.47\)。
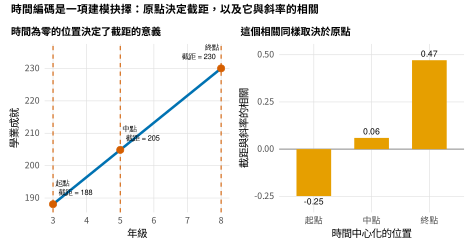
註:左:學校成長資料的平均線性軌跡,標出三個候選原點與各自隱含的截距。原點放在哪裡,斜率都是同一條線。右:同一個模型把原點分別放在窗的起點、中點與終點時,估計出來的截距斜率相關。原點越往後移,相關由 \(-0.25\) 變成 \(+0.06\) 再變成 \(+0.47\),儘管資料與斜率都沒有改變。
相關的符號反轉(sign reversal)不是弔詭(paradox),也不是該修正的假象(artifact),而是一個正確的陳述:不同的問題有不同的答案。斜率與三年級截距的相關問的是「入學時起點較高的兒童是否增加得比較快」,答案是否定的,這些兒童增加得略慢。斜率與八年級截距的相關問的是「最後成就較高的兒童是不是靠增加得比較快才到那裡」,答案是肯定的,而且必然如此:起點相近而要以高分作結,就非得爬得比較陡不可。兩句話對同一群兒童都成立。實務上的教訓是,原點要選得讓截距成為科學上關心的那個量,最常見的是治療開始之時、某個發展窗(developmental window)的起點,或某個有意義的錨定年齡(anchor age);而所報告的截距變異數與截距斜率相關,永遠要相對於選定的原點來解讀。在已發表的成長模型裡看到很強的截距斜率相關,下任何實質結論之前都該先問時間的零點設在哪裡,因為同一項研究改在別處中心化,報出來的就是另一個數字。表 14.2 依「截距要回答什麼問題」整理原點的決定,並一併列出計量的選擇,也就是波次編號、經過的時間或年齡,這由設計與估計標的(estimand)共同決定。
表 14.2 時間計量與其原點的決策指引。
| 問題或錨點 | 時間編碼 | 對截距的後果 |
|---|---|---|
| 觀察起點時的水準 | 中心化在第一個時點 | 截距即基線水準 |
| 終點或達成時的水準 | 中心化在最後一個時點 | 截距即最終狀態 |
| 某個實質事件時的水準 | 中心化在事件發生的時間 | 截距即事件當下的水準 |
| 以年齡索引的發展歷程 | 以年齡為計量(加速設計) | 需要世代(cohort)收斂檢查 |
| 未按時程受測的人 | 用觀察到的時間,不用波次編號 | 移除時程飄移(schedule drift)造成的偏誤(bias) |
註:原點要選得讓截距成為科學上關心的那個量,因為截距變異數與截距斜率相關只有相對於它才可解讀。重新編碼原點會改變那些量,但不會改變模型的配適,也不會改變斜率。實際施測日期偏離名目日期時,計量要用每次測量實際觀察到的時間。
基礎概念 • 為什麼斜率不變而截距會變
把軌跡寫在平移後的原點 \(a^{\ast} = a - c\) 上。直線 \(\pi_{0i} + \pi_{1i}a\) 變成 \(\pi_{0i} + \pi_{1i}(a^{\ast}+c) = (\pi_{0i}+\pi_{1i}c) + \pi_{1i}a^{\ast}\)。新的斜率仍是 \(\pi_{1i}\),所以斜率與它的變異數 \(\tau_{11}\) 都不變。新的截距 \(\pi_{0i}^{\ast} = \pi_{0i} + c\,\pi_{1i}\) 是舊截距與斜率的線性組合(linear combination),變異數因而是 \(\tau_{00}^{\ast} = \tau_{00} + 2c\,\tau_{01} + c^{2}\tau_{11}\),與斜率的共變數則是 \(\tau_{01}^{\ast} = \tau_{01} + c\,\tau_{11}\)。這個共變數是平移量 \(c\) 的一條直線,斜率為 \(\tau_{11}>0\);原點越往後移,截距斜率共變數就無上限地增大,並且恰好穿過零一次,位置在 \(c = -\tau_{01}/\tau_{11}\)。圖 14.1 的整個型態就出自這一條代數事實:截距斜率相關的符號不是資料本身的性質,而是資料與所選原點合起來的性質。
14.2 改變的形狀:非線性軌跡
直線成長是很強的假設,而心理學與教育中許多改變是彎的:接近天花板(ceiling)時趨緩的增長、一段平淡之後的衝刺(spurt),或在某個已知轉折(例如入學或治療開始)處變換的速率。混合模型不必離開這個架構就能容納曲率,因為在時間上非線性的軌跡,可以是在轉換後(transformed)的時間預測變項上為線性的模型。三種取向涵蓋了大多數應用,它們在平滑性與可解讀性之間各有取捨 (Cudeck & Harring, 2007; Grimm et al., 2011)。
多項式成長模型(polynomial growth model)把時間的次方加進來當預測變項。二次模型 \(y_{it} = \gamma_{00} + \gamma_{10}a_{it} + \gamma_{20}a_{it}^{2} + u_{0i} + u_{1i}a_{it} + e_{it}\) 引進一個固定曲率 \(\gamma_{20}\) 把平均軌跡彎起來:負值為減速(deceleration),正值為加速(acceleration);三次項則再加上一個反曲點(inflection)。多項式吸引人的地方在於對參數仍然是線性的(linear in the parameters),一般的混合模型軟體就配適得了,但它帶著兩項弱點。線性項之後的係數沒有「速率」這種直接的解讀,而配適出來的曲線一旦推到觀察範圍之外就外推(extrapolate)得離譜,所以二次式絕不可以讀出資料範圍之外。在學校成長的平均數上,如圖 14.2 所示,二次項是 \(-0.57\),屬於溫和的減速,而它值回票價:Akaike 訊息準則(Akaike information criterion, AIC)由線性模型的 \(39{,}058\) 降到二次模型的 \(39{,}003\),相差 \(54\),決定性地支持曲線。三次項則沒有比二次更好,AIC 為 \(39{,}010\),略差一些。這個減速是真的,但幅度不大,正是成就測量在上端壓縮(compression)時常見的那種趨緩。
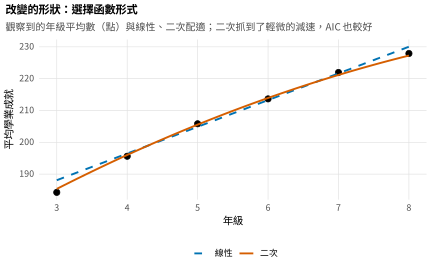
註:學校成長資料觀察到的年級平均數(點),配上配適出來的線性(虛線)與二次(實線)平均軌跡。二次抓到跨年級的輕微減速,Akaike 訊息準則比線性模型好 \(54\),三次項則沒有任何增益。多項式的配適絕不可外推到觀察到的年級範圍之外。
分段線性(piecewise-linear)或樣條(spline)成長模型把單一條直線換成兩段以上的線段,在一個節點(knot)處接起來;節點就是斜率獲准改變的那個時間值(time value)。節點若放在實質上有意義的轉折處,這個模型就擁有多項式所缺的解讀優勢:每一段都有一個斜率,而那是結果變項自己單位上的改變速率。它的基底(basis)是時間變項,再加上時間超過節點之後的正部(positive part);因此在六年級設節點時,兩個預測變項就是 \(a_{it}\) 與 \((\text{年級}-6)_{+}\),後者在六年級之前為零、之後等於年級減六。第一個的係數是節點前的斜率,第二個的係數是斜率在節點處的改變量,節點後的斜率則是兩者之和。配適到學校成長資料上,如圖 14.3 所示,節點前斜率為每年級 \(9.21\) 分,在節點處改變 \(-2.48\),節點後斜率因而是 \(6.73\):早期年級成長迅速,後期年級減速。這與二次式說的是同一個故事,只是改用兩個可解讀的速率來表達,而不是一個曲率係數。節點可以像這裡一樣依理論事先固定,更進階的處理也可以由資料估計;各分段(segment)本身還可以隨人隨機變動,讓不同的人有各自的節點前與節點後速率。
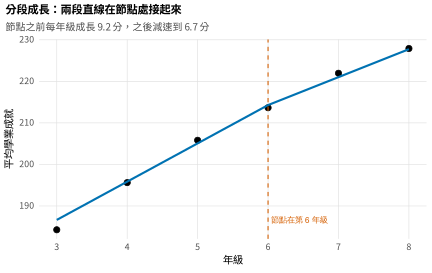
註:學校成長的平均數以兩段直線配適,在六年級處以一個節點(knot)接起來。節點前的斜率是每年級 \(9.2\) 分,節點後是 \(6.7\) 分,轉折處減速 \(2.5\) 分。與多項式的係數不同,每一段的斜率都是結果變項自己單位上的改變速率;節點標記一個有意義的轉折時,這正是樣條在解讀上的優勢。
形狀怎麼選,先由理論指引,再看配適。已知有實質上的轉折,分段模型可以直接檢定它,並報告兩側的速率。改變若是平滑彎曲而沒有自然的斷點,低次多項式較為簡約(parsimonious)。形狀真的未知而時點又多,可以考慮帶著數個節點、更有彈性的樣條,或帶著漸近線(asymptote)與速率常數等參數的非線性模型,代價是可解讀性(interpretability)與識別性(identification)。AIC 與貝氏訊息準則(Bayesian information criterion, BIC)這類配適指標可以在巢套與非巢套(non-nested)的替代方案之間作裁決,但絕不該推翻歷程理論所要求的函數形式;只因為配適略好就選一個容易外推失控的多項式,是常見而且可以避免的錯誤。表 14.3 收齊了常見的形式、各自的 R 語法、參數的意義,以及在什麼條件下較佳。
表 14.3 成長軌跡的函數形式選單。
| 形式 | R 語法 | 參數的意義 | 何時較佳 |
|---|---|---|---|
| 線性 | y ~ t | 固定的改變速率 | 三波;單調的改變 |
| 二次 | poly(t, 2, raw = TRUE) | 曲率;減速或加速 | 平滑的曲線,只讀範圍之內 |
| 分段 | pre + post | 每一段一個速率 | 已知的轉折或節點 |
| 樣條 | ns(t, knots) | 有彈性的局部形狀 | 波次多、形狀未知 |
| 非線性 | nlme(...) | 漸近線與速率常數 | 理論給得出參數 |
註:理論選定形式,配適在候選之間裁決。多項式絕不讀到觀察範圍之外;漸近線或速率常數這類參數本身就是實質關心的量時,以本質上非線性的形式為佳。懲罰式與本質非線性的形式在第 30 章發展。
14.3 個別不同的測量時點與加速設計
平衡(balanced)成長模型藏著一個假設:每個人都按同一個時程受測,於是時點與時間重合。真實的研究經常違反這一點。參與者在不同的實足年齡(chronological age)受測,施測日期偏離名目日期(nominal date);而最有用的一種情形是研究刻意設計成讓不同世代涵蓋年齡範圍中不同但互相重疊的段落。混合模型的表述不必特別處理就能容納這些,因為時間是以數值預測變項 \(a_{it}\) 進場,可以對每一個人、每一個時點取不同的值。這正是多層次成長模型在實務上的決定性優勢,勝過第 11 章的古典重複量數變異數分析,在平衡的情形下也勝過第 19 章寬格式的潛在成長模型:個別不同的測量時點(individually varying occasions)所需要的,不過就是把每個人實際的時間值填進去 (Mehta & West, 2000; Sterba, 2014)。
最能發揮這一點的設計是加速縱貫設計(accelerated longitudinal design),也稱世代序列設計(cohort-sequential design),由 Bell (1953) 提出,用意是在很短的日曆時間(calendar time)內橫跨一段很長的發展範圍(developmental range)。研究者不追蹤單一個世代走完整個年齡範圍(那要花掉與範圍等長的年數),而是招募幾個年齡不同的世代,各自追蹤一段較短且互相重疊的期間,再在年齡計量上把它們連結(link)成單一條軌跡。學校成長資料的三個世代正好示範這個設計:世代 A 觀察三到六年級,世代 B 觀察四到七年級,世代 C 觀察五到八年級,每個孩子因此只貢獻六個年級中的四個,但各世代彼此重疊,合起來涵蓋完整的跨度。圖 14.4 把三個世代的平均數畫在共用的年級軸上,重疊處三者幾乎重合;配適在合併資料上的單一個成長模型,即使沒有任何一個孩子被測滿六個年級,仍然還原出一條由三年級到八年級的連續軌跡。
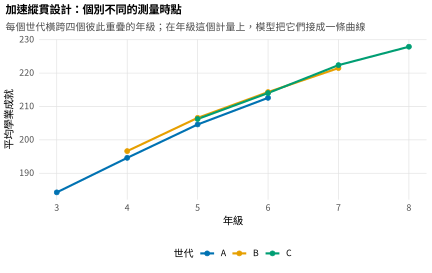
註:學校成長三個世代的平均成就,畫在共用的年級計量上。世代 A 橫跨三到六年級,世代 B 四到七年級,世代 C 五到八年級,因此沒有任何一個孩子被觀察滿整個範圍;然而重疊的段落彼此對齊,合併後的成長模型把它們接成一條從三年級到八年級的軌跡。這個連結倚賴「世代與年齡不混淆」這個收斂假設。
這個設計的威力立基於一個必須明說、可能時還要檢驗的假設。收斂假設(convergence assumption)是說各世代出自同一個成長歷程,軌跡取決於年齡而不取決於世代;不同世代貢獻的段落因此可以當成同一條曲線的片段,而不是幾條剛好重疊的不同曲線 (Miyazaki & Raudenbush, 2000; Raudenbush & Chan, 1992)。假設成立時,這個設計以一小部分的日曆時間與參與者負擔(burden),換到很寬的發展範圍。假設失敗時,例如世代趨勢(secular trend)、某個世代特有的事件,或差別性的選擇(differential selection)使各世代真的不同,接起來的軌跡就成了年齡改變與世代差異的混合物,可能把兩者都呈現錯誤。檢查的方式是把世代加進去當預測變項,檢定它有沒有調節成長參數,或比較各段落在重疊區域內的表現;在實質上,則是論證各世代只在年齡上不同,不在任何會改變發展歷程的因素上不同。這個設計是混合模型架構送的一份大禮,但它完成的連結是一項推論,不是一次測量,誠實的報告會把收斂假設明白寫出來。
14.4 條件成長:預測軌跡
無條件模型描述人們如何改變,條件成長模型(conditional growth model)則解釋人們為什麼不同:把個人層次的共變項當成成長參數的預測變項放進來。時間不變共變項(time-invariant covariate) \(W_i\) 是組別(arm)、性別或基線分數(baseline score)這類個人特徵,它同時進入截距與斜率的第二層方程式,\(\pi_{0i} = \gamma_{00} + \gamma_{01}W_i + u_{0i}\) 與 \(\pi_{1i} = \gamma_{10} + \gamma_{11}W_i + u_{1i}\)。代入第一層模型得到合併形式 \(y_{it} = \gamma_{00} + \gamma_{10}a_{it} + \gamma_{01}W_i + \gamma_{11}W_i a_{it} + u_{0i} + u_{1i}a_{it} + e_{it}\),其中 \(\gamma_{01}\) 是共變項對起始水準的效果;關鍵則在 \(\gamma_{11}\),它是乘積項 \(W_i a_{it}\) 的係數,也就是個人層次共變項與時間之間的跨層次交互作用(cross-level interaction)。這個交互作用正是「共變項調節了改變」的形式表達:共變項每增加一個單位,成長速率相差多少。它也是一項縱貫介入(intervention)研究之所以存在要估計的那個量,因為它就是各條件之間的斜率差。
示範用的是 therapy_rct,那個模擬的抗憂鬱劑試驗,實驗組與控制組的病人在十二個週次上以 Hamilton 憂鬱量表受測。以組別為共變項配適條件模型,控制組的斜率是 \(\gamma_{10} = -0.64\) 分/週,也就是病人在控制條件下的改善;組別與週次的交互作用為 \(\gamma_{11} = -0.51\),實驗組因此以 \(-0.64 + (-0.51) = -1.15\) 分/週改善,將近兩倍快。圖 14.5 畫出兩條模型隱含的軌跡,分岔(diverging)下降的樣子就是跨層次交互作用的視覺標記(signature)。成長模型中的治療效果不是某一個時點上的平均數差,而是這個斜率差,也就是改變速率的差;研究要問的若是「介入有沒有改變一條軌跡」,而不只是「有沒有移動一個水準」,斜率差正是恰當的估計標的。報告交互作用係數與它的信賴區間,再換算成研究結束時結果變項上隱含的差距,就能以臨床工作者(clinician)需要的語言傳達這個效果。
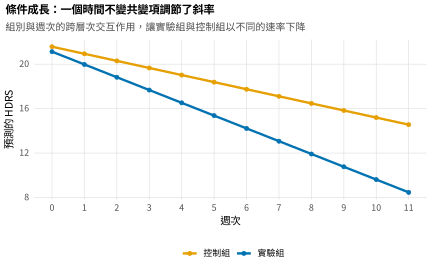
註:模擬試驗中,實驗組與控制組在 Hamilton 憂鬱量表上模型隱含的軌跡。控制組每週下降 \(0.64\) 分,實驗組每週下降 \(1.15\) 分,兩條線之間的落差就是組別與週次的跨層次交互作用 \(-0.51\)。成長模型中的治療效果是這個斜率差,不是任何單一週次上的水準差。
把共變項加到斜率上的條件模型,同時也改變了斜率變異數的意義。無條件的斜率變異數 \(\tau_{11}\) 描述所有人成長速率的總分散程度;共變項一進場,殘餘的斜率變異數就只描述共變項未能解釋的那一部分。強力調節(moderate)成長的處理會吸收掉一部分斜率變異數,比較加入共變項前後的殘餘斜率變異數,就量化了共變項解釋掉多少改變上的個別差異,這是第 13 章解釋變異數邏輯在成長模型中的對應物。只報告交互作用係數,卻不說它對斜率變異數做了什麼,只講了一半的故事。
14.5 成長模型中的時間變動共變項
有些預測變項會在研究期間於個體內改變:起伏的壓力源(stressor)、隨時間變動的劑量(dose)、演變中的環境脈絡(context)。時間變動共變項(time-varying covariate) \(x_{it}\) 與時間並列進入第一層,而它一納入,第 13 章的中心化問題就完整地醒了過來,因為時間變動共變項的原始係數混淆了兩個不同的效果。個體內效果問的是:一個人的共變項高於自己的平均數時,結果變項是否相應地較高,這是同一個人身上隨時間耦合(coupling)的問題。個體間效果問的是:共變項平均水準較高的人,結果變項是否較高,這是穩定個別差異(stable individual differences)的問題。兩個問題不同,答案可能不同,甚至符號相反,而原始係數是兩者無法解讀的混合。解法就是第 13 章發展的個人平均數中心化:把共變項分解成個人平均數 \(\bar{x}_i\) 與個體內偏離 \(x_{it}-\bar{x}_i\),兩者都放進去,偏離就帶著個體內效果,個人平均數帶著個體間效果。
一項真值已知的模擬讓這個還原看得見。資料由一個線性成長歷程產生,\(300\) 個人、六個時點,內建一個真正的個體內共變項效果 \(1.5\),以及一個透過共享特質(shared trait)造成、不同而且較弱的個體間關聯(association)。共變項若原封不動放進去,得到的是被兩者污染(contaminated)的單一係數。改用個人平均數中心化配適,如圖 14.6 所示,還原出的個體內係數為 \(1.42\),接近真值 \(1.5\),個體間係數則另外是 \(0.44\):兩個效果分了開來,也正確辨認出個體內效果是其中較強的那一個。這個教訓由第 13 章直接轉移到成長的情境:時間變動共變項就是一個和其他變項一樣的第一層預測變項,要不要作個人平均數中心化,決定的是它的係數回答哪一個問題。成長模型中的賭注更高,因為時間與時間變動共變項本身可能相關;隨時間走的共變項若不把個體內與個體間成分分開,就會從成長斜率那裡偷走變異數(steal variance)。
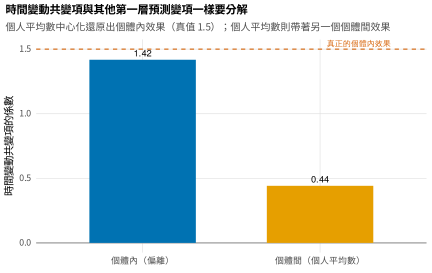
註:一項模擬中,以個人平均數中心化配適的成長模型裡,時間變動共變項的估計係數;該模擬真正的個體內效果為 \(1.5\)(虛線)。個體內偏離還原出 \(1.42\) 的效果,個人平均數則帶著另一個較弱的個體間關聯 \(0.44\)。把共變項原封不動放進去,這兩個效果會混成一個無法解讀的係數。
成長模型中的時間變動共變項還有一項複雜之處,超出個體內與個體間分解:隨時間走的共變項會與成長斜率競爭同一份變異數。在研究期間上升的共變項若不去趨勢(detrend),最好是逐個體去趨勢,就會吸收掉一部分軌跡,使估計出來的改變速率衰減 (Curran & Bauer, 2011)。表 14.4 依序列出這些決定。
表 14.4 成長模型中時間變動共變項的各項決定。
| 問題 | 選擇 | 解讀 |
|---|---|---|
| 要的是個體內還是個體間效果? | 把共變項作個人平均數中心化 | 偏離帶著個體內效果,個人平均數帶著個體間效果 |
| 共變項會隨時間走嗎? | 去趨勢,必要時逐人去趨勢 | 把共變項的效果與它原本會吸收掉的成長斜率分開 |
| 原封不動、未中心化地放進去 | 不建議 | 混合起來的係數,甚至可能帶著錯的符號 |
註:與時間相關的時間變動共變項會吸收掉屬於成長軌跡的變異數,所以要像第 13 章那樣分開它的個體內與個體間成分;有趨勢的共變項則要先去趨勢再解讀。加入時間變動共變項也會改變成長因素的意義,這一項細節與第 19 章的平行處理互相協調。
14.6 殘差共變數結構
成長模型的隨機效果隱含了重複測量之間的邊際共變數,也就是第 13 章的 \(\mathbf{Z}_i\mathbf{T}\mathbf{Z}_i' + \sigma^2\mathbf{I}\)。但 \(\sigma^2\mathbf{I}\) 這一項裡藏著的假設,也就是第一層殘差彼此獨立、且在各時點上變異數相同,對間隔很近(closely spaced)的測量往往太強。時間上靠近的觀察值若比隨機效果所預測的更相像,剩下的依賴(dependence)就住在殘差裡,而直接為它建模可以同時改善配適與固定效果的標準誤。工具是殘差共變數結構(residual covariance structure),也就是給個體內殘差共變數 \(\mathbf{R}_i\) 一個帶參數的形式來取代 \(\sigma^2\mathbf{I}\);在 R 中由 nlme 套件提供,它的 correlation 引數可以配適 lme4 做不到的結構。三種結構涵蓋了常見的情形,示於圖 14.7。獨立結構就是預設的 \(\sigma^2\mathbf{I}\),沒有殘差相關。一階自我迴歸(first-order autoregressive)即 AR(1) 結構,讓殘差相關隨間隔呈幾何級數(geometric)衰退,\(\rho^{|s-t|}\),於是相鄰的殘差最相像、相隔遠的幾乎獨立,這對等間距的時點是很自然的形式。Toeplitz 結構此處以一個二階自我迴歸形式近似,容許每一個延宕各有相關,是更有彈性的帶狀(banded)型態,代價是參數較多。
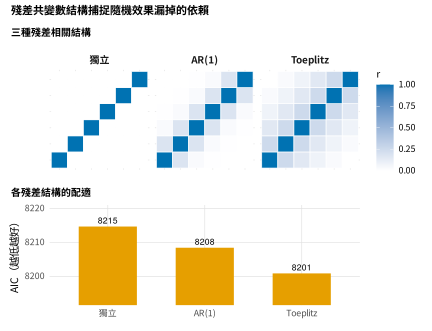
註:上:六個時點的三種殘差相關結構,以熱圖呈現:沒有非對角線相關的獨立結構、呈幾何級數衰退的 AR(1) 結構,以及每個延宕各有一個相關的類 Toeplitz 結構。下:把每種結構疊在隨機截距成長模型上,配適於學校成長資料一個子集所得的 Akaike 訊息準則。越低越好。AR(1) 與 Toeplitz 都比獨立好,顯示隨機截距沒有吸收完的殘差依賴確實存在。
把三種結構配適在一個隨機截距成長模型上,為求速度使用學校成長資料 \(250\) 位兒童的子集,排序與理論預測一致。獨立模型的 AIC 是 \(8{,}215\);加上估計為 \(\rho = 0.18\) 的 AR(1) 殘差相關,降到 \(8{,}208\);類 Toeplitz 結構再降到 \(8{,}201\)。此處的改善幅度不大,因為隨機截距已經吸收了兒童之內大部分的依賴,而這也是常見的情形:隨機效果的結構夠豐富,尤其是有隨機斜率時,剩下可供建模的殘差依賴就很少,獨立殘差已經夠用。殘差共變數建模真正派上用場的是相反的情形:隨機結構刻意保持簡單時、時點既多又密如密集縱貫設計時,或殘差自我相關(autocorrelation)本身就是研究興趣所在時。處理個體內依賴的兩條路,也就是更豐富的隨機效果與有結構的殘差,在某種程度上可以互相替代(substitutable),設定良好的模型會挑與機制相符的那一條:軌跡上真有個別差異就用隨機斜率,測量歷程中有序列依賴(serial dependence)就用有結構的殘差。像這裡一樣以訊息準則比較各結構,是實務上的決定方式,但比較時必須固定住固定效果與隨機效果,只變動殘差結構。表 14.5 列出 nlme 套件提供的結構,以及各自適合的設計。
表 14.5 nlme 中的第一層殘差共變數結構。
| 結構 | nlme 引數 | 說得通的設計 |
|---|---|---|
| 獨立 | 預設的殘差 | 隨機效果已經吸收了依賴 |
| 一階自我迴歸 | correlation = corAR1() | 等間距時點,依賴隨序列衰退 |
| Toeplitz 或 ARMA | correlation = corARMA(p, q) | 帶狀依賴,各延宕的相關互不相同 |
| 異質變異數 | weights = varIdent() | 殘差變異數隨時點改變 |
註:有結構的殘差與隨機斜率都會產生「越靠近對角線相關越高」的樣子,兩者因此可能很難分開。豐富的隨機效果結構是第一選擇;殘差結構則在固定與隨機效果保持不變的條件下以訊息準則挑選,並當成敏感度檢查報告。
實務要點 • 要隨機斜率還是有結構的殘差?
面對個體內的依賴,可以加一個隨機斜率,也可以加一個有結構的殘差;兩者都會改善配適,因此容易混淆。區別在於機制。隨機斜率說的是「人們的改變速率真的不同」,這是個體間的事,隱含一個變異數隨時間增大的特定邊際共變數。有結構的殘差說的是「測量誤差彼此有序列相關」,這是噪音歷程的個體內事實,隱含的共變數相關隨延宕衰退、變異數大致固定。兩者都說得通而資料又夠豐富,就兩個都配適,讓訊息準則與實質解讀去決定。資料量不足時,改變上的個別差異若是科學問題就選隨機斜率;那份依賴若只是測量上要控制而不是要解釋的干擾,就選有結構的殘差。在完整的隨機斜率模型之上再疊一個精緻的殘差結構,常常得到奇異(singular)或不可識別的配適,因為兩者正在競爭解釋同一份依賴。
14.7 實作範例與報告
一份完整的學業成就成長分析,依第 13 章的建模順序進行,再針對成長加以特化。無條件平均數模型只有隨機截距、沒有時間,用來分割(partition)總變異數,確認相當大的一份落在兒童之間與學校之間,多層次的處理因而有理。無條件成長模型加入時間的固定與隨機效果,確立成就平均每年級上升 \(8.4\) 分,並以 \(3.1\) 的斜率標準差確立兒童在速率上確有可觀的差異。接著檢視形狀:二次項的配適決定性地優於線性,指出有輕微的減速,所以報告的模型帶一個固定的二次項。圖 14.8 左邊是配適出來的二次模型疊在一部分個體軌跡上,右邊是模型隱含的年級平均數對觀察到的平均數,那正是成長模型的診斷(diagnostic):問所選的函數形式有沒有重現平均軌跡。隱含平均數與觀察平均數在六個年級上都貼得很近,二次式抓住了平均結構(mean structure)。條件模型接下來會加入學校層次與兒童層次的共變項來解釋截距與斜率的變異數,殘差結構也要檢查,不過這裡的隨機斜率已經沒剩下多少殘差依賴可供建模。
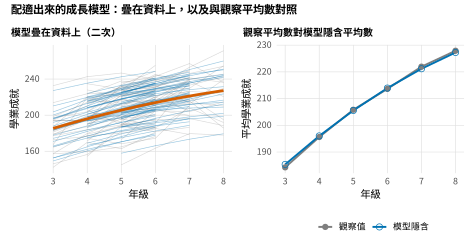
註:左:學校成長資料上,配適出來的二次平均軌跡(紅)疊在 \(60\) 位兒童的個體軌跡(灰)與各自的模型配適值(藍)之上。右:模型隱含的年級平均數(藍)對觀察到的年級平均數(灰)。兩者在三到八年級之間貼得很近,顯示二次的函數形式重現了資料的平均結構。
要把成長模型報告到可供發表的水準,需要幾個橫斷面研究的寫作所沒有的元素。時間計量與原點必須明說,因為每一個與截距有關的量都取決於它們;讀者不知道時間零在哪裡,就無法解讀截距變異數或截距斜率相關。函數形式必須指名並提出理由,附上導向它的配適比較,任何非線性係數也都要換算成關於減速或加速的實質陳述(substantive statement),不能光留一個數字。固定效果給出平均軌跡,在條件模型中還給出共變項對水準與對斜率的效果,後者就是承載實質調節作用的跨層次交互作用。隨機效果,也就是截距與斜率的變異數及其相關,當成改變上個別差異的描述來報告,相關則要相對於所陳述的原點來解讀。遺漏資料的處理方式也應該說明:以概似為基礎的混合模型在第 6 章所發展的隨機遺漏假設之下會用上所有可得的時點,相對於整列刪除(listwise deletion)是一項重大優勢。Curran et al. (2010) 提供了一份清楚的目錄,列出成長模型中反覆出現的問題與各自牽涉的報告決定;Grimm et al. (2017) 則給出更完整的處理,把這裡用的多層次形式接上第 19 章的結構方程形式。表 14.6 整合了一份成長模型寫作在一般迴歸報告之外必須包含的元素。
表 14.6 成長曲線分析的報告檢核表。
| 項目 | 要報告什麼 |
|---|---|
| 時間計量與原點 | 用的是哪個變項、單位為何,以及它在哪裡等於零 |
| 函數形式 | 形狀,以及選定它的依據 |
| 固定效果 | 平均軌跡,以及任何共變項對水準與對斜率的效果 |
| 隨機效果 | 截距與斜率的變異數及其相關,並在所陳述的原點下解讀 |
| 殘差結構 | 獨立或有結構,並附一段敏感度說明 |
| 遺漏資料 | 所假定的機制與估計式,通常是完全訊息最大概似法 |
| 模型比較 | 支撐形狀與預測變項選擇的訊息準則或概似比檢定 |
註:這些是一份成長模型寫作在一般迴歸報告之外必須包含的元素,延伸自第 13 章的混合模型檢核表。每一個與截距有關的量,沒有時間計量與原點就無法解讀,因此兩者列在最前面。
14.8 在 R 中執行成長模型
無條件與條件成長模型以 lme4 的 lmer 配適,時間以數值預測變項進場,並中心化在選定的原點。形狀比較與加速連結不需要任何超出一般模型語法的東西,因為時間就只是一個共變項。
library(lme4); library(lmerTest); library(dplyr)
sg <- readRDS("Examples/data/school_growth.rds") |>
  mutate(grade_c = grade - 3)                     # 原點放在三年級

# --- 無條件線性成長 ---
m_lin <- lmer(achievement ~ grade_c + (1 + grade_c | child_id) +
                (1 | school_id), sg)
summary(m_lin); VarCorr(m_lin)                    # 固定斜率;T 矩陣

# --- 形狀:多項式對線性(在 ML 之下以 AIC 比較)---
m_quad <- lmer(achievement ~ poly(grade_c, 2, raw = TRUE) +
                 (1 + grade_c | child_id) + (1 | school_id), sg, REML = FALSE)
AIC(update(m_lin, REML = FALSE), m_quad)

# --- 形狀:節點在六年級的分段模型 ---
sg <- sg |> mutate(pre = grade_c, post = pmax(grade - 6, 0))
m_pw <- lmer(achievement ~ pre + post + (1 + pre | child_id) +
               (1 | school_id), sg)               # post = 斜率的改變量
原點只要重新編碼時間變項就能更換;重新配適之後便看得到截距、截距的變異數以及它與斜率的相關都在移動,斜率則不動。條件模型透過與時間的交互作用把個人層次共變項加到斜率上,時間變動共變項則完全依第 13 章的方式作個人平均數中心化。
# --- 原點會改變截距與截距斜率相關 ---
for (c0 in c(3, 5, 8)) {
  d <- sg |> mutate(gt = grade - c0)
  print(VarCorr(lmer(achievement ~ gt + (1 + gt | child_id) +
                       (1 | school_id), d)))
}

# --- 條件成長:跨層次交互作用(治療試驗)---
rct <- readRDS("Examples/data/therapy_rct.rds")
# week:arm 即斜率差
m_cond <- lmer(hdrs ~ week * arm + (1 + week | patient_id), rct)

# --- 殘差共變數結構要用 nlme,不是 lme4 ---
library(nlme)
g0 <- lme(achievement ~ grade_c, random = ~1 | child_id, data = sg, method = "ML")
g1 <- update(g0, correlation = corAR1(form = ~ grade | child_id))   # AR(1)
anova(g0, g1)                                                      # 以 AIC 比較
完整的分析都在隨附的腳本 ch14_analysis_V01.R 之中,包括時間編碼的示範、多項式與分段配適、加速世代的平均數、條件模型與時間變動共變項模型,以及殘差結構的比較。圖形由中文版的 ch14_figures_zh_V01.R 繪出。殘差結構需要 nlme 套件;同一批成長模型的結構方程參數化在第 19 章處理,以 lavaan 配適。
軟體提示 • 同一個成長模型在各套軟體中
多層次成長模型在 SPSS 中由 MIXED 配適,在 Stata 中是 mixed,在 SAS 中是 PROC MIXED,在 Mplus 中是 TYPE = TWOLEVEL 或 growth 指令;每一種都接受個別不同的時間值,所以加速設計在所有軟體中都以同樣的方式配適。有兩項專屬於成長模型的跨程式注意事項。第一,第 14.6 節的殘差共變數結構在各軟體中名稱不同:nlme 是 corAR1,SAS 與 SPSS 是 REPEATED 加一個共變數型態,Stata 則是 residual 選項。所有軟體的預設都是獨立,有結構的殘差必須刻意要求。第二,結構方程程式以寬格式的潛在曲線模型配適成長,需要平衡或明確設定型態的時點,個別不同的時間則透過定義變項或 TSCORES 選項處理。本章所用的多層次長格式配適沒有這種要求,時點在個體間自由變動時偏好它,理由就在這裡。
14.9 常見的迷思
關於成長模型,有幾種說法會誤導讀者。第一種是截距斜率相關是資料的固定性質:它是資料與所選原點合起來的性質,會隨原點移動而改變,甚至反轉符號(圖 14.1),沒有陳述時間零點就沒有意義。第二種是配適較好的多項式就是較好的模型:配適只好一點的多項式,外推起來可能荒謬,係數也不可解讀;即使配適相當,理論驅動的分段或非線性形式往往仍然更好。第三種是加速設計測量了一條很長的軌跡:它是在「各世代只在年齡上不同」這個收斂假設之下推論出一條軌跡,假設失敗時,接起來的曲線就把發展與世代混淆在一起。第四種是時間變動共變項的係數就是它的效果:沒有作個人平均數中心化,它就是個體內與個體間效果無法解讀的混合,甚至可能帶著錯的符號(wrong sign)。第五種是有結構的殘差與隨機斜率是可以互換的補救辦法:兩者編碼(encode)的是不同的機制(mechanism),一個是改變上的個別差異,一個是測量中的序列相關,把兩者都完整配適常常會得到一個奇異的模型。
常見陷阱 • 成長模型實務上的四個錯誤
第一,報告截距變異數或截距斜率相關卻不陳述原點:每一個與截距有關的量都取決於時間零點在哪裡,所以原點必須指名,而且要選得讓截距成為關心的那個量。第二,把多項式外推到資料之外:在觀察範圍內配適的二次或三次式,對範圍之外說不出任何可信的話,絕不可往前投射。第三,在加速設計中不檢查收斂就把各世代接起來:請把世代加進去當成長參數的調節變項,為「各世代只在年齡上不同」提出辯護,然後才把那些段落當成一條曲線。第四,把時間變動共變項原封不動地放進去:請作個人平均數中心化,並像第 13 章那樣分別報告個體內與個體間效果。
本章摘要
成長曲線模型就是第 13 章的線性混合模型,只是把時間放在第一層當預測變項,所以它的估計、推論與中心化邏輯全部原封不動沿用過來。屬於個人的截距與斜率成了起始水準與改變速率,而隨機效果的共變數,也就是截距變異數、斜率變異數與兩者的相關,就是改變上個別差異的實徵描述(empirical description)。時間計量的原點是一項後果嚴重的建模抉擇:它固定了截距的意義,並透過一條平移直線的代數決定截距變異數與截距斜率相關,後者會隨原點移動而反轉符號,斜率則保持不變(圖 14.1)。非線性的改變以多項式、分段線性或樣條基底建模,在平滑性(smoothness)與線段斜率的可解讀性之間取捨(圖 14.2、14.3);在學校成長資料上,二次式與兩段樣條都抓到了輕微的減速。個別不同的測量時點所需要的,不過就是把每個人實際的時間值填進去,加速縱貫設計因此成為可能,在收斂假設之下把重疊的世代接成一條軌跡(圖 14.4)。個人層次共變項作為截距與斜率的預測變項進場,而加在斜率上的共變項就是與時間的跨層次交互作用,也是一項縱貫介入研究的估計標的(圖 14.5)。時間變動共變項以個人平均數中心化分解成個體內與個體間效果(圖 14.6)。隨機效果沒吸收完的殘差依賴,可以在 nlme 中以 AR(1) 或 Toeplitz 殘差結構建模,而它在隨機結構刻意保持簡單(deliberately simple)時幫助最大(圖 14.7)。一份完整的分析會陳述時間計量、為形狀提出理由,並同時報告平均軌跡與個別差異(圖 14.8)。
接下來讀哪裡
這裡發展的成長模型會往好幾個方向延伸。第 15 章與第 16 章透過廣義線性混合模型把它帶到非常態與非連續的結果變項,讓計數、二元結果與有界量尺也能成長。第 17 章提供貝氏估計,能穩住豐富的成長模型經常產生的弱識別隨機結構,也能優雅地處理非線性的成長參數。第 19 章揭示潛在成長曲線模型就是結構方程形式的同一個模型:截距與斜率成為潛在因素,第 14.6 節的隱含共變數成為因素結構,而這個架構還多了一項能力,可以把成長因素當成其他變項的因與果來建模。第 20 章與第 21 章在此之上建立成長混合分配模型,問母體中是不是含有幾類截然不同的軌跡潛在類別,而不是一條帶著連續變異的軌跡,並建立平行歷程與交叉延宕的延伸,為兩個構念的聯合成長建模。本章關於時間編碼與中心化的教訓會一路重現:只要時間是預測變項,它的原點與它的個體內個體間分解就決定了模型的係數是什麼意思。
習題
- 14.1 重新編碼原點。在所提供的成長資料集上,把時間分別中心化在第一個、中間與最後一個時點各配適一次線性模型,列表比較三者的截距、截距變異數與截距斜率相關。以代數驗證斜率不變、共變數隨平移量線性移動,並找出使相關為零的那個原點。
- 14.2 選一個形狀。對一條彎曲的軌跡配適線性、二次與兩段分段模型,以 AIC 與 BIC 比較,再以理論與可解讀性、而不是單以配適,為其中一個提出辯護。把選定模型的非線性參數換算成關於改變速率的實質陳述。
- 14.3 把世代接起來。在一個加速設計上配適合併的成長模型,再把世代加進去當截距與斜率的調節變項,檢定收斂假設。報告各世代能不能當成同一個歷程;若不能,接起來的軌跡會錯誤呈現什麼。
- 14.4 估計治療對斜率的效果。在一項兩組試驗中配適條件成長模型,報告組別與時間的跨層次交互作用及其信賴區間,並換算成研究結束時結果變項上隱含的差距。說明這個交互作用對殘餘斜率變異數做了什麼。
- 14.5 分解一個時間變動共變項。把一個時間變動共變項先原封不動、再以個人平均數中心化放進去,寫出三種解讀,指出哪一個係數回答個體內的問題,並解釋原始係數如何把兩者混在一起。
- 14.6 為殘差建模。在時點間隔很近的資料上,於
nlme中以獨立、AR(1) 與 Toeplitz 三種殘差結構配適隨機截距成長模型,以 AIC 比較,並討論隨機斜率會不會是對同一份依賴更好的說明。
本章重要名詞中英對照
| 中文 | English | 說明/首次出現處 |
|---|---|---|
| 成長曲線模型 | growth curve model | 以時間為第一層預測變項的線性混合模型;第 14.1 節 |
| 無條件線性成長模型 | unconditional linear growth model | 沒有共變項、只有時間的成長模型;第 14.1 節 |
| 時間計量 | time metric | 時間以什麼變項與單位進場;第 14.1.1 節 |
| 原點 | origin | 時間計量等於零的位置;決定截距的意義;第 14.1.1 節 |
| 多項式成長模型 | polynomial growth model | 以時間的次方項建曲率;不可外推;第 14.2 節 |
| 分段線性 | piecewise-linear | 兩段以上直線在節點處相接;第 14.2 節 |
| 節點 | knot | 允許斜率改變的那個時間值;第 14.2 節 |
| 樣條 | spline | 由分段多項式組成的有彈性基底;第 14.2 節 |
| 個別不同的測量時點 | individually varying occasions | 每個人每個時點各自的實際時間值;第 14.3 節 |
| 加速縱貫設計 | accelerated longitudinal design | 以重疊世代在短時間內橫跨長發展範圍;第 14.3 節 |
| 收斂假設 | convergence assumption | 各世代出自同一個成長歷程;第 14.3 節 |
| 條件成長模型 | conditional growth model | 以個人層次共變項預測截距與斜率;第 14.4 節 |
| 時間不變共變項 | time-invariant covariate | 不隨時間改變的個人特徵;第 14.4 節 |
| 殘差共變數結構 | residual covariance structure | 取代 \(\sigma^2\mathbf{I}\) 的帶參數殘差形式;第 14.6 節 |
| 去趨勢 | detrend | 把共變項隨時間的走勢移除,避免與成長斜率競爭;第 14.5 節 |
參考文獻
Bell, R. Q. (1953). Convergence: An accelerated longitudinal approach. Child Development, 24(2), 145–152. https://doi.org/10.2307/1126345
Biesanz, J. C., Deeb-Sossa, N., Papadakis, A. A., Bollen, K. A., & Curran, P. J. (2004). The role of coding time in estimating and interpreting growth curve models. Psychological Methods, 9(1), 30–52. https://doi.org/10.1037/1082-989X.9.1.30
Bollen, K. A., & Curran, P. J. (2006). Latent curve models: A structural equation perspective. Wiley. https://doi.org/10.1002/0471746096
Cudeck, R., & Harring, J. R. (2007). Analysis of nonlinear patterns of change with random coefficient models. Annual Review of Psychology, 58(1), 615–637. https://doi.org/10.1146/annurev.psych.58.110405.085520
Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62, 583–619. https://doi.org/10.1146/annurev.psych.093008.100356
Curran, P. J., Obeidat, K., & Losardo, D. (2010). Twelve frequently asked questions about growth curve modeling. Journal of Cognition and Development, 11(2), 121–136. https://doi.org/10.1080/15248371003699969
Grimm, K. J., Ram, N., & Estabrook, R. (2017). Growth modeling: Structural equation and multilevel modeling approaches. Guilford Press.
Grimm, K. J., Ram, N., & Hamagami, F. (2011). Nonlinear growth curves in developmental research. Child Development, 82(5), 1357–1371. https://doi.org/10.1111/j.1467-8624.2011.01630.x
Mehta, P. D., & West, S. G. (2000). Putting the individual back into individual growth curves. Psychological Methods, 5(1), 23–43. https://doi.org/10.1037/1082-989X.5.1.23
Miyazaki, Y., & Raudenbush, S. W. (2000). Tests for linkage of multiple cohorts in an accelerated longitudinal design. Psychological Methods, 5(1), 44–63. https://doi.org/10.1037/1082-989X.5.1.44
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage.
Raudenbush, S. W., & Chan, W.-S. (1992). Growth curve analysis in accelerated longitudinal designs. Journal of Research in Crime and Delinquency, 29(4), 387–411. https://doi.org/10.1177/0022427892029004001
Singer, J. D., & Willett, J. B. (2003). Applied longitudinal data analysis: Modeling change and event occurrence. Oxford University Press.
Sterba, S. K. (2014). Fitting nonlinear latent growth curve models with individually varying time points. Structural Equation Modeling: A Multidisciplinary Journal, 21(4), 630–647. https://doi.org/10.1080/10705511.2014.919828
引用本章
APA 第 7 版沒有「單一作者專書之章」這個文獻類型:正式的參考文獻指向整本書,章次寫在內文引用裡。若您要讓引用直接連到本章這一頁,再採用下方第二組(依 APA 的網站文件格式)。
引用全書、於內文指明章次(建議)
只引用本章這一頁
英文稿件中引用
APA 第 7 版第 9.38 節:非英文著作保留原文題名,並於方括號內附英文翻譯。